
Last chance! 50% off DataCamp Premium
Sale ends in
कॉशी वितरण एक दिलचस्प सांख्यिक पहेली प्रस्तुत करता है। यद्यपि इसका आकार कई अन्य सतत प्रायिकता वितरणों जैसा घंटी-आकृति का होता है, यह परंपरागत विश्लेषण से परे है क्योंकि इसका न तो परिभाषित माध्य होता है और न ही विचरण। गणितज्ञ ऑगस्टिन-लुई कॉशी के नाम पर रखा गया यह वितरण वित्तीय मॉडलिंग से लेकर बायेज़ियन सांख्यिकी तक कई क्षेत्रों में स्वाभाविक रूप से उभरता है।
एक शिक्षण उपकरण के रूप में, कॉशी वितरण मूलभूत सांख्यिकीय अवधारणाओं को उल्लेखनीय स्पष्टता से दर्शाता है। यह नमूना माध्य के अभिसरण-न-होने को दिखाता है, वितरण-संबंधी मान्यताओं के महत्व को रेखांकित करता है, और बताता है कि विभिन्न परिस्थितियों में आकलक कैसे काम करते हैं।
क्या आप इन सांख्यिकीय अवधारणाओं और उनके डेटा साइंस में अनुप्रयोगों में निपुण होना चाहते हैं? हमारे Machine Learning Scientist in R करियर ट्रैक को देखें, जहाँ आप R प्रोग्रामिंग का उपयोग करके इन विचारों को लागू करना सीखेंगे।
कॉशी वितरण एक सतत प्रायिकता वितरण है जो अपनी विशिष्ट विशेषताओं और भारी पूँछों के लिए प्रसिद्ध है। इसे दो प्रमुख मानदंडों द्वारा परिभाषित किया जाता है:
वितरण को गणितीय रूप से इसके प्रायिकता घनत्व फलन (PDF) द्वारा परिभाषित किया जाता है:
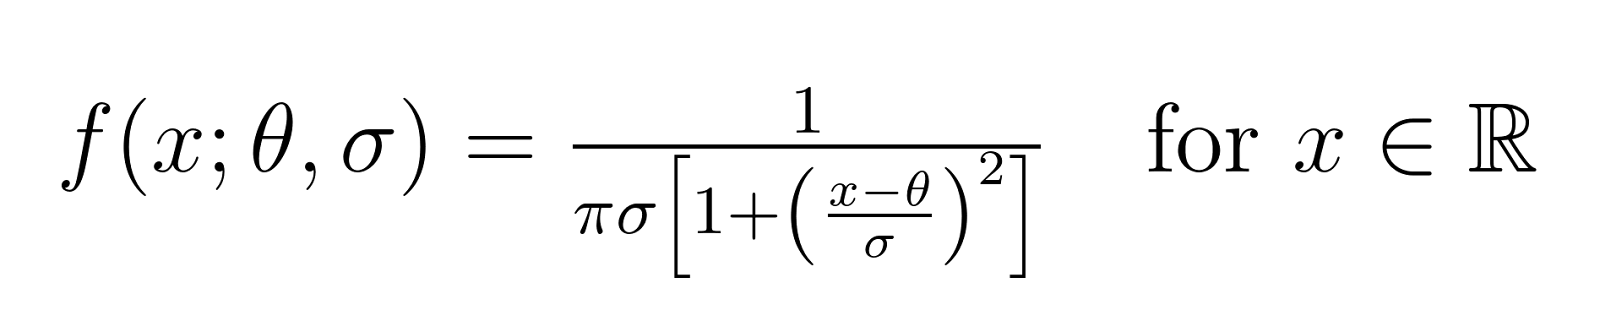
जब हम θ = 0 और σ = 1 रखते हैं, तो हमें मानक कॉशी वितरण मिलता है। यह वितरण का सबसे सरल रूप है और अधिक जटिल मामलों को समझने के लिए संदर्भ बिंदु के रूप में काम करता है।
कॉशी वितरण को "चरम घटनाओं" का वितरण मानें। जहाँ सामान्य वितरण यह सुझाता है कि केंद्र से बहुत दूर के मान बहुत दुर्लभ होते हैं (जैसे 7 फीट लंबे व्यक्ति को पाना), वहीं कॉशी वितरण बताता है कि चरम मान आपकी अपेक्षा से अधिक बार घटित होते हैं।
उदाहरण के लिए, शेयर बाजार प्रतिफलों में, एक ही दिन में बड़े दाम परिवर्तन (जैसे बाजार के ध्वंस या उछाल के दौरान) सामान्य वितरण की भविष्यवाणी से अधिक बार होते हैं। कॉशी वितरण की भारी पूँछें ऐसे "ब्लैक स्वान" घटनाओं को बेहतर ढंग से समेट सकती हैं।
यह संभवतः कॉशी वितरण का सबसे रोचक गुण है। अधिकांश वितरणों के विपरीत, कॉशी वितरण का कोई सार्थक औसत (माध्य) या फैलाव (विचरण) नहीं होता।
यह क्यों मायने रखता है, इसे समझने के लिए: यदि आप कॉशी वितरण से बार-बार नमूने लें और उनका औसत निकालने की कोशिश करें, तो आप लाखों नमूनों के बाद भी किसी विशिष्ट मान पर अभिसारित नहीं होंगे। इसका सांख्यिकीय विश्लेषण पर प्रभाव पड़ता है, क्योंकि पारंपरिक विधियाँ जो माध्य और विचरण पर निर्भर करती हैं (जैसे t-परीक्षण या ANOVA) कॉशी-वितरित डेटा के साथ काम नहीं करतीं।
कॉशी वितरण अपने लोकेशन पैरामीटर (θ) के चारों ओर पूर्णतः संतुलित होता है, जैसे दोनों ओर दर्पण-प्रतिबिंब। हालाँकि, यह सममिति इसका व्यवहार सामान्य वितरण जैसा होने की गारंटी नहीं देती। दोनों वितरण सममित होने पर भी, कॉशी वितरण अपनी प्रायिकता को बहुत अधिक व्यापक रूप से फैलाता है। इसका अर्थ है कि यद्यपि इसका एक स्पष्ट केंद्र है, मान उल्लेखनीय प्रायिकता के साथ इस केंद्र से बहुत दूर भी जा सकते हैं।
कॉशी वितरण का एक उल्लेखनीय गुण है: जब आप दो स्वतंत्र कॉशी-वितरित चर को जोड़ते हैं, तो आपको फिर से एक कॉशी वितरण मिलता है! स्थिरता (stability) के नाम से जानी जाने वाली यह विशेषता केवल कुछ अन्य वितरणों (जैसे सामान्य वितरण) में पाई जाती है। यह भौतिकी और वित्तीय मॉडलिंग में विशेष रूप से उपयोगी है, जहाँ हमें अक्सर यह समझने की आवश्यकता होती है कि संयुक्त यादृच्छिक प्रक्रियाएँ समय के साथ कैसे व्यवहार करती हैं।
कॉशी वितरण आउटलायर को संभालने में उत्कृष्ट है क्योंकि यह उनके घटित होने की अपेक्षा करता है। यह उन परिस्थितियों में विशेष रूप से उपयोगी है जहाँ चरम मान डेटा का स्वाभाविक हिस्सा होते हैं, न कि हटाने योग्य गलतियाँ। ऐसे मामलों में, पारंपरिक आउटलायर पहचान विधियाँ अत्यधिक सख्त हो सकती हैं और वैध डेटा बिंदुओं को हटाने के लिए गलत ढंग से चिह्नित कर सकती हैं। कॉशी वितरण ऐसे सुदृढ़ मॉडल बनाने का ढाँचा प्रदान करता है जो चरम अवलोकनों से अनावश्यक रूप से प्रभावित नहीं होंगे, जिससे यह उन डेटासेट्स के साथ काम करते समय मूल्यवान उपकरण बन जाता है जहाँ आउटलायर्स कोई अपवाद नहीं बल्कि अंतर्निहित विशेषता हैं।
कॉशी वितरण का उपयोग करना है या नहीं, यह आपके डेटा और लक्ष्यों पर निर्भर करता है। जब आपका डेटा अक्सर चरम मान दिखाता है, जब आप सामान्य-वितरित चरों के अनुपात के साथ काम कर रहे हों, या जब आपको भारी-पूँछ वाले डेटा को संभालने में सक्षम सुदृढ़ मॉडल चाहिए, तब कॉशी वितरण विशेष रूप से मूल्यवान है। हालाँकि, कुछ स्थितियों में आपको कॉशी वितरण का उपयोग करते समय सावधानी बरतनी चाहिए: जब आपको माध्य और विचरण पर निर्भर रहना हो, जब आपका डेटा वास्तव में हल्की पूँछ वाले वितरण का अनुसरण करता हो, या जब संगणनात्मक दक्षता प्राथमिक चिंता हो। इन समझौतों को समझना इस बारे में सूचित निर्णय लेने में सहायक है कि क्या कॉशी वितरण आपकी विशिष्ट विश्लेषण आवश्यकताओं के लिए उपयुक्त है।
यद्यपि कॉशी वितरण का गणितीय सूत्र सीधा है, इसके साथ संगणनात्मक रूप से काम करना चुनौतीपूर्ण हो सकता है। पैरामीटर आकलन के लिए अक्सर मार्कोव चेइन मोंटे कार्लो (MCMC) जैसी विशिष्ट तकनीकों की आवश्यकता होती है, और मानक अधिकतम संभाव्यता विधियाँ भारी पूँछों के कारण संघर्ष कर सकती हैं। सौभाग्य से, आधुनिक सांख्यिकीय सॉफ़्टवेयर पैकेजों में अक्सर कॉशी वितरण को संभालने के लिए विशिष्ट उपकरण शामिल होते हैं, जिससे इसकी संगणनात्मक जटिलताओं के बावजूद व्यवहार में इस वितरण के साथ काम करना अधिक संभव हो जाता है।
कॉशी वितरण के कई महत्वपूर्ण गणितीय गुण हैं जो इसे अद्वितीय और उपयोगी बनाते हैं:
कॉशी वितरण के व्यवहार को विज़ुअलाइज़ेशन के माध्यम से सबसे अच्छी तरह समझा जा सकता है। आइए R का उपयोग करके अलग-अलग कॉशी वितरणों के प्लॉट बनाते हैं, यह दर्शाते हुए कि लोकेशन (θ) और स्केल (σ) पैरामीटर वितरण के आकार और स्थिति को कैसे प्रभावित करते हैं।
R अपने stats पैकेज के माध्यम से कॉशी वितरणों के साथ काम करने के लिए फ़ंक्शनों की सुविधा देता है। हम स्पष्ट, प्रकाशन-गुणवत्ता के विज़ुअल्स बनाने के लिए ggplot2 का भी उपयोग करेंगे:
# Load required libraries
library(ggplot2)  # for plotting
# Note: dcauchy is from the stats package which is loaded by default in R

# Create a sequence of x values
x <- seq(-10, 10, length.out = 1000)

# Generate different Cauchy distributions using stats::dcauchy
# Standard Cauchy (θ = 0, σ = 1)
standard_cauchy <- dcauchy(x, location = 0, scale = 1)

# Location and Scale Adjusted (θ = 2, σ = 3)
adjusted_cauchy <- dcauchy(x, location = 2, scale = 3)

# Highly Scaled (θ = -1, σ = 5)
scaled_cauchy <- dcauchy(x, location = -1, scale = 5)

# Create a data frame for plotting
plot_data <- data.frame(
  x = rep(x, 3),
  density = c(standard_cauchy, adjusted_cauchy, scaled_cauchy),
  distribution = rep(c("Standard (θ=0, σ=1)",
                      "Adjusted (θ=2, σ=3)",
                      "Scaled (θ=-1, σ=5)"),
                    each = length(x))
)

# Create the plot
ggplot(plot_data, aes(x = x, y = density, color = distribution)) +
  geom_line(size = 1) +
  theme_minimal() +
  labs(title = "Comparison of Cauchy Distributions",
       x = "x",
       y = "Density",
       color = "Parameters") +
  theme(legend.position = "bottom",
        plot.title = element_text(hjust = 0.5)) +
  scale_color_brewer(palette = "Set1")
यह कोड तीन अलग-अलग कॉशी वितरणों का तुलना-प्लॉट बनाता है:
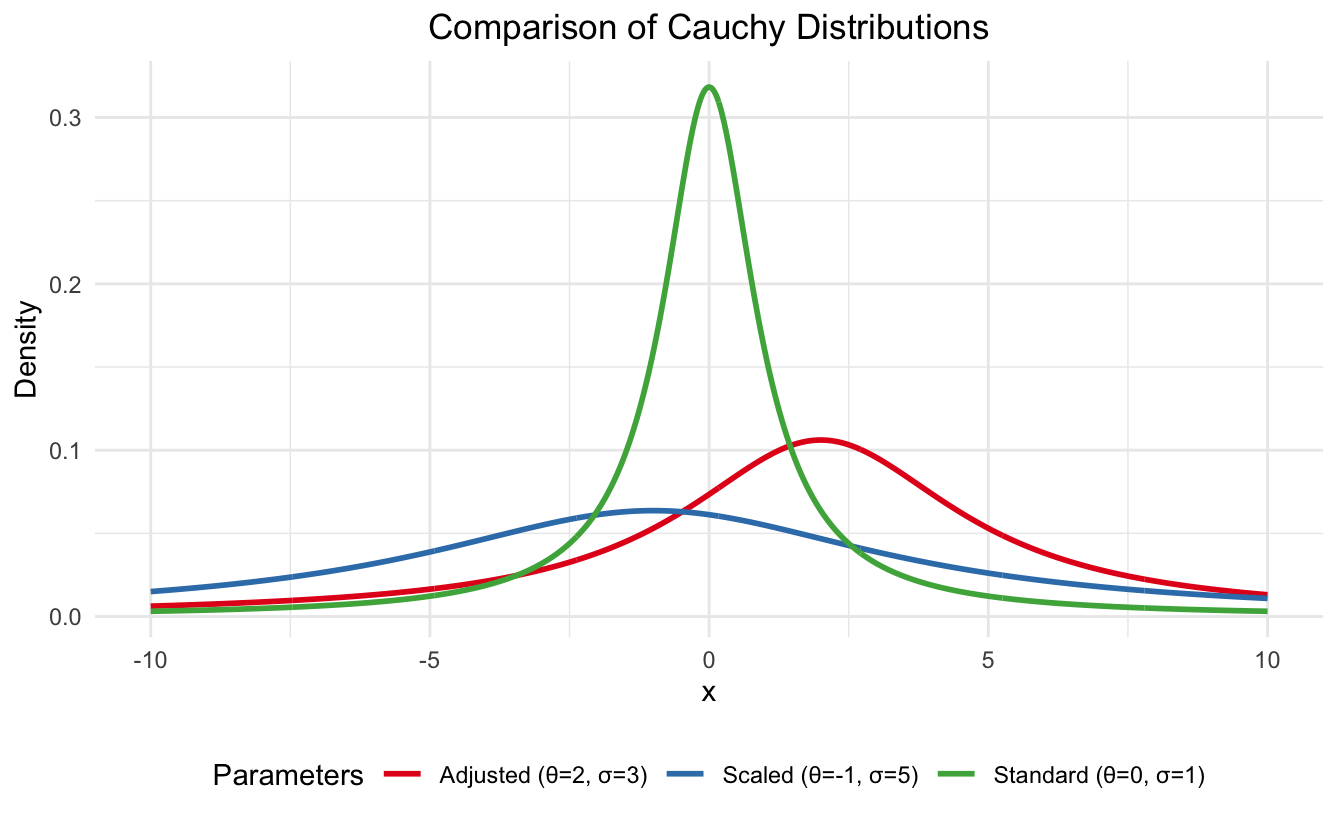
R में कॉशी वितरण। चित्र: लेखक
यह विज़ुअलाइज़ेशन स्पष्ट रूप से दिखाता है कि स्केल पैरामीटर (σ) बढ़ाने से वितरण अधिक चपटा और फैला हुआ हो जाता है, जबकि लोकेशन पैरामीटर (θ) केवल पूरे वितरण को बाएँ या दाएँ खिसकाता है।
R में कॉशी वितरण के पैरामीटरों का अन्वेषण करने के बाद, आइए Python का उपयोग करके कॉशी वितरण की तुलना इसके अधिक परिचित रिश्तेदार, सामान्य (Normal) वितरण से करें। Python का वैज्ञानिक संगणन स्टैक, विशेष रूप से scipy.stats, प्रायिकता वितरणों के साथ काम करने के लिए उत्कृष्ट उपकरण प्रदान करता है।
जहाँ R के stats पैकेज ने हमें कॉशी वितरण फ़ंक्शनों तक सीधी पहुँच दी, वहीं Python का scipy.stats मॉड्यूल समान कार्यक्षमता थोड़े भिन्न इंटरफ़ेस के साथ प्रदान करता है। हम स्पष्ट विज़ुअलाइज़ेशन बनाने के लिए Python की प्रमुख प्लॉटिंग लाइब्रेरी matplotlib का उपयोग करेंगे:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Set style parameters for better visualization
plt.style.use('seaborn')
plt.rcParams.update({
    'font.size': 16,
    'axes.labelsize': 18,
    'axes.titlesize': 24,
    'xtick.labelsize': 16,
    'ytick.labelsize': 16,
    'legend.fontsize': 16,
})

# Create data
x = np.linspace(-10, 10, 1000)
cauchy = stats.cauchy.pdf(x, loc=0, scale=1)
normal = stats.norm.pdf(x, loc=0, scale=1)

# Create the plot
plt.figure(figsize=(12, 8))

# Plot distributions
plt.plot(x, cauchy, 'b-', linewidth=2.5, label='Cauchy(0,1)')
plt.plot(x, normal, 'r--', linewidth=2.5, label='Normal(0,1)')

# Customize the plot
plt.title('Cauchy vs Normal Distribution', pad=20)
plt.xlabel('x', labelpad=10)
plt.ylabel('Density', labelpad=10)

# Customize legend
plt.legend(fontsize=16, bbox_to_anchor=(0.99, 0.99),
          loc='upper right', borderaxespad=0.)

# Add grid and adjust layout
plt.grid(True, alpha=0.3)
plt.tight_layout()

plt.show()
ऊपर दिया गया कोड मानक कॉशी वितरण (नीली ठोस रेखा) और मानक सामान्य वितरण (लाल डैश्ड रेखा) के बीच तुलना बनाता है, जो दोनों 0 पर केंद्रित हैं और स्केल पैरामीटर 1 है।
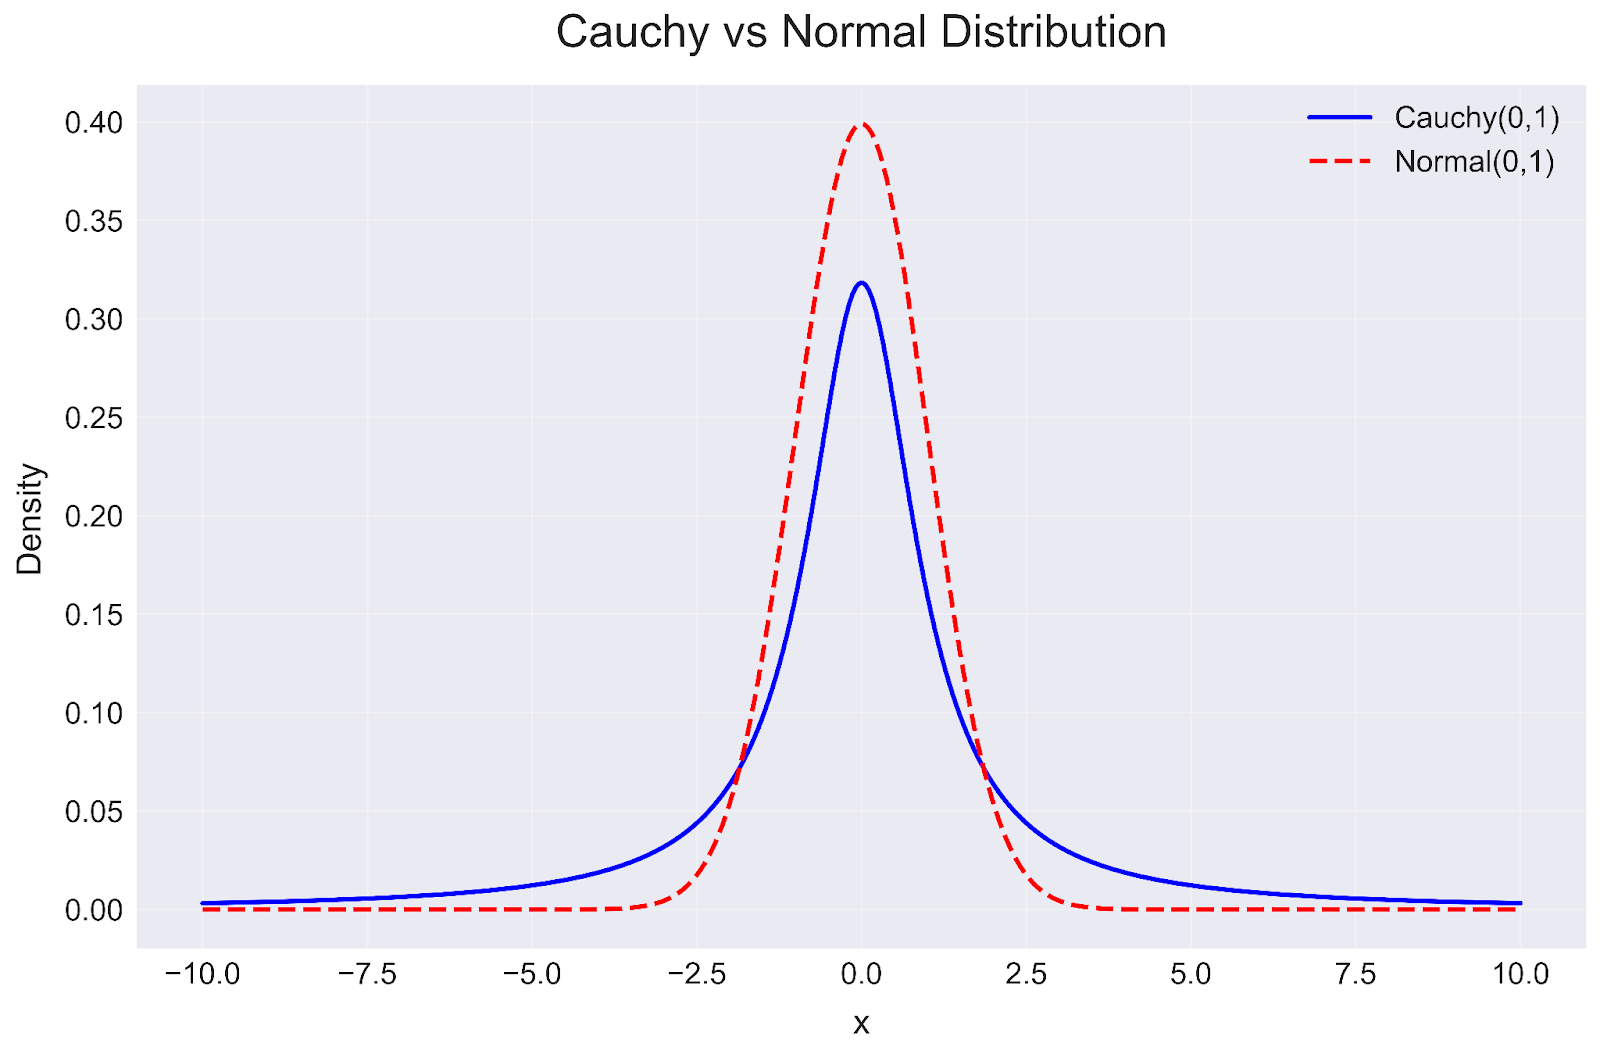
Python में कॉशी वितरण। चित्र: लेखक
यह विज़ुअलाइज़ेशन कई प्रमुख अंतर्दृष्टियाँ उजागर करता है:
यह तुलना यह समझाने में मदद करती है कि क्यों कॉशी वितरण का उपयोग अक्सर उन परिस्थितियों में किया जाता है जहाँ सामान्य वितरण चरम घटनाओं की प्रायिकता को कम आँकता है। यद्यपि दोनों वितरण अपने केंद्र के चारों ओर सममित होते हैं, कॉशी वितरण की भारी पूँछें इसे उन प्रणालियों के मॉडलिंग के लिए अधिक उपयुक्त बनाती हैं जहाँ आउटलायर आम हैं, न कि दुर्लभ अपवाद।
कॉशी वितरण डेटा विश्लेषण और मॉडलिंग में विशिष्ट उद्देश्यों की पूर्ति करता है। आइए देखें कि इसे विभिन्न डोमेन में प्रभावी ढंग से कैसे उपयोग किया जाता है।
वित्तीय बाजार अपनी अप्रत्याशित प्रकृति के लिए जाने जाते हैं, जो अक्सर नाटकीय दाम उतार-चढ़ाव का अनुभव करते हैं जिन्हें सामान्य वितरण मान्यताओं के अंतर्गत "असंभव" माना जाएगा। कॉशी वितरण यहाँ इसलिए चमकता है क्योंकि:
उदाहरण के लिए, 2008 के वित्तीय संकट के दौरान, कई पारंपरिक मॉडल विफल रहे क्योंकि उन्होंने सामान्य वितरण मान लिए थे। कॉशी-आधारित मॉडल ऐसे चरम बाजार उतार-चढ़ाव की संभावना का बेहतर अनुमान लगा सकता था।
निवेश जोखिम का मूल्यांकन करते समय, कॉशी वितरण एक अधिक सतर्क और यथार्थवादी दृष्टिकोण प्रदान करता है। यह चरम परिदृश्यों को ध्यान में रखकर जोखिम प्रबंधकों को अधिक उपयुक्त पूंजी भंडार निर्धारित करने में मदद करता है, उल्लेखनीय हानियों या लाभों की प्रायिकता का बेहतर अनुमान देता है, और पोर्टफोलियो के स्ट्रेस टेस्टिंग के लिए अधिक यथार्थवादी मॉडल प्रदान करता है। जोखिम आकलन का यह दृष्टिकोण वित्तीय संस्थानों को अलभ्य लेकिन प्रभावशाली बाजार घटनाओं के लिए तैयार होने में मदद करता है।
बायेज़ियन विश्लेषण में सही पूर्व-वितरण चुनना अत्यंत महत्वपूर्ण है। कॉशी वितरण यहाँ विशेष रूप से मूल्यवान है क्योंकि:
उदाहरण के लिए, किसी नए चिकित्सीय उपचार की प्रभावशीलता का विश्लेषण करते समय, प्रभाव आकार के लिए कॉशी पूर्व-वितरण का उपयोग यह सुनिश्चित करने में मदद करता है कि हम बड़े उपचार प्रभावों की संभावना को कम न आँकें।
पारंपरिक प्रतिगमन आउटलायर से बहुत प्रभावित हो सकता है। कॉशी-वितरित त्रुटि पदों का उपयोग करके अधिक सुदृढ़ मॉडल बनाए जा सकते हैं, क्योंकि यह मॉडल को चरम अवलोकनों के प्रति कम संवेदनशील बनाता है। परिणाम बाहरी मानों की उपस्थिति में भी विश्वसनीय बने रहते हैं, और असामान्य डेटा बिंदुओं के होने पर पूर्वानुमान अधिक स्थिर रहते हैं। यह सुदृढ़ता वास्तविक डेटासेट्स के साथ काम करते समय विशेष रूप से मूल्यवान है, जिनमें अक्सर अप्रत्याशित या चरम मान होते हैं।
आधुनिक मशीन लर्निंग अक्सर शोरयुक्त, वास्तविक दुनिया के डेटा से निपटती है। कॉशी वितरण अधिक लचीले एल्गोरिदम बनाने में मदद करता है:
उदाहरण के लिए, कंप्यूटर विज़न में, कॉशी-वितरित शोर मॉडलों का उपयोग एल्गोरिदम को इमेज आर्टिफैक्ट्स या सेंसर गड़बड़ियों को बेहतर ढंग से संभालने में मदद कर सकता है।
उन्नत मशीन लर्निंग अनुप्रयोगों में, कॉशी वितरण अधिक लचीले मॉडल बनाने में मदद करता है। यह वैरिएशनल ऑटोएन्कोडर्स में उपयोगी है जहाँ डेटा में भारी-पूँछ के लक्षण हो सकते हैं, बीच-बीच में आने वाले चरम मानों सहित अधिक यथार्थपरक सिंथेटिक डेटा उत्पन्न करने में मदद करता है, और उन लेटेंट स्पेस का मॉडलिंग करने में मूल्यवान है जहाँ सामान्य वितरण बहुत प्रतिबंधक हो सकते हैं। यह लचीलापन जनरेटिव मॉडलिंग कार्यों में कॉशी वितरण को विशेष रूप से उपयोगी बनाता है, जहाँ संभावित डेटा विविधताओं की पूरी श्रेणी को समेटना महत्वपूर्ण होता है।
कॉशी वितरण को अन्य समान वितरणों के साथ भ्रमित करना आम है। आपके विश्लेषण के लिए सही विकल्प चुनने में मदद के लिए आइए प्रमुख अंतरों का अन्वेषण करें।
सामान्य वितरण कई विश्लेषणों के लिए अक्सर डिफ़ॉल्ट विकल्प होता है, लेकिन इसके और कॉशी वितरण के बीच महत्वपूर्ण अंतर हैं:
यद्यपि दोनों वितरण सममित हैं, उनकी पूँछें बहुत अलग कहानी कहती हैं: सामान्य वितरण यह सुझाता है कि तीन मानक विचलनों से परे के मान अत्यंत दुर्लभ हैं। कॉशी वितरण बताता है कि चरम मान आपकी अपेक्षा से कहीं अधिक सामान्य हैं।
इन वितरणों के विश्लेषण के तरीके मौलिक रूप से भिन्न हैं: सामान्य वितरण के सुव्यवस्थित मोमेंट्स होते हैं (माध्य = μ, विचरण = σ²)। कॉशी वितरण का कोई परिभाषित माध्य या विचरण नहीं होता, जिससे पारंपरिक सांख्यिकीय विधियाँ अनुपयोगी हो जाती हैं।
यह अंतर वास्तविक अनुप्रयोगों में मायने रखता है: सामान्य वितरण का उपयोग तब करें जब आपका डेटा एक केंद्रीय मान के आसपास पूर्वानुमेय फैलाव के साथ समूहित होता है। कॉशी वितरण का उपयोग तब करें जब आपका डेटा अक्सर ऐसे चरम मान दिखाता है जो सामान्य मान्यताओं के तहत "असंभव" होंगे।
लैप्लास वितरण पहली नज़र में कॉशी जैसा लग सकता है, लेकिन कुछ प्रमुख अंतर इन्हें अलग करते हैं:
दोनों वितरणों की पूँछें सामान्य वितरण से भारी होती हैं, लेकिन उनकी भारीपन में अंतर है: लैप्लास वितरण की पूँछें घातीय रूप से क्षीण होती हैं। कॉशी वितरण की पूँछें अधिक धीरे-धीरे (बहुपदात्मक रूप से) क्षीण होती हैं, जिससे चरम मानों की संभावना और भी अधिक हो जाती है।
दोनों वितरण अपने केंद्र के चारों ओर सममित होते हैं, लेकिन उनकी पूँछों का व्यवहार अलग है: लैप्लास वितरण अपनी पूँछों में घातीय क्षीणन दिखाता है। कॉशी वितरण बहुपदात्मक क्षीणन दिखाता है, जिससे इसकी पूँछें लैप्लास की तुलना में भारी होती हैं।
इन अंतरों को समझना सही उपकरण चुनने में मदद करता है: लैप्लास वितरण का उपयोग तब करें जब आप कभी-कभार आउटलायर की अपेक्षा करते हों लेकिन परिभाषित मोमेंट्स भी चाहिए हों। कॉशी वितरण का उपयोग तब करें जब आप बार-बार चरम मानों की अपेक्षा करते हों और आपको माध्य की गणना नहीं करनी हो।
कॉशी वितरण, भले ही सामान्य वितरण जितना सर्वत्र लागू न हो, उन क्षेत्रों में महत्वपूर्ण महत्व रखता है जहाँ डेटा भारी-पूँछ वाला व्यवहार दिखाता है, आउटलायर के प्रति सुदृढ़ता आवश्यक है, या स्थिर वितरणों के सैद्धांतिक गुणों में रुचि है। चाहे भौतिकी हो, वित्त हो, या बायेज़ियन सांख्यिकी, कॉशी वितरण को समझना ऐसे डेटा का मॉडलिंग और व्याख्या करने की आपकी क्षमता को बढ़ाता है जो पर्याप्त परिवर्तनशीलता और आउटलायर दिखाते हैं।
संबंधित प्रायिकता वितरणों की गहरी समझ के लिए, आपको निम्नलिखित शृंखला मूल्यवान लग सकती है: हमारा Gaussian Distribution गाइड सबसे व्यापक रूप से उपयोग किए जाने वाले प्रायिकता वितरण की पड़ताल करता है, जो कॉशी वितरण के भारी-पूँछ वाले व्यवहार के लिए उत्कृष्ट विरोधाभास प्रदान करता है। हमारा Poisson Distribution गाइड समय या स्थान पर घटित होने वाली डिस्क्रीट घटनाओं के मॉडलिंग में गहराई से जाता है, जबकि हमारा Binomial Distribution गाइड स्वतंत्र परीक्षणों के अनुक्रम के पीछे का गणित समझाता है। जो लोग प्रायिकता सिद्धांत की बुनियाद में रुचि रखते हैं, उनके लिए हमारा Bernoulli Distribution गाइड अधिक जटिल वितरणों के निर्माण खंडों पर अंतर्दृष्टि प्रदान करता है।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
