
Cursus
Fijn-afstemmen met Llama 3
2 uur
4.1K
We hebben talloze gidsen over fijnslijpen van grote taalmodellen (LLM’s) verkend, maar er zijn weinig bronnen die het proces van het fijnslijpen van multimodale modellen behandelen. In deze tutorial onderzoeken we een state-of-the-art multimodaal model, het Llama 3.2 Vision-model, en laten we zien hoe je het fijnslijt met de Amazon-productdataset. Ons doel is een generator voor productbeschrijvingen te bouwen die accurate en vereenvoudigde beeldbijschriften levert voor producten op Amazon.
Als je nieuw bent met het fijnslijpen van LLM’s, volg dan de cursus Fine-tuning met Llama 3 om vertrouwd te raken met gangbare methoden en terminologie. Bekijk ook onze Llama 3.2 90B-tutorial, waarin wordt uitgelegd hoe je een app voor beeldbijschriften bouwt met Streamlit voor de front-end, Llama 3.2 90B voor het genereren van bijschriften en Groq als de API.
Afbeelding door de auteur
Llama 3.2 introduceert multimodale modellen die zowel beeld- als tekstdata kunnen verwerken om natuurlijke en nauwkeurige antwoorden te genereren. De Llama 3.2-visionmodellen zijn beschikbaar in varianten met 11B en 90B parameters en zijn speciaal ontworpen om beeld-redeneringstoepassingen met opmerkelijke precisie aan te pakken. Deze modellen presteren beter dan veel bestaande open-source en gesloten multimodale modellen op gangbare industriële benchmarks.
Lees de Llama 3.2-gids: hoe het werkt, use-cases en meer om alle modelvariabelen in detail te leren kennen.
De Llama 3.2-visionmodellen blinken uit in taken zoals begrip op documentniveau, analyse van grafieken en diagrammen, beeldbijschriften en visuele verankering, waarbij natuurlijke taalbeschrijvingen worden gebruikt om objecten in beelden te identificeren.
Llama 3.2 Vision is gebouwd bovenop het oudere, tekst-only model Llama 3.1, een geavanceerd taalmodel met een transformer-architectuur. Het is fijngeslepen met supervised learning (SFT) en reinforcement learning met menselijke feedback (RLHF) om af te stemmen op menselijke voorkeuren voor behulpzaamheid en veiligheid.
Om beeldherkenning te faciliteren, bevat Llama 3.2 Vision een apart getrainde vision-adapter. Deze adapter gebruikt cross-attentionlagen om de outputs van de beeldencoder te integreren in het voorgetrainde Llama 3.1-taalmodel, waardoor het zowel tekst- als beeldgebaseerde taken effectief aankan.
Llama 3.2 Vision blinkt uit in use-cases zoals visual question answering, documentanalyse, beeldbijschriften, image-text retrieval en visuele verankering.
Voor dit project gebruiken we Kaggle als onze code- en rekenomgeving, Unsloth als het framework voor fijnslijpen en de Amazon-productbeschrijvingsdataset. Unsloth is snel, gebruikt minder GPU-geheugen en vereist minder regels code dan traditionele methoden.
Als je LLM’s wilt fijnslijpen voor een tekstgeneratie-oplossing, hebben we de perfecte tutorial voor je: Llama 3.2 fijnslijpen en lokaal gebruiken: een stapsgewijze gids.
Maak een nieuw Kaggle-notebook en stel de accelerator in op twee T4-GPU’s. Voeg je Hugging Face-token toe als een Kaggle secret zodat je je model later veilig naar je Hugging Face-repository kunt pushen. Installeer vervolgens het Python-pakket unsloth met het pip-commando.
%%capture
!pip install unsloth
Ontdek meer over Unsloth door de Unsloth-gids: LLM-fijnslijpen optimaliseren en versnellen te lezen.
In deze setup laden we het Llama-3.2-11B-Vision-Instruct-model, specifiek de door Unsloth geleverde versie, die is geoptimaliseerd voor efficiënt fijnslijpen en inferentie. Het model wordt in 4-bit kwantisatie geladen om het geheugengebruik en de rekenvereisten aanzienlijk te verminderen, waardoor grote visionmodellen op T4-GPU’s kunnen draaien.
from unsloth import FastVisionModel
import torch

model, tokenizer = FastVisionModel.from_pretrained(
    "unsloth/Llama-3.2-11B-Vision-Instruct",
    load_in_4bit = True,
    use_gradient_checkpointing = "unsloth",
)LoRA (Low-Rank Adaptation) is een techniek om grote voorgetrainde modellen efficiënt fijn te slijpen door leerbare low-rangematrices in specifieke onderdelen van het model te introduceren. Deze aanpak is lichtgewicht en rekenkundig efficiënt en maakt taakgericht fijnslijpen mogelijk zonder de kernstructuur van het voorgetrainde model aan te passen.
Om een model met LoRA te trainen, focussen we op het selecteren en fijnslijpen van specifieke componenten, zoals visionlagen, taallagen, attentionmodules en MLP-modules. Zo kunnen we het model aan specifieke taken aanpassen met minimale wijzigingen aan de oorspronkelijke architectuur.
model = FastVisionModel.get_peft_model(
    model,
    finetune_vision_layers     = True,
    finetune_language_layers   = True,
    finetune_attention_modules = True,
    finetune_mlp_modules       = True,
    r = 16,
    lora_alpha = 16,
    lora_dropout = 0,
    bias = "none",
    random_state = 3443,
    use_rslora = False,
    loftq_config = None,
)Laad de philschmid/amazon-product-descriptions-vlm-dataset van de Hugging Face Hub en selecteer alleen de eerste 500 samples. De dataset bevat productafbeeldingen en productbeschrijvingen, samen met andere noodzakelijke informatie.
from datasets import load_dataset
dataset = load_dataset("philschmid/amazon-product-descriptions-vlm",
                       split = "train[0:500]")


dataset
Dataset({
features: ['image', 'Uniq Id', 'Product Name', 'Category', 'Selling Price', 'Model Number', 'About Product', 'Product Specification', 'Technical Details', 'Shipping Weight', 'Variants', 'Product Url', 'Is Amazon Seller', 'description'],
num_rows: 500
})Dit is een van de afbeeldingen van het product.
dataset[45]["image"]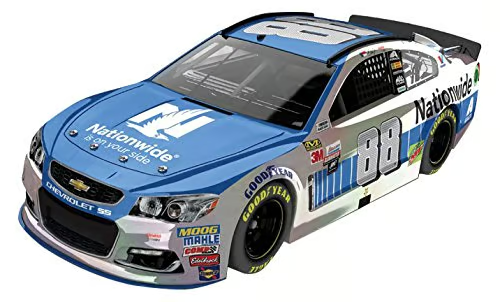
Hier is de beschrijving ervan.
dataset[45]["description"]'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'We verwerken nu de dataset die alleen de tekst en afbeeldingen bevat. De prompt-templates bevatten gebruikersvragen, afbeeldingen en productbeschrijvingen.
instruction = """
You are an expert Amazon worker who is good at writing product descriptions.
Write the product description accurately by looking at the image.
"""


def convert_to_conversation(sample):
    conversation = [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": instruction},
                {"type": "image", "image": sample["image"]},
            ],
        },
        {
            "role": "assistant",
            "content": [{"type": "text", "text": sample["description"]}],
        },
    ]
    return {"messages": conversation}


pass


converted_dataset = [convert_to_conversation(sample) for sample in dataset]
De nieuwe dataset is niet tabelvormig; in plaats daarvan volgt deze een promptstijl die lijkt op het OpenAI-formaat.
converted_dataset[45]{'messages': [{'role': 'user',
'content': [{'type': 'text',
'text': '\nYou are an expert Amazon worker who is good at writing product descriptions. \nWrite the product description accurately by looking at the image.\n'},
{'type': 'image',
'image': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=500x302>}]},
{'role': 'assistant',
'content': [{'type': 'text',
'text': 'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'}]}]}We kiezen de 46e sample uit de dataset en voeren daarop inferentie uit om te beoordelen hoe goed het out-of-the-box de productbeschrijving schrijft zonder fijnslijpen.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
De gegenereerde beschrijving is lang en onnauwkeurig. Zelfs de schrijfstijl wijkt af.
The image showcases a race car featuring the well-known sponsorship branding "Nationwide," likely the primary vehicle in the Nationwide Series. The vehicle has a blue hood with the "Nationwide" logo prominently displayed and white text that reads, "on your side," on the windscreen. The car is predominantly white and grey, adorned with sponsor decals on various parts of the vehicle.

The front grille showcases the Chevrolet "Bowtie" logo, and the car is equipped with Chevrolet emblems and other sponsor decals, including:

• A white 88 logo on the front windscreen

Notably, the vehicle's wheels are equipped with "GoodYearWe zetten het model nu in trainingsmodus en initialiseren een supervised fine-tuning (SFT) trainer om een visionmodel voor te bereiden op training met een aangepaste datacollator, dataset en trainingsconfiguratie die is geoptimaliseerd voor efficiënt fijnslijpen.
from unsloth import is_bf16_supported
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig

FastVisionModel.for_training(model)  # Enable for training!

trainer = SFTTrainer(
    model=model,
    tokenizer=tokenizer,
    data_collator=UnslothVisionDataCollator(model, tokenizer),  # Must use!
    train_dataset=converted_dataset,
    args=SFTConfig(
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        warmup_steps=5,
        max_steps=30,
        learning_rate=2e-4,
        fp16=not is_bf16_supported(),
        bf16=is_bf16_supported(),
        logging_steps=5,
        optim="adamw_8bit",
        weight_decay=0.01,
        lr_scheduler_type="linear",
        seed=3407,
        output_dir="outputs",
        report_to="none",  # For Weights and Biases
        remove_unused_columns=False,
        dataset_text_field="",
        dataset_kwargs={"skip_prepare_dataset": True},
        dataset_num_proc=4,
        max_seq_length=2048,
    ),
)Start het trainingsproces door de code trainer.train() uit te voeren.
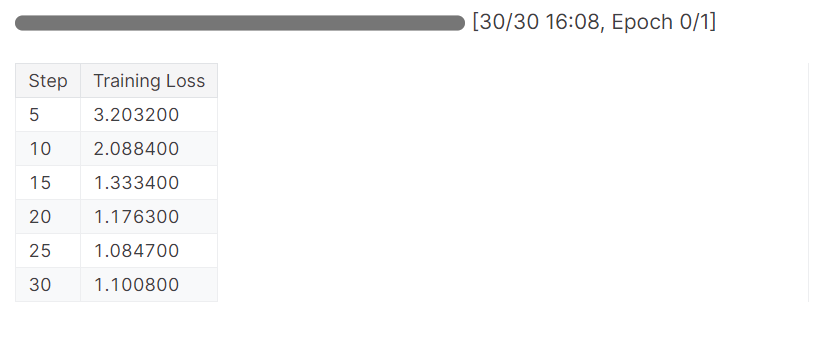
trainer_stats = trainer.train()Het model heeft één epoch voltooid in 16 minuten en de training loss is geleidelijk gedaald. Dit is een goed resultaat.
We testen nu ons model om te controleren of het fijnslijpen is geslaagd. We selecteren dezelfde sample-afbeelding uit de dataset en voeren daarop inferentie uit.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
De resultaten zijn goed maar niet volledig accuraat. De hashtags waren onnodig. Voor optimale resultaten moeten we het model trainen op de volledige dataset met minstens 3 epochs.
Bring the thrill of NASCAR racing to your desk or shelf with the 1/64 Die-Cast 2016 NASCAR 88 Dale Earnhardt Jr. Nationwide Chevrolet SS! Highly detailed and precision engineered, this collectible die-cast car captures the iconic look of Earnhardt's famous No. 88 ride. Perfect for kids and adults alike, this miniature masterpiece makes a great gift. #NASCAR #DieCast #CollectibleCars #DaleEarnhardtJr #Nationwide<|eot_id|>Laten we het model lokaal opslaan en het vervolgens naar de Hugging Face Hub pushen. Om het model naar de Hugging Face-server te uploaden, moeten we inloggen met ons Hugging Face-token.
Verken de transformerende wereld van Hugging Face, de open-source hub van de AI-community voor machine learning en grote taalmodellen (LLM’s), door de blog Wat is Hugging Face? De open-source oase van de AI-community te lezen.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)
Sla daarna het model en de tokenizer lokaal op.
model.save_pretrained("llama_3.2_vision_amazon_product") # Local saving
tokenizer.save_pretrained("llama_3.2_vision_amazon_product")
Gebruik vervolgens push_to_hub om het model op de Hugging Face Hub op te slaan.
model.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
tokenizer.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
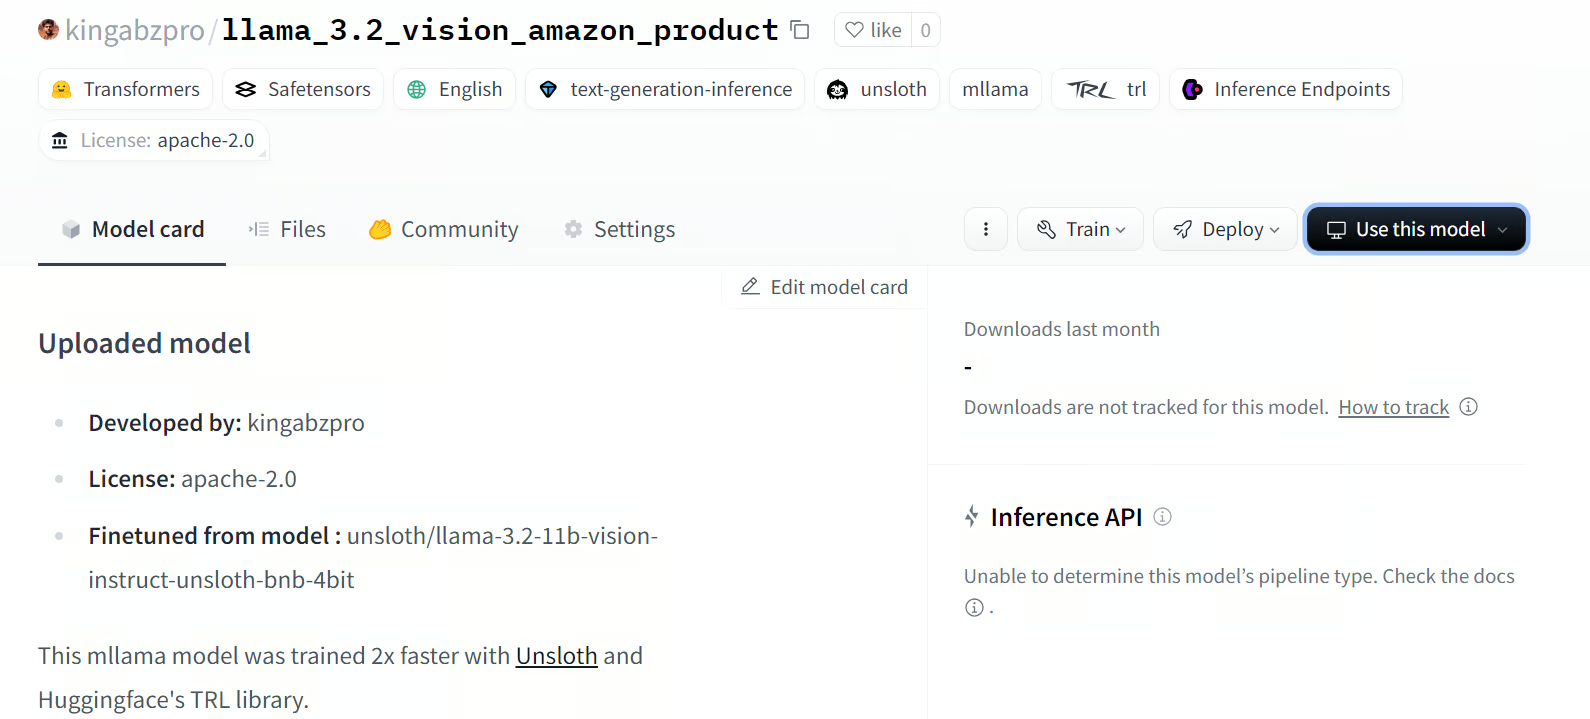
Saved model to https://huggingface.co/kingabzpro/llama_3.2_vision_amazon_productBovenstaand commando maakt de nieuwe modelrepository aan en pusht alle bestanden naar Hugging Face.
Bron: kingabzpro/llama_3.2_vision_amazon_product
Als je problemen ondervindt bij het uitvoeren van de bovenstaande code, raadpleeg dan het Kaggle-notebook: Fine-tuning Llama 3.2 Vision on Amazon Dataset
Het fijnslijpen van Llama 3.2 Vision-modellen opent een nieuwe wereld aan mogelijkheden, vooral in scenario’s waar zowel beelden als tekst nodig zijn om relevante en nauwkeurige resultaten te leveren. Door het te fijnslijpen op een aangepaste dataset kunnen we de prestaties verbeteren en de stijl aanpassen voor toepassingen zoals Visual Question Answering (VQA), Document VQA (DocVQA), beeldbijschriften en Image-Text Retrieval.
In deze tutorial duiken we diep in de Llama 3.2 Vision-modellen. We slijpen ook de 11B-variant van het model fijn op de dataset met Amazon-productbeschrijvingen om een sterk aangepaste generator voor productbeschrijvingen te bouwen die de gewenste stijl aanneemt en accurate productbeschrijvingen levert.
De volgende stap in je traject is leren hoe je de AI-applicatie bouwt en naar de cloud deployt met een Docker-image door de gids te volgen: How to Deploy LLM Applications Using Docker: A Step-by-Step Guide.
Top AI-cursussen
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

