
Corso
Fine-tuning con Llama 3
2 ore
4.1K
Abbiamo esplorato numerose guide sul fine-tuning dei large language model (LLM), ma esistono pochissime risorse che coprono il processo di fine-tuning dei modelli multimodali. In questo tutorial esploreremo un modello multimodale all’avanguardia chiamato Llama 3.2 Vision Model e mostreremo come effettuare il fine-tuning utilizzando il dataset dei prodotti Amazon. Il nostro obiettivo è creare un generatore di descrizioni prodotto che fornisca didascalie d’immagine accurate e semplificate per i prodotti elencati su Amazon.
Se sei alle prime armi con il fine-tuning degli LLM, segui il corso Fine-tuning con Llama 3 per familiarizzare con metodologie e terminologie comuni. Puoi anche dare un’occhiata al nostro tutorial su Llama 3.2 90B, che spiega come creare un’app di image captioning con Streamlit per il front end, Llama 3.2 90B per generare le didascalie e Groq come API.
Immagine dell’autore
Llama 3.2 introduce modelli multimodali in grado di elaborare sia immagini che testo per generare risposte naturali e accurate. I modelli Llama 3.2 Vision sono disponibili nelle varianti da 11B e 90B parametri e sono progettati specificamente per gestire casi d’uso di ragionamento su immagini con notevole precisione. Questi modelli superano molti modelli multimodali open-source e closed-source esistenti nei benchmark di settore più comuni.
Leggi la Guida a Llama 3.2: come funziona, casi d’uso e altro per conoscere nel dettaglio tutte le varianti del modello.
I modelli Llama 3.2 Vision eccellono in attività come la comprensione a livello di documento, l’analisi di grafici e diagrammi, l’image captioning e il visual grounding, in cui si usano descrizioni in linguaggio naturale per identificare oggetti nelle immagini.
Llama 3.2 Vision è costruito sopra il precedente modello Llama 3.1 solo testo, un avanzato modello linguistico basato su architettura transformer. È stato sottoposto a fine-tuning con apprendimento supervisionato (SFT) e reinforcement learning con feedback umano (RLHF) per allinearsi alle preferenze umane in termini di utilità e sicurezza.
Per abilitare il riconoscimento delle immagini, Llama 3.2 Vision integra un adattatore visivo addestrato separatamente. Questo adattatore utilizza livelli di cross-attention per integrare gli output dell’encoder di immagini nel modello linguistico Llama 3.1 pre-addestrato, consentendogli di gestire efficacemente sia attività basate su testo sia su immagini.
Llama 3.2 Vision eccelle in casi d’uso come visual question answering, analisi di documenti, image captioning, image-text retrieval e visual grounding.
Per questo progetto useremo Kaggle come ambiente di coding e calcolo, Unsloth come framework di fine-tuning e il dataset delle descrizioni dei prodotti Amazon. Unsloth è veloce, consuma meno memoria GPU e richiede meno righe di codice rispetto ai metodi tradizionali.
Se vuoi fare fine-tuning di LLM per una soluzione di generazione di testo, abbiamo il tutorial perfetto per te: Fine-tuning di Llama 3.2 e utilizzo in locale: guida passo passo.
Crea un nuovo notebook Kaggle e imposta l’acceleratore su due GPU T4. Aggiungi il tuo token Hugging Face come secret di Kaggle così potrai inviare in sicurezza il tuo modello al repository Hugging Face in un secondo momento. Quindi installa il pacchetto Python unsloth usando il comando pip.
%%capture
!pip install unsloth
Scopri di più su Unsloth leggendo la Guida a Unsloth: ottimizza e velocizza il fine-tuning degli LLM.
In questa configurazione carichiamo il modello Llama-3.2-11B-Vision-Instruct, nello specifico la versione fornita da Unsloth, ottimizzata per un fine-tuning e un’inferenza efficienti. Il modello è caricato con quantizzazione a 4 bit per ridurre significativamente l’uso di memoria e i requisiti computazionali, rendendo possibile l’esecuzione di grandi modelli di visione su GPU T4.
from unsloth import FastVisionModel
import torch

model, tokenizer = FastVisionModel.from_pretrained(
    "unsloth/Llama-3.2-11B-Vision-Instruct",
    load_in_4bit = True,
    use_gradient_checkpointing = "unsloth",
)LoRA (Low-Rank Adaptation) è una tecnica per effettuare il fine-tuning in modo efficiente di grandi modelli pre-addestrati introducendo matrici a basso rango apprendibili in parti specifiche del modello. Questo approccio è leggero ed efficiente dal punto di vista computazionale e consente un fine-tuning specifico per il task senza modificare la struttura principale del modello pre-addestrato.
Per addestrare un modello usando LoRA, ci concentriamo sulla selezione e il fine-tuning di componenti specifici, come i livelli di visione, i livelli linguistici, i moduli di attenzione e i moduli MLP. Questo ci permette di adattare il modello a task specifici con modifiche minime all’architettura originale.
model = FastVisionModel.get_peft_model(
    model,
    finetune_vision_layers     = True,
    finetune_language_layers   = True,
    finetune_attention_modules = True,
    finetune_mlp_modules       = True,
    r = 16,
    lora_alpha = 16,
    lora_dropout = 0,
    bias = "none",
    random_state = 3443,
    use_rslora = False,
    loftq_config = None,
)Carica il dataset philschmid/amazon-product-descriptions-vlm dall’Hugging Face Hub e seleziona solo i primi 500 campioni. Il dataset contiene immagini dei prodotti e descrizioni dei prodotti insieme ad altre informazioni necessarie.
from datasets import load_dataset
dataset = load_dataset("philschmid/amazon-product-descriptions-vlm",
                       split = "train[0:500]")


dataset
Dataset({
features: ['image', 'Uniq Id', 'Product Name', 'Category', 'Selling Price', 'Model Number', 'About Product', 'Product Specification', 'Technical Details', 'Shipping Weight', 'Variants', 'Product Url', 'Is Amazon Seller', 'description'],
num_rows: 500
})Questa è una delle immagini del prodotto.
dataset[45]["image"]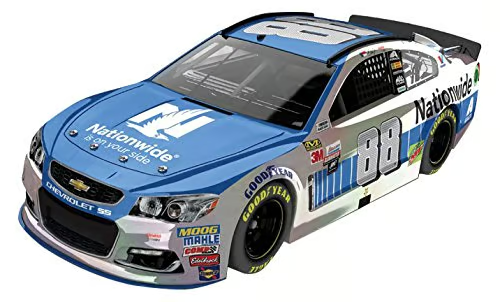
Ecco la sua descrizione.
dataset[45]["description"]'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'Ora elaboreremo il dataset che contiene solo testo e immagini. I template di prompt includono le domande dell’utente, le immagini e le descrizioni dei prodotti.
instruction = """
You are an expert Amazon worker who is good at writing product descriptions.
Write the product description accurately by looking at the image.
"""


def convert_to_conversation(sample):
    conversation = [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": instruction},
                {"type": "image", "image": sample["image"]},
            ],
        },
        {
            "role": "assistant",
            "content": [{"type": "text", "text": sample["description"]}],
        },
    ]
    return {"messages": conversation}


pass


converted_dataset = [convert_to_conversation(sample) for sample in dataset]
Il nuovo dataset non è tabellare; segue invece uno stile di prompt simile al formato di OpenAI.
converted_dataset[45]{'messages': [{'role': 'user',
'content': [{'type': 'text',
'text': '\nYou are an expert Amazon worker who is good at writing product descriptions. \nWrite the product description accurately by looking at the image.\n'},
{'type': 'image',
'image': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=500x302>}]},
{'role': 'assistant',
'content': [{'type': 'text',
'text': 'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'}]}]}Selezioneremo il 46º campione dal dataset ed eseguiremo l’inferenza per valutare quanto bene scrive la descrizione del prodotto out of the box, senza fine-tuning.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
La descrizione generata è lunga e imprecisa. Anche lo stile di scrittura è diverso.
The image showcases a race car featuring the well-known sponsorship branding "Nationwide," likely the primary vehicle in the Nationwide Series. The vehicle has a blue hood with the "Nationwide" logo prominently displayed and white text that reads, "on your side," on the windscreen. The car is predominantly white and grey, adorned with sponsor decals on various parts of the vehicle.

The front grille showcases the Chevrolet "Bowtie" logo, and the car is equipped with Chevrolet emblems and other sponsor decals, including:

• A white 88 logo on the front windscreen

Notably, the vehicle's wheels are equipped with "GoodYearOra imposteremo il modello per l’addestramento e inizializzeremo un trainer per SFT (supervised fine-tuning) per preparare un modello di visione al training con un data collator personalizzato, dataset e configurazione di training ottimizzati per un fine-tuning efficiente.
from unsloth import is_bf16_supported
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig

FastVisionModel.for_training(model)  # Enable for training!

trainer = SFTTrainer(
    model=model,
    tokenizer=tokenizer,
    data_collator=UnslothVisionDataCollator(model, tokenizer),  # Must use!
    train_dataset=converted_dataset,
    args=SFTConfig(
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        warmup_steps=5,
        max_steps=30,
        learning_rate=2e-4,
        fp16=not is_bf16_supported(),
        bf16=is_bf16_supported(),
        logging_steps=5,
        optim="adamw_8bit",
        weight_decay=0.01,
        lr_scheduler_type="linear",
        seed=3407,
        output_dir="outputs",
        report_to="none",  # For Weights and Biases
        remove_unused_columns=False,
        dataset_text_field="",
        dataset_kwargs={"skip_prepare_dataset": True},
        dataset_num_proc=4,
        max_seq_length=2048,
    ),
)Avvia il processo di training eseguendo il codice trainer.train().
trainer_stats = trainer.train()Il modello ha completato un’epoca in 16 minuti e la training loss si è ridotta gradualmente. È un buon risultato.
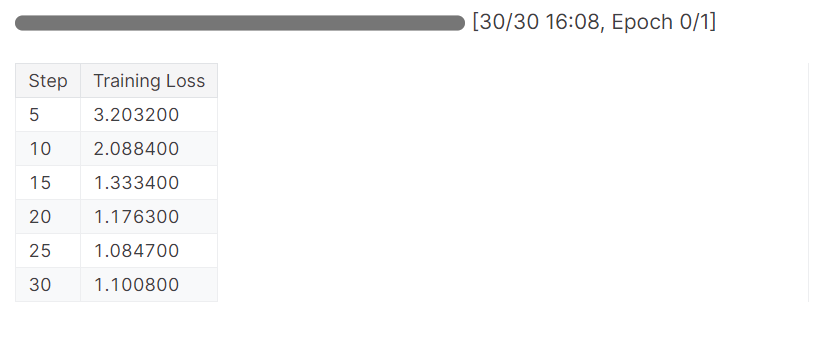
Ora testeremo il nostro modello per verificare se il fine-tuning ha avuto successo. Selezioniamo la stessa immagine di esempio dal dataset ed eseguiamo l’inferenza.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
I risultati sono ottimi ma non del tutto accurati. Gli hashtag erano superflui. Per ottenere risultati ottimali, dovremo addestrare il modello sull’intero dataset con almeno 3 epoche.
Bring the thrill of NASCAR racing to your desk or shelf with the 1/64 Die-Cast 2016 NASCAR 88 Dale Earnhardt Jr. Nationwide Chevrolet SS! Highly detailed and precision engineered, this collectible die-cast car captures the iconic look of Earnhardt's famous No. 88 ride. Perfect for kids and adults alike, this miniature masterpiece makes a great gift. #NASCAR #DieCast #CollectibleCars #DaleEarnhardtJr #Nationwide<|eot_id|>Salviamo il modello in locale e poi inviamolo all’Hugging Face Hub. Per caricare il modello sul server Hugging Face, dobbiamo effettuare il login usando il nostro token Hugging Face.
Esplora il mondo trasformativo di Hugging Face, l’hub open-source della comunità AI per il machine learning e i large language model (LLM), leggendo il blog Cos’è Hugging Face? L’oasi open-source della comunità AI.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)
Successivamente, salva in locale modello e tokenizer.
model.save_pretrained("llama_3.2_vision_amazon_product") # Local saving
tokenizer.save_pretrained("llama_3.2_vision_amazon_product")
Poi usa push_to_hub per salvare il modello sull’Hugging Face Hub.
model.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
tokenizer.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
Saved model to https://huggingface.co/kingabzpro/llama_3.2_vision_amazon_productIl comando sopra creerà il nuovo repository del modello e caricherà tutti i file su Hugging Face.
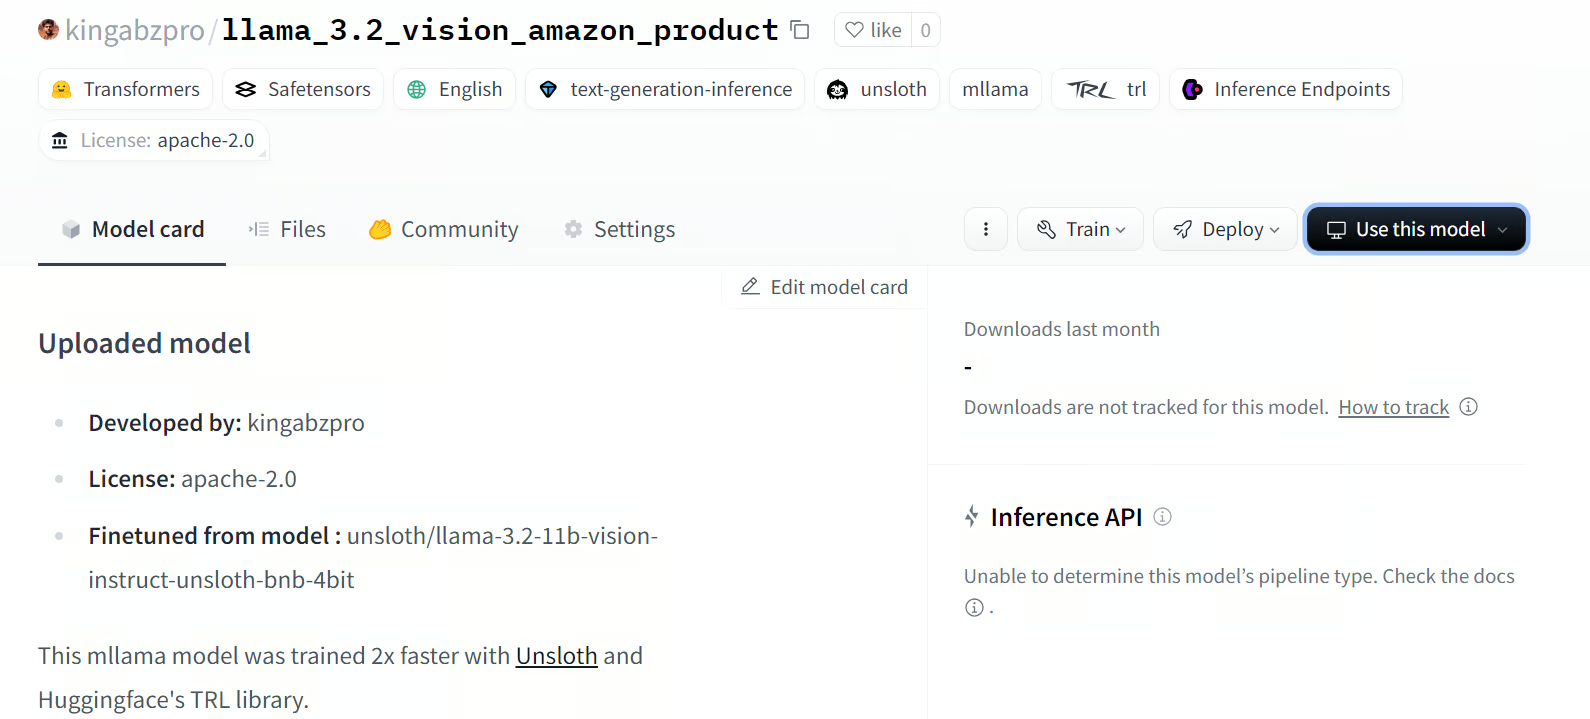
Fonte: kingabzpro/llama_3.2_vision_amazon_product
Se riscontri problemi nell’esecuzione del codice sopra, fai riferimento al notebook Kaggle: Fine-tuning di Llama 3.2 Vision sul dataset Amazon
Il fine-tuning dei modelli Llama 3.2 Vision apre un nuovo mondo di possibilità, soprattutto in scenari in cui sono necessari sia immagini sia testo per fornire risultati pertinenti e accurati. Effettuando il fine-tuning su un dataset personalizzato, possiamo migliorare le prestazioni e adattare lo stile per applicazioni come Visual Question Answering (VQA), Document VQA (DocVQA), Image Captioning e Image-Text Retrieval.
In questo tutorial approfondiamo i modelli Llama 3.2 Vision. Eseguiamo anche il fine-tuning della variante 11B del modello sul dataset delle descrizioni dei prodotti Amazon per costruire un generatore di descrizioni prodotto altamente personalizzato che adotta lo stile desiderato e fornisce descrizioni accurate dei prodotti.
Il prossimo passo del tuo percorso è imparare a creare l’applicazione AI e distribuirla sul cloud usando un’immagine Docker seguendo la guida: Come distribuire applicazioni LLM con Docker: guida passo passo.
I migliori corsi di AI
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



