
Kurs
Llama 3 ile İnce Ayar (Fine-Tuning)
2 sa
4.1K
Büyük dil modellerinin ince ayarı (LLM) üzerine pek çok rehber inceledik, ancak çok az kaynak çok modlu modellerin ince ayar sürecini ele alıyor. Bu eğitimde, Llama 3.2 Vision Model adlı en güncel çok modlu bir modeli inceleyecek ve Amazon ürün veri kümesini kullanarak nasıl ince ayar yapılacağını göstereceğiz. Amacımız, Amazon’da listelenen ürünler için doğru ve sadeleştirilmiş görsel açıklamalar üreten bir ürün açıklaması oluşturucu geliştirmek.
LLM’lerin ince ayarına yeniyseniz, yaygın metodolojileri ve terminolojileri öğrenmek için lütfen Llama 3 ile İnce Ayar kursunu alın. Ayrıca, ön uç için Streamlit, altyazı üretimi için Llama 3.2 90B ve API olarak Groq kullanarak bir görüntü altyazılama uygulamasının nasıl oluşturulacağını ele alan Llama 3.2 90B eğitimimize de göz atabilirsiniz.
Görsel: Yazar
Llama 3.2 hem görsel hem metin verisini işleyerek doğal ve doğru yanıtlar üretebilen çok modlu modeller sunar. Llama 3.2 görsel modelleri 11B ve 90B parametre varyasyonlarıyla gelir ve özellikle görüntü akıl yürütme kullanım senaryolarını dikkat çekici bir hassasiyetle ele almak üzere tasarlanmıştır. Bu modeller, yaygın endüstri kıyaslarında birçok mevcut açık kaynaklı ve kapalı çok modlu modeli geride bırakır.
Tüm model değişkenleri hakkında ayrıntılı bilgi edinmek için Llama 3.2 Rehberi: Nasıl Çalışır, Kullanım Alanları ve Daha Fazlası yazısını okuyun.
Llama 3.2 görsel modelleri; belge düzeyinde anlama, grafik ve çizelge analizi, görüntü altyazılama ve görsel dayanaklandırma (doğal dil açıklamalarıyla görüntülerdeki nesneleri tanımlama) gibi görevlerde üstündür.
Llama 3.2 Vision modeli, yalnızca metin için olan daha eski Llama 3.1 modelinin üzerine inşa edilmiştir; bu, dönüştürücü mimarisi kullanan gelişmiş bir dil modelidir. İnsanların yardımseverlik ve güvenlik tercihleriyle hizalanması için denetimli öğrenme (SFT) ve insan geri bildirimiyle pekiştirmeli öğrenme (RLHF) ile ince ayarlanmıştır.
Görüntü tanımayı kolaylaştırmak için Llama 3.2 Vision ayrı eğitilmiş bir görsel adaptör içerir. Bu adaptör, görüntü kodlayıcının çıktılarının önceden eğitilmiş Llama 3.1 dil modeline entegre edilmesi için çapraz-dikkat katmanları kullanır; böylece hem metin hem görsel tabanlı görevleri etkili biçimde ele alabilir.
Llama 3.2 Vision; görsel soru cevaplama, belge analizi, görüntü altyazılama, görüntü-metin getirimi ve görsel dayanaklandırma gibi kullanım alanlarında öne çıkar.
Bu proje için kodlama ve hesaplama ortamı olarak Kaggle’ı, ince ayar çerçevesi olarak Unsloth’u ve Amazon ürün açıklaması veri kümesini kullanacağız. Unsloth hızlıdır, daha az GPU belleği kullanır ve geleneksel yöntemlere kıyasla daha az kod satırı gerektirir.
Metin üretimi çözümü için LLM’leri ince ayarlamak istiyorsanız, sizin için mükemmel bir eğitimimiz var: Llama 3.2’nin İnce Ayarı ve Yerelde Kullanımı: Adım Adım Rehber.
Yeni bir Kaggle defteri oluşturun ve hızlandırıcıyı iki T4 GPU kullanacak şekilde ayarlayın. Hugging Face belirtecinizi Kaggle gizli anahtarı olarak ekleyin; böylece modelinizi daha sonra güvenli bir şekilde Hugging Face deposuna itebilirsiniz. Ardından, pip komutuyla unsloth Python paketini kurun.
%%capture
!pip install unsloth
Unsloth hakkında daha fazlasını Unsloth Rehberi: LLM İnce Ayarını Optimize Edin ve Hızlandırın yazısını okuyarak keşfedin.
Bu kurulumda, özellikle Unsloth tarafından sağlanan ve verimli ince ayar ile kestirim (inference) için optimize edilmiş Llama-3.2-11B-Vision-Instruct modelini yüklüyoruz. Model, bellek kullanımını ve hesaplama gereksinimlerini önemli ölçüde azaltmak için 4 bit niceleme ile yüklenir; bu da büyük görsel modelleri T4 GPU’larda çalıştırmayı mümkün kılar.
from unsloth import FastVisionModel
import torch

model, tokenizer = FastVisionModel.from_pretrained(
    "unsloth/Llama-3.2-11B-Vision-Instruct",
    load_in_4bit = True,
    use_gradient_checkpointing = "unsloth",
)LoRA (Düşük Rütbeli Uyarlama), öğrenilebilir düşük rütbeli matrisleri modelin belirli bölümlerine ekleyerek büyük önceden eğitilmiş modelleri verimli şekilde ince ayar yapma tekniğidir. Bu yaklaşım hafiftir, hesaplama açısından verimlidir ve önceden eğitilmiş modelin çekirdek yapısını değiştirmeden göreve özel ince ayara olanak tanır.
LoRA ile bir modeli eğitmek için; görsel katmanlar, dil katmanları, dikkat modülleri ve MLP modülleri gibi belirli bileşenleri seçip ince ayarlamaya odaklanırız. Bu, özgün mimaride en az değişiklikle modeli belirli görevlere uyarlamamızı sağlar.
model = FastVisionModel.get_peft_model(
    model,
    finetune_vision_layers     = True,
    finetune_language_layers   = True,
    finetune_attention_modules = True,
    finetune_mlp_modules       = True,
    r = 16,
    lora_alpha = 16,
    lora_dropout = 0,
    bias = "none",
    random_state = 3443,
    use_rslora = False,
    loftq_config = None,
)Hugging Face Hub’dan philschmid/amazon-product-descriptions-vlm veri kümesini yükleyin ve yalnızca ilk 500 örneği seçin. Veri kümesi, gerekli diğer bilgilerin yanı sıra ürün görselleri ve ürün açıklamaları içerir.
from datasets import load_dataset
dataset = load_dataset("philschmid/amazon-product-descriptions-vlm",
                       split = "train[0:500]")


dataset
Dataset({
features: ['image', 'Uniq Id', 'Product Name', 'Category', 'Selling Price', 'Model Number', 'About Product', 'Product Specification', 'Technical Details', 'Shipping Weight', 'Variants', 'Product Url', 'Is Amazon Seller', 'description'],
num_rows: 500
})Bu, ürün görsellerinden biridir.
dataset[45]["image"]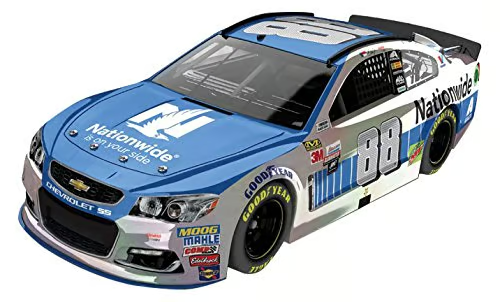
İşte açıklaması.
dataset[45]["description"]'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'Şimdi yalnızca metin ve görselleri içeren veri kümesini işleyeceğiz. İstem şablonları kullanıcı soruları, görseller ve ürün açıklamalarını içerir.
instruction = """
You are an expert Amazon worker who is good at writing product descriptions.
Write the product description accurately by looking at the image.
"""


def convert_to_conversation(sample):
    conversation = [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": instruction},
                {"type": "image", "image": sample["image"]},
            ],
        },
        {
            "role": "assistant",
            "content": [{"type": "text", "text": sample["description"]}],
        },
    ]
    return {"messages": conversation}


pass


converted_dataset = [convert_to_conversation(sample) for sample in dataset]
Yeni veri kümesi tabular değil; bunun yerine OpenAI’nin biçimine benzer bir istem stilini izler.
converted_dataset[45]{'messages': [{'role': 'user',
'content': [{'type': 'text',
'text': '\nYou are an expert Amazon worker who is good at writing product descriptions. \nWrite the product description accurately by looking at the image.\n'},
{'type': 'image',
'image': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=500x302>}]},
{'role': 'assistant',
'content': [{'type': 'text',
'text': 'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'}]}]}Veri kümesinden 46. örneği seçecek ve ince ayar yapmadan, modelin kutudan çıktığı haliyle ürün açıklamasını ne kadar iyi yazdığını görmek için kestirim çalıştıracağız.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
Üretilen açıklama uzun ve hatalı. Yazı stili de farklı.
The image showcases a race car featuring the well-known sponsorship branding "Nationwide," likely the primary vehicle in the Nationwide Series. The vehicle has a blue hood with the "Nationwide" logo prominently displayed and white text that reads, "on your side," on the windscreen. The car is predominantly white and grey, adorned with sponsor decals on various parts of the vehicle.

The front grille showcases the Chevrolet "Bowtie" logo, and the car is equipped with Chevrolet emblems and other sponsor decals, including:

• A white 88 logo on the front windscreen

Notably, the vehicle's wheels are equipped with "GoodYearŞimdi modeli eğitime ayarlayacak ve özel bir veri birleştirici, veri kümesi ve verimli ince ayar için optimize edilmiş eğitim yapılandırmasıyla bir görsel modeli eğitime hazırlamak üzere denetimli ince ayar (SFT) eğiticisini başlatacağız.
from unsloth import is_bf16_supported
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig

FastVisionModel.for_training(model)  # Enable for training!

trainer = SFTTrainer(
    model=model,
    tokenizer=tokenizer,
    data_collator=UnslothVisionDataCollator(model, tokenizer),  # Must use!
    train_dataset=converted_dataset,
    args=SFTConfig(
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        warmup_steps=5,
        max_steps=30,
        learning_rate=2e-4,
        fp16=not is_bf16_supported(),
        bf16=is_bf16_supported(),
        logging_steps=5,
        optim="adamw_8bit",
        weight_decay=0.01,
        lr_scheduler_type="linear",
        seed=3407,
        output_dir="outputs",
        report_to="none",  # For Weights and Biases
        remove_unused_columns=False,
        dataset_text_field="",
        dataset_kwargs={"skip_prepare_dataset": True},
        dataset_num_proc=4,
        max_seq_length=2048,
    ),
)Eğitim sürecini trainer.train() kodunu çalıştırarak başlatın.
trainer_stats = trainer.train()Model 16 dakikada bir dönemi (epoch) tamamladı ve eğitim kaybı kademeli olarak azaldı. Bu iyi bir sonuç.
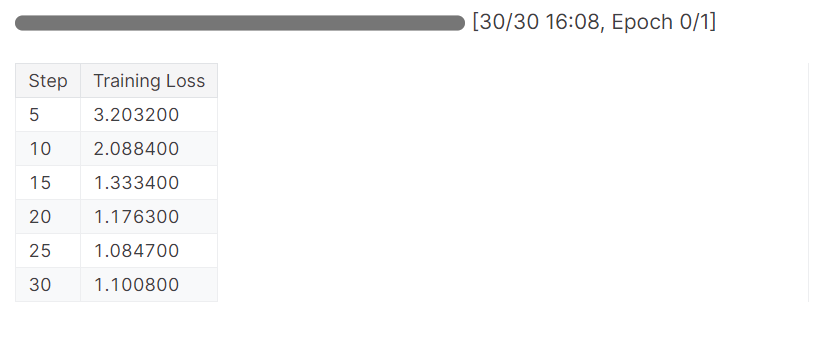
Şimdi modelimizi test ederek ince ayarın başarılı olup olmadığını kontrol edeceğiz. Veri kümesinden aynı örnek görseli seçecek ve üzerinde kestirim çalıştıracağız.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
Sonuçlar iyi ancak tamamen doğru değil. Hashtagler gereksizdi. En iyi sonuçlar için modeli tüm veri kümesi üzerinde en az 3 dönem (epoch) eğitmemiz gerekecek.
Bring the thrill of NASCAR racing to your desk or shelf with the 1/64 Die-Cast 2016 NASCAR 88 Dale Earnhardt Jr. Nationwide Chevrolet SS! Highly detailed and precision engineered, this collectible die-cast car captures the iconic look of Earnhardt's famous No. 88 ride. Perfect for kids and adults alike, this miniature masterpiece makes a great gift. #NASCAR #DieCast #CollectibleCars #DaleEarnhardtJr #Nationwide<|eot_id|>Modeli yerel olarak kaydedelim ve ardından Hugging Face Hub’a itelim. Modeli Hugging Face sunucusuna yüklemek için Hugging Face belirteciyle oturum açmamız gerekir.
Makine öğrenimi ve büyük dil modelleri (LLM) için yapay zekâ topluluğunun açık kaynak merkezi olan Hugging Face’in dönüştürücü dünyasını, Hugging Face Nedir? Yapay Zekâ Topluluğunun Açık Kaynak Vahası başlıklı blogu okuyarak keşfedin.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)
Bundan sonra, modeli ve belirteçleyiciyi yerelde kaydedin.
model.save_pretrained("llama_3.2_vision_amazon_product") # Local saving
tokenizer.save_pretrained("llama_3.2_vision_amazon_product")
Ardından modeli Hugging Face hub’da kaydetmek için push_to_hub kullanın.
model.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
tokenizer.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
Saved model to https://huggingface.co/kingabzpro/llama_3.2_vision_amazon_productYukarıdaki komut yeni model deposunu oluşturacak ve tüm dosyaları Hugging Face’e itecek.
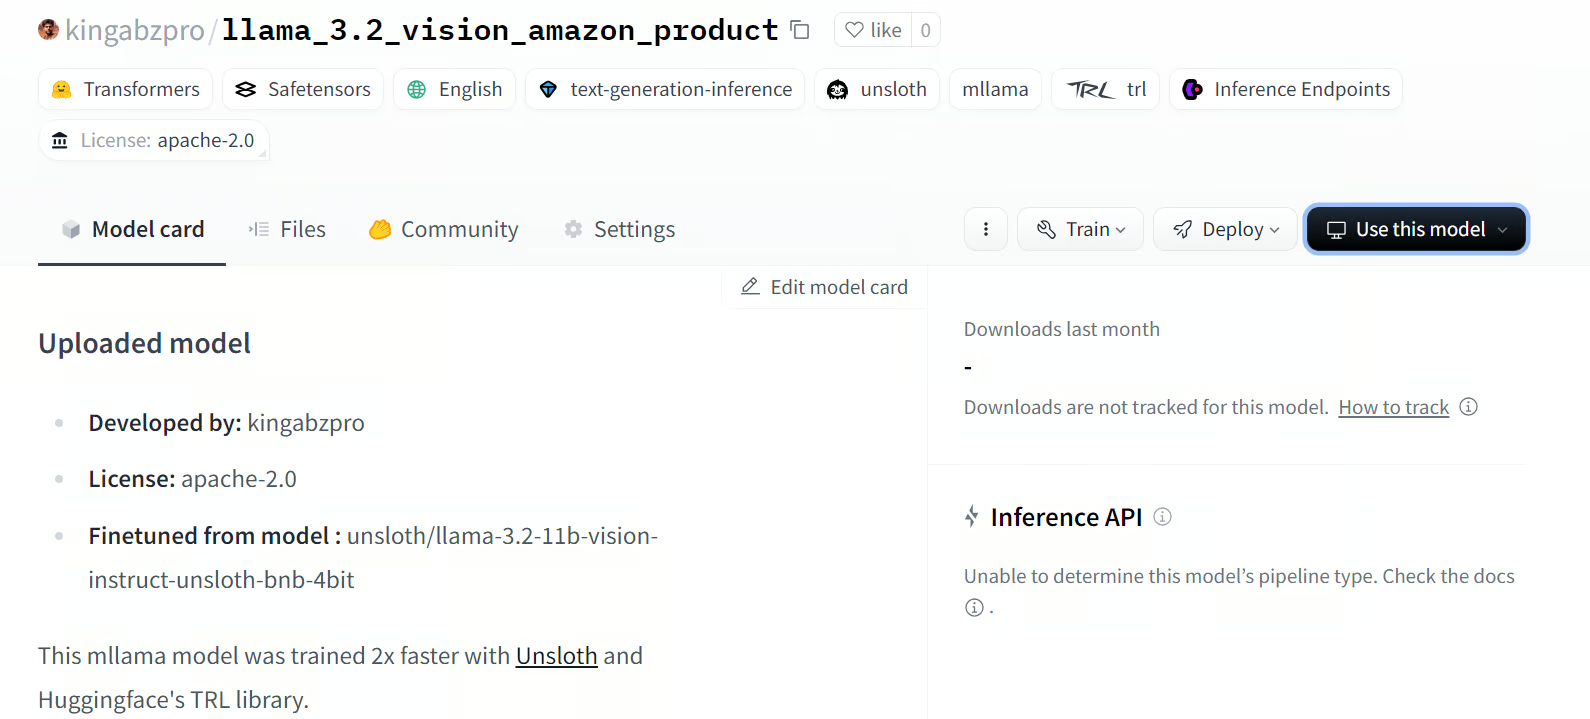
Kaynak: kingabzpro/llama_3.2_vision_amazon_product
Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız, lütfen şu Kaggle defterine bakın: Amazon Veri Kümesi Üzerinde Llama 3.2 Vision’ı İnce Ayarlama
Llama 3.2 Vision modellerinin ince ayarı, özellikle hem görsellerin hem metnin gerekli olduğu senaryolarda, alakalı ve doğru sonuçlar sunmak için yeni olanaklar açar. Özel bir veri kümesi üzerinde ince ayar yaparak performansı artırabilir ve VQA, DocVQA, Görüntü Altyazılama ve Görüntü-Metin Getirimi gibi uygulamalara uygun bir stil uyarlayabiliriz.
Bu eğitimde, Llama 3.2 Vision modellerini derinlemesine inceliyoruz. Ayrıca modelin 11B varyantını Amazon ürün açıklamaları veri kümesi üzerinde ince ayarlayarak, istenen stili benimseyen ve ürünlerin doğru açıklamalarını sağlayan, yüksek düzeyde özelleştirilmiş bir ürün açıklaması oluşturucu oluşturuyoruz.
Yolculuğunuzdaki bir sonraki adım, şu rehberi izleyerek bir yapay zekâ uygulamasını nasıl oluşturacağınızı ve bir Docker imajı kullanarak buluta nasıl dağıtacağınızı öğrenmektir: Docker Kullanarak LLM Uygulamalarını Dağıtma: Adım Adım Rehber.
En İyi Yapay Zekâ Kursları
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




