
Khóa học
Fine-Tuning với Llama 3
2 giờ
4.1K
Chúng tôi đã khám phá nhiều hướng dẫn về tinh chỉnh các mô hình ngôn ngữ lớn (LLM), nhưng có rất ít tài liệu đề cập đến quy trình tinh chỉnh các mô hình đa phương thức. Trong hướng dẫn này, chúng ta sẽ tìm hiểu một mô hình đa phương thức tiên tiến có tên Llama 3.2 Vision và trình diễn cách tinh chỉnh nó bằng bộ dữ liệu sản phẩm Amazon. Mục tiêu của chúng ta là xây dựng một trình tạo mô tả sản phẩm đưa ra chú thích hình ảnh chính xác và đơn giản cho các sản phẩm được liệt kê trên Amazon.
Nếu bạn mới bắt đầu tinh chỉnh LLM, vui lòng học khóa Fine-tuning with Llama 3 để làm quen với các phương pháp và thuật ngữ phổ biến. Bạn cũng có thể xem hướng dẫn Llama 3.2 90B của chúng tôi, trong đó hướng dẫn cách xây dựng ứng dụng tạo chú thích hình ảnh bằng Streamlit cho giao diện, Llama 3.2 90B để tạo chú thích và Groq làm API.
Hình do Tác giả cung cấp
Llama 3.2 giới thiệu các mô hình đa phương thức có thể xử lý cả dữ liệu hình ảnh và văn bản để tạo ra phản hồi tự nhiên và chính xác. Các mô hình thị giác Llama 3.2 có các phiên bản 11B và 90B tham số, được thiết kế riêng để xử lý các bài toán suy luận trên hình ảnh với độ chính xác ấn tượng. Những mô hình này vượt trội hơn nhiều mô hình đa phương thức nguồn mở và đóng khác trên các thang đo chuẩn trong ngành.
Đọc Hướng dẫn Llama 3.2: Cách hoạt động, trường hợp sử dụng và hơn thế nữa để tìm hiểu chi tiết về tất cả các biến số của mô hình.
Các mô hình thị giác Llama 3.2 xuất sắc trong các nhiệm vụ như hiểu tài liệu ở cấp độ toàn văn bản, phân tích biểu đồ và đồ thị, tạo chú thích hình ảnh và định vị trực quan, nơi mô tả ngôn ngữ tự nhiên được dùng để xác định đối tượng trong ảnh.
Llama 3.2 Vision được xây dựng dựa trên Llama 3.1 (chỉ văn bản), là một mô hình ngôn ngữ tiên tiến dùng kiến trúc transformer. Mô hình được tinh chỉnh bằng học có giám sát (SFT) và học tăng cường với phản hồi của con người (RLHF) để phù hợp với sở thích của con người về tính hữu ích và an toàn.
Để hỗ trợ nhận dạng hình ảnh, Llama 3.2 Vision tích hợp một bộ chuyển tiếp thị giác (vision adapter) được huấn luyện riêng. Bộ chuyển tiếp này dùng các lớp cross-attention để tích hợp đầu ra của bộ mã hóa hình ảnh vào mô hình ngôn ngữ Llama 3.1 đã được huấn luyện sẵn, cho phép mô hình xử lý hiệu quả cả các tác vụ dựa trên văn bản và hình ảnh.
Llama 3.2 Vision vượt trội trong các trường hợp như hỏi đáp dựa trên hình ảnh, phân tích tài liệu, tạo chú thích hình ảnh, truy hồi ảnh-văn bản và định vị trực quan.
Trong dự án này, chúng ta sẽ dùng Kaggle làm môi trường mã hóa và tính toán, Unsloth làm framework tinh chỉnh, và bộ dữ liệu mô tả sản phẩm Amazon. Unsloth nhanh, tiêu thụ ít bộ nhớ GPU và yêu cầu ít dòng mã hơn so với các phương pháp truyền thống.
Nếu bạn muốn tinh chỉnh LLM cho bài toán sinh văn bản, chúng tôi có hướng dẫn hoàn hảo dành cho bạn: Fine-tuning Llama 3.2 và chạy cục bộ: Hướng dẫn từng bước.
Tạo một notebook Kaggle mới và đặt bộ tăng tốc để dùng hai GPU T4. Thêm token Hugging Face của bạn làm bí mật trong Kaggle để sau này có thể đẩy mô hình lên kho Hugging Face một cách an toàn. Sau đó cài đặt gói Python unsloth bằng lệnh pip.
%%capture
!pip install unsloth
Tìm hiểu thêm về Unsloth bằng cách đọc Hướng dẫn Unsloth: Tối ưu và tăng tốc tinh chỉnh LLM.
Trong thiết lập này, chúng ta tải mô hình Llama-3.2-11B-Vision-Instruct, cụ thể là phiên bản do Unsloth cung cấp, được tối ưu cho tinh chỉnh và suy luận hiệu quả. Mô hình được tải ở dạng lượng tử hóa 4-bit để giảm đáng kể việc sử dụng bộ nhớ và yêu cầu tính toán, cho phép chạy các mô hình thị giác lớn trên GPU T4.
from unsloth import FastVisionModel
import torch

model, tokenizer = FastVisionModel.from_pretrained(
    "unsloth/Llama-3.2-11B-Vision-Instruct",
    load_in_4bit = True,
    use_gradient_checkpointing = "unsloth",
)LoRA (Low-Rank Adaptation) là kỹ thuật tinh chỉnh hiệu quả các mô hình tiền huấn luyện lớn bằng cách đưa các ma trận hạng thấp có thể học được vào những phần cụ thể của mô hình. Cách tiếp cận này nhẹ, hiệu quả tính toán và cho phép tinh chỉnh theo nhiệm vụ mà không sửa đổi cấu trúc cốt lõi của mô hình tiền huấn luyện.
Để huấn luyện mô hình bằng LoRA, chúng ta tập trung chọn và tinh chỉnh các thành phần cụ thể, như các lớp thị giác, lớp ngôn ngữ, mô-đun attention và mô-đun MLP. Cách này giúp điều chỉnh mô hình cho các tác vụ cụ thể với thay đổi tối thiểu đối với kiến trúc gốc.
model = FastVisionModel.get_peft_model(
    model,
    finetune_vision_layers     = True,
    finetune_language_layers   = True,
    finetune_attention_modules = True,
    finetune_mlp_modules       = True,
    r = 16,
    lora_alpha = 16,
    lora_dropout = 0,
    bias = "none",
    random_state = 3443,
    use_rslora = False,
    loftq_config = None,
)Tải bộ dữ liệu philschmid/amazon-product-descriptions-vlm từ Hugging Face Hub và chỉ chọn 500 mẫu đầu tiên. Bộ dữ liệu chứa hình ảnh sản phẩm và mô tả sản phẩm cùng các thông tin cần thiết khác.
from datasets import load_dataset
dataset = load_dataset("philschmid/amazon-product-descriptions-vlm",
                       split = "train[0:500]")


dataset
Dataset({
features: ['image', 'Uniq Id', 'Product Name', 'Category', 'Selling Price', 'Model Number', 'About Product', 'Product Specification', 'Technical Details', 'Shipping Weight', 'Variants', 'Product Url', 'Is Amazon Seller', 'description'],
num_rows: 500
})Đây là một trong các hình ảnh của sản phẩm.
dataset[45]["image"]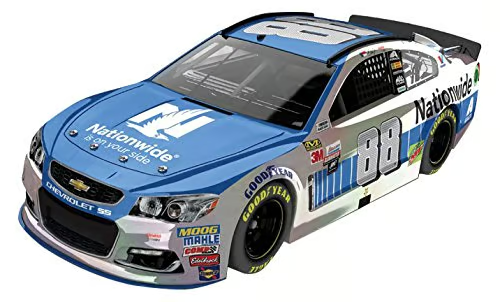
Và đây là mô tả của nó.
dataset[45]["description"]'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'Giờ chúng ta sẽ xử lý bộ dữ liệu chỉ chứa văn bản và hình ảnh. Các mẫu prompt bao gồm câu hỏi của người dùng, hình ảnh và mô tả sản phẩm.
instruction = """
You are an expert Amazon worker who is good at writing product descriptions.
Write the product description accurately by looking at the image.
"""


def convert_to_conversation(sample):
    conversation = [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": instruction},
                {"type": "image", "image": sample["image"]},
            ],
        },
        {
            "role": "assistant",
            "content": [{"type": "text", "text": sample["description"]}],
        },
    ]
    return {"messages": conversation}


pass


converted_dataset = [convert_to_conversation(sample) for sample in dataset]
Bộ dữ liệu mới không còn dạng bảng; thay vào đó, nó theo phong cách prompt tương tự định dạng của OpenAI.
converted_dataset[45]{'messages': [{'role': 'user',
'content': [{'type': 'text',
'text': '\nYou are an expert Amazon worker who is good at writing product descriptions. \nWrite the product description accurately by looking at the image.\n'},
{'type': 'image',
'image': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=500x302>}]},
{'role': 'assistant',
'content': [{'type': 'text',
'text': 'Authentic Dale Earnhardt Jr. 1:24 scale diecast car. Nationwide Raw Finish. Collectible model car for racing fans. Perfect gift for NASCAR enthusiasts.'}]}]}Chúng ta sẽ chọn mẫu thứ 46 trong bộ dữ liệu và chạy suy luận để đánh giá khả năng viết mô tả sản phẩm của mô hình khi chưa tinh chỉnh.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
Mô tả được tạo ra dài và thiếu chính xác. Ngay cả phong cách viết cũng khác biệt.
The image showcases a race car featuring the well-known sponsorship branding "Nationwide," likely the primary vehicle in the Nationwide Series. The vehicle has a blue hood with the "Nationwide" logo prominently displayed and white text that reads, "on your side," on the windscreen. The car is predominantly white and grey, adorned with sponsor decals on various parts of the vehicle.

The front grille showcases the Chevrolet "Bowtie" logo, and the car is equipped with Chevrolet emblems and other sponsor decals, including:

• A white 88 logo on the front windscreen

Notably, the vehicle's wheels are equipped with "GoodYearGiờ chúng ta sẽ chuyển mô hình sang chế độ huấn luyện và khởi tạo một trình huấn luyện SFT (supervised fine-tuning) để chuẩn bị mô hình thị giác cho việc huấn luyện với bộ gom dữ liệu tùy chỉnh, bộ dữ liệu và cấu hình huấn luyện tối ưu cho tinh chỉnh hiệu quả.
from unsloth import is_bf16_supported
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig

FastVisionModel.for_training(model)  # Enable for training!

trainer = SFTTrainer(
    model=model,
    tokenizer=tokenizer,
    data_collator=UnslothVisionDataCollator(model, tokenizer),  # Must use!
    train_dataset=converted_dataset,
    args=SFTConfig(
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        warmup_steps=5,
        max_steps=30,
        learning_rate=2e-4,
        fp16=not is_bf16_supported(),
        bf16=is_bf16_supported(),
        logging_steps=5,
        optim="adamw_8bit",
        weight_decay=0.01,
        lr_scheduler_type="linear",
        seed=3407,
        output_dir="outputs",
        report_to="none",  # For Weights and Biases
        remove_unused_columns=False,
        dataset_text_field="",
        dataset_kwargs={"skip_prepare_dataset": True},
        dataset_num_proc=4,
        max_seq_length=2048,
    ),
)Bắt đầu quá trình huấn luyện bằng cách chạy trainer.train().
trainer_stats = trainer.train()Mô hình đã hoàn thành một epoch trong 16 phút và loss huấn luyện giảm dần. Đây là kết quả tốt.
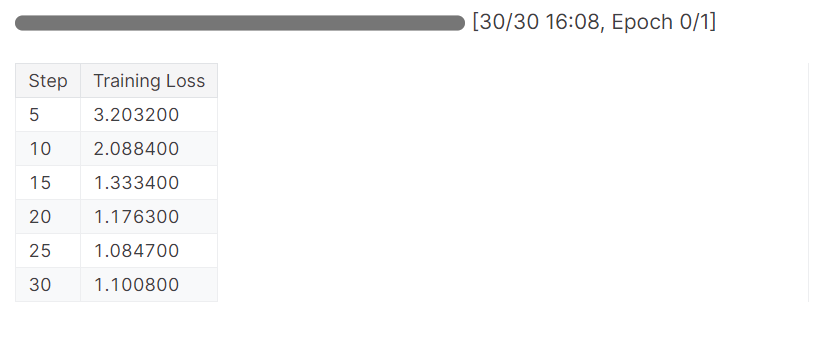
Giờ chúng ta sẽ kiểm tra mô hình để xem việc tinh chỉnh có thành công hay không. Chúng ta sẽ chọn lại cùng một ảnh mẫu trong bộ dữ liệu và chạy suy luận trên đó.
FastVisionModel.for_inference(model)  # Enable for inference!

image = dataset[45]["image"]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": instruction},
        ],
    }
]
input_text = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True
)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens=False,
    return_tensors="pt",
).to("cuda")

from transformers import TextStreamer

text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(
    **inputs,
    streamer=text_streamer,
    max_new_tokens=128,
    use_cache=True,
    temperature=1.5,
    min_p=0.1
)
Kết quả khá tốt nhưng chưa hoàn toàn chính xác. Các hashtag là không cần thiết. Để đạt kết quả tối ưu, chúng ta cần huấn luyện mô hình trên toàn bộ bộ dữ liệu với ít nhất 3 epoch.
Bring the thrill of NASCAR racing to your desk or shelf with the 1/64 Die-Cast 2016 NASCAR 88 Dale Earnhardt Jr. Nationwide Chevrolet SS! Highly detailed and precision engineered, this collectible die-cast car captures the iconic look of Earnhardt's famous No. 88 ride. Perfect for kids and adults alike, this miniature masterpiece makes a great gift. #NASCAR #DieCast #CollectibleCars #DaleEarnhardtJr #Nationwide<|eot_id|>Hãy lưu mô hình cục bộ rồi đẩy lên Hugging Face Hub. Để tải mô hình lên máy chủ Hugging Face, chúng ta cần đăng nhập bằng token Hugging Face.
Khám phá thế giới chuyển đổi của Hugging Face, ốc đảo nguồn mở của cộng đồng AI dành cho machine learning và các mô hình ngôn ngữ lớn (LLM), bằng cách đọc bài blog What is Hugging Face? The AI Community's Open-Source Oasis.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)
Sau đó, lưu mô hình và tokenizer cục bộ.
model.save_pretrained("llama_3.2_vision_amazon_product") # Local saving
tokenizer.save_pretrained("llama_3.2_vision_amazon_product")
Tiếp theo dùng push_to_hub để lưu mô hình lên Hugging Face hub.
model.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
tokenizer.push_to_hub(
    "kingabzpro/llama_3.2_vision_amazon_product"
)  # Online saving
Saved model to https://huggingface.co/kingabzpro/llama_3.2_vision_amazon_productLệnh trên sẽ tạo kho mô hình mới và đẩy tất cả tệp lên Hugging Face.
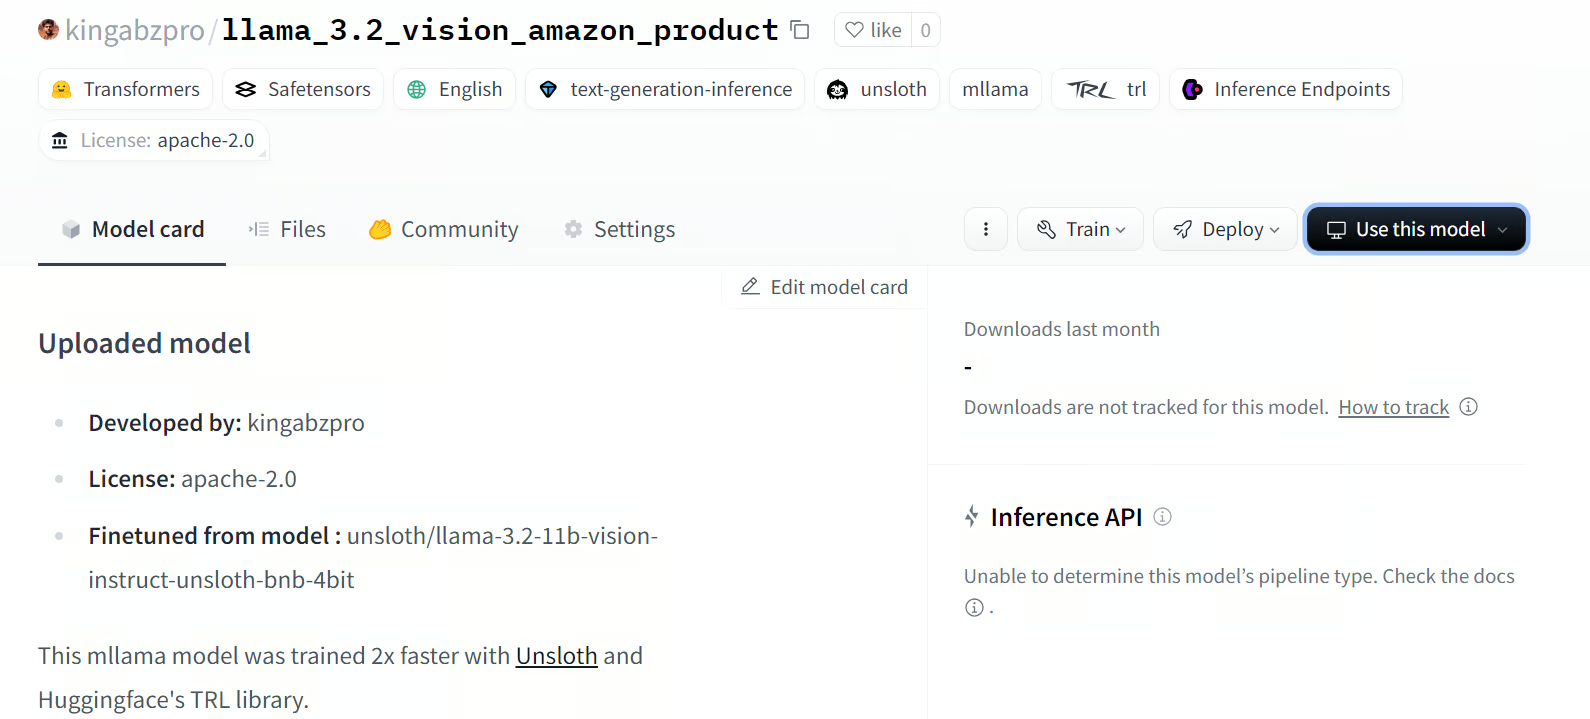
Nguồn: kingabzpro/llama_3.2_vision_amazon_product
Nếu bạn gặp vấn đề khi chạy mã trên, hãy tham khảo notebook Kaggle: Fine-tuning Llama 3.2 Vision on Amazon Dataset
Tinh chỉnh các mô hình Llama 3.2 Vision mở ra một thế giới khả năng mới, đặc biệt trong các tình huống cần cả hình ảnh và văn bản để mang lại kết quả phù hợp và chính xác. Bằng cách tinh chỉnh trên bộ dữ liệu tùy chỉnh, chúng ta có thể nâng cao hiệu năng và điều chỉnh phong cách cho các ứng dụng như Hỏi đáp thị giác (VQA), DocVQA, Tạo chú thích ảnh và Truy hồi ảnh-văn bản.
Trong hướng dẫn này, chúng ta đi sâu vào tìm hiểu các mô hình Llama 3.2 Vision. Chúng ta cũng tinh chỉnh biến thể 11B của mô hình trên bộ dữ liệu mô tả sản phẩm Amazon để xây dựng một trình tạo mô tả sản phẩm tùy biến cao, áp dụng phong cách mong muốn và cung cấp mô tả chính xác về sản phẩm.
Bước tiếp theo trong hành trình của bạn là học cách xây dựng ứng dụng AI và triển khai nó lên đám mây bằng Docker image theo hướng dẫn: Cách triển khai ứng dụng LLM bằng Docker: Hướng dẫn từng bước.
Top AI Courses
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
