

Cursus
Inleiding tot statistiek
4 uur
163.9K
Oefen en volg je voortgang.
Ga Verder Met GoogleDe tools van data-analyse beheersen zonder de achterliggende concepten te begrijpen is alsof je een gereedschapskist vol schroevendraaiers hebt, maar niet weet wanneer en hoe je elke schroevendraaier gebruikt. Statistiek is belangrijk om te leren, omdat de opkomst van door AI gegenereerde en door AI ondersteunde analysetools technische vaardigheden minder onderscheidend zal maken ten gunste van begripskennis en kritisch inzicht.
Laat je niet afschrikken door de complexiteit van statistiek. Dit artikel wil een uitgebreide gids bieden voor de meest relevante statistische concepten voor data-analisten en data scientists aan de hand van 35 statistiek-sollicitatievragen en -antwoorden. Of je je nu voorbereidt op een gesprek of niet, ik weet zeker dat je deze vragen informatief zult vinden.
Tot slot, voordat we beginnen: overweeg onze cursus Introduction to Statistics in R te volgen om de basis te leren, inclusief hoe je statistische analyses uitvoert en resultaten interpreteert. En als je je actief voorbereidt op een gesprek waarbij statistisch inzicht vereist is, behandelen de volgende twee DataCamp-cursussen alle meest voorkomende statistische onderwerpen: Practicing Statistics Interview Questions in Python en Practicing Statistics Interview Questions in R.
De meeste, zo niet alle, data-analytische functies vereisen een basisbegrip van statistiek, waaronder beschrijvende statistiek, inferentiële statistiek en kansrekening. Als je je beschrijvende statistiek wilt opfrissen voor een gesprek, download dan onze Descriptive Statistics Cheat Sheet voor snelle referentie. En als je wat berekeningen en methoden wilt doornemen, bekijk dan de volgende DataCamp-tutorials om relevante concepten in meer detail te verkennen:
Varianties en standaarddeviatie meten allebei de spreiding van een dataset. Variantie is het gemiddelde van de gekwadrateerde afwijkingen ten opzichte van het gemiddelde. Het geeft een idee van hoezeer de waarden in een dataset afwijken van het gemiddelde. Omdat het echter met gekwadrateerde afwijkingen werkt, zijn de eenheden ook gekwadrateerd, wat minder intuïtief kan zijn dan de standaarddeviatie. Standaarddeviatie is de vierkantswortel van de variantie, waardoor de eenheden weer overeenkomen met de oorspronkelijke data. Het biedt een beter interpreteerbare maat voor spreiding. Als de variantie van een dataset bijvoorbeeld 25 is, is de standaarddeviatie √25 = 5.
Scheefheid meet de asymmetrie van een dataset rond het gemiddelde; die kan positief, negatief of nul zijn. Data met positieve scheefheid, of rechts-scheve data, heeft een langere rechterstaart, wat betekent dat het gemiddelde groter is dan de mediaan. Data met negatieve scheefheid, of links-scheve data, heeft een langere linkerstaart, wat betekent dat het gemiddelde kleiner is dan de mediaan. Nul scheefheid duidt op een symmetrische verdeling, zoals een normale verdeling, waar gemiddelde, mediaan en modus gelijk zijn.
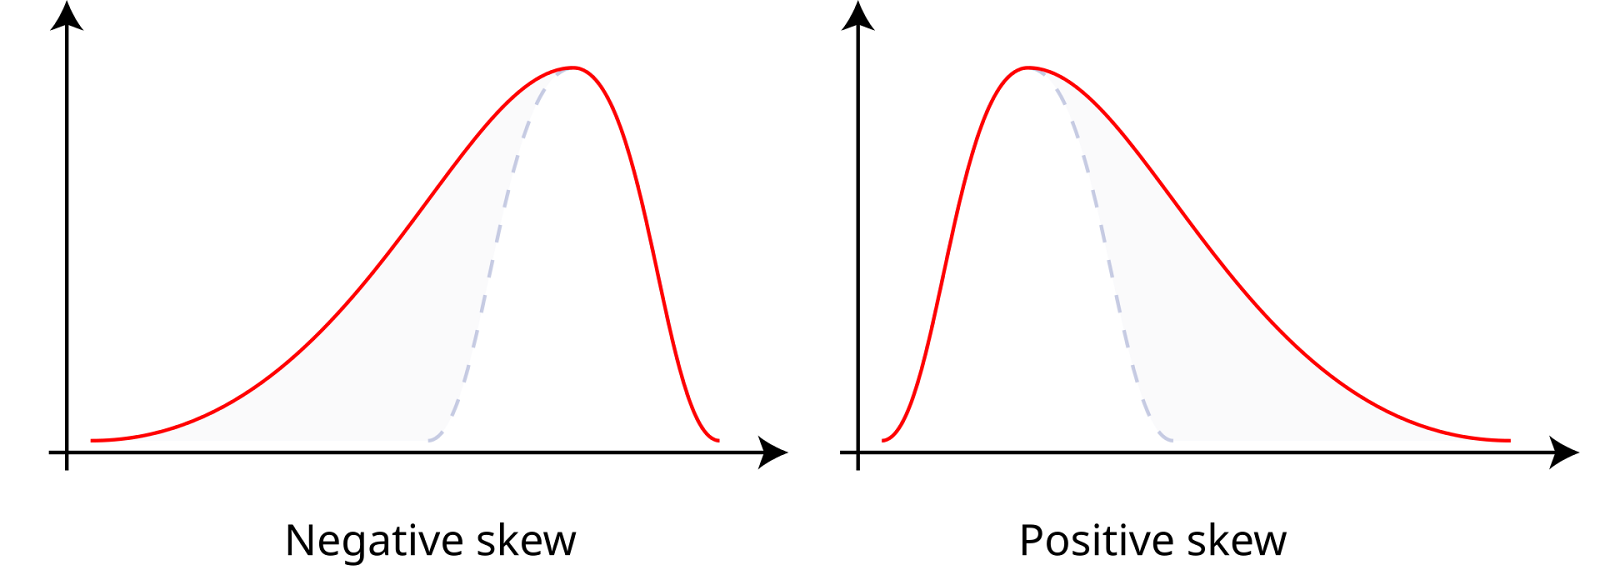
Positieve en negatieve scheefheid. Bron: Wikiversity.
Een histogram is een grafische weergave van de verdeling van een dataset. Het verdeelt de data in klassen (intervallen) en toont de frequentie (of telling) van datapunten binnen elke klasse. Histogrammen worden gebruikt om de onderliggende frequentieverdeling (vorm) van een set continue data te begrijpen. Ze helpen patronen te identificeren zoals scheefheid, modaliteit (aantal pieken) en de aanwezigheid van uitschieters.
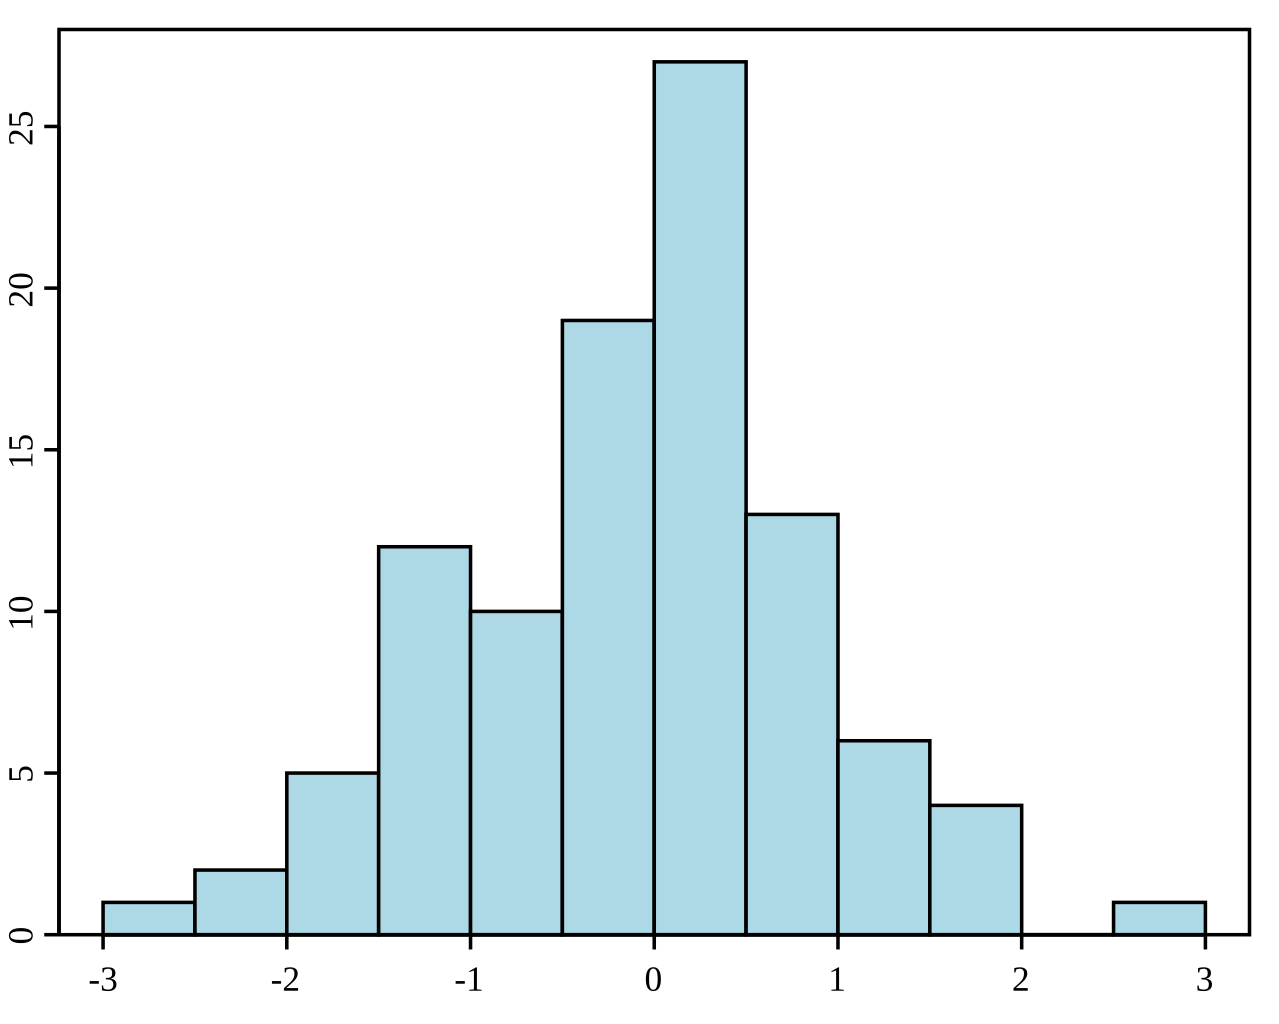
Voorbeeld van een histogram. Bron: Wikipedia.
Inferentiële statistiek houdt in dat je voorspellingen of gevolgtrekkingen doet over een populatie op basis van een willekeurige steekproef uit die populatie. Het gebruikt verschillende methoden om populatieparameters te schatten, hypothesen te toetsen en voorspellingen te doen. Waar beschrijvende statistiek de kenmerken van een dataset samenvat en beschrijft, gebruikt inferentiële statistiek de data om generalisaties te maken en conclusies te trekken over een grotere populatie.
Verschillende steekproefmethoden worden gebruikt om ervoor te zorgen dat steekproeven representatief en willekeurig zijn. Bij een eenvoudige aselecte steekproef heeft elk populatielid evenveel kans om geselecteerd te worden. Systematische steekproeven houden in dat je elk k-de populatielid selecteert, beginnend vanaf een willekeurig gekozen startpunt. Gestratificeerde steekproeven verdelen de populatie in strata of subgroepen, waarbij uit elk stratum willekeurige steekproeven worden genomen. Clustersteekproeven verdelen de populatie in clusters, selecteren willekeurig enkele clusters en nemen vervolgens alle leden binnen die clusters op.
De centrale limietstelling stelt dat de steekproevenverdeling van het steekproefgemiddelde naar een normale verdeling nadert naarmate de steekproefgrootte toeneemt, ongeacht de verdeling van de populatie, mits de steekproeven onafhankelijk en identiek verdeeld zijn.
Marginale kans is de kans op het optreden van één enkele gebeurtenis, ongeacht andere gebeurtenissen, genoteerd als P(A) voor gebeurtenis A. Gezamenlijke kans is de kans dat twee gebeurtenissen samen optreden, weergegeven als P(A∩B) voor gebeurtenissen A en B. Voorwaardelijke kans is de kans dat een gebeurtenis optreedt gegeven dat een andere gebeurtenis is opgetreden, uitgedrukt als P(A|B) voor gebeurtenissen A en B.
Een kansverdeling beschrijft hoe de waarden van een toevalsvariabele verdeeld zijn. Ze biedt een functie die de uitkomsten van een toevalsvariabele koppelt aan hun bijbehorende kansen. Er zijn twee hoofdtypen kansverdelingen. De discrete kansverdeling voor discrete toevalsvariabelen, zoals de binomiale verdeling of de Poissonverdeling. En de continue kansverdeling voor continue toevalsvariabelen, zoals de normale verdeling of de exponentiële verdeling.
De normale verdeling, ook wel de Gaussische verdeling, is een continue kansverdeling die wordt gekenmerkt door haar klokvormige curve, symmetrisch rond het gemiddelde. Bij normale verdelingen is het gemiddelde daarom gelijk aan de mediaan. Ook is bekend dat ongeveer 68% van de data binnen één standaarddeviatie van het gemiddelde valt, 95% binnen twee en 99,7% binnen drie standaarddeviaties. Dit staat bekend als de 68-95-99,7-regel.
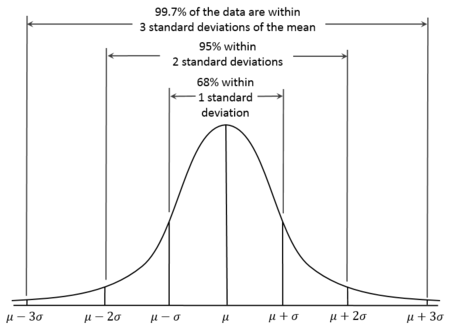
Curve van de normale verdeling. Bron: Wikiversity.
De binomiale verdeling is een discrete kansverdeling die het aantal successen modelleert in een vast aantal onafhankelijke Bernoulli-proeven, elk met dezelfde kans op succes. Ze wordt gebruikt wanneer er precies twee mogelijke uitkomsten zijn (succes en mislukking) per proef. Zo kun je bijvoorbeeld het aantal koppen in een reeks muntworpen modelleren.
De Poissonverdeling is een discrete kansverdeling die het aantal gebeurtenissen modelleert binnen een vast tijd- of ruimte-interval, waarbij de gebeurtenissen onafhankelijk en met een constante gemiddelde snelheid optreden. Ze is geschikt wanneer je het aantal zeldzame gebeurtenissen wilt modelleren, zoals het aantal e-mails per uur of het aantal aardbevingen per jaar.
Voor functies op gemiddeld niveau ligt de focus op hypothesetoetsing, intervalschatting en regressiemodellering. Als je je tijdens het lezen van deze vragen onzeker voelt over sommige concepten, kun je terugvallen op DataCamp-bronnen. Je kunt hypothesetoetsing leren via de cursussen Hypothesis Testing in Python en Hypothesis Testing in R. Je kunt regressietechnieken ook onder de knie krijgen met de volgende cursussen en tutorials:
Een p-waarde is de kans om een toetsingsgrootheid te verkrijgen die minstens zo extreem is als de geobserveerde, aangenomen dat de nulhypothese waar is. Ze wordt gebruikt bij hypothesetoetsing om de significantie van het testresultaat te bepalen. Als de p-waarde kleiner is dan of gelijk aan het gekozen significantieniveau (α), verwerpen we de nulhypothese. Als de p-waarde groter is dan α, verwerpen we de nulhypothese niet.
Type I-fouten bij hypothesetoetsing treden op wanneer de nulhypothese waar is, maar we die ten onrechte verwerpen, wat leidt tot een vals-positief. De kans op een type I-fout is gelijk aan het significantieniveau. Type II-fouten treden op wanneer de nulhypothese onwaar is, maar we die niet verwerpen, wat leidt tot een vals-negatief.
Parametrische toetsen gaan ervan uit dat data een specifieke verdeling volgt, zoals normaal, en vereisen bepaalde populatieparameters; ze zijn ideaal als aan deze aannames is voldaan. Enkele voorbeelden van parametrische toetsen die ik vaak gebruik zijn de t-toets, Z-toets en ANOVA. Niet-parametrische toetsen veronderstellen geen specifieke verdeling en worden gebruikt wanneer data niet aan de parametrische aannames voldoet, vooral bij kleine steekproeven. Veel mensen kennen deze toetsen wel, maar herkennen ze niet per se als niet-parametrisch. Ik heb onder andere de Chi-kwadraattoets, Mann-Whitney U-toets, Wilcoxon Signed-Rank Test en de Kruskal-Wallis-toets gebruikt.
Regressieanalyse is een statistische methode om de relatie te onderzoeken tussen één afhankelijke variabele en één of meer onafhankelijke variabelen. Ze helpt te begrijpen hoe de afhankelijke variabele verandert wanneer één van de onafhankelijke variabelen varieert, terwijl de andere onafhankelijke variabelen constant worden gehouden.
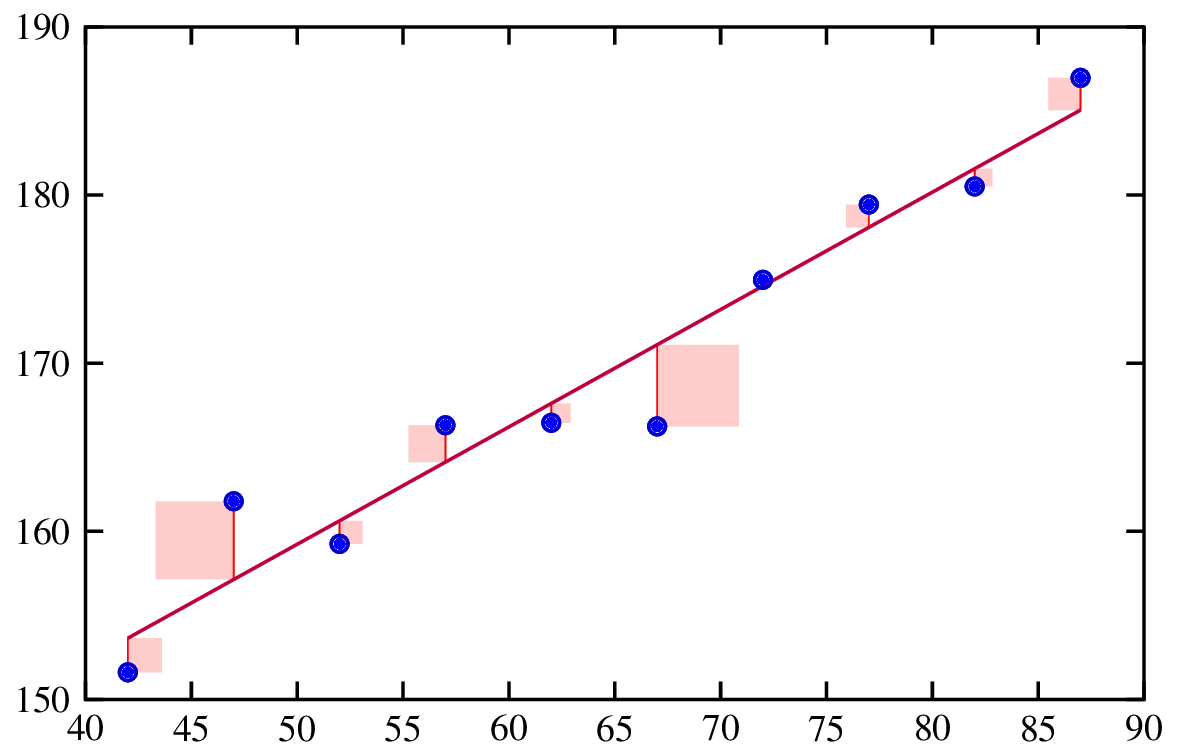
Een regressielijn fitten. Bron: Risk Engineering.
Residuen zijn de verschillen tussen de geobserveerde waarden en de voorspelde waarden uit een regressiemodel. Ze zijn belangrijk omdat het analyseren van residuen helpt om de aannames van ons model te controleren, evenals de algehele fit van het model te beoordelen.
In een lineair regressiemodel geeft elke coëfficiënt de verwachte verandering in de afhankelijke variabele weer bij een toename van één eenheid in de overeenkomstige onafhankelijke variabele, terwijl alle andere variabelen constant worden gehouden. Als de coëfficiënt van een onafhankelijke variabele 𝑥𝑖 bijvoorbeeld 2 is, betekent dit dat de afhankelijke variabele y naar verwachting met 2 eenheden toeneemt voor elke toename van 1 eenheid in 𝑥𝑖, ervan uitgaande dat andere variabelen onveranderd blijven.
Een 95%-betrouwbaarheidsinterval betekent dat als we veel steekproeven zouden nemen en voor elke steekproef een betrouwbaarheidsinterval zouden berekenen, ongeveer 95% van deze intervallen de werkelijke populatieparameter zou bevatten. We kunnen ook zeggen dat we er 95% zeker van zijn dat de parameterwaarde binnen het geschatte interval ligt.
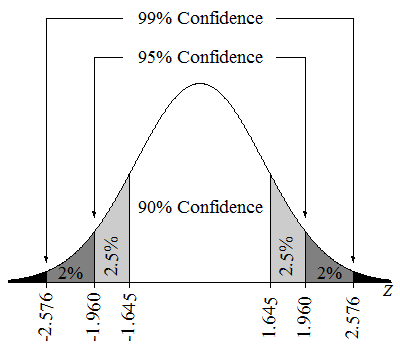
Betrouwbaarheidsintervallen op een Z-verdeling. Bron: Lumen Learning.
Multicollineariteit treedt op wanneer twee of meer onafhankelijke variabelen in een meervoudig regressiemodel sterk gecorreleerd zijn. Dat is een probleem omdat de coëfficiëntschattingen dan instabiel en moeilijk te interpreteren kunnen worden. Hoge multicollineariteit kan ook de standaardfouten van de coëfficiënten opblazen, wat leidt tot minder betrouwbare statistische toetsen.
Regularisatietechnieken zijn een krachtig middel om multicollineariteit in regressiemodellen aan te pakken. Ze worden ook gebruikt om overfitting te voorkomen door een straf toe te voegen voor grote coëfficiënten. Dit helpt een algemener model te creëren. Veelgebruikte regularisatietechnieken zijn onder meer Lasso en Ridge Regression.
Als ik me zou voorbereiden op een gesprek dat een gevorderd begrip van statistiek vereist, zou ik me verdiepen in Bayesiaanse statistiek en machine learning.
Voor Bayesiaanse statistiek, bekijk onze cursussen: Bayesian Data Analysis in Python en Fundamentals of Bayesian Data Analysis in R. Voor machine learning kun je DataCamp-carrièrepaden of cursussen over machine learning bekijken, waaronder ons carrièrepad Machine Learning Scientist with Python en de cursus Understanding Machine Learning.
Bayesiaanse statistiek maakt gebruik van de stelling van Bayes om de kans op een hypothese bij te werken naarmate er meer bewijs of informatie beschikbaar komt. Ze combineert eerdere overtuigingen met nieuwe data om tot een posteriori kans te komen.
Markov Chain Monte Carlo is een klasse van algoritmen die wordt gebruikt om te steekproeven uit een kansverdeling te nemen wanneer direct steekproeven lastig is. Het is belangrijk in Bayesiaanse statistiek omdat het de schatting van posteriori verdelingen mogelijk maakt, vooral in complexe modellen waar analytische oplossingen niet haalbaar zijn.
De bias-variantie-afweging in machine learning draait om het balanceren van twee foutbronnen. Bias is de fout door te simpele modelaannames, wat leidt tot underfitting en het missen van patronen. Variantie is de fout door een te grote gevoeligheid voor fluctuaties in trainingsdata, wat leidt tot overfitting en het vastleggen van ruis in plaats van echte patronen.
Causale inferentie is een belangrijk idee dat veel aandacht krijgt. Het is het proces om te bepalen of en hoe één variabele (de oorzaak) direct een andere variabele (het effect) beïnvloedt, wat een onderscheidend kenmerk is tussen causale inferentie en louter correlatie. Causale inferentie is eigenlijk een groep methoden die een oorzaak-gevolgrelatie wil vaststellen om te begrijpen of iets werkt, zoals een interventie of behandeling. Als een onderzoeker bijvoorbeeld moet begrijpen of een medicijn werkt, kan causale inferentie helpen om die vraag te beantwoorden.
Structurele vergelijkingsmodellering (SEM) is een techniek voor het analyseren van relaties tussen zogenoemde geobserveerde en latente variabelen. Het is een soort mix tussen meervoudige regressie en factoranalyse. Structurele vergelijkingsmodellering vereist meerdere stappen, zoals modelspecificatie, schatting en daarna evaluatie. SEM staat bekend als flexibel, maar vereist grote steekproeven en, om het te gebruiken, heb je een sterke theoretische basis nodig.
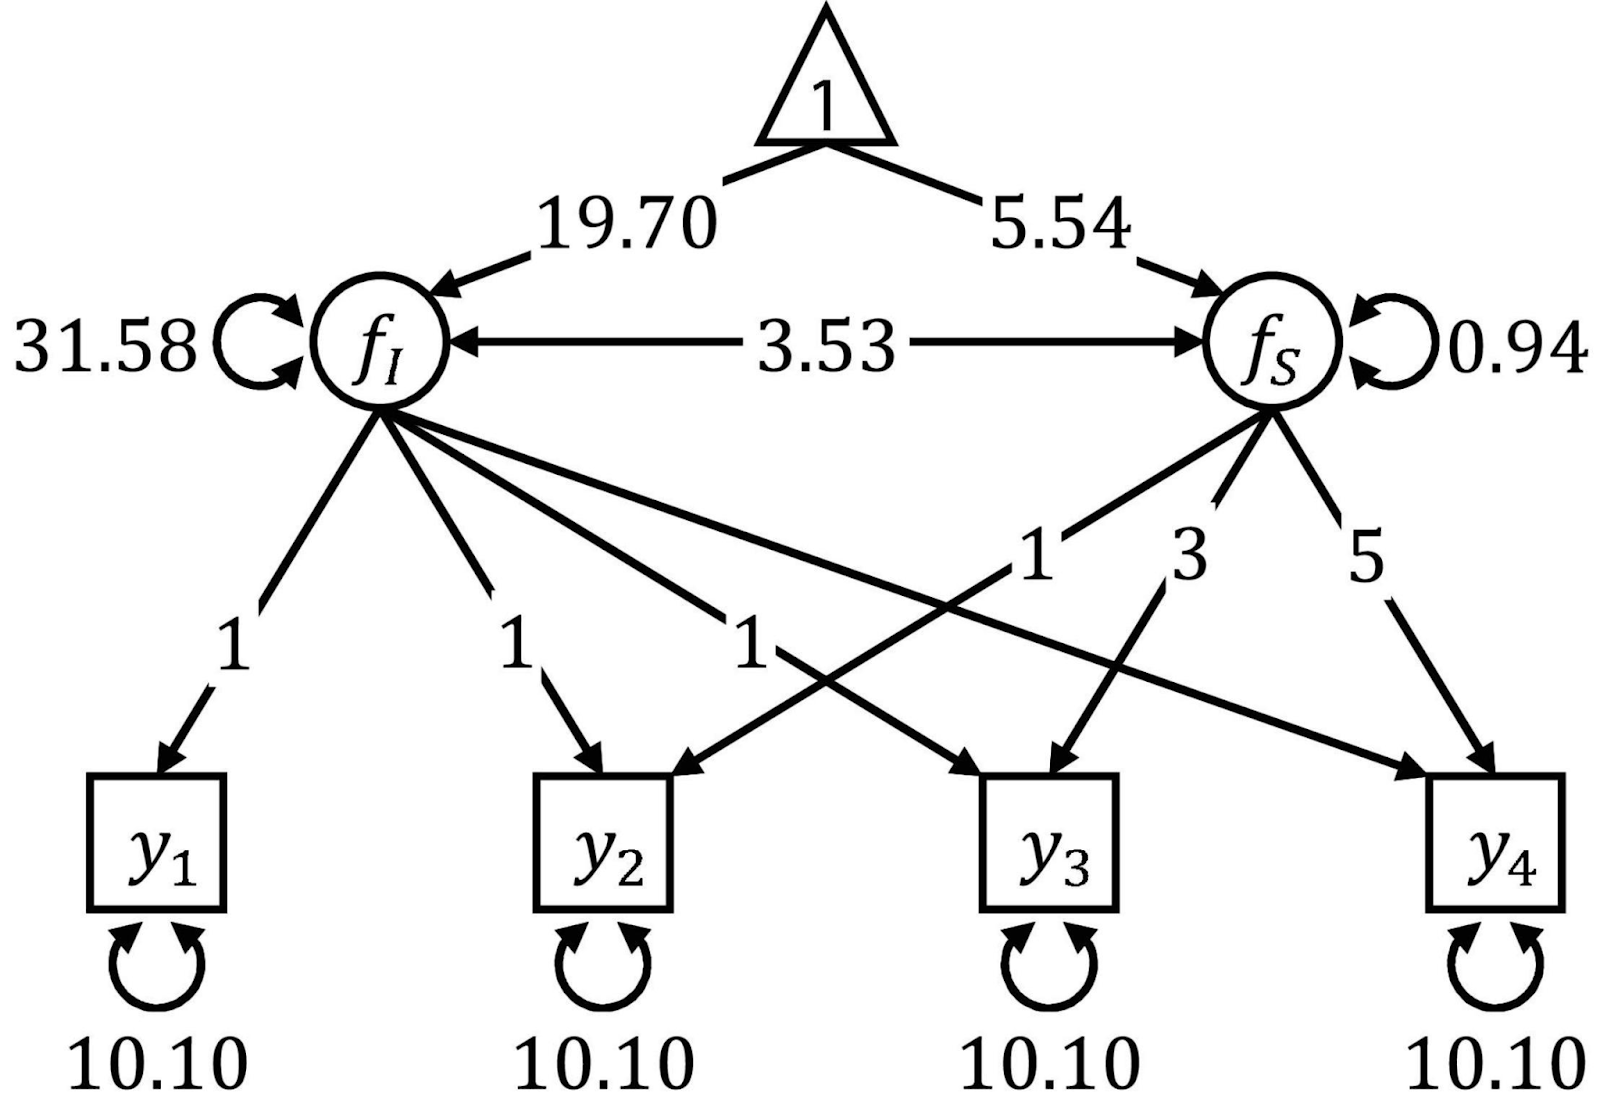
Pad-diagrammen worden vaak gebruikt om SEM te visualiseren. Bron: Frontiers.
De volgende vragen zijn nuttig als je solliciteert naar een rol die meer gericht is op de kruising van data science en statistiek. Onderwerpen hier zijn datapreprocessing en -opschoning, A/B-testen en experimenteel ontwerp, tijdreeksvoorspelling en geavanceerde statistische technieken.
Als je deze concepten lastig vindt en je serieus je sollicitatieproces wilt verbeteren, neem dan deze DataCamp-bronnen over A/B-testen: de cursus A/B Testing in Python of de cursus A/B Testing in R. Kies vervolgens om tijdreeksanalyse te beheersen tussen de skill tracks Time Series with R of Time Series with Python om ervaring op te doen.
Het splitsen van data in trainings- en testsets helpt ons de prestaties van het model op onbekende data te evalueren. De trainingsset wordt gebruikt om het model te trainen, terwijl de testset wordt gebruikt om te beoordelen hoe goed het model generaliseert naar nieuwe data. Deze aanpak helpt overfitting te detecteren en zorgt ervoor dat het model goed presteert op real-world data.
Overfitting treedt op wanneer een model zowel de onderliggende patronen als de ruis in de trainingsdata leert, wat leidt tot uitstekende prestaties op trainingsdata maar slechte prestaties op nieuwe, onbekende data. Underfitting gebeurt wanneer een model te simpel is om de onderliggende patronen in de data vast te leggen, wat resulteert in slechte prestaties op zowel de trainingsdata als op nieuwe data.
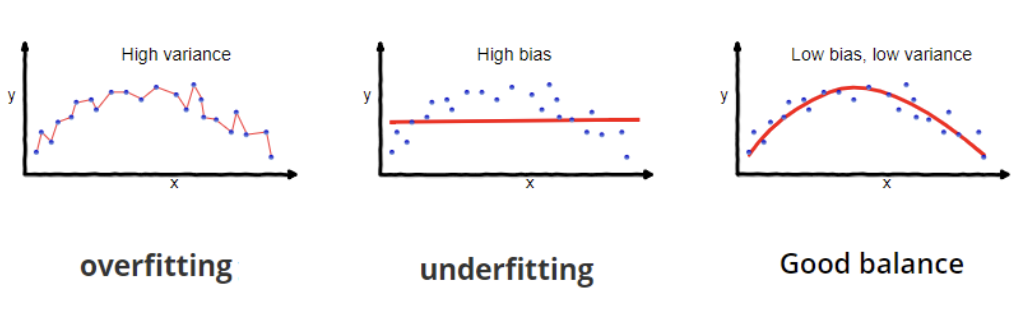
Overfitting en underfitting. Bron: Wikipedia.
Het begrijpen van het mechanisme van ontbrekendheid (MCAR, MAR, MNAR) is cruciaal omdat het de keuze van geschikte methoden voor het omgaan met ontbrekende data stuurt. Onjuiste technieken kunnen bias introduceren, de geldigheid van de resultaten verminderen en tot verkeerde conclusies leiden. Eenvoudige imputatiemethoden kunnen bijvoorbeeld geschikt zijn voor MCAR-data, terwijl meer geavanceerde technieken zoals multiple imputation of modelgebaseerde methoden nodig kunnen zijn voor MAR- of MNAR-data om onbevooroordeelde schattingen te produceren.
Het verwijderen van ontbrekende waarden kan geschikt zijn wanneer het aandeel ontbrekende data heel klein is, doorgaans minder dan 5%. Ook is het een goed idee wanneer de ontbrekende data MCAR (Missing Completely at Random) is, wat betekent dat de ontbrekendheid geen bias introduceert. Ten slotte zou ik overwegen ontbrekende waarden te verwijderen als de dataset groot genoeg is zodat het verwijderen van een klein aantal rijen de analyse niet significant beïnvloedt.
Elke imputatiemethode heeft zijn voor- en nadelen. Zo is imputatie met gemiddelde/mediaan/modus eenvoudig te implementeren, maar kan het bias introduceren en relaties tussen variabelen verstoren. K-nearest neighbors (KNN)-imputatie houdt rekening met relaties tussen variabelen en kan tot nauwkeurigere resultaten leiden, maar kan rekenintensief zijn.
A/B-testen is een methode binnen experimenteel ontwerp om twee versies van een variabele te vergelijken, zoals een webpagina, app-functie of marketingcampagne, om te bepalen welke beter presteert. Het is een zeer relevant onderwerp en staat in het gedeelte ‘vereist’ van veel functieomschrijvingen.
Seizoensinvloed is een van de componenten van tijdreeksen, naast trend en residuen (ruis). Om seizoensinvloeden te detecteren, kunnen we eerst de tijdreeks visueel inspecteren via een lijngrafiek. Als seizoensinvloed wordt vermoed, kunnen we overgaan tot decompositie van de tijdreeks om de omvang van het seizoens effect te bepalen.
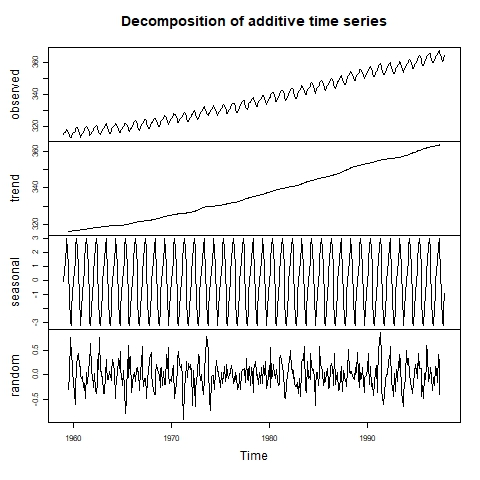
Tijdreeks visueel gedecomponeerd. Bron: Lab of Environmental Informatics.
Modellen voor exponentiële afvlakking gebruiken gewogen gemiddelden van eerdere observaties voor eenvoudige, kortetermijnvoorspellingen. ARIMA-modellen combineren autoregressie, differencing en moving-average-componenten, waardoor ze complexer zijn maar geschikt voor zowel korte- als langetermijnvoorspellingen, vooral bij complexe patronen en significante autocorrelaties.
Kruisvalidatie is een techniek om te beoordelen hoe een machinelearningmodel zal generaliseren naar een onafhankelijke dataset. Het houdt in dat je de data in meerdere folds verdeelt en meerdere rondes van training en validatie uitvoert.
Omdat perfecte statistiek en analyse-resultaten pas compleet zijn als je de uitkomst aan business stakeholders communiceert, zijn softskills essentieel voor werkgevers die datafuncties invullen, zeker omdat het communiceren van inzichten uit statistiek nooit eenvoudig is.
Om effectief te communiceren met verschillende stakeholders pas ik mijn stijl aan op hun achtergrond en interesses. Voor leidinggevenden prioriteer ik bijvoorbeeld de zakelijke impact, met zakelijke taal en visuals om snel beslissingen te faciliteren. Voor developers daarentegen geef ik technische details. In beide gevallen zorg ik dat de betrokken concepten duidelijk en toegankelijk zijn, en moedig ik vragen en feedback aan. Deze aanpak zorgt ervoor dat elke stakeholdergroep de informatie krijgt die ze nodig heeft, in een vorm die bij hen aanslaat.
Statistiek leren voor data-analytische rollen kan uitdagend zijn. Veel mensen komen uit uiteenlopende achtergronden die niet per se veel of enige statistische kennis omvatten. De meeste online beschikbare bronnen moedigen leerlingen aan zich alleen op de tools te richten, waarbij het cruciale belang van statistiek over het hoofd wordt gezien.
Om je kennis en carrièrekansen verder te vergroten, kun je aanvullende bronnen en cursussen verkennen. Voor een gedetailleerde gids over hoe je statisticus wordt, bekijk onze blogpost How to Become a Statistician, die waardevolle inzichten biedt. Dit kun je aanvullen met ons carrièrepad Statistician with R. Neem de tijd om je intuïtie te testen met de cursus Probability Puzzles in R. Als je de voorkeur geeft aan Python, is onze skill track Statistics Fundamentals with Python een goede optie.
Veel succes met je komende sollicitatiegesprekken!
Leer statistiek met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

