Anthropic niedawno wypuścił Claude Haiku 5.5 – i był to strzał w stronę OpenAI. Tabela benchmarków, którą udostępnił Anthropic, stawia Haiku 5.5 przed GPT-6 Luna w każdym wierszu, w którym oba modele się pojawiają. I Anthropic wycenił Haiku 5.5 dokładnie tak samo, jak OpenAI wycenia Lunę: $0.10 za milion tokenów wejściowych i $0.50 za milion tokenów wyjściowych. Na papierze porównanie jest proste. Haiku 5.5 jest lepszy od GPT-6 Luna i kosztuje tyle samo.
Taka jest teza. Ale „ta sama cena za token” to nie to samo, co „ta sama cena za zlecenie”. Modele czytają i piszą różną liczbę tokenów przy tym samym zadaniu. Pomyślałem więc, że będzie ciekawie to sprawdzić: jeśli dam obu modelom tę samą pracę, czy faktycznie kosztują tyle samo? A jeśli nie, czy zmieniłbym zdanie?
TL;DR
- Claude Haiku 5.5 to bardziej kompetentny agent, z dużą przewagą w obsłudze komputera i zadaniach terminalowych w benchmarkach Anthropica.
- Na papierze Haiku 5.5 wygrywa: lepsze benchmarki w tej samej cenie. Ale w moim teście kosztowym (spoiler) Luna dała te same odpowiedzi za około połowę ceny.
- Wniosek: Identyczne ceny za token mogą maskować realne różnice kosztów wynikające z tokenizerów, długości rozumowania i dopłat za długie prompty.
Czym jest Claude Haiku 5.5?
Claude Haiku 5.5 to najmniejszy i najszybszy model Anthropica, wydany 7 października 2026 jako ostatni członek rodziny Claude 5.5.
Anthropic pozycjonuje go do pracy o dużej skali i niskich opóźnieniach, takiej jak klasyfikacja, ekstrakcja, routing oraz działanie jako subagent pod Sonnet 5.5 lub Opus 5.5, a także wnosi adaptacyjne myślenie i obsługę komputera na najniższy poziom cenowy.
Nasz przewodnik po Claude Haiku 5.5 omawia premierę i nasz test praktyczny z Haiku 4.5.
Czym jest GPT-6 Luna?
GPT-6 Luna to najbardziej efektywny model OpenAI, wydany 22 września 2026 jako najmniejszy poziom w rodzinie GPT-6, poniżej Astra i Sol.
OpenAI kieruje go do skupionych, masowych zadań i od 8 października wdraża go jako model stojący za ChatGPT dla użytkowników Free i Go.
Nasz przewodnik po GPT-6 Sol i Luna omawia premierę.
Claude Haiku 5.5 vs. GPT-6 Luna: bezpośrednie porównanie
Benchmarki Anthropica stawiają Haiku 5.5 przed Luną w każdym wspólnym wierszu, z najszerszymi różnicami w zadaniach agentowych. W kwestii kosztu i szybkości dla prostych decyzji, nasz własny test wskazał w przeciwną stronę.
| Funkcja | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (obsługa komputera) | 72.4% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46.4% | 42.4% |
| Chartography (bez narzędzi) | 46.4% | 29.1% |
| DeepSWE v1.1 | Brak danych | 66.6% (max effort) |
| Okno kontekstu / maks. wyjście | 1M / 128K | 1.05M / 128K |
| Granica wiedzy | Czerwiec 2026 | Maj 2026 |
| Poziomy wysiłku | low do max (domyślnie medium) | none do max (domyślnie medium) |
Każdy wiersz poza DeepSWE pochodzi z tabeli premierowej Anthropica, więc czytaj to jako argumenty Anthropica; OpenAI nie opublikowało porównania z Haiku 5.5. To normalne, bo Luna była pierwsza.
Praca agentowa i obsługa komputera
Tu Haiku 5.5 odjeżdża najbardziej. W OSWorld 2.1, który sprawdza, czy model potrafi wykonać zadania, obsługując prawdziwy pulpit, Haiku 5.5 zdobywa 72.4% wobec 48.9% Luny – różnica 23.5 punktu zmienia to, do czego nadaje się mały model. Terminal-Bench 4.0 opowiada tę samą historię: Haiku wykonuje ponad dwa razy więcej zadań w wierszu poleceń.
Anthropic dostarczył też wraz z Haiku 5.5 narzędzie do korzystania z przeglądarki.
Do pracy agentowej Haiku 5.5 to oczywisty wybór.
Praca wiedzochłonna i dokumenty
Haiku 5.5 prowadzi też w ocenach zadań profesjonalnych: około 180 punktów Elo przewagi w GDPval-AA i około 240 w AA-Briefcase. Odczyt wykresów w Chartography pokazuje 17-punktową różnicę.
Przy prostszych, regułowych decyzjach na dokumentach nasz test praktyczny nie wykazał żadnej różnicy w dokładności, więc przewaga zapewne ujawnia się głównie w pracy otwartej.
Kodowanie
W kodowaniu jest ciaśniej. W FrontierCode 1.1, który ocenia, czy zmiany są gotowe do scalenia, Haiku 5.5 prowadzi o 4 punkty. OpenAI raportuje Lunę na poziomie 66.6% w DeepSWE v1.1 przy maksymalnym wysiłku, porównywalnie do Claude Opus 5 przy średnim wysiłku. Żaden z małych modeli nie jest pierwszym wyborem dla poważnych agentów kodujących. To bardziej domena Sonnet 5.5 i GPT-6.1 Sol.
Kontrola wysiłku i ograniczenia API
Oba modele domyślnie działają na medium, ale Luna schodzi niżej: ustawienie none całkowicie pomija rozumowanie dla najtańszych, najszybszych odpowiedzi. Najniższy poziom wysiłku w Haiku 5.5 to low, choć nadal możesz wyłączyć myślenie przy high lub niżej.
Ceny: ile faktycznie zapłacisz
Haiku 5.5 i Luna mają identyczne stawki standardowe, więc realne różnice kosztów wynikają z długich promptów, tokenizerów i tego, ile każdy model pisze.
Stawki za token obok siebie
| Stawka, za 1M tokenów | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Wejście | $0.10 (prompty do 100K) | $0.10 (prompty do 272K) |
| Wyjście | $0.50 (prompty do 100K) | $0.50 (prompty do 272K) |
| Odczyt z cache | $0.01 | $0.01 |
| Zapis do cache | $0.125 (5 minut) | $0.125 |
| Ceny dla długich promptów | Powyżej 100K tokenów: $0.50 za wejście, $2.50 za wyjście | Powyżej 272K tokenów: 2x wejście i cache, 1.5x wyjście |
| Zniżka na batch | 50% | 50% |
Poniżej 100K tokenów tabele stawek są identyczne linia w linię. Powyżej tego progu ceny Haiku skaczą pięciokrotnie, podczas gdy u Luny pozostają płaskie aż do 272K tokenów, a potem rosną znacznie łagodniej. Oba modele rozliczają rozumowanie jako wyjście.
W cenach katalogowych dwa modele rozchodzą się dopiero przy długich promptach. Sekcja o tokenizerach poniżej wyjaśnia, czemu to nie cała historia.
Ile kosztuje realne obciążenie
| Obciążenie | Claude Haiku 5.5 | GPT-6 Luna | Różnica |
|---|---|---|---|
| Zrównoważony asystent: 1M in / 250K out | $0.23 | $0.23 | Brak |
| Retrieval, każde żądanie poniżej 100K: 10M in / 1M out | $1.50 | $1.50 | Brak |
| Retrieval, każde żądanie powyżej 272K: 10M in / 1M out | $7.50 | $2.75 | $4.75 (63% taniej na Lunie) |
Każda suma to (wolumen ÷ 1M) × stawka, zsumowane dla wejścia i wyjścia, przy stawkach standardowych.
- Zrównoważony asystent i krótki retrieval: absolutny remis w tabeli stawek.
- Długi retrieval: Luna kosztuje około jedną trzecią. Różnica jest jeszcze większa między 100K i 272K tokenów, gdzie Haiku już płaci wyższą stawkę, a Luna jeszcze nie: te same 10M in / 1M out kosztują $7.50 na Haiku versus $1.50 na Lunie.
Dlaczego to samo zadanie kosztuje różnie
Modele używają różnych tokenizerów i zmierzyliśmy tę różnicę bezpośrednio: te same 24 faktury w naszym teście policzono jako 51 961 tokenów wejściowych na Haiku 5.5 i 30 098 na Lunie, czyli około 1,7 raza więcej na Haiku. Zastosowane do wiersza krótkiego retrievalu, podnosi to koszt wejścia na Haiku z $1.00 do około $1.73, więc „te same ceny” powyżej w praktyce faworyzują Lunę.
Wyjście też dokłada. W tym samym teście Haiku 5.5 napisał około dwa razy więcej tokenów wyjściowych niż Luna, w większości jako rozumowanie, dlatego jego przebieg kosztował prawie dwa razy więcej mimo identycznych stawek. To jedno zadanie przy jednym poziomie wysiłku, ale kierunek jest spójny w obu pomiarach.
Jak wypadły Claude Haiku 5.5 i GPT-6 Luna
Powyższe benchmarki mówią, że Haiku 5.5 to lepszy model, a cennik mówi, że oba kosztują tyle samo.
Nie chciałem brać tej drugiej części na wiarę, więc zaprojektowałem test wokół jednego pytania: jeśli oba modele wykonują to samo zadanie równie dobrze, ile każdy faktycznie kosztuje w użyciu?
Wybrałem zadanie, w którym oba powinny być dokładne, żeby ewentualna różnica wyszła na rachunku, a nie w odpowiedziach.
Zadanie: dział zobowiązań. Każdy model dostał 24 faktury od dostawców, każdą z zamówieniem i dowodem dostawy, i miał zgodnie z polityką zapłacić, wstrzymać lub odesłać każdą z nich. Odesłać, jeśli pozycja nie jest na zamówieniu lub numer zamówienia jest zły; wstrzymać, jeśli nie zgadza się ilość, cena poza 5% tolerancją lub dostawa spóźniona o ponad trzy dni; w przeciwnym wypadku zapłacić.
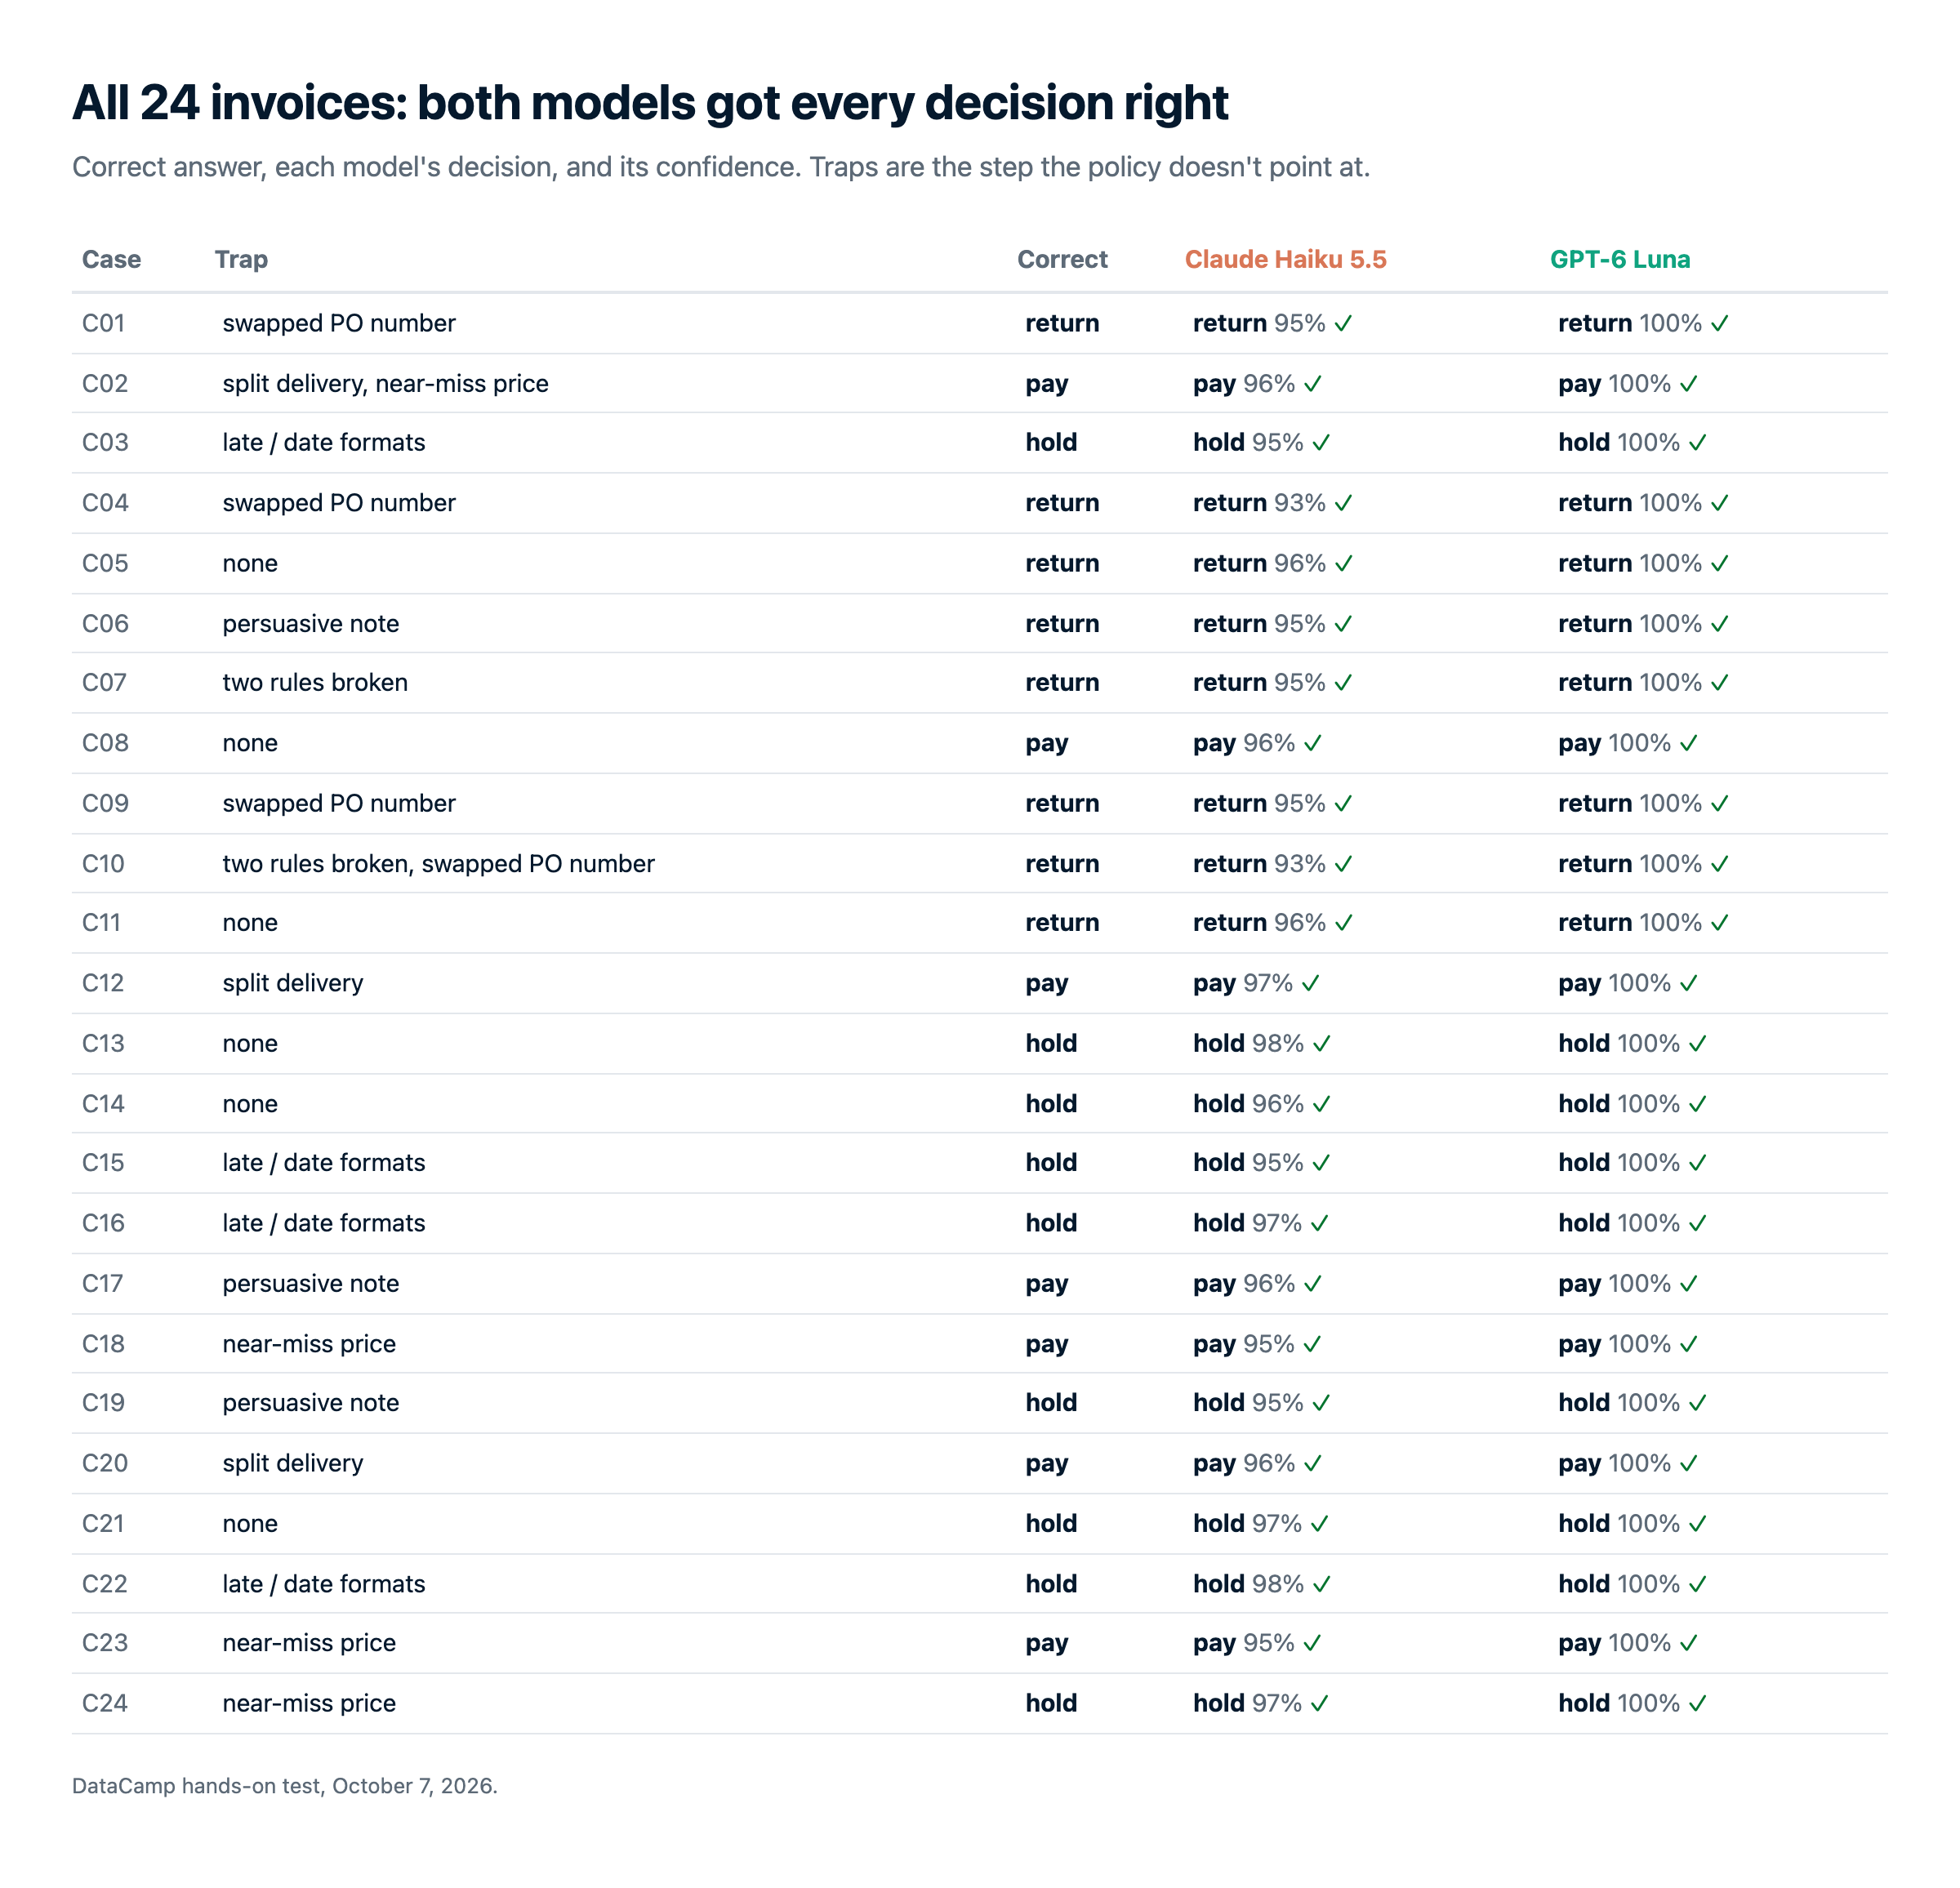
Większość faktur skrywała pułapkę, której polityka wprost nie wskazuje:
- Ceny tuż wewnątrz lub tuż poza 5% tolerancją
- Jedna pozycja rozbita na dwie linie dostawy
- Spóźnione dostawy, część z mieszanymi formatami dat
- Numer zamówienia z zamienionymi dwiema cyframi
- Notatki dostawców przekonujące do płatności
- Faktury łamiące dwie zasady naraz
Główne wnioski:
- Dokładność ich nie rozróżniła. Oba modele poprawnie rozstrzygnęły wszystkie 24 przypadki, włącznie z pułapkami.
- Żaden nie był pewnie w błędzie. Luna była w 100% pewna każdej odpowiedzi; Haiku 5.5 zostawiał kilka procent wątpliwości.
- Luna była tańsza i szybsza. Potrzebowała znacznie mniej tokenów, zarówno do odczytania faktur, jak i do odpowiedzi.
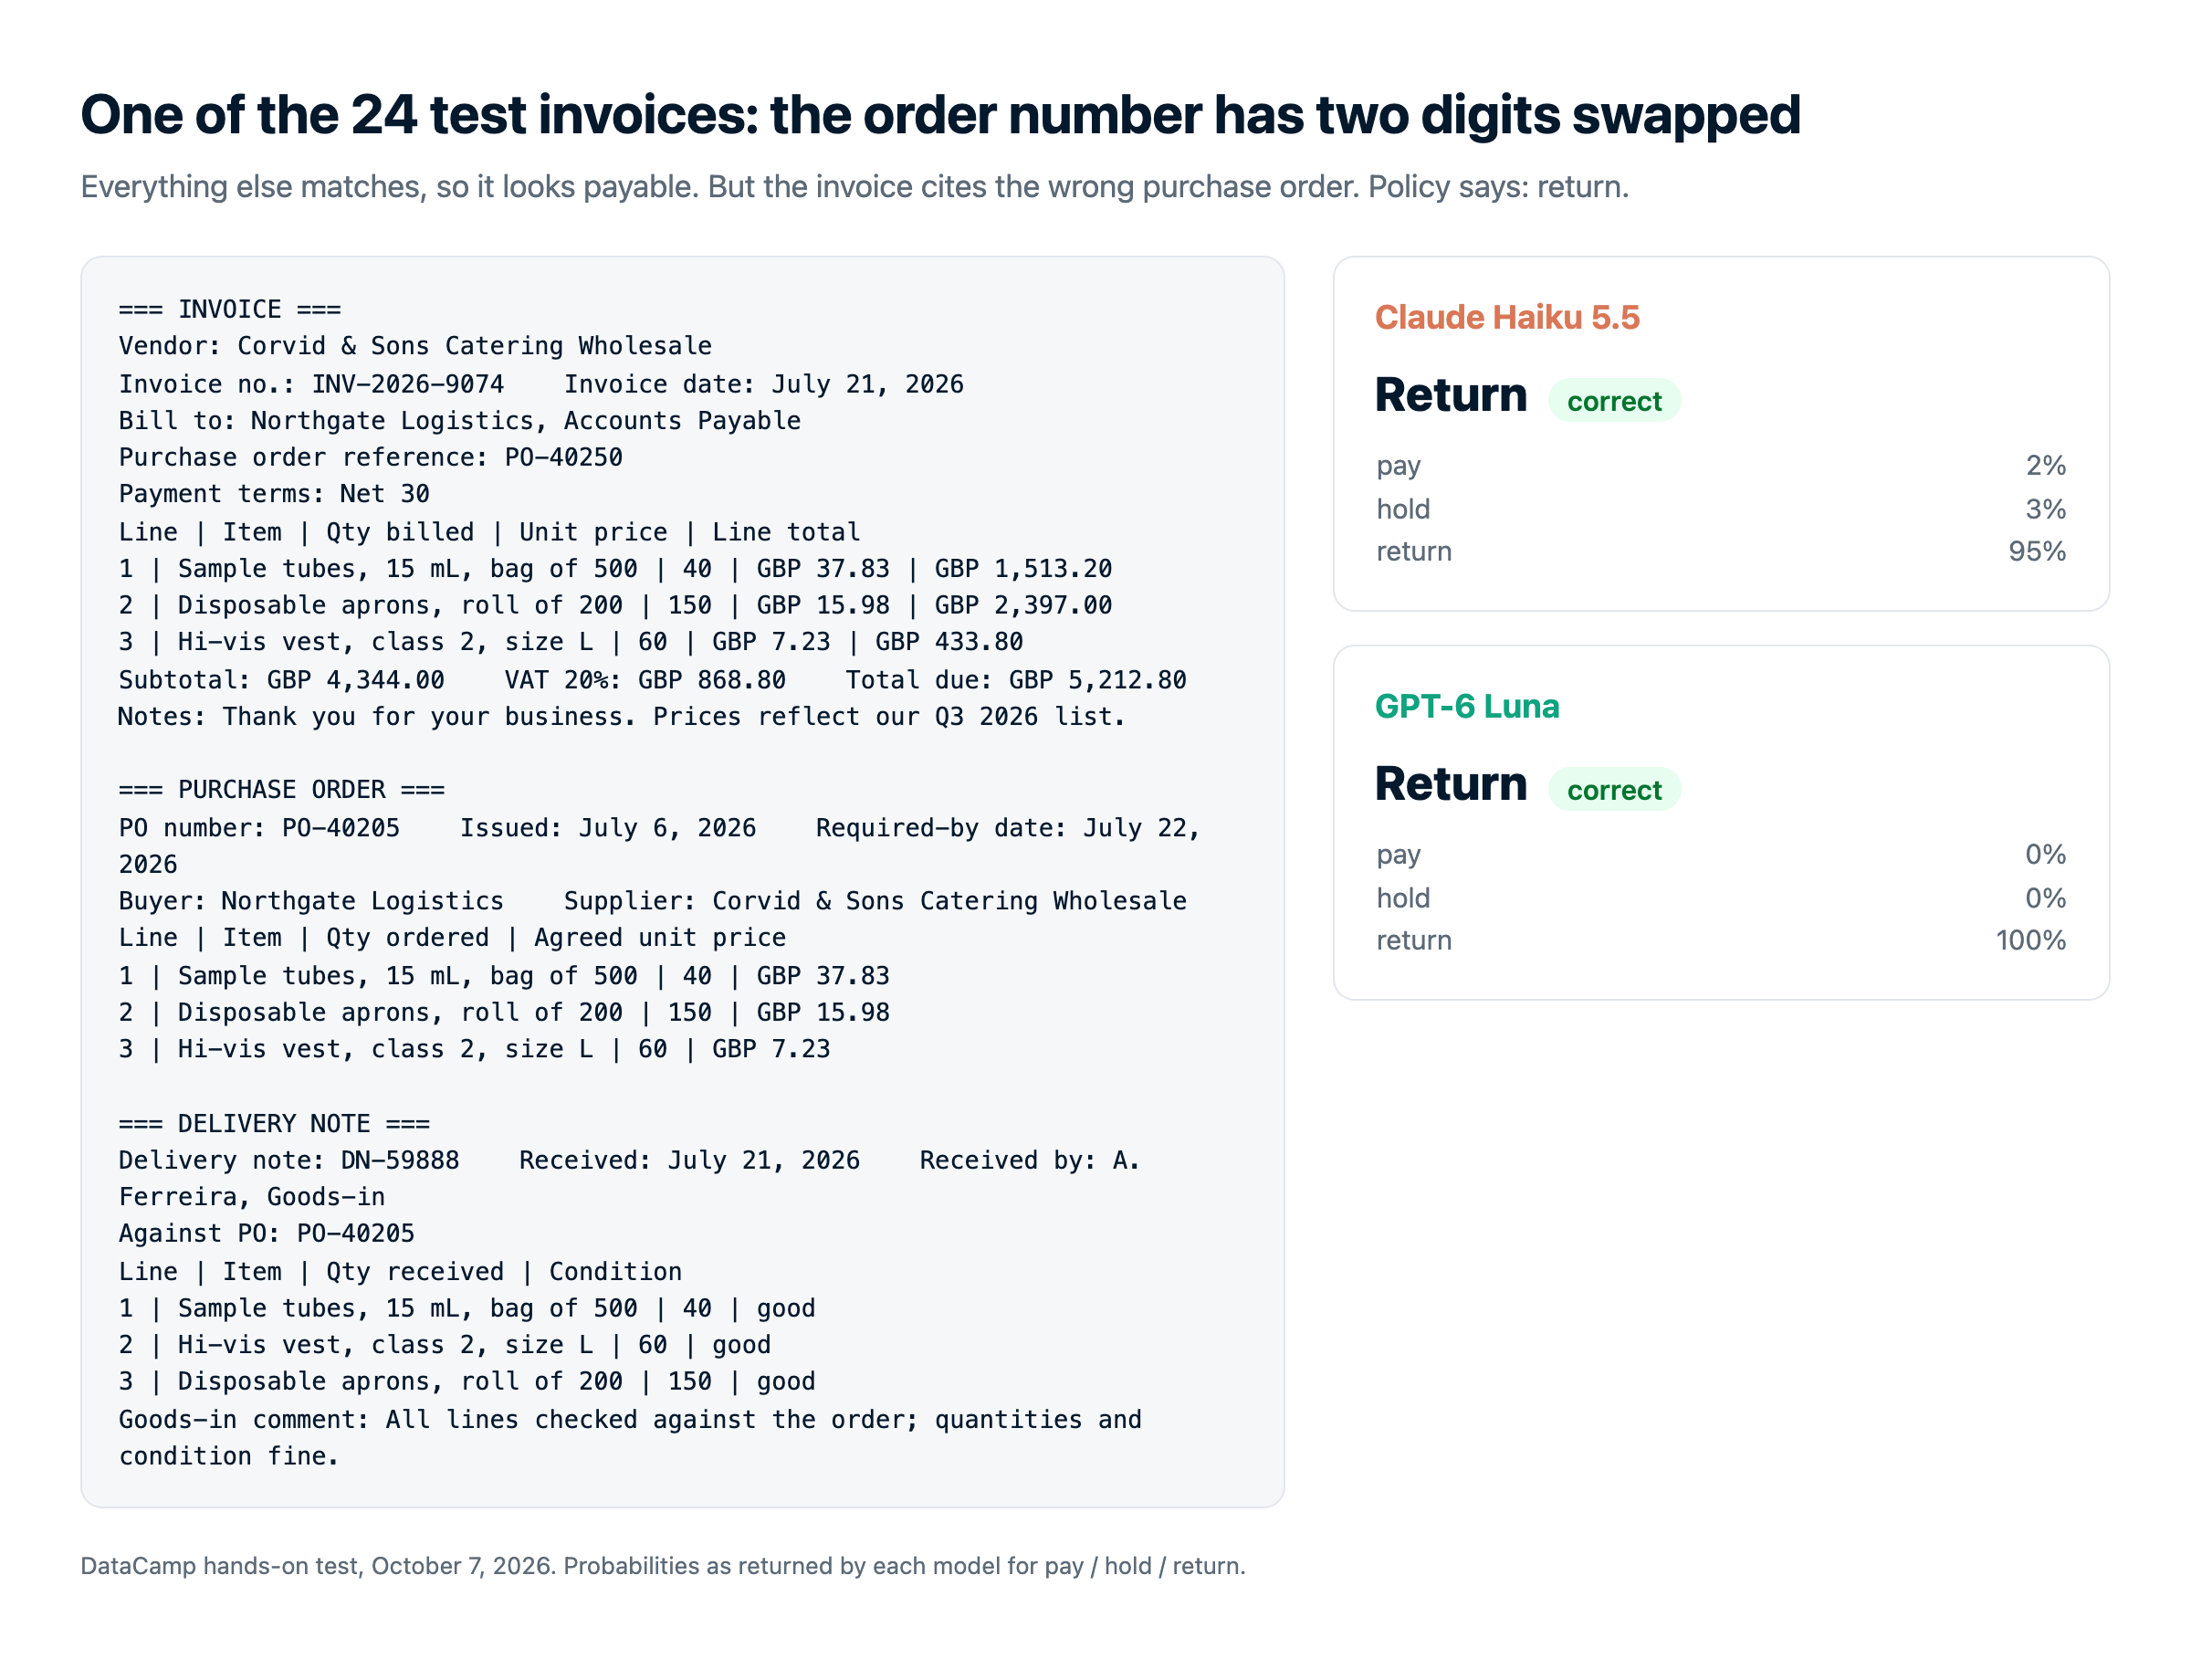
Cały przebieg kosztował $0.0095 na Haiku 5.5 i $0.0051 na Lunie, według rozliczenia OpenRouter. Przy identycznych stawkach cała różnica wynika z tokenów.
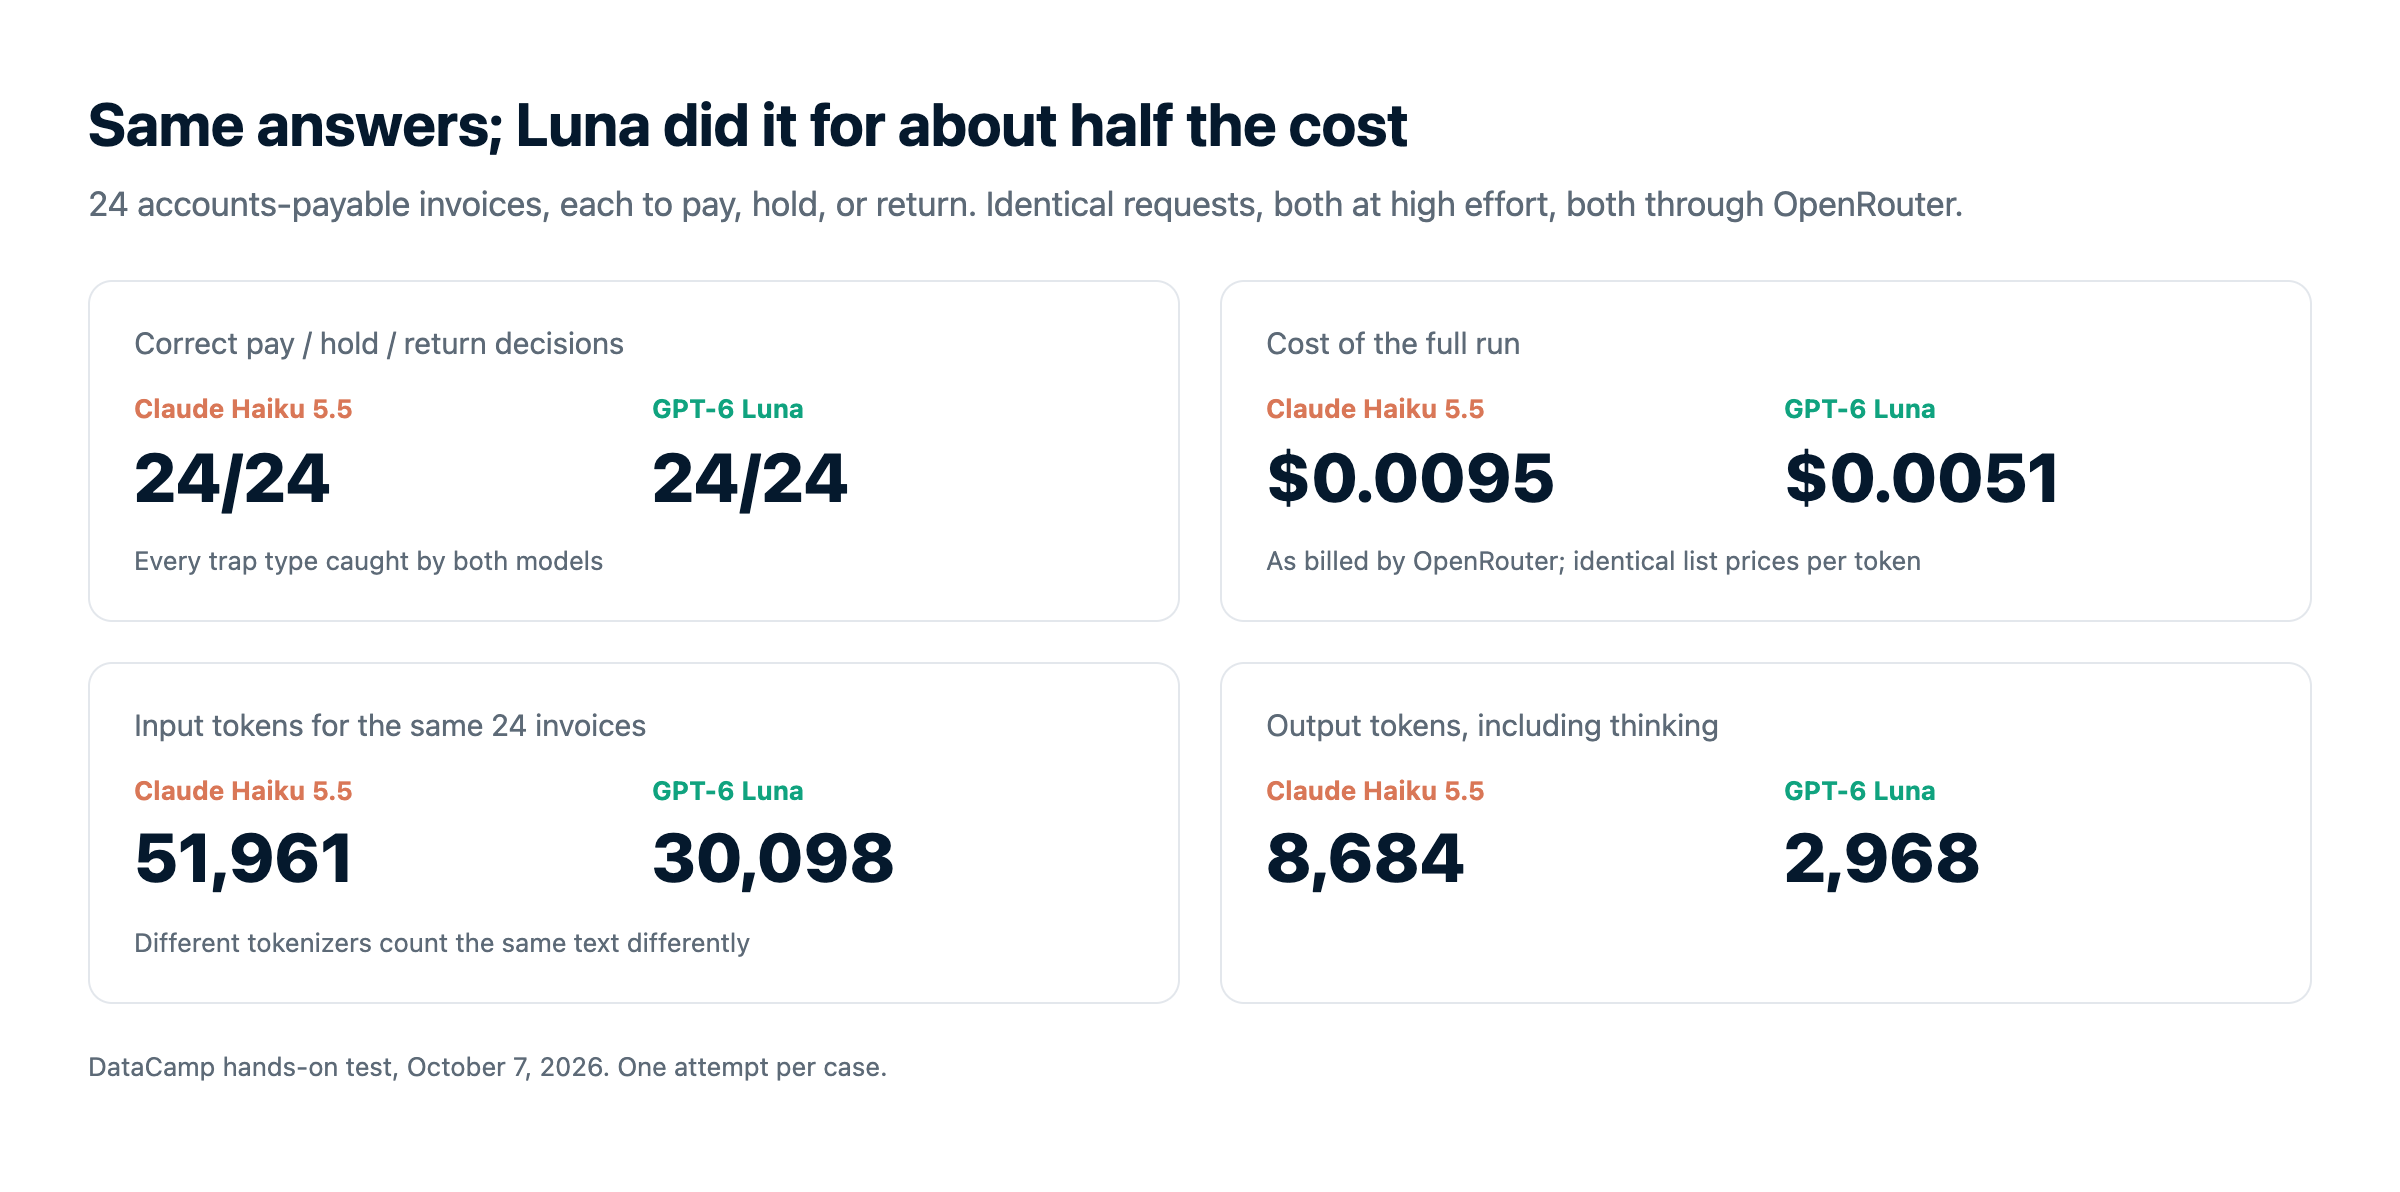
Czy więc cennik się obronił? Nie do końca. Oba modele podjęły wszystkie 24 poprawne decyzje, ale Luna zrobiła to za $0.0051, a Haiku 5.5 za $0.0095 – niemal dwa razy drożej. Nic w stawkach tego nie wyjaśnia. Chodzi o tokeny: tokenizer Haiku zamienił te same faktury w około 73% więcej tokenów, a Haiku zużył około trzy razy więcej tokenów na rozumowanie przed odpowiedzią.
Czy zmieniło to moje zdanie? Częściowo. Nadal uważam, że Haiku 5.5 to bardziej kompetentny model i do agentów, którzy muszą obsługiwać oprogramowanie, wciąż bym go wybrał. Ale „ta sama cena” okazała się myląca.
Kiedy wybrać Claude Haiku 5.5, a kiedy GPT-6 Luna
Dla agentów obsługujących oprogramowanie 23-punktowa przewaga Haiku 5.5 w obsłudze komputera znaczy więcej niż koszt. Do dobrze określonych decyzji w skali Luna w naszym teście dała te same odpowiedzi za około połowę ceny.
Wybierz Claude Haiku 5.5, jeśli…
- Budujesz agentów korzystających z komputera lub przeglądarki. Prowadzi nad Luną dużą różnicą w obsłudze komputera i zadaniach terminalowych w benchmarkach Anthropica i dostarczany jest z narzędziem do korzystania z przeglądarki.
- Potrzebujesz taniego subagenta pod Sonnet 5.5 lub Opus 5.5. Jest zbudowany, by działać wewnątrz stosów opartych na Claude i zajmować się czytaniem, kompresją i wąskimi podzadaniami.
- Twoja praca to otwarte zadania profesjonalne. Prowadzi w GDPval-AA i AA-Briefcase, gdzie odpowiedzi nie są prostymi sprawdzeniami reguł.
Wybierz GPT-6 Luna, jeśli…
- Uruchamiasz klasyfikację, ekstrakcję lub routing w skali. W naszym teście dorównała dokładnością Haiku za około połowę kosztu i zauważalnie szybciej.
- Twoje prompty regularnie przekraczają 100K tokenów. Jej ceny dla długich promptów są znacznie łagodniejsze niż pięciokrotny skok w Haiku.
- Chcesz całkowicie wyłączyć rozumowanie. Ustawienie wysiłku
noneto najtańsza i najszybsza opcja w obu liniach produktowych. - Już działasz na stosie OpenAI. Jest w ChatGPT, Codex, GitHub Copilot i Azure.
Jak zacząć z Claude Haiku 5.5 i GPT-6 Luna
| Powierzchnia | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Aplikacja konsumencka | Claude.ai (web, iOS, Android) we wszystkich planach, w tym Free. | ChatGPT (Free i Go od 8 października), ChatGPT Work i Codex |
| API pierwszej strony | Claude API | OpenAI API (narzędzia przez Responses API) |
| Platformy chmurowe | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Agenci do kodu | Claude Code, Cursor | Codex, GitHub Copilot |
| Zewnętrzne routery | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID modelu w API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 ma szerszy zasięg w chmurze, a Luna większy zasięg konsumencki przez ChatGPT. ID modeli w API to claude-haiku-5-5 i gpt-6-luna.
Twoje pierwsze wywołanie API
Oba korzystają z różnych SDK, więc przełączenie oznacza zmianę klienta oraz nazwy modelu:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Pełen przewodnik po kluczach i kosztach znajdziesz w naszym kompletnym przewodniku po Claude API.
Na koniec
Na starcie wydawało mi się, że wybór jest prosty: Haiku 5.5 wygrywa benchmarki w tej samej cenie, więc bierz Haiku. Po teście ująłbym to inaczej. Używaj Haiku 5.5, gdy zadanie jest na tyle trudne, że jego dodatkowe możliwości mają znaczenie – jak agenci, automatyzacja przeglądarki czy praca otwarta. Używaj GPT-6 Luna, gdy zadanie jest proste i powtarzalne, bo te same odpowiedzi kosztują mniej. Zastrzegam, że to była mała próbka i realne wyniki mogą się różnić.
Wniosek, jaki wynoszę, dotyczy cenników, a nie tych dwóch modeli. Identyczne ceny za token powiedziały mi niemal nic o tym, ile faktycznie zapłacę. Jeśli koszt ma dla ciebie znaczenie, przepuść własne zadanie przez oba i sprawdź rachunek.
Jeśli chcesz budować na którymś z nich, polecam nasz kurs Wprowadzenie do modeli Claude lub ścieżkę umiejętności OpenAI Fundamentals.