Anthropic เปิดตัว Claude Haiku 5.5 เมื่อไม่นานมานี้ และเป็นการท้าชน OpenAI ตารางเบนช์มาร์กที่ Anthropic เผยแพร่จัดให้ Haiku 5.5 นำหน้า GPT-6 Luna ในทุกรายการที่มีทั้งสองโมเดล และ Anthropic ตั้งราคา Haiku 5.5 เท่ากับที่ OpenAI ตั้งราคา Luna: $0.10 ต่อโทเค็นขาเข้า 1 ล้านโทเค็น และ $0.50 ต่อโทเค็นขาออก 1 ล้านโทเค็น บนกระดาษ การเปรียบเทียบดูง่าย Haiku 5.5 ดีกว่า GPT-6 Luna และมีราคาเท่ากัน
นั่นคือข้อสรุปแบบรวบรัด แต่ “ราคาเท่ากันต่อโทเค็น” ไม่ได้แปลว่า “ราคาเท่ากันต่อภารกิจ” โมเดลอ่านและเขียนจำนวนโทเค็นต่างกันสำหรับงานเดียวกัน ก็เลยลองเช็กเล่นๆ ว่า ถ้าให้ทั้งสองโมเดลทำงานเดียวกันจริง ๆ ค่าใช้จ่ายจะเท่ากันไหม และถ้าไม่เท่า ความเห็นจะเปลี่ยนไหม
สรุปสั้น ๆ
- Claude Haiku 5.5 เป็นเอเจนต์ที่มีศักยภาพมากกว่า นำห่างในการใช้งานคอมพิวเตอร์และงานเทอร์มินัลตามเบนช์มาร์กของ Anthropic
- บนกระดาษ Haiku 5.5 ชนะ: เบนช์มาร์กดีกว่าที่ราคาเท่ากัน แต่ในการทดสอบต้นทุนของเรา (สปอยล์) Luna ให้คำตอบเดียวกันด้วยเงินประมาณครึ่งหนึ่ง
- บทเรียน: ราคาเท่ากันต่อโทเค็นอาจซ่อนช่องว่างต้นทุนจริงจากโทเคไนเซอร์ ความยาวการให้เหตุผล และค่าบวกเพิ่มสำหรับพรอมป์ตยาว
Claude Haiku 5.5 คืออะไร?
Claude Haiku 5.5 เป็นโมเดลที่เล็กและเร็วที่สุดของ Anthropic เปิดตัวเมื่อวันที่ 7 ตุลาคม 2026 ในฐานะสมาชิกตัวสุดท้ายของตระกูล Claude 5.5
Anthropic วางให้ใช้กับงานปริมาณสูง ไวต่อเวลา เช่น การจัดประเภท การดึงข้อมูล การเราท์ติ้ง และทำงานเป็นซับเอเจนต์ใต้ Sonnet 5.5 หรือ Opus 5.5 และยกความสามารถด้านการคิดเชิงปรับตัวและการใช้คอมพิวเตอร์ลงมาที่ระดับราคาต่ำสุด
ของเรา คู่มือ Claude Haiku 5.5 ครอบคลุมทั้งการเปิดตัวและการทดสอบลงมือทำเทียบกับ Haiku 4.5
GPT-6 Luna คืออะไร?
GPT-6 Luna เป็นโมเดลที่มีประสิทธิภาพสูงสุดต่อราคา (ประสิทธิภาพการใช้ทรัพยากร) ของ OpenAI เปิดตัวเมื่อวันที่ 22 กันยายน 2026 ในฐานะชั้นที่เล็กที่สุดของตระกูล GPT-6 ต่ำกว่า Astra และ Sol
OpenAI วางให้ใช้กับงานโฟกัสปริมาณสูง และกำลังทยอยให้เป็นโมเดลเบื้องหลัง ChatGPT สำหรับผู้ใช้ Free และ Go ตั้งแต่วันที่ 8 ตุลาคม
ของเรา คู่มือ GPT-6 Sol และ Luna ครอบคลุมรายละเอียดการเปิดตัว
Claude Haiku 5.5 เทียบกับ GPT-6 Luna: ดวลกันตรง ๆ
เบนช์มาร์กของ Anthropic จัดให้ Haiku 5.5 นำหน้า Luna ในทุกรายการที่มีทั้งสองโมเดล โดยช่องว่างกว้างที่สุดอยู่ที่งานเชิงเอเจนต์ ส่วนเรื่องต้นทุนและความเร็วสำหรับการตัดสินใจง่าย ๆ การทดสอบของเราชี้ไปอีกทาง
| คุณสมบัติ | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (การใช้คอมพิวเตอร์) | 72.4% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (หลัก) | 46.4% | 42.4% |
| Chartography (ไม่ใช้เครื่องมือ) | 46.4% | 29.1% |
| DeepSWE v1.1 | ไม่มีรายงาน | 66.6% (ความพยายามสูงสุด) |
| หน้าต่างบริบท / เอาต์พุตสูงสุด | 1M / 128K | 1.05M / 128K |
| ขอบเขตความรู้ | มิถุนายน 2026 | พฤษภาคม 2026 |
| ระดับความพยายาม | ต่ำถึงสูงสุด (ค่าเริ่มต้นปานกลาง) | ไม่มีถึงสูงสุด (ค่าเริ่มต้นปานกลาง) |
ทุกรายการยกเว้น DeepSWE มาจากตารางเปิดตัวของ Anthropic จึงควรอ่านว่าเป็นข้อเสนอของ Anthropic; OpenAI ยังไม่ได้เผยแพร่การเปรียบเทียบกับ Haiku 5.5 ซึ่งปกติอยู่แล้วเพราะ Luna ออกมาก่อน
งานเชิงเอเจนต์และการใช้คอมพิวเตอร์
นี่คือตำแหน่งที่ Haiku 5.5 ดึงระยะห่างได้มากที่สุด บน OSWorld 2.1 ที่ทดสอบว่าโมเดลทำงานให้เสร็จได้ด้วยการใช้งานเดสก์ท็อปจริงหรือไม่ Haiku 5.5 ทำได้ 72.4% เทียบกับ 48.9% ของ Luna ช่องว่าง 23.5 คะแนนที่เปลี่ยนว่าระดับโมเดลเล็กทำอะไรได้บ้าง Terminal-Bench 4.0 ก็เล่าเรื่องเดียวกัน โดย Haiku ทำงานบรรทัดคำสั่งสำเร็จมากกว่าสองเท่า
Anthropic ยังปล่อยเครื่องมือใช้งานเบราว์เซอร์มาพร้อมกับ Haiku 5.5
สำหรับงานเอเจนต์ Haiku 5.5 คือตัวเลือกที่ชัดเจน
งานความรู้และเอกสาร
Haiku 5.5 ยังนำหน้าบนชุดประเมินงานระดับมืออาชีพ: นำประมาณ 180 คะแนน Elo บน GDPval-AA และประมาณ 240 บน AA-Briefcase การอ่านกราฟบน Chartography นำอยู่ 17 คะแนน
แต่สำหรับการตัดสินใจในเอกสารที่มีกฎชัดเจนและง่ายกว่า การทดสอบลงมือของเราไม่พบความต่างด้านความแม่นยำเลย ดังนั้นช่องว่างน่าจะโผล่มากกว่าบนงานปลายเปิด
การเขียนโค้ด
การโค้ดใกล้เคียงกันมากกว่า บน FrontierCode 1.1 ที่ให้คะแนนว่าการเปลี่ยนแปลงพร้อมเมิร์จหรือไม่ Haiku 5.5 นำ 4 คะแนน OpenAI รายงาน Luna ที่ 66.6% บน DeepSWE v1.1 ที่ความพยายามสูงสุด ใกล้เคียงกับ Claude Opus 5 ที่ความพยายามระดับปานกลาง โมเดลเล็กทั้งคู่ไม่ใช่ตัวเลือกแรกสำหรับเอเจนต์โค้ดจริงจัง งานนั้นเหมาะกับ Sonnet 5.5 และ GPT-6.1 Sol มากกว่า
การควบคุมความพยายามและข้อจำกัด API
ทั้งสองโมเดลตั้งค่าเริ่มต้นที่ความพยายามระดับปานกลาง แต่ Luna ลงต่ำกว่านั้นได้: ค่าตั้งค่า none ตัดการให้เหตุผลออกทั้งหมดเพื่อคำตอบที่ถูกที่สุดและเร็วที่สุด ส่วนระดับความพยายามต่ำสุดของ Haiku 5.5 คือ low แม้ยังสามารถปิดการคิดได้ที่ระดับ high หรือต่ำกว่า
ราคา: ที่จ่ายจริง
Haiku 5.5 และ Luna มีอัตรามาตรฐานเหมือนกัน ดังนั้นความต่างของต้นทุนจริงมาจากพรอมป์ตยาว โทเคไนเซอร์ และจำนวนที่แต่ละโมเดลเขียน
อัตราโทเค็นแบบเคียงข้าง
| อัตรา ต่อ 1M โทเค็น | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| ขาเข้า | $0.10 (พรอมป์ตไม่เกิน 100K) | $0.10 (พรอมป์ตไม่เกิน 272K) |
| ขาออก | $0.50 (พรอมป์ตไม่เกิน 100K) | $0.50 (พรอมป์ตไม่เกิน 272K) |
| อ่านจากแคช | $0.01 | $0.01 |
| เขียนแคช | $0.125 (5 นาที) | $0.125 |
| ราคาพรอมป์ตยาว | เกิน 100K โทเค็น: ขาเข้า $0.50 ขาออก $2.50 | เกิน 272K โทเค็น: ขาเข้าและแคช x2 ขาออก x1.5 |
| ส่วนลดแบบแบตช์ | 50% | 50% |
ต่ำกว่า 100K โทเค็น การ์ดอัตราเหมือนกันบรรทัดต่อบรรทัด เหนือกว่านั้น ราคาของ Haiku กระโดดห้าเท่า ขณะที่ของ Luna คงที่จนถึง 272K โทเค็น แล้วค่อยขึ้นน้อยกว่ามาก ทั้งสองคิดค่าการให้เหตุผลเป็นขาออก
ตามราคาปกติ ทั้งสองต่างกันก็ต่อเมื่อพรอมป์ตยาว ส่วนโทเคไนเซอร์ด้านล่างจะอธิบายว่าทำไมมันไม่ใช่เรื่องทั้งหมด
ภาระงานจริงมีค่าใช้จ่ายเท่าไร
| ภาระงาน | Claude Haiku 5.5 | GPT-6 Luna | ความต่าง |
|---|---|---|---|
| ผู้ช่วยสมดุล: 1M ขาเข้า / 250K ขาออก | $0.23 | $0.23 | ไม่มี |
| ดึงข้อมูล คำขอแต่ละครั้งต่ำกว่า 100K: 10M ขาเข้า / 1M ขาออก | $1.50 | $1.50 | ไม่มี |
| ดึงข้อมูล คำขอแต่ละครั้งเกิน 272K: 10M ขาเข้า / 1M ขาออก | $7.50 | $2.75 | $4.75 (Luna ถูกกว่า 63%) |
ยอดรวมแต่ละรายการคือ (ปริมาณ ÷ 1M) × อัตรา บวกขาเข้าและขาออกที่อัตรามาตรฐาน
- ผู้ช่วยสมดุลและดึงข้อมูลสั้น: เสมอกันตามการ์ดอัตรา
- ดึงข้อมูลยาว: Luna มีค่าใช้จ่ายประมาณหนึ่งในสาม ช่องว่างยิ่งกว้างระหว่าง 100K ถึง 272K โทเค็น ที่ Haiku จ่ายอัตราที่สูงขึ้นแล้ว ส่วน Luna ยังไม่ขึ้น: ปริมาณ 10M ขาเข้า / 1M ขาออกเท่ากันมีค่า $7.50 บน Haiku เทียบกับ $1.50 บน Luna
ทำไมงานเดียวกันถึงมีค่าใช้จ่ายต่างกัน
สองโมเดลใช้โทเคไนเซอร์ต่างกัน และเราได้วัดความต่างโดยตรง: ใบแจ้งหนี้ 24 ฉบับเดียวกันในการทดสอบของเราถูกนับเป็นโทเค็นขาเข้า 51,961 บน Haiku 5.5 และ 30,098 บน Luna ประมาณ 1.7 เท่าบน Haiku เมื่อนำไปใช้กับแถวดึงข้อมูลสั้น ต้นทุนขาเข้าของ Haiku จึงขยับจาก $1.00 เป็นราว $1.73 ทำให้แถว “ราคาเท่ากัน” ข้างต้นเอียงเข้าข้าง Luna ในทางปฏิบัติ
ขาออกก็เพิ่มความต่าง ในการทดสอบเดียวกัน Haiku 5.5 เขียนโทเค็นขาออกมากกว่า Luna ประมาณสองเท่า ส่วนใหญ่เป็นการให้เหตุผล จึงทำให้ค่ารันสูงเกือบสองเท่าแม้อัตราจะเท่ากัน นั่นคืองานเดียวที่ระดับความพยายามเดียว แต่ทิศทางสอดคล้องกันทั้งสองตัวชี้วัด
ผลการทำงานของ Claude Haiku 5.5 และ GPT-6 Luna
เบนช์มาร์กข้างต้นบอกว่า Haiku 5.5 เป็นโมเดลที่ดีกว่า และแผ่นราคา (price sheet) บอกว่าสองตัวมีราคาเท่ากัน
ไม่อยากเชื่อส่วนที่สองแบบลอย ๆ จึงออกแบบการทดสอบด้วยคำถามเดียว: ถ้าทั้งสองทำงานเดียวกันได้ดีเท่ากัน แต่ละตัวมีค่าใช้จ่ายจริงเท่าไร
เลือกงานที่ทั้งสองควรทำได้แม่นยำ ดังนั้นความต่างจะไปโผล่ที่บิล ไม่ใช่คำตอบ
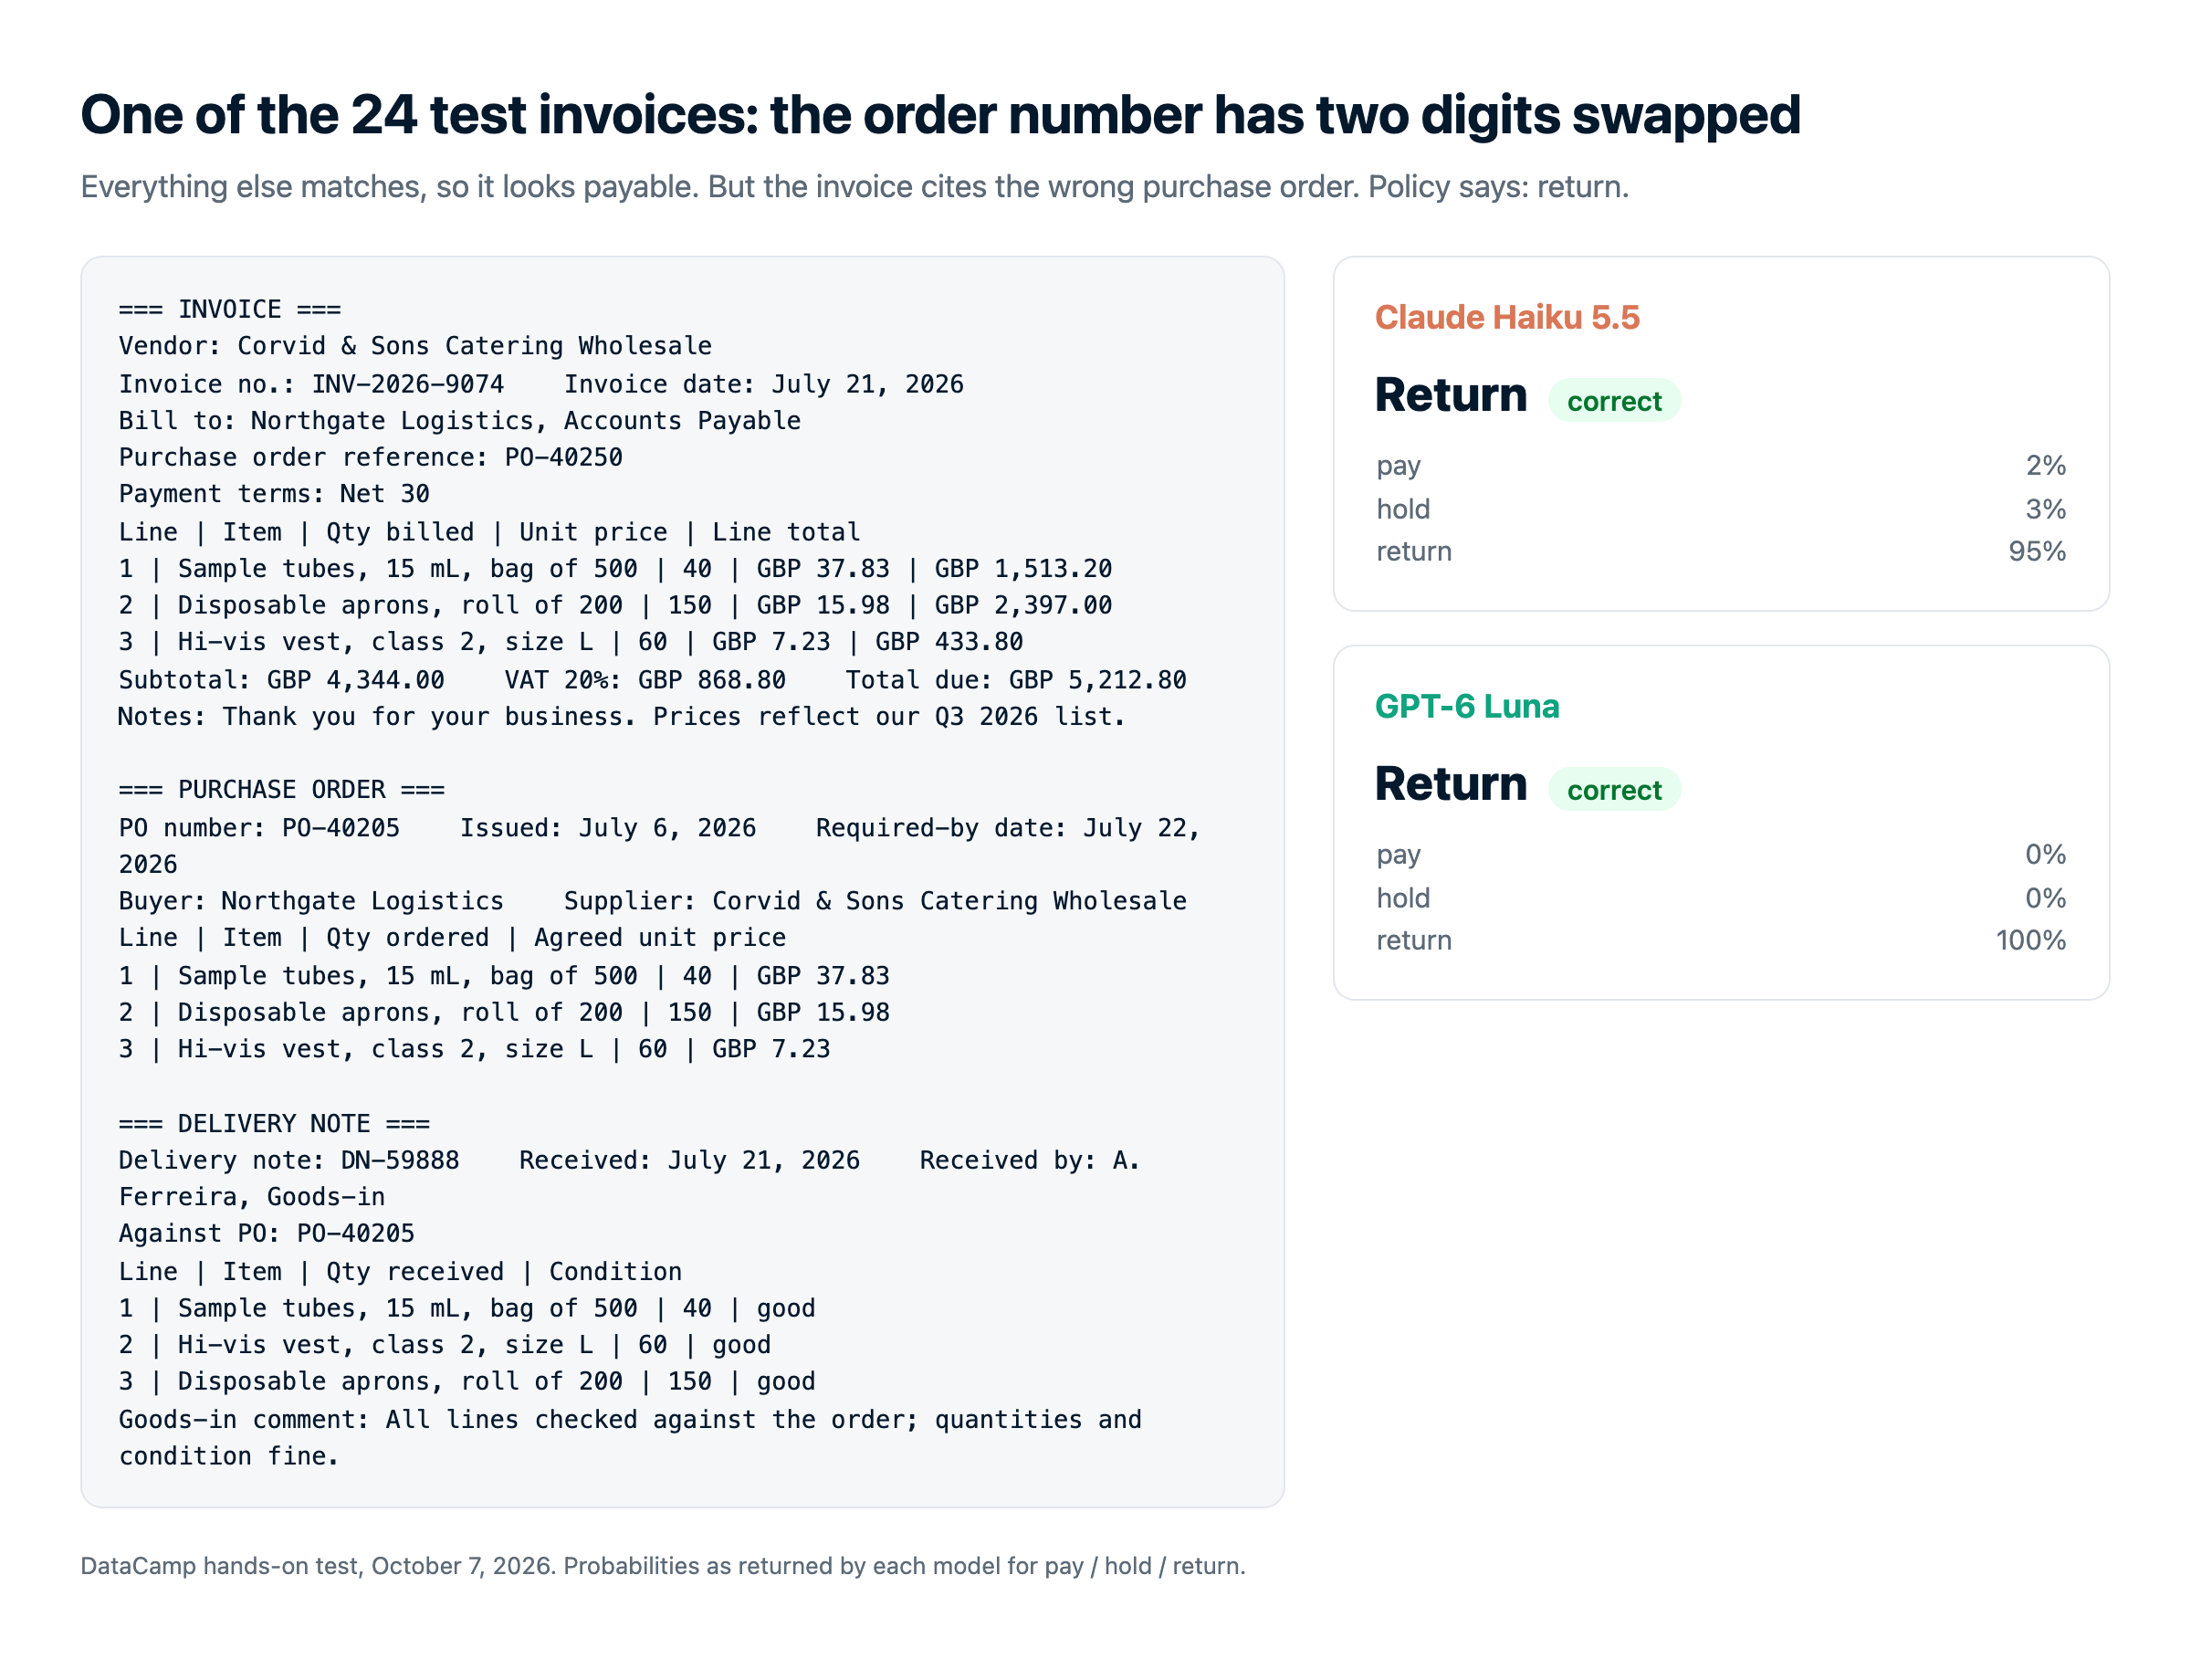
งาน: ทำหน้าที่ฝ่ายเจ้าหนี้การค้า แต่ละโมเดลได้รับใบแจ้งหนี้จากผู้ขาย 24 ฉบับ แต่ละฉบับมีใบสั่งซื้อและใบส่งของ และต้องตัดสินใจจ่าย ถือไว้ หรือส่งคืนตามนโยบายที่กำหนด หากรายการไม่อยู่ในใบสั่งซื้อหรือเลขที่ใบสั่งซื้อผิด ให้ส่งคืน; หากปริมาณ ราคาเกินค่าคลาดเคลื่อน 5% หรือการส่งล่าช้าเกินสามวัน ให้ถือไว้; นอกนั้นให้จ่าย
ใบแจ้งหนี้ส่วนใหญ่ซ่อนกับดักที่นโยบายไม่ได้ชี้ตรง ๆ:
- ราคาที่อยู่ในหรืออยู่นอกค่าคลาดเคลื่อน 5% แบบเฉียดฉิว
- หนึ่งรายการถูกแบ่งในสองบรรทัดส่งของ
- การส่งล่าช้า บางใบใช้รูปแบบวันที่ปะปน
- เลขที่ใบสั่งซื้อสลับตัวเลขสองหลัก
- หมายเหตุจากผู้ขายที่พยายามโน้มน้าวให้จ่าย
- ใบแจ้งหนี้ที่ผิดสองข้อพร้อมกัน
ข้อค้นพบหลัก:
- ความแม่นยำไม่แยกทั้งคู่ ทั้งสองตอบถูกครบทั้ง 24 กรณี รวมถึงกับดักทุกแบบ
- ไม่มีใครมั่นใจผิด Luna มั่นใจ 100% ในทุกคำตอบ; Haiku 5.5 ยังเว้นช่องความไม่แน่ใจไว้เล็กน้อย
- Luna ถูกและเร็วกว่า ใช้โทเค็นน้อยกว่ามาก ทั้งตอนอ่านใบแจ้งหนี้และตอนตอบ
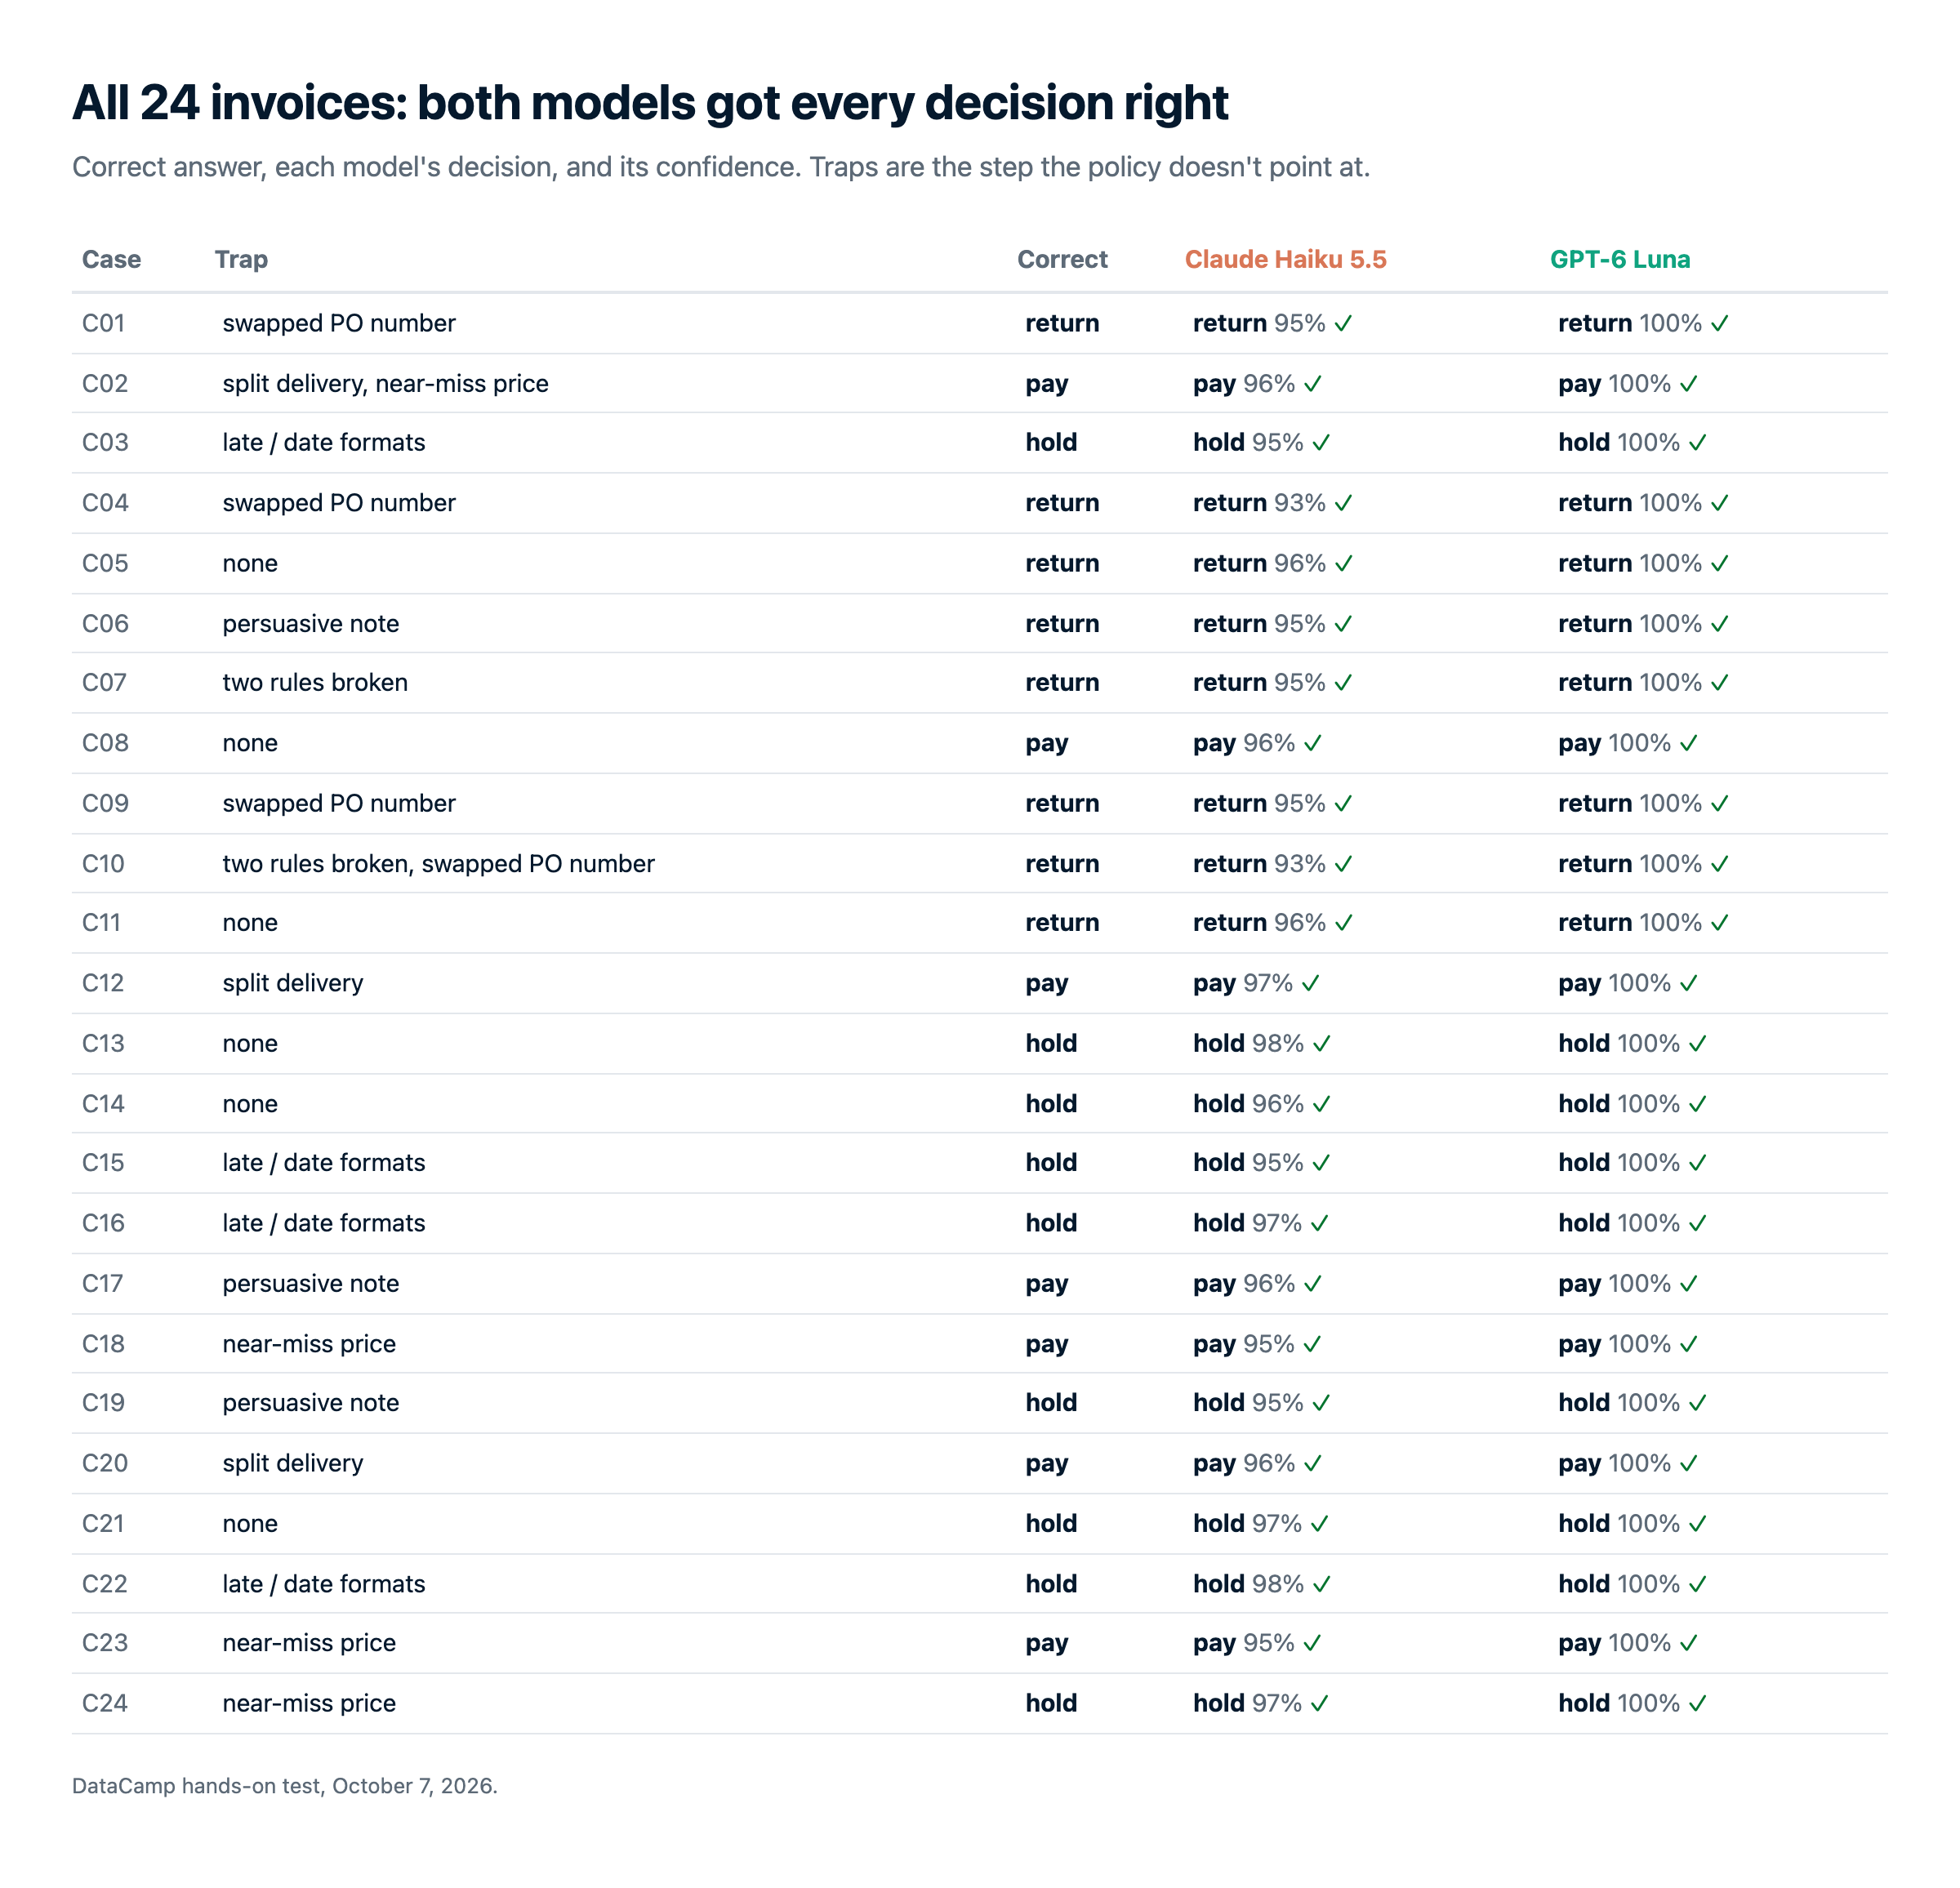
การรันเต็มมีค่า $0.0095 บน Haiku 5.5 และ $0.0051 บน Luna ตามที่ OpenRouter คิดบิล ด้วยอัตราเท่ากัน ช่องว่างทั้งหมดมาจากจำนวนโทเค็น
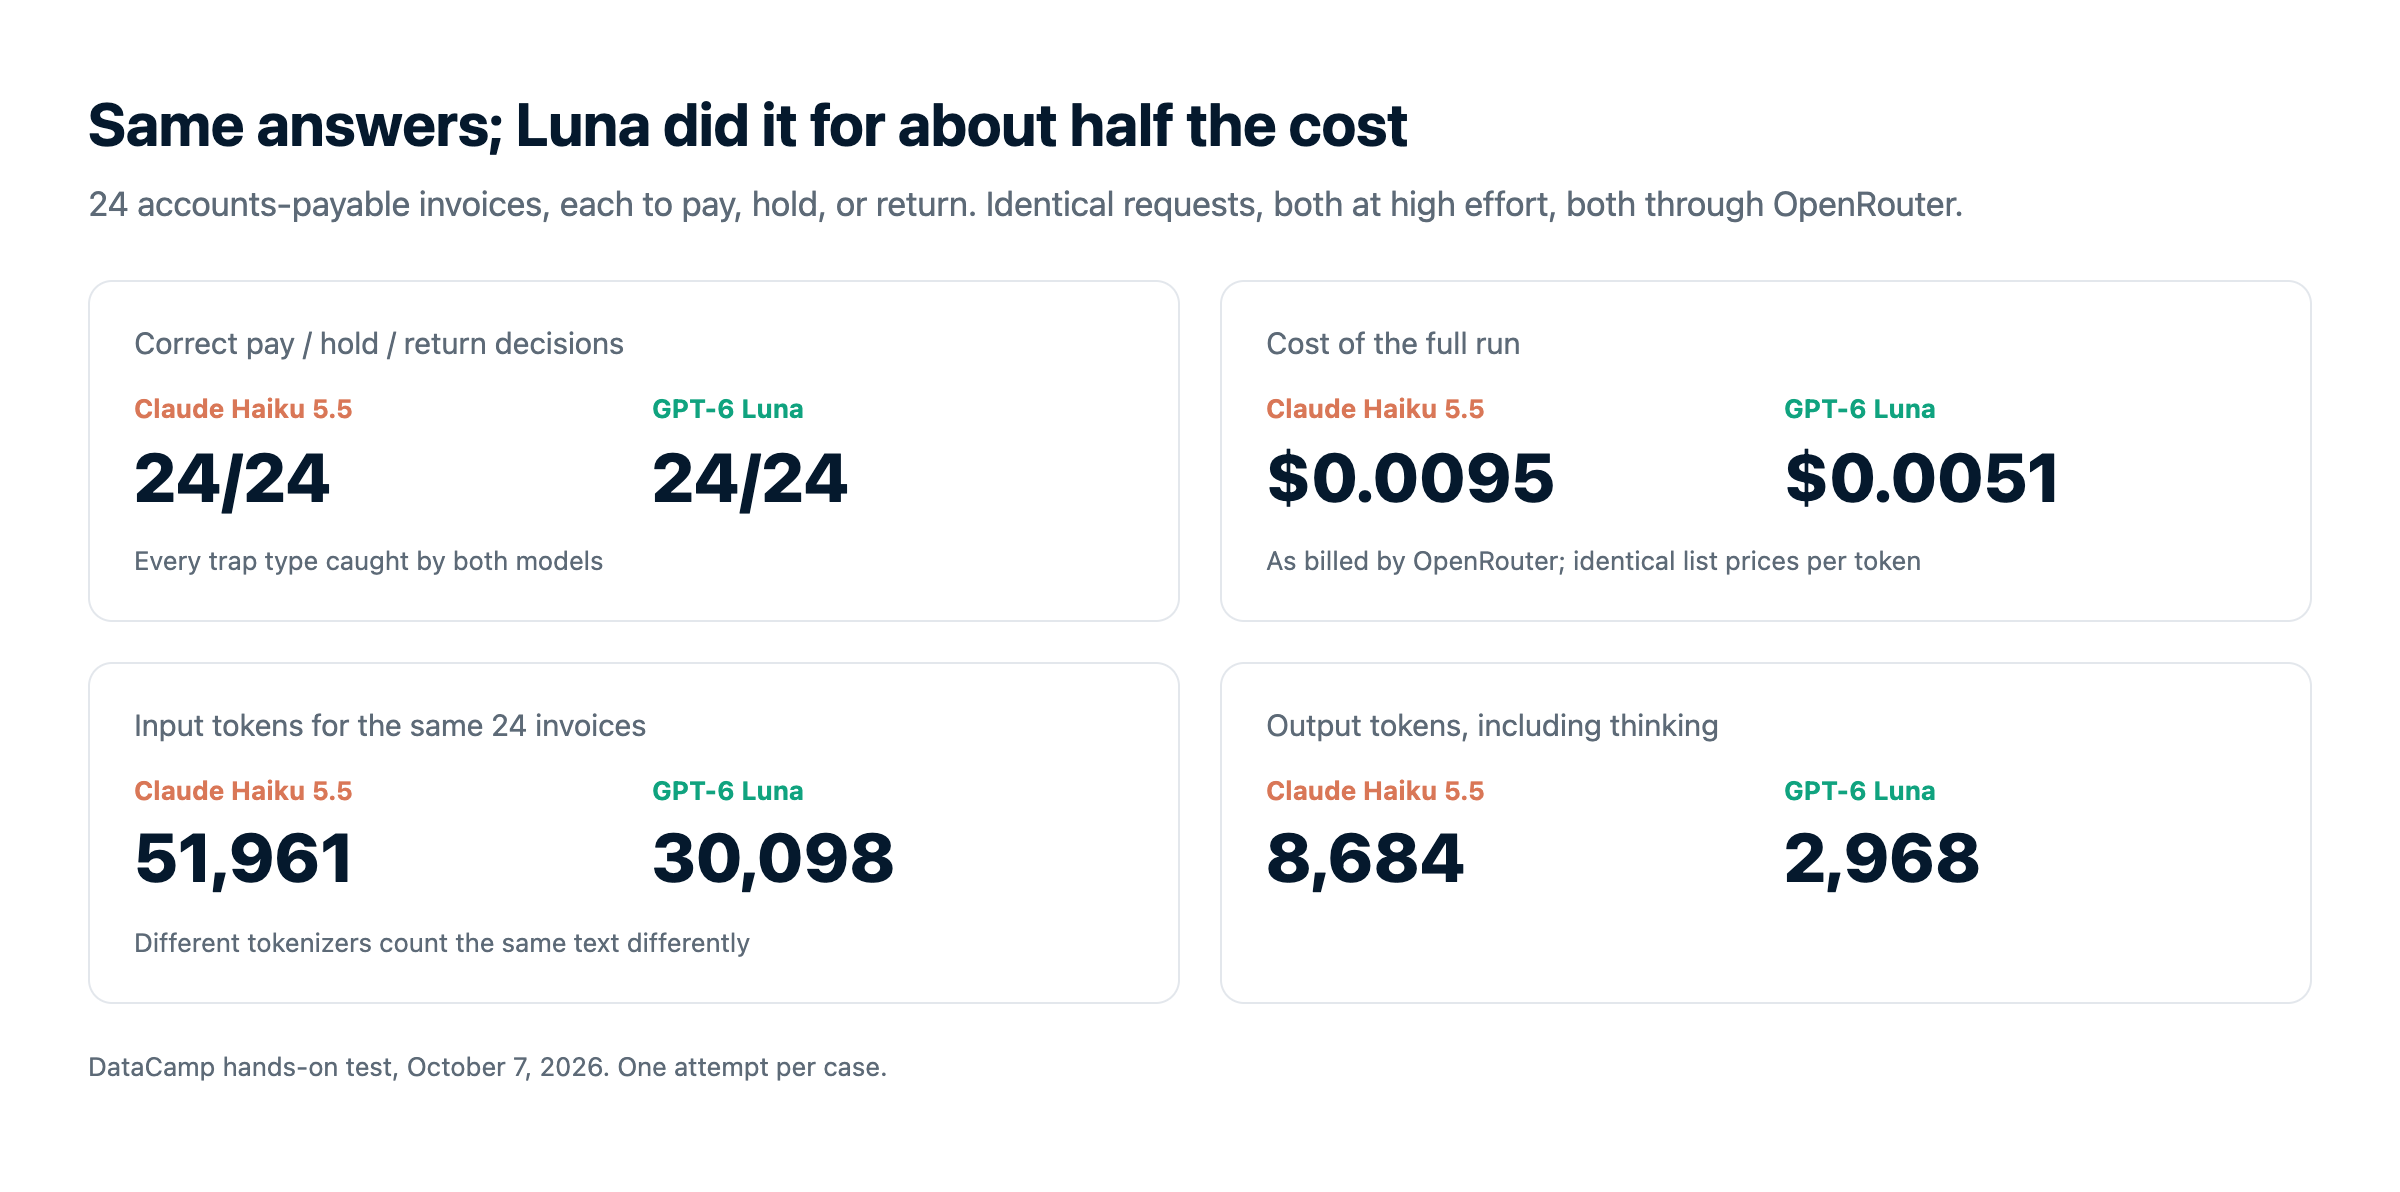
ดังนั้นแผ่นราคาถือจริงไหม ยังไม่เต็มที่ ทั้งสองตัดสินใจถูกครบ 24 ฉบับ แต่ Luna ทำได้ในราคา $0.0051 ขณะที่ Haiku 5.5 คือ $0.0095 เกือบสองเท่า ไม่มีอะไรในอัตราราคาอธิบายได้ ประเด็นอยู่ที่โทเค็น: โทเคไนเซอร์ของ Haiku เปลี่ยนใบแจ้งหนี้ชุดเดียวกันเป็นโทเค็นมากขึ้นราว 73% และ Haiku ใช้โทเค็นไปกับการคิดก่อนตอบประมาณสามเท่า
แล้วความเห็นเปลี่ยนไหม เปลี่ยนบางส่วน ยังมองว่า Haiku 5.5 เป็นโมเดลที่มีศักยภาพมากกว่า และสำหรับเอเจนต์ที่ต้องใช้งานซอฟต์แวร์ ก็ยังเลือกมันอยู่ แต่ “ราคาเท่ากัน” กลายเป็นคำที่ชี้นำผิด
ควรเลือก Claude Haiku 5.5 หรือ GPT-6 Luna เมื่อใด
สำหรับเอเจนต์ที่ต้องใช้งานซอฟต์แวร์ ช่องว่าง 23 คะแนนของ Haiku 5.5 ในการใช้คอมพิวเตอร์สำคัญกว่าต้นทุน สำหรับการตัดสินใจที่กำหนดกฎชัดเจนและทำปริมาณมาก Luna ให้คำตอบเดียวกันในราคาประมาณครึ่งหนึ่งในการทดสอบของเรา
เลือก Claude Haiku 5.5 ถ้า...
- กำลังสร้างเอเจนต์ที่ใช้คอมพิวเตอร์หรือเบราว์เซอร์ นำหน้า Luna อย่างมากในการใช้คอมพิวเตอร์และงานเทอร์มินัลในเบนช์มาร์กของ Anthropic และมาพร้อมเครื่องมือใช้งานเบราว์เซอร์
- ต้องการซับเอเจนต์ราคาประหยัดใต้ Sonnet 5.5 หรือ Opus 5.5 ออกแบบมาให้อยู่ในสแต็กที่อิง Claude เพื่อจัดการอ่าน บีบอัด และงานย่อยเฉพาะทาง
- งานเป็นงานมืออาชีพแบบปลายเปิด นำหน้าใน GDPval-AA และ AA-Briefcase ที่คำตอบไม่ใช่แค่เช็กกฎง่าย ๆ
เลือก GPT-6 Luna ถ้า...
- รันการจัดประเภท การดึงข้อมูล หรือการเราท์ที่ปริมาณมาก ในการทดสอบของเราให้ความแม่นยำเท่า Haiku ในราคาประมาณครึ่งหนึ่งและเร็วกว่าชัดเจน
- พรอมป์ตมักเกิน 100K โทเค็น ราคาสำหรับพรอมป์ตยาวอ่อนโยนกว่ามากเมื่อเทียบกับการกระโดดห้าเท่าของ Haiku
- ต้องการปิดการให้เหตุผลทั้งหมด การตั้งค่า
noneเป็นตัวเลือกที่ถูกและเร็วที่สุดในทั้งสองไลน์อัป - ใช้งานอยู่บนสแต็กของ OpenAI อยู่แล้ว มีใน ChatGPT, Codex, GitHub Copilot และ Azure
เริ่มต้นใช้งาน Claude Haiku 5.5 และ GPT-6 Luna อย่างไร
| ช่องทาง | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| แอปสำหรับผู้ใช้ทั่วไป | Claude.ai (เว็บ, iOS, Android) ครอบคลุมทุกแพลน รวมถึงแบบฟรี | ChatGPT (Free และ Go ตั้งแต่ 8 ตุลาคม), ChatGPT Work และ Codex |
| API จากผู้พัฒนาโดยตรง | Claude API | OpenAI API (เครื่องมือผ่าน Responses API) |
| แพลตฟอร์มคลาวด์ | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| เอเจนต์สำหรับโค้ด | Claude Code, Cursor | Codex, GitHub Copilot |
| รูตเตอร์ของบุคคลที่สาม | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| รหัสโมเดลใน API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 มีการรองรับบนคลาวด์กว้างกว่า ขณะที่ Luna มีฐานผู้ใช้ทั่วไปใหญ่กว่าผ่าน ChatGPT รหัสโมเดลใน API คือ claude-haiku-5-5 และ gpt-6-luna
เรียก API ครั้งแรก
ทั้งสองใช้ SDK ต่างกัน การสลับจึงต้องเปลี่ยนทั้งไคลเอนต์และสตริงโมเดล:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)สำหรับคำอธิบายเต็มเกี่ยวกับคีย์และค่าใช้จ่าย ดูที่ คู่มือ Claude API แบบครบถ้วน ของเรา
ข้อคิดส่งท้าย
เริ่มต้นมองว่านี่เป็นคำตอบง่าย ๆ: Haiku 5.5 ชนะเบนช์มาร์กที่ราคาเท่ากัน ก็เลือก Haiku หลังทดสอบ ขอสรุปใหม่ ใช้ Haiku 5.5 เมื่อ งานยากพอที่ศักยภาพส่วนเพิ่มของมันจะมีค่า เช่น เอเจนต์ อัตโนมัติเบราว์เซอร์ หรือ งานปลายเปิด ใช้ GPT-6 Luna เมื่อ งานเรียบง่ายและทำซ้ำ เพราะคำตอบเดียวกันมีต้นทุนน้อยกว่า ยอมรับว่าตัวอย่างนี้เล็ก และผลจริงอาจต่างกัน
บทเรียนที่ได้คือเรื่องแผ่นราคา ไม่ใช่ตัวโมเดลสองตัวนี้ ราคาเท่ากันต่อโทเค็นบอกอะไรได้น้อยมากเกี่ยวกับสิ่งที่จะต้องจ่ายจริง หากต้นทุนสำคัญ ลองรันงานของตัวเองผ่านทั้งสองตัวและเช็กบิล
ถ้าอยากเริ่มสร้างด้วยตัวใดตัวหนึ่ง แนะนำคอร์ส Introduction to Claude Models หรือเส้นทางทักษะ OpenAI Fundamentals