Anthropic lanserade nyligen Claude Haiku 5.5, och det var en markering mot OpenAI. Benchmarktabellen Anthropic delade placerar Haiku 5.5 före GPT-6 Luna på varje rad där båda finns med. Och Anthropic prissatte Haiku 5.5 exakt lika som OpenAI tar för Luna: $0.10 per miljon inputtokens och $0.50 per miljon outputtokens. På pappret är jämförelsen enkel. Haiku 5.5 är bättre än GPT-6 Luna och kostar lika mycket.
Det är slutsatsen. Men "samma pris per token" är inte detsamma som "samma pris per jobb". Modeller läser och skriver olika många tokens för samma uppgift. Så jag tyckte det vore kul att kolla: om jag ger båda modellerna samma jobb, kostar de verkligen lika mycket? Och om de inte gör det, skulle jag ändra uppfattning?
TL;DR
- Claude Haiku 5.5 är den mer kapabla agenten, med stora försprång inom datoranvändning och terminaluppgifter i Anthropics benchmark.
- På pappret vinner Haiku 5.5: bättre benchmark till samma pris. Men i mitt kostnadstest (spoiler), gav Luna samma svar för ungefär halva kostnaden.
- Lärdomen: Identiska per-token-priser kan dölja verkliga kostnadsskillnader från tokenizers, resonemangslängd och påslag för långa prompts.
Vad är Claude Haiku 5.5?
Claude Haiku 5.5 är Anthropics minsta och snabbaste modell, släppt den 7 oktober 2026 som den sista medlemmen i Claude 5.5-familjen.
Anthropic marknadsför den för högvolymjobb med låg latens såsom klassificering, extrahering, dirigering och som underagent under Sonnet 5.5 eller Opus 5.5, och den tar adaptivt tänkande och datoranvändning till den lägsta prisklassen.
Vår guide till Claude Haiku 5.5 täcker lanseringen och vårt praktiska test mot Haiku 4.5.
Vad är GPT-6 Luna?
GPT-6 Luna är OpenAIs mest effektiva modell, släppt den 22 september 2026 som den minsta nivån i GPT-6-familjen, under Astra och Sol.
OpenAI positionerar den för fokuserade, högvolymuppgifter, och OpenAI rullar ut den som modellen bakom ChatGPT för Free- och Go-användare från 8 oktober.
Vår guide till GPT-6 Sol och Luna täcker lanseringen.
Claude Haiku 5.5 vs. GPT-6 Luna: Direkt jämförelse
Anthropics benchmark placerar Haiku 5.5 före Luna på varje rad där båda modellerna finns, med störst skillnader på agentuppgifter. När det gäller kostnad och hastighet för enkla beslut pekade vårt eget test åt andra hållet.
| Funktion | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (datoranvändning) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46,4% | 42,4% |
| Chartography (utan verktyg) | 46,4% | 29,1% |
| DeepSWE v1.1 | Inte rapporterat | 66,6% (max ansträngning) |
| Context window / max output | 1M / 128K | 1,05M / 128K |
| Kunskapsstopp | juni 2026 | maj 2026 |
| Ansträngningsnivåer | low till max (standard medium) | none till max (standard medium) |
Varje rad utom DeepSWE kommer från Anthropics lanseringstabell, så läs det som Anthropics argument; OpenAI har inte publicerat en jämförelse mot Haiku 5.5. Det är normalt eftersom Luna kom först.
Agentarbete och datoranvändning
Här drar Haiku 5.5 ifrån mest. På OSWorld 2.1, som testar om en modell kan slutföra uppgifter genom att använda ett riktigt skrivbord, får Haiku 5.5 72,4% mot Lunas 48,9% — en skillnad på 23,5 punkter som förändrar vad en liten modell är användbar till. Terminal-Bench 4.0 visar samma mönster, där Haiku löser mer än dubbelt så många kommandoradsuppgifter.
Anthropic skickade också med ett webbläsarverktyg tillsammans med Haiku 5.5.
För agentarbete är Haiku 5.5 det tydliga valet.
Kunskapsarbete och dokument
Haiku 5.5 leder också på utvärderingar av professionella uppgifter: cirka 180 Elo-poäng före på GDPval-AA och cirka 240 på AA-Briefcase. Diagramläsning i Chartography visar en skillnad på 17 punkter.
Vid enklare, regelstyrda dokumentbeslut hittade vårt praktiska test dock ingen noggrannhetsskillnad alls, så skillnaden visar sig troligen mest i öppna uppgifter.
Kodning
Kodning är jämnare. På FrontierCode 1.1, som bedömer om ändringar är redo att mergas, leder Haiku 5.5 med 4 poäng. OpenAI rapporterar att Luna når 66,6% på DeepSWE v1.1 vid maximal ansträngning, jämförbart med Claude Opus 5 vid medium ansträngning. Ingen av de små modellerna är förstaval för seriösa kodningsagenter. Det är mer Sonnet 5.5- och GPT-6.1 Sol-territorium.
Ansträngningskontroller och API-begränsningar
Båda modellerna har medium som standard, men Luna går lägre: dess none-läge hoppar över resonemang helt för de billigaste, snabbaste svaren. Haiku 5.5:s lägsta ansträngningsnivå är low, även om du fortfarande kan stänga av tänkandet på high eller lägre.
Prissättning: vad du faktiskt betalar
Haiku 5.5 och Luna har identiska standardpriser, så de verkliga kostnadsskillnaderna kommer från långa prompts, tokenizers och hur mycket varje modell skriver.
Tokenpriser sida vid sida
| Pris, per 1M tokens | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Input | $0.10 (prompts upp till 100K) | $0.10 (prompts upp till 272K) |
| Output | $0.50 (prompts upp till 100K) | $0.50 (prompts upp till 272K) |
| Cachead inläsning | $0.01 | $0.01 |
| Cache-skrivning | $0.125 (5 minuter) | $0.125 |
| Priser för långa prompts | Över 100K tokens: $0.50 input, $2.50 output | Över 272K tokens: 2x input och cache, 1,5x output |
| Batchrabatt | 50% | 50% |
Under 100K tokens är prislistorna identiska rad för rad. Ovanför det hoppar Haikus priser femfaldigt medan Lunas ligger stilla till 272K tokens och stiger sedan betydligt mindre. Båda debiterar resonemang som output.
Till listpriserna skiljer de sig bara när prompts blir långa. Avsnittet om tokenizer nedan visar varför det inte är hela bilden.
Vad en verklig arbetslast kostar
| Arbetslast | Claude Haiku 5.5 | GPT-6 Luna | Skillnad |
|---|---|---|---|
| Balanserad assistent: 1M in / 250K ut | $0.23 | $0.23 | Ingen |
| Återhämtning, varje förfrågan under 100K: 10M in / 1M ut | $1.50 | $1.50 | Ingen |
| Återhämtning, varje förfrågan över 272K: 10M in / 1M ut | $7.50 | $2.75 | $4.75 (63% billigare på Luna) |
Varje totalsumma är (volym ÷ 1M) × pris, summerat över input och output, till standardpriser.
- Balanserad assistent och kort återhämtning: helt jämnt enligt prislistan.
- Lång återhämtning: Luna kostar cirka en tredjedel så mycket. Skillnaden är ännu större mellan 100K och 272K tokens, där Haiku redan betalar högre pris och Luna inte gör det: samma 10M in / 1M ut kostar $7.50 på Haiku mot $1.50 på Luna.
Varför samma uppgift kostar olika
Modellerna använder olika tokenizers, och vi mätte skillnaden direkt: samma 24 fakturor i vårt praktiska test räknades som 51 961 inputtokens på Haiku 5.5 och 30 098 på Luna, ungefär 1,7 gånger fler på Haiku. Applicerat på raden för kort återhämtning höjer det Haikus inputkostnad från $1.00 till ungefär $1.73, så raderna med "samma pris" ovan gynnar i praktiken Luna.
Output förstärker detta. I samma test skrev Haiku 5.5 ungefär dubbelt så många outputtokens som Luna, mestadels resonemang, vilket är varför körningen kostade nästan dubbelt så mycket trots identiska priser. Det är en uppgift vid en ansträngningsnivå, men riktningen är konsekvent över båda mätningarna.
Hur Claude Haiku 5.5 och GPT-6 Luna presterade
Benchmarkresultaten ovan säger att Haiku 5.5 är den bättre modellen, och prislistan säger att de kostar lika.
Jag ville inte ta den andra delen på tro, så jag designade ett test kring en fråga: om båda modellerna gör samma jobb lika bra, vad kostar var och en faktiskt att köra?
Jag valde ett jobb där båda borde vara träffsäkra, så att eventuella skillnader skulle synas på fakturan snarare än i svaren.
Uppgiften: agera leverantörsreskontra. Varje modell fick 24 leverantörsfakturor, var och en med sin inköpsorder och följesedel, och skulle betala, hålla eller returnera varje enligt en fast policy. Returnera om en artikel inte finns på ordern eller om ordernumret är fel; håll om en kvantitet, ett pris utanför 5% tolerans eller en leverans mer än tre dagar sen avviker; annars betala.
De flesta fakturorna dolde en fälla som policyn inte pekar ut:
- Priser precis inom eller utanför 5% tolerans
- En artikel uppdelad på två leveransrader
- Sena leveranser, vissa med blandade datumformat
- Ett ordernummer med två siffror omkastade
- Leverantörsnotiser som argumenterar för betalning
- Fakturor som bryter mot två regler samtidigt
Huvudfynden:
- Träffsäkerheten skilde dem inte åt. Båda fick alla 24 besluten rätt, inklusive varje fälla.
- Ingen var självsäkert fel. Luna var 100% säker på varje svar; Haiku 5.5 behöll några procents tvekan.
- Luna var billigare och snabbare. Den behövde betydligt färre tokens, både för att läsa fakturorna och för att svara på dem.
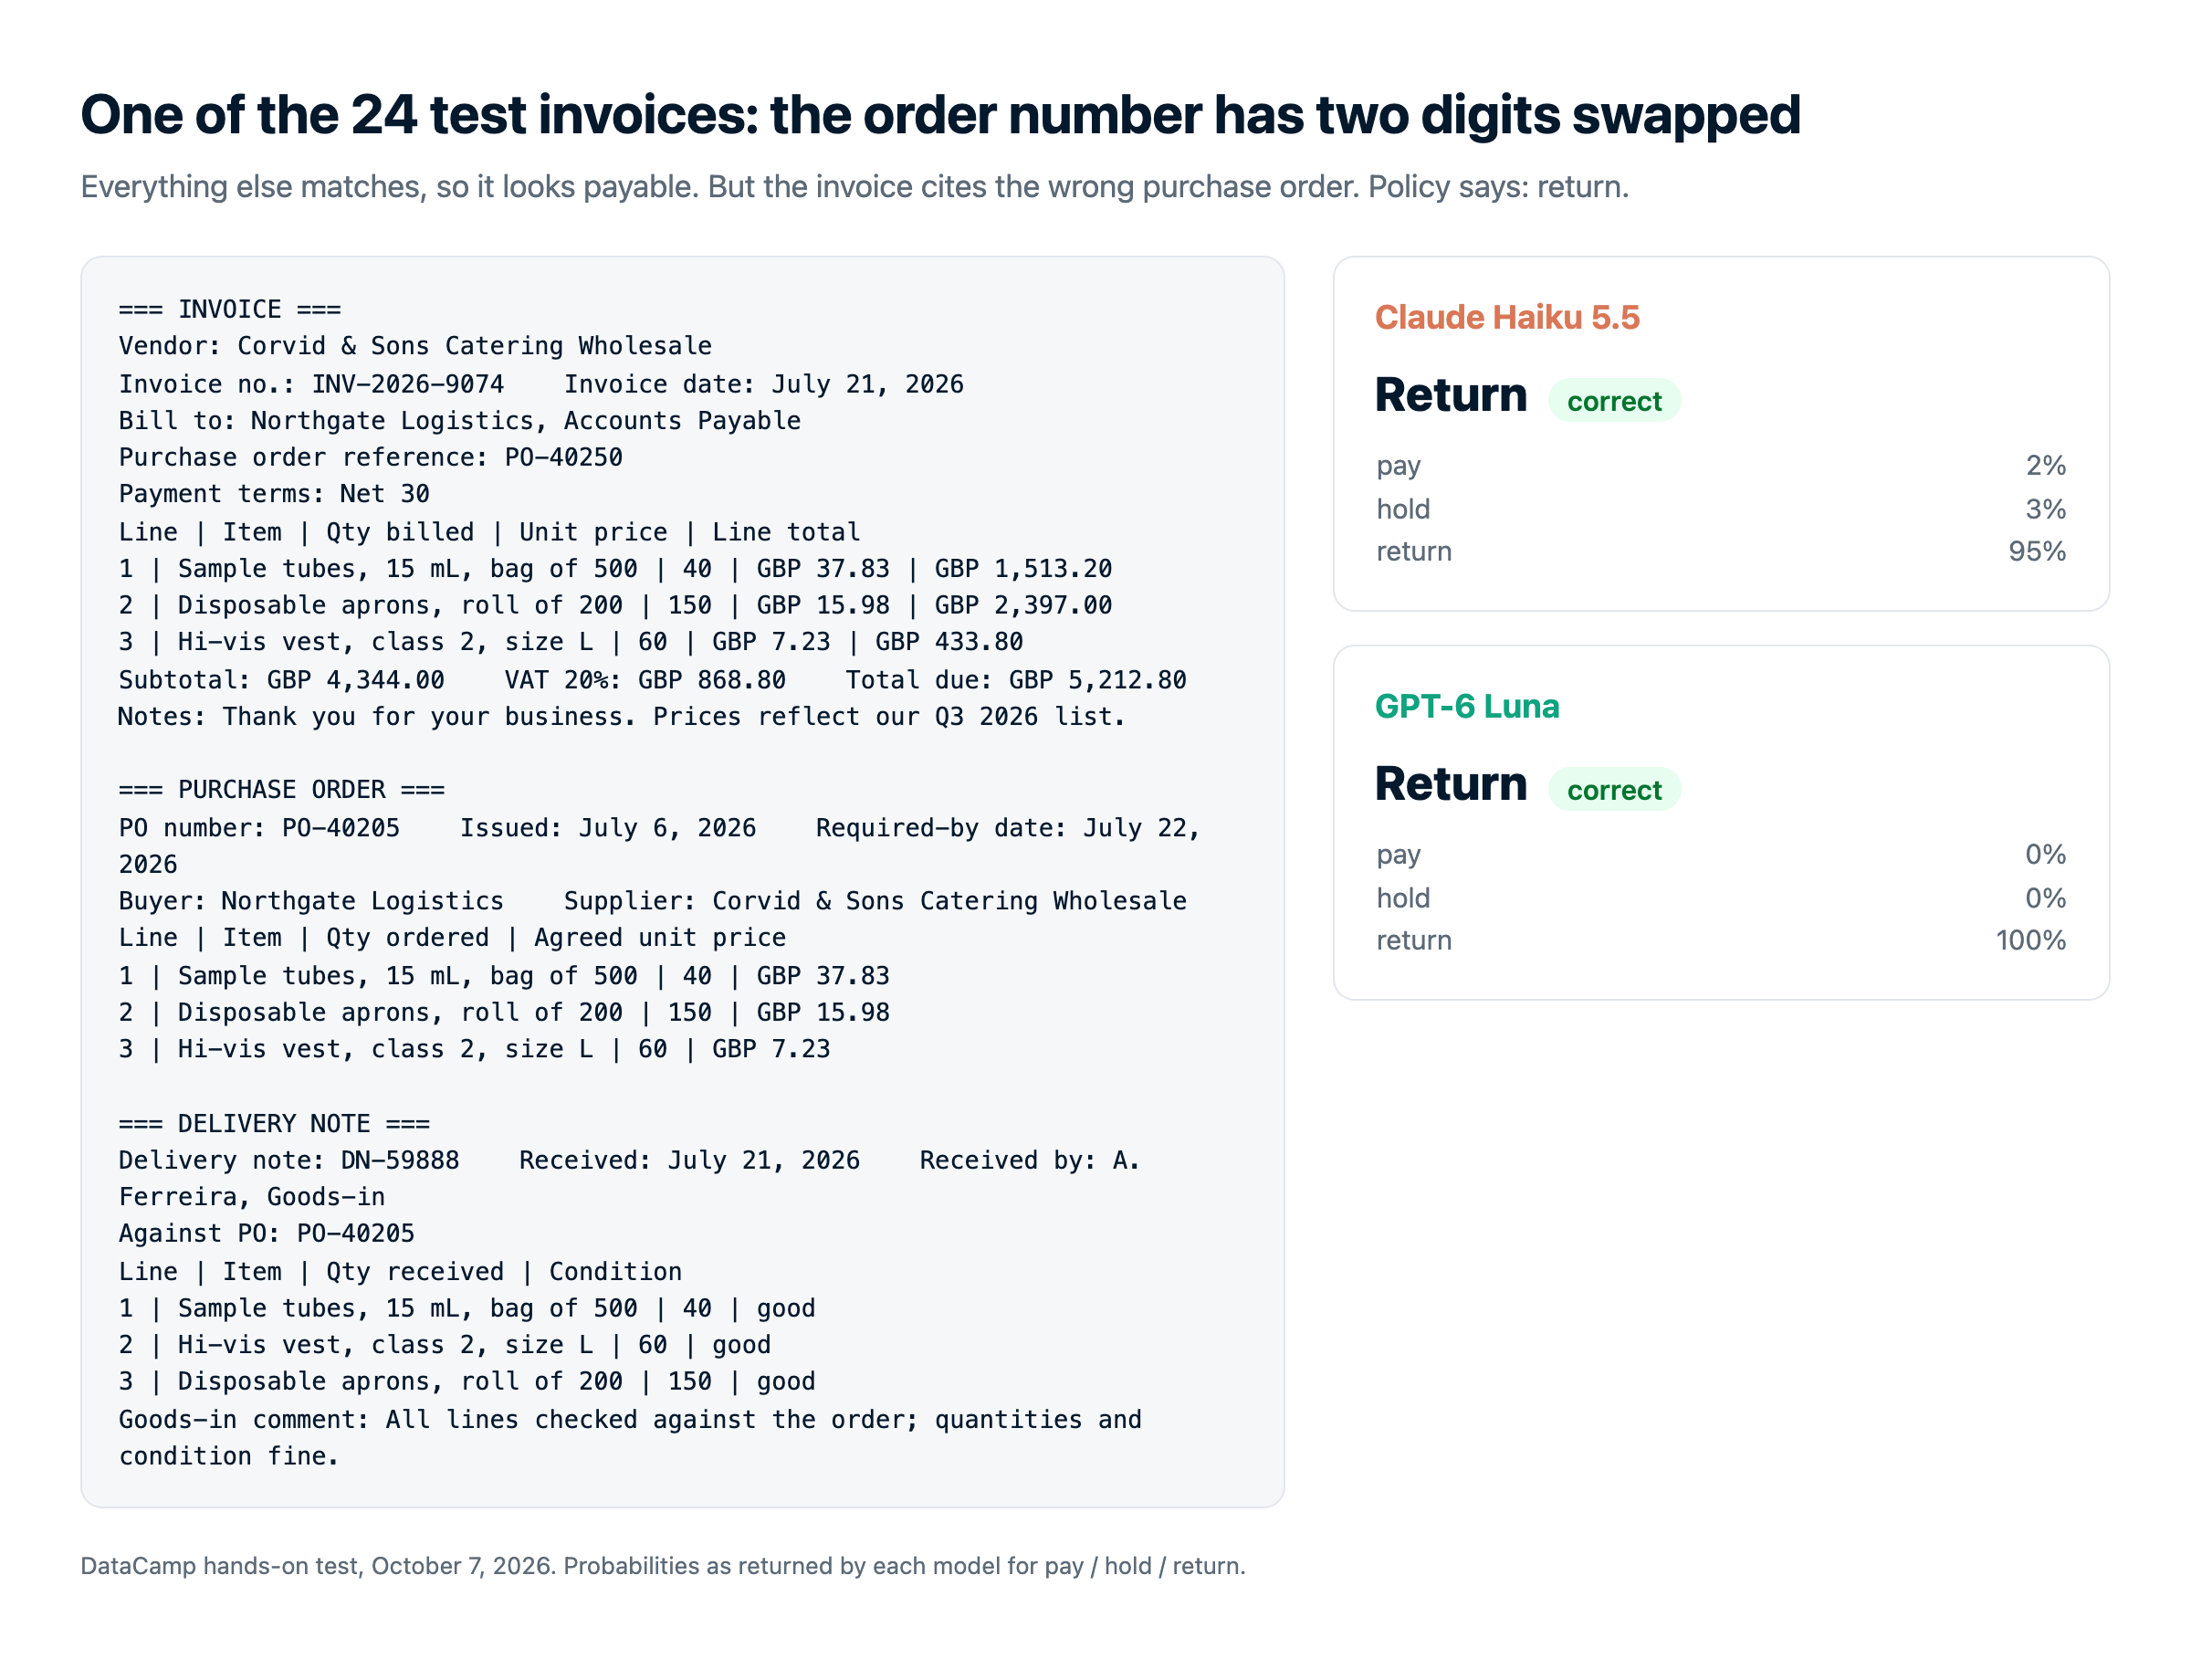
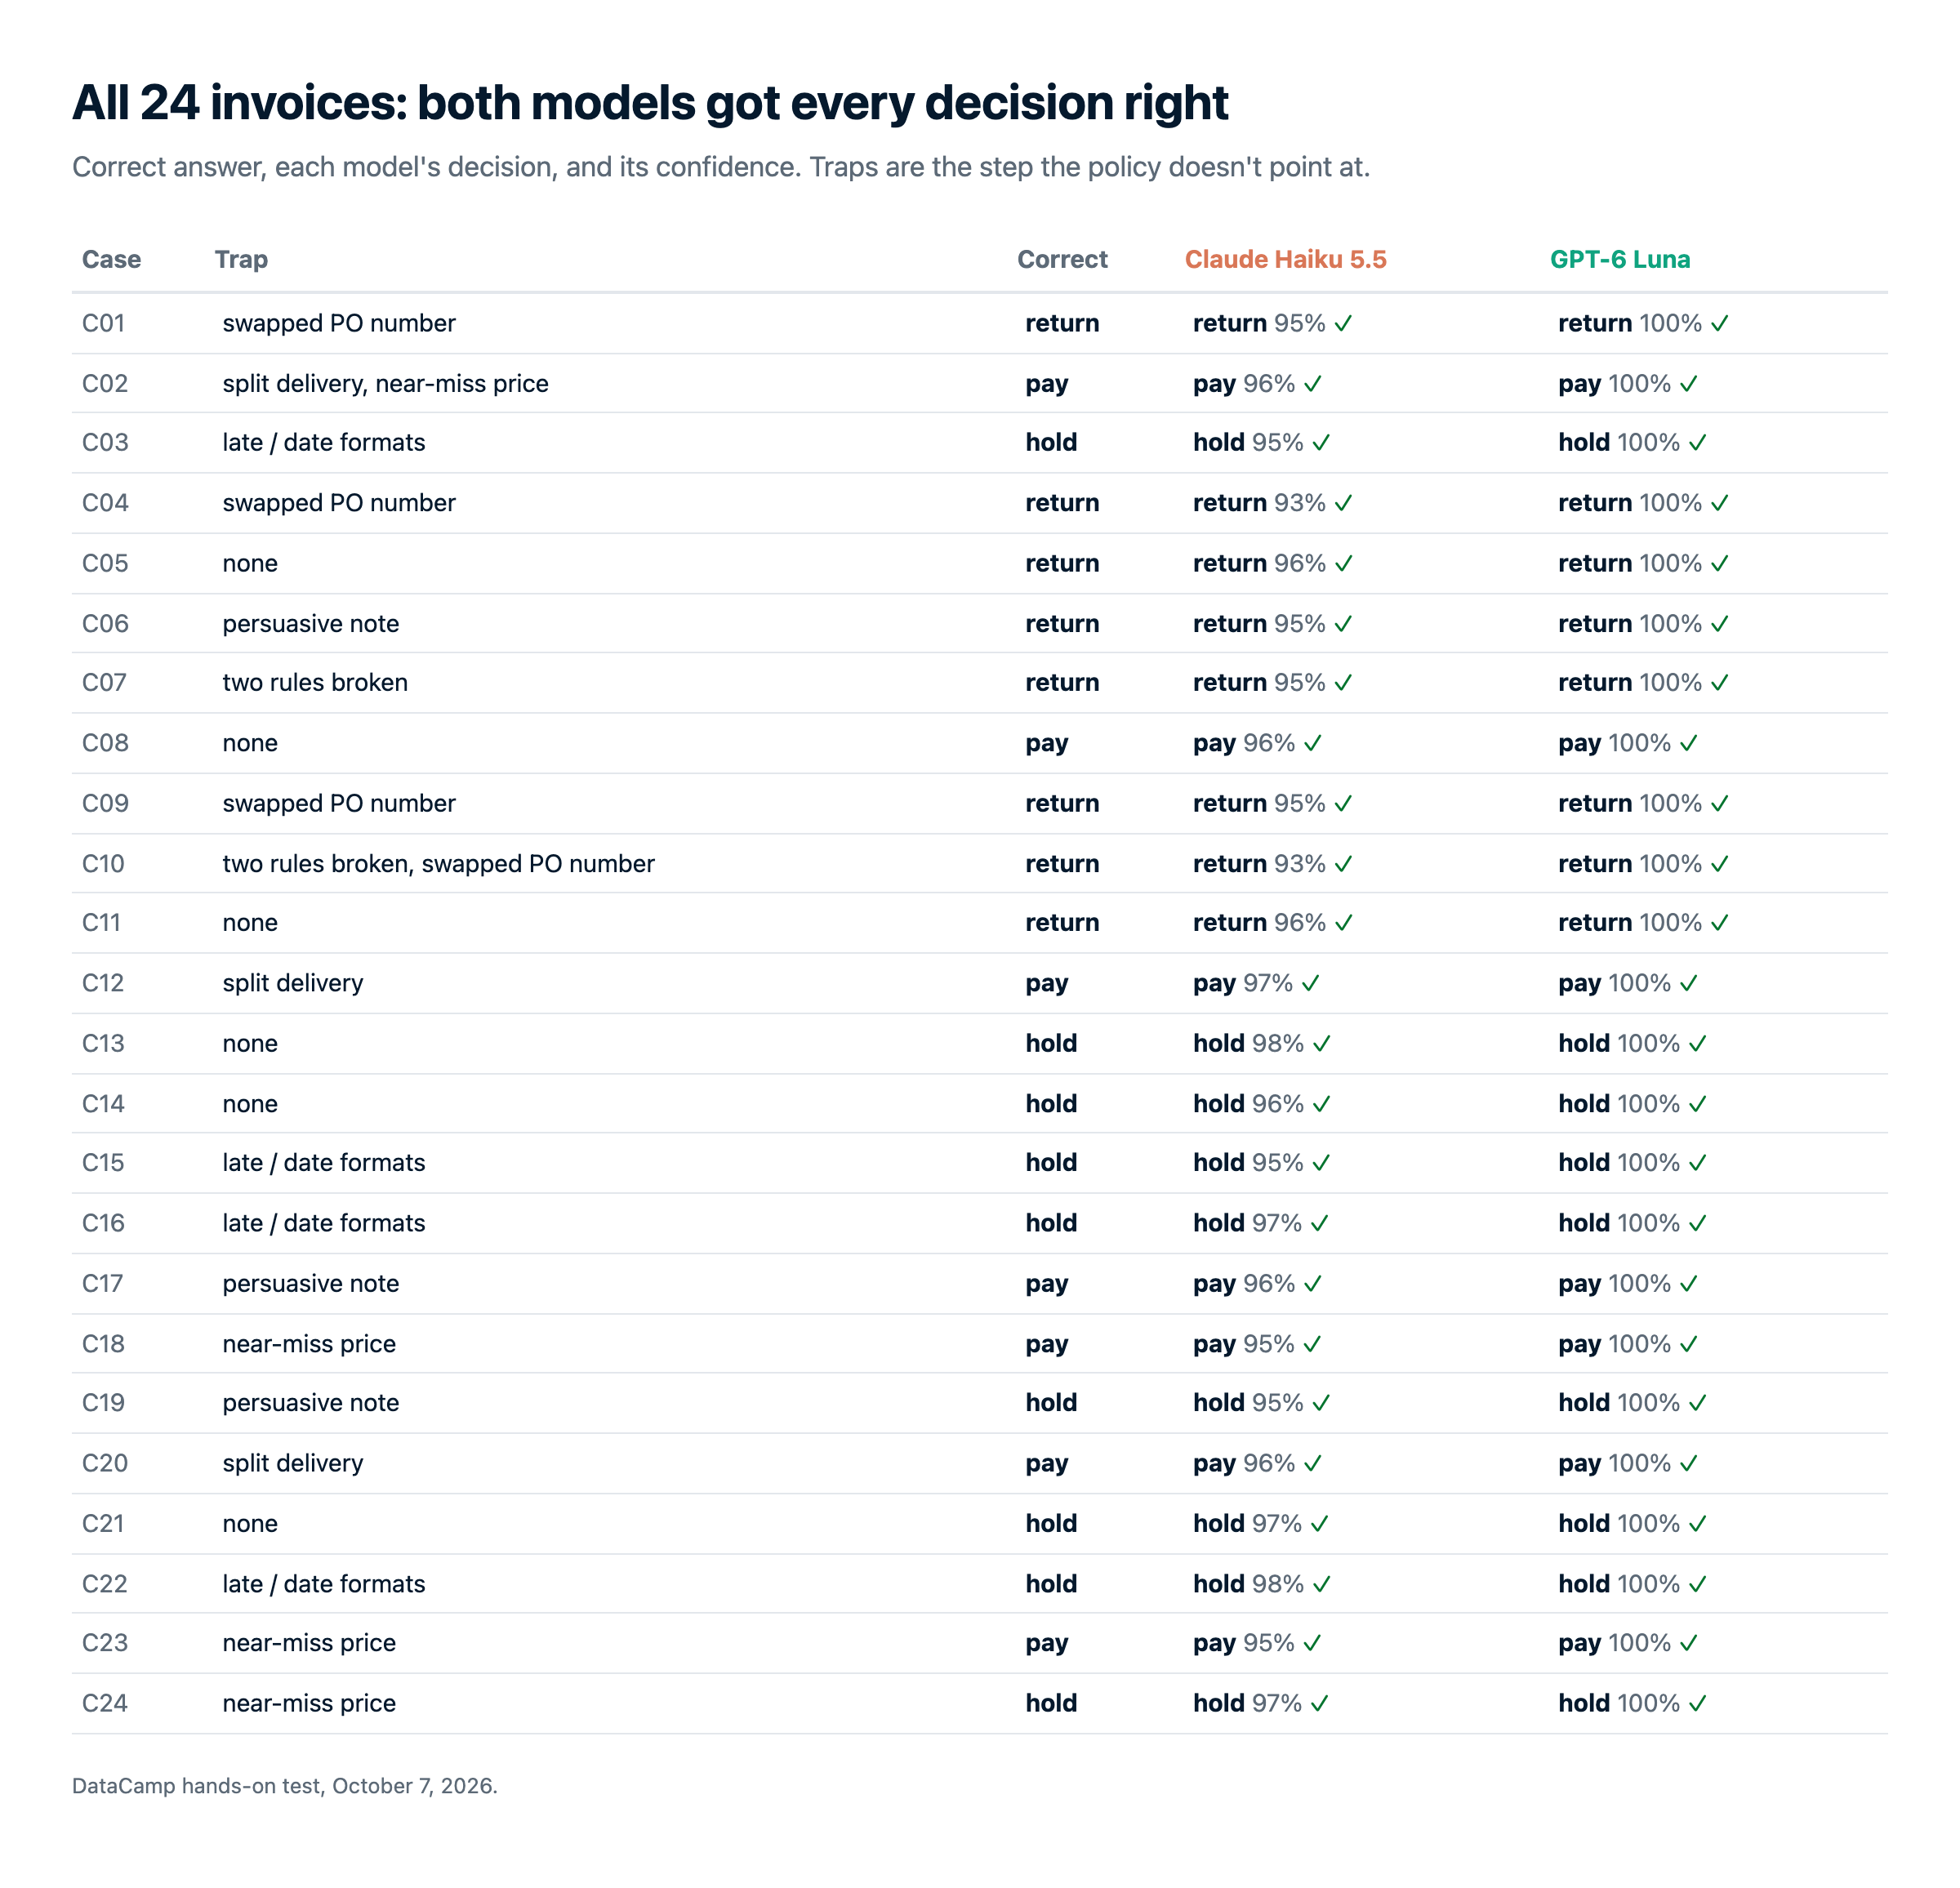
Hela körningen kostade $0.0095 på Haiku 5.5 och $0.0051 på Luna, enligt OpenRouter. Med identiska priser kommer hela skillnaden från tokens.
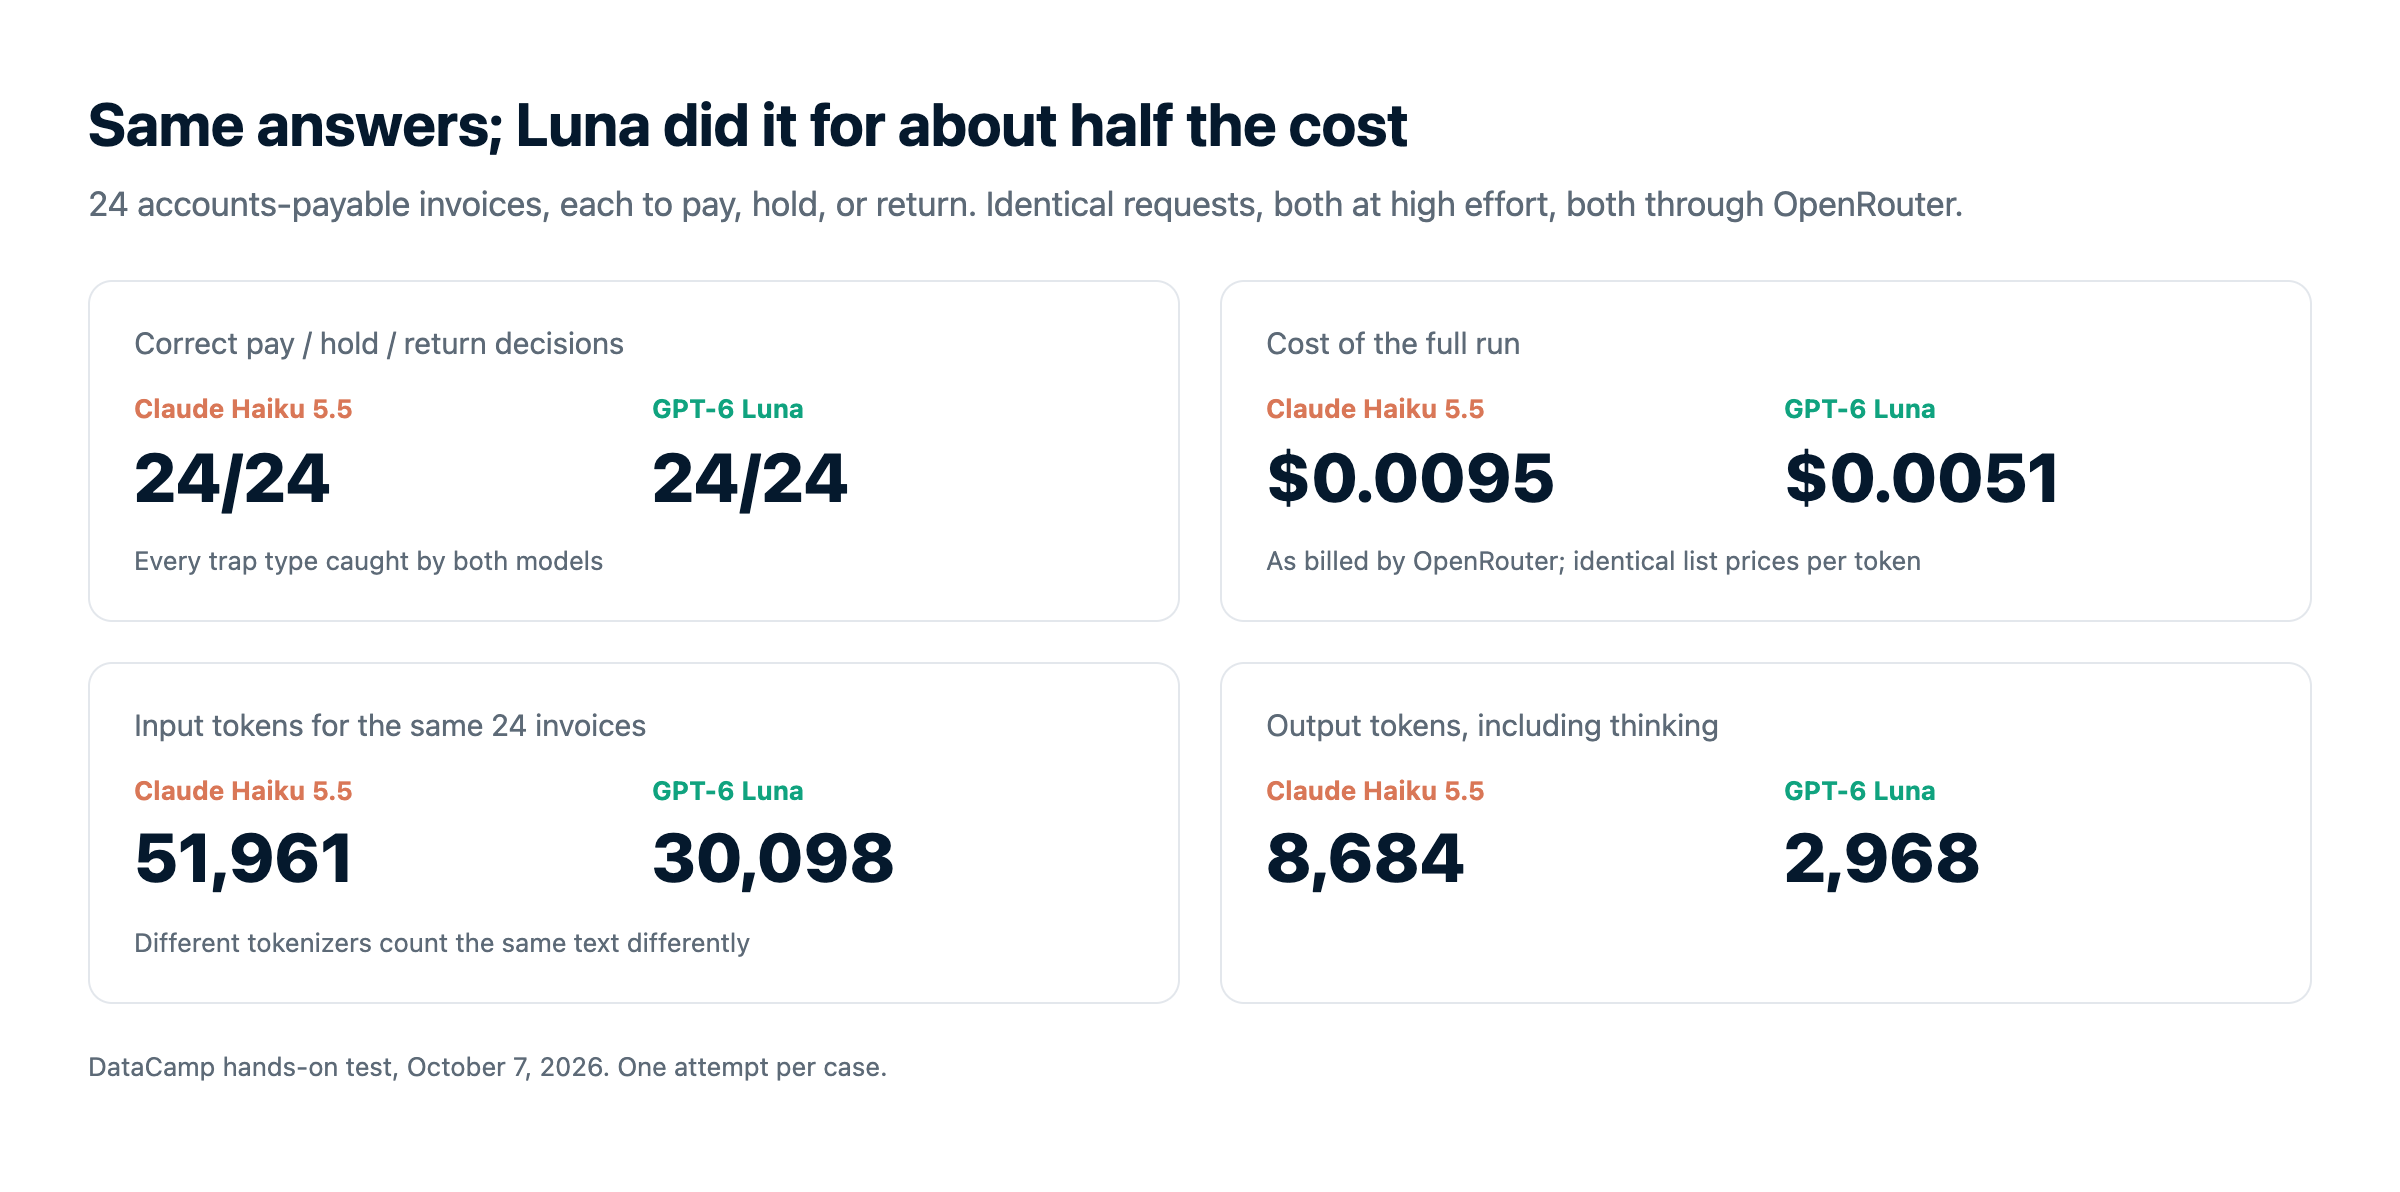
Höll prislistan? Inte riktigt. Båda modellerna gjorde alla 24 korrekta bedömningar, men Luna gjorde det för $0.0051 och Haiku 5.5 för $0.0095, nästan dubbelt. Inget i priserna förklarar det. Det handlar om tokens: Haikus tokenizer gjorde samma fakturor till cirka 73% fler tokens, och Haiku lade cirka tre gånger så många tokens på att tänka innan den svarade.
Ändrade det min uppfattning? Delvis. Jag tycker fortfarande att Haiku 5.5 är den mer kapabla modellen, och för agenter som behöver använda programvara skulle jag fortfarande välja den. Men "samma pris" visade sig vara missvisande.
När du ska välja Claude Haiku 5.5 vs GPT-6 Luna
För agenter som använder programvara väger Haiku 5.5:s försprång på 23 punkter i datoranvändning tyngre än kostnad. För väl specificerade beslut i stor skala gav Luna samma svar för ungefär halva priset i vårt test.
Välj Claude Haiku 5.5 om...
- Du bygger agenter som använder en dator eller webbläsare. Den leder Luna med bred marginal på datoranvändning och terminaluppgifter i Anthropics benchmark, och levereras med ett webbläsarverktyg.
- Du behöver en billig underagent under Sonnet 5.5 eller Opus 5.5. Den är byggd för att passa i Claude-baserade stackar och hantera läsning, komprimering och snäva deluppgifter.
- Ditt arbete är öppna professionella uppgifter. Den leder på GDPval-AA och AA-Briefcase, där svar inte är enkla regelkontroller.
Välj GPT-6 Luna om...
- Du kör klassificering, extrahering eller dirigering i stor skala. I vårt test matchade den Haikus träffsäkerhet till ungefär halva kostnaden och märkbart snabbare.
- Dina prompts går regelbundet över 100K tokens. Dess prissättning för långa prompts är betydligt mildare än Haikus femfaldiga hopp.
- Du vill stänga av resonemang helt. Dess
none-läge är det billigaste och snabbaste alternativet i någon av uppställningarna. - Du redan kör på OpenAIs stack. Den finns i ChatGPT, Codex, GitHub Copilot och Azure.
Så kommer du igång med Claude Haiku 5.5 och GPT-6 Luna
| Yta | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Konsumentapp | Claude.ai (webb, iOS, Android) i alla planer, inklusive Free. | ChatGPT (Free och Go från 8 oktober), ChatGPT Work och Codex |
| Förstaparts-API | Claude API | OpenAI API (verktyg via Responses API) |
| Molnplattformar | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Kodningsagenter | Claude Code, Cursor | Codex, GitHub Copilot |
| Tredjepartsroutrar | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| API-modell-ID | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 har bredare molnanknytning, medan Luna har större konsumentnärvaro via ChatGPT. API-modell-ID:na är claude-haiku-5-5 och gpt-6-luna.
Göra ditt första API-anrop
De använder olika SDK:er, så ett byte innebär att byta klient såväl som modellsträng:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)För en fullständig genomgång av nycklar och kostnader, se vår kompletta guide till Claude API.
Avslutande tankar
Jag började med att tänka att detta var ett enkelt val: Haiku 5.5 vinner benchmark till samma pris, så välj Haiku. Efter testet skulle jag uttrycka det annorlunda. Använd Haiku 5.5 när jobbet är tillräckligt svårt för att dess extra förmåga ska spela roll, som agenter, webbläsarautomatisering eller öppna uppgifter. Använd GPT-6 Luna när jobbet är enkelt och repetitivt, eftersom samma svar kostar mindre. Jag medger att detta var ett litet urval, och utfallet i verkligheten kommer att variera.
Lärdomen jag tar med mig handlar om prislistor, inte om dessa två modeller. Identiska per-token-priser sa mig nästan inget om vad jag faktiskt skulle betala. Om kostnad spelar roll för dig, kör din egen uppgift genom båda och kolla fakturan.
Om du är sugen på att bygga med någon av dem rekommenderar jag vår kurs Introduction to Claude Models eller kompetensspåret OpenAI Fundamentals.