Anthropic ha lanciato da poco Claude Haiku 5.5, ed è stato un colpo ad OpenAI. La tabella dei benchmark condivisa da Anthropic mette Haiku 5.5 davanti a GPT-6 Luna in ogni riga in cui compaiono entrambi. E Anthropic ha prezzato Haiku 5.5 esattamente come OpenAI prezza Luna: $0,10 per milione di token in input e $0,50 per milione di token in output. Sulla carta, il confronto è semplice. Haiku 5.5 è migliore di GPT-6 Luna e costa uguale.
Questo è il punto. Ma "stesso prezzo per token" non è lo stesso di "stesso prezzo per lavoro". I modelli leggono e scrivono numeri diversi di token per lo stesso compito. Quindi ho pensato che sarebbe stato divertente verificare: se do a entrambi i modelli lo stesso lavoro, costano davvero uguale? E se non è così, cambierei idea?
TL;DR
- Claude Haiku 5.5 è l'agente più capace, con grandi vantaggi nell'uso del computer e nei task da terminale nei benchmark di Anthropic.
- Sulla carta, vince Haiku 5.5: benchmark migliori allo stesso prezzo. Ma nel mio test sui costi (spoiler), Luna ha dato le stesse risposte a circa metà del prezzo.
- La lezione: prezzi identici per token possono nascondere vere differenze di costo dovute a tokenizer, lunghezza del ragionamento e sovrapprezzi per prompt lunghi.
Cos'è Claude Haiku 5.5?
Claude Haiku 5.5 è il modello più piccolo e veloce di Anthropic, rilasciato il 7 ottobre 2026 come ultimo membro della famiglia Claude 5.5.
Anthropic lo propone per lavori ad alto volume e sensibili alla latenza come classificazione, estrazione, instradamento e come subagent sotto Sonnet 5.5 o Opus 5.5, portando pensiero adattivo e uso del computer al gradino più basso dei prezzi.
La nostra guida a Claude Haiku 5.5 copre il lancio e il nostro test pratico contro Haiku 4.5.
Cos'è GPT-6 Luna?
GPT-6 Luna è il modello più efficiente di OpenAI, rilasciato il 22 settembre 2026 come il tier più piccolo della famiglia GPT-6, sotto Astra e Sol.
OpenAI lo posiziona per compiti mirati e ad alto volume, e lo sta distribuendo come modello dietro ChatGPT per utenti Free e Go dall'8 ottobre.
La nostra guida a GPT-6 Sol e Luna copre il lancio.
Claude Haiku 5.5 vs. GPT-6 Luna: confronto diretto
I benchmark di Anthropic mettono Haiku 5.5 davanti a Luna in ogni riga condivisa, con i divari più ampi nei task agentici. Su costi e velocità per decisioni semplici, il nostro test ha indicato il contrario.
| Feature | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (uso del computer) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46,4% | 42,4% |
| Chartography (senza strumenti) | 46,4% | 29,1% |
| DeepSWE v1.1 | Non riportato | 66,6% (max effort) |
| Finestra di contesto / output max | 1M / 128K | 1,05M / 128K |
| Knowledge cutoff | Giugno 2026 | Maggio 2026 |
| Livelli di effort | low a max (default medium) | none a max (default medium) |
Ogni riga tranne DeepSWE proviene dalla tabella di lancio di Anthropic, quindi leggila come la tesi di Anthropic; OpenAI non ha pubblicato un confronto con Haiku 5.5. È normale, dato che Luna è uscita per prima.
Lavoro agentico e uso del computer
Qui è dove Haiku 5.5 prende il vantaggio più ampio. Su OSWorld 2.1, che testa se un modello sa completare task operando un vero desktop, Haiku 5.5 segna 72,4% contro il 48,9% di Luna, un divario di 23,5 punti che cambia ciò per cui è utile un modello piccolo. Terminal-Bench 4.0 racconta la stessa storia, con Haiku che completa più del doppio dei task da riga di comando.
Anthropic ha anche rilasciato uno strumento per l'uso del browser insieme a Haiku 5.5.
Per il lavoro agentico, Haiku 5.5 è la scelta netta.
Lavoro di conoscenza e documenti
Haiku 5.5 è avanti anche nelle valutazioni su compiti professionali: circa 180 punti Elo in più su GDPval-AA e circa 240 su AA-Briefcase. La lettura di grafici su Chartography mostra un divario di 17 punti.
Sulle decisioni documentali più semplici e regolate da regole, però, il nostro test pratico non ha riscontrato differenze di accuratezza, quindi il divario probabilmente emerge soprattutto nel lavoro aperto.
Coding
Nel coding il confronto è più stretto. Su FrontierCode 1.1, che valuta se le modifiche sono pronte per il merge, Haiku 5.5 è avanti di 4 punti. OpenAI riporta Luna al 66,6% su DeepSWE v1.1 a massimo effort, paragonabile a Claude Opus 5 a effort medio. Nessuno dei due small model è la prima scelta per agent di coding seri. È più territorio da Sonnet 5.5 e GPT-6.1 Sol.
Controlli di effort e vincoli API
Entrambi i modelli predefiniscono su medium effort, ma Luna scende più in basso: la sua impostazione none salta del tutto il ragionamento per le risposte più economiche e veloci. Il livello minimo di effort di Haiku 5.5 è low, anche se puoi comunque disattivare il thinking a high o meno.
Prezzi: cosa paghi davvero
Haiku 5.5 e Luna hanno tariffe standard identiche, quindi le vere differenze di costo derivano da prompt lunghi, tokenizer e da quanto ciascun modello scrive.
Tariffe per token a confronto
| Tariffa, per 1M token | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Input | $0,10 (prompt fino a 100K) | $0,10 (prompt fino a 272K) |
| Output | $0,50 (prompt fino a 100K) | $0,50 (prompt fino a 272K) |
| Lettura input in cache | $0,01 | $0,01 |
| Scrittura cache | $0,125 (5 minuti) | $0,125 |
| Prezzi per prompt lungo | Oltre 100K token: $0,50 input, $2,50 output | Oltre 272K token: 2x input e cache, 1,5x output |
| Sconto batch | 50% | 50% |
Sotto i 100K token, le schede tariffarie sono identiche riga per riga. Sopra, i prezzi di Haiku quintuplicano mentre quelli di Luna restano piatti fino a 272K token e poi crescono molto meno. Entrambi fatturano il ragionamento come output.
A prezzi di listino, i due divergono solo quando i prompt si allungano. La sezione sui tokenizer sotto mostra perché non è tutta la storia.
Quanto costa un workload reale
| Workload | Claude Haiku 5.5 | GPT-6 Luna | Differenza |
|---|---|---|---|
| Assistant bilanciato: 1M in / 250K out | $0,23 | $0,23 | Nessuna |
| Retrieval, ogni richiesta sotto 100K: 10M in / 1M out | $1,50 | $1,50 | Nessuna |
| Retrieval, ogni richiesta oltre 272K: 10M in / 1M out | $7,50 | $2,75 | $4,75 (63% in meno su Luna) |
Ogni totale è (volume ÷ 1M) × tariffa, sommato tra input e output, a tariffe standard.
- Assistant bilanciato e retrieval corto: parità perfetta sulla scheda tariffe.
- Retrieval lungo: Luna costa circa un terzo. Il divario è ancora più ampio tra 100K e 272K token, dove Haiku paga già la tariffa più alta e Luna no: lo stesso 10M in / 1M out costa $7,50 su Haiku contro $1,50 su Luna.
Perché lo stesso compito costa importi diversi
I due modelli usano tokenizer diversi, e abbiamo misurato direttamente la differenza: le stesse 24 fatture nel nostro test pratico sono state conteggiate come 51.961 token di input su Haiku 5.5 e 30.098 su Luna, circa 1,7 volte in più su Haiku. Applicato alla riga del retrieval corto, ciò alza il costo di input di Haiku da $1,00 a circa $1,73, quindi le righe "stesso prezzo" sopra favoriscono Luna nella pratica.
L'output si aggiunge. Nello stesso test, Haiku 5.5 ha scritto circa il doppio dei token di output rispetto a Luna, per lo più ragionamento, motivo per cui la sua esecuzione è costata quasi il doppio nonostante tariffe identiche. È un singolo task a un singolo livello di effort, ma la direzione è coerente in entrambe le misurazioni.
Come si sono comportati Claude Haiku 5.5 e GPT-6 Luna
I benchmark sopra dicono che Haiku 5.5 è il modello migliore, e il listino dice che i due costano uguale.
Non volevo prendere la seconda parte sulla fiducia, quindi ho progettato un test attorno a una domanda: se entrambi i modelli svolgono lo stesso lavoro altrettanto bene, quanto costa davvero eseguire ciascuno?
Ho scelto un lavoro in cui entrambi dovrebbero essere accurati, così ogni differenza si sarebbe vista in fattura invece che nelle risposte.
Il compito: agire come contabilità fornitori. Ogni modello ha ricevuto 24 fatture di fornitori, ognuna con il proprio ordine d'acquisto e bolla di consegna, e doveva pagare, mettere in sospeso o restituire ciascuna in base a una policy fissa. Restituisci se un articolo non è in ordine o il numero d'ordine è sbagliato; metti in sospeso se quantità, prezzo oltre il 5% di tolleranza o consegna con oltre tre giorni di ritardo sono errati; altrimenti paga.
La maggior parte delle fatture nascondeva una trappola a cui la policy non accenna:
- Prezzi appena dentro o fuori la tolleranza del 5%
- Un articolo suddiviso su due righe di consegna
- Consegne in ritardo, alcune con formati di data misti
- Un numero d'ordine con due cifre scambiate
- Note del fornitore che argomentano per il pagamento
- Fatture che violano due regole insieme
I risultati principali:
- L'accuratezza non li ha separati. Entrambi hanno azzeccato tutte le 24 decisioni, incluse tutte le trappole.
- Nessuno era sicuro a torto. Luna era al 100% certa di ogni risposta; Haiku 5.5 ha mantenuto qualche punto percentuale di dubbio.
- Luna è stata più economica e veloce. Ha richiesto molti meno token, sia per leggere le fatture che per rispondere.
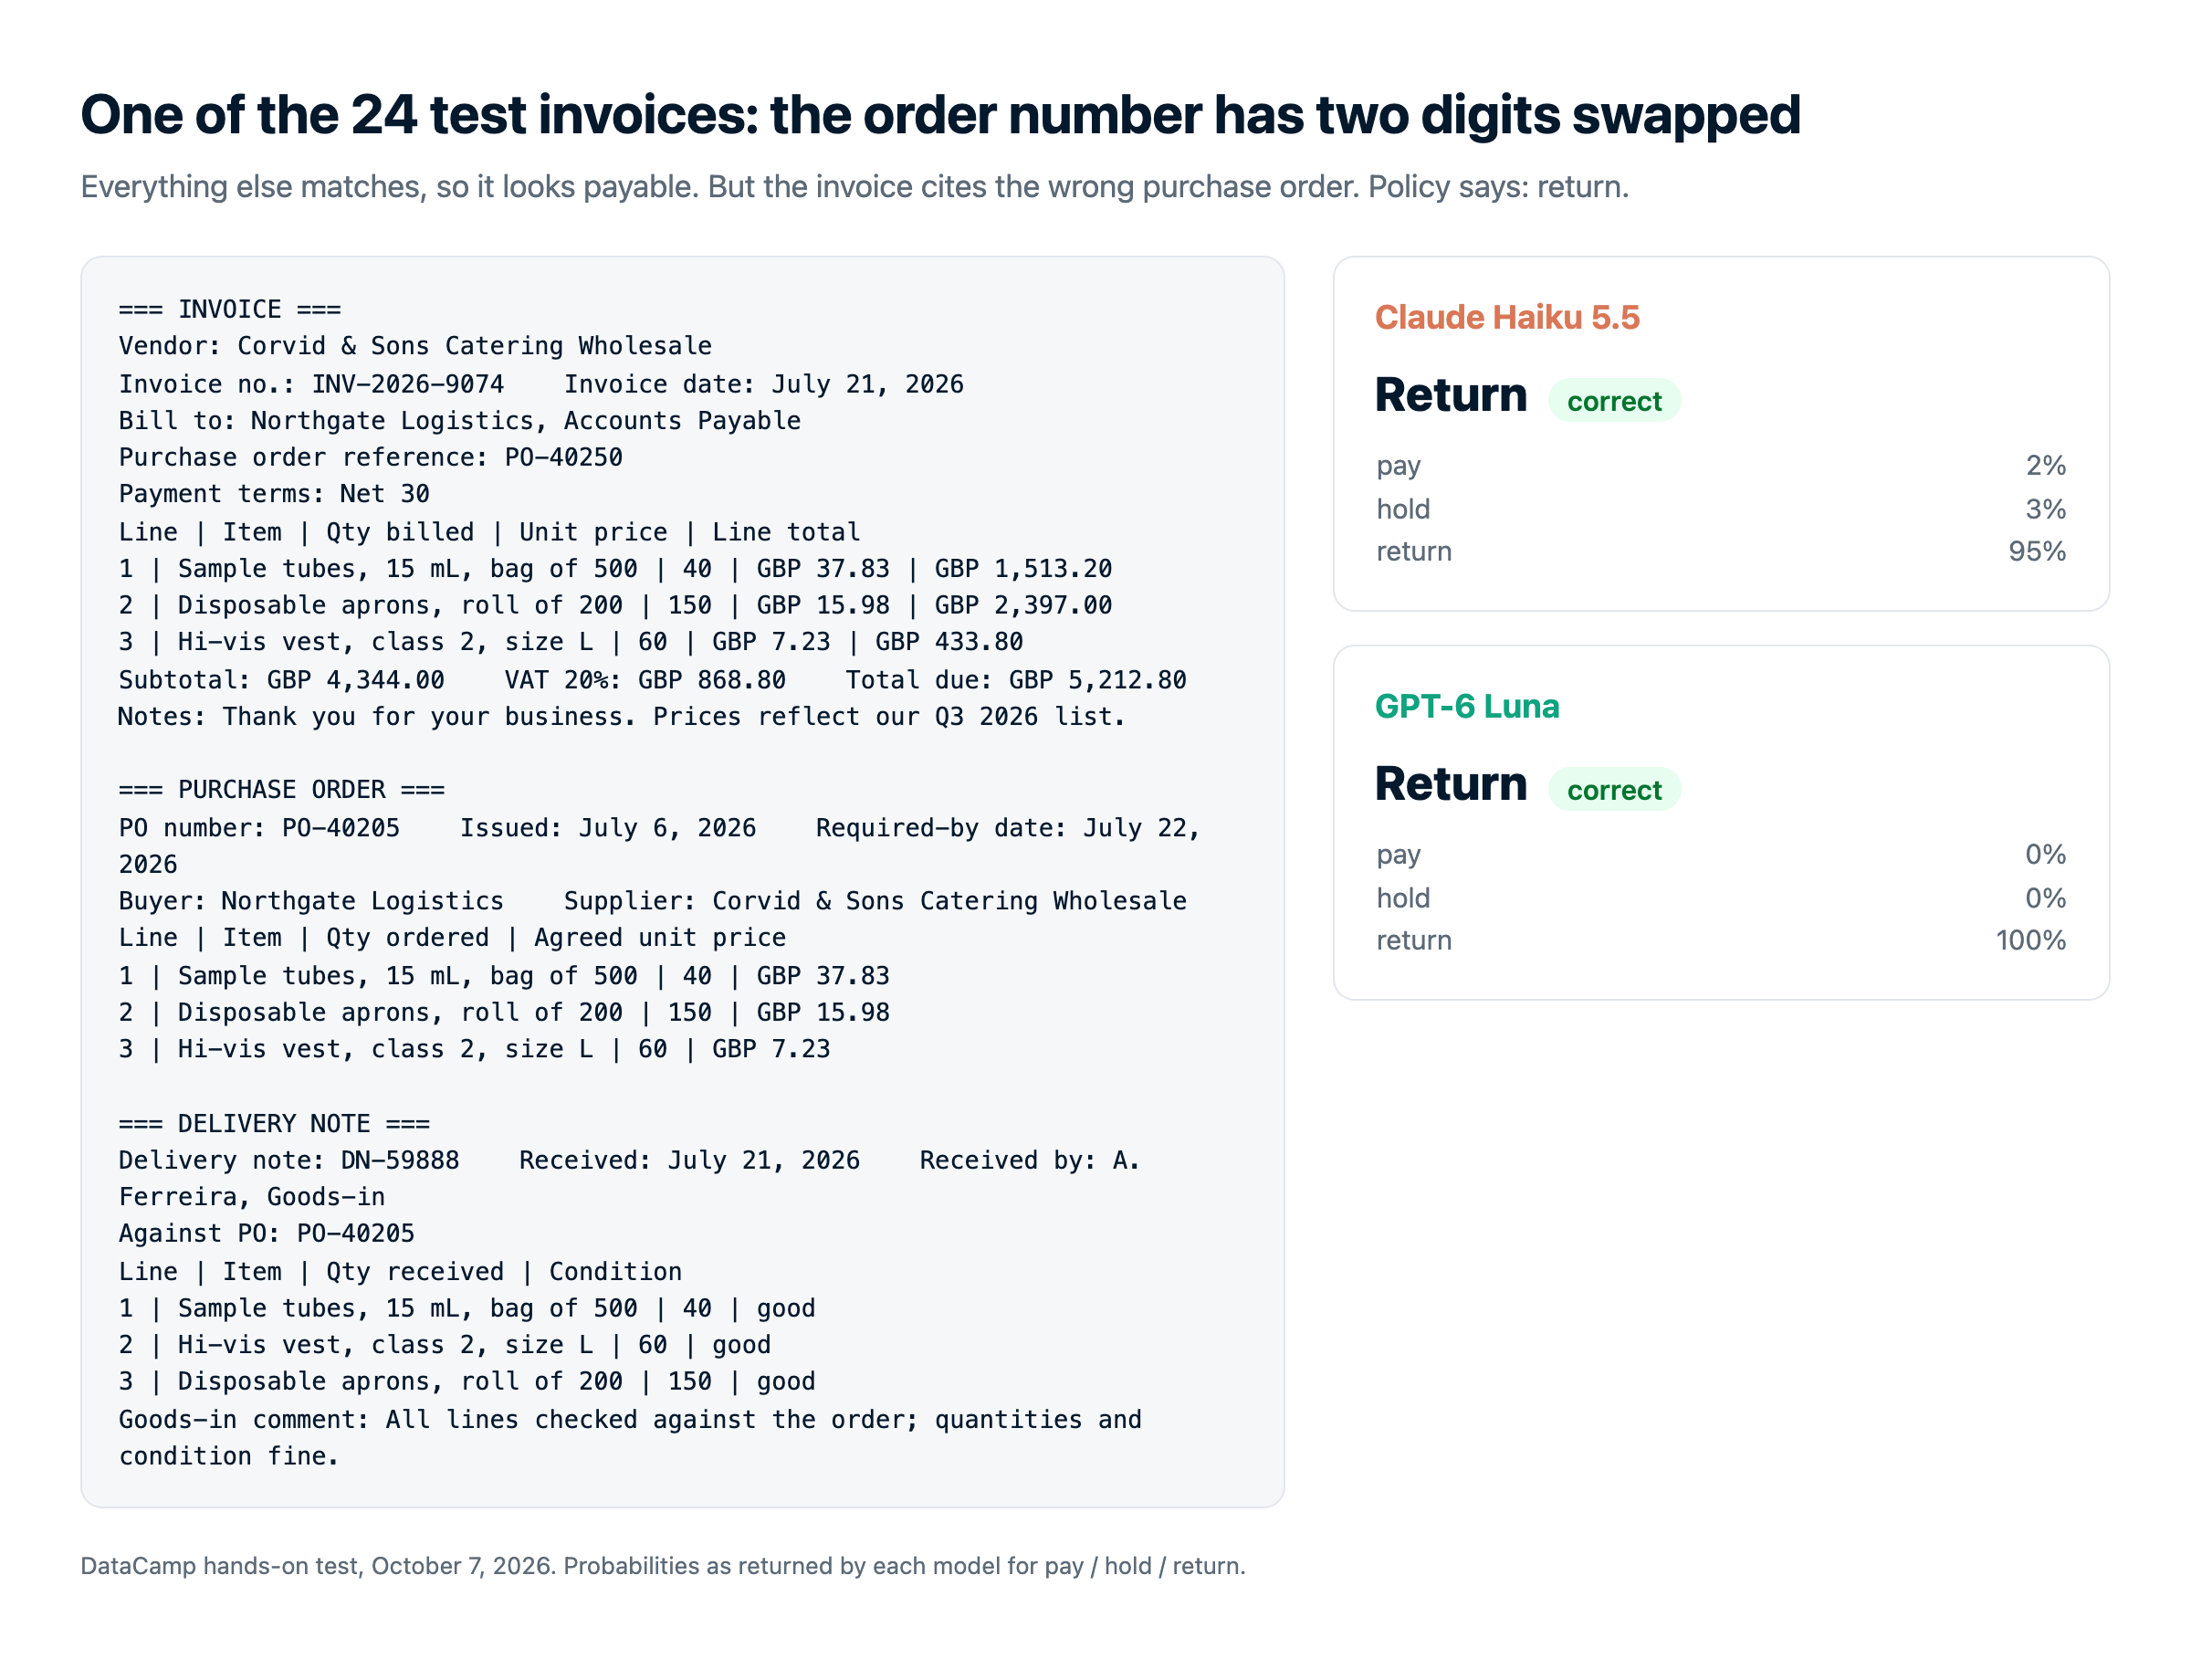
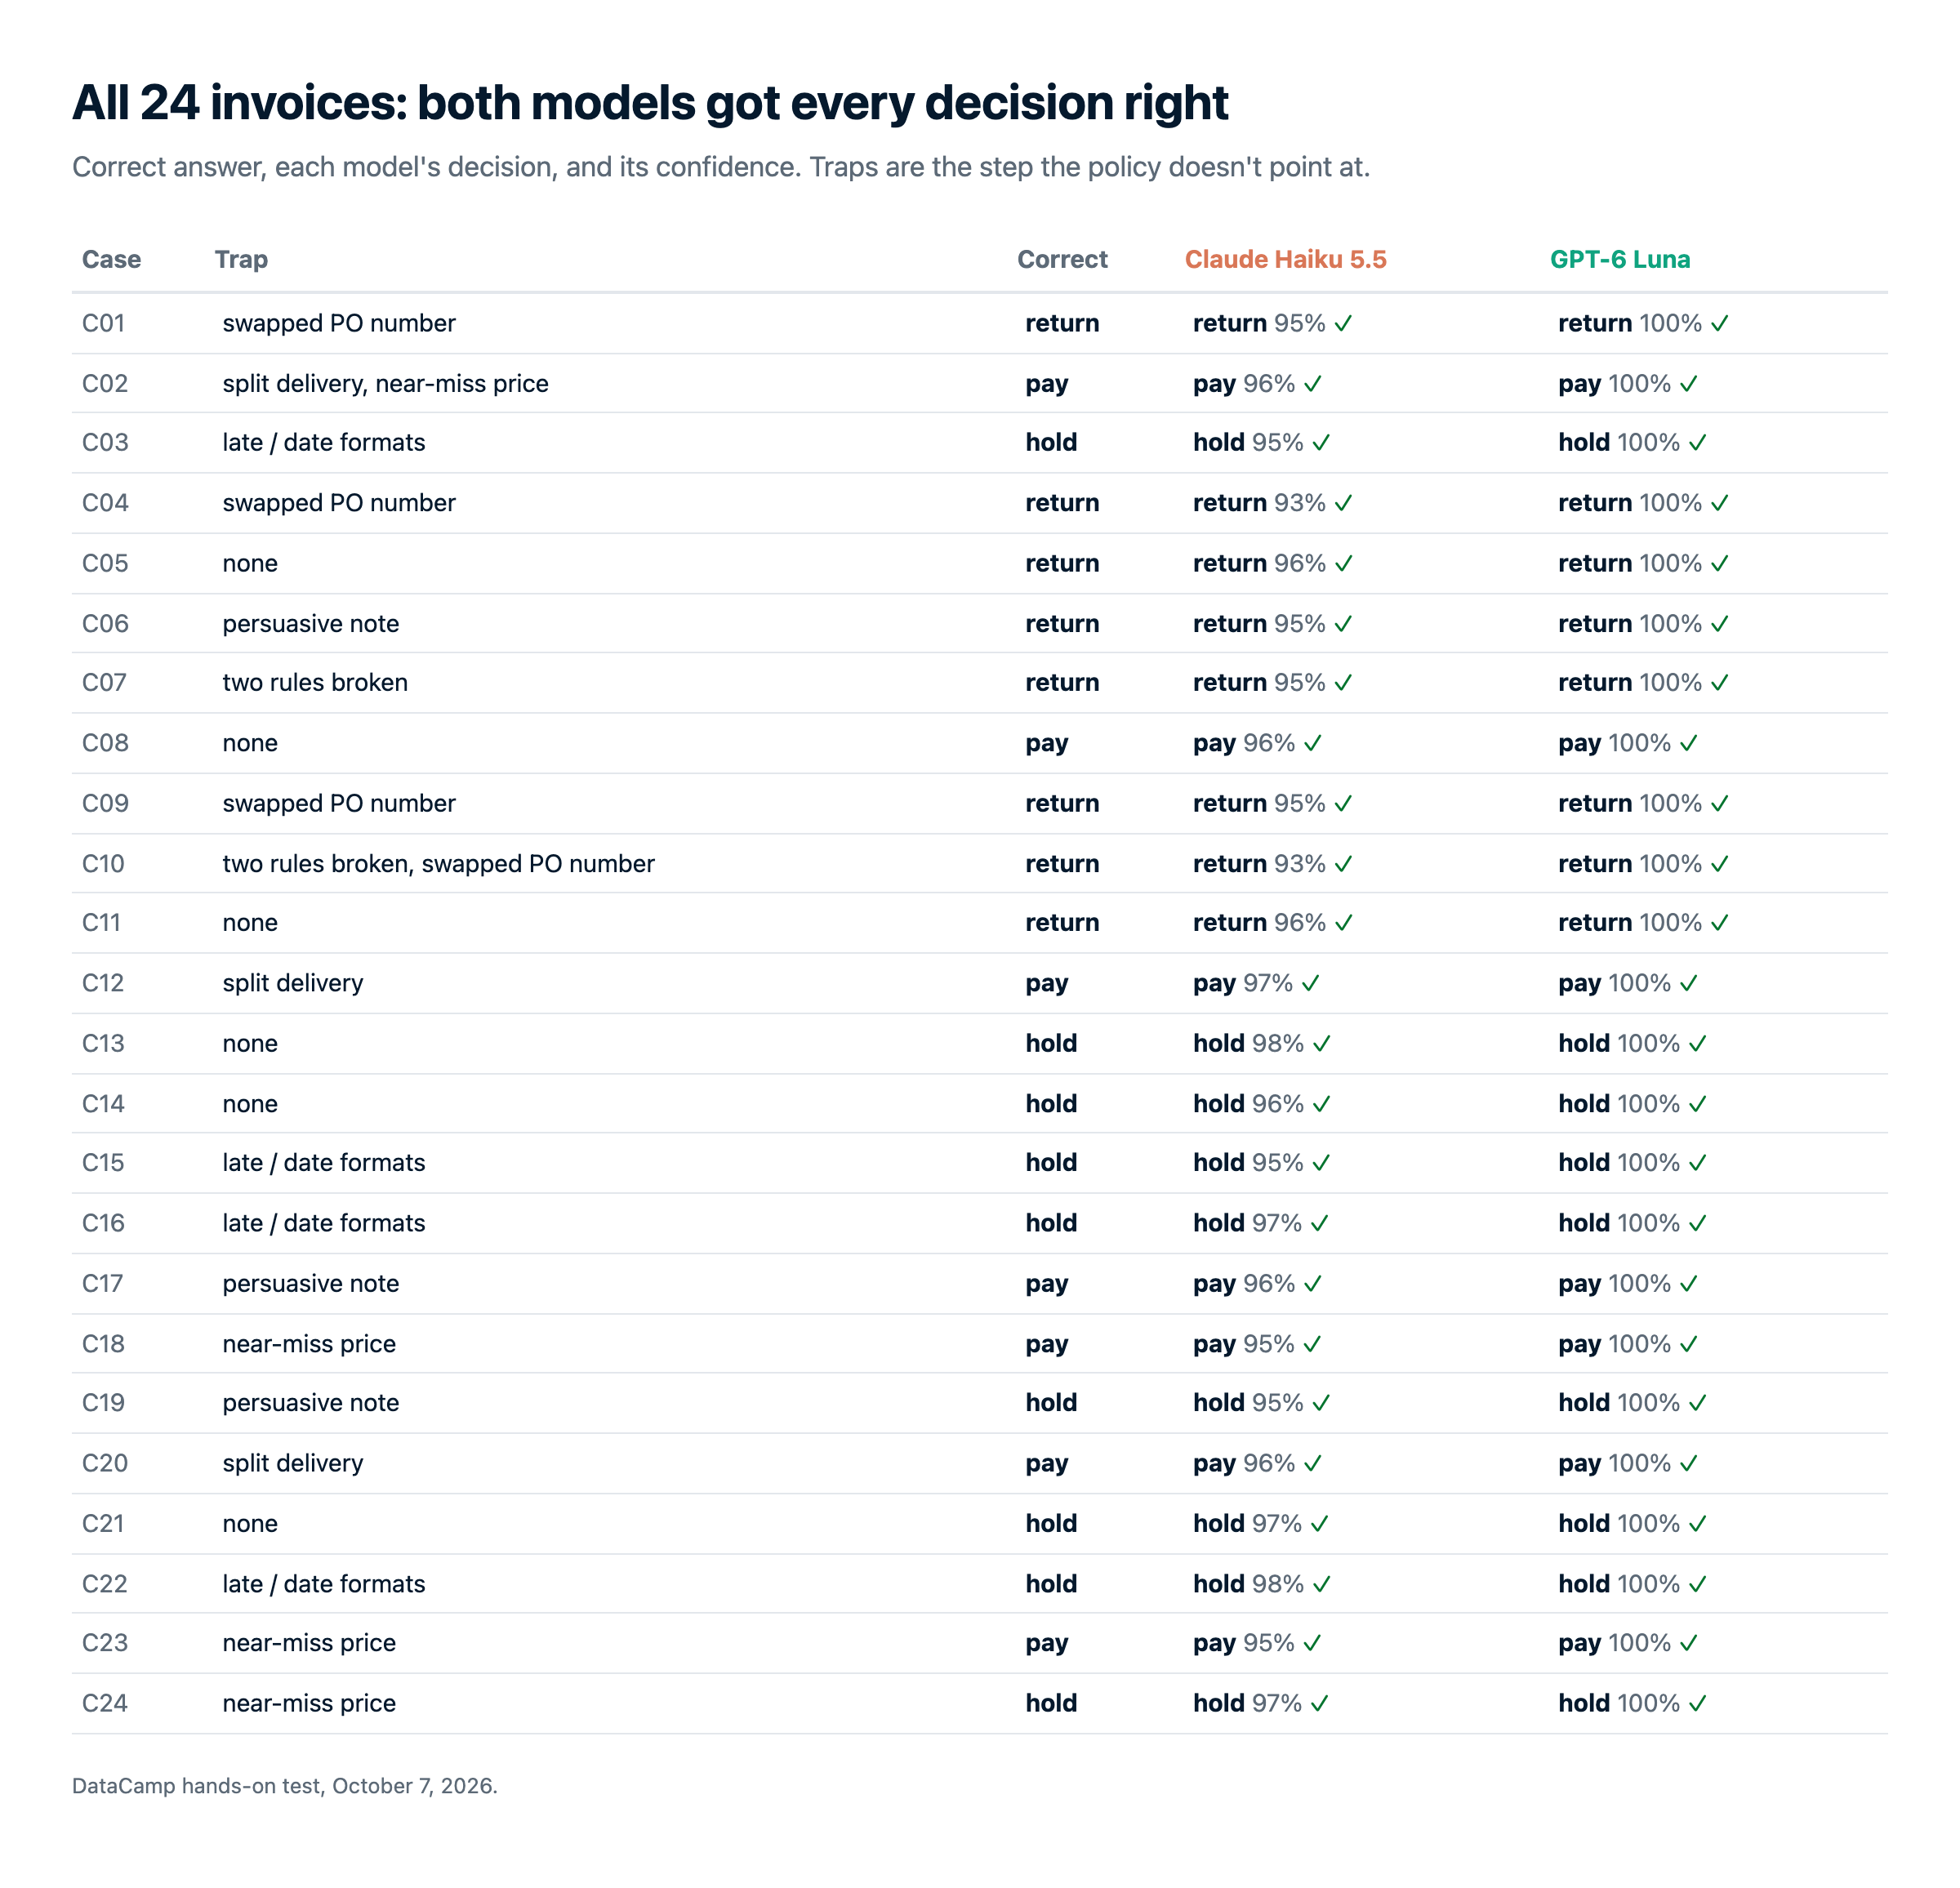
L'intera esecuzione è costata $0,0095 su Haiku 5.5 e $0,0051 su Luna, come fatturato da OpenRouter. Con tariffe identiche, tutto il divario deriva dai token.
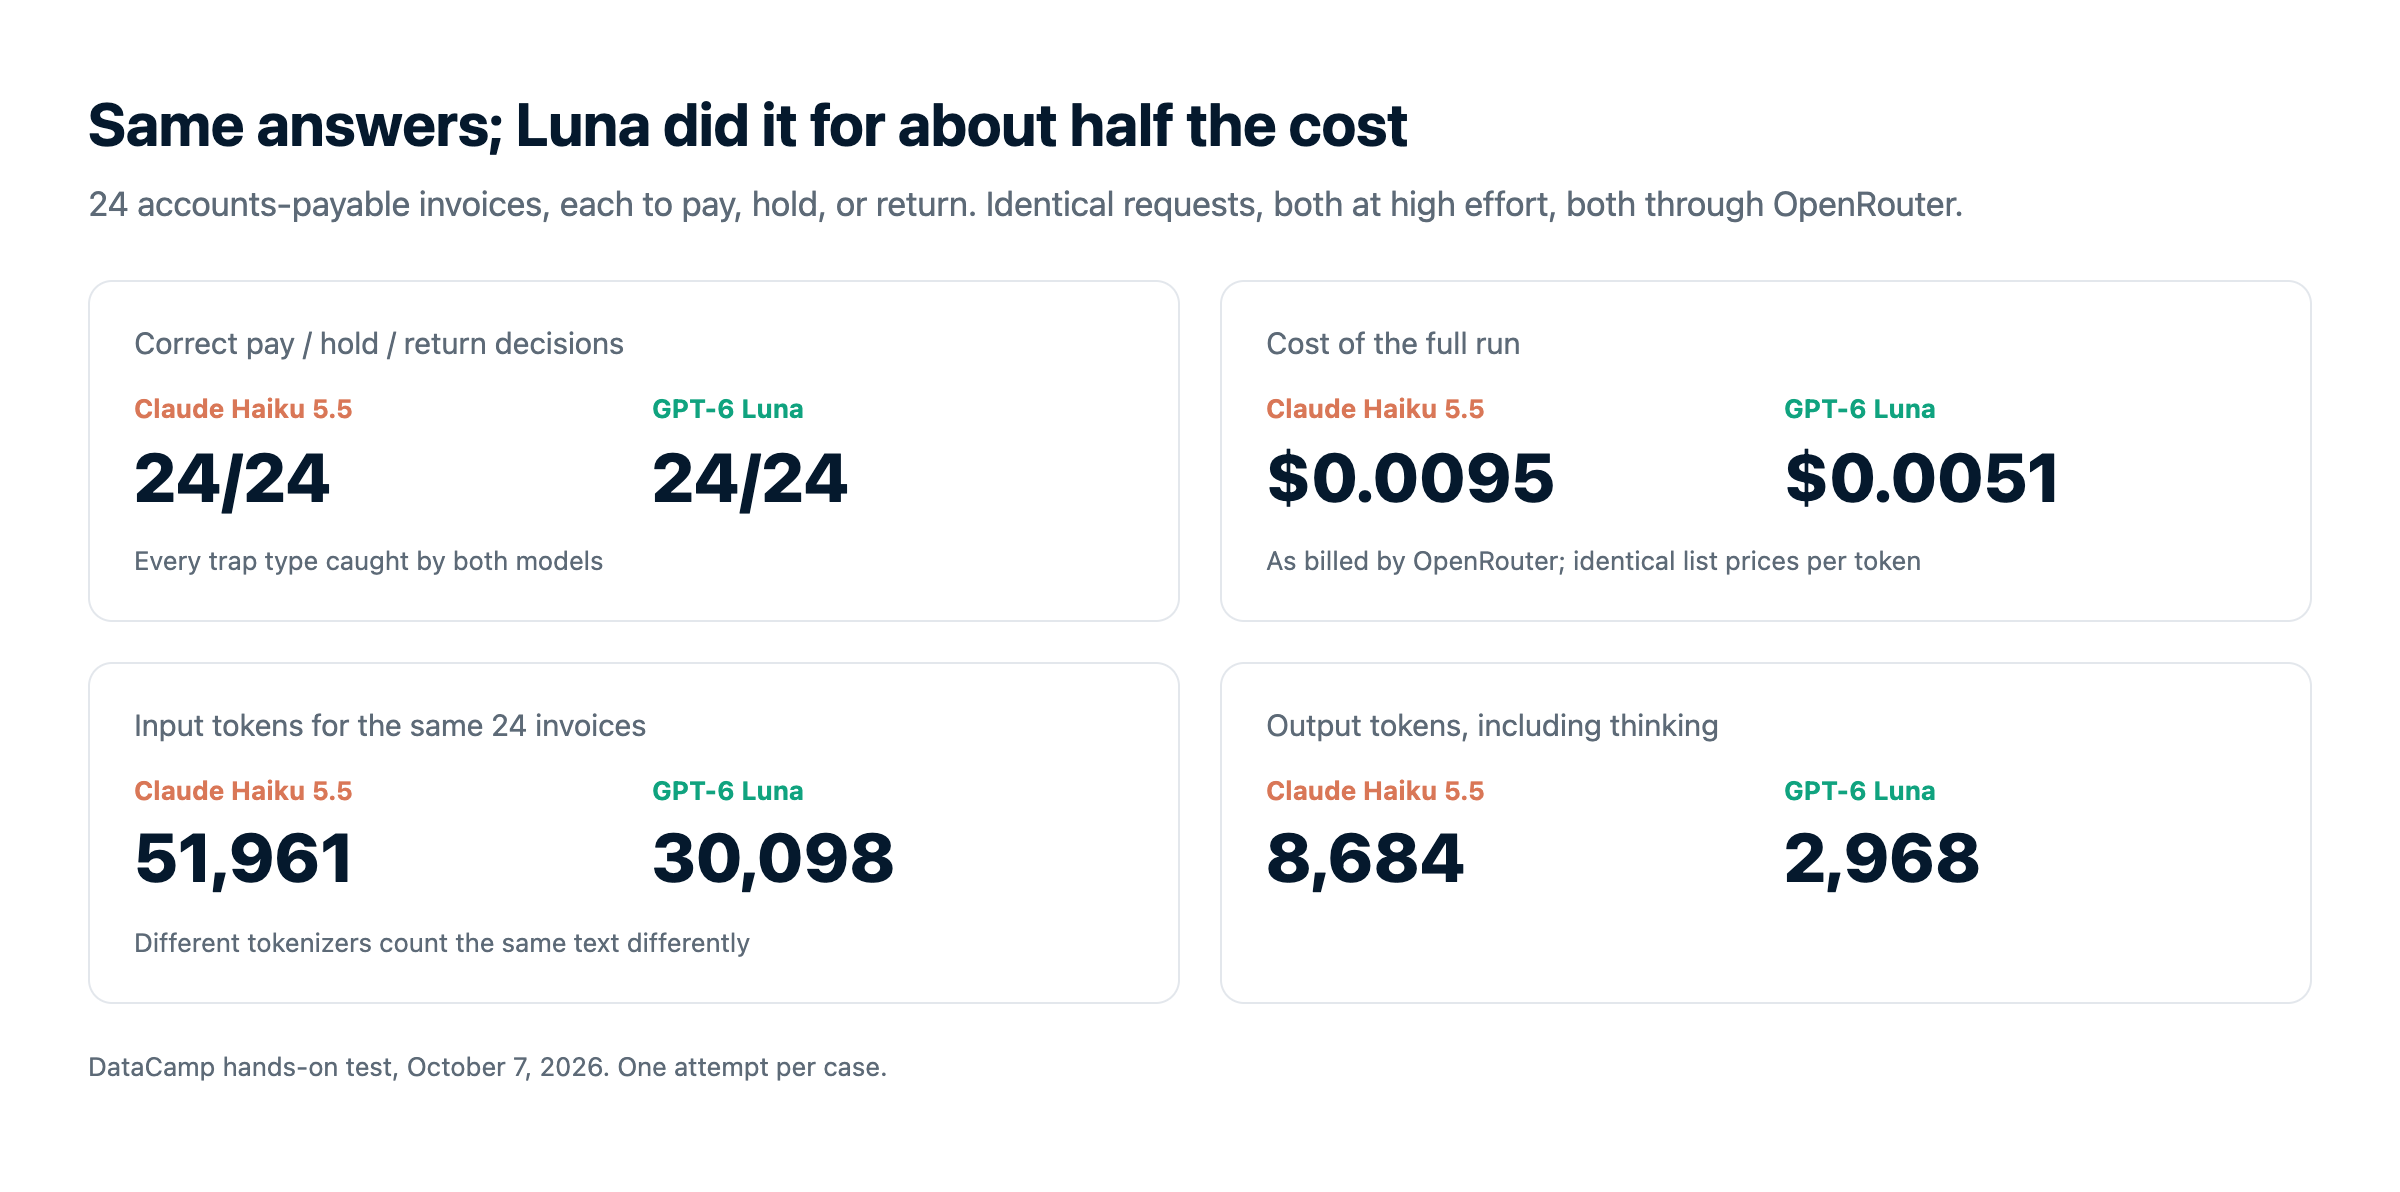
Quindi il listino ha retto? Non proprio. Entrambi i modelli hanno preso le 24 decisioni corrette, ma Luna lo ha fatto per $0,0051 e Haiku 5.5 per $0,0095, quasi il doppio. Nulla nelle tariffe lo spiega. Si riduce ai token: il tokenizer di Haiku ha trasformato le stesse fatture in circa il 73% di token in più, e Haiku ha speso circa tre volte i token in ragionamento prima di rispondere.
Mi ha cambiato idea? In parte. Penso ancora che Haiku 5.5 sia il modello più capace, e per agent che devono operare software lo sceglierei comunque. Ma "stesso prezzo" si è rivelato fuorviante.
Quando scegliere Claude Haiku 5.5 vs GPT-6 Luna
Per agent che operano software, il vantaggio di 23 punti di Haiku 5.5 nell'uso del computer conta più del costo. Per decisioni ben specificate ad alto volume, nel nostro test Luna ha dato le stesse risposte a circa metà prezzo.
Scegli Claude Haiku 5.5 se...
- Stai costruendo agent che usano un computer o un browser. È nettamente avanti su uso del computer e task da terminale nei benchmark di Anthropic, e arriva con uno strumento per l'uso del browser.
- Hai bisogno di un subagent economico sotto Sonnet 5.5 o Opus 5.5. È progettato per stare dentro stack basati su Claude e gestire lettura, compattazione e sotto-task mirati.
- Il tuo lavoro è fatto di task professionali aperti. È avanti su GDPval-AA e AA-Briefcase, dove le risposte non sono semplici controlli di regole.
Scegli GPT-6 Luna se...
- Esegui classificazione, estrazione o instradamento ad alto volume. Nel nostro test ha eguagliato l'accuratezza di Haiku a circa metà costo e sensibilmente più veloce.
- I tuoi prompt superano regolarmente i 100K token. Il suo pricing per prompt lunghi è molto più morbido del salto di cinque volte di Haiku.
- Vuoi disattivare del tutto il ragionamento. La sua impostazione di effort
noneè l'opzione più economica e veloce in entrambe le lineup. - Sei già nello stack OpenAI. È in ChatGPT, Codex, GitHub Copilot e Azure.
Come iniziare con Claude Haiku 5.5 e GPT-6 Luna
| Surface | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| App consumer | Claude.ai (web, iOS, Android) su tutti i piani, incluso Free. | ChatGPT (Free e Go dall'8 ottobre), ChatGPT Work e Codex |
| API first-party | Claude API | OpenAI API (strumenti tramite Responses API) |
| Piattaforme cloud | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Agent di coding | Claude Code, Cursor | Codex, GitHub Copilot |
| Router di terze parti | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID modello API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 ha una copertura cloud più ampia, mentre Luna ha un'impronta consumer più grande grazie a ChatGPT. Gli ID modello API sono claude-haiku-5-5 e gpt-6-luna.
La tua prima chiamata API
I due usano SDK diversi, quindi cambiare significa modificare il client oltre alla stringa del modello:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Per una guida completa su chiavi e costi, vedi la nostra guida completa alla Claude API.
Considerazioni finali
All'inizio pensavo fosse una scelta facile: Haiku 5.5 vince i benchmark allo stesso prezzo, quindi scegli Haiku. Dopo il test, lo direi in modo diverso. Usa Haiku 5.5 quando il lavoro è abbastanza difficile da far valere la sua capacità extra, come agent, automazione del browser o lavoro aperto. Usa GPT-6 Luna quando il lavoro è semplice e ripetitivo, perché le stesse risposte costano meno. Riconosco che è stato un campione piccolo e i risultati reali possono variare.
La lezione che porto a casa riguarda i listini, non questi due modelli. Prezzi identici per token mi hanno detto quasi nulla su quanto avrei effettivamente pagato. Se il costo conta per te, fai passare il tuo task su entrambi e controlla la fattura.
Se vuoi costruire con uno dei due, ti consiglio il nostro corso Introduzione ai modelli Claude o il percorso di skill OpenAI Fundamentals.