Anthropic baru saja meluncurkan Claude Haiku 5.5, dan itu merupakan tantangan bagi OpenAI. Tabel benchmark yang dibagikan Anthropic menempatkan Haiku 5.5 di depan GPT-6 Luna pada setiap baris yang keduanya miliki. Dan Anthropic memasang harga Haiku 5.5 persis sama dengan harga Luna dari OpenAI: $0.10 per sejuta token input dan $0.50 per sejuta token output. Di atas kertas, perbandingannya mudah. Haiku 5.5 lebih baik daripada GPT-6 Luna, dan harganya sama.
Itu ringkasannya. Namun "harga per token yang sama" tidak sama dengan "harga per pekerjaan yang sama." Model membaca dan menulis jumlah token yang berbeda untuk tugas yang sama. Jadi saya pikir akan menarik untuk mengecek: jika saya memberi kedua model pekerjaan yang sama, apakah biayanya benar-benar sama? Dan jika tidak, apakah itu akan mengubah pendapat saya?
Ringkasnya
- Claude Haiku 5.5 adalah agen yang lebih andal, dengan keunggulan besar pada penggunaan komputer dan tugas terminal di benchmark Anthropic.
- Di atas kertas, Haiku 5.5 unggul: benchmark lebih baik pada harga yang sama. Namun dalam uji biaya saya (spoiler), Luna memberi jawaban yang sama dengan kira-kira setengah biaya.
- Pelajarannya: Harga per token yang identik bisa menyembunyikan selisih biaya nyata akibat tokenizer, panjang penalaran, dan biaya tambahan long-prompt.
Apa itu Claude Haiku 5.5?
Claude Haiku 5.5 adalah model terkecil dan tercepat Anthropic, dirilis pada 7 Oktober 2026 sebagai anggota terakhir keluarga Claude 5.5.
Anthropic memposisikannya untuk pekerjaan ber-volume tinggi dan sensitif latensi seperti klasifikasi, ekstraksi, perutean, serta berjalan sebagai subagen di bawah Sonnet 5.5 atau Opus 5.5, dan model ini menghadirkan pemikiran adaptif serta penggunaan komputer pada tingkat harga terbawah.
Panduan Claude Haiku 5.5 kami membahas peluncuran dan uji langsung kami melawan Haiku 4.5.
Apa itu GPT-6 Luna?
GPT-6 Luna adalah model paling efisien dari OpenAI, dirilis pada 22 September 2026 sebagai tier terkecil dari keluarga GPT-6, di bawah Astra dan Sol.
OpenAI memposisikannya untuk tugas fokus ber-volume tinggi, dan OpenAI meluncurkannya sebagai model di balik ChatGPT untuk pengguna Free dan Go mulai 8 Oktober.
Panduan GPT-6 Sol dan Luna kami membahas peluncurannya.
Claude Haiku 5.5 vs. GPT-6 Luna: Perbandingan Langsung
Benchmark Anthropic menempatkan Haiku 5.5 di depan Luna pada setiap baris yang keduanya miliki, dengan selisih terbesar pada tugas agen. Pada biaya dan kecepatan untuk keputusan sederhana, uji kami sendiri menunjukkan sebaliknya.
| Fitur | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (penggunaan komputer) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Utama) | 46,4% | 42,4% |
| Chartography (tanpa tools) | 46,4% | 29,1% |
| DeepSWE v1.1 | Tidak dilaporkan | 66,6% (upaya maksimum) |
| Jendela konteks / output maks | 1M / 128K | 1,05M / 128K |
| Batas pengetahuan | Juni 2026 | Mei 2026 |
| Tingkat upaya | rendah hingga maksimum (default sedang) | tidak ada hingga maksimum (default sedang) |
Setiap baris kecuali DeepSWE berasal dari tabel peluncuran Anthropic, jadi bacalah sebagai argumen Anthropic; OpenAI belum menerbitkan perbandingan terhadap Haiku 5.5. Itu wajar karena Luna rilis lebih dulu.
Pekerjaan agen dan penggunaan komputer
Di sinilah Haiku 5.5 melesat paling jauh. Pada OSWorld 2.1, yang menguji apakah model dapat menyelesaikan tugas dengan mengoperasikan desktop nyata, Haiku 5.5 meraih 72,4% melawan 48,9% milik Luna, selisih 23,5 poin yang mengubah kegunaan model kecil. Terminal-Bench 4.0 menunjukkan hal serupa, dengan Haiku menyelesaikan lebih dari dua kali lipat tugas command-line.
Anthropic juga merilis tool penggunaan browser bersamaan dengan Haiku 5.5.
Untuk pekerjaan agen, Haiku 5.5 adalah pilihan yang jelas.
Pekerjaan pengetahuan dan dokumen
Haiku 5.5 juga unggul pada evaluasi tugas profesional: sekitar 180 poin Elo pada GDPval-AA dan sekitar 240 pada AA-Briefcase. Pembacaan grafik pada Chartography menunjukkan selisih 17 poin.
Namun, pada keputusan dokumen yang lebih sederhana dan berbasis aturan, uji langsung kami tidak menemukan perbedaan akurasi sama sekali, jadi kemungkinan selisihnya terutama muncul pada pekerjaan yang lebih terbuka.
Pemrograman
Koding lebih ketat. Pada FrontierCode 1.1, yang menilai apakah perubahan siap digabungkan, Haiku 5.5 unggul 4 poin. OpenAI melaporkan Luna di 66,6% pada DeepSWE v1.1 dengan upaya maksimum, sebanding dengan Claude Opus 5 pada upaya sedang. Keduanya bukan pilihan utama untuk agen koding serius. Itu lebih cocok untuk wilayah Sonnet 5.5 dan GPT-6.1 Sol.
Kontrol upaya dan batasan API
Keduanya default ke upaya sedang, tetapi Luna bisa lebih rendah: pengaturan none melewati penalaran sepenuhnya untuk jawaban termurah dan tercepat. Level upaya terendah Haiku 5.5 adalah low, meski Anda tetap bisa mematikan penalaran pada upaya high atau di bawahnya.
Harga: yang benar-benar Anda bayar
Haiku 5.5 dan Luna memiliki tarif standar yang identik, jadi perbedaan biaya nyata berasal dari prompt panjang, tokenizer, dan seberapa banyak masing-masing model menulis.
Tarif token berdampingan
| Tarif, per 1M token | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Input | $0.10 (prompt hingga 100K) | $0.10 (prompt hingga 272K) |
| Output | $0.50 (prompt hingga 100K) | $0.50 (prompt hingga 272K) |
| Baca cache input | $0.01 | $0.01 |
| Tulis cache | $0.125 (5 menit) | $0.125 |
| Harga long-prompt | Di atas 100K token: $0.50 input, $2.50 output | Di atas 272K token: 2x input dan cache, 1,5x output |
| Diskon batch | 50% | 50% |
Di bawah 100K token, kartu tarifnya sama persis. Di atas itu, harga Haiku melonjak lima kali lipat sementara harga Luna tetap datar hingga 272K token dan kemudian naik jauh lebih ringan. Keduanya menagihkan penalaran sebagai output.
Pada harga daftar, keduanya baru berbeda saat prompt menjadi panjang. Bagian tokenizer di bawah menjelaskan mengapa itu bukan keseluruhan cerita.
Biaya beban kerja nyata
| Beban kerja | Claude Haiku 5.5 | GPT-6 Luna | Selisih |
|---|---|---|---|
| Asisten seimbang: 1M masuk / 250K keluar | $0.23 | $0.23 | Tidak ada |
| Retrieval, tiap permintaan di bawah 100K: 10M masuk / 1M keluar | $1.50 | $1.50 | Tidak ada |
| Retrieval, tiap permintaan di atas 272K: 10M masuk / 1M keluar | $7.50 | $2.75 | $4.75 (63% lebih murah di Luna) |
Setiap total adalah (volume ÷ 1M) × tarif, dijumlahkan pada input dan output, pada tarif standar.
- Asisten seimbang dan retrieval pendek: seri mutlak pada kartu tarif.
- Retrieval panjang: Luna berbiaya sekitar sepertiga. Selisihnya bahkan lebih lebar antara 100K dan 272K token, saat Haiku sudah membayar tarif lebih tinggi sementara Luna belum: beban 10M masuk / 1M keluar yang sama berbiaya $7.50 di Haiku versus $1.50 di Luna.
Mengapa tugas yang sama berbiaya berbeda
Kedua model menggunakan tokenizer berbeda, dan kami mengukurnya langsung: 24 invoice yang sama dalam uji langsung kami dihitung sebagai 51.961 token input di Haiku 5.5 dan 30.098 di Luna, sekitar 1,7 kali lebih banyak di Haiku. Diterapkan pada baris retrieval pendek, itu mengerek biaya input Haiku dari $1.00 menjadi sekitar $1.73, jadi baris "harga sama" di atas dalam praktiknya menguntungkan Luna.
Output menambahnya. Dalam uji yang sama, Haiku 5.5 menulis sekitar dua kali lebih banyak token output dibanding Luna, sebagian besar adalah penalaran, itulah sebabnya biayanya hampir dua kali lipat meski tarifnya identik. Itu satu tugas pada satu pengaturan upaya, tetapi arahnya konsisten pada kedua pengukuran.
Kinerja Claude Haiku 5.5 dan GPT-6 Luna
Benchmark di atas menyatakan Haiku 5.5 adalah model yang lebih baik, dan lembar harga menyatakan keduanya berbiaya sama.
Saya tidak ingin menerima bagian kedua begitu saja, jadi saya merancang uji dengan satu pertanyaan: jika kedua model melakukan pekerjaan yang sama sama baiknya, berapa sebenarnya biaya menjalankan masing-masing?
Saya memilih pekerjaan yang keduanya seharusnya akurat, sehingga perbedaan akan muncul pada tagihan, bukan pada jawabannya.
Tugas: bertindak sebagai bagian utang dagang. Masing-masing model menerima 24 invoice vendor, masing-masing dengan purchase order dan delivery note, lalu harus memutuskan bayar, tahan, atau kembalikan berdasarkan kebijakan tetap. Kembalikan jika item tidak ada di order atau nomor order salah; tahan jika ada kuantitas, harga di luar toleransi 5%, atau pengiriman terlambat lebih dari tiga hari; jika tidak, bayar.
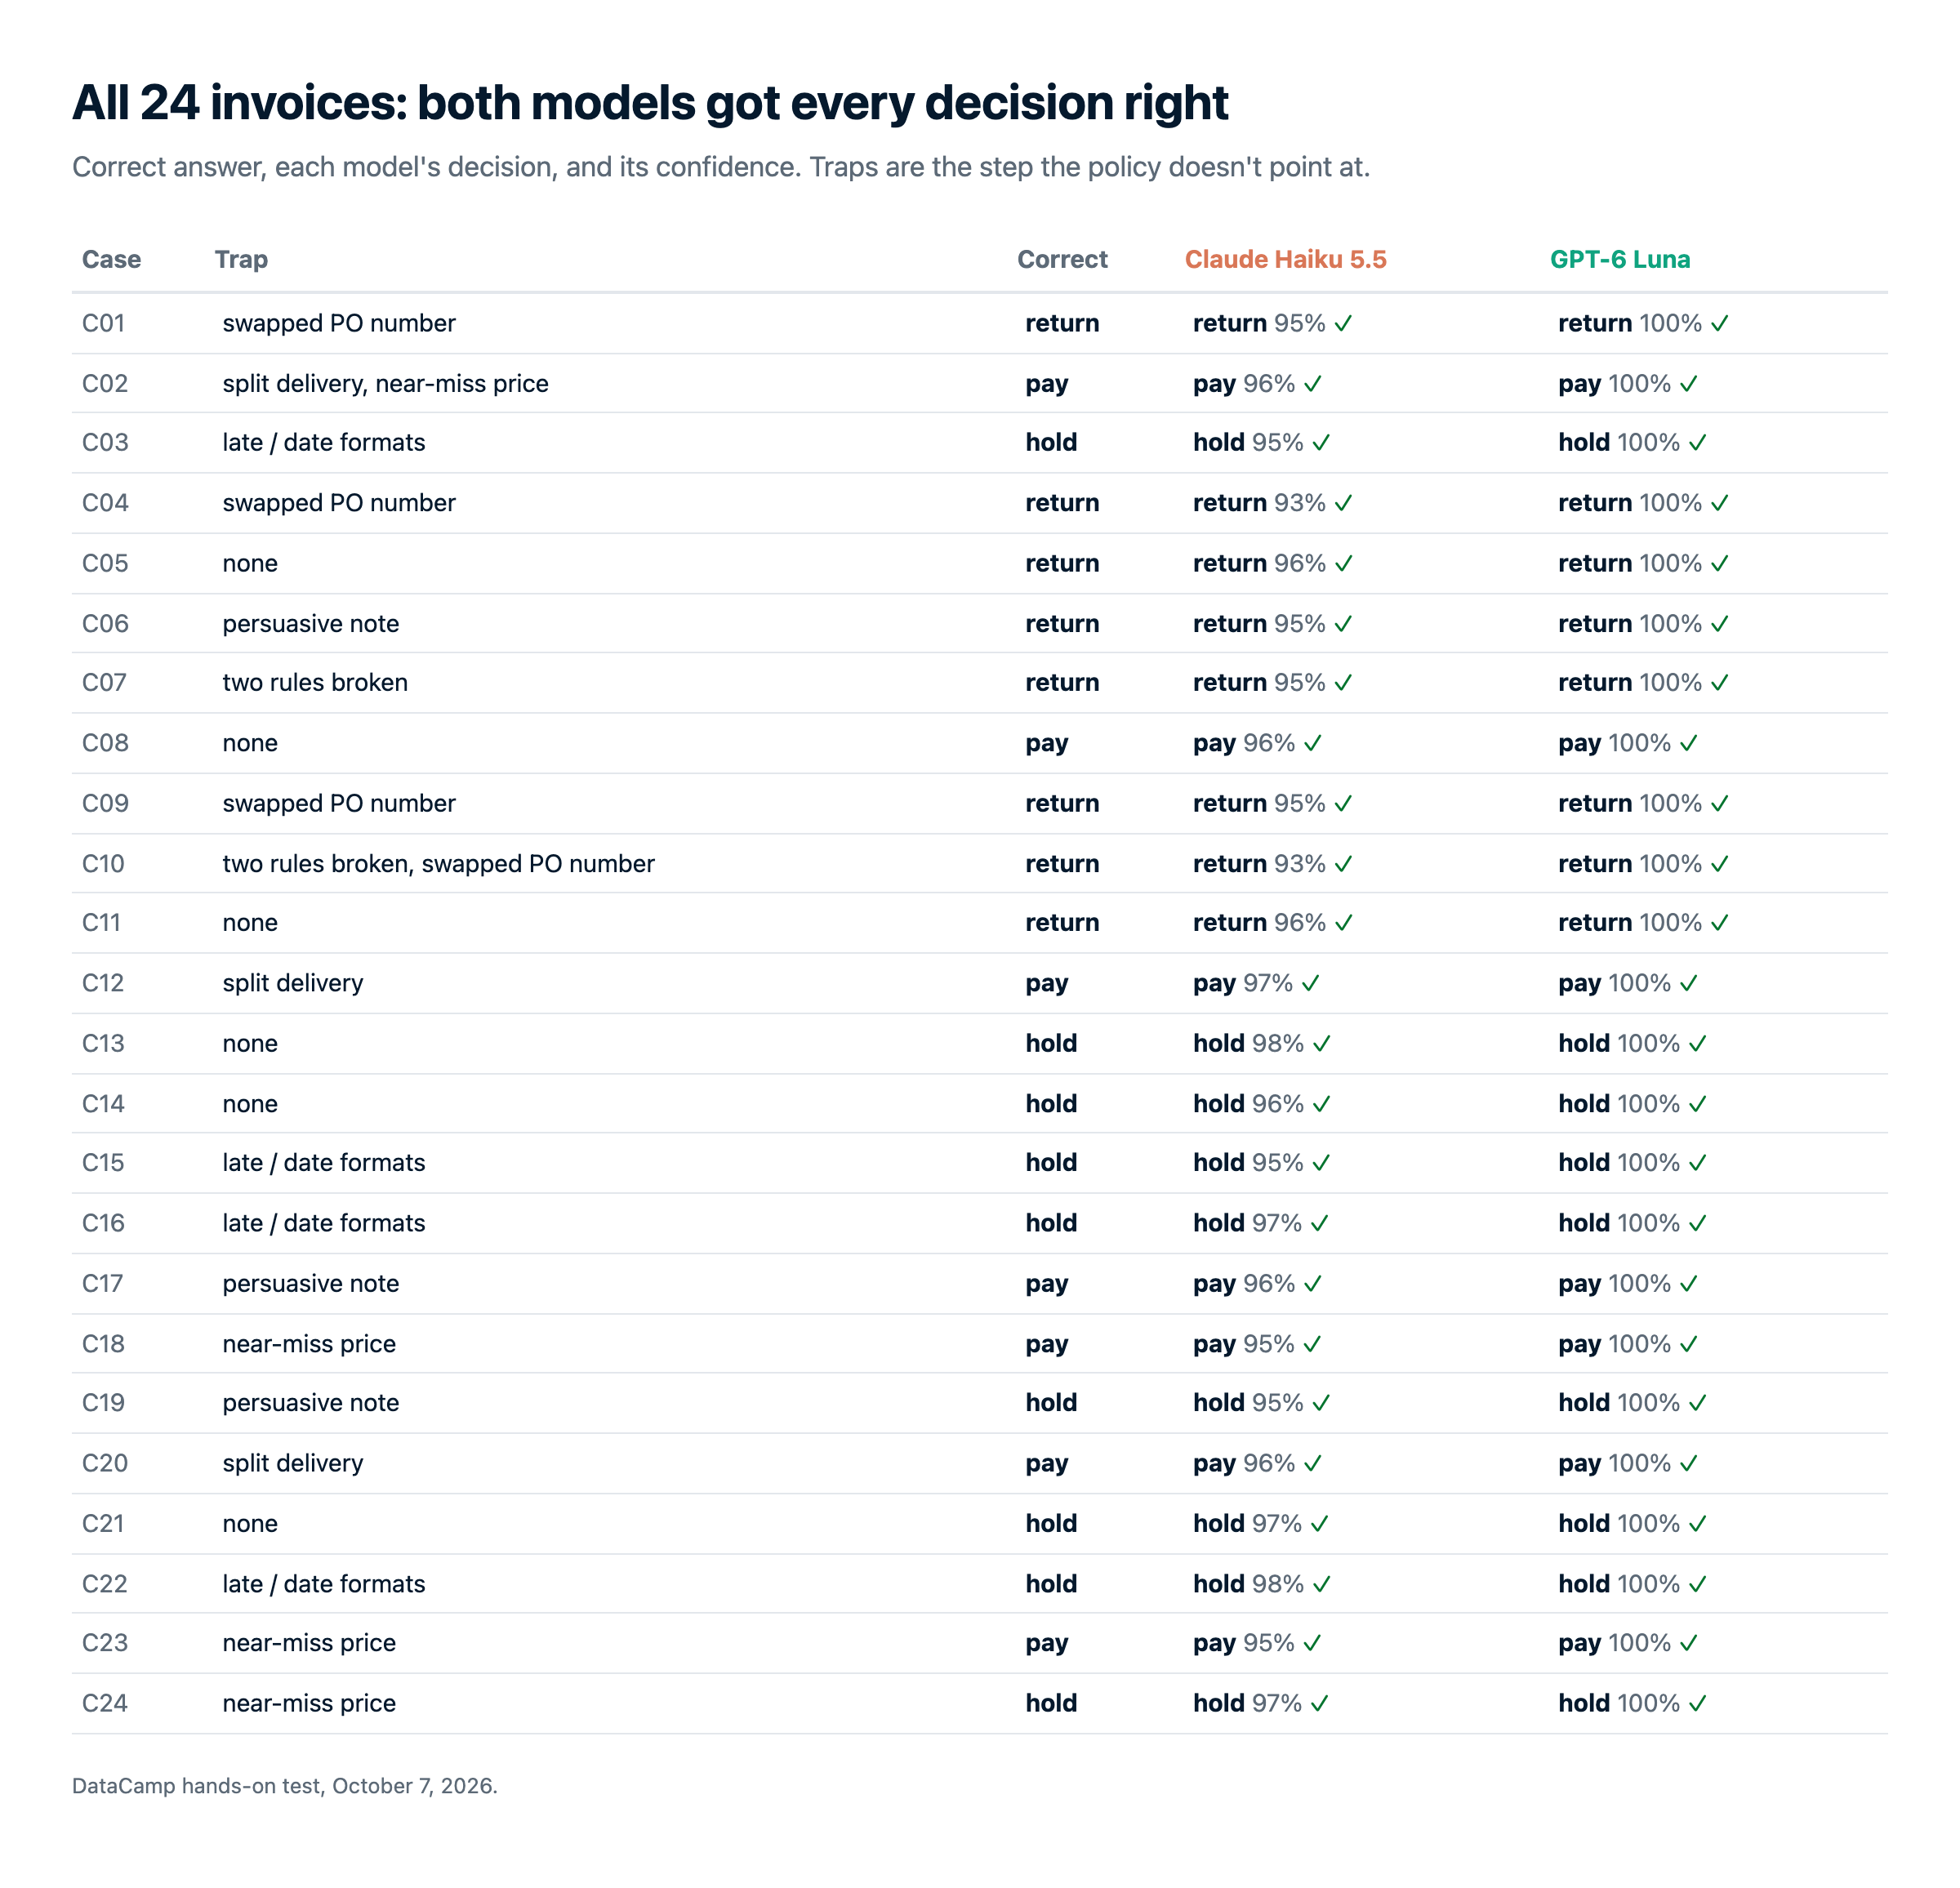
Kebanyakan invoice menyembunyikan jebakan yang tidak tersurat dalam kebijakan:
- Harga tepat di dalam atau di luar toleransi 5%
- Satu item dibagi ke dua baris pengiriman
- Pengiriman terlambat, beberapa dengan format tanggal campuran
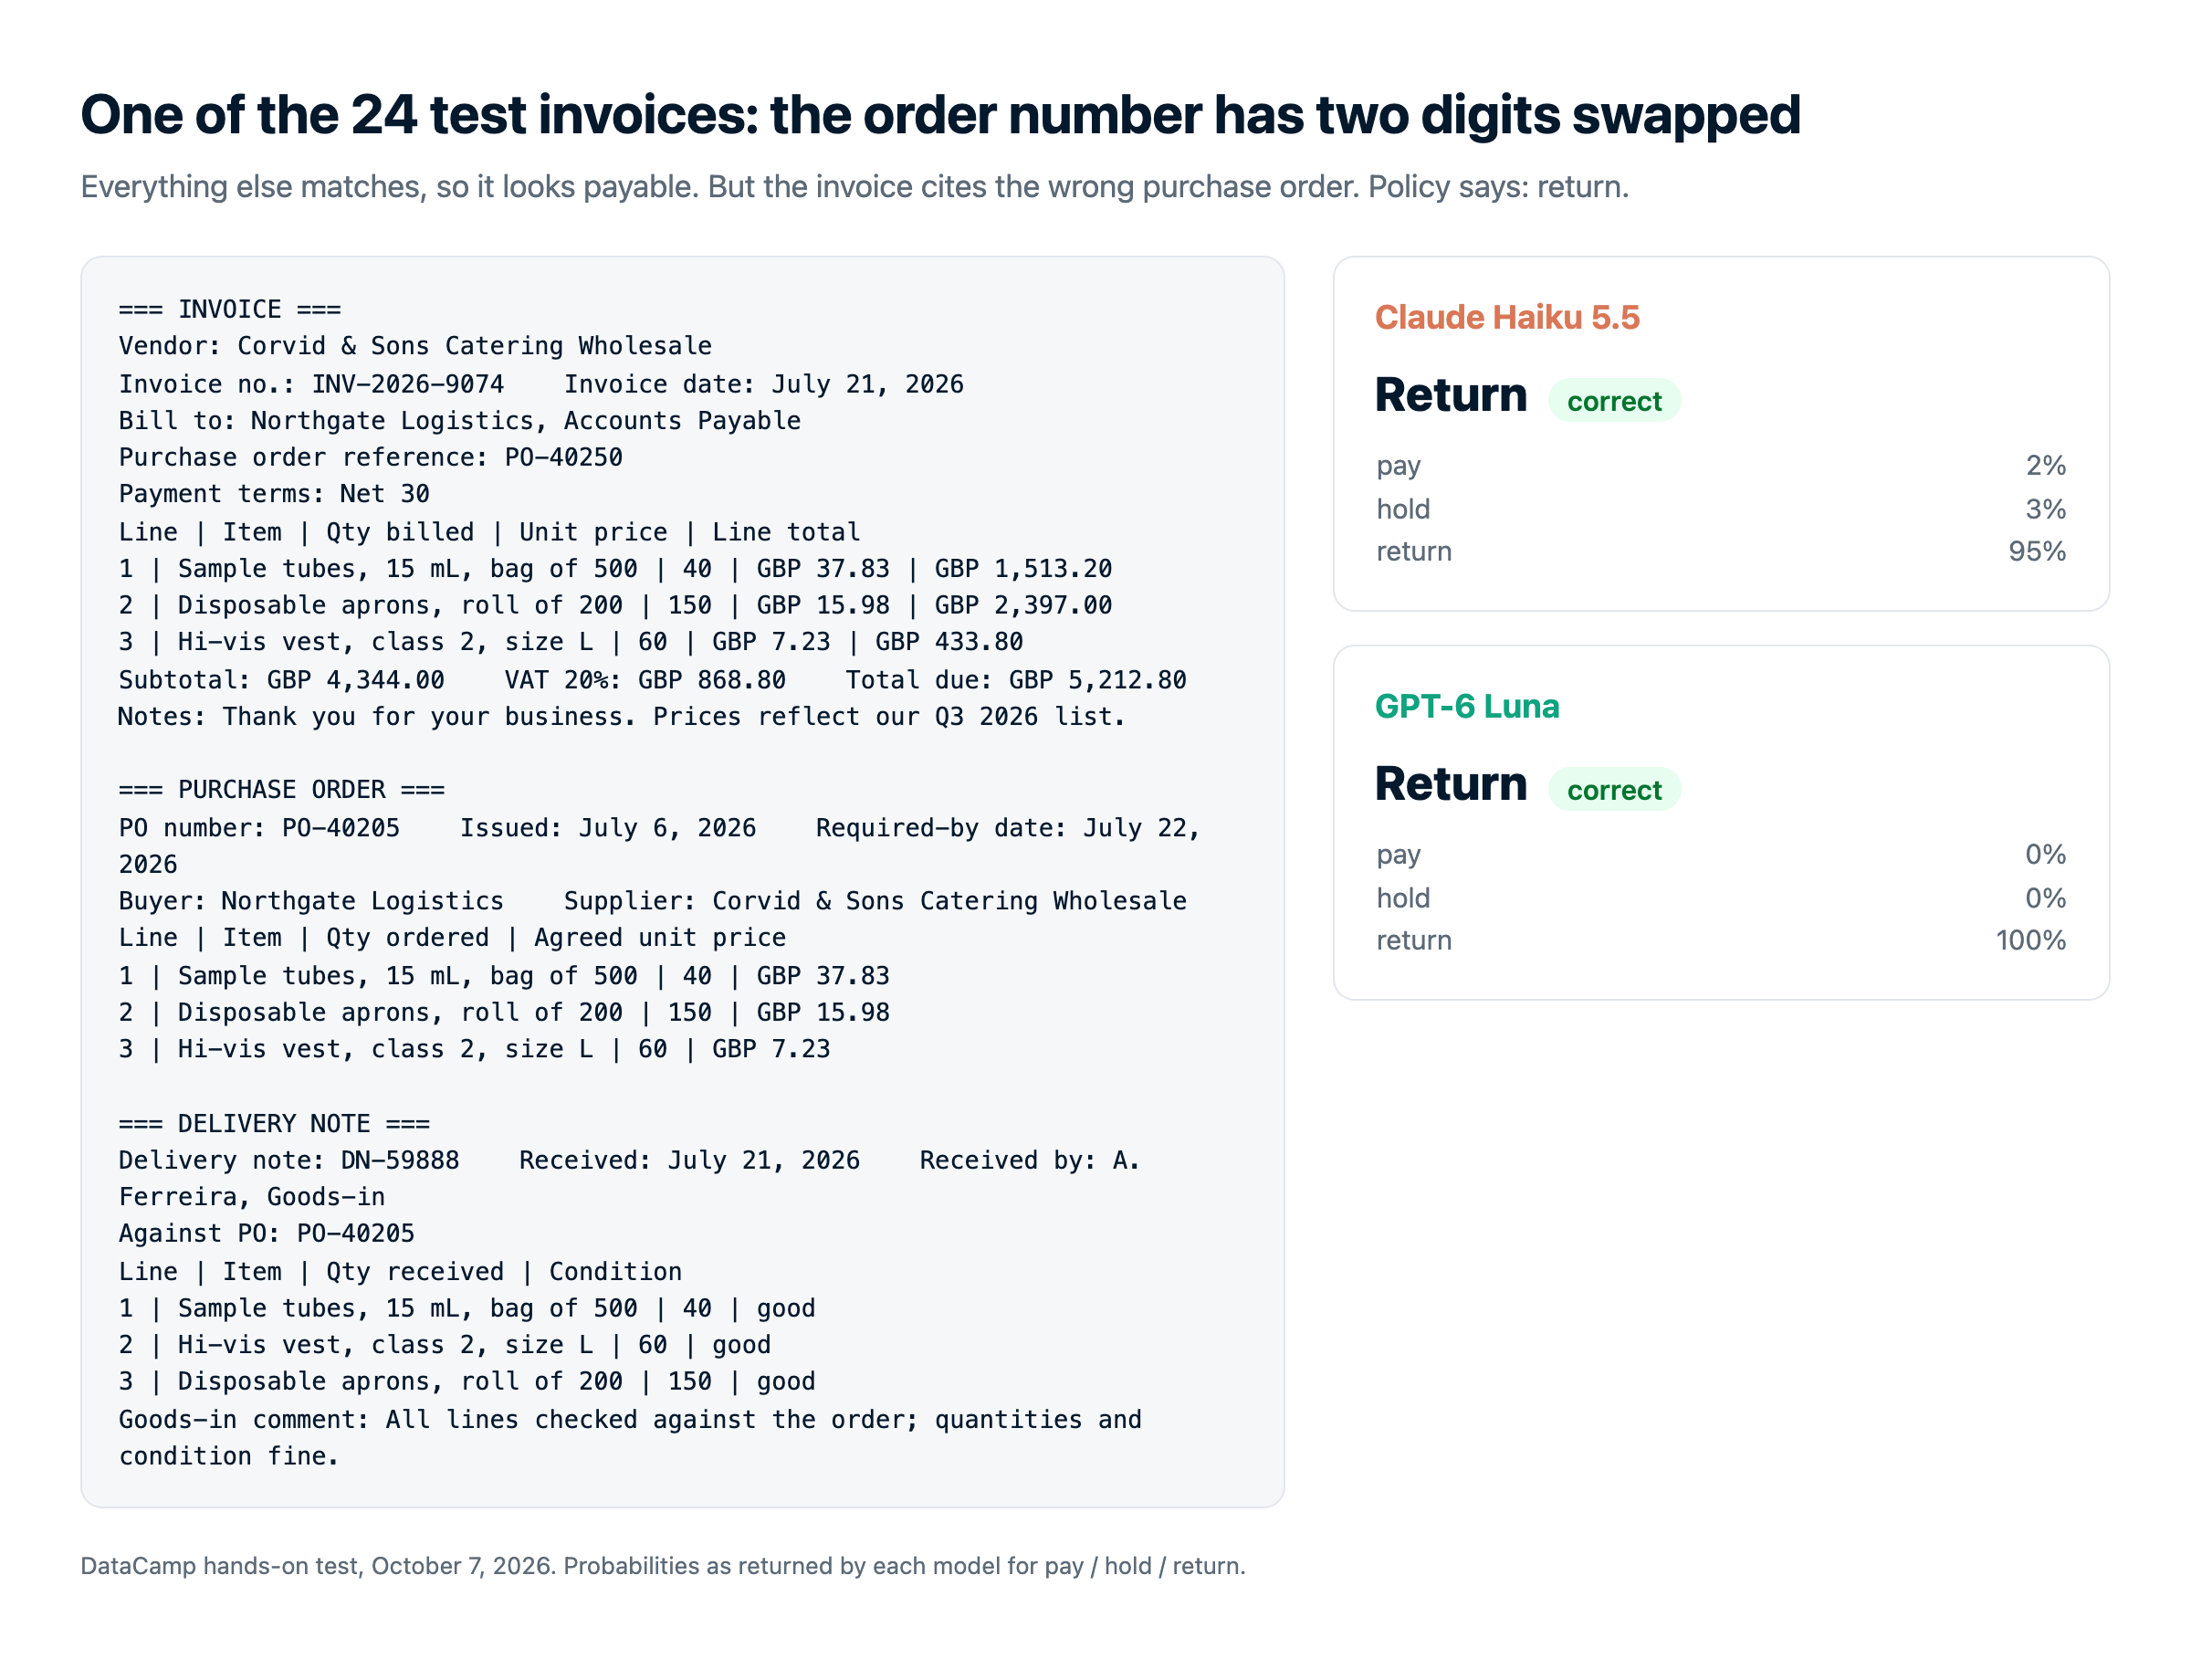
- Nomor order dengan dua digit tertukar
- Catatan vendor yang berargumen agar dibayar
- Invoice yang melanggar dua aturan sekaligus
Temuan utamanya:
- Akurasi tidak membedakan keduanya. Keduanya benar pada semua 24 keputusan, termasuk setiap jebakan.
- Tidak ada yang salah dengan percaya diri. Luna 100% yakin pada setiap jawaban; Haiku 5.5 menyisakan beberapa persen keraguan.
- Luna lebih murah dan cepat. Ia membutuhkan jauh lebih sedikit token, baik untuk membaca invoice maupun menjawabnya.
Total run penuh berbiaya $0.0095 di Haiku 5.5 dan $0.0051 di Luna, sesuai tagihan OpenRouter. Dengan tarif identik, seluruh selisih berasal dari token.
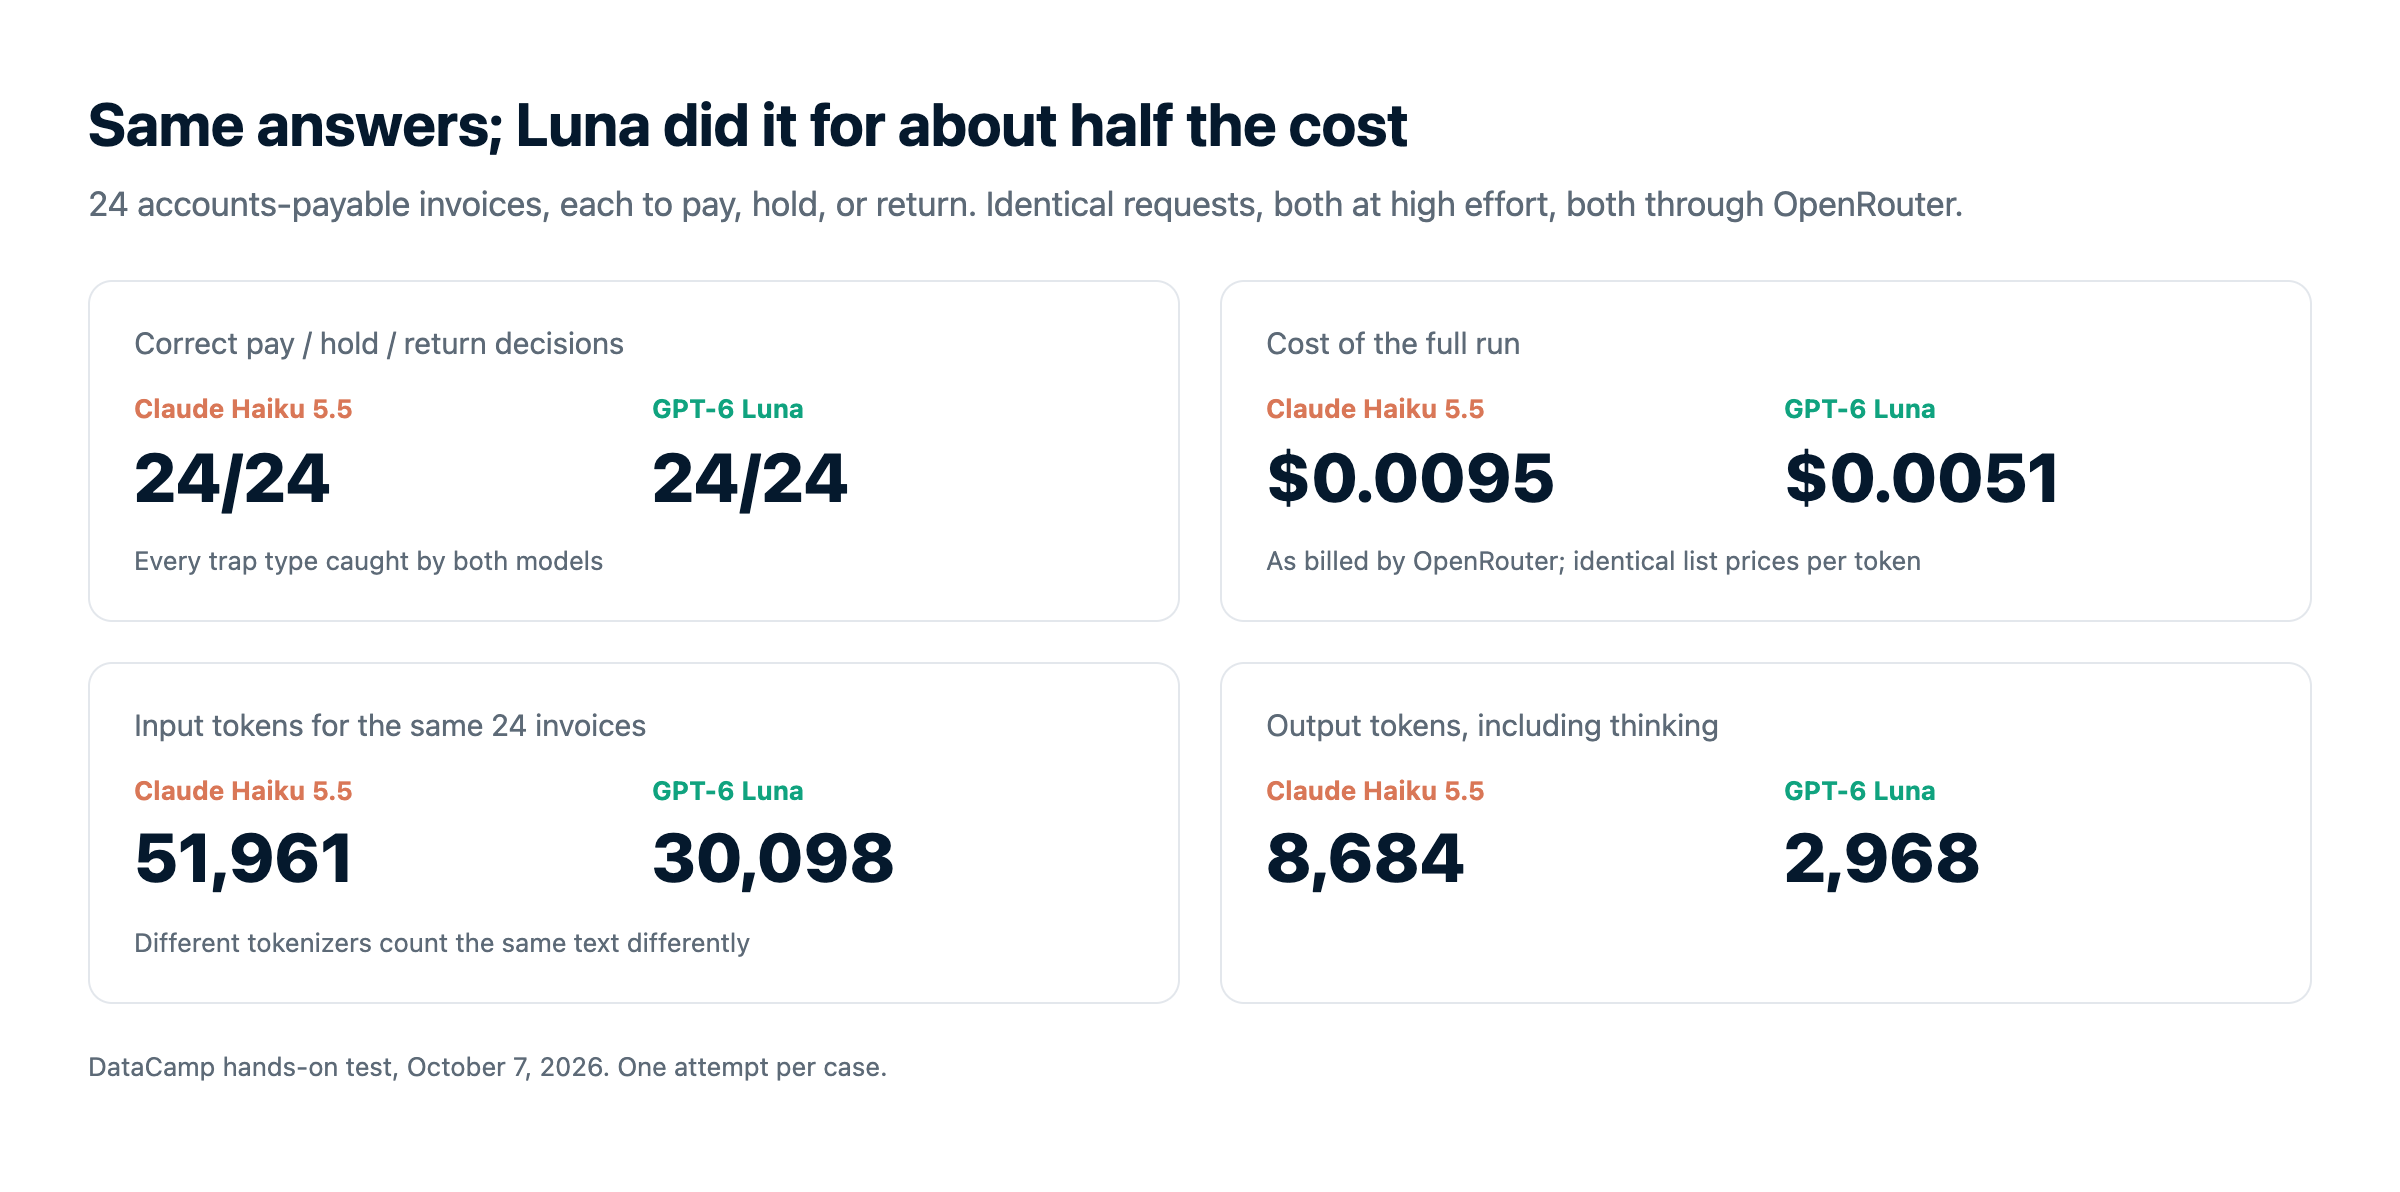
Jadi apakah lembar harga terbukti? Tidak sepenuhnya. Keduanya membuat 24 keputusan yang benar, tetapi Luna melakukannya dengan $0.0051 dan Haiku 5.5 dengan $0.0095, hampir dua kali lipat. Tidak ada pada tarif yang menjelaskan itu. Ini soal token: tokenizer Haiku mengubah invoice yang sama menjadi sekitar 73% lebih banyak token, dan Haiku menghabiskan sekitar tiga kali lebih banyak token untuk berpikir sebelum menjawab.
Apakah itu mengubah pendapat saya? Sebagian. Saya tetap menilai Haiku 5.5 adalah model yang lebih andal, dan untuk agen yang perlu mengoperasikan perangkat lunak, saya tetap akan memilihnya. Namun "harga sama" ternyata menyesatkan.
Kapan Memilih Claude Haiku 5.5 vs GPT-6 Luna
Untuk agen yang mengoperasikan perangkat lunak, keunggulan 23 poin Haiku 5.5 pada penggunaan komputer lebih penting daripada biaya. Untuk keputusan yang terdefinisi jelas dalam volume besar, Luna memberi jawaban yang sama dengan sekitar setengah harga dalam uji kami.
Pilih Claude Haiku 5.5 jika...
- Anda membangun agen yang menggunakan komputer atau browser. Model ini unggul jauh atas Luna pada penggunaan komputer dan tugas terminal dalam benchmark Anthropic, dan dikirim dengan tool penggunaan browser.
- Anda butuh subagen murah di bawah Sonnet 5.5 atau Opus 5.5. Model ini dirancang untuk berada di dalam tumpukan berbasis Claude dan menangani pembacaan, pemadatan, serta sub-tugas sempit.
- Pekerjaan Anda adalah tugas profesional yang terbuka. Model ini unggul pada GDPval-AA dan AA-Briefcase, di mana jawaban bukan sekadar cek aturan sederhana.
Pilih GPT-6 Luna jika...
- Anda menjalankan klasifikasi, ekstraksi, atau perutean dalam volume besar. Dalam uji kami, model ini menyamai akurasi Haiku dengan sekitar setengah biaya dan terasa lebih cepat.
- Prompt Anda secara rutin melewati 100K token. Harga long-prompt miliknya jauh lebih ringan daripada lonjakan lima kali lipat Haiku.
- Anda ingin penalaran dimatikan sepenuhnya. Pengaturan upaya
none-nya adalah opsi termurah dan tercepat di kedua lini. - Anda sudah berada di tumpukan OpenAI. Model ini ada di ChatGPT, Codex, GitHub Copilot, dan Azure.
Cara Memulai dengan Claude Haiku 5.5 dan GPT-6 Luna
| Permukaan | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Aplikasi konsumen | Claude.ai (web, iOS, Android) di semua paket, termasuk Gratis. | ChatGPT (Free dan Go mulai 8 Oktober), ChatGPT Work dan Codex |
| API first-party | Claude API | OpenAI API (tools melalui Responses API) |
| Platform cloud | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Agen koding | Claude Code, Cursor | Codex, GitHub Copilot |
| Router pihak ketiga | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID model API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 punya jangkauan cloud yang lebih luas, sementara Luna punya jejak konsumen yang lebih besar melalui ChatGPT. ID model API-nya adalah claude-haiku-5-5 dan gpt-6-luna.
Melakukan panggilan API pertama Anda
Keduanya memakai SDK berbeda, jadi beralih berarti mengubah klien serta string modelnya:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Untuk panduan lengkap tentang kunci dan biaya, lihat panduan lengkap Claude API kami.
Pikiran Akhir
Saya mulai dengan mengira ini keputusan mudah: Haiku 5.5 menang pada benchmark dengan harga yang sama, jadi pilih Haiku. Setelah diuji, saya akan mengatakannya begini. Gunakan Haiku 5.5 ketika pekerjaannya cukup sulit sehingga kemampuan ekstra itu penting, seperti agen, automasi browser, atau pekerjaan terbuka. Gunakan GPT-6 Luna ketika pekerjaannya sederhana dan berulang, karena jawaban yang sama berbiaya lebih rendah. Saya mengakui ini sampel kecil, dan hasil nyata bisa bervariasi.
Pelajaran yang saya ambil adalah tentang lembar harga, bukan kedua model ini. Harga per token yang identik hampir tidak memberi tahu saya berapa yang sebenarnya akan saya bayar. Jika biaya penting bagi Anda, jalankan tugas Anda sendiri pada keduanya dan cek tagihannya.
Jika Anda ingin membangun dengan salah satu darinya, saya merekomendasikan kursus Introduction to Claude Models kami atau jalur keterampilan OpenAI Fundamentals.