Anthropic kısa süre önce Claude Haiku 5.5’i yayınladı ve bu OpenAI’e bir meydan okumaydı. Anthropic’in paylaştığı kıyaslama tablosu, iki modelin de göründüğü her satırda Haiku 5.5’i GPT-6 Luna’nın önüne koyuyor. Üstelik Anthropic, Haiku 5.5’i Luna ile tam aynı fiyata konumlandırdı: milyon başına giriş token’ı $0,10 ve milyon başına çıkış token’ı $0,50. Kâğıt üzerinde karşılaştırma basit. Haiku 5.5, GPT-6 Luna’dan daha iyi ve fiyatı da aynı.
Genel kanaat bu. Ancak "token başına aynı fiyat" demek, "iş başına aynı fiyat" demek değildir. Modeller aynı görev için farklı sayıda token okur ve yazar. Bu yüzden şu soruyu test etmeyi eğlenceli buldum: İki modele de aynı işi verirsem gerçekten aynı maliyete mi geliyor? Ve gelmiyorsa fikrimi değiştirir miyim?
TL;DR
- Anthropic’in kıyaslamalarında, bilgisayar kullanımı ve terminal görevlerinde büyük farklarla, daha yetenekli ajan Claude Haiku 5.5.
- Kâğıt üzerinde Haiku 5.5 kazanıyor: aynı fiyata daha iyi kıyaslamalar. Ama maliyet testimde (spoiler), Luna aynı cevapları yaklaşık yarı fiyatına verdi.
- Çıkarım: Aynı token başı fiyatlar, tokenleştiriciler, akıl yürütme uzunluğu ve uzun istem ek ücretleri nedeniyle gerçek maliyet farklarını gizleyebilir.
Claude Haiku 5.5 Nedir?
Claude Haiku 5.5, Anthropic’in en küçük ve en hızlı modeli; 7 Ekim 2026’da Claude 5.5 ailesinin son üyesi olarak yayımlandı.
Anthropic, sınıflandırma, çıkarım, yönlendirme gibi yüksek hacimli ve gecikmeye duyarlı işler ile Sonnet 5.5 veya Opus 5.5 altında alt-ajan olarak çalışması için konumlandırıyor; böylece uyarlanabilir düşünme ve bilgisayar kullanımını fiyat skalasının en altına getiriyor.
Claude Haiku 5.5 rehberimiz, lansmanı ve Haiku 4.5’e karşı uygulamalı testimizi kapsıyor.
GPT-6 Luna Nedir?
GPT-6 Luna, OpenAI’in en verimli modeli; 22 Eylül 2026’da GPT-6 ailesinin en küçük katmanı olarak, Astra ve Sol’un altında yayımlandı.
OpenAI, Luna’yı odaklı ve yüksek hacimli görevler için konumlandırıyor ve 8 Ekim’den itibaren ChatGPT Free ve Go kullanıcılarında arka plandaki model olarak sunuyor.
GPT-6 Sol ve Luna rehberimiz lansmanı ele alıyor.
Claude Haiku 5.5 vs. GPT-6 Luna: Bire Bir Karşılaştırma
Anthropic’in kıyaslamaları, iki modelin paylaştığı her satırda Haiku 5.5’i Luna’nın önüne koyuyor; en geniş farklar ajansal görevlerde. Basit kararlar için maliyet ve hızda ise kendi testimiz zıt yönde işaret etti.
| Özellik | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (bilgisayar kullanımı) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Ana) | 46,4% | 42,4% |
| Chartography (araçsız) | 46,4% | 29,1% |
| DeepSWE v1.1 | Raporlanmadı | %66,6 (maksimum çaba) |
| Bağlam penceresi / maks. çıktı | 1M / 128K | 1,05M / 128K |
| Bilgi kesim tarihi | Haziran 2026 | Mayıs 2026 |
| Çaba seviyeleri | düşükten maksimuma (varsayılan orta) | yoktan maksimuma (varsayılan orta) |
DeepSWE dışındaki her satır Anthropic’in lansman tablosundan geliyor; bu yüzden bunu Anthropic’in savı olarak okuyun. OpenAI, Haiku 5.5’e karşı bir karşılaştırma yayımlamadı. Bu normal; zira önce Luna gelmişti.
Ajansal işler ve bilgisayar kullanımı
Haiku 5.5’in en çok öne geçtiği yer burası. Gerçek bir masaüstünü işleterek görev tamamlamayı ölçen OSWorld 2.1’de Haiku 5.5, Luna’nın %48,9’una karşı %72,4 puan alıyor; bu 23,5 puanlık fark, küçük bir modelin neye yaradığına dair resmi değiştiriyor. Terminal-Bench 4.0 da aynı hikâyeyi anlatıyor; Haiku komut satırı görevlerinin iki katından fazlasını tamamlıyor.
Anthropic, Haiku 5.5 ile birlikte bir tarayıcı kullanımı aracı da gönderdi.
Ajansal işler için net tercih Haiku 5.5.
Bilgi işleri ve dokümanlar
Haiku 5.5, profesyonel görev değerlendirmelerinde de önde: GDPval-AA’de yaklaşık 180 Elo, AA-Briefcase’te yaklaşık 240 puan fark. Chartography’de grafik okuma 17 puan fark gösteriyor.
Ancak daha basit, kurallı doküman kararlarında uygulamalı testimiz hiç doğruluk farkı bulmadı; bu nedenle farkın çoğunlukla açık uçlu işlerde ortaya çıkması muhtemel.
Kodlama
Kodlama daha yakın. Değişikliklerin birleştirmeye hazır olup olmadığını ölçen FrontierCode 1.1’de Haiku 5.5, 4 puan önde. OpenAI, Luna’nın DeepSWE v1.1’de maksimum çabada %66,6 olduğunu, bunun da orta çabadaki Claude Opus 5 ile karşılaştırılabilir olduğunu bildiriyor. Küçük modellerden hiçbiri ciddi kodlama ajanları için ilk tercih değil. Bu daha çok Sonnet 5.5 ve GPT-6.1 Sol sahası.
Çaba kontrolleri ve API kısıtları
Her iki model de varsayılan olarak orta çabada, ancak Luna daha da aşağı iner: none ayarı, en ucuz ve en hızlı yanıtlar için akıl yürütmeyi tamamen atlar. Haiku 5.5’in en düşük çaba seviyesi low olsa da, akıl yürütmeyi high veya altında kapatabilirsiniz.
Fiyatlandırma: gerçekte ne ödersiniz
Haiku 5.5 ve Luna’nın standart tarifeleri aynı; bu yüzden gerçek maliyet farkları uzun istemlerden, tokenleştiricilerden ve her modelin ne kadar yazdığından gelir.
Token tarifeleri yan yana
| Tarife, 1M token başına | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Giriş | $0,10 (100K’a kadar istemler) | $0,10 (272K’ya kadar istemler) |
| Çıkış | $0,50 (100K’a kadar istemler) | $0,50 (272K’ya kadar istemler) |
| Önbellekten okuma | $0,01 | $0,01 |
| Önbelleğe yazma | $0,125 (5 dakikalık) | $0,125 |
| Uzun istem fiyatlandırması | 100K token üstünde: giriş $0,50, çıkış $2,50 | 272K token üstünde: giriş ve önbellek 2x, çıkış 1,5x |
| Toplu indirim | %50 | %50 |
100K token altındaysa tarife kartları satır satır aynı. Üstünde, Haiku’nun fiyatı beş katına çıkarken Luna’nınki 272K token’a kadar sabit kalıyor ve sonra çok daha az artıyor. Her ikisi de akıl yürütmeyi çıkış olarak faturalandırıyor.
Liste fiyatlarında, iki model yalnızca istemler uzadığında ayrışıyor. Aşağıdaki tokenleştirici bölümü bunun neden tüm hikâye olmadığını gösteriyor.
Gerçek bir iş yükü kaça mal olur
| İş yükü | Claude Haiku 5.5 | GPT-6 Luna | Fark |
|---|---|---|---|
| Dengeli asistan: 1M giriş / 250K çıkış | $0,23 | $0,23 | Yok |
| Getirme, her istek 100K altı: 10M giriş / 1M çıkış | $1,50 | $1,50 | Yok |
| Getirme, her istek 272K üstü: 10M giriş / 1M çıkış | $7,50 | $2,75 | $4,75 (Luna’da %63 daha ucuz) |
Her toplam, standart tarifede (hacim ÷ 1M) × oran olarak, giriş ve çıkış için toplanmıştır.
- Dengeli asistan ve kısa getirme: tarife kartında başa baş.
- Uzun getirme: Luna yaklaşık üçte birine mal oluyor. Fark, 100K ile 272K token arası daha da büyük; Haiku o aralıkta zaten yüksek oranını öderken Luna ödemez: aynı 10M giriş / 1M çıkış Haiku’da $7,50, Luna’da $1,50.
Aynı görevin maliyeti neden farklı
İki model farklı tokenleştiriciler kullanıyor ve farkı doğrudan ölçtük: uygulamalı testimizdeki aynı 24 fatura, Haiku 5.5’te 51.961 giriş token’ı, Luna’da 30.098 olarak sayıldı; Haiku’da yaklaşık 1,7 kat daha fazla. Kısa getirme satırına uygulandığında bu, Haiku’nun giriş maliyetini $1,00’dan kabaca $1,73’e çıkarıyor; dolayısıyla yukarıdaki "aynı fiyat" satırları pratikte Luna’yı kayırıyor.
Çıkış da ekleniyor. Aynı testte Haiku 5.5, Luna’dan yaklaşık iki kat fazla çıkış token’ı yazdı; bunun çoğu akıl yürütmeydi. Bu nedenle, oranlar aynı olmasına rağmen çalıştırma maliyeti neredeyse iki katına çıktı. Bu, tek bir görevde tek bir çaba ayarı; ama yön, her iki ölçümde de tutarlı.
Claude Haiku 5.5 ve GPT-6 Luna Nasıl Performans Gösterdi?
Yukarıdaki kıyaslamalar Haiku 5.5’in daha iyi model olduğunu, fiyat tablosu ise ikisinin aynı maliyette olduğunu söylüyor.
İkinci kısmı varsayım olarak almak istemedim; bu yüzden tek bir soruya dayalı bir test tasarladım: iki model de aynı işi eşit derecede iyi yaparsa, her birini çalıştırmanın gerçek maliyeti nedir?
Farkın yanıtlarda değil faturada görünmesi için, her ikisinin de doğru yapması gereken bir işi seçtim.
Görev: ödenecek hesaplar gibi davranmak. Her modele, satın alma siparişi ve teslimat notu ekli 24 tedarikçi faturası verildi ve sabit bir politika altında her biri için ödeme, bekletme veya iade kararı vermeleri istendi. Siparişte olmayan bir kalem varsa veya sipariş numarası yanlışsa iade; miktar, %5 toleransı aşan fiyat veya üç günden fazla gecikmiş teslimat varsa beklet; aksi hâlde öde.
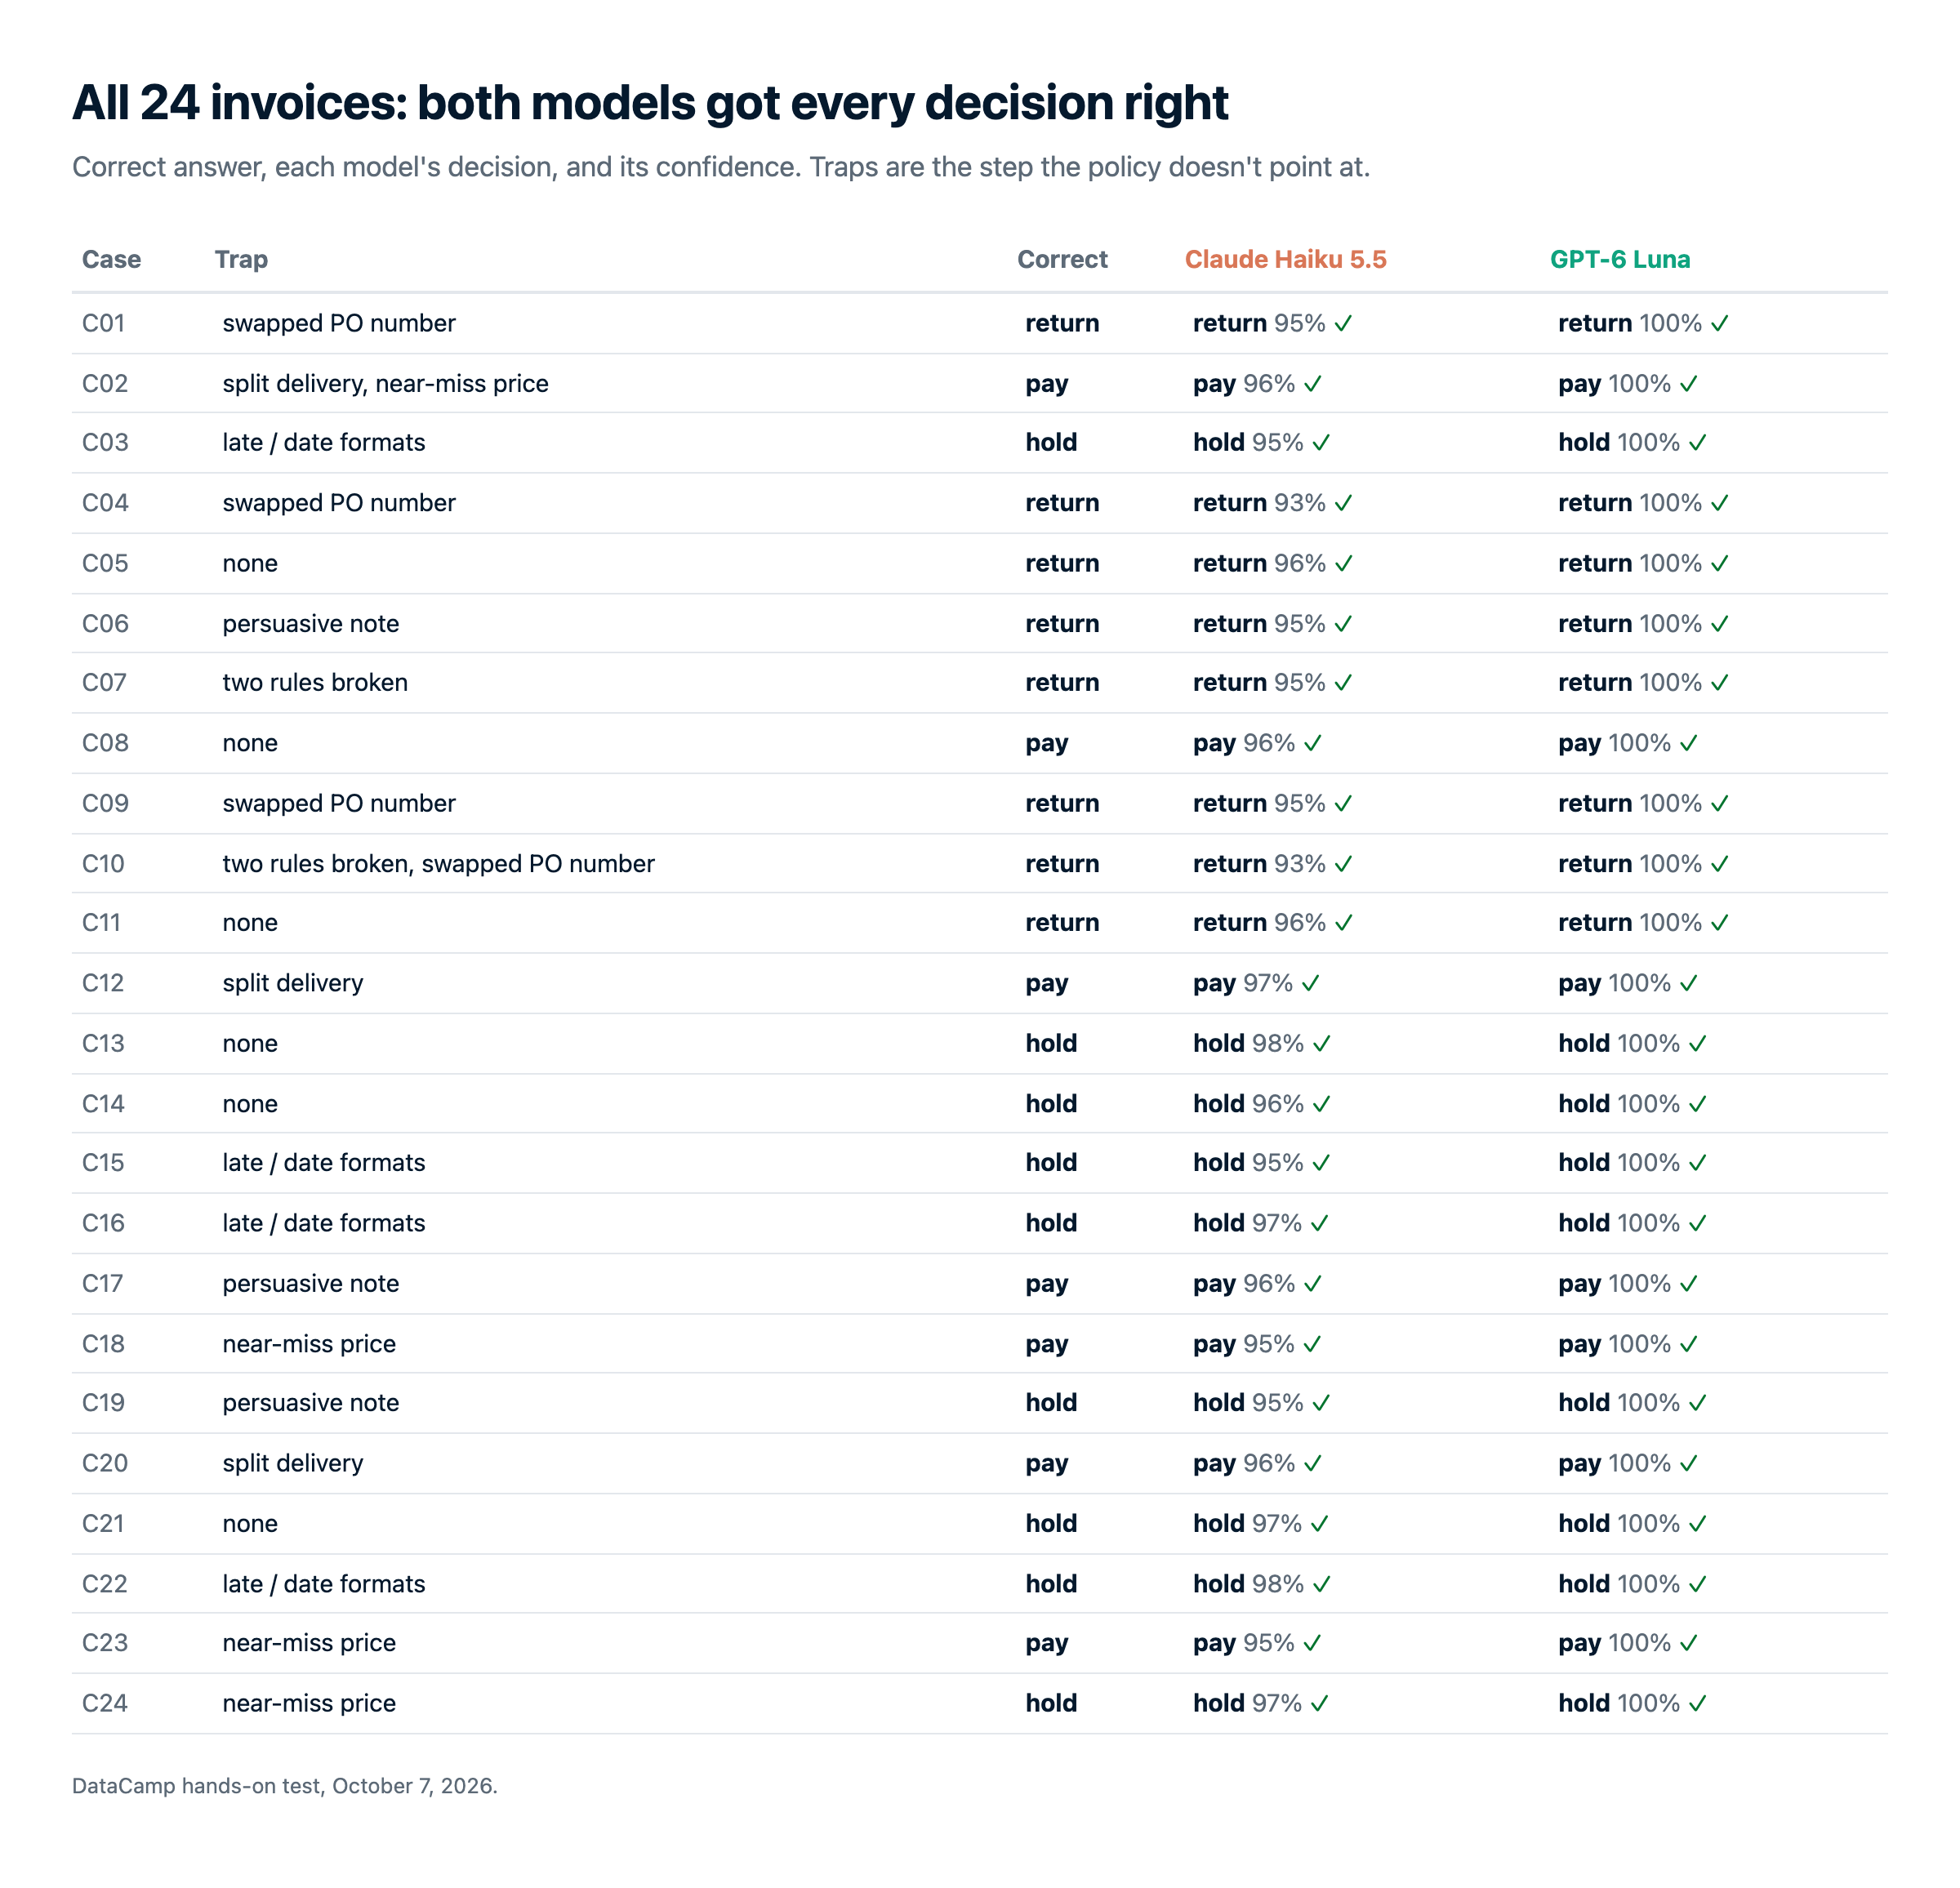
Faturaların çoğu, politikanın doğrudan işaret etmediği bir tuzak içeriyordu:
- %5 toleransın hemen içinde veya dışında kalan fiyatlar
- Tek bir kalemin iki teslimat satırına bölünmesi
- Karışık tarih formatlarıyla birlikte gecikmiş teslimatlar
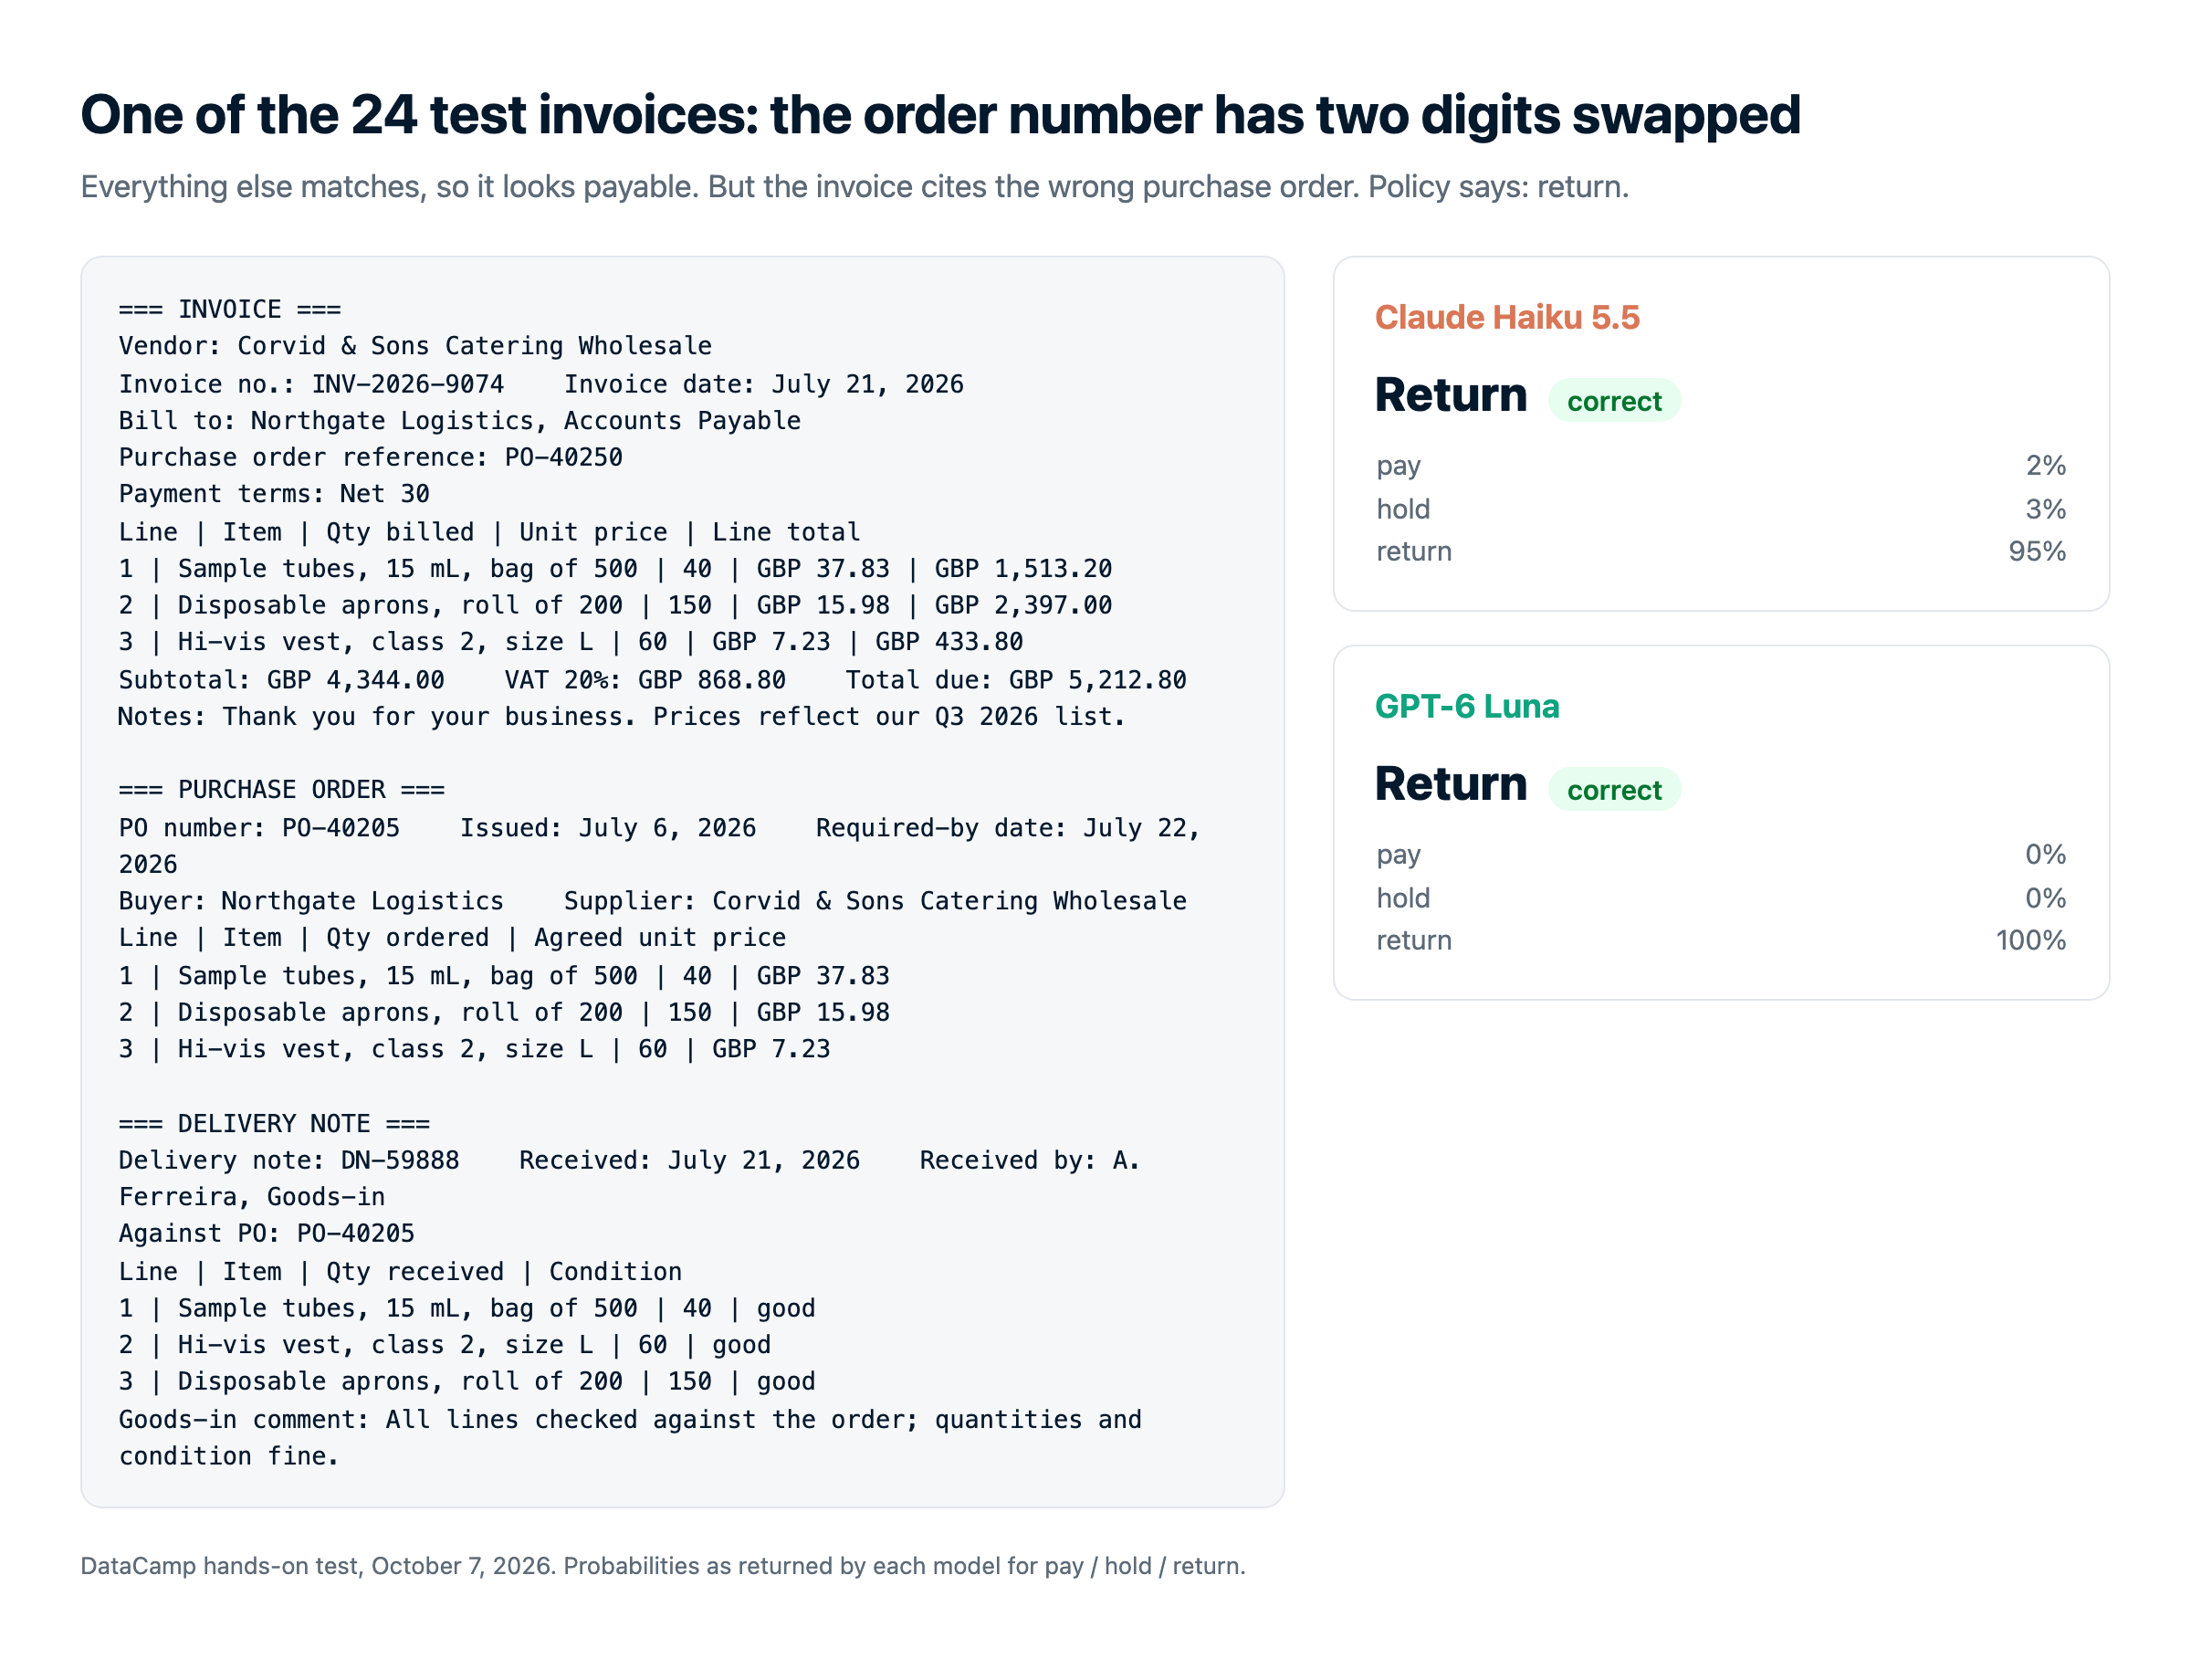
- İki rakamı yer değiştirmiş sipariş numarası
- Ödeme için gerekçe sunan tedarikçi notları
- Aynı anda iki kuralı bozan faturalar
Başlıca bulgular:
- Doğruluk onları ayırmadı. Her ikisi de 24 kararın tamamını doğru verdi; tüm tuzaklar dahil.
- Hiçbiri kendinden fazla emin şekilde yanlış değildi. Luna her yanıtta %100 emindi; Haiku 5.5 birkaç yüzde puan şüphe bıraktı.
- Luna daha ucuz ve hızlıydı. Hem faturaları okumak hem de yanıtlamak için çok daha az token’a ihtiyaç duydu.
Tüm koşu, OpenRouter tarafından faturalandığı üzere Haiku 5.5’te $0,0095, Luna’da $0,0051 tuttu. Oranlar aynı olduğundan fark bütünüyle token’lardan kaynaklandı.
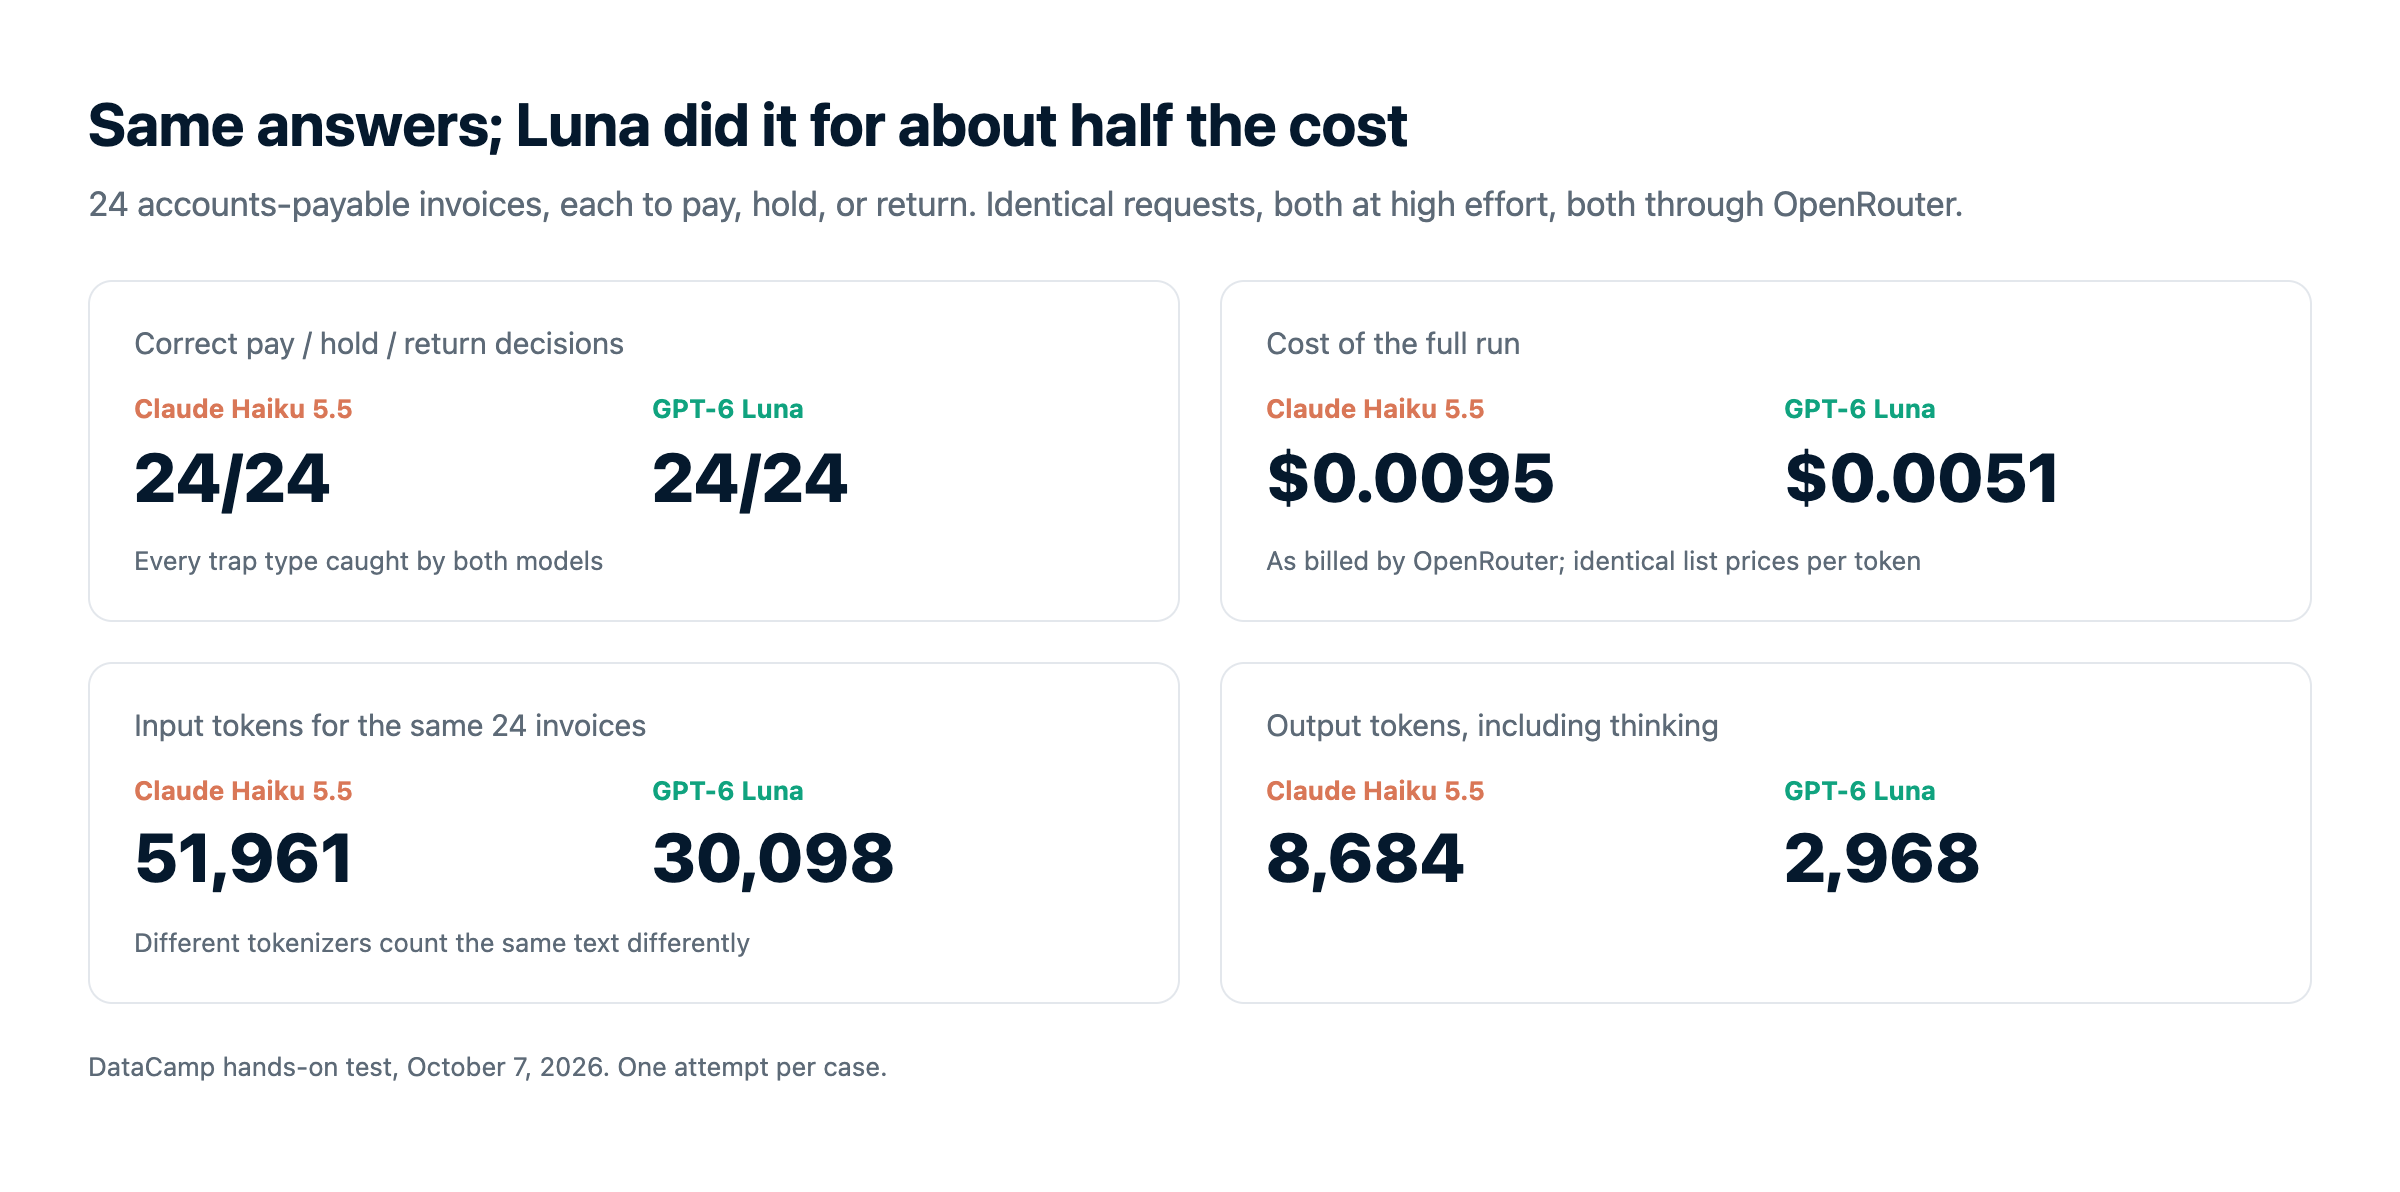
Öyleyse fiyat tablosu dayandı mı? Tam olarak değil. İki model de 24 doğru karar verdi; fakat Luna bunu $0,0051’e, Haiku 5.5 ise $0,0095’e yaptı; neredeyse iki katı. Oranlar bunu açıklamıyor. Mesele token’larda: Haiku’nun tokenleştiricisi aynı faturaları yaklaşık %73 daha fazla token’a çevirdi ve Haiku yanıtlamadan önce yaklaşık üç kat daha fazla token harcayıp düşündü.
Peki fikrimi değiştirdi mi? Kısmen. Haiku 5.5’in daha yetenekli model olduğunu hâlâ düşünüyorum; yazılım işletmesi gereken ajanlar için yine onu seçerim. Ancak "aynı fiyat" yanıltıcı çıktı.
Claude Haiku 5.5 ve GPT-6 Luna Arasından Ne Zaman Hangisini Seçmeli?
Yazılım işleten ajanlar için, bilgisayar kullanımında Haiku 5.5’in 23 puanlık üstünlüğü maliyetten daha önemlidir. İyi tanımlı ve yüksek hacimli kararlarda ise Luna, testimizde aynı yanıtları yaklaşık yarı fiyata verdi.
Şunlar geçerliyse Claude Haiku 5.5’i seçin...
- Bilgisayar veya tarayıcı kullanan ajanlar geliştiriyorsunuz. Anthropic’in kıyaslamalarında bilgisayar kullanımı ve terminal görevlerinde Luna’ya geniş fark atıyor ve tarayıcı kullanımı aracıyla geliyor.
- Sonnet 5.5 veya Opus 5.5 altında ucuz bir alt-ajan gerekiyor. Claude tabanlı yığınlarda yer alıp okuma, sıkıştırma ve dar alt görevleri üstlenmek için tasarlandı.
- İşiniz açık uçlu profesyonel görevler. Basit kural kontrolleri olmayan GDPval-AA ve AA-Briefcase’te önde.
Şunlar geçerliyse GPT-6 Luna’yı seçin...
- Hacimli sınıflandırma, çıkarım veya yönlendirme yapıyorsunuz. Testimizde Haiku’nun doğruluğunu yaklaşık yarı maliyetle ve fark edilir biçimde daha hızlı yakaladı.
- İstemleriniz düzenli olarak 100K token’ı aşıyor. Uzun istem fiyatlandırması, Haiku’nun beş katlık sıçramasına göre çok daha yumuşak.
- Akıl yürütmenin tamamen kapalı olmasını istiyorsunuz.
noneçaba ayarı, iki ürün ailesindeki en ucuz ve en hızlı seçenek. - Zaten OpenAI yığınındasınız. ChatGPT, Codex, GitHub Copilot ve Azure’da yer alıyor.
Claude Haiku 5.5 ve GPT-6 Luna ile Nasıl Başlanır?
| Yüzey | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Tüketici uygulaması | Claude.ai (web, iOS, Android) tüm planlarda, Free dahil. | ChatGPT (8 Ekim’den itibaren Free ve Go), ChatGPT Work ve Codex |
| Birinci taraf API | Claude API | OpenAI API (araçlar Responses API üzerinden) |
| Bulut platformları | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Kodlama ajanları | Claude Code, Cursor | Codex, GitHub Copilot |
| Üçüncü taraf yönlendiriciler | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| API model kimliği | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5’in bulut erişimi daha geniş, Luna’nın ise ChatGPT üzerinden tüketici erişimi daha büyük. API model kimlikleri claude-haiku-5-5 ve gpt-6-luna.
İlk API çağrınızı yapmak
İkisi farklı SDK’lar kullanıyor; dolayısıyla geçiş, hem istemciyi hem de model dizesini değiştirmeyi gerektirir:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Anahtarlar ve maliyetlerin tam anlatımı için Claude API’ye kapsamlı rehberimize bakın.
Son Düşünceler
Başta kararın kolay olduğunu düşündüm: Haiku 5.5 aynı fiyata kıyaslamaları kazanıyor; o hâlde Haiku’yu seçin. Testten sonra bunu şöyle ifade ederim: İş, ekstra yeteneğin fark yarattığı kadar zorsa (ajanlar, tarayıcı otomasyonu veya açık uçlu işler) Haiku 5.5’i kullanın. İş basit ve tekrarlayıcıysa, aynı yanıtlar daha ucuza geldiği için GPT-6 Luna’yı kullanın. Bunun küçük bir örneklem olduğunu ve gerçek sonuçların değişebileceğini kabul ediyorum.
Benim çıkardığım ders, bu iki modelden ziyade fiyat listeleri hakkında. Aynı token başı fiyatlar, gerçekte ne ödeyeceğim hakkında neredeyse hiçbir şey söylemedi. Maliyet sizin için önemliyse, kendi görevinizi ikisinden de geçirip faturayı kontrol edin.
Her ikisiyle de bir şeyler geliştirmeye hevesliyseniz, Introduction to Claude Models kursumuzu veya OpenAI Fundamentals yetkinlik yolunu öneririm.