A Anthropic lançou o Claude Haiku 5.5 recentemente, e foi um recado para a OpenAI. A tabela de benchmarks que a Anthropic compartilhou coloca o Haiku 5.5 à frente do GPT-6 Luna em todas as linhas onde ambos aparecem. E a Anthropic precificou o Haiku 5.5 exatamente igual ao Luna da OpenAI: US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de tokens de saída. No papel, a comparação é simples. O Haiku 5.5 é melhor que o GPT-6 Luna e custa o mesmo.
Essa é a primeira impressão. Mas "mesmo preço por token" não é o mesmo que "mesmo preço por tarefa". Os modelos leem e escrevem quantidades diferentes de tokens para o mesmo trabalho. Então achei que seria interessante conferir: se eu der o mesmo serviço para os dois, eles realmente custam o mesmo? E se não custarem, eu mudaria de opinião?
Resumo
- O Claude Haiku 5.5 é o agente mais competente, com grande vantagem em uso de computador e tarefas de terminal nos benchmarks da Anthropic.
- No papel, o Haiku 5.5 vence: melhores benchmarks pelo mesmo preço. Mas no meu teste de custo (spoiler), o Luna deu as mesmas respostas por cerca de metade do valor.
- O aprendizado: preços idênticos por token podem esconder diferenças reais de custo por causa de tokenizadores, comprimento do raciocínio e sobretaxas para prompts longos.
O que é o Claude Haiku 5.5?
O Claude Haiku 5.5 é o menor e mais rápido modelo da Anthropic, lançado em 7 de outubro de 2026 como o último membro da família Claude 5.5.
A Anthropic o posiciona para trabalho em alto volume e sensível à latência, como classificação, extração, roteamento e como subagente sob o Sonnet 5.5 ou Opus 5.5 — levando raciocínio adaptativo e uso de computador para a faixa de preço mais baixa.
Nosso guia do Claude Haiku 5.5 cobre o lançamento e nosso teste prático contra o Haiku 4.5.
O que é o GPT-6 Luna?
O GPT-6 Luna é o modelo mais eficiente da OpenAI, lançado em 22 de setembro de 2026 como o menor nível da família GPT-6, abaixo de Astra e Sol.
A OpenAI o posiciona para tarefas focadas e de alto volume, e está implementando o Luna como o modelo por trás do ChatGPT para usuários Free e Go a partir de 8 de outubro.
Nosso guia do GPT-6 Sol e Luna cobre o lançamento.
Claude Haiku 5.5 vs. GPT-6 Luna: comparação direta
Os benchmarks da Anthropic colocam o Haiku 5.5 à frente do Luna em todas as linhas que ambos compartilham, com as maiores diferenças em tarefas agentivas. Em custo e velocidade para decisões simples, nosso teste apontou o contrário.
| Recurso | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (uso de computador) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (principal) | 46,4% | 42,4% |
| Chartography (sem ferramentas) | 46,4% | 29,1% |
| DeepSWE v1.1 | Não informado | 66,6% (esforço máximo) |
| Janela de contexto / saída máxima | 1M / 128K | 1,05M / 128K |
| Data limite de conhecimento | junho de 2026 | maio de 2026 |
| Níveis de esforço | baixo a máximo (padrão médio) | nenhum a máximo (padrão médio) |
Todas as linhas, exceto DeepSWE, vêm da tabela de lançamento da Anthropic, então leia como o argumento da Anthropic; a OpenAI não publicou uma comparação contra o Haiku 5.5. Isso é normal, já que o Luna veio antes.
Trabalho agentivo e uso de computador
É aqui que o Haiku 5.5 se distancia mais. No OSWorld 2.1, que testa se um modelo consegue concluir tarefas operando um desktop real, o Haiku 5.5 faz 72,4% contra 48,9% do Luna — uma diferença de 23,5 pontos que muda o que um modelo pequeno consegue fazer. O Terminal-Bench 4.0 conta a mesma história, com o Haiku concluindo mais que o dobro de tarefas em linha de comando.
A Anthropic também lançou uma ferramenta de uso de navegador junto com o Haiku 5.5.
Para trabalho agentivo, o Haiku 5.5 é a escolha clara.
Trabalho intelectual e documentos
O Haiku 5.5 também lidera em avaliações de tarefas profissionais: cerca de 180 pontos Elo à frente no GDPval-AA e aproximadamente 240 no AA-Briefcase. A leitura de gráficos no Chartography mostra uma diferença de 17 pontos.
Em decisões mais simples e baseadas em regras sobre documentos, porém, nosso teste prático não encontrou diferença de acurácia, então a vantagem provavelmente aparece mais em trabalhos abertos.
Programação
Em código, a disputa é mais apertada. No FrontierCode 1.1, que avalia se mudanças estão prontas para merge, o Haiku 5.5 lidera por 4 pontos. A OpenAI reporta o Luna com 66,6% no DeepSWE v1.1 em esforço máximo, comparável ao Claude Opus 5 em esforço médio. Nenhum dos modelos pequenos é a primeira escolha para agentes de código mais sérios. Isso fica mais para o território do Sonnet 5.5 e do GPT-6.1 Sol.
Controles de esforço e limites de API
Ambos os modelos usam esforço médio por padrão, mas o Luna vai mais baixo: sua configuração none pula o raciocínio completamente para respostas mais baratas e rápidas. O nível mais baixo do Haiku 5.5 é low, embora você ainda possa desligar o raciocínio em high ou abaixo.
Preços: o que você realmente paga
Haiku 5.5 e Luna têm tarifas padrão idênticas, então as diferenças reais de custo vêm de prompts longos, tokenizadores e de quanto cada modelo escreve.
Tarifas por token, lado a lado
| Tarifa, por 1M de tokens | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Entrada | US$ 0,10 (prompts até 100K) | US$ 0,10 (prompts até 272K) |
| Saída | US$ 0,50 (prompts até 100K) | US$ 0,50 (prompts até 272K) |
| Leitura em cache | US$ 0,01 | US$ 0,01 |
| Gravação em cache | US$ 0,125 (5 minutos) | US$ 0,125 |
| Preço para prompt longo | Acima de 100K tokens: US$ 0,50 entrada, US$ 2,50 saída | Acima de 272K tokens: 2x entrada e cache, 1,5x saída |
| Desconto em lote | 50% | 50% |
Abaixo de 100K tokens, as tabelas de preço são idênticas linha a linha. Acima disso, os preços do Haiku sobem cinco vezes, enquanto os do Luna ficam estáveis até 272K tokens e depois aumentam bem menos. Ambos cobram o raciocínio como saída.
Nos preços de lista, os dois só divergem quando os prompts ficam longos. A seção de tokenização abaixo mostra por que isso não é a história completa.
Quanto custa uma carga de trabalho real
| Carga de trabalho | Claude Haiku 5.5 | GPT-6 Luna | Diferença |
|---|---|---|---|
| Assistente equilibrado: 1M entrada / 250K saída | US$ 0,23 | US$ 0,23 | Nenhuma |
| Recuperação, cada requisição abaixo de 100K: 10M entrada / 1M saída | US$ 1,50 | US$ 1,50 | Nenhuma |
| Recuperação, cada requisição acima de 272K: 10M entrada / 1M saída | US$ 7,50 | US$ 2,75 | US$ 4,75 (63% mais barato no Luna) |
Cada total é (volume ÷ 1M) × tarifa, somado entre entrada e saída, nas tarifas padrão.
- Assistente equilibrado e recuperação curta: empate técnico na tabela de preços.
- Recuperação longa: o Luna custa cerca de um terço. A diferença é ainda maior entre 100K e 272K tokens, quando o Haiku já paga a tarifa mais alta, e o Luna não: os mesmos 10M entrada / 1M saída saem por US$ 7,50 no Haiku contra US$ 1,50 no Luna.
Por que a mesma tarefa custa valores diferentes
Os dois modelos usam tokenizadores diferentes, e medimos isso diretamente: as mesmas 24 faturas no nosso teste prático contaram 51.961 tokens de entrada no Haiku 5.5 e 30.098 no Luna — cerca de 1,7 vez mais no Haiku. Aplicado à linha de recuperação curta, isso eleva o custo de entrada do Haiku de US$ 1,00 para aproximadamente US$ 1,73, então as linhas de "mesmo preço" acima favorecem o Luna na prática.
A saída também pesa. No mesmo teste, o Haiku 5.5 escreveu cerca do dobro de tokens de saída em relação ao Luna, a maior parte em raciocínio — por isso a execução custou quase o dobro, apesar das tarifas idênticas. É uma tarefa em um nível de esforço, mas a direção é consistente nas duas medições.
Como Claude Haiku 5.5 e GPT-6 Luna se saíram
Os benchmarks acima dizem que o Haiku 5.5 é o melhor modelo, e a tabela de preços diz que os dois custam o mesmo.
Eu não quis aceitar a segunda parte sem testar, então desenhei um experimento com uma pergunta: se ambos fazem o mesmo trabalho igualmente bem, quanto cada um realmente custa para rodar?
Escolhi um trabalho em que ambos deveriam ser precisos, para que qualquer diferença aparecesse na conta — não nas respostas.
A tarefa: atuar como contas a pagar. Cada modelo recebeu 24 faturas de fornecedores, cada uma com seu pedido de compra e nota de entrega, e tinha que pagar, reter ou devolver cada uma seguindo uma política fixa. Devolver se houver item fora do pedido ou número de pedido errado; reter se houver quantidade, preço acima de 5% de tolerância ou entrega com mais de três dias de atraso; caso contrário, pagar.
A maioria das faturas escondia uma armadilha não explicitada pela política:
- Preços logo abaixo ou acima da tolerância de 5%
- Um item dividido em duas linhas de entrega
- Entregas atrasadas, algumas com formatos de data mistos
- Um número de pedido com dois dígitos trocados
- Observações do fornecedor argumentando pelo pagamento
- Faturas violando duas regras ao mesmo tempo
Principais resultados:
- Acurácia não os separou. Ambos acertaram as 24 decisões, incluindo todas as armadilhas.
- Nenhum errou com confiança. O Luna esteve 100% confiante em todas as respostas; o Haiku 5.5 manteve alguns pontos percentuais de dúvida.
- O Luna foi mais barato e rápido. Ele precisou de bem menos tokens, tanto para ler as faturas quanto para responder.
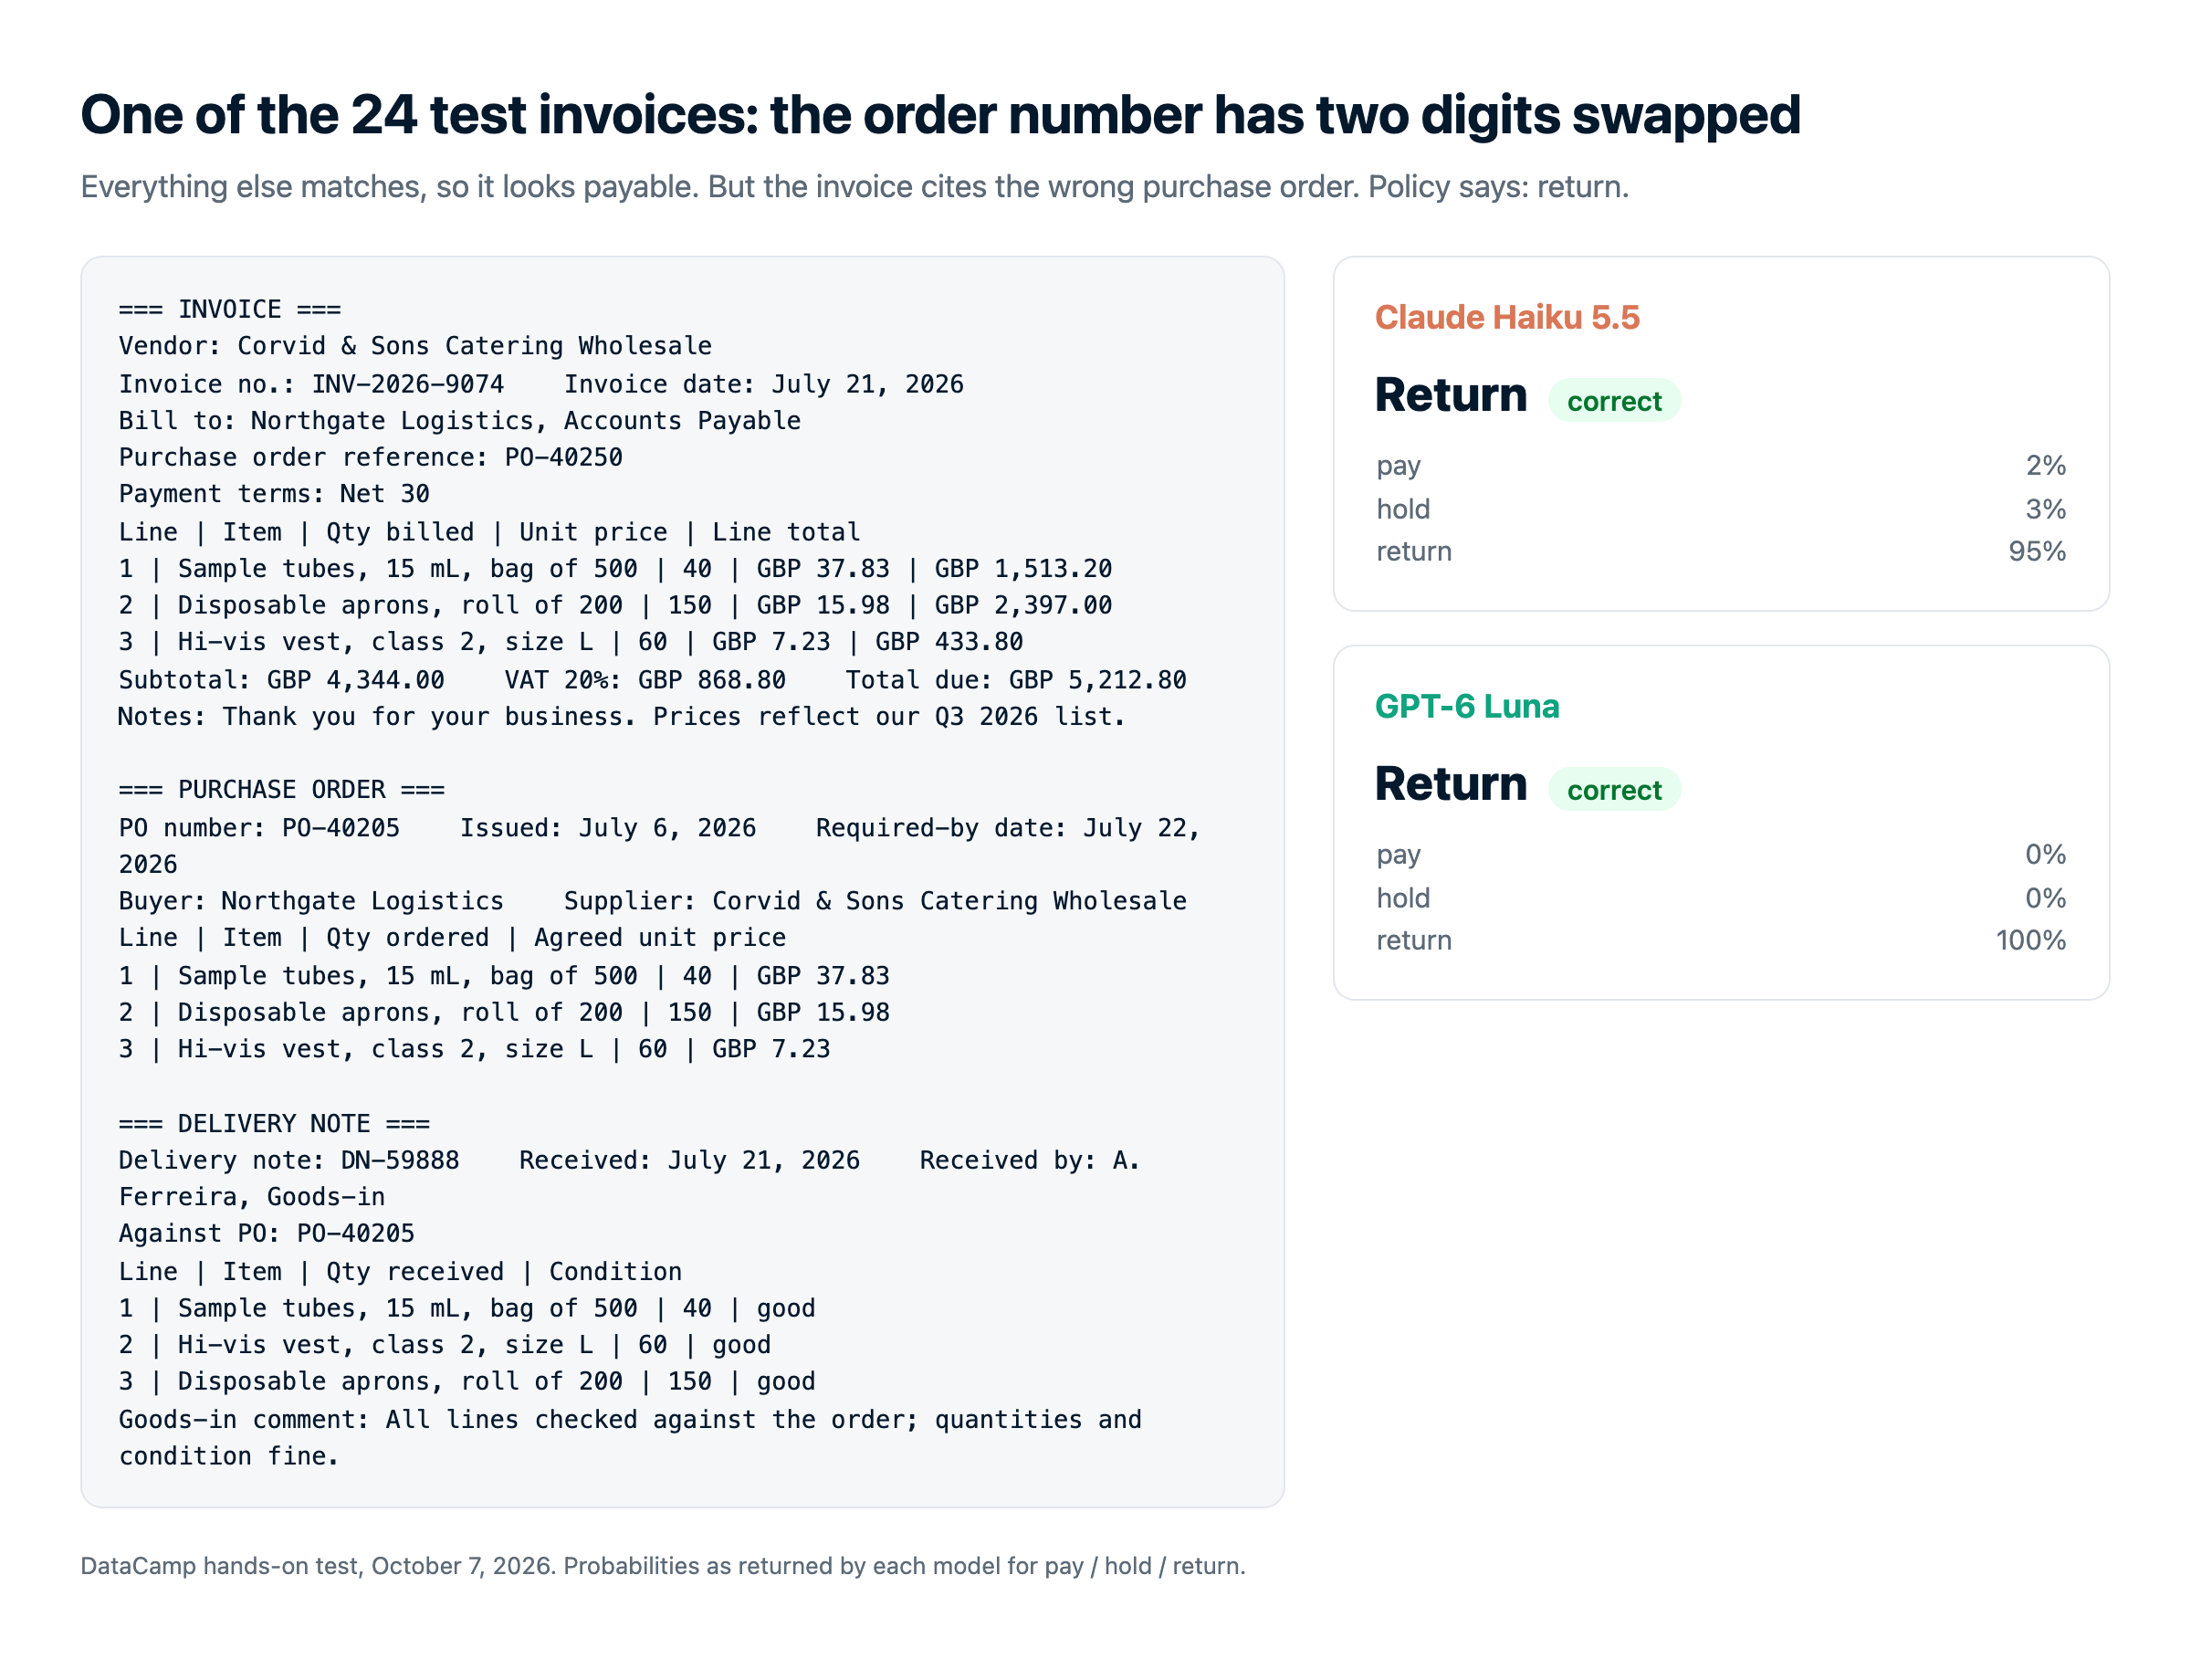
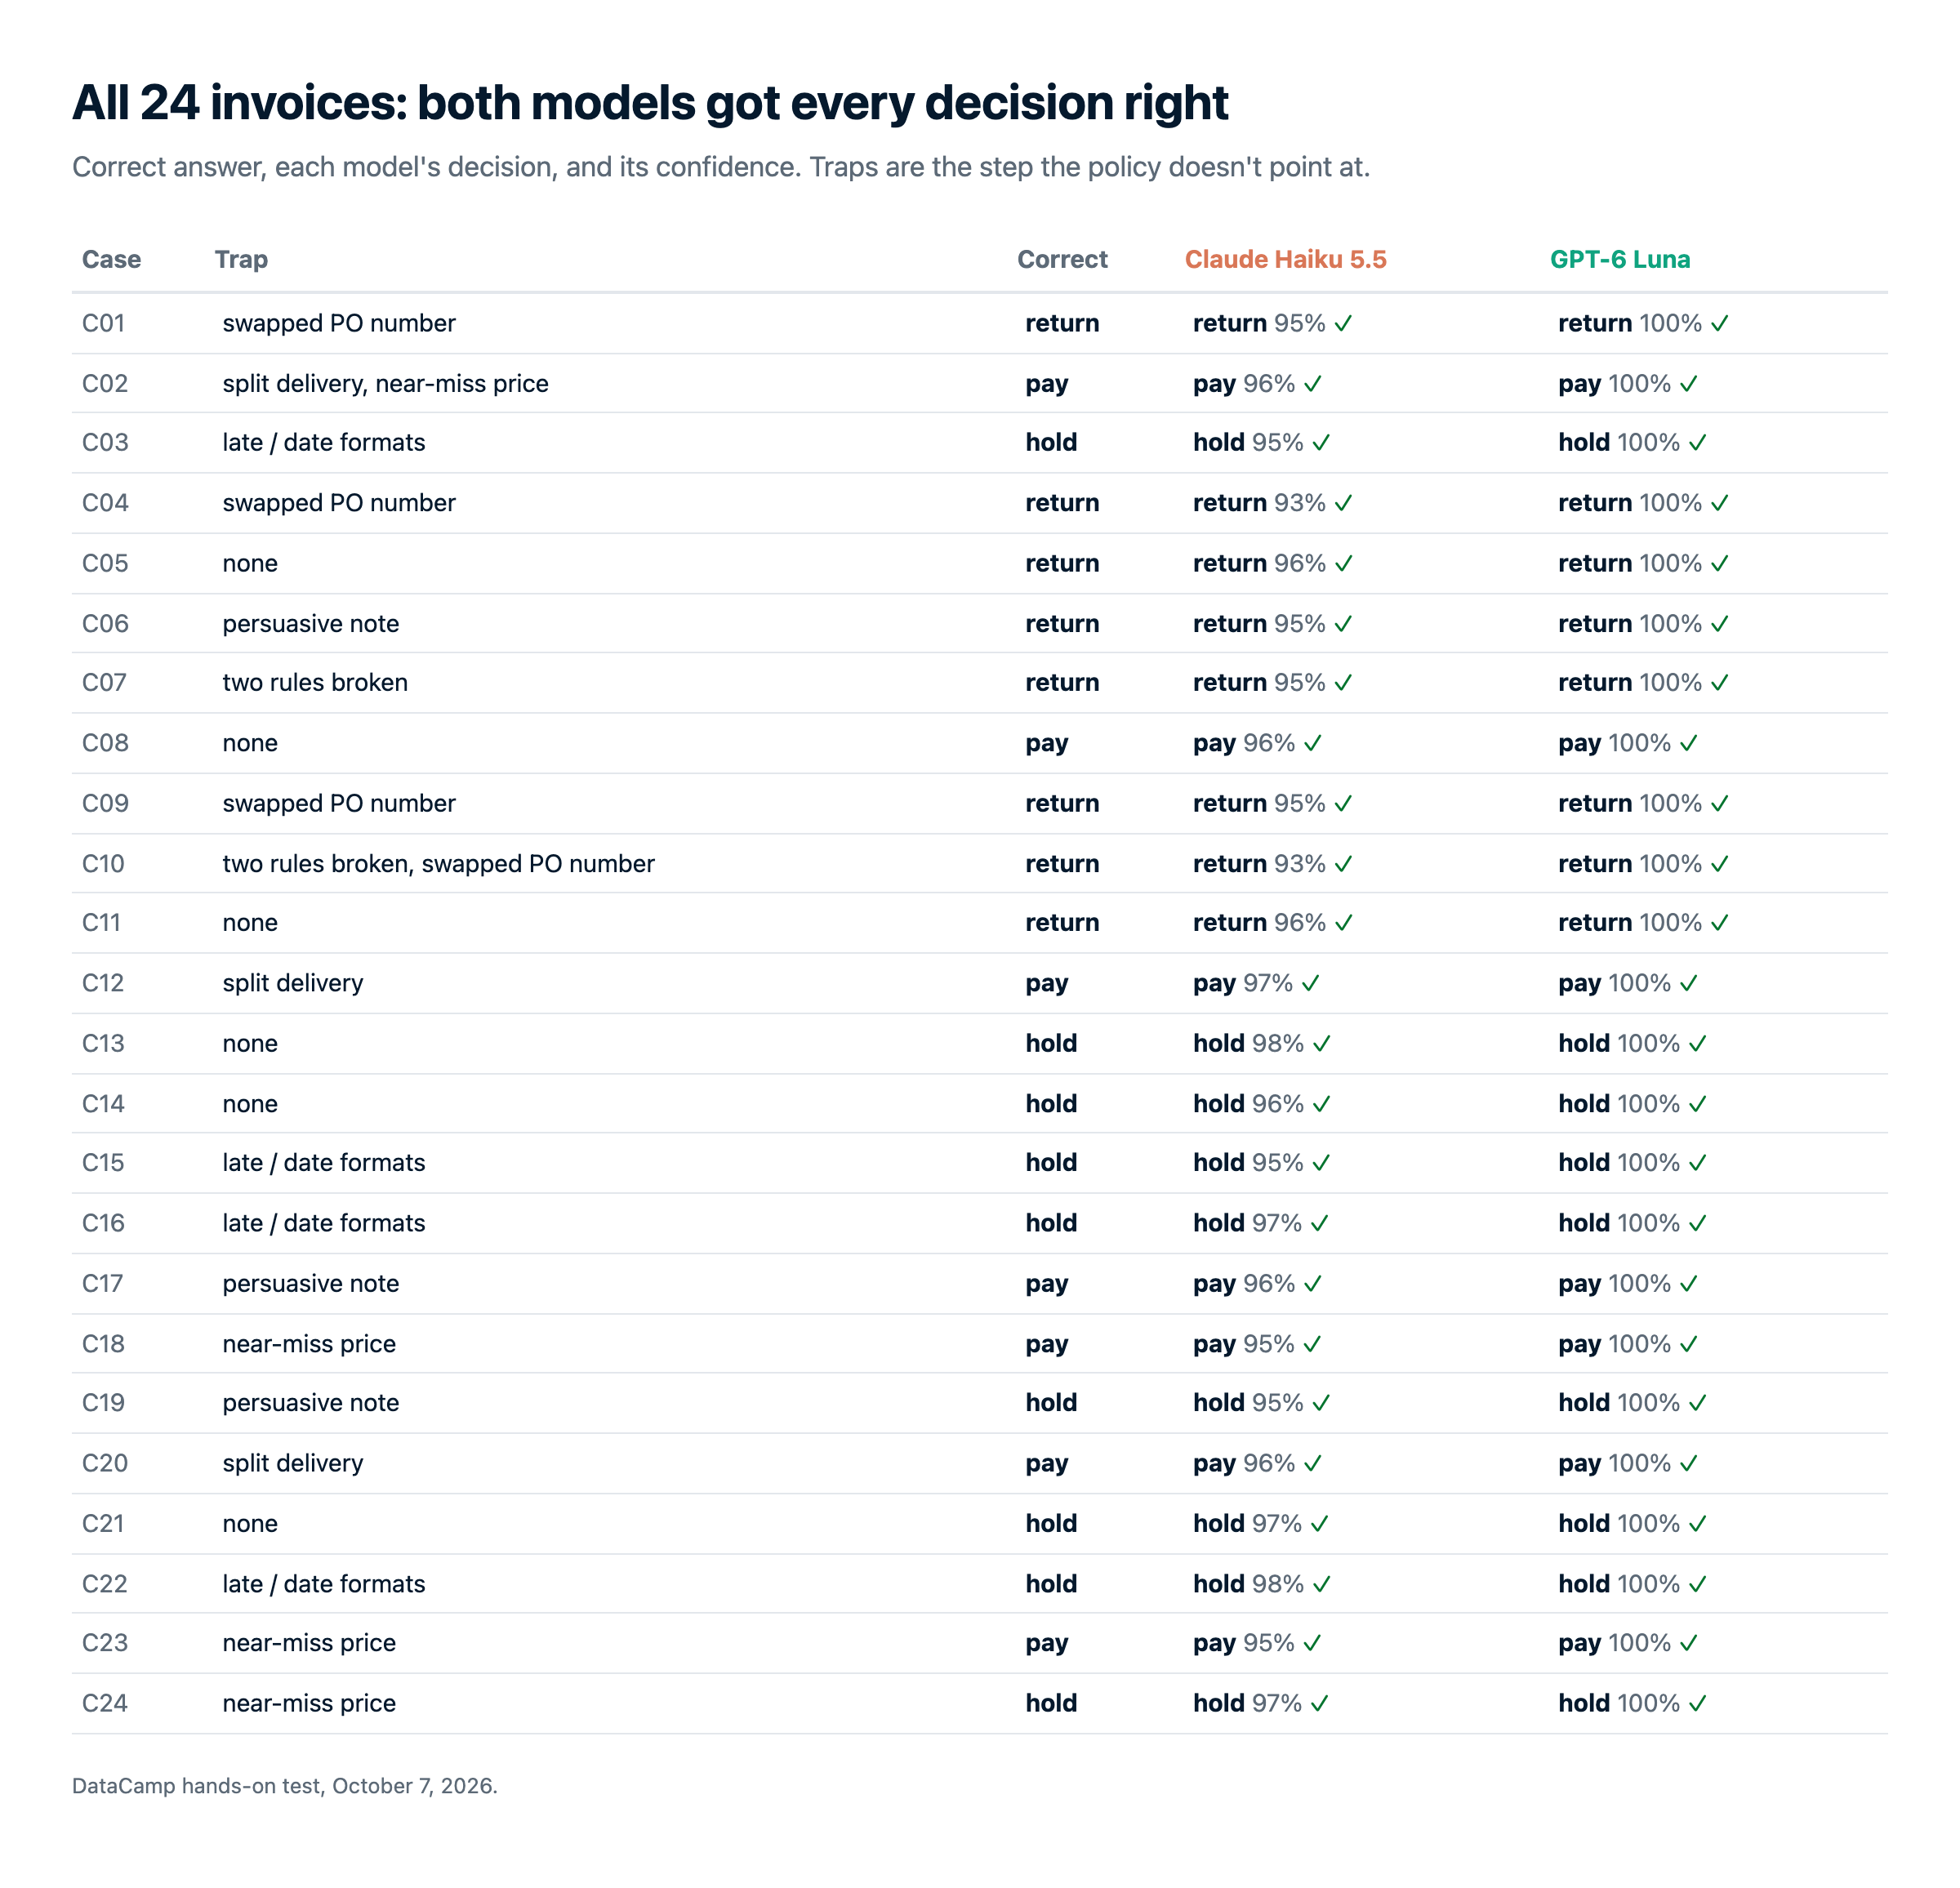
A execução completa custou US$ 0,0095 no Haiku 5.5 e US$ 0,0051 no Luna, conforme cobrado pelo OpenRouter. Com tarifas idênticas, toda a diferença vem dos tokens.
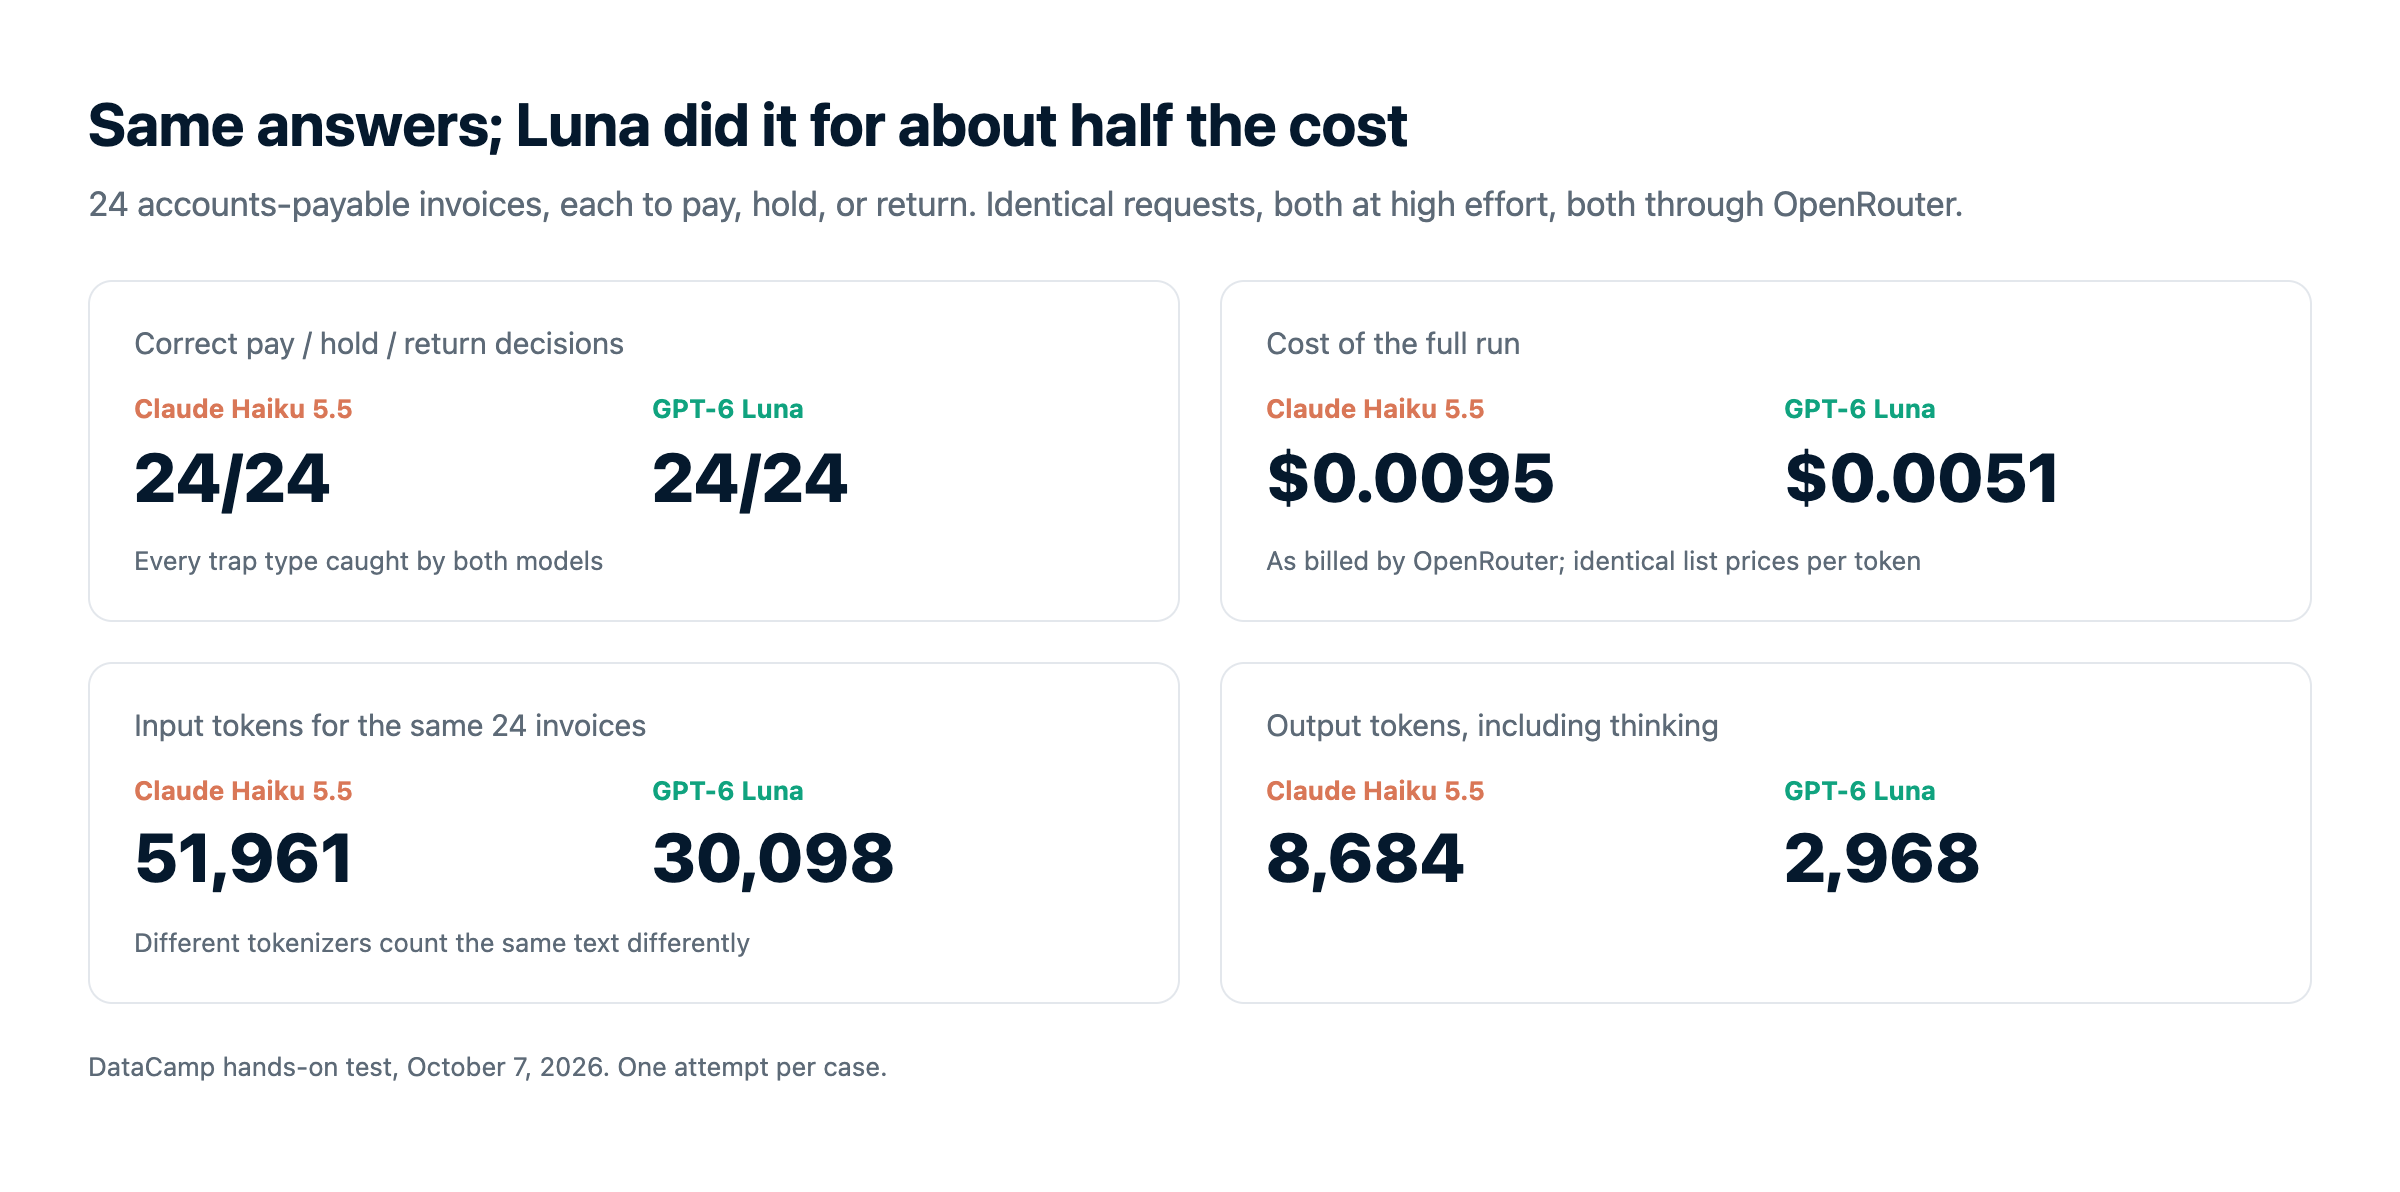
Então a tabela de preços se sustenta? Não exatamente. Ambos acertaram as 24 decisões, mas o Luna fez isso por US$ 0,0051 e o Haiku 5.5 por US$ 0,0095 — quase o dobro. Nada nas tarifas explica isso. É questão de tokens: o tokenizador do Haiku transformou as mesmas faturas em cerca de 73% mais tokens, e o Haiku gastou cerca de três vezes mais tokens pensando antes de responder.
Isso mudou minha opinião? Em parte. Continuo achando que o Haiku 5.5 é o modelo mais capaz e, para agentes que precisam operar software, eu ainda o escolheria. Mas "mesmo preço" acabou sendo enganoso.
Quando escolher Claude Haiku 5.5 vs GPT-6 Luna
Para agentes que operam software, a vantagem de 23 pontos do Haiku 5.5 em uso de computador pesa mais do que o custo. Para decisões bem especificadas em grande volume, o Luna deu as mesmas respostas por cerca de metade do preço no nosso teste.
Escolha o Claude Haiku 5.5 se...
- Você está construindo agentes que usam computador ou navegador. Ele lidera o Luna por ampla margem em uso de computador e tarefas de terminal nos benchmarks da Anthropic e já vem com uma ferramenta de uso de navegador.
- Você precisa de um subagente barato sob o Sonnet 5.5 ou Opus 5.5. Ele foi feito para compor stacks baseados em Claude e cuidar de leitura, compactação e subtarefas específicas.
- Seu trabalho envolve tarefas profissionais abertas. Ele lidera no GDPval-AA e AA-Briefcase, onde as respostas não são simples checagens de regra.
Escolha o GPT-6 Luna se...
- Você roda classificação, extração ou roteamento em volume. No nosso teste, ele igualou a acurácia do Haiku por cerca de metade do custo e visivelmente mais rápido.
- Seus prompts passam de 100K tokens com frequência. Sua precificação para prompts longos é bem mais suave que o salto de 5x do Haiku.
- Você quer o raciocínio totalmente desligado. O nível de esforço
noneé a opção mais barata e rápida entre as duas linhas. - Você já está no stack da OpenAI. Ele está no ChatGPT, Codex, GitHub Copilot e Azure.
Como começar com Claude Haiku 5.5 e GPT-6 Luna
| Superfície | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| App para consumidor | Claude.ai (web, iOS, Android) em todos os planos, incluindo o Free. | ChatGPT (Free e Go a partir de 8 de outubro), ChatGPT Work e Codex |
| API proprietária | Claude API | OpenAI API (ferramentas via Responses API) |
| Plataformas em nuvem | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Agentes de código | Claude Code, Cursor | Codex, GitHub Copilot |
| Roteadores de terceiros | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID do modelo na API | claude-haiku-5-5 |
gpt-6-luna |
O Haiku 5.5 tem alcance mais amplo em nuvem, enquanto o Luna tem presença maior no consumidor via ChatGPT. Os IDs de modelo na API são claude-haiku-5-5 e gpt-6-luna.
Fazendo sua primeira chamada de API
Os dois usam SDKs diferentes, então mudar envolve trocar o cliente além da string do modelo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Para um passo a passo completo de chaves e custos, veja nosso guia completo da Claude API.
Considerações finais
Eu comecei achando que a escolha era fácil: o Haiku 5.5 vence os benchmarks pelo mesmo preço, então escolha o Haiku. Depois do teste, eu diria diferente. Use o Haiku 5.5 quando o trabalho for difícil o bastante para sua capacidade extra fazer diferença, como agentes, automação de navegador ou tarefas abertas. Use o GPT-6 Luna quando o trabalho for simples e repetitivo, porque as mesmas respostas saem mais barato. Reconheço que foi uma amostra pequena e que os resultados reais podem variar.
A lição que levo é sobre tabelas de preço, não sobre estes dois modelos. Preços idênticos por token me disseram quase nada sobre quanto eu realmente pagaria. Se o custo importa para você, rode sua própria tarefa em ambos e confira a fatura.
Se você quer construir com qualquer um dos dois, recomendo nosso curso Introduction to Claude Models ou a trilha de habilidades OpenAI Fundamentals.