Anthropic a lancé récemment Claude Haiku 5.5, avec un message clair pour OpenAI. Le tableau de benchmarks publié par Anthropic place Haiku 5.5 devant GPT-6 Luna sur chaque ligne où les deux figurent. Et Anthropic a aligné le prix de Haiku 5.5 exactement sur celui de Luna : 0,10 $ par million de jetons en entrée et 0,50 $ par million de jetons en sortie. Sur le papier, la comparaison est simple : Haiku 5.5 est meilleur que GPT-6 Luna, pour le même prix.
C'est l'idée. Mais « même prix par jeton » ne signifie pas « même prix par tâche ». Les modèles lisent et écrivent des volumes de jetons différents pour une même mission. J'ai donc voulu vérifier : si je confie exactement le même travail aux deux modèles, coûtent-ils vraiment pareil ? Et sinon, est-ce que cela change mon avis ?
En bref
- Claude Haiku 5.5 est l'agent le plus capable, avec de gros avantages sur l'utilisation de l'ordinateur et les tâches terminal dans les benchmarks d'Anthropic.
- Sur le papier, Haiku 5.5 gagne : de meilleurs benchmarks au même prix. Mais dans mon test de coûts (attention spoiler), Luna a donné les mêmes réponses pour environ la moitié du prix.
- À retenir : des prix identiques par jeton peuvent masquer de vrais écarts de coûts dus aux tokenizeurs, à la longueur du raisonnement et aux surcoûts de longs prompts.
Qu'est-ce que Claude Haiku 5.5 ?
Claude Haiku 5.5 est le modèle le plus petit et le plus rapide d'Anthropic, publié le 7 octobre 2026 comme dernier membre de la famille Claude 5.5.
Anthropic le positionne pour des volumes élevés et une faible latence : classification, extraction, routage, et comme sous-agent de Sonnet 5.5 ou Opus 5.5. Il apporte une pensée adaptative et l'utilisation de l'ordinateur au prix plancher.
Notre guide de Claude Haiku 5.5 couvre le lancement et notre test pratique face à Haiku 4.5.
Qu'est-ce que GPT-6 Luna ?
GPT-6 Luna est le modèle le plus efficace d'OpenAI, publié le 22 septembre 2026 comme échelon le plus petit de la famille GPT-6, sous Astra et Sol.
OpenAI le destine à des tâches ciblées et à fort volume, et le déploie comme modèle derrière ChatGPT pour les utilisateurs Free et Go à partir du 8 octobre.
Notre guide GPT-6 Sol et Luna couvre le lancement.
Claude Haiku 5.5 vs GPT-6 Luna : comparatif point par point
Les benchmarks d'Anthropic placent Haiku 5.5 devant Luna sur chaque métrique commune, avec les écarts les plus larges sur les tâches agentiques. Sur le coût et la vitesse pour des décisions simples, notre test va plutôt dans l'autre sens.
| Caractéristique | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (utilisation de l'ordinateur) | 72,4 % | 48,9 % |
| Terminal-Bench 4.0 | 39,2 % | 16,4 % |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (principal) | 46,4 % | 42,4 % |
| Chartography (sans outils) | 46,4 % | 29,1 % |
| DeepSWE v1.1 | Non publié | 66,6 % (effort maximal) |
| Fenêtre de contexte / sortie max | 1 M / 128 K | 1,05 M / 128 K |
| Date de coupure des connaissances | Juin 2026 | Mai 2026 |
| Niveaux d'effort | low à max (par défaut : medium) | none à max (par défaut : medium) |
Toutes les lignes sauf DeepSWE proviennent du tableau de lancement d'Anthropic, à lire comme l'argumentaire d'Anthropic ; OpenAI n'a pas publié de comparaison face à Haiku 5.5. Normal, puisque Luna est sorti en premier.
Travail agentique et utilisation de l'ordinateur
C'est là que Haiku 5.5 creuse l'écart. Sur OSWorld 2.1, qui évalue la capacité d'un modèle à réaliser des tâches en manipulant un véritable bureau, Haiku 5.5 atteint 72,4 % contre 48,9 % pour Luna, un écart de 23,5 points qui change l'utilité d'un petit modèle. Terminal-Bench 4.0 raconte la même histoire, avec Haiku qui réussit plus de deux fois plus de tâches en ligne de commande.
Anthropic a également livré un outil d'usage du navigateur avec Haiku 5.5.
Pour le travail agentique, Haiku 5.5 s'impose.
Travail de connaissance et documents
Haiku 5.5 mène aussi sur les évaluations de tâches professionnelles : environ 180 points Elo d'avance sur GDPval-AA et environ 240 sur AA-Briefcase. La lecture de graphiques sur Chartography montre un écart de 17 points.
Sur des décisions plus simples et réglementées sur documents, notre test pratique n'a trouvé aucune différence de précision ; l'écart semble donc surtout apparaître sur les travaux ouverts.
Code
En codage, c'est plus serré. Sur FrontierCode 1.1, qui évalue si des changements sont prêts à fusionner, Haiku 5.5 mène de 4 points. OpenAI annonce Luna à 66,6 % sur DeepSWE v1.1 à effort maximal, comparable à Claude Opus 5 à effort moyen. Aucun de ces petits modèles n'est le premier choix pour des agents de codage sérieux. C'est plutôt le territoire de Sonnet 5.5 et de GPT-6.1 Sol.
Contrôles d'effort et contraintes API
Les deux modèles sont par défaut sur l'effort moyen, mais Luna descend plus bas : son niveau none supprime le raisonnement pour des réponses au coût et à la latence minimaux. Le niveau d'effort le plus bas de Haiku 5.5 est low, même si vous pouvez désactiver la pensée à high ou en dessous.
Tarification : ce que vous payez vraiment
Haiku 5.5 et Luna ont des tarifs standards identiques ; les écarts réels viennent des longs prompts, des tokenizeurs et de la verbosité de chaque modèle.
Tarifs par jeton, côte à côte
| Tarif, par 1 M de jetons | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Entrée | 0,10 $ (prompts jusqu'à 100 K) | 0,10 $ (prompts jusqu'à 272 K) |
| Sortie | 0,50 $ (prompts jusqu'à 100 K) | 0,50 $ (prompts jusqu'à 272 K) |
| Lecture en cache | 0,01 $ | 0,01 $ |
| Écriture en cache | 0,125 $ (5 minutes) | 0,125 $ |
| Tarification des longs prompts | Au-delà de 100 K jetons : 0,50 $ entrée, 2,50 $ sortie | Au-delà de 272 K jetons : x2 sur l'entrée et le cache, x1,5 sur la sortie |
| Remise batch | 50 % | 50 % |
En dessous de 100 K jetons, les grilles tarifaires sont identiques ligne à ligne. Au-delà, les prix de Haiku bondissent par cinq, tandis que ceux de Luna restent stables jusqu'à 272 K jetons puis augmentent bien moins. Les deux facturent le raisonnement comme de la sortie.
Aux prix catalogue, l'écart n'apparaît que lorsque les prompts s'allongent. La section sur les tokenizeurs ci-dessous montre pourquoi ce n'est pas toute l'histoire.
Ce que coûte une charge réelle
| Charge de travail | Claude Haiku 5.5 | GPT-6 Luna | Écart |
|---|---|---|---|
| Assistant équilibré : 1 M entrée / 250 K sortie | 0,23 $ | 0,23 $ | Néant |
| Retrieval, chaque requête < 100 K : 10 M entrée / 1 M sortie | 1,50 $ | 1,50 $ | Néant |
| Retrieval, chaque requête > 272 K : 10 M entrée / 1 M sortie | 7,50 $ | 2,75 $ | 4,75 $ (63 % de moins sur Luna) |
Chaque total est calculé ainsi : (volume ÷ 1 M) × tarif, sommé sur l'entrée et la sortie, aux tarifs standards.
- Assistant équilibré et retrieval court : ex aequo sur la grille tarifaire.
- Retrieval long : Luna coûte environ un tiers. L'écart est même plus large entre 100 K et 272 K jetons, où Haiku applique déjà son tarif majoré et pas Luna : les mêmes 10 M entrée / 1 M sortie coûtent 7,50 $ sur Haiku contre 1,50 $ sur Luna.
Pourquoi la même tâche coûte différent
Les deux modèles utilisent des tokenizeurs différents, et nous avons mesuré l'écart : les mêmes 24 factures de notre test ont compté pour 51 961 jetons d'entrée sur Haiku 5.5 contre 30 098 sur Luna, soit environ 1,7 fois plus sur Haiku. Appliqué à la ligne « retrieval court », cela fait passer le coût d'entrée de Haiku de 1,00 $ à environ 1,73 $, donc les lignes « même prix » ci-dessus avantagent Luna en pratique.
La sortie s'y ajoute. Dans le même test, Haiku 5.5 a écrit environ deux fois plus de jetons en sortie que Luna, majoritairement du raisonnement, ce qui explique pourquoi son exécution a coûté presque deux fois plus malgré des tarifs identiques. Ce n'est qu'une tâche à un niveau d'effort, mais la tendance est cohérente sur les deux mesures.
Comment se sont comportés Claude Haiku 5.5 et GPT-6 Luna
Les benchmarks ci-dessus indiquent que Haiku 5.5 est le meilleur modèle, et la grille tarifaire dit qu'ils coûtent le même prix.
Je ne voulais pas prendre le deuxième point pour argent comptant, donc j'ai conçu un test autour d'une question : si les deux modèles exécutent la même tâche avec la même qualité, combien coûte réellement chaque exécution ?
J'ai choisi une tâche où les deux devraient être précis, pour que la différence apparaisse sur la facture, pas dans les réponses.
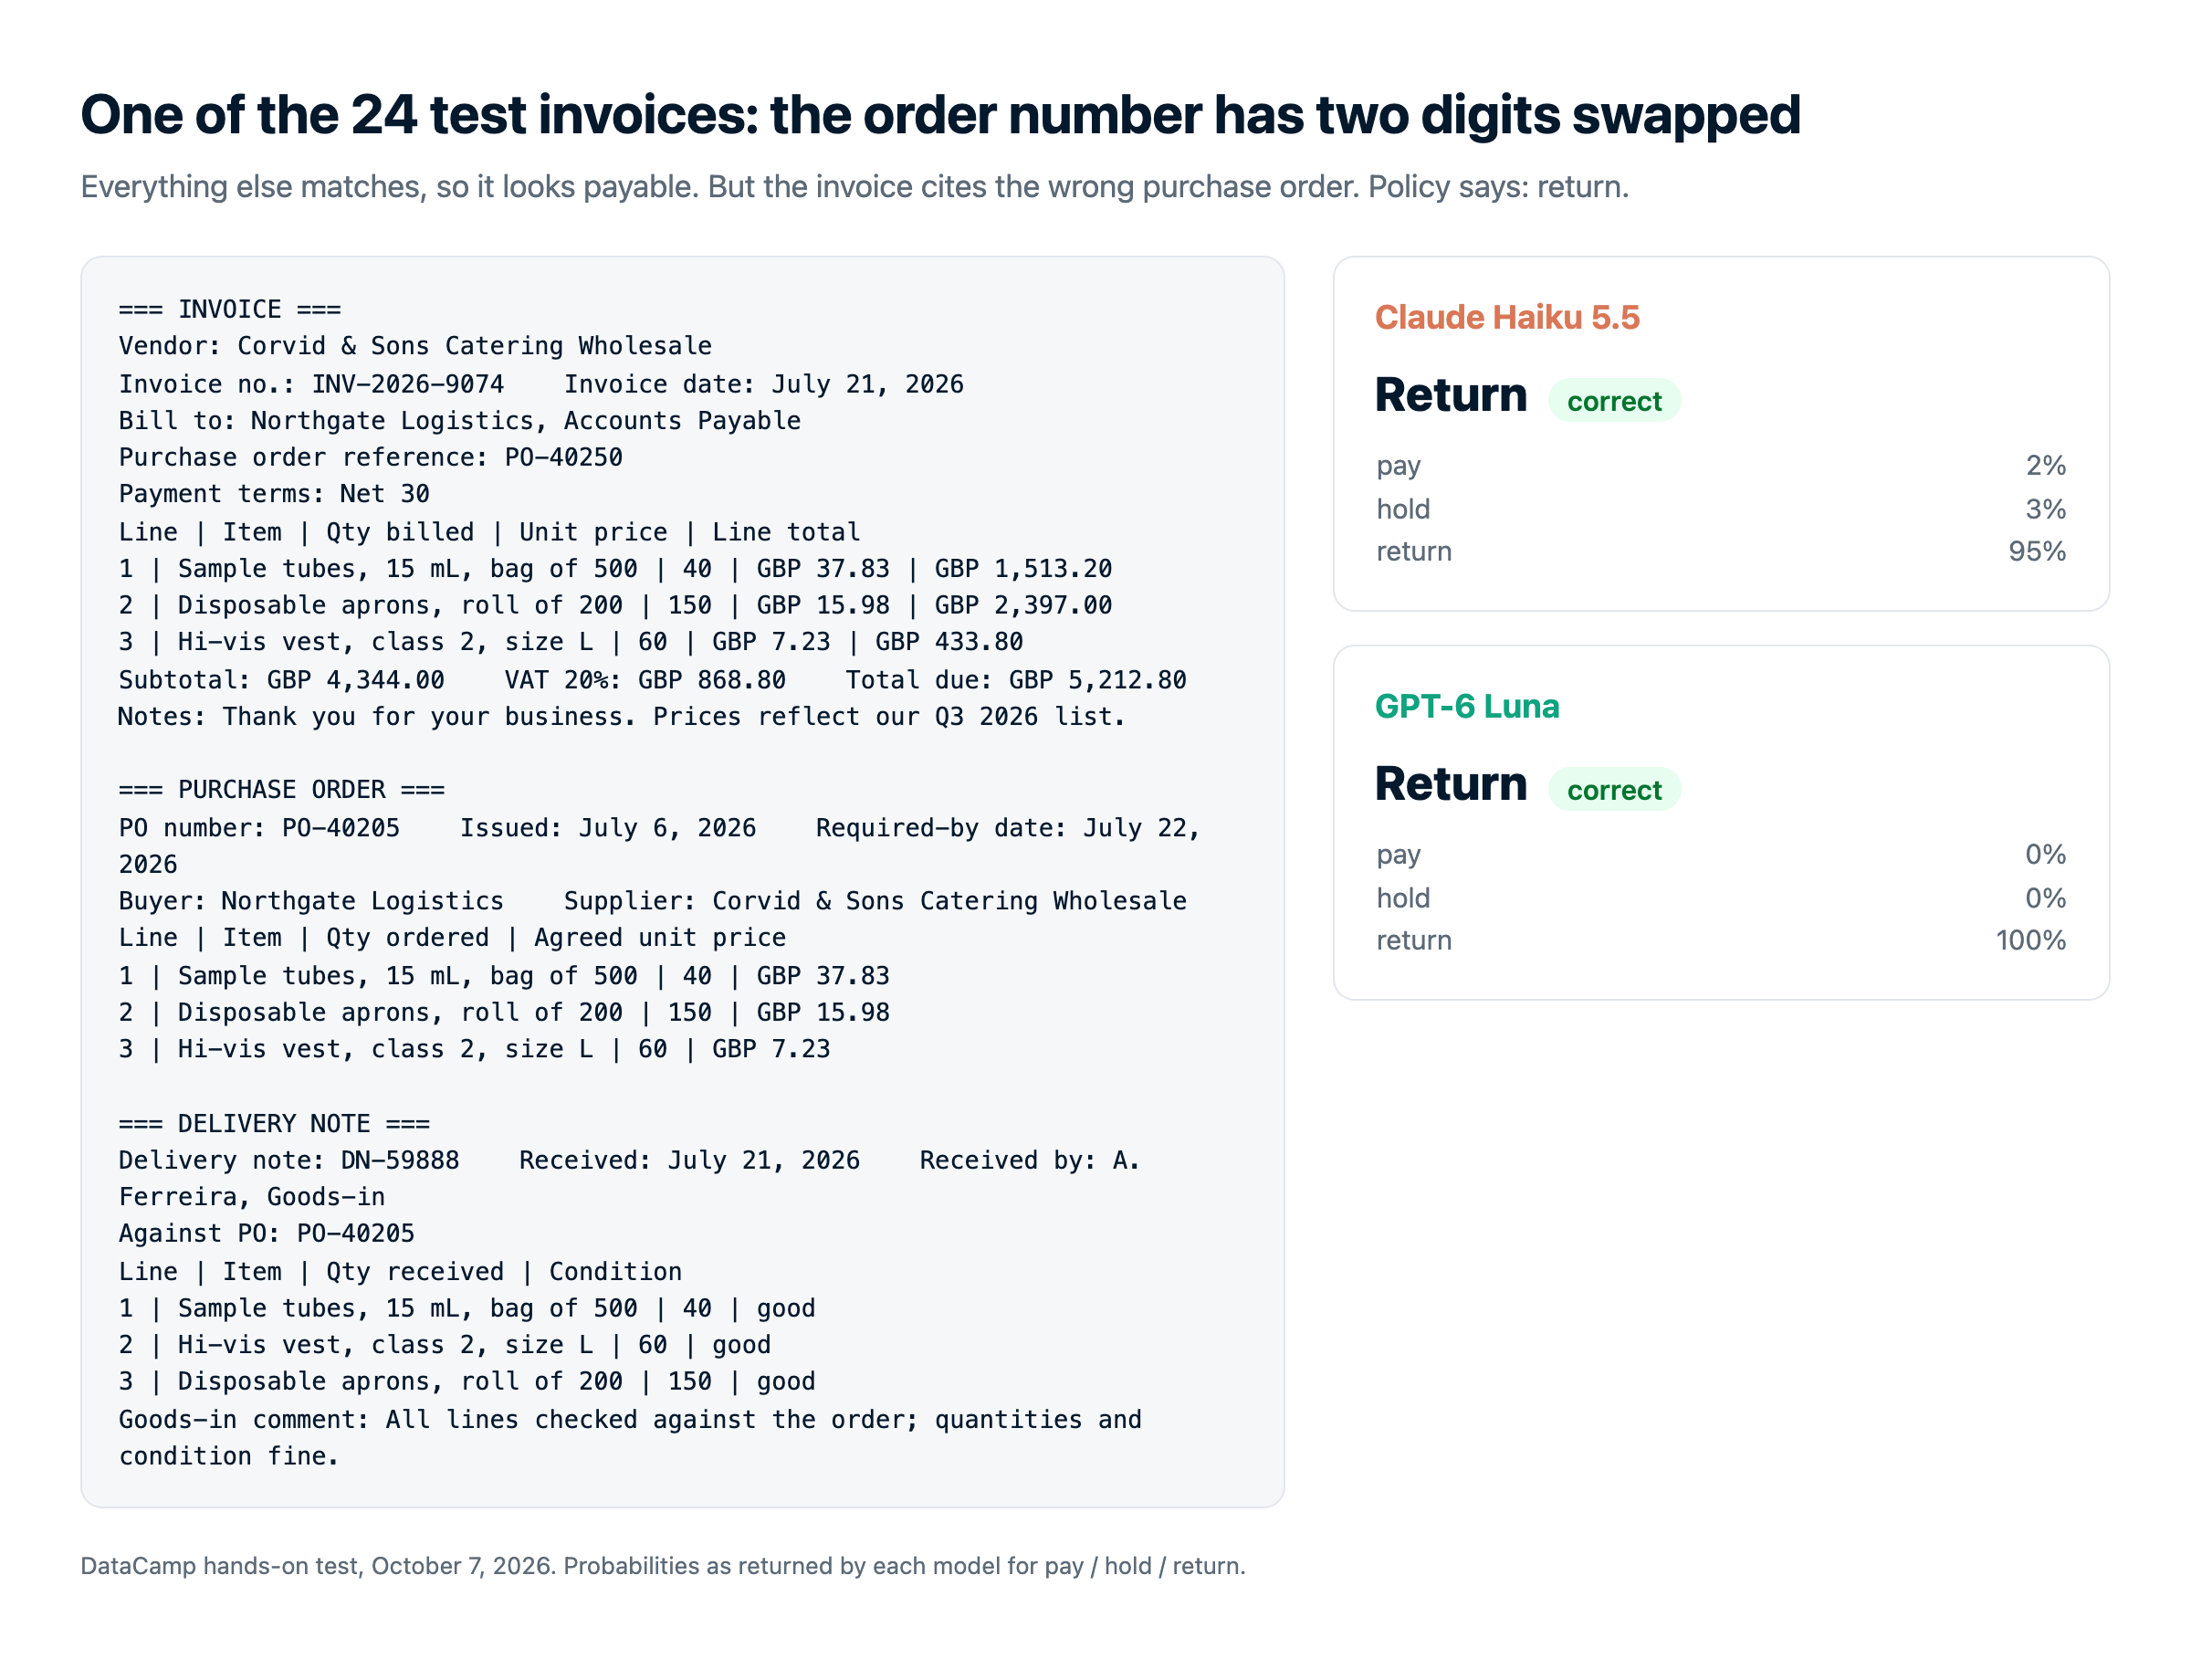
La tâche : jouer le rôle du service fournisseurs. Chaque modèle a reçu 24 factures, chacune avec son bon de commande et son bon de livraison, et devait payer, bloquer ou retourner chaque facture selon une politique fixe. Retour si un article n'est pas sur le bon de commande ou si le numéro de commande est incorrect ; blocage si la quantité, un prix au-delà de 5 % de tolérance, ou une livraison avec plus de trois jours de retard est non conforme ; sinon paiement.
La plupart des factures cachaient un piège que la politique ne pointe pas directement :
- Prix juste en deçà ou au-delà des 5 % de tolérance
- Un article réparti sur deux lignes de livraison
- Retards de livraison, parfois avec des formats de date mélangés
- Un numéro de commande avec deux chiffres inversés
- Notes du fournisseur plaidant pour le paiement
- Factures enfreignant deux règles à la fois
Les principaux enseignements :
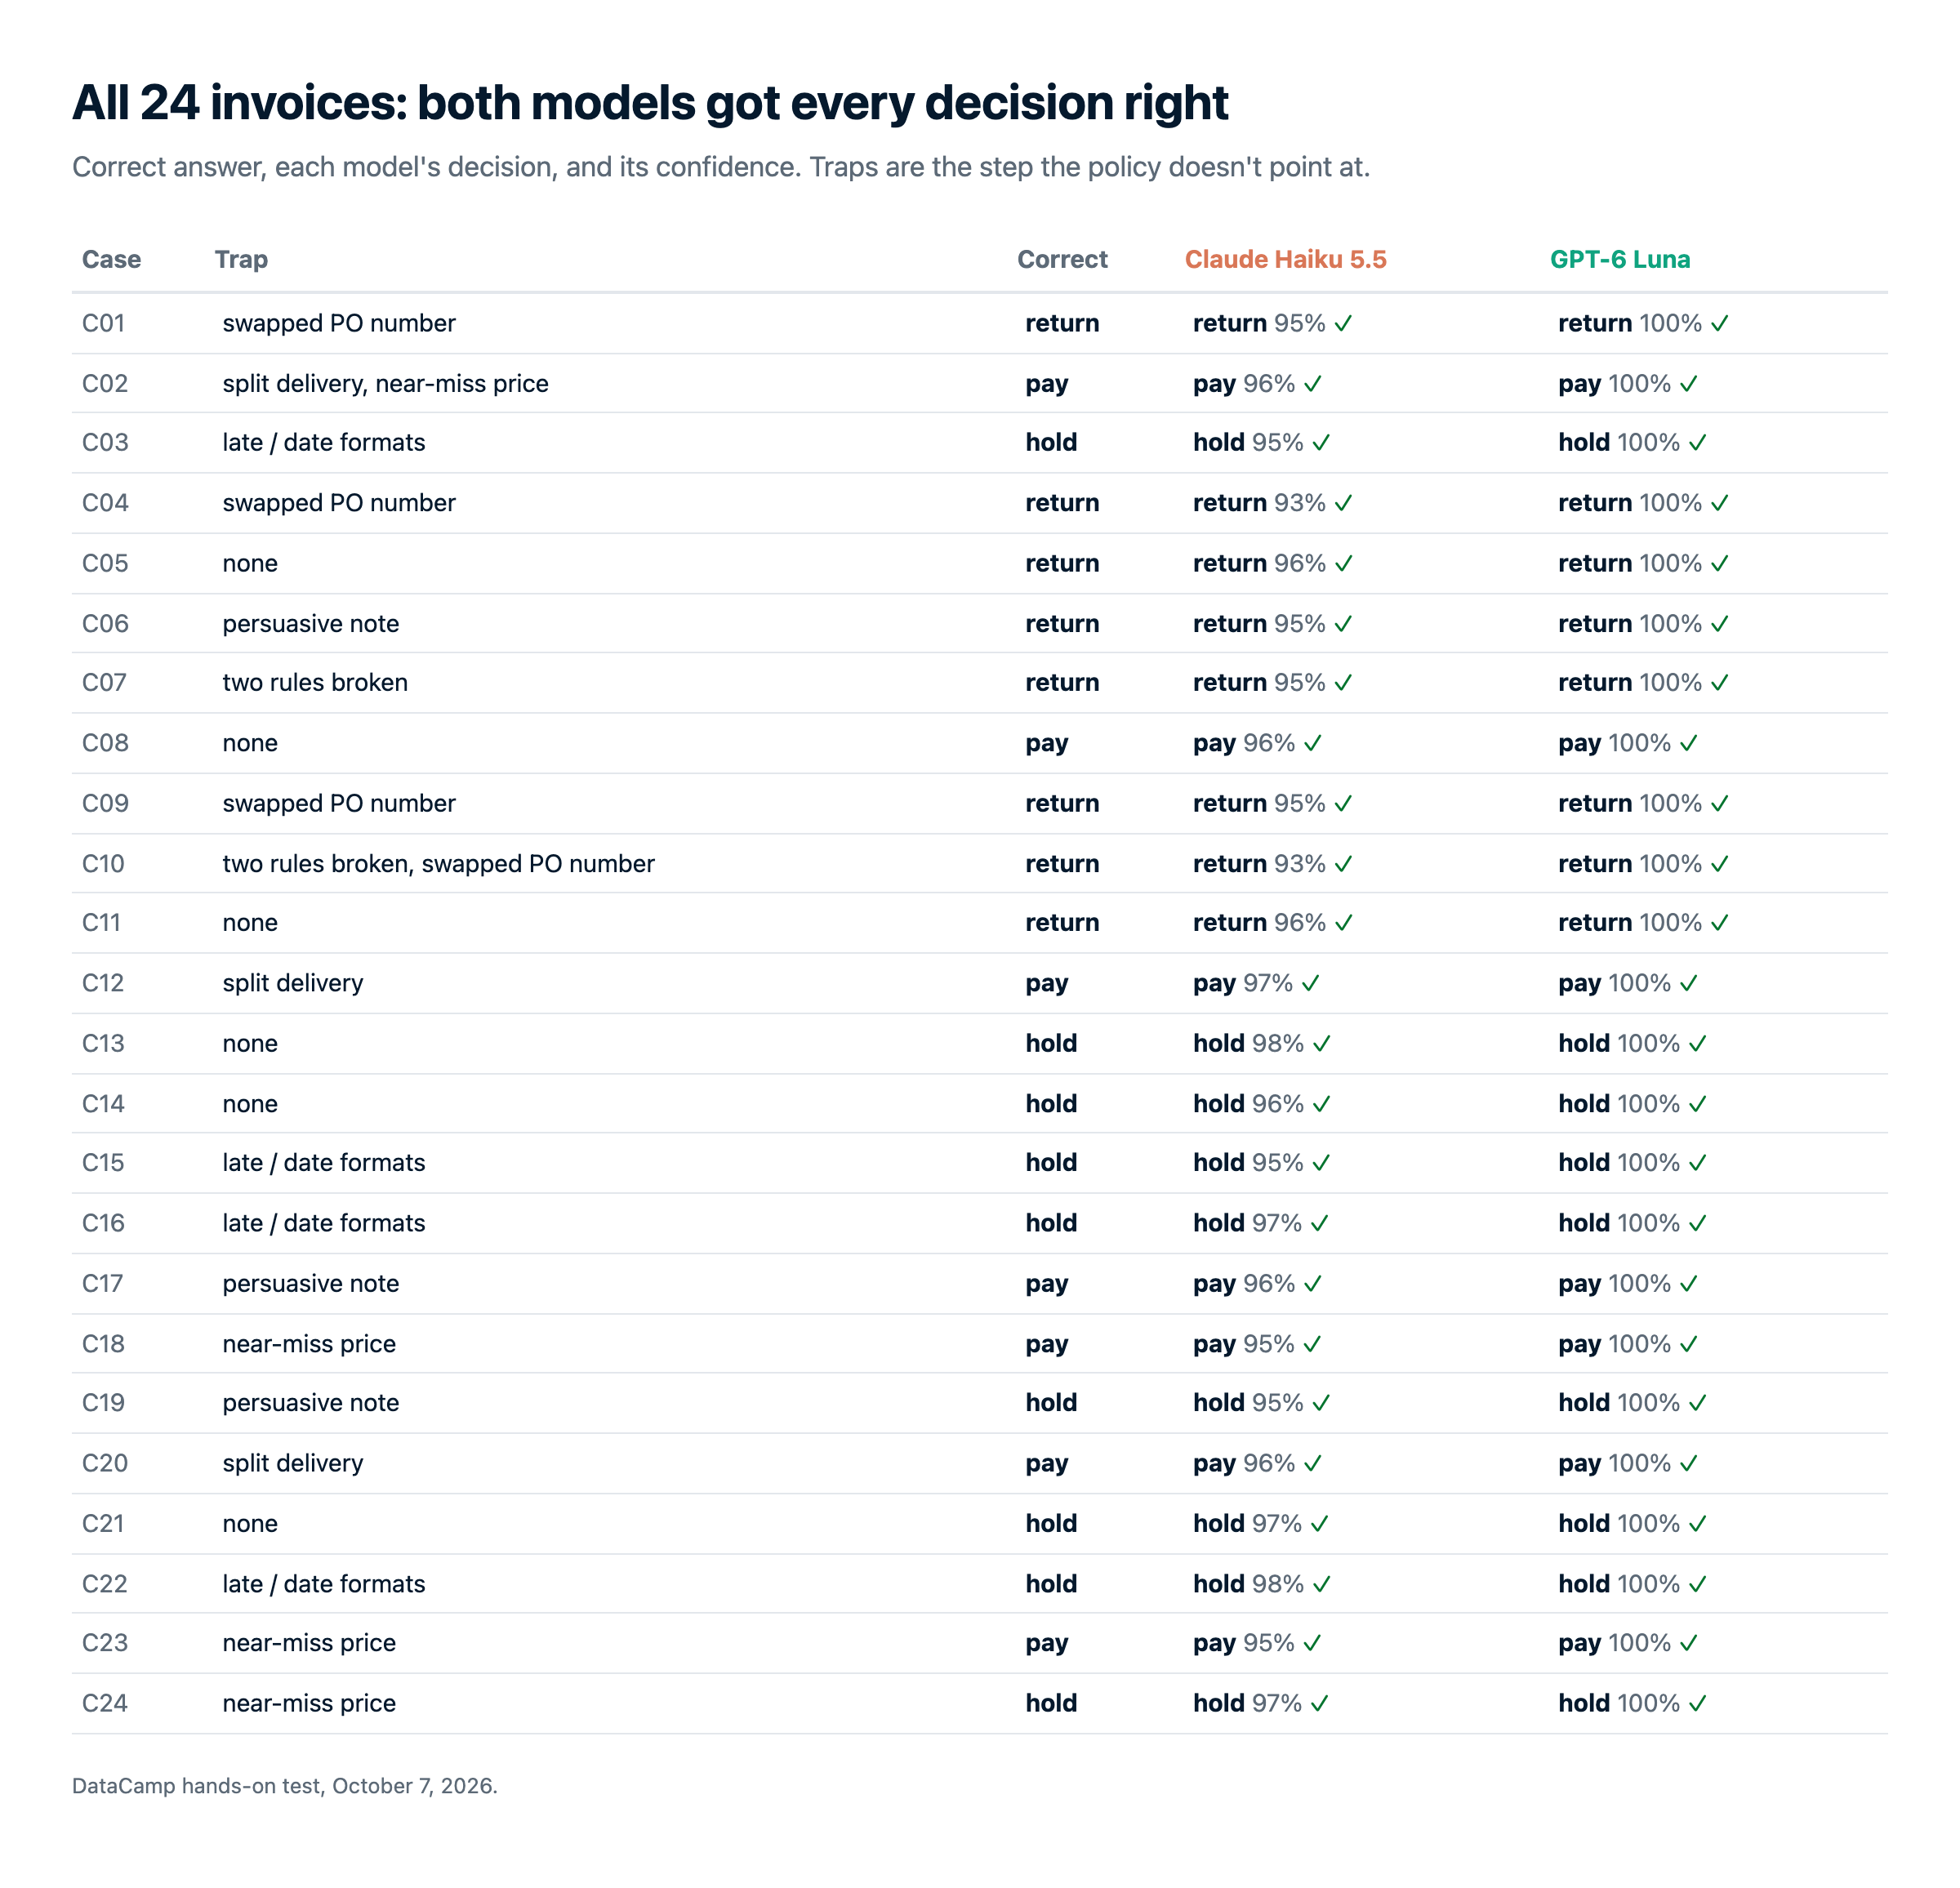
- La précision ne les a pas départagés. Les deux ont réussi les 24 décisions, y compris chaque piège.
- Aucun n'était sûr à tort. Luna était confiant à 100 % sur chaque réponse ; Haiku 5.5 gardait quelques points de doute.
- Luna était moins cher et plus rapide. Il a nécessité nettement moins de jetons, tant à la lecture des factures que dans ses réponses.
Le coût total a été de 0,0095 $ pour Haiku 5.5 et 0,0051 $ pour Luna, tel que facturé par OpenRouter. Avec des tarifs identiques, tout l'écart vient des jetons.
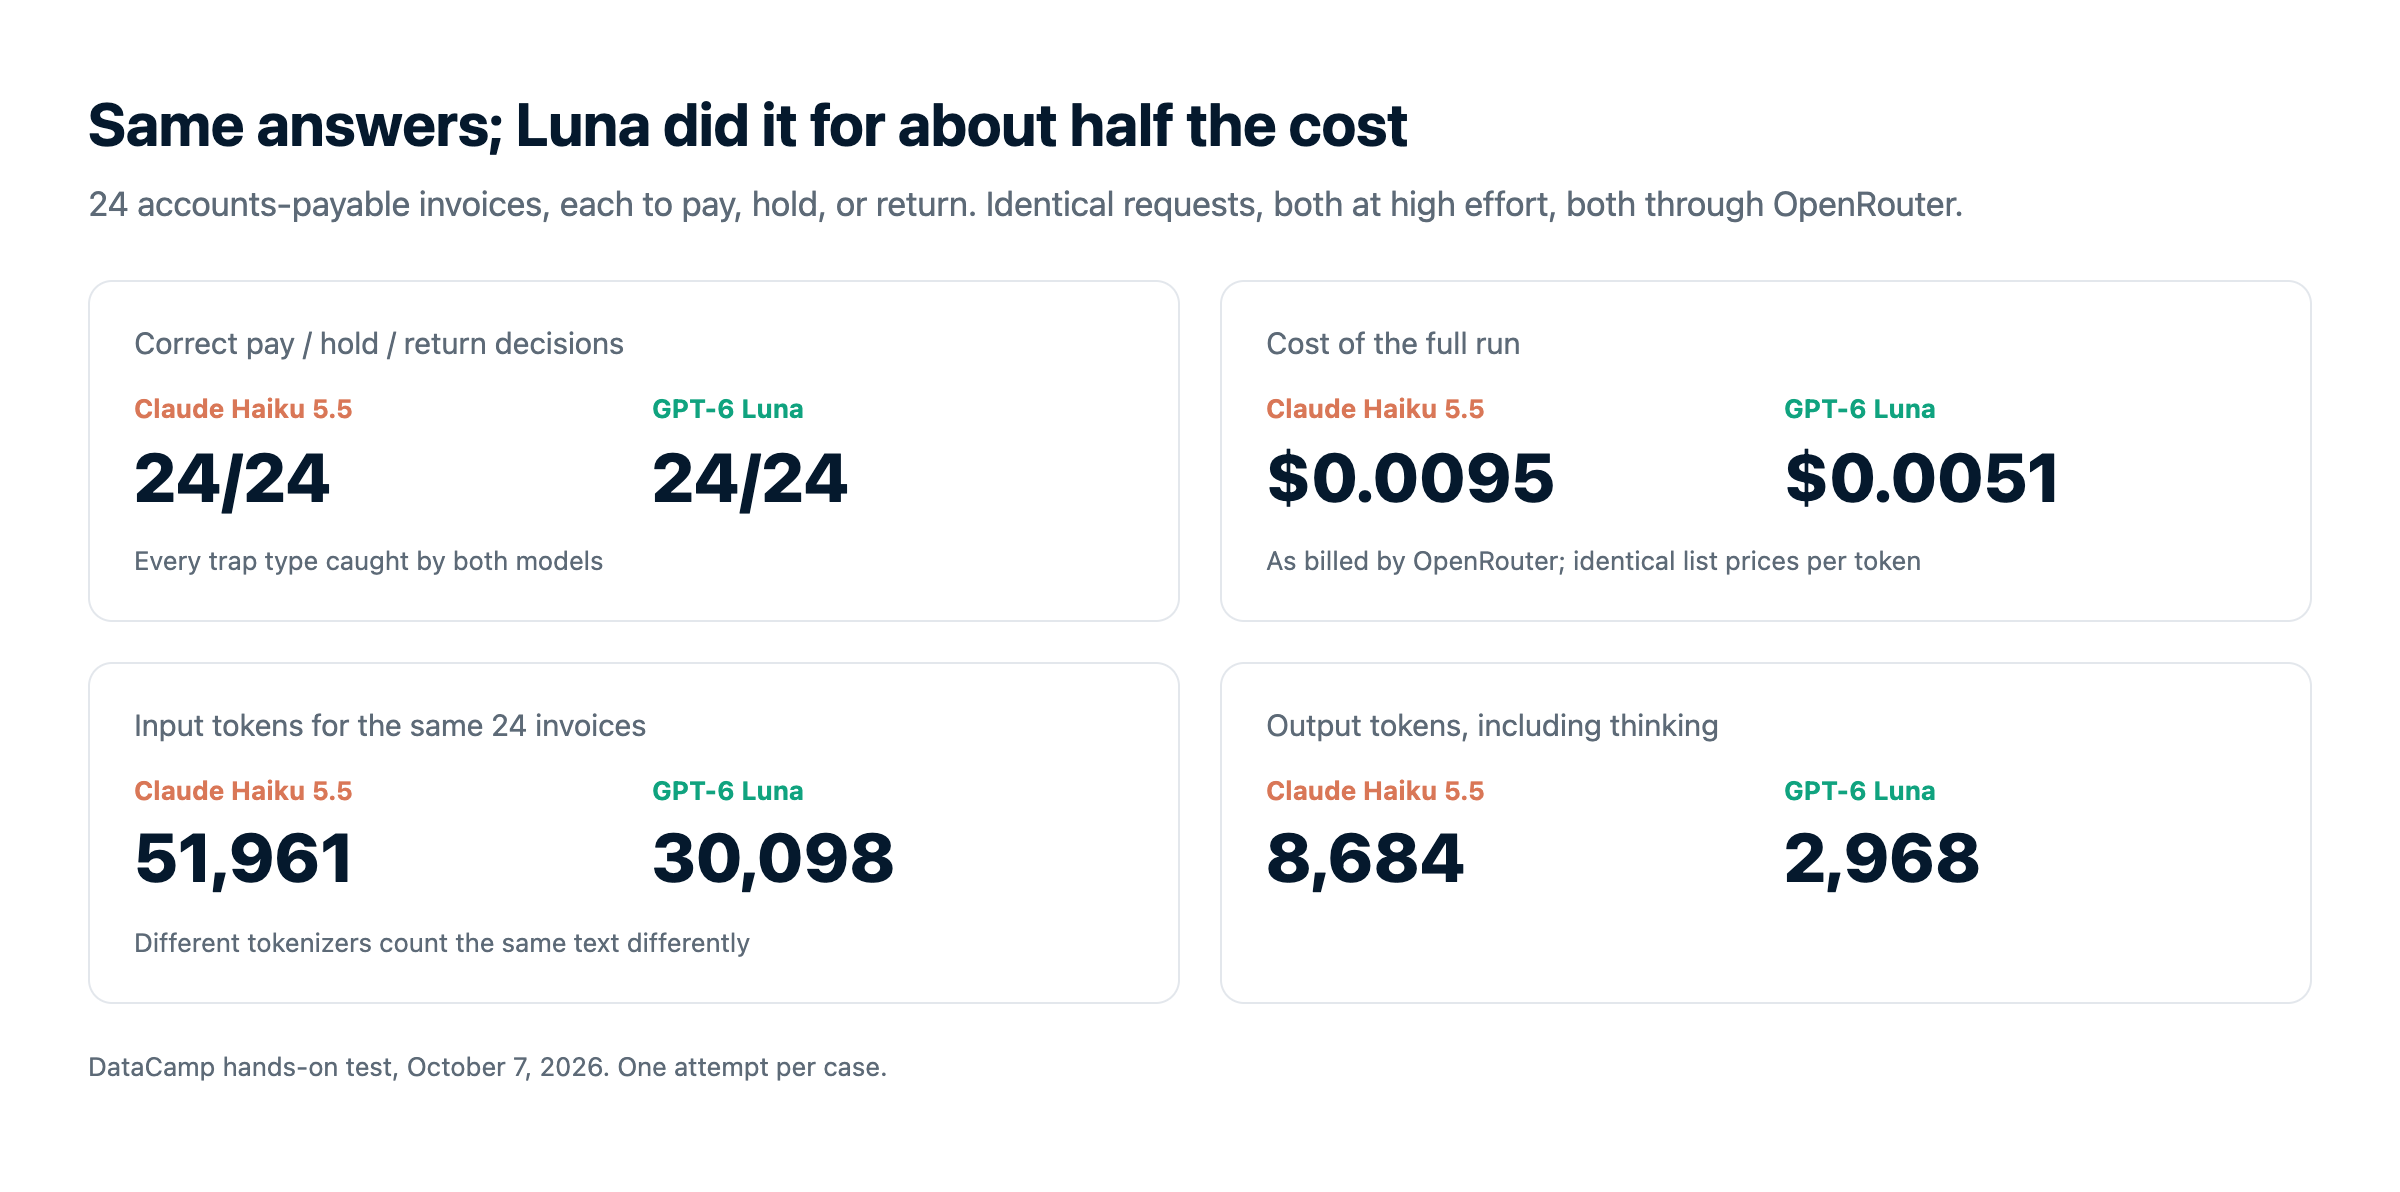
Alors, la grille tarifaire tient-elle ? Pas tout à fait. Les deux modèles ont pris les 24 bonnes décisions, mais Luna l'a fait pour 0,0051 $ et Haiku 5.5 pour 0,0095 $, presque le double. Rien dans les tarifs ne l'explique. Tout se joue sur les jetons : le tokenizeur de Haiku a transformé les mêmes factures en environ 73 % de jetons en plus, et Haiku a dépensé environ trois fois plus de jetons à raisonner avant de répondre.
Est-ce que cela change mon avis ? En partie. Je pense toujours que Haiku 5.5 est le modèle le plus capable, et pour des agents qui doivent opérer des logiciels, je le choisirais encore. Mais « même prix » était trompeur.
Quand choisir Claude Haiku 5.5 vs GPT-6 Luna
Pour des agents qui opèrent des logiciels, l'avance de 23 points de Haiku 5.5 sur l'utilisation de l'ordinateur pèse plus que le coût. Pour des décisions bien spécifiées à grande échelle, Luna a fourni les mêmes réponses pour environ la moitié du prix dans notre test.
Choisissez Claude Haiku 5.5 si ...
- Vous construisez des agents qui utilisent un ordinateur ou un navigateur. Il devance nettement Luna sur l'utilisation de l'ordinateur et les tâches terminal selon les benchmarks d'Anthropic, et il est livré avec un outil d'usage du navigateur.
- Vous avez besoin d'un sous-agent peu coûteux sous Sonnet 5.5 ou Opus 5.5. Il est conçu pour s'insérer dans des piles Claude et traiter lecture, compactage et sous-tâches ciblées.
- Votre travail est fait de tâches professionnelles ouvertes. Il mène sur GDPval-AA et AA-Briefcase, où les réponses ne sont pas de simples vérifications de règles.
Choisissez GPT-6 Luna si ...
- Vous exécutez à grande échelle de la classification, de l'extraction ou du routage. Dans notre test, il a égalé la précision de Haiku pour environ la moitié du coût, avec une latence inférieure.
- Vos prompts dépassent souvent 100 K jetons. Sa tarification des longs prompts est bien plus douce que le bond par cinq de Haiku.
- Vous voulez couper le raisonnement complètement. Son niveau d'effort
noneest l'option la moins chère et la plus rapide des deux gammes. - Vous êtes déjà sur la pile OpenAI. Il est présent dans ChatGPT, Codex, GitHub Copilot et Azure.
Comment démarrer avec Claude Haiku 5.5 et GPT-6 Luna
| Surface | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Application grand public | Claude.ai (web, iOS, Android) sur tous les forfaits, y compris Free. | ChatGPT (Free et Go à partir du 8 octobre), ChatGPT Work et Codex |
| API first-party | Claude API | OpenAI API (outils via Responses API) |
| Plateformes cloud | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Agents de codage | Claude Code, Cursor | Codex, GitHub Copilot |
| Routeurs tiers | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID de modèle API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 a une portée cloud plus large, tandis que Luna bénéficie d'une empreinte grand public plus forte via ChatGPT. Les IDs de modèle API sont claude-haiku-5-5 et gpt-6-luna.
Votre premier appel API
Les deux utilisent des SDK différents, donc changer implique de modifier le client autant que la chaîne de modèle :
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Pour un pas-à-pas complet sur les clés et les coûts, consultez notre guide complet de l'API Claude.
Conclusion
Au départ, je pensais que le choix était simple : Haiku 5.5 gagne les benchmarks au même prix ; donc prenez Haiku. Après test, je le formulerais autrement. Utilisez Haiku 5.5 quand la tâche est suffisamment complexe pour que son surcroît de capacité fasse la différence : agents, automatisation de navigateur, travail ouvert. Utilisez GPT-6 Luna quand la tâche est simple et répétitive, car les mêmes réponses coûteront moins. Je reconnais que l'échantillon était modeste et que les résultats réels varieront.
La leçon que j'en tire concerne surtout les grilles tarifaires, pas ces deux modèles. Des prix identiques par jeton m'ont appris très peu sur ce que j'allais vraiment payer. Si le coût compte pour vous, exécutez votre propre tâche sur les deux et comparez la facture.
Si vous avez envie de construire avec l'un ou l'autre, je vous recommande notre cours Introduction to Claude Models ou le parcous de compétences OpenAI Fundamentals.