Anthropic lanzó Claude Haiku 5.5 hace poco, y fue un golpe directo a OpenAI. En la tabla de benchmarks que compartió Anthropic, Haiku 5.5 supera a GPT-6 Luna en todas las filas en las que ambos aparecen. Y Anthropic fijó el mismo precio que OpenAI para Luna: 0,10 $ por millón de tokens de entrada y 0,50 $ por millón de tokens de salida. Sobre el papel, la comparación es sencilla. Haiku 5.5 es mejor que GPT-6 Luna y cuesta lo mismo.
Esa es la lectura rápida. Pero "mismo precio por token" no equivale a "mismo precio por trabajo". Los modelos leen y escriben cantidades distintas de tokens para la misma tarea. Así que pensé: si les doy el mismo trabajo a ambos, ¿de verdad cuestan lo mismo? Y si no, ¿cambiaría mi opinión?
Resumen
- Claude Haiku 5.5 es el agente más capaz, con ventajas claras en uso de ordenador y tareas de terminal según los benchmarks de Anthropic.
- Sobre el papel, gana Haiku 5.5: mejores benchmarks al mismo precio. Pero en mi prueba de costes (spoiler), Luna dio las mismas respuestas por aproximadamente la mitad.
- La lección: precios idénticos por token pueden ocultar diferencias reales de coste por tokenizadores, longitud de razonamiento y recargos por prompts largos.
¿Qué es Claude Haiku 5.5?
Claude Haiku 5.5 es el modelo más pequeño y rápido de Anthropic, lanzado el 7 de octubre de 2026 como el último miembro de la familia Claude 5.5.
Anthropic lo posiciona para trabajos de alto volumen y baja latencia como clasificación, extracción, enrutamiento y como subagente bajo Sonnet 5.5 u Opus 5.5, acercando el pensamiento adaptativo y el uso de ordenador al tramo más barato.
Nuestra guía de Claude Haiku 5.5 cubre el lanzamiento y nuestra prueba práctica frente a Haiku 4.5.
¿Qué es GPT-6 Luna?
GPT-6 Luna es el modelo más eficiente de OpenAI, lanzado el 22 de septiembre de 2026 como el nivel más pequeño de la familia GPT-6, por debajo de Astra y Sol.
OpenAI lo orienta a tareas enfocadas y de alto volumen, y lo está desplegando como el modelo detrás de ChatGPT para usuarios Free y Go desde el 8 de octubre.
Nuestra guía de GPT-6 Sol y Luna cubre el lanzamiento.
Claude Haiku 5.5 vs GPT-6 Luna: comparación directa
Los benchmarks de Anthropic sitúan a Haiku 5.5 por delante de Luna en todas las filas que comparten, con las mayores diferencias en tareas de agentes. En coste y velocidad para decisiones simples, nuestra prueba señaló en sentido contrario.
| Característica | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (uso de ordenador) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46,4% | 42,4% |
| Chartography (sin herramientas) | 46,4% | 29,1% |
| DeepSWE v1.1 | No reportado | 66,6% (máximo esfuerzo) |
| Ventana de contexto / salida máx. | 1M / 128K | 1,05M / 128K |
| Fecha de corte de conocimiento | junio de 2026 | mayo de 2026 |
| Niveles de esfuerzo | bajo a máximo (por defecto, medio) | none a máximo (por defecto, medio) |
Todo salvo DeepSWE procede de la tabla de lanzamiento de Anthropic, así que léelo como el argumento de Anthropic; OpenAI no ha publicado una comparación contra Haiku 5.5. Es normal: Luna salió antes.
Trabajo con agentes y uso de ordenador
Aquí es donde Haiku 5.5 se escapa más. En OSWorld 2.1, que evalúa si un modelo puede completar tareas manejando un escritorio real, Haiku 5.5 logra un 72,4% frente al 48,9% de Luna, una brecha de 23,5 puntos que cambia para qué sirve un modelo pequeño. Terminal-Bench 4.0 cuenta lo mismo: Haiku completa más del doble de tareas en línea de comandos.
Anthropic también lanzó junto a Haiku 5.5 una herramienta para uso de navegador.
Para trabajo agentivo, Haiku 5.5 es la elección clara.
Trabajo de conocimiento y documentos
Haiku 5.5 también lidera en evaluaciones de tareas profesionales: unos 180 puntos Elo por delante en GDPval-AA y unos 240 en AA-Briefcase. En lectura de gráficos (Chartography) hay una diferencia de 17 puntos.
Sin embargo, en decisiones documentales más simples y regladas, nuestra prueba práctica no encontró diferencias de precisión, así que probablemente la brecha aparece sobre todo en trabajo abierto.
Programación
En código, están más parejos. En FrontierCode 1.1, que valora si los cambios están listos para integrar, Haiku 5.5 lleva 4 puntos de ventaja. OpenAI reporta Luna al 66,6% en DeepSWE v1.1 con esfuerzo máximo, comparable a Claude Opus 5 con esfuerzo medio. Ninguno de los modelos pequeños sería mi primera opción para agentes de programación serios. Para eso mejor Sonnet 5.5 y GPT-6.1 Sol.
Controles de esfuerzo y límites de API
Ambos modelos parten de esfuerzo medio, pero Luna llega más abajo: su ajuste none omite el razonamiento por completo para dar respuestas más baratas y rápidas. El nivel más bajo de Haiku 5.5 es low, aunque también puedes desactivar el pensamiento en high o por debajo.
Precios: lo que realmente pagas
Haiku 5.5 y Luna tienen tarifas estándar idénticas, así que las diferencias reales vienen de prompts largos, tokenizadores y cuánto escribe cada modelo.
Tarifas por token, lado a lado
| Tarifa, por 1M de tokens | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Entrada | 0,10 $ (prompts hasta 100K) | 0,10 $ (prompts hasta 272K) |
| Salida | 0,50 $ (prompts hasta 100K) | 0,50 $ (prompts hasta 272K) |
| Lectura en caché | 0,01 $ | 0,01 $ |
| Escritura en caché | 0,125 $ (5 minutos) | 0,125 $ |
| Precio para prompts largos | Más de 100K tokens: 0,50 $ entrada, 2,50 $ salida | Más de 272K tokens: 2x entrada y caché, 1,5x salida |
| Descuento por lotes | 50% | 50% |
Por debajo de 100K tokens, las tarifas son calcadas línea por línea. Por encima, los precios de Haiku se multiplican por cinco, mientras que los de Luna se mantienen hasta 272K y luego suben bastante menos. Ambos facturan el razonamiento como salida.
A precios de lista, solo divergen cuando los prompts se alargan. La sección de tokenizadores explica por qué no es toda la historia.
Lo que cuesta una carga de trabajo real
| Carga de trabajo | Claude Haiku 5.5 | GPT-6 Luna | Diferencia |
|---|---|---|---|
| Asistente equilibrado: 1M in / 250K out | 0,23 $ | 0,23 $ | Ninguna |
| Recuperación, cada petición < 100K: 10M in / 1M out | 1,50 $ | 1,50 $ | Ninguna |
| Recuperación, cada petición > 272K: 10M in / 1M out | 7,50 $ | 2,75 $ | 4,75 $ (63% menos en Luna) |
Cada total es (volumen ÷ 1M) × tarifa, sumando entrada y salida, a tarifas estándar.
- Asistente equilibrado y recuperación corta: empate técnico en la tabla de tarifas.
- Recuperación larga: Luna cuesta aproximadamente un tercio. La brecha es aún mayor entre 100K y 272K tokens, donde Haiku ya paga la tarifa alta y Luna no: los mismos 10M in / 1M out cuestan 7,50 $ en Haiku frente a 1,50 $ en Luna.
Por qué la misma tarea cuesta distinto
Los dos modelos usan tokenizadores diferentes, y medimos la diferencia directamente: las mismas 24 facturas en nuestra prueba contaron como 51.961 tokens de entrada en Haiku 5.5 y 30.098 en Luna, alrededor de 1,7 veces más en Haiku. Aplicado a la fila de recuperación corta, eso sube el coste de entrada de Haiku de 1,00 $ a unos 1,73 $, así que las filas de "mismo precio" favorecen en la práctica a Luna.
La salida también suma. En la misma prueba, Haiku 5.5 escribió aproximadamente el doble de tokens de salida que Luna, la mayoría de razonamiento, por lo que su ejecución costó casi el doble pese a tener tarifas idénticas. Es una tarea a un nivel de esfuerzo, pero la tendencia es coherente en ambas medidas.
Así rindieron Claude Haiku 5.5 y GPT-6 Luna
Los benchmarks dicen que Haiku 5.5 es el mejor modelo, y la hoja de precios dice que ambos cuestan lo mismo.
No quise dar lo segundo por hecho, así que diseñé una prueba con una sola pregunta: si ambos modelos hacen igual de bien el mismo trabajo, ¿cuánto cuesta realmente ejecutar cada uno?
Elegí un trabajo donde ambos deberían ser precisos, para que cualquier diferencia apareciera en la factura y no en las respuestas.
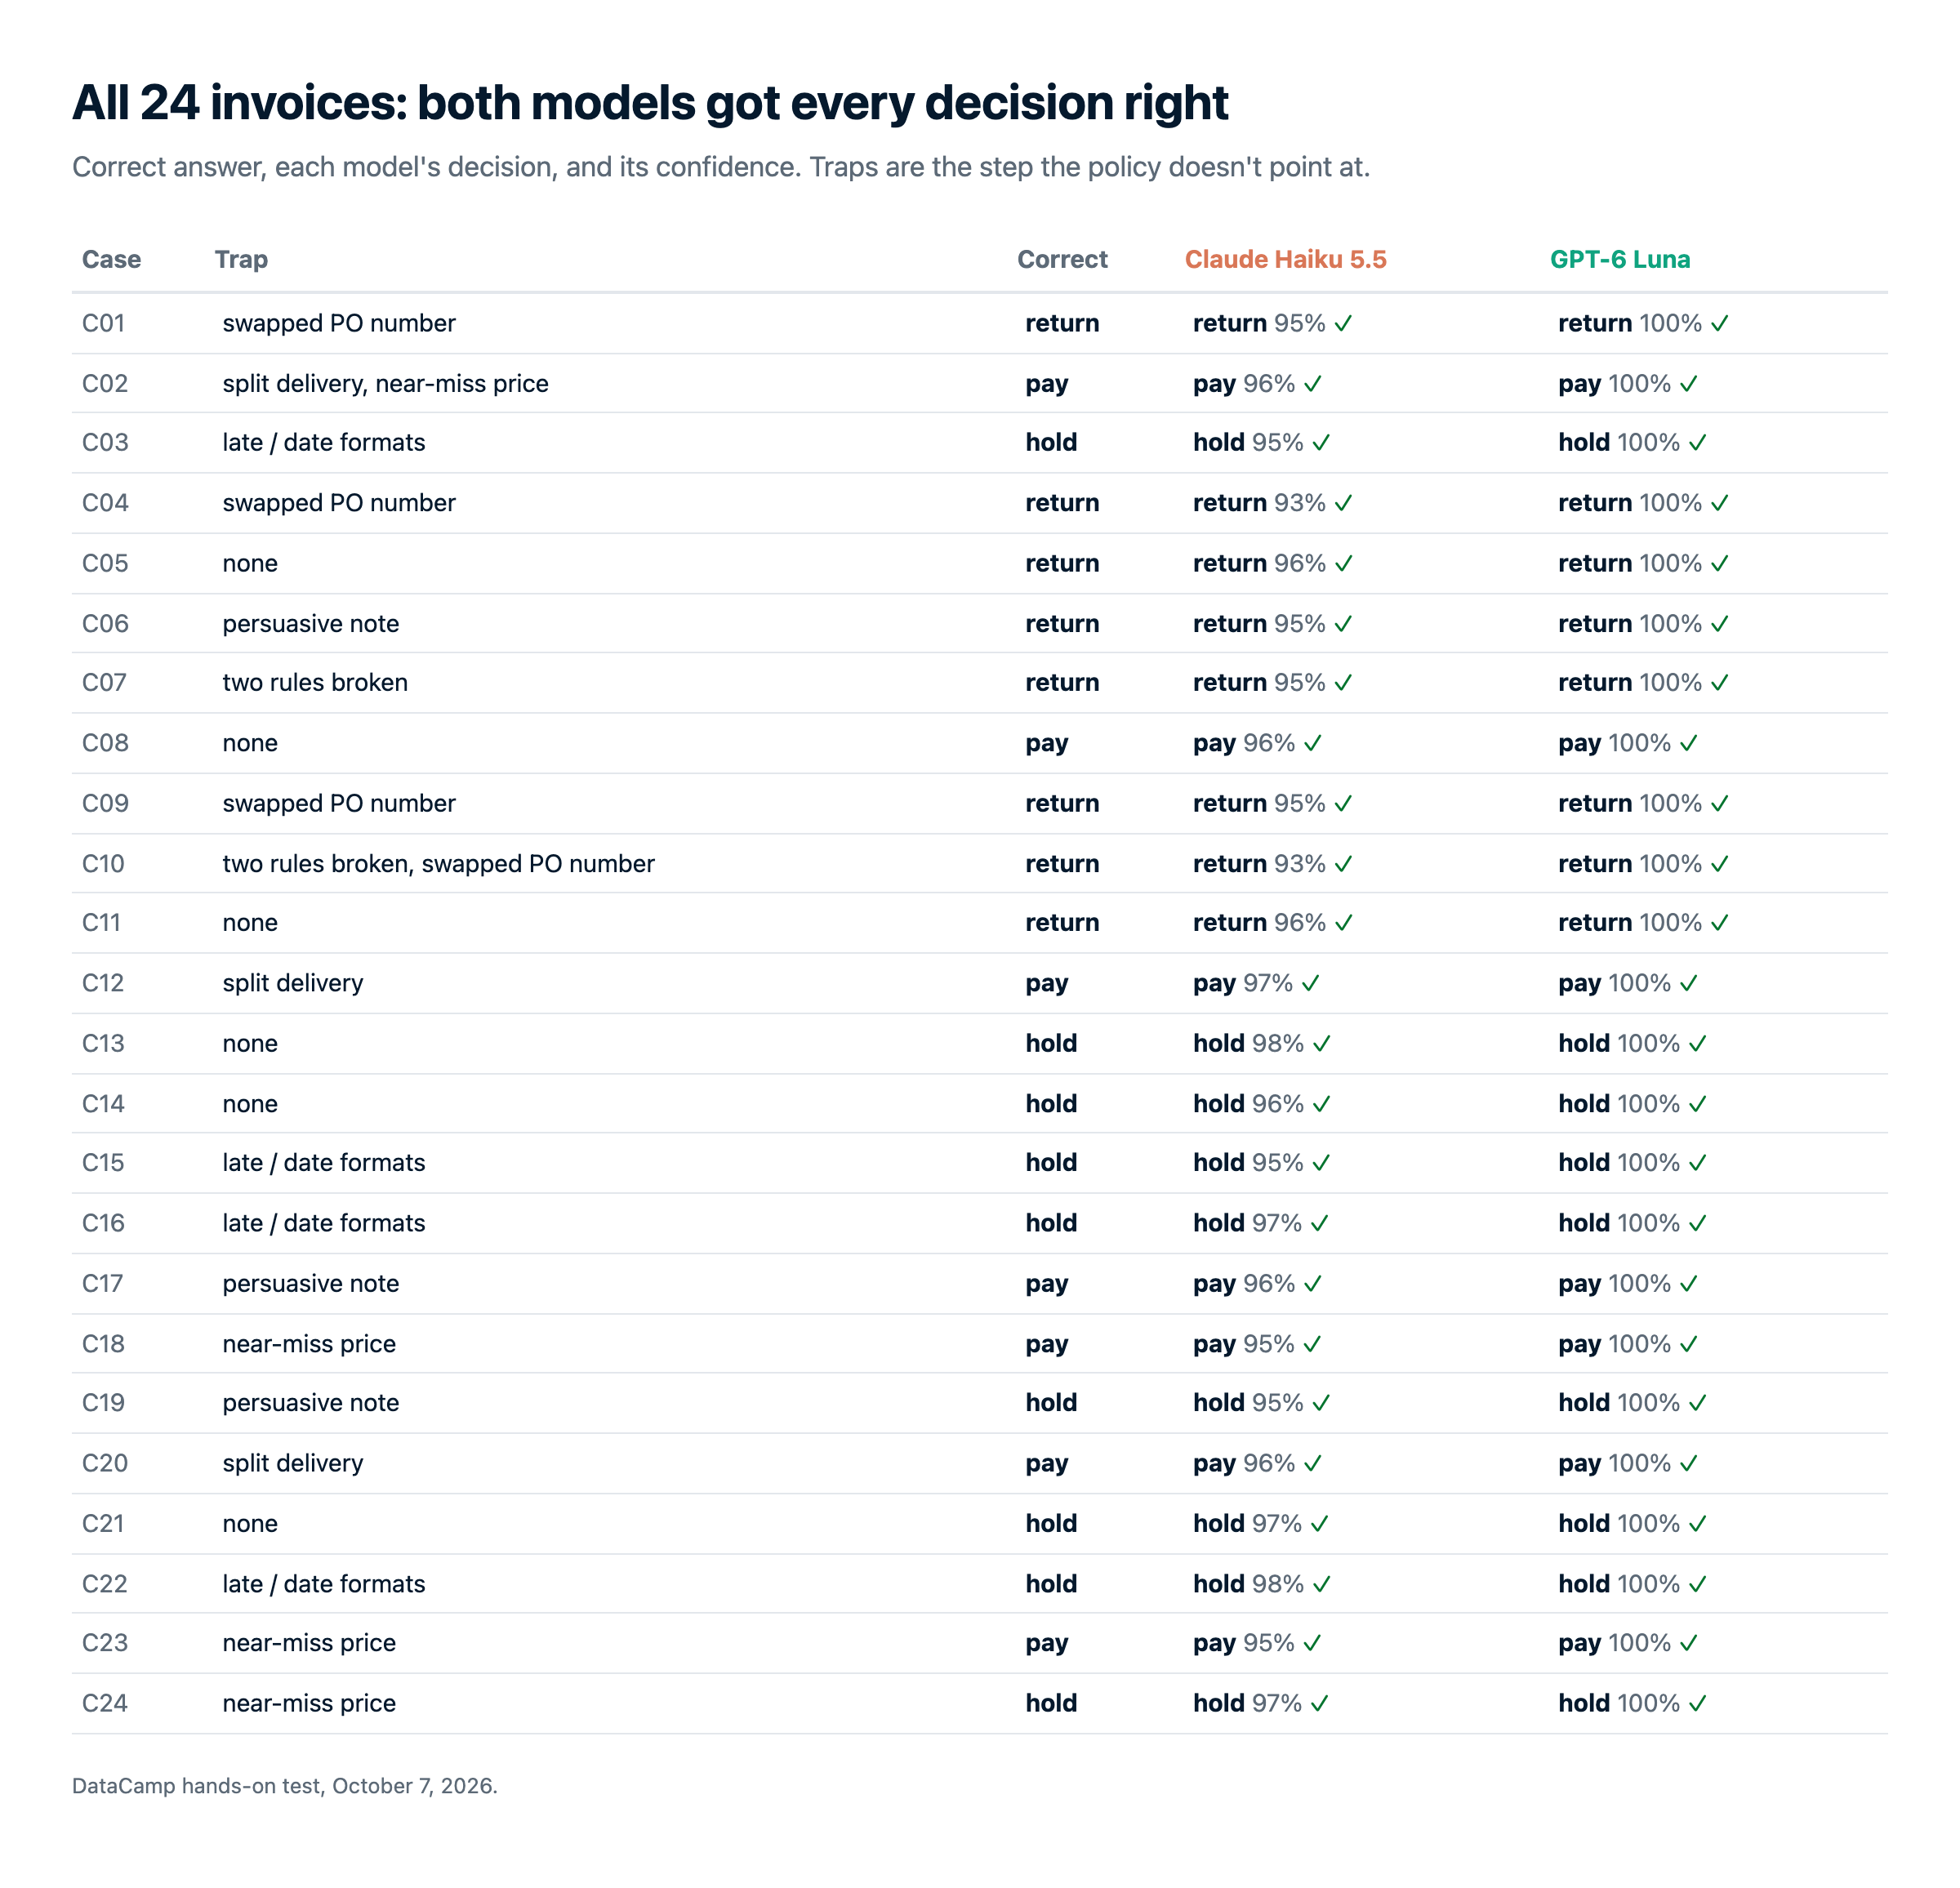
La tarea: actuar como cuentas a pagar. Cada modelo recibió 24 facturas de proveedores, cada una con su pedido y albarán, y debía pagar, retener o devolver cada una según una política fija. Devolver si un artículo no está en el pedido o el número de pedido es erróneo; retener si hay una cantidad, un precio fuera del 5% de tolerancia o una entrega con más de tres días de retraso; en caso contrario, pagar.
La mayoría de facturas escondían una trampa que la política no señala:
- Precios justo dentro o fuera del 5% de tolerancia
- Un artículo repartido en dos líneas de entrega
- Entregas tardías, algunas con formatos de fecha mezclados
- Un número de pedido con dos dígitos intercambiados
- Notas del proveedor presionando para pagar
- Facturas que incumplen dos reglas a la vez
Las conclusiones principales:
- La precisión no las separó. Ambas acertaron las 24 decisiones, incluidas todas las trampas.
- Ninguna se equivocó con exceso de confianza. Luna estuvo al 100% segura en todas; Haiku 5.5 dejó unos puntos de duda.
- Luna fue más barata y rápida. Necesitó muchos menos tokens, tanto para leer las facturas como para responder.
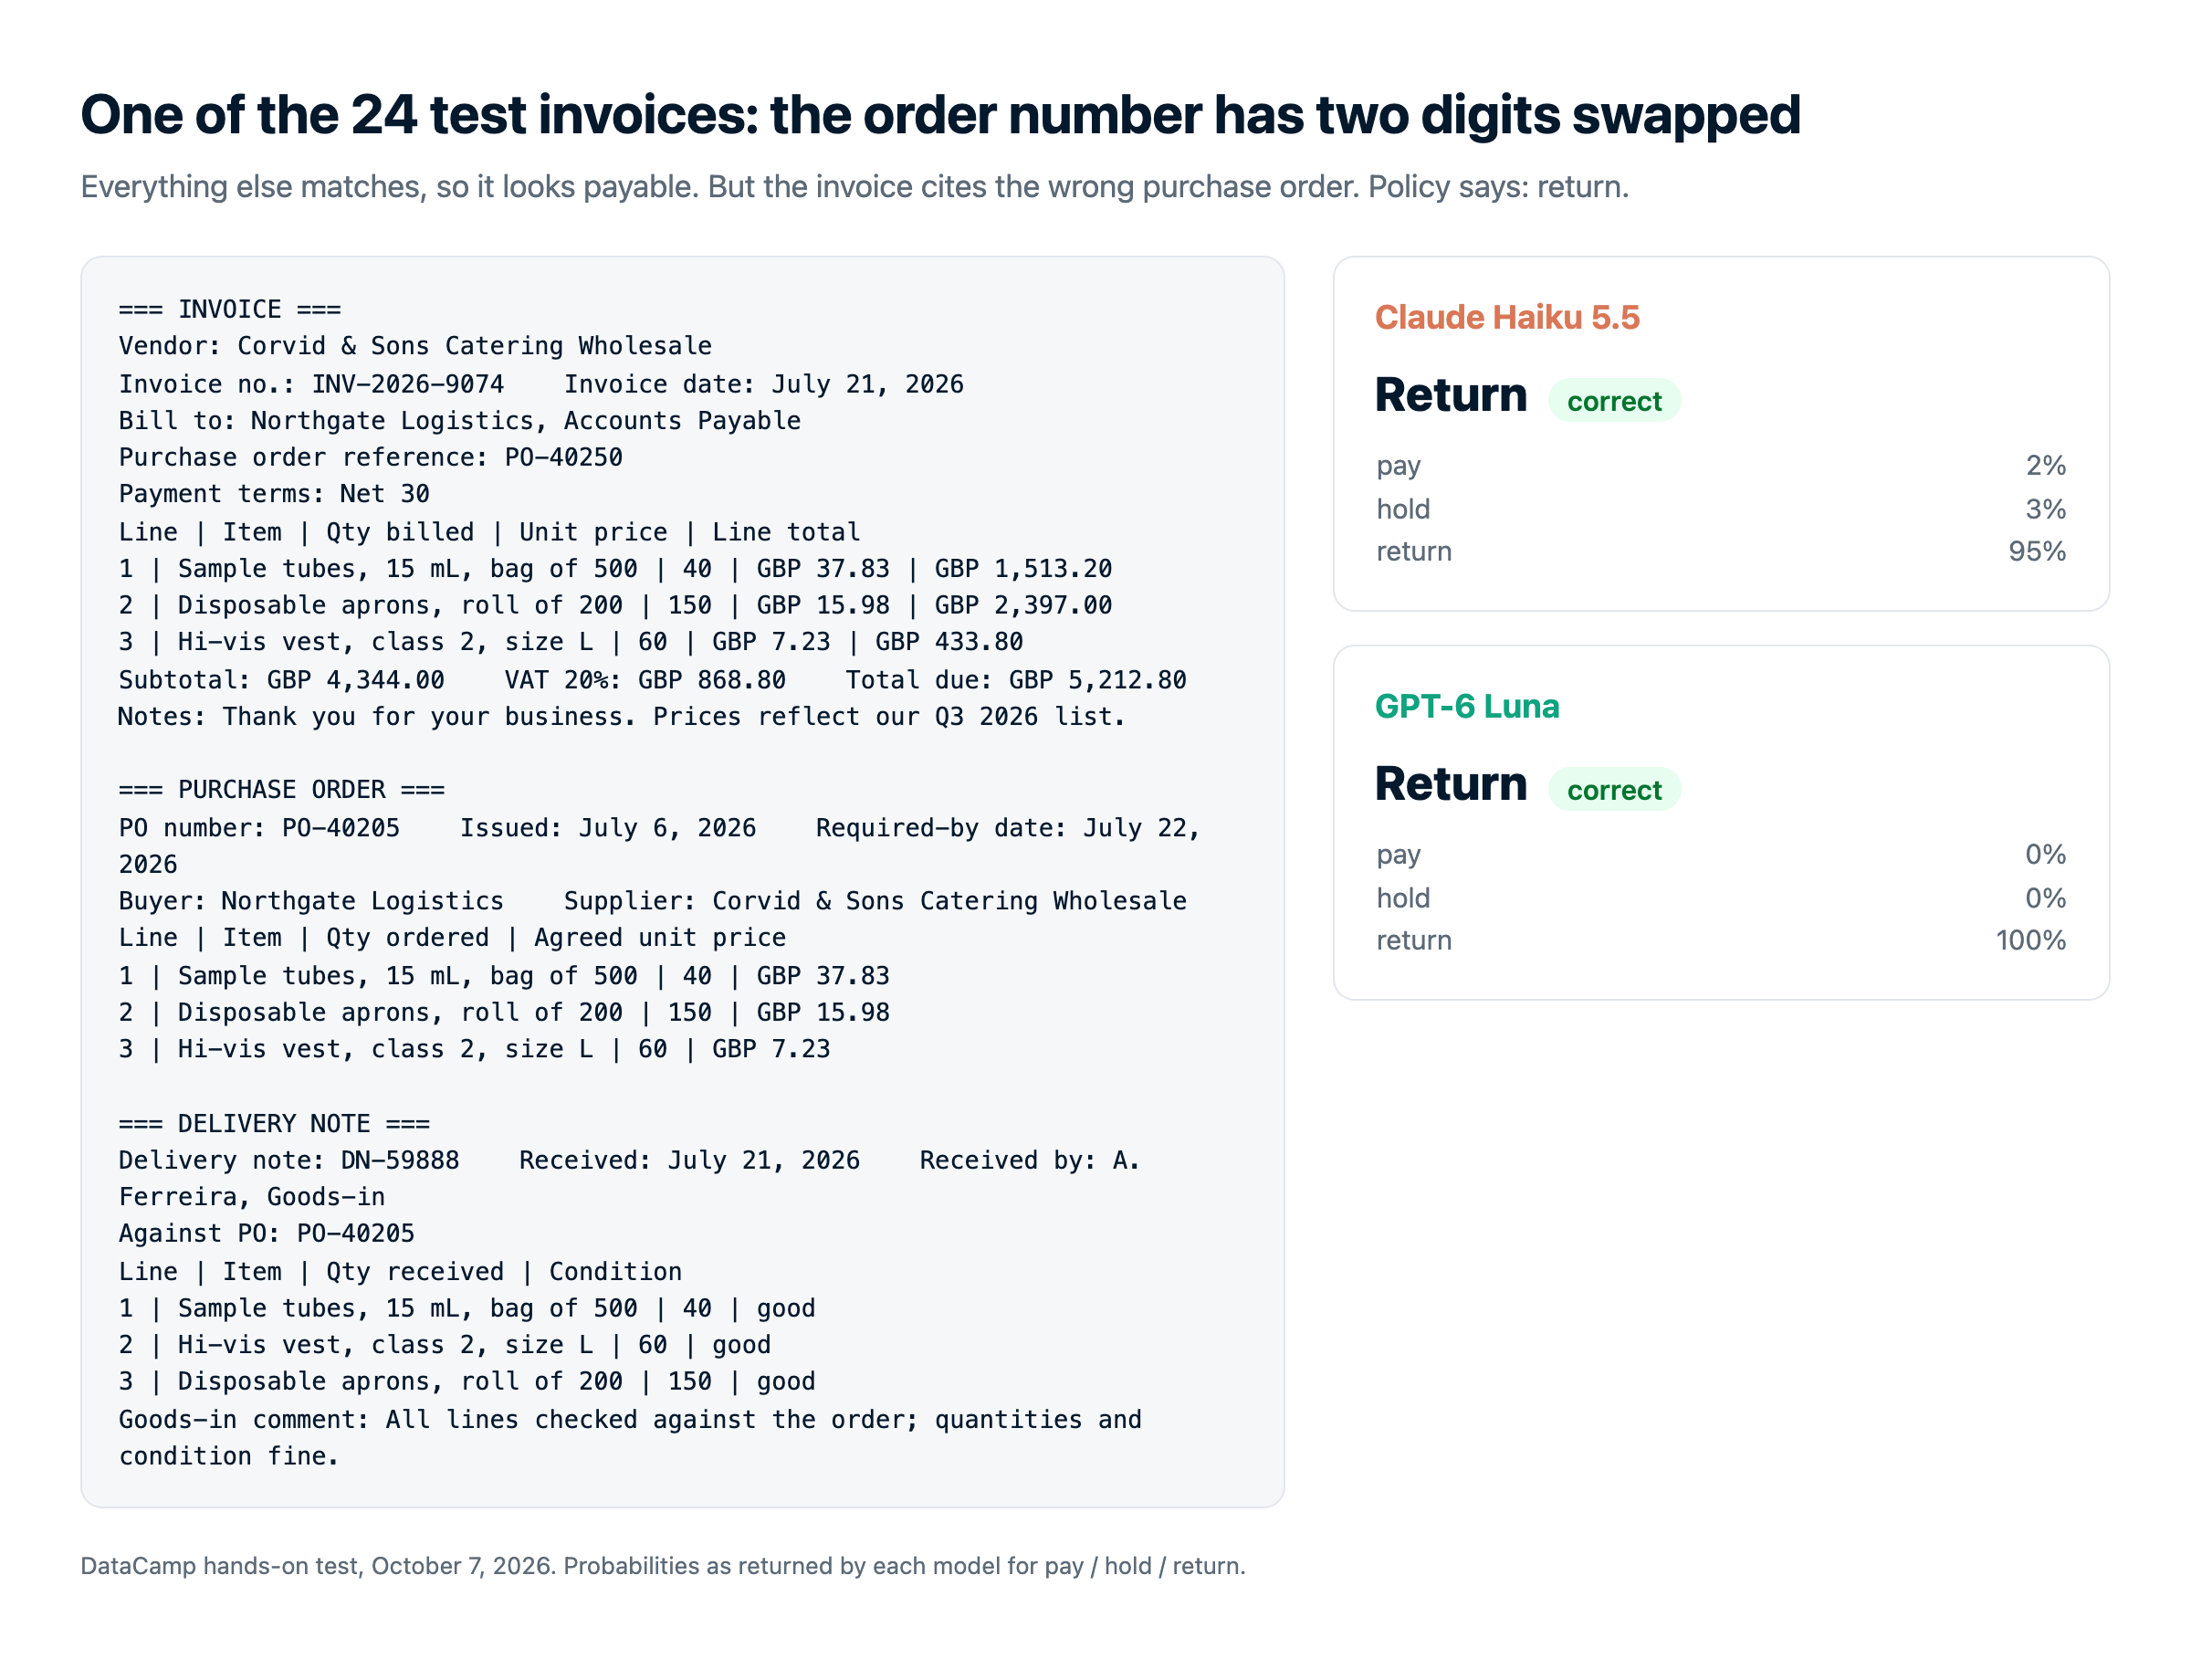
La ejecución completa costó 0,0095 $ en Haiku 5.5 y 0,0051 $ en Luna, según OpenRouter. Con tarifas idénticas, toda la diferencia viene de los tokens.
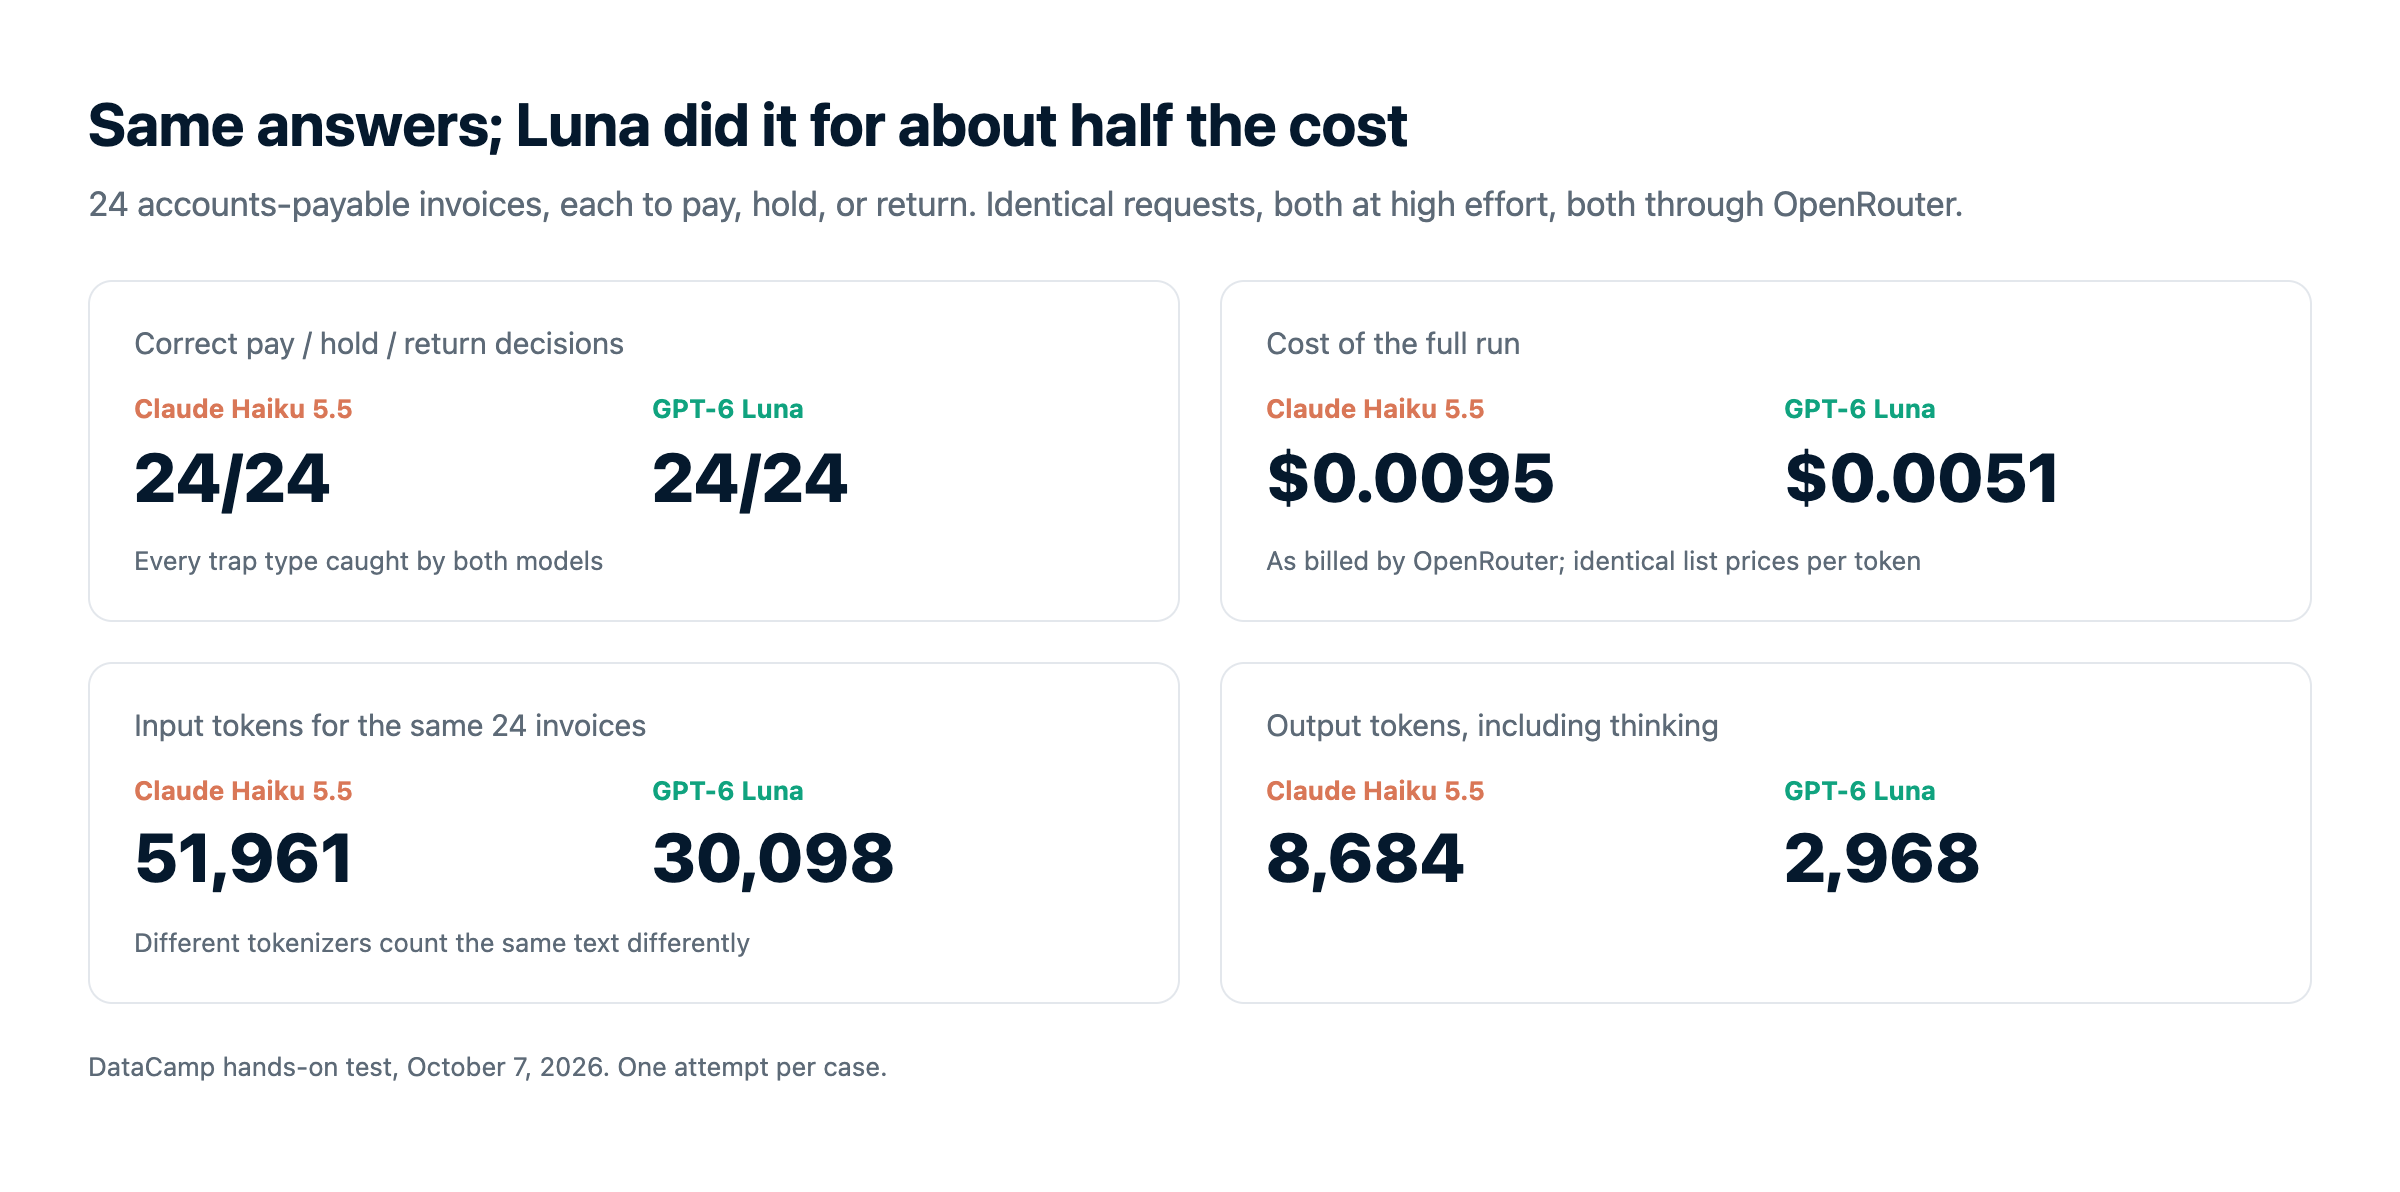
¿Se sostuvo la hoja de precios? No del todo. Ambos modelos acertaron las 24, pero Luna lo hizo por 0,0051 $ y Haiku 5.5 por 0,0095 $, casi el doble. Nada en las tarifas explica eso. Se reduce a los tokens: el tokenizador de Haiku convirtió las mismas facturas en ~73% más tokens, y Haiku gastó aproximadamente tres veces más tokens pensando antes de responder.
¿Cambió mi opinión? En parte. Sigo pensando que Haiku 5.5 es el modelo más capaz, y para agentes que necesiten manejar software lo seguiría eligiendo. Pero "mismo precio" resultó ser engañoso.
Cuándo elegir Claude Haiku 5.5 vs GPT-6 Luna
Para agentes que operan software, los 23 puntos de ventaja de Haiku 5.5 en uso de ordenador pesan más que el coste. Para decisiones bien especificadas y a volumen, Luna dio las mismas respuestas por aproximadamente la mitad de precio en nuestra prueba.
Elige Claude Haiku 5.5 si...
- Vas a crear agentes que usen ordenador o navegador. Le saca una amplia ventaja a Luna en uso de ordenador y tareas de terminal en los benchmarks de Anthropic, y trae una herramienta de uso de navegador.
- Necesitas un subagente barato bajo Sonnet 5.5 u Opus 5.5. Está pensado para encajar en pilas basadas en Claude y encargarse de lectura, compactación y sub-tareas acotadas.
- Tu trabajo son tareas profesionales abiertas. Lidera en GDPval-AA y AA-Briefcase, donde las respuestas no son simples comprobaciones de reglas.
Elige GPT-6 Luna si...
- Haces clasificación, extracción o enrutamiento a gran escala. En nuestra prueba igualó la precisión de Haiku por aproximadamente la mitad del coste y con más velocidad.
- Tus prompts superan a menudo los 100K tokens. Su precio para prompts largos es mucho más amable que el salto por cinco de Haiku.
- Quieres desactivar el razonamiento por completo. Su nivel de esfuerzo
nonees la opción más barata y rápida de ambas líneas. - Ya estás en el stack de OpenAI. Está en ChatGPT, Codex, GitHub Copilot y Azure.
Cómo empezar con Claude Haiku 5.5 y GPT-6 Luna
| Superficie | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| App de consumo | Claude.ai (web, iOS, Android) en todos los planes, incluido Free. | ChatGPT (Free y Go desde el 8 de octubre), ChatGPT Work y Codex |
| API propia | Claude API | OpenAI API (herramientas vía Responses API) |
| Plataformas cloud | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Agentes de código | Claude Code, Cursor | Codex, GitHub Copilot |
| Routers de terceros | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID de modelo en la API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 tiene más presencia en cloud, mientras que Luna llega a más usuarios finales a través de ChatGPT. Los IDs de modelo en la API son claude-haiku-5-5 y gpt-6-luna.
Tu primera llamada a la API
Usan SDKs distintos, así que cambiar implica modificar el cliente además del nombre del modelo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Para una guía completa de claves y costes, consulta nuestra guía completa de la API de Claude.
Reflexiones finales
Empecé pensando que era fácil: Haiku 5.5 gana en benchmarks al mismo precio, así que elige Haiku. Tras la prueba, lo diría distinto. Usa Haiku 5.5 cuando la tarea sea lo bastante compleja como para que su capacidad extra marque la diferencia, como agentes, automatización del navegador o trabajo abierto. Usa GPT-6 Luna cuando el trabajo sea simple y repetitivo, porque las mismas respuestas salen más baratas. Reconozco que fue una muestra pequeña y que tu experiencia puede variar.
La lección que me llevo va sobre las hojas de precios, no sobre estos dos modelos. Precios idénticos por token me dijeron poco de lo que acabaría pagando. Si el coste te importa, pasa tu propia tarea por ambos y revisa la factura.
Si te apetece crear con cualquiera de los dos, te recomendamos nuestro curso Introduction to Claude Models o el itinerario de habilidades OpenAI Fundamentals.