Anthropic가 최근 Claude Haiku 5.5를 출시했는데, 이는 OpenAI를 겨냥한 승부수였습니다. Anthropic가 공유한 벤치마크 표에서는 두 모델이 모두 등장하는 모든 항목에서 Haiku 5.5가 GPT-6 Luna를 앞섭니다. 게다가 Anthropic는 Haiku 5.5의 가격을 OpenAI의 Luna와 정확히 동일하게 책정했습니다: 입력 100만 토큰당 $0.10, 출력 100만 토큰당 $0.50. 표면적으로는 비교가 쉽습니다. Haiku 5.5가 GPT-6 Luna보다 성능이 좋고, 가격은 같습니다.
여기까지가 요점입니다. 하지만 "토큰당 가격이 같다"고 해서 "작업당 가격도 같다"는 뜻은 아닙니다. 같은 작업이라도 모델마다 읽고 쓰는 토큰 수가 다릅니다. 그래서 확인해 보기로 했습니다. 두 모델에 똑같은 일을 시키면 정말 비용이 같을까요? 만약 다르다면, 제 판단은 달라질까요?
한눈에 보기
- Anthropic의 벤치마크에서 Claude Haiku 5.5는 에이전트 작업과 터미널 작업에서 큰 격차로 앞서며, 더 유능한 에이전트입니다.
- 종이 위에선 Haiku 5.5가 승리: 같은 가격에 더 나은 벤치마크. 하지만 제 비용 테스트에선(스포일러) Luna가 절반가량의 비용으로 같은 답을 냈습니다.
- 교훈: 동일한 토큰 단가 뒤에는 토크나이저, 추론 길이, 장문 프롬프트 할증으로 인한 실제 비용 차이가 숨어 있습니다.
Claude Haiku 5.5란?
Claude Haiku 5.5는 Anthropic의 가장 작고 가장 빠른 모델로, Claude 5.5 패밀리의 마지막 멤버로 2026년 10월 7일 출시되었습니다.
Anthropic는 분류, 추출, 라우팅, 그리고 Sonnet 5.5나 Opus 5.5 하위 에이전트 등 대량·저지연 작업에 적합하다고 소개하며, 최하위 가격대에서도 적응형 사고와 컴퓨터 사용 능력을 제공합니다.
저희의 Claude Haiku 5.5 가이드는 출시 내용과 Haiku 4.5와의 실전 비교를 다룹니다.
GPT-6 Luna란?
GPT-6 Luna는 OpenAI의 최고 효율 모델로, GPT-6 패밀리에서 Astra와 Sol 아래에 위치한 가장 작은 등급으로 2026년 9월 22일 출시되었습니다.
OpenAI는 집중된 대량 작업을 위한 모델로 포지셔닝했으며, 10월 8일부터 ChatGPT Free 및 Go 사용자용 기본 모델로 단계적 도입 중입니다.
저희의 GPT-6 Sol 및 Luna 가이드에서 출시를 확인하세요.
Claude Haiku 5.5 vs. GPT-6 Luna: 정면 비교
Anthropic의 벤치마크에 따르면, 두 모델이 공유하는 모든 항목에서 Haiku 5.5가 Luna를 앞서며, 특히 에이전트 작업에서 격차가 가장 큽니다. 반면 단순 의사결정의 비용과 속도에선 저희 테스트가 다른 방향을 가리켰습니다.
| 항목 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (컴퓨터 사용) | 72.4% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46.4% | 42.4% |
| Chartography (도구 없음) | 46.4% | 29.1% |
| DeepSWE v1.1 | 미공개 | 66.6% (최대 노력) |
| 컨텍스트 윈도우 / 최대 출력 | 1M / 128K | 1.05M / 128K |
| 지식 컷오프 | 2026년 6월 | 2026년 5월 |
| 노력 수준 | low ~ max (기본 medium) | none ~ max (기본 medium) |
DeepSWE를 제외한 모든 행은 Anthropic의 출시 표에서 가져온 것이므로, Anthropic의 논거로 읽으시면 됩니다. OpenAI는 Haiku 5.5와의 비교를 공개하지 않았습니다. Luna가 먼저 나왔기 때문에 자연스러운 일입니다.
에이전트 작업과 컴퓨터 사용
Haiku 5.5가 가장 크게 앞서는 영역입니다. 실제 데스크톱을 조작해 작업을 완료할 수 있는지를 시험하는 OSWorld 2.1에서 Haiku 5.5는 72.4%, Luna는 48.9%로, 23.5포인트 격차가 납니다. 이는 소형 모델의 활용 범위를 바꿉니다. Terminal-Bench 4.0도 같은 이야기로, Haiku가 커맨드라인 작업을 두 배 이상 더 많이 완료했습니다.
Anthropic는 Haiku 5.5와 함께 브라우저 사용 도구도 제공했습니다.
에이전트 작업이라면 Haiku 5.5가 확실한 선택입니다.
지식 작업과 문서
전문 작업 평가에서도 Haiku 5.5가 앞섭니다. GDPval-AA에서 약 180 Elo, AA-Briefcase에서 약 240 Elo 앞서고, Chartography의 차트 판독에서도 17포인트 격차가 납니다.
다만 더 단순하고 규칙 기반의 문서 판정에서는, 저희 실전 테스트에서 정확도 차이가 전혀 없었습니다. 격차는 주로 개방형 작업에서 드러나는 듯합니다.
코딩
코딩은 격차가 작습니다. 변경사항의 머지 준비 여부를 평가하는 FrontierCode 1.1에서 Haiku 5.5가 4포인트 앞섭니다. OpenAI는 Luna가 DeepSWE v1.1에서 최대 노력 기준 66.6%라고 보고하며, 이는 Claude Opus 5의 중간 노력과 비슷한 수준입니다. 두 소형 모델 모두 본격적인 코딩 에이전트의 1순위는 아닙니다. 그런 용도는 Sonnet 5.5와 GPT-6.1 Sol의 영역에 가깝습니다.
노력 제어와 API 제약
두 모델 모두 기본은 medium이지만, Luna는 더 낮은 수준까지 지원합니다. none 설정은 추론을 완전히 건너뛰어 가장 저렴하고 빠른 답을 냅니다. Haiku 5.5의 최저 노력 수준은 low이지만, high 이하에선 여전히 생각 과정을 끌 수 있습니다.
가격: 실제로 내는 비용
Haiku 5.5와 Luna는 표준 요금이 동일하므로, 실제 비용 차이는 장문 프롬프트, 토크나이저, 그리고 각 모델이 쓰는 토큰 양에서 발생합니다.
토큰 요금 비교
| 요율 (100만 토큰당) | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 입력 | $0.10 (프롬프트 100K까지) | $0.10 (프롬프트 272K까지) |
| 출력 | $0.50 (프롬프트 100K까지) | $0.50 (프롬프트 272K까지) |
| 캐시된 입력 읽기 | $0.01 | $0.01 |
| 캐시 쓰기 | $0.125 (5분) | $0.125 |
| 장문 프롬프트 요금 | 100K 초과: 입력 $0.50, 출력 $2.50 | 272K 초과: 입력·캐시 2배, 출력 1.5배 |
| 배치 할인 | 50% | 50% |
100K 토큰 이하에서는 항목별로 완전히 동일합니다. 그 이상이 되면 Haiku는 요금이 다섯 배로 뛰는 반면, Luna는 272K 토큰까지는 동일하고 이후 인상 폭도 훨씬 적습니다. 두 모델 모두 추론은 출력으로 과금합니다.
정가 기준으로는 프롬프트가 길어져야 두 모델의 비용이 갈립니다. 하지만 아래 토크나이저 섹션이 이것만이 전부가 아님을 보여줍니다.
실제 워크로드 비용
| 워크로드 | Claude Haiku 5.5 | GPT-6 Luna | 차이 |
|---|---|---|---|
| 균형형 어시스턴트: 입력 100만 / 출력 25만 | $0.23 | $0.23 | 없음 |
| 검색·조회, 각 요청 100K 이하: 입력 1천만 / 출력 100만 | $1.50 | $1.50 | 없음 |
| 검색·조회, 각 요청 272K 초과: 입력 1천만 / 출력 100만 | $7.50 | $2.75 | $4.75 (Luna가 63% 저렴) |
각 합계는 (물량 ÷ 100만) × 요율을 입력과 출력에 각각 적용해 더한 값입니다.
- 균형형 어시스턴트와 짧은 조회: 요율표상 완전 무승부입니다.
- 긴 조회: Luna가 약 1/3 비용입니다. 100K~272K 구간에선 격차가 더 큽니다. Haiku는 이미 높은 요금을 내지만 Luna는 그대로이기 때문입니다. 동일한 입력 1천만/출력 100만이 Haiku에선 $7.50, Luna에선 $1.50입니다.
같은 작업인데 비용이 다른 이유
두 모델은 서로 다른 토크나이저를 사용합니다. 실측 결과, 같은 24개 인보이스가 Haiku 5.5에서는 입력 토큰 51,961개, Luna에서는 30,098개로 집계되어 Haiku가 약 1.7배 더 많았습니다. 이 차이를 짧은 조회 시나리오에 적용하면, Haiku의 입력 비용은 $1.00에서 약 $1.73으로 올라, 위의 "같은 가격" 행들이 실제로는 Luna에 유리해집니다.
출력도 한몫합니다. 같은 테스트에서 Haiku 5.5는 Luna보다 약 두 배 많은 출력 토큰을 썼고, 그 대부분은 추론이었습니다. 그래서 요율이 동일함에도 실행 비용이 거의 두 배가 됐습니다. 하나의 작업, 하나의 노력 설정에서의 결과이긴 하지만, 두 지표 모두 같은 방향을 가리킵니다.
Claude Haiku 5.5와 GPT-6 Luna의 성능
위 벤치마크는 Haiku 5.5가 더 나은 모델이라고 말하고, 가격표는 두 모델의 비용이 같다고 말합니다.
두 번째 주장은 그대로 믿고 싶지 않아, 한 가지 질문에 맞춘 테스트를 설계했습니다. 두 모델이 같은 일을 똑같이 잘해낸다면, 실제 실행 비용은 각각 얼마인가?
두 모델 모두 정확해야 할 작업을 골랐습니다. 그래야 차이가 답변이 아니라 청구서에서 드러납니다.
작업: 매입채무 역할 수행. 각 모델은 24개의 공급업체 인보이스와 해당 구매 주문서, 납품서를 받아 정해진 정책에 따라 지급, 보류, 반송 중 하나를 결정해야 했습니다. 주문서에 없는 항목이 있거나 주문번호가 틀리면 반송; 수량, 가격(허용 오차 5% 초과), 3일 초과 지연 납품 중 하나라도 문제가 있으면 보류; 그 외에는 지급.
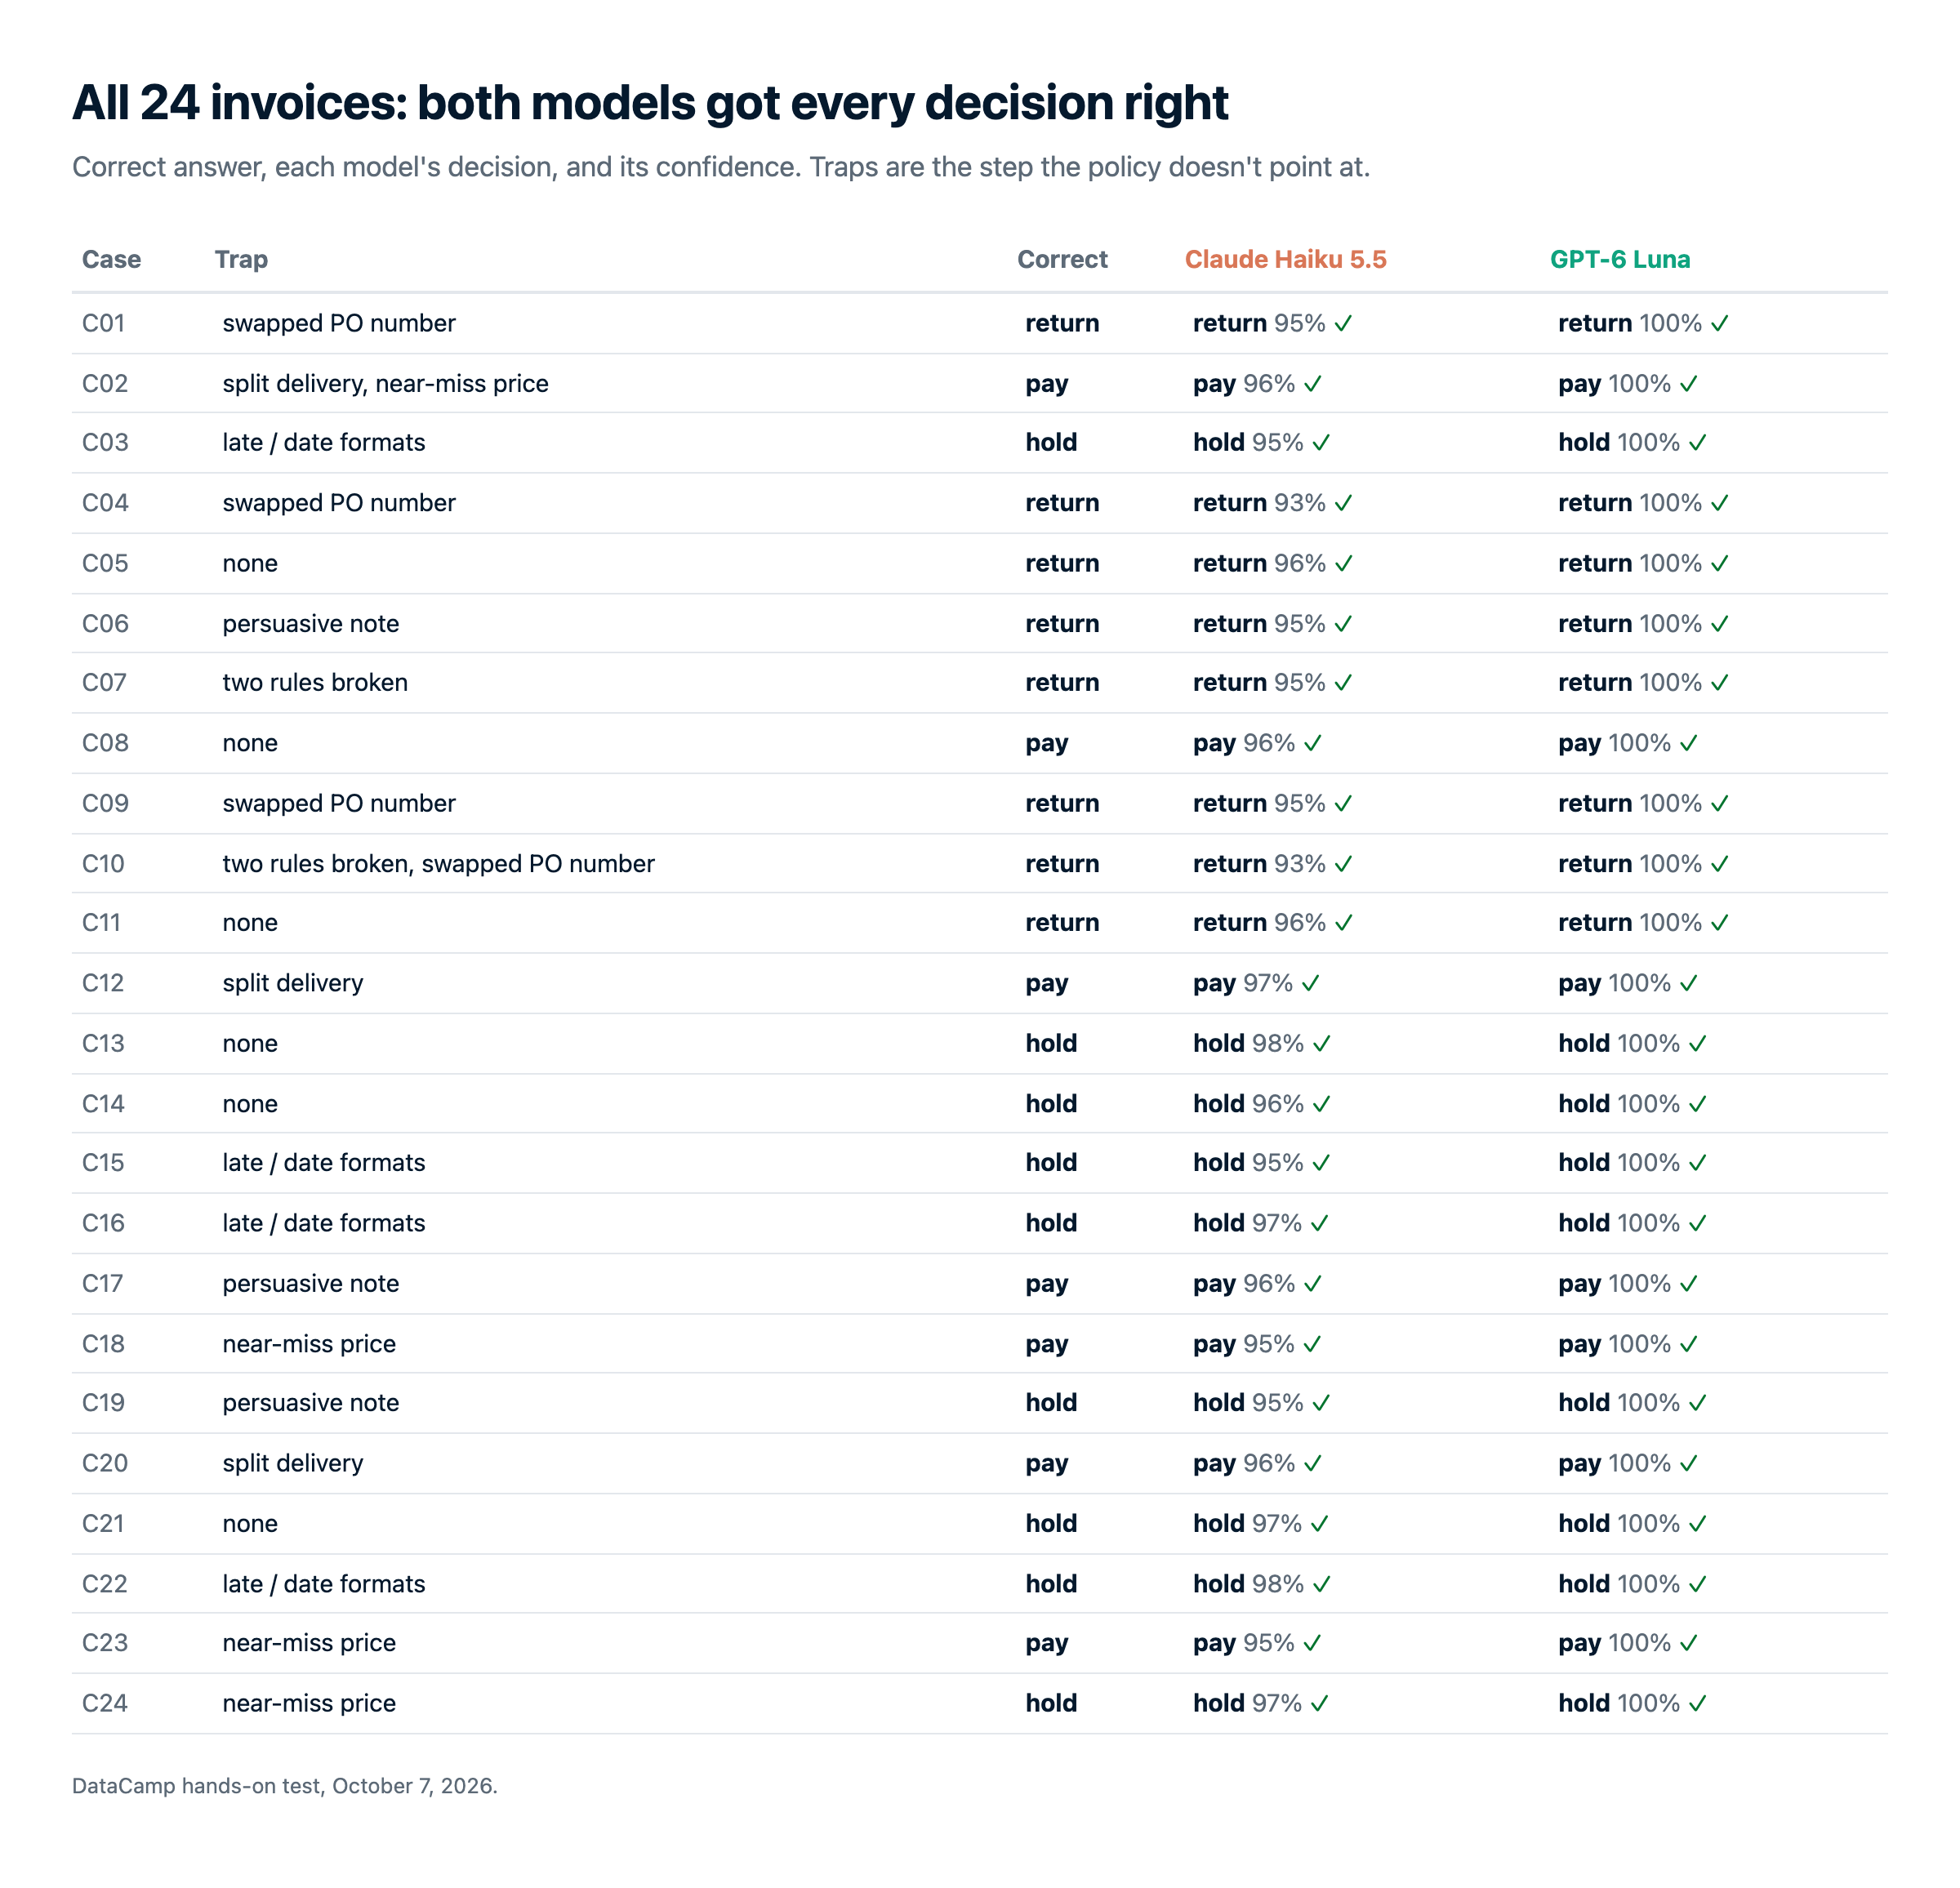
대부분의 인보이스에는 정책이 직접 지적하지 않는 함정이 숨겨져 있었습니다:
- 허용 오차 5%의 경계선 안팎 가격
- 한 품목을 두 개의 납품 라인으로 분할
- 지연 납품(날짜 형식이 뒤섞인 경우 포함)
- 두 자리 숫자가 뒤바뀐 주문번호
- 지급을 주장하는 공급업체 코멘트
- 두 가지 규칙을 동시에 위반한 인보이스
주요 결과:
- 정확도는 우열을 가리지 못했습니다. 두 모델 모두 24건 전부를, 모든 함정을 포함해 정확히 맞혔습니다.
- 확신에 찬 오답은 없었습니다. Luna는 모든 답에 100% 확신을 보였고, Haiku 5.5는 몇 퍼센트의 여지를 남겼습니다.
- Luna가 더 저렴하고 빨랐습니다. 인보이스를 읽고 답변하는 데 모두 훨씬 적은 토큰이 필요했습니다.
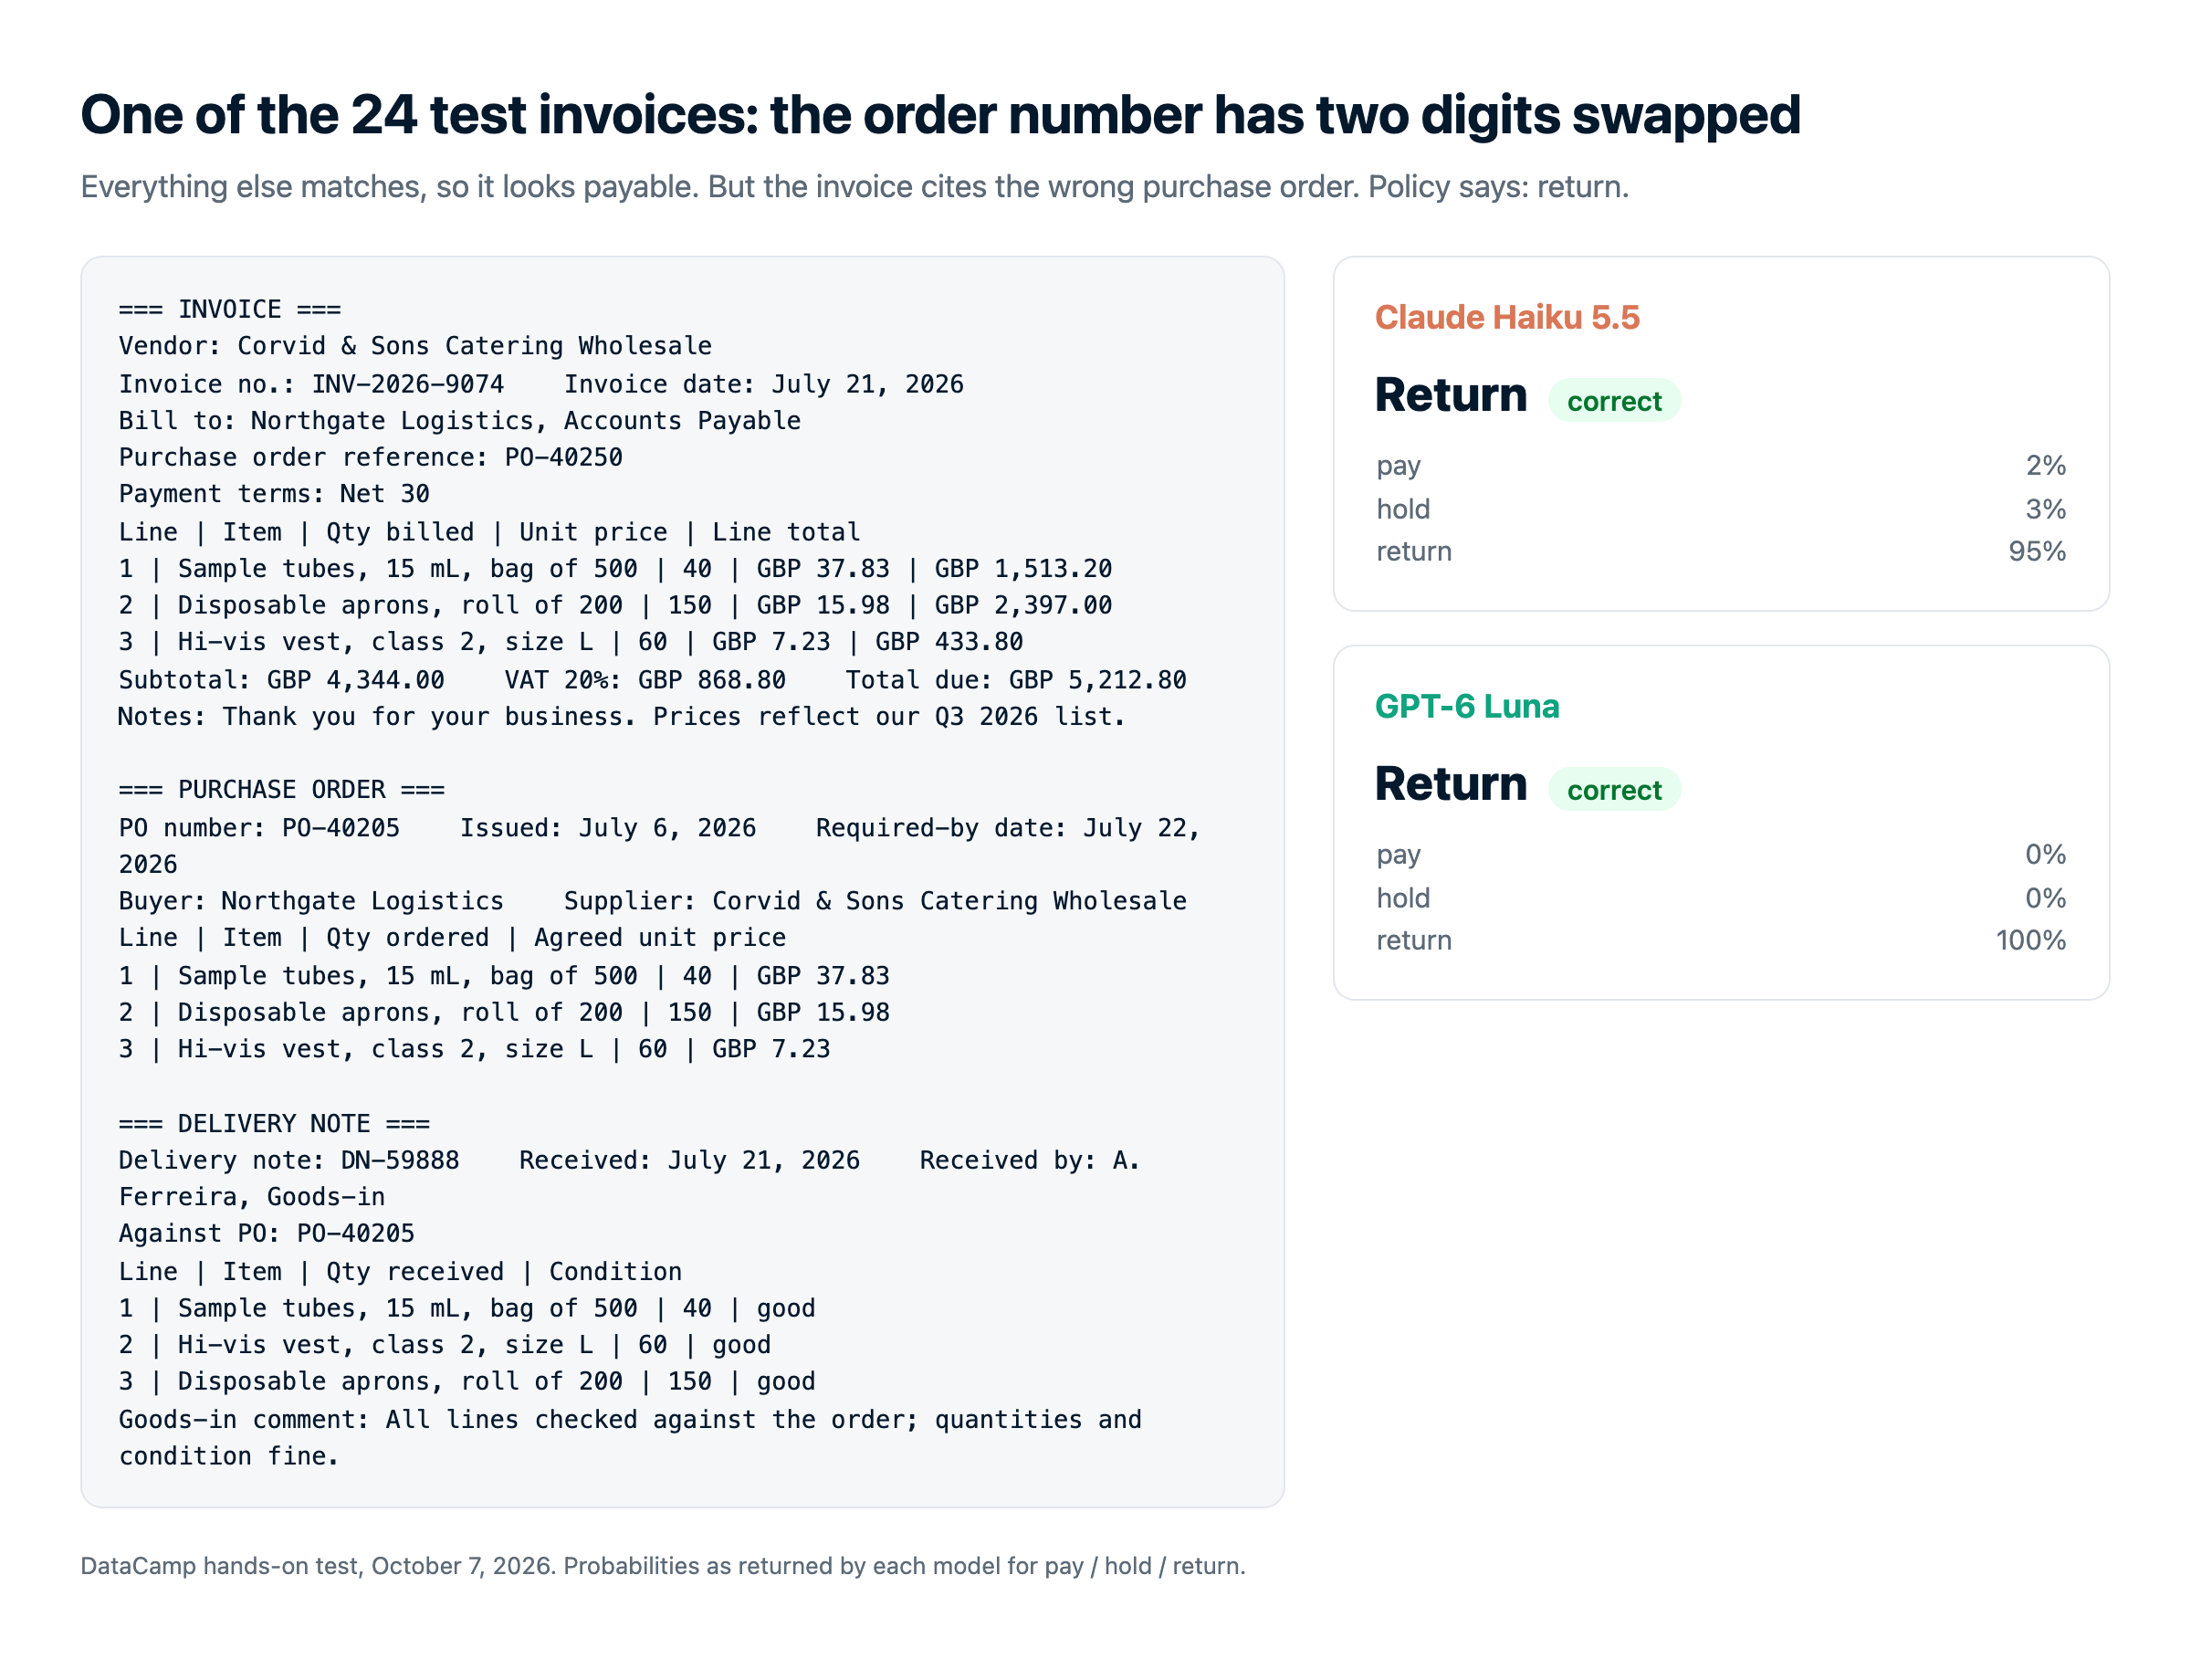
전체 실행 비용은 OpenRouter 청구 기준 Haiku 5.5가 $0.0095, Luna가 $0.0051이었습니다. 요율이 동일하므로, 격차는 전적으로 토큰에서 비롯됐습니다.
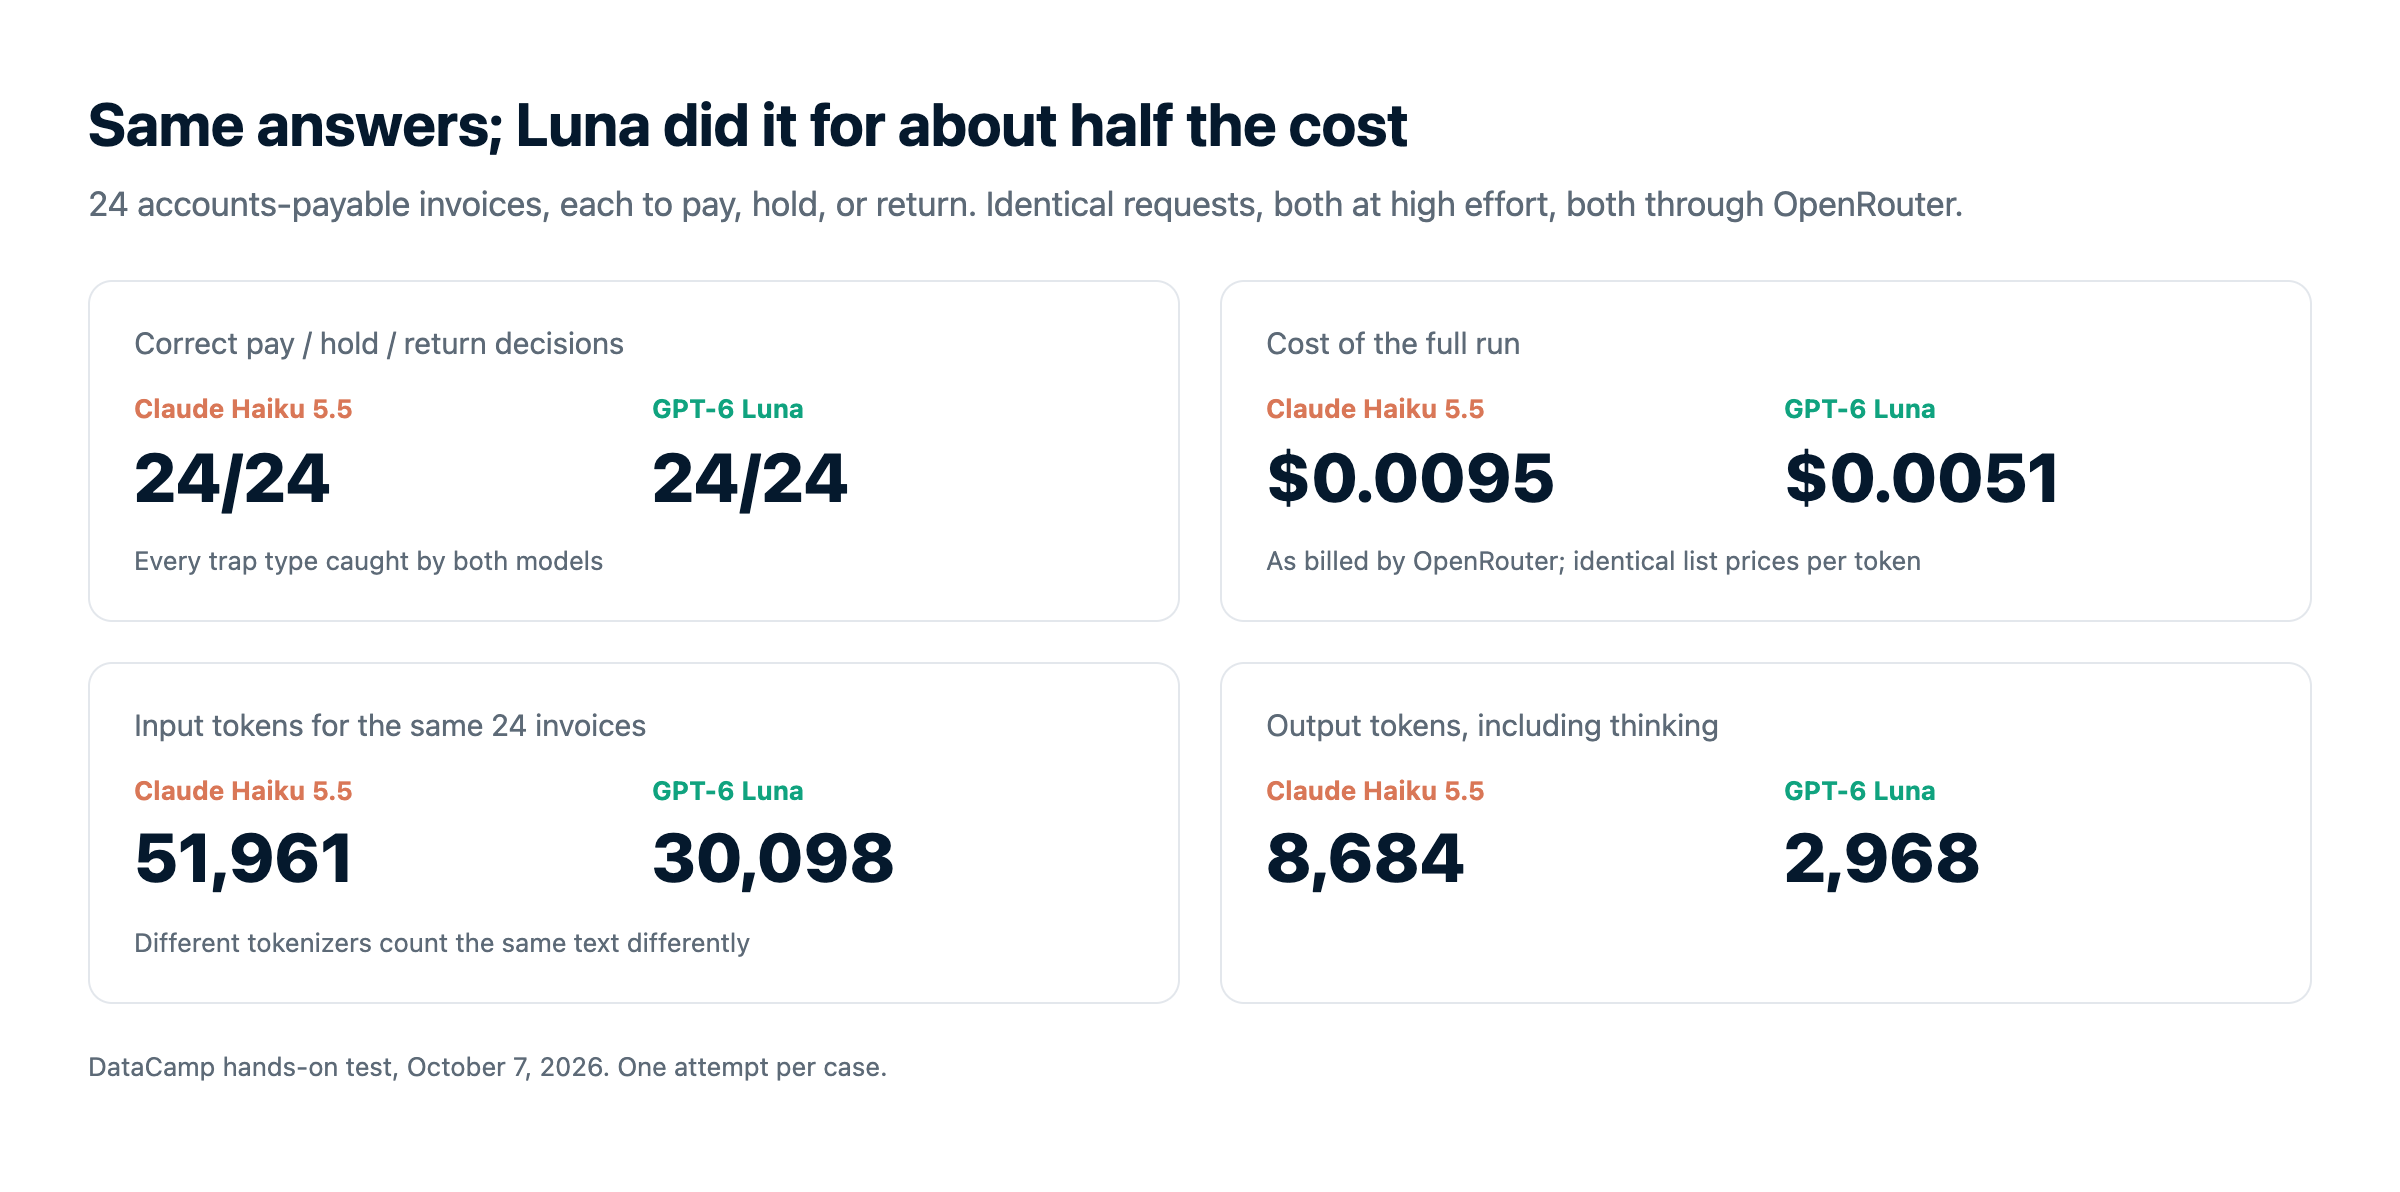
가격표가 그대로 적용됐을까요? 완전히는 아닙니다. 두 모델 모두 24건을 정확히 판정했지만, Luna는 $0.0051, Haiku 5.5는 $0.0095가 들었습니다. 거의 두 배 차이입니다. 요율로는 설명되지 않습니다. 토큰이 결정적입니다. Haiku의 토크나이저는 같은 인보이스를 약 73% 더 많은 토큰으로 분할했고, Haiku는 답변 전 추론에 약 세 배 가까운 토큰을 썼습니다.
제 의견이 바뀌었냐고요? 부분적으로요. 여전히 Haiku 5.5가 더 유능한 모델이라고 생각하고, 소프트웨어를 실제로 조작해야 하는 에이전트라면 Haiku를 택하겠습니다. 하지만 "같은 가격"이라는 말은 결국 오해의 소지가 있었습니다.
Claude Haiku 5.5와 GPT-6 Luna 중 언제 무엇을 고를까
소프트웨어를 조작하는 에이전트라면, Haiku 5.5의 컴퓨터 사용 23포인트 격차가 비용보다 중요합니다. 명확한 규칙이 있는 대량 의사결정이라면, 저희 테스트에서 Luna가 절반가량의 가격으로 같은 답을 냈습니다.
다음에 해당하면 Claude Haiku 5.5를 선택하세요
- 컴퓨터나 브라우저를 사용하는 에이전트를 구축 중입니다. Anthropic 벤치마크에서 컴퓨터 사용과 터미널 작업에서 Luna를 큰 격차로 앞서고, 브라우저 사용 도구도 함께 제공합니다.
- Sonnet 5.5 또는 Opus 5.5 하위 에이전트가 필요합니다. Claude 기반 스택 안에서 읽기, 요약·압축, 좁은 하위 작업을 맡도록 설계되었습니다.
- 업무가 개방형 전문 작업입니다. 간단한 규칙 검사가 아닌 GDPval-AA, AA-Briefcase에서 앞섭니다.
다음에 해당하면 GPT-6 Luna를 선택하세요
- 대량의 분류, 추출, 라우팅을 운영합니다. 저희 테스트에서 Haiku와 동일한 정확도를 더 저렴하고 눈에 띄게 빠르게 달성했습니다.
- 프롬프트가 자주 100K 토큰을 넘습니다. 장문 프롬프트 요금 인상이 Haiku의 5배 점프보다 훨씬 완만합니다.
- 추론을 완전히 끄고 싶습니다.
none노력 설정은 양 라인업에서 가장 저렴하고 빠른 옵션입니다. - 이미 OpenAI 스택을 사용 중입니다. ChatGPT, Codex, GitHub Copilot, Azure에 통합되어 있습니다.
Claude Haiku 5.5와 GPT-6 Luna 시작하기
| 채널 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 소비자 앱 | Claude.ai (웹, iOS, Android) 전 요금제, Free 포함 | ChatGPT (10월 8일부터 Free 및 Go), ChatGPT Work 및 Codex |
| 퍼스트파티 API | Claude API | OpenAI API (도구는 Responses API 경유) |
| 클라우드 플랫폼 | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| 코딩 에이전트 | Claude Code, Cursor | Codex, GitHub Copilot |
| 서드파티 라우터 | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| API 모델 ID | claude-haiku-5-5 |
gpt-6-luna |
클라우드 도달성은 Haiku 5.5가 더 넓고, 소비자 접점은 ChatGPT를 통한 Luna가 더 큽니다. API 모델 ID는 claude-haiku-5-5와 gpt-6-luna입니다.
첫 API 호출 만들기
두 모델은 SDK가 다르므로, 모델 문자열뿐 아니라 클라이언트도 바꿔야 합니다:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)키와 비용 전반에 대한 자세한 안내는 Claude API 완전 가이드를 참고하세요.
마무리
처음에는 간단하다고 생각했습니다. 같은 가격에 벤치마크에서 Haiku 5.5가 이기니 Haiku를 고르자. 테스트를 마친 지금은 표현을 바꾸겠습니다. 에이전트, 브라우저 자동화, 개방형 작업처럼 난도가 높은 일에는 Haiku 5.5를 쓰세요. 단순하고 반복적인 일에는 GPT-6 Luna를 쓰세요. 같은 답을 더 저렴하게 냅니다. 물론 표본이 작았으니, 실제 결과는 환경에 따라 달라질 수 있습니다.
제가 얻은 교훈은 두 모델 자체보다 가격표에 관한 것입니다. 동일한 토큰 단가는 실제로 얼마를 내게 될지 거의 알려주지 못했습니다. 비용이 중요하다면, 직접 자신의 작업을 두 모델에 돌려보고 청구서를 확인하세요.
둘 중 어느 쪽이든 빌드할 생각이라면, Introduction to Claude Models 강의나 OpenAI Fundamentals 스킬 트랙을 추천합니다.