Anthropic a lansat recent Claude Haiku 5.5, iar a fost o lovitură către OpenAI. Tabelul de benchmarkuri publicat de Anthropic îl plasează pe Haiku 5.5 înaintea lui GPT-6 Luna pe fiecare rând în care apar amândouă. Și Anthropic a prețuit Haiku 5.5 exact la fel cum OpenAI prețuiește Luna: 0,10 $ per un milion de tokeni input și 0,50 $ per un milion de tokeni output. Pe hârtie, comparația e simplă. Haiku 5.5 este mai bun decât GPT-6 Luna și costă la fel.
Asta e concluzia rapidă. Dar „același preț pe token” nu înseamnă „același preț pe job”. Modelele citesc și scriu un număr diferit de tokeni pentru aceeași sarcină. Așa că m-am gândit că ar fi interesant să verific: dacă dau ambelor modele aceeași muncă, chiar costă la fel? Și dacă nu, mi-aș schimba părerea?
Pe scurt
- Claude Haiku 5.5 este agentul mai capabil, cu avantaje mari la folosirea calculatorului și sarcini în terminal, conform benchmarkurilor Anthropic.
- Pe hârtie, Haiku 5.5 câștigă: benchmarkuri mai bune la același preț. Dar în testul meu de cost (spoiler), Luna a dat aceleași răspunsuri pentru cam jumătate din bani.
- Concluzia: prețurile identice pe token pot ascunde diferențe reale de cost, din cauza tokenizerelor, a lungimii raționamentului și a suprataxelor pentru prompturi lungi.
Ce este Claude Haiku 5.5?
Claude Haiku 5.5 este cel mai mic și cel mai rapid model al Anthropic, lansat pe 7 octombrie 2026 ca ultimul membru al familiei Claude 5.5.
Anthropic îl propune pentru muncă la volum mare și sensibilă la latență, precum clasificare, extragere, rutare și rulare ca subagent sub Sonnet 5.5 sau Opus 5.5, aducând gândirea adaptivă și folosirea calculatorului la baza scării de preț.
Ghidul nostru Claude Haiku 5.5 acoperă lansarea și testul nostru practic față de Haiku 4.5.
Ce este GPT-6 Luna?
GPT-6 Luna este cel mai eficient model al OpenAI, lansat pe 22 septembrie 2026 ca cel mai mic nivel al familiei GPT-6, sub Astra și Sol.
OpenAI îl poziționează pentru sarcini concentrate, la volum mare, iar OpenAI îl lansează ca modelul din spatele ChatGPT pentru utilizatorii Free și Go începând cu 8 octombrie.
Ghidul nostru GPT-6 Sol și Luna acoperă lansarea.
Claude Haiku 5.5 vs. GPT-6 Luna: comparație directă
Benchmarkurile Anthropic îl plasează pe Haiku 5.5 înaintea lui Luna pe fiecare rând pe care îl împart, cu cele mai mari diferențe la sarcinile agentice. La cost și viteză pentru decizii simple, testul nostru propriu a indicat invers.
| Funcționalitate | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (folosire calculator) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46,4% | 42,4% |
| Chartography (fără unelte) | 46,4% | 29,1% |
| DeepSWE v1.1 | Neraportat | 66,6% (efort maxim) |
| Fereastră de context / output maxim | 1M / 128K | 1,05M / 128K |
| Limită de cunoștințe | Iunie 2026 | Mai 2026 |
| Niveluri de efort | scăzut la maxim (implicit mediu) | niciunul la maxim (implicit mediu) |
Fiecare rând în afară de DeepSWE provine din tabelul de lansare al Anthropic, așa că citește-l ca argumentul Anthropic; OpenAI nu a publicat o comparație cu Haiku 5.5. E normal, deoarece Luna a apărut prima.
Muncă agentică și folosirea calculatorului
Aici Haiku 5.5 se desprinde cel mai mult. Pe OSWorld 2.1, care testează dacă un model poate finaliza taskuri operând un desktop real, Haiku 5.5 obține 72,4% față de 48,9% pentru Luna, o diferență de 23,5 puncte care schimbă ce poate face util un model mic. Terminal-Bench 4.0 spune aceeași poveste, cu Haiku rezolvând de peste două ori mai multe sarcini în linia de comandă.
Anthropic a livrat și un instrument de folosire a browserului odată cu Haiku 5.5.
Pentru muncă agentică, Haiku 5.5 este alegerea clară.
Muncă de cunoaștere și documente
Haiku 5.5 conduce și la evaluările pentru sarcini profesionale: cu aproximativ 180 de puncte Elo în față pe GDPval-AA și aproximativ 240 pe AA-Briefcase. Citirea de grafice în Chartography arată o diferență de 17 puncte.
La decizii mai simple, cu reguli stricte pe documente, însă, testul nostru practic nu a găsit nicio diferență de acuratețe, deci probabil diferența apare mai ales la munca deschisă.
Programare
Programarea e mai strânsă. Pe FrontierCode 1.1, care evaluează dacă schimbările sunt gata de integrat, Haiku 5.5 conduce cu 4 puncte. OpenAI raportează Luna la 66,6% pe DeepSWE v1.1 la efort maxim, comparabil cu Claude Opus 5 la efort mediu. Niciunul dintre modelele mici nu e prima alegere pentru agenți serioși de programare. Asta e mai degrabă teren pentru Sonnet 5.5 și GPT-6.1 Sol.
Controale de efort și constrângeri API
Ambele modele au implicit efort mediu, dar Luna merge mai jos: setarea sa none sare peste raționament pentru răspunsuri cât mai ieftine și rapide. Cel mai scăzut nivel de efort al lui Haiku 5.5 este low, deși poți opri gândirea și la efort high sau mai jos.
Prețuri: cât plătești de fapt
Haiku 5.5 și Luna au tarife standard identice, așa că diferențele reale de cost vin din prompturi lungi, tokenizere și cât de mult scrie fiecare model.
Tarife pe token, alăturat
| Tarif, per 1M tokeni | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Input | 0,10 $ (prompturi până la 100K) | 0,10 $ (prompturi până la 272K) |
| Output | 0,50 $ (prompturi până la 100K) | 0,50 $ (prompturi până la 272K) |
| Citire din cache | 0,01 $ | 0,01 $ |
| Scriere în cache | 0,125 $ (5 minute) | 0,125 $ |
| Prețuri pentru prompturi lungi | Peste 100K tokeni: 0,50 $ input, 2,50 $ output | Peste 272K tokeni: 2x input și cache, 1,5x output |
| Reducere pentru batch | 50% | 50% |
Sub 100K tokeni, tabelele de tarife sunt identice linie cu linie. Peste, prețurile lui Haiku cresc de cinci ori, în timp ce ale lui Luna rămân neschimbate până la 272K tokeni și apoi cresc mult mai puțin. Ambele taxează raționamentul ca output.
La prețurile de listă, cele două se despart doar când prompturile devin lungi. Secțiunea despre tokenizer de mai jos arată de ce nu e toată povestea.
Cât costă o sarcină reală
| Sarcină | Claude Haiku 5.5 | GPT-6 Luna | Diferență |
|---|---|---|---|
| Asistent echilibrat: 1M in / 250K out | 0,23 $ | 0,23 $ | Nicio |
| Retrieval, fiecare cerere sub 100K: 10M in / 1M out | 1,50 $ | 1,50 $ | Nicio |
| Retrieval, fiecare cerere peste 272K: 10M in / 1M out | 7,50 $ | 2,75 $ | 4,75 $ (−63% pe Luna) |
Fiecare total este (volum ÷ 1M) × tarif, cumulat pe input și output, la tarife standard.
- Asistent echilibrat și retrieval scurt: egalitate perfectă pe tabelul de tarife.
- Retrieval lung: Luna costă cam o treime. Diferența e și mai mare între 100K și 272K tokeni, unde Haiku plătește deja tariful mai mare, iar Luna nu: aceiași 10M in / 1M out costă 7,50 $ pe Haiku față de 1,50 $ pe Luna.
De ce aceeași sarcină costă sume diferite
Cele două modele folosesc tokenizere diferite, iar noi am măsurat direct diferența: aceleași 24 de facturi din testul practic au fost numărate ca 51.961 tokeni input pe Haiku 5.5 și 30.098 pe Luna, cam de 1,7 ori mai mulți pe Haiku. Aplicat la rândul de retrieval scurt, asta ridică costul de input al lui Haiku de la 1,00 $ la aproximativ 1,73 $, așa că rândurile „același preț” de mai sus favorizează în practică Luna.
Outputul amplifică. În același test, Haiku 5.5 a scris cam de două ori mai mulți tokeni output decât Luna, majoritatea raționament, motiv pentru care rularea lui a costat aproape dublu, în ciuda tarifelor identice. E un singur task la un singur nivel de efort, dar direcția e consecventă în ambele măsurători.
Cum au performat Claude Haiku 5.5 și GPT-6 Luna
Benchmarkurile de mai sus spun că Haiku 5.5 este modelul mai bun, iar foaia de prețuri spune că cele două costă la fel.
N-am vrut să iau a doua parte de bună, așa că am proiectat un test în jurul unei întrebări: dacă ambele modele fac aceeași muncă la fel de bine, cât costă de fapt rularea fiecăruia?
Am ales o muncă unde ambele ar trebui să fie precise, astfel încât orice diferență să apară pe factură, nu în răspunsuri.
Sarcina: acționează ca plăți către furnizori (accounts payable). Fiecare model a primit 24 de facturi de la furnizori, fiecare cu comanda de achiziție și avizul de livrare, și a trebuit să plătească, să rețină sau să returneze fiecare factură după o politică fixă. Returnează dacă un articol nu e pe comandă sau numărul comenzii e greșit; reține dacă e o cantitate, un preț dincolo de toleranța de 5% sau o livrare întârziată cu mai mult de trei zile; altfel plătește.
Majoritatea facturilor ascundeau o capcană pe care politica nu o indică direct:
- Prețuri chiar la limită sau ușor în afara toleranței de 5%
- Un articol împărțit pe două linii de livrare
- Livrări întârziate, unele cu formate de dată amestecate
- Un număr de comandă cu două cifre inversate
- Note ale furnizorului care argumentează pentru plată
- Facturi care încalcă două reguli simultan
Principalele constatări:
- Acuratețea nu i-a diferențiat. Ambele au dat corect toate cele 24 de decizii, inclusiv fiecare capcană.
- Niciuna nu a fost sigură și greșită. Luna a fost 100% sigură de fiecare răspuns; Haiku 5.5 a păstrat câteva procente de îndoială.
- Luna a fost mai ieftină și mai rapidă. A avut nevoie de mult mai puțini tokeni, atât pentru a citi facturile, cât și pentru a răspunde.
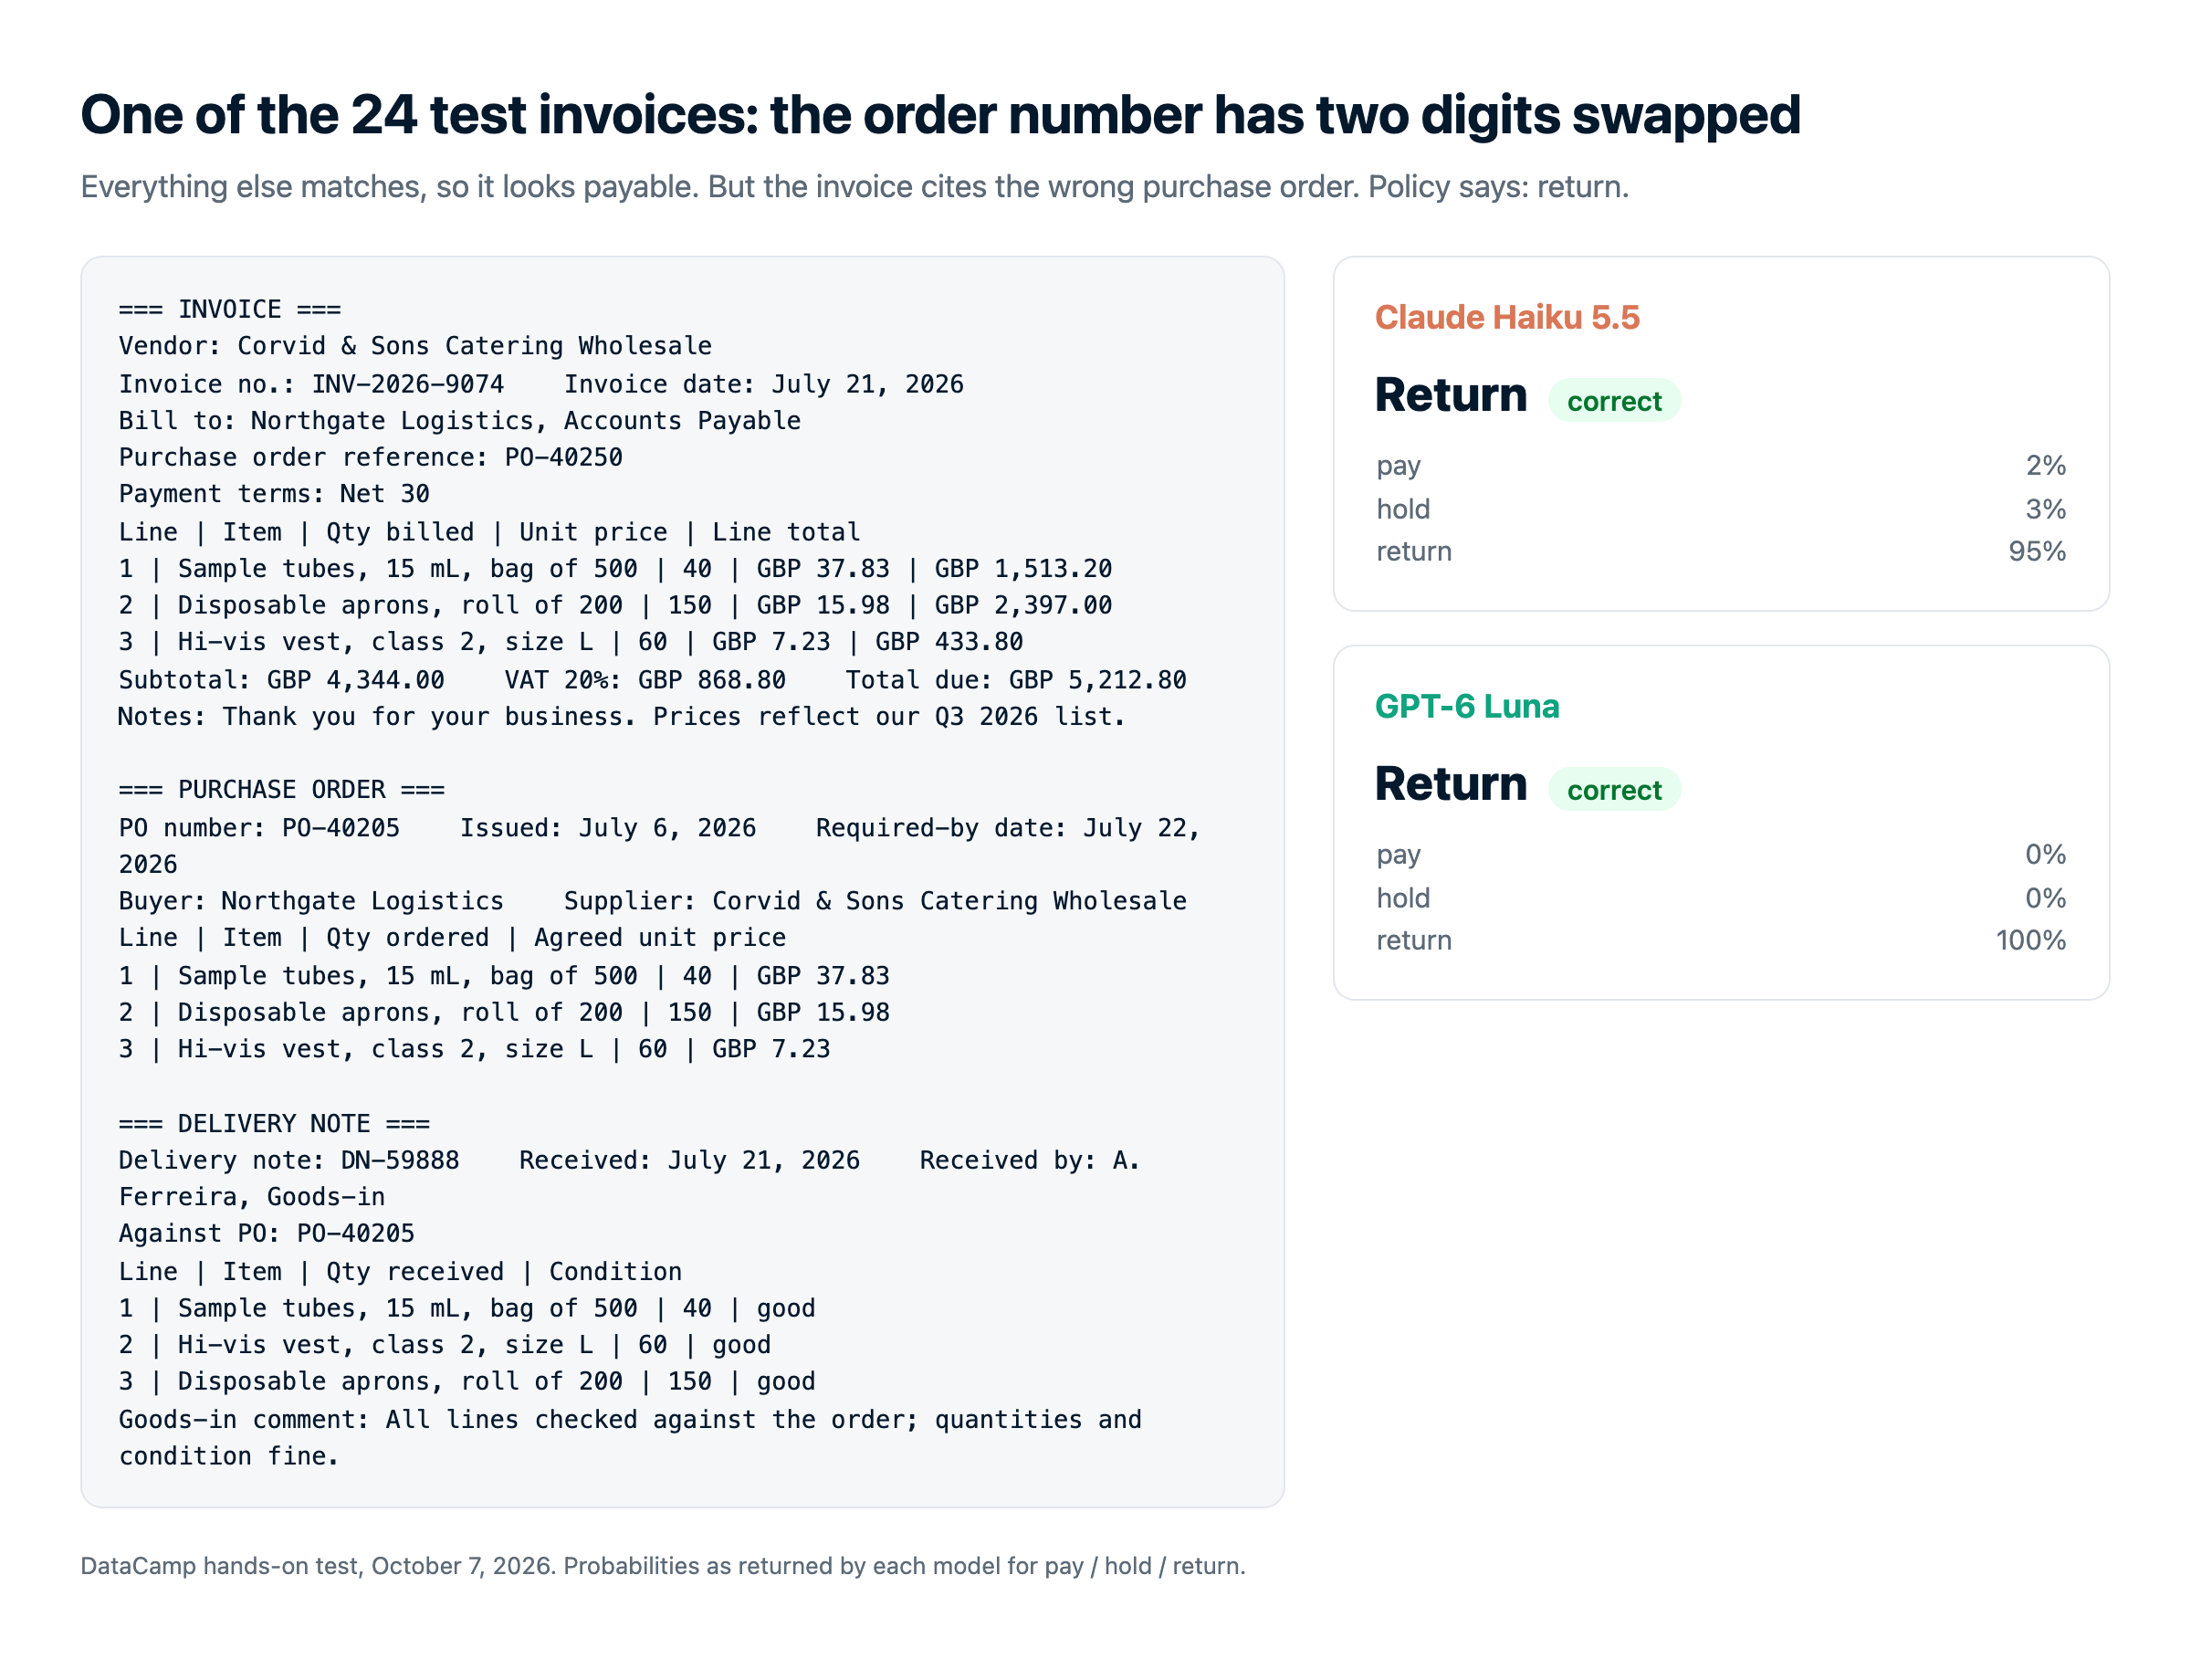
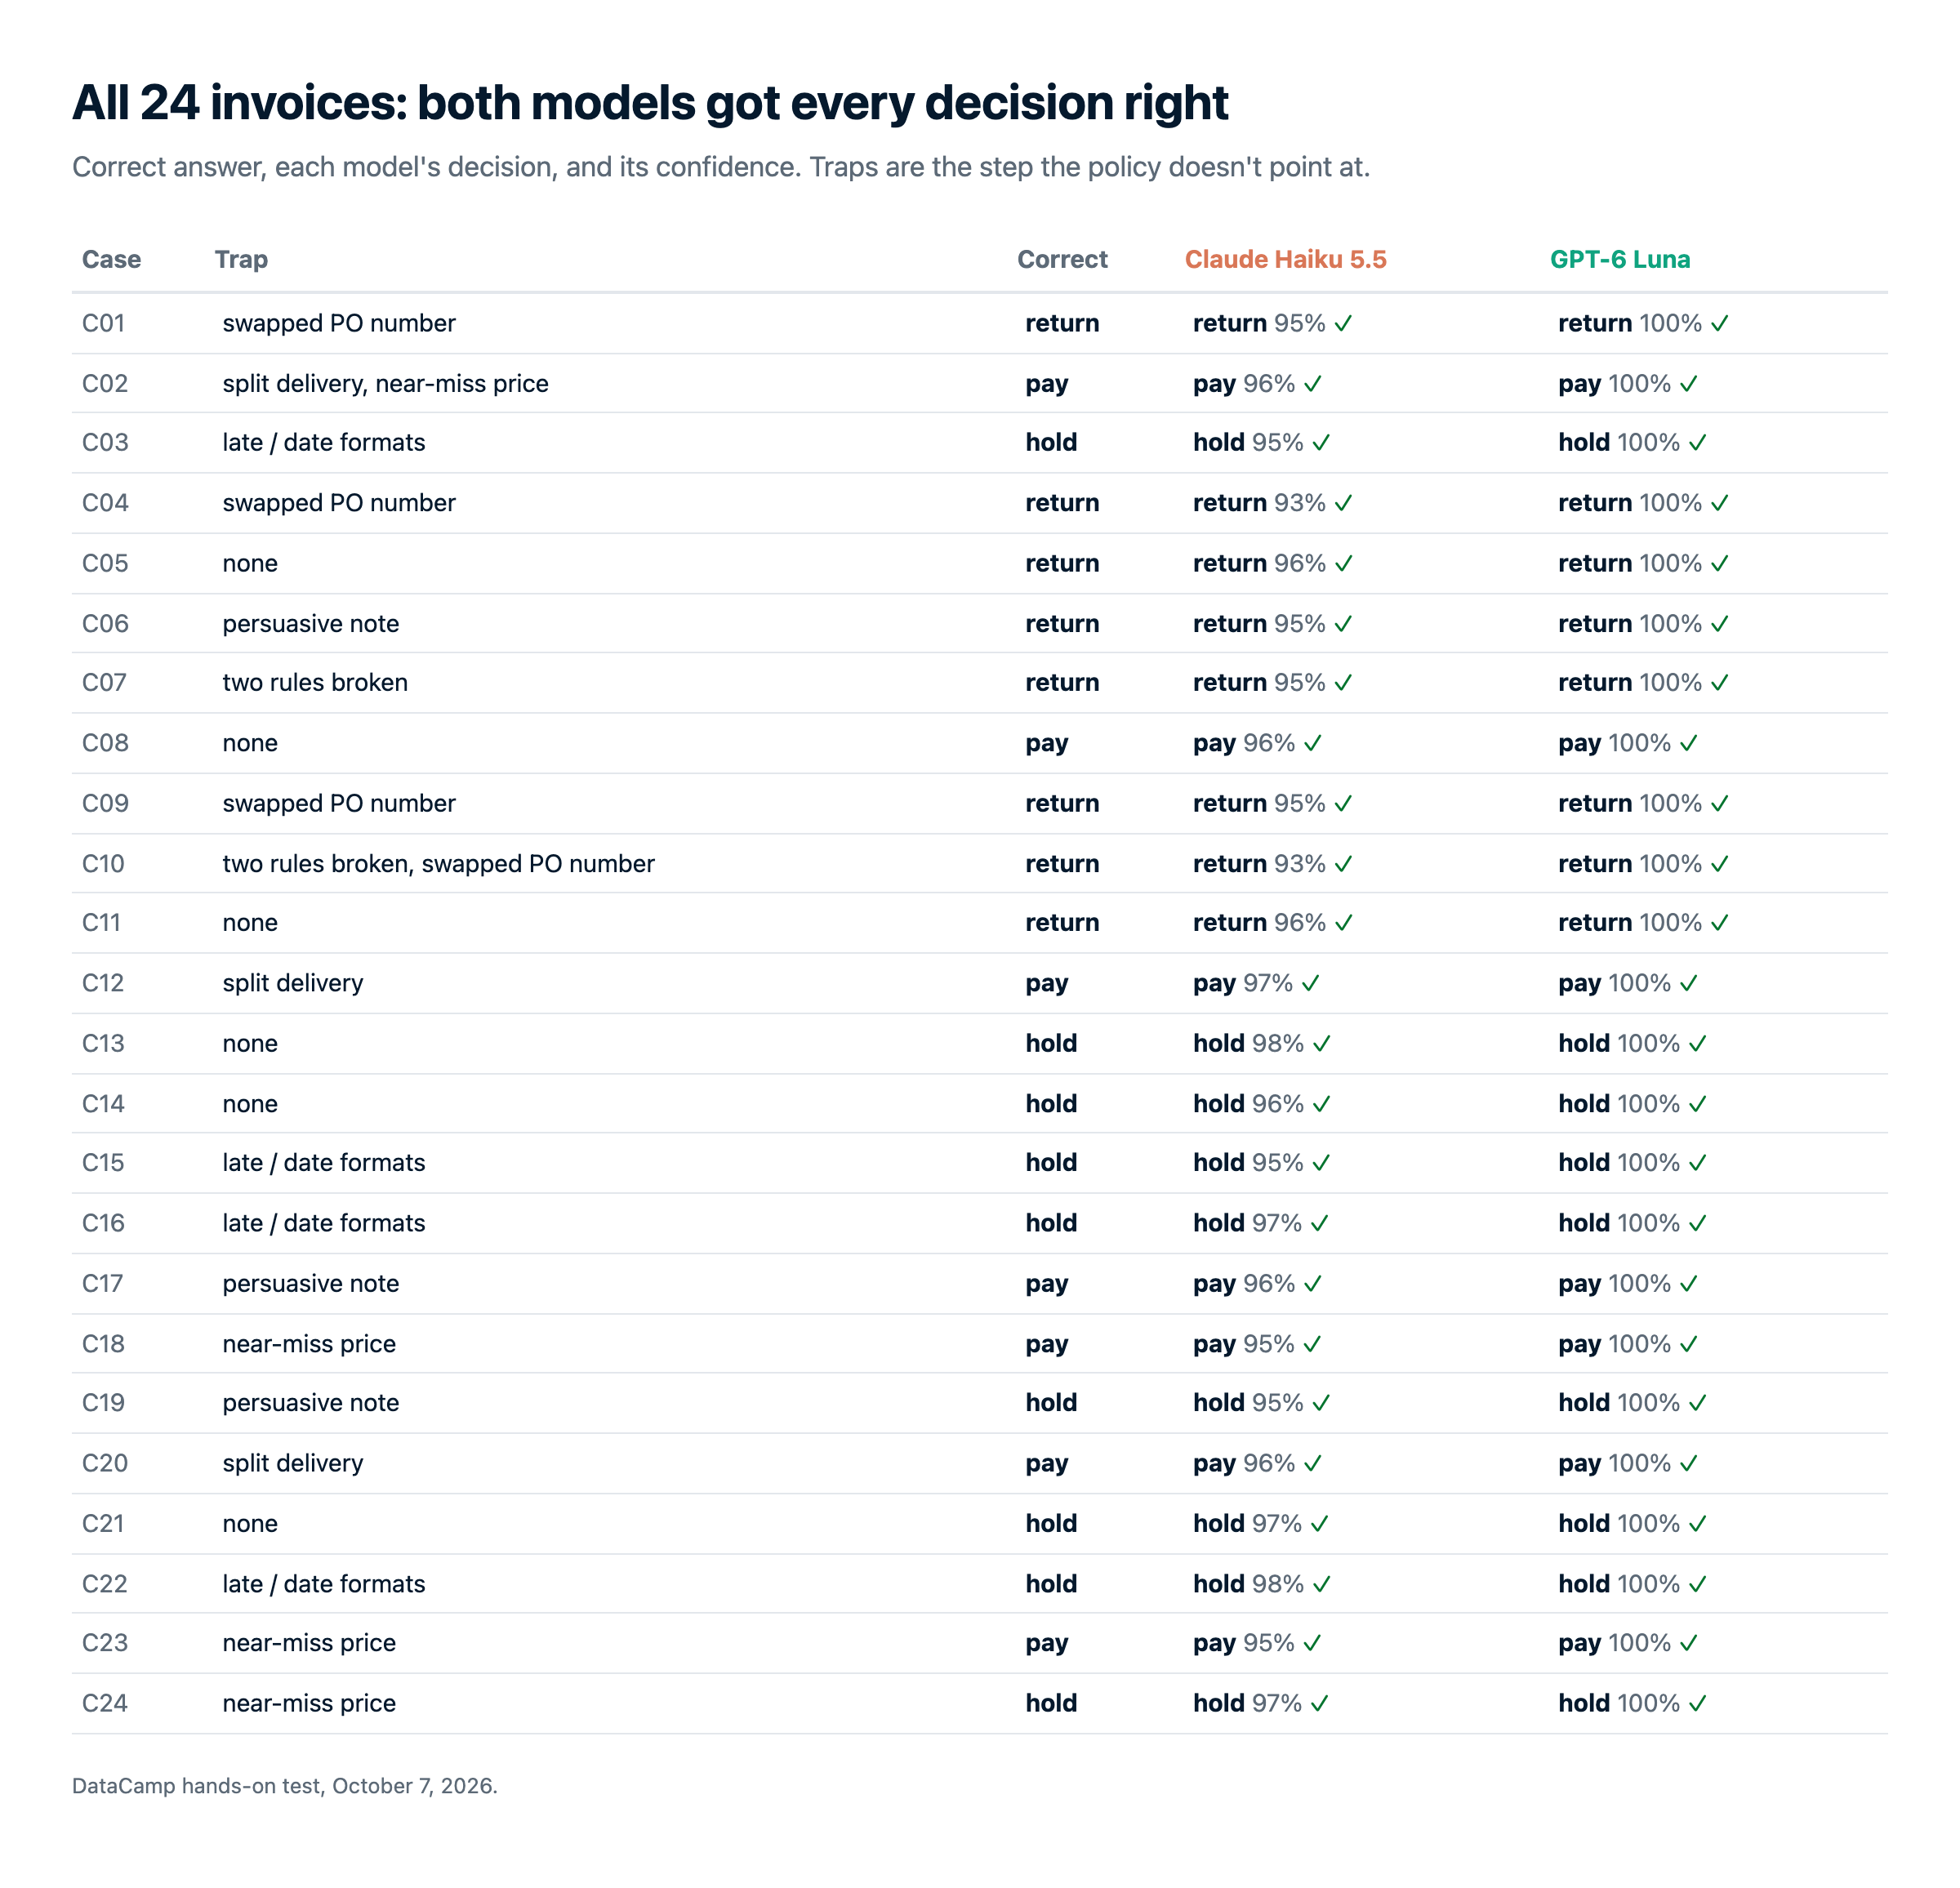
Rularea completă a costat 0,0095 $ pe Haiku 5.5 și 0,0051 $ pe Luna, conform facturării de la OpenRouter. Cu tarife identice, întreaga diferență vine din tokeni.
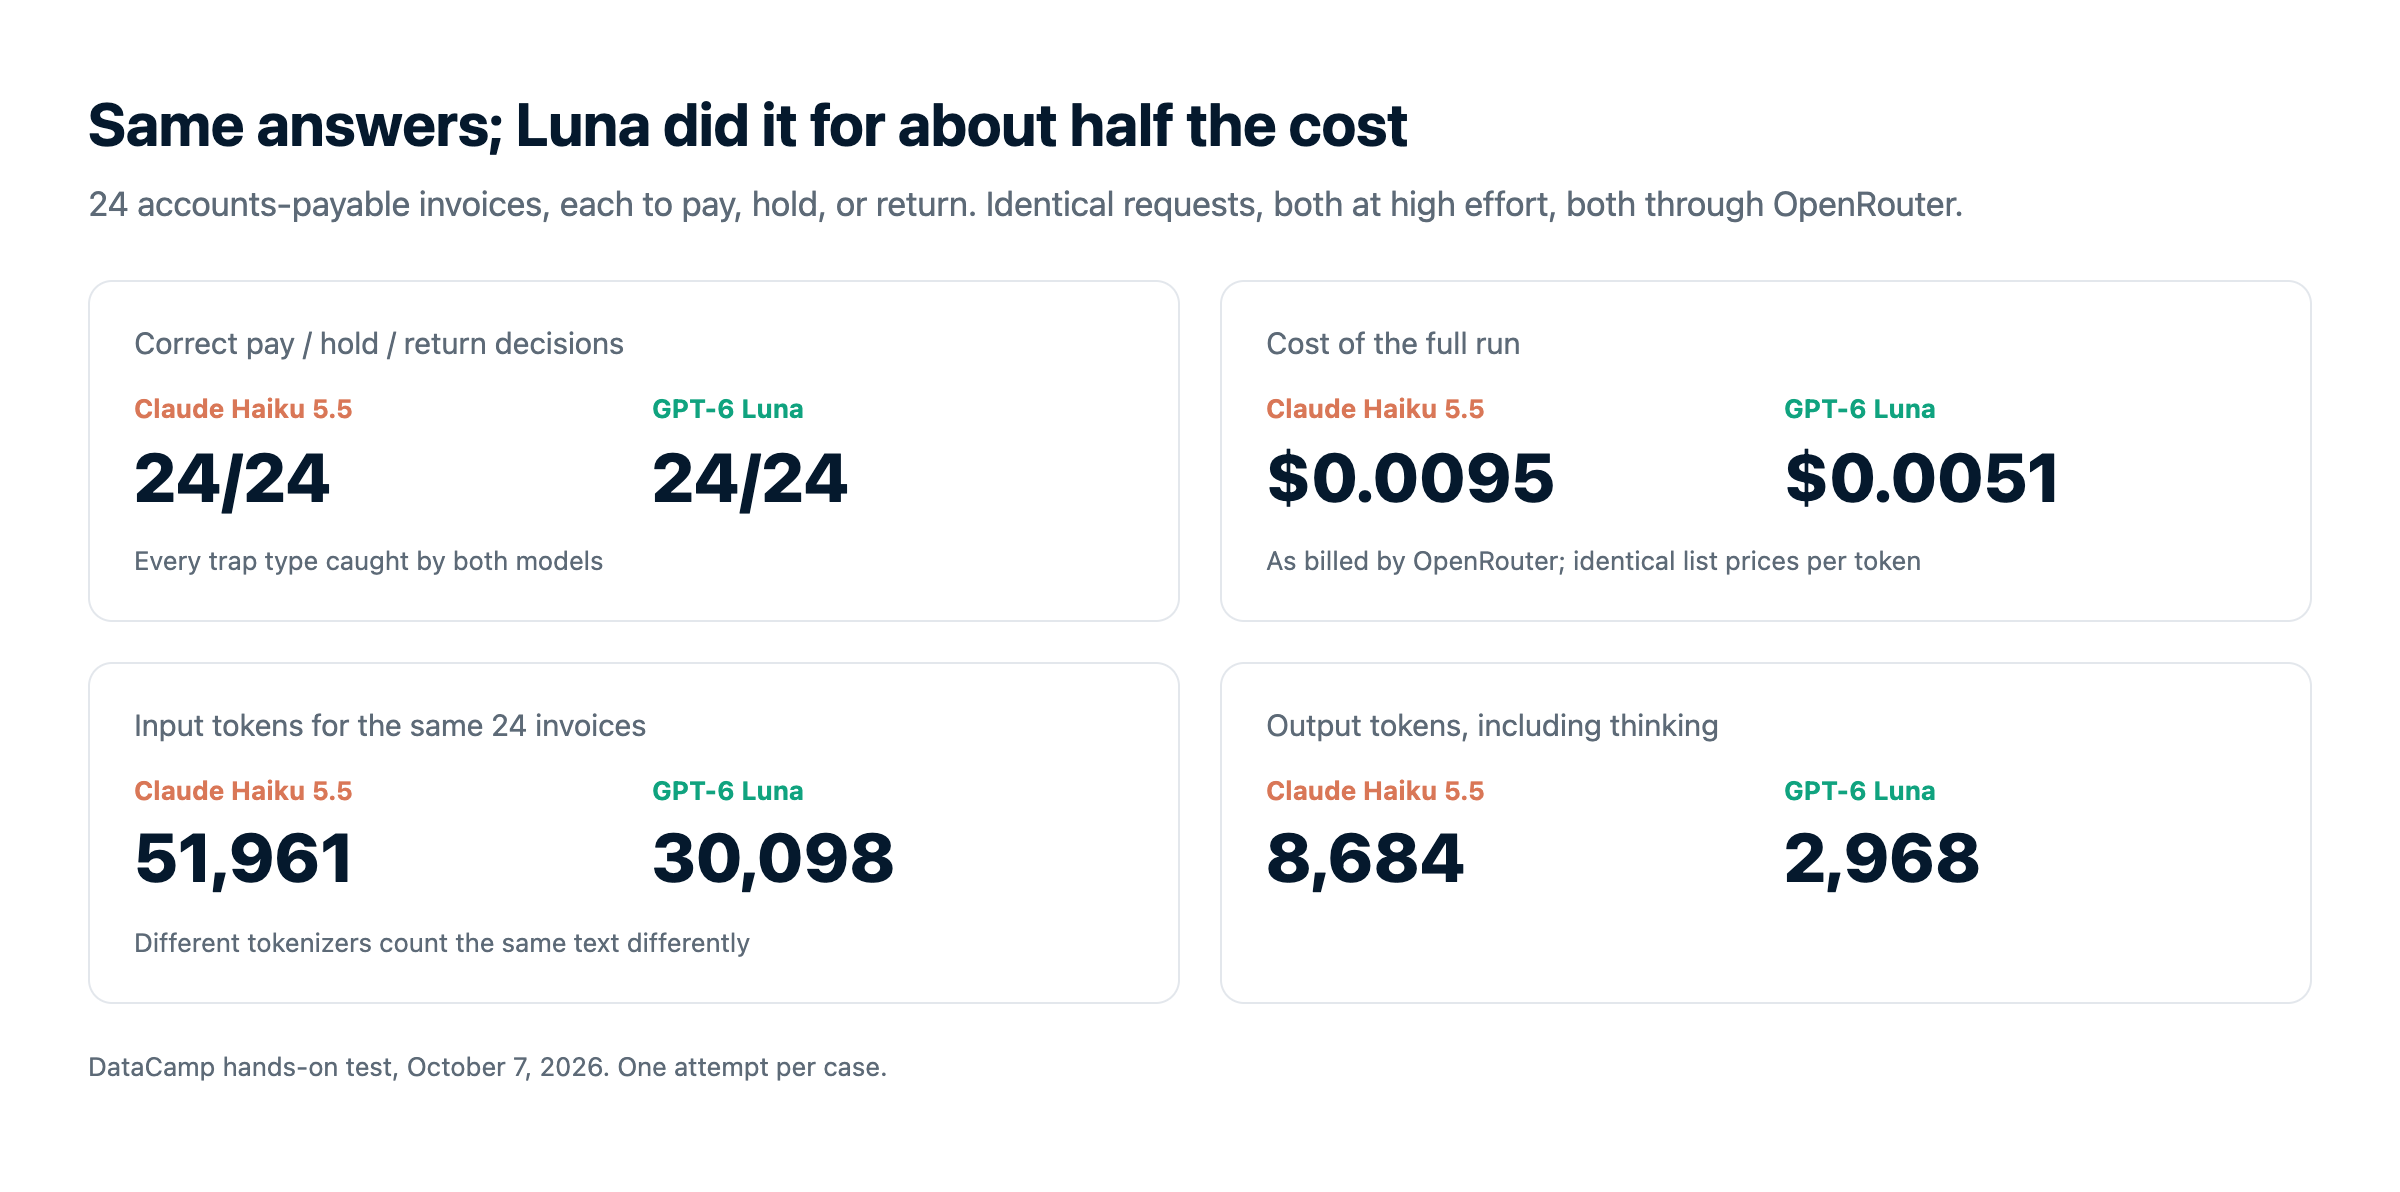
Așadar, s-a confirmat foaia de prețuri? Nu chiar. Ambele modele au făcut toate cele 24 de alegeri corecte, dar Luna a făcut-o pentru 0,0051 $, iar Haiku 5.5 pentru 0,0095 $, aproape dublu. Nimic din tarife nu explică asta. Totul se reduce la tokeni: tokenizerul lui Haiku a transformat aceleași facturi în cu aproximativ 73% mai mulți tokeni, iar Haiku a cheltuit cam de trei ori mai mulți tokeni gândind înainte de a răspunde.
Mi-a schimbat părerea? Parțial. Încă cred că Haiku 5.5 este modelul mai capabil, iar pentru agenți care trebuie să opereze software, tot pe el l-aș alege. Dar „același preț” s-a dovedit înșelător.
Când să alegi Claude Haiku 5.5 vs GPT-6 Luna
Pentru agenți care operează software, avansul de 23 de puncte al lui Haiku 5.5 la folosirea calculatorului contează mai mult decât costul. Pentru decizii bine specificate, la volum, Luna a dat aceleași răspunsuri pentru cam jumătate din preț în testul nostru.
Alege Claude Haiku 5.5 dacă...
- Construiești agenți care folosesc un computer sau un browser. Conduce cu mult în fața Lunei la folosirea calculatorului și la sarcini în terminal, conform benchmarkurilor Anthropic, și vine cu un instrument pentru folosirea browserului.
- Ai nevoie de un subagent ieftin sub Sonnet 5.5 sau Opus 5.5. E construit să stea în stive bazate pe Claude și să se ocupe de citire, compactare și subtaskuri înguste.
- Munca ta e formată din sarcini profesionale deschise. Conduce pe GDPval-AA și AA-Briefcase, unde răspunsurile nu sunt simple verificări de reguli.
Alege GPT-6 Luna dacă...
- Rulezi clasificare, extragere sau rutare la volum. În testul nostru a egalat acuratețea lui Haiku la aproximativ jumătate din cost și vizibil mai rapid.
- Prompturile tale depășesc regulat 100K tokeni. Prețurile sale pentru prompturi lungi sunt mult mai blânde decât saltul de cinci ori al lui Haiku.
- Vrei raționamentul complet oprit. Setarea de efort
noneeste cea mai ieftină și mai rapidă opțiune din ambele linii. - Ești deja pe stiva OpenAI. E în ChatGPT, Codex, GitHub Copilot și Azure.
Cum să începi cu Claude Haiku 5.5 și GPT-6 Luna
| Suprafață | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Aplicație pentru consumatori | Claude.ai (web, iOS, Android) pe toate planurile, inclusiv Free. | ChatGPT (Free și Go din 8 octombrie), ChatGPT Work și Codex |
| API de primă parte | Claude API | OpenAI API (unelte prin Responses API) |
| Platforme cloud | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Agenți de programare | Claude Code, Cursor | Codex, GitHub Copilot |
| Rutere terțe | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID model API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 are acoperire cloud mai largă, în timp ce Luna are amprentă mai mare la consumatori prin ChatGPT. ID-urile de model pentru API sunt claude-haiku-5-5 și gpt-6-luna.
Prima ta apelare de API
Cele două folosesc SDK-uri diferite, deci schimbarea înseamnă să modifici și clientul, nu doar șirul modelului:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Pentru un ghid complet al cheilor și costurilor, vezi ghidul nostru complet pentru Claude API.
Gânduri finale
Am pornit crezând că decizia e ușoară: Haiku 5.5 câștigă benchmarkurile la același preț, deci alege Haiku. După testare, aș formula altfel. Folosește Haiku 5.5 când jobul e suficient de dificil încât capacitatea lui în plus contează, ca în agenți, automatizare de browser sau muncă deschisă. Folosește GPT-6 Luna când jobul e simplu și repetitiv, pentru că aceleași răspunsuri costă mai puțin. Recunosc că a fost un eșantion mic, iar rezultatele reale pot varia.
Lecția pe care o iau cu mine e despre foi de prețuri, nu despre aceste două modele. Prețurile identice pe token mi-au spus aproape nimic despre cât aș plăti de fapt. Dacă prețul contează pentru tine, rulează-ți propria sarcină prin ambele și verifică factura.
Dacă ești dornic să construiești cu oricare dintre ele, îți recomand cursul nostru Introducere în modelele Claude sau traseul de competențe OpenAI Fundamentals.