Anthropic 近日发布了 Claude Haiku 5.5,这是对 OpenAI 的一次正面出击。Anthropic 公布的基准测试表中,在两者同时出现的每一项上,Haiku 5.5 都领先于 GPT-6 Luna。而且 Anthropic 将 Haiku 5.5 的定价与 OpenAI 的 Luna 完全对齐:每百万输入词元 $0.10、每百万输出词元 $0.50。纸面上看,比较很简单:Haiku 5.5 更好,价格还一样。
这是直观结论。但“相同的每词元价格”并不等于“相同的每任务价格”。不同模型在同一任务上读写的词元数量不同。所以我想做个验证:如果我让两款模型干同样的活,它们真的花费一样吗?如果不一样,我会改变看法吗?
要点速览
- Claude Haiku 5.5 作为智能体更有能力,在 Anthropic 的基准中,电脑操作与终端任务上优势明显。
- 纸面上,Haiku 5.5 获胜:同价更高分。但在我的成本测试中(剧透),Luna 以大约一半的费用给出了同样的答案。
- 结论:相同的每词元价格,可能被分词器、推理长度和长提示加价掩盖真实成本差距。
什么是 Claude Haiku 5.5?
Claude Haiku 5.5 是 Anthropic 的最小、最快模型,于 2026 年 10 月 7 日发布,也是 Claude 5.5 家族的最后一员。
Anthropic 将其定位于高吞吐、低延迟的工作,如分类、抽取、路由,以及在 Sonnet 5.5 或 Opus 5.5 之下作为子智能体运行,并把自适应思考与电脑使用带到了价格阶梯的底端。
我们的Claude Haiku 5.5 指南涵盖了发布要点以及与 Haiku 4.5 的上手对比。
什么是 GPT-6 Luna?
GPT-6 Luna 是 OpenAI 最高效的模型,于 2026 年 9 月 22 日发布,是 GPT-6 家族中体量最小的一档,位于 Astra 与 Sol 之下。
OpenAI 将其定位于聚焦的高吞吐任务,并从 10 月 8 日起将其作为 ChatGPT 免费版与 Go 用户背后的模型逐步推送。
我们的GPT-6 Sol 与 Luna 指南涵盖了发布信息。
Claude Haiku 5.5 对比 GPT-6 Luna:正面对决
Anthropic 的基准测试显示,在两者共同参与的每一项上,Haiku 5.5 均领先于 Luna,且在智能体任务上差距最大。对于简单决策的成本与速度,我们的自测结果则指向相反方向。
| 特性 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1(电脑操作) | 72.4% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| GDPval-AA v2.1(Elo) | 1620 | 1437 |
| AA-Briefcase v1.1(Elo) | 1578 | 1336 |
| FrontierCode 1.1(主榜) | 46.4% | 42.4% |
| Chartography(无工具) | 46.4% | 29.1% |
| DeepSWE v1.1 | 未公布 | 66.6%(最大努力) |
| 上下文窗/最大输出 | 1M / 128K | 1.05M / 128K |
| 知识截止 | 2026 年 6 月 | 2026 年 5 月 |
| 努力等级 | low 至 max(默认 medium) | none 至 max(默认 medium) |
除 DeepSWE 外的各行均来自 Anthropic 的发布表,因此可视为 Anthropic 的立场;OpenAI 尚未发布与 Haiku 5.5 的对比。这很正常,因为 Luna 更早发布。
智能体工作与电脑操作
这是 Haiku 5.5 领先最远的领域。在 OSWorld 2.1 上(测试模型是否能通过操作真实桌面完成任务),Haiku 5.5 得分 72.4%,而 Luna 为 48.9%,23.5 个百分点的差距改变了小模型的可用场景。Terminal-Bench 4.0 讲述了相同的故事,Haiku 完成的命令行任务超过 Luna 的两倍。
Anthropic 也随 Haiku 5.5 一同发布了浏览器使用工具。
对于智能体工作,Haiku 5.5 是明确之选。
知识型工作与文档
Haiku 5.5 在专业任务评测上也领先:在 GDPval-AA 高约 180 Elo,在 AA-Briefcase 高约 240。图表解读(Chartography)上有 17 个百分点差距。
不过,在更简单、规则明确的文档决策上,我们的上手测试没有发现准确率差异,因此差距大概率主要体现在开放性任务上。
编程
编程方面更接近。在 FrontierCode 1.1(评估改动是否可合并)上,Haiku 5.5 领先 4 个百分点。OpenAI 报告 Luna 在 DeepSWE v1.1 上于最大努力时为 66.6%,与 Claude Opus 5 在中等努力时相当。两款小模型都不是严肃编程智能体的首选。这类任务更适合Sonnet 5.5 与 GPT-6.1 Sol。
努力控制与 API 约束
两款模型默认都是中等努力,但 Luna 可以更低:其 none 设置完全跳过推理,以获得最便宜、最快的答案。Haiku 5.5 的最低努力是 low,不过您仍可在 high 或更低时关闭思考。
定价:您实际会付多少钱
Haiku 5.5 与 Luna 标准费率相同,因此真实成本差异来自长提示、分词器,以及各自的输出量。
词元费率对照
| 费率(每百万词元) | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 输入 | $0.10(提示至多 100K) | $0.10(提示至多 272K) |
| 输出 | $0.50(提示至多 100K) | $0.50(提示至多 272K) |
| 缓存读取 | $0.01 | $0.01 |
| 缓存写入 | $0.125(5 分钟) | $0.125 |
| 长提示定价 | 超过 100K 词元:输入 $0.50,输出 $2.50 | 超过 272K 词元:输入与缓存 2 倍,输出 1.5 倍 |
| 批量折扣 | 50% | 50% |
在 100K 词元以下,两者价目表逐项一致。超过该阈值后,Haiku 的价格跃升至 5 倍,而 Luna 直到 272K 词元才上涨,且涨幅远小。两者都将推理计作输出。
按标价,只有当提示变长时二者才会分化。下文的分词器章节解释了为何这还不是全部。
真实工作负载要花多少钱
| 工作负载 | Claude Haiku 5.5 | GPT-6 Luna | 差异 |
|---|---|---|---|
| 均衡助理:1M 入 / 250K 出 | $0.23 | $0.23 | 无 |
| 检索,单次请求低于 100K:10M 入 / 1M 出 | $1.50 | $1.50 | 无 |
| 检索,单次请求超过 272K:10M 入 / 1M 出 | $7.50 | $2.75 | $4.75(Luna 便宜 63%) |
每项总价为(体量 ÷ 1M)× 费率,按输入与输出分别计算并相加,均为标准费率。
- 均衡助理与短检索:价目表上平分秋色。
- 长检索:Luna 约为三分之一成本。若在 100K 至 272K 之间,差距更大:Haiku 已按更高费率计价,而 Luna 仍按标准价;同样 10M 入 / 1M 出,Haiku 为 $7.50,Luna 为 $1.50。
为何同一任务成本不同
两者使用不同分词器,我们做了直接测量:在我们的上手测试中,同样 24 张发票在 Haiku 5.5 上计为 51,961 个输入词元,而在 Luna 上为 30,098 个,Haiku 约为 Luna 的 1.7 倍。按此应用到“短检索”一行,Haiku 的输入成本从 $1.00 升至约 $1.73,因此上文“同价”情形在实际中更偏向 Luna。
输出也会叠加影响。在同一测试中,Haiku 5.5 写出的输出词元约为 Luna 的两倍,多数是推理文本,这也是为何在费率相同的情况下,它的运行成本几乎高出一倍。虽然这只是一个任务、一个努力设置,但两个测量的方向一致。
Claude Haiku 5.5 与 GPT-6 Luna 的实测表现
上述基准表明 Haiku 5.5 是更强的模型,而价目表显示两者成本相同。
我不想对第二点盲从,所以围绕一个问题设计了测试:如果两款模型把同一工作做得一样好,各自实际运行要花多少钱?
我选择了一个两者都应当准确的工作,这样任何差异都会体现在账单上,而非答案上。
任务:充当应付账款。每个模型收到 24 份供应商发票,每份都附带采购订单与送货单,需要在固定政策下决定支付、暂扣或退回。若有不在订单上的项目或订单号错误则退回;若数量、价格超出 5% 容差,或交付延迟超过 3 天则暂扣;否则支付。
大多数发票隐藏了政策未明示的陷阱:
- 价格刚好在 5% 容差内或外
- 一个项目拆成两条送货明细
- 延迟交付,且日期格式混杂
- 订单号两位数字对调
- 供应商备注为付款辩解
- 同一发票同时违反两条规则
主要发现:
- 准确率未拉开差距。两者 24/24 全对,包括所有陷阱。
- 都没有自信地答错。Luna 对每个答案的置信度都是 100%;Haiku 5.5 则保留了几个百分点的不确定。
- Luna 更便宜也更快。它读取发票与作答所需的词元都显著更少。
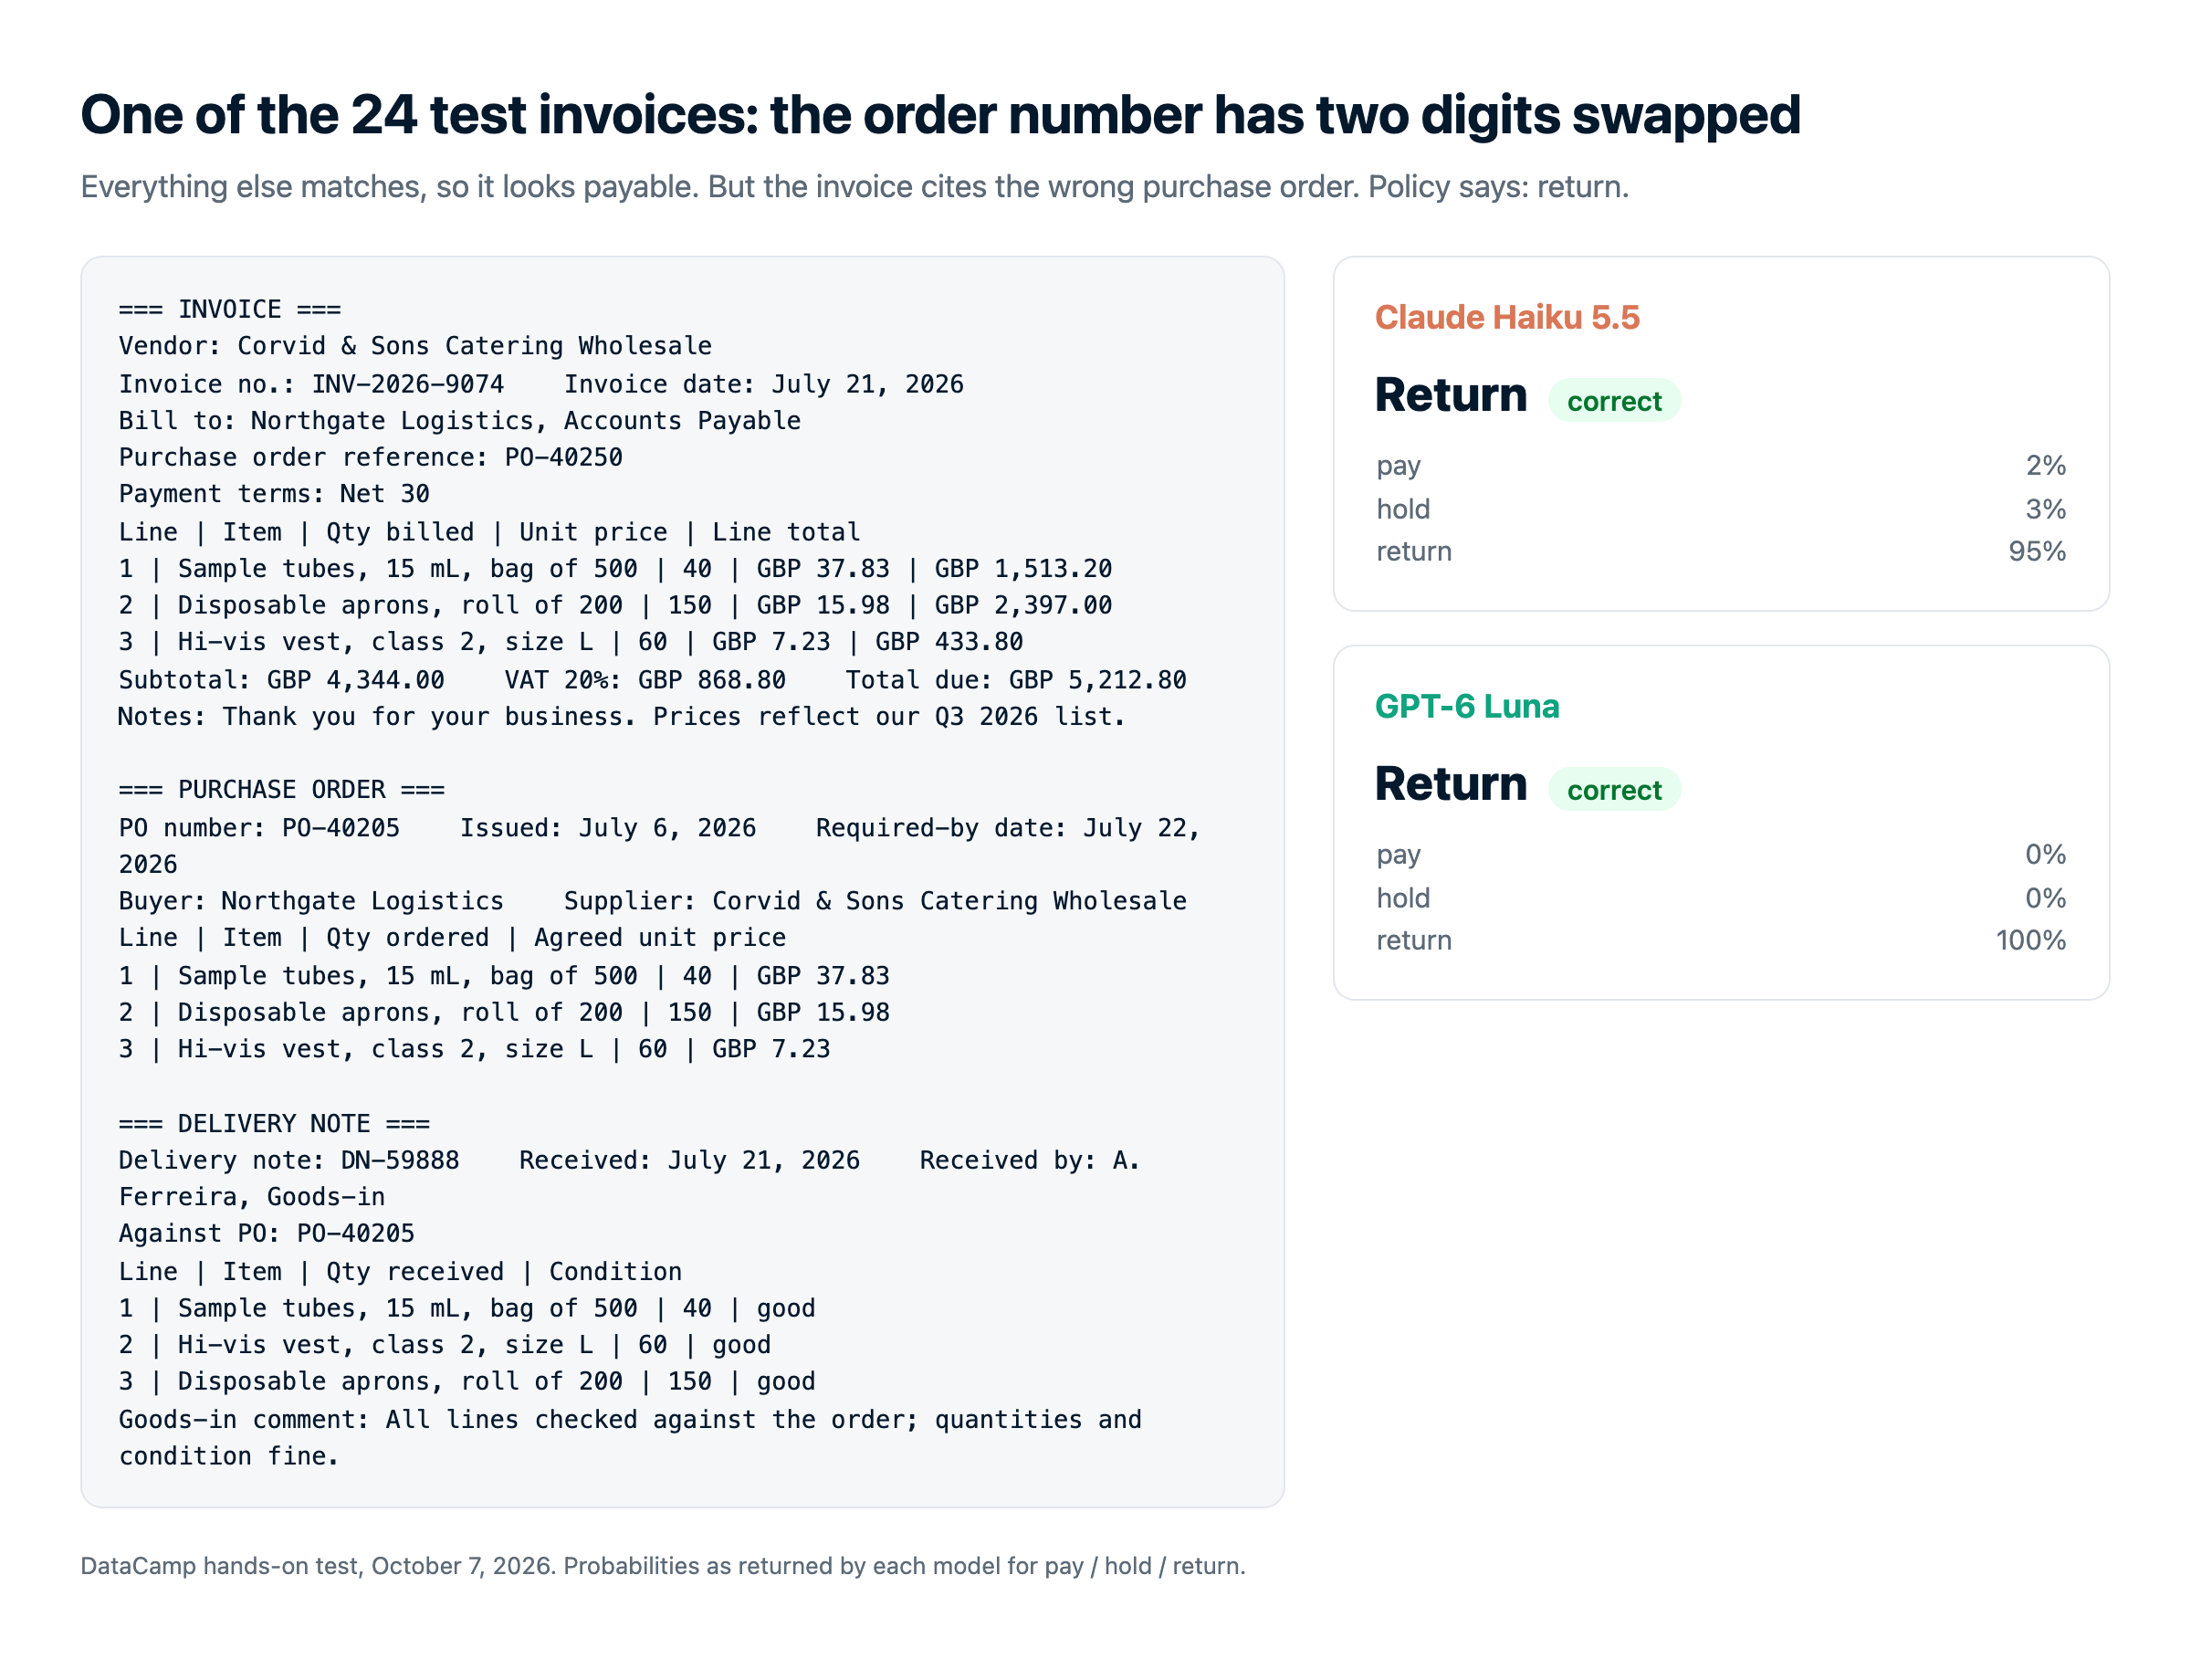
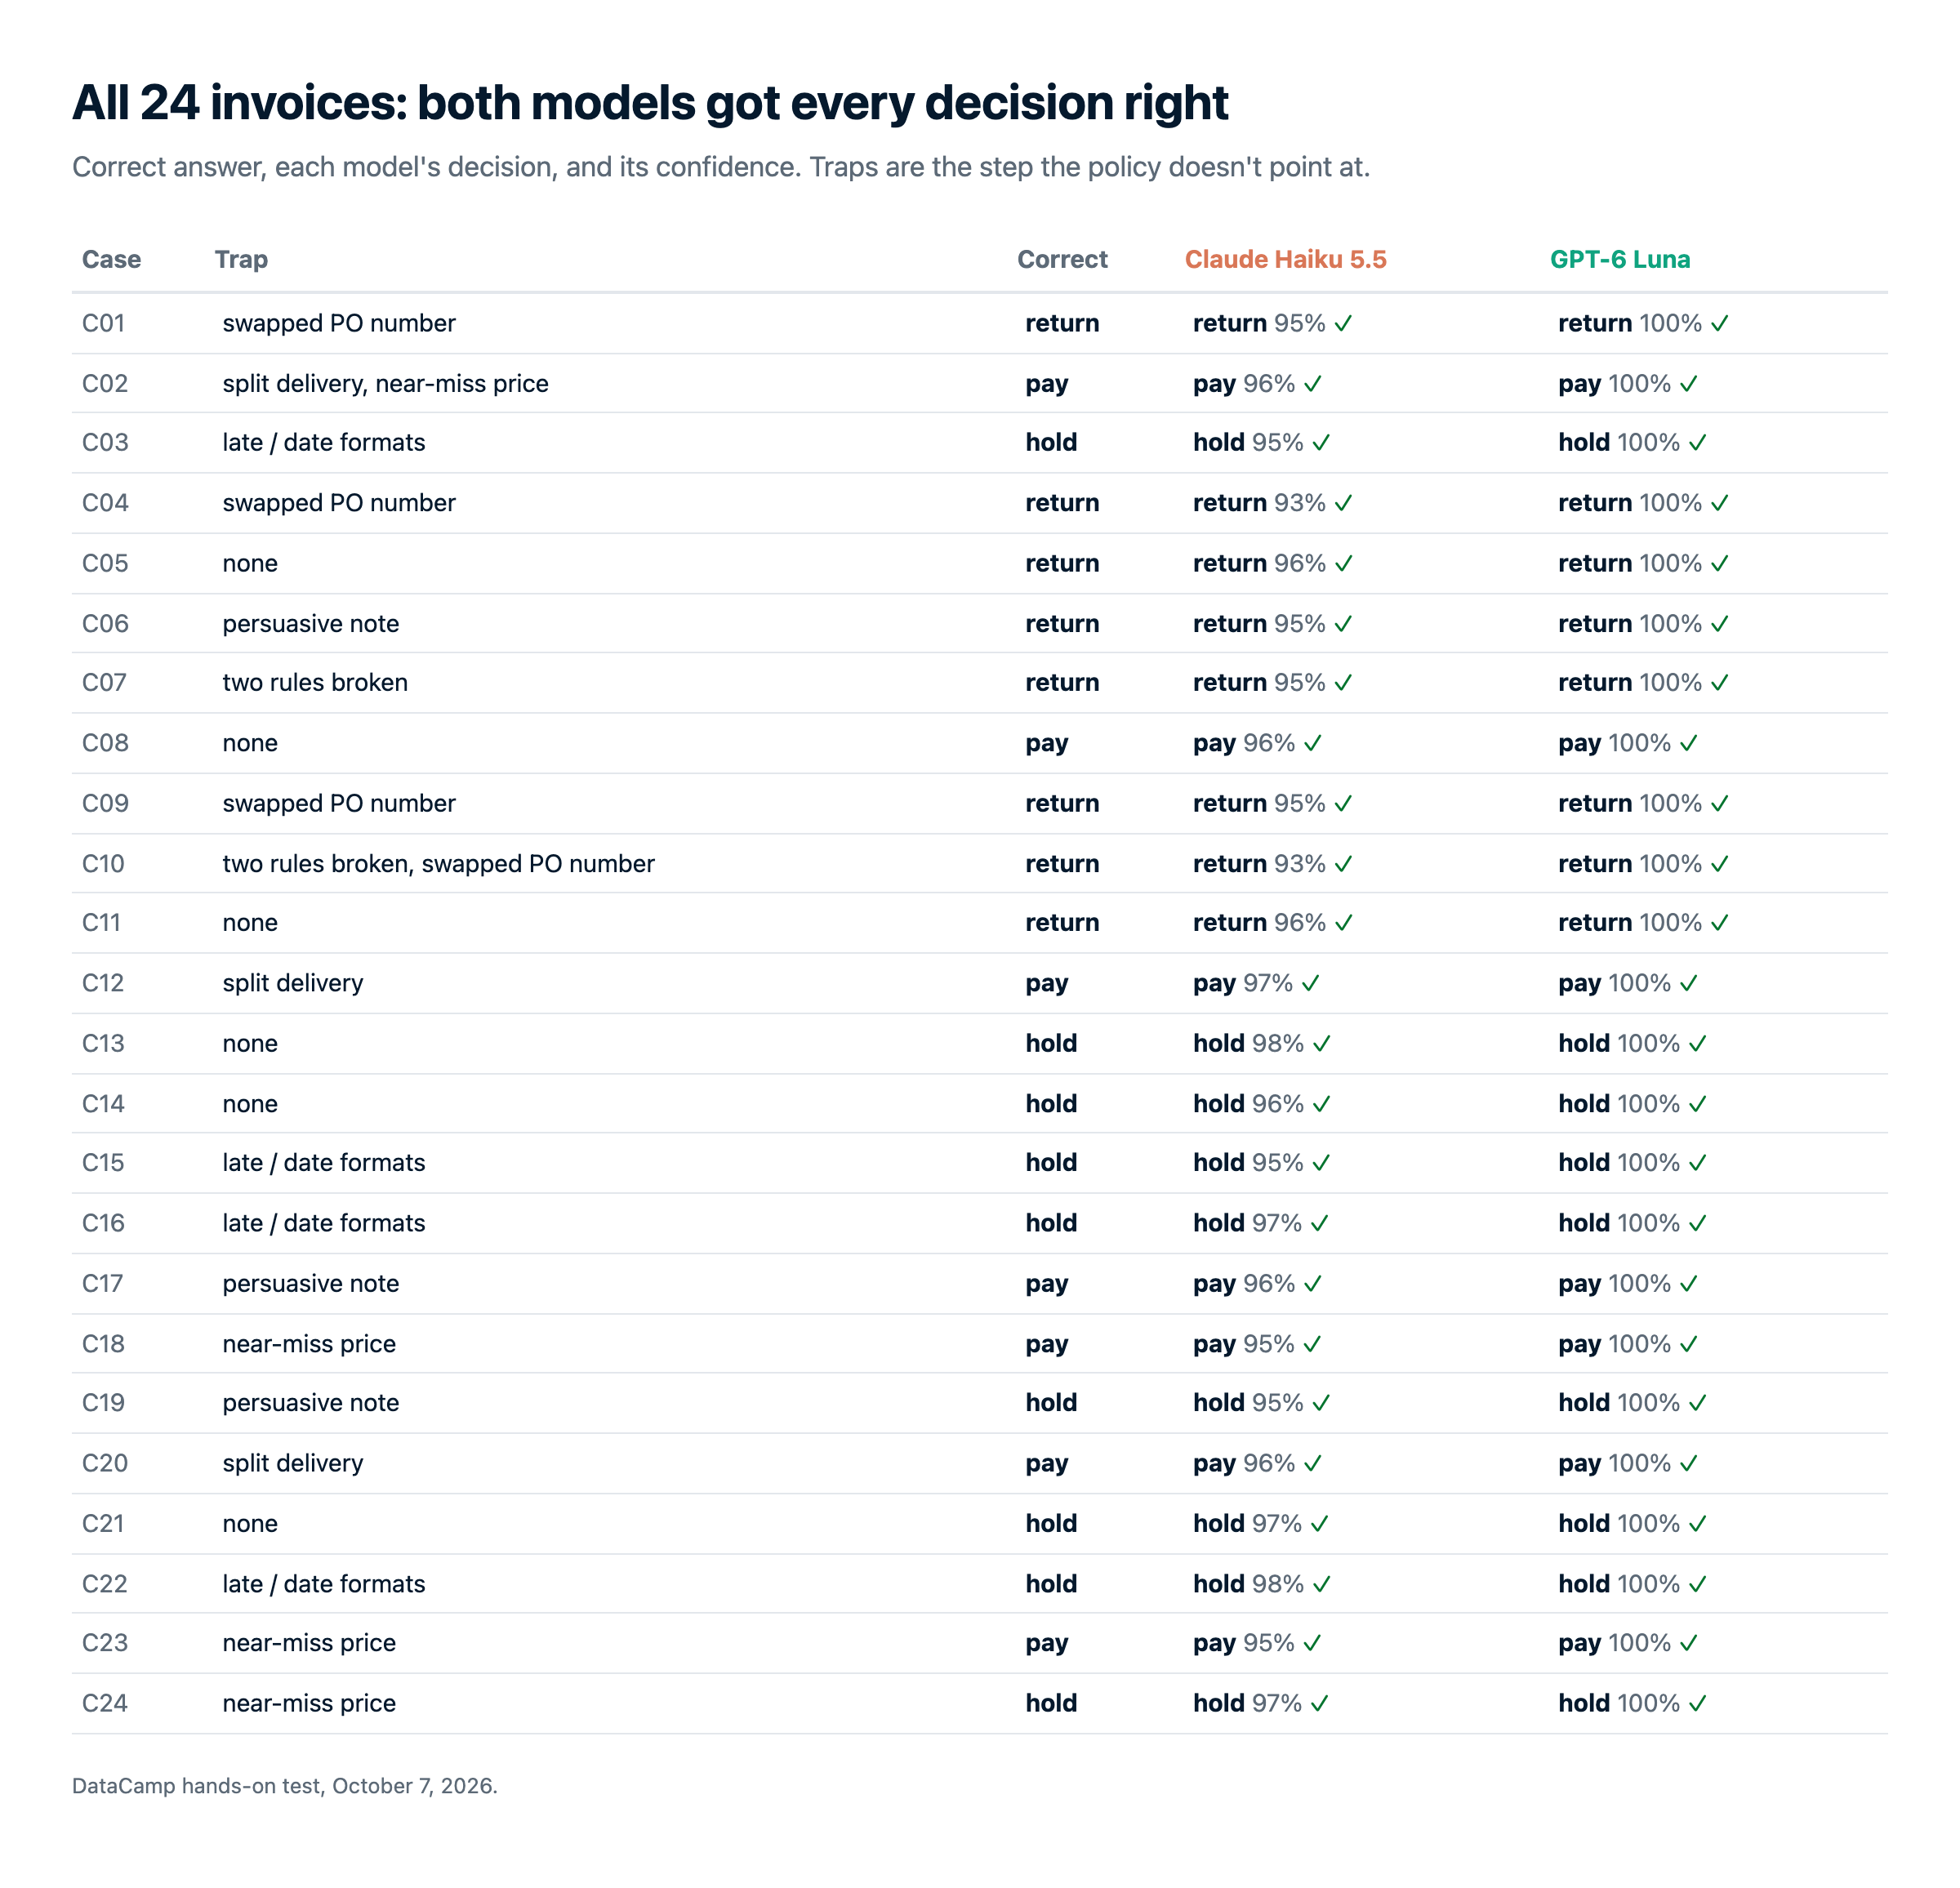
整次运行在 OpenRouter 上计费:Haiku 5.5 为 $0.0095,Luna 为 $0.0051。在费率相同的前提下,差距完全来自词元。
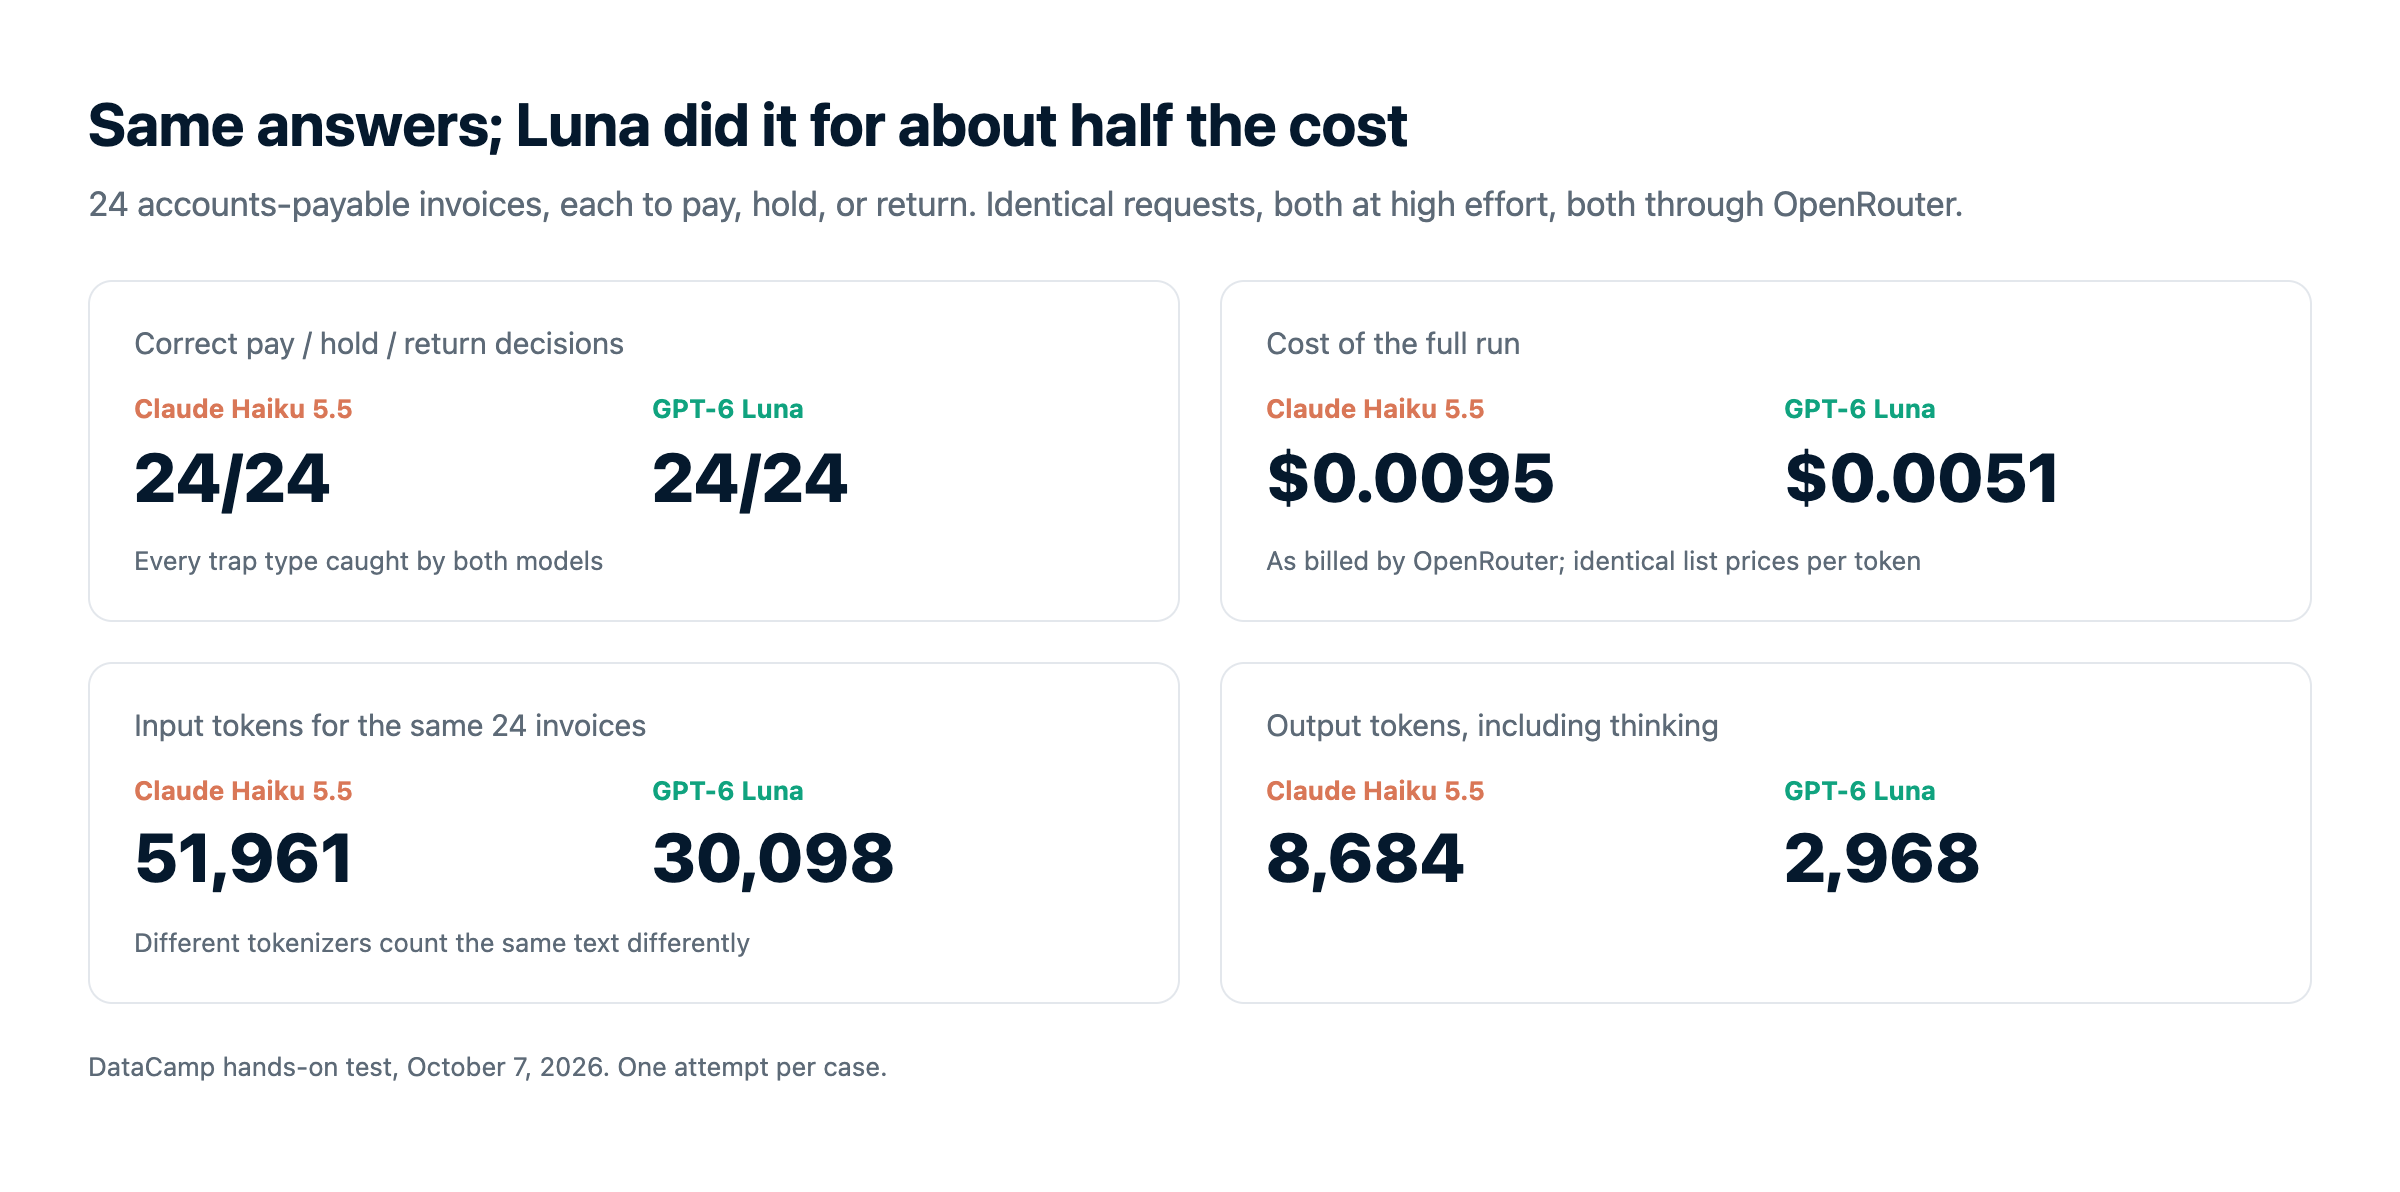
那么价目表是否站得住?不完全。两款模型都做出了 24 个正确判断,但 Luna 花费 $0.0051,而 Haiku 5.5 为 $0.0095,接近翻倍。费率并不能解释这一点,关键在于词元:Haiku 的分词器将相同发票切分为约多 73% 的词元,且 Haiku 在作答前用于思考的词元约为 Luna 的三倍。
这改变了我的看法吗?部分改变。我仍认为 Haiku 5.5 更有能力,若智能体需要操作软件,我依然会选它。但“同价”被证明具有误导性。
何时选择 Claude Haiku 5.5,何时选择 GPT-6 Luna
对于需要操作软件的智能体,Haiku 5.5 在电脑使用上高出 23 个百分点的重要性胜过成本。对于高量、规则明确的决策,在我们的测试中,Luna 以约一半的价格给出了相同答案。
在以下情况下选择 Claude Haiku 5.5:
- 您在构建使用电脑或浏览器的智能体。在 Anthropic 的基准中,它在电脑操作与终端任务上大幅领先于 Luna,并自带浏览器使用工具。
- 您需要在 Sonnet 5.5 或 Opus 5.5 之下的廉价子智能体。它专为嵌入基于 Claude 的栈而设计,处理阅读、压缩与窄任务。
- 您的工作是开放性的专业任务。在 GDPval-AA 与 AA-Briefcase 上领先,而这些任务的答案并非简单规则核对。
在以下情况下选择 GPT-6 Luna:
- 您以规模化方式运行分类、抽取或路由。在我们的测试中,它以约一半成本、且明显更快地匹配了 Haiku 的准确度。
- 您的提示经常超过 100K 词元。其长提示定价远比 Haiku 的 5 倍跳涨温和。
- 您希望完全关闭推理。其
none努力设置是两家阵容中最便宜、最快的选项。 - 您已使用 OpenAI 的栈。它已在 ChatGPT、Codex、GitHub Copilot 与 Azure 中。
如何开始使用 Claude Haiku 5.5 与 GPT-6 Luna
| 使用入口 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 消费级应用 | Claude.ai(网页、iOS、Android),覆盖各档位,包括免费版。 | ChatGPT(自 10 月 8 日起的免费版与 Go)、ChatGPT Work 与 Codex |
| 第一方 API | Claude API | OpenAI API(通过 Responses API 使用工具) |
| 云平台 | Amazon Bedrock、Google Cloud、Microsoft Foundry | Azure AI Foundry |
| 编程智能体 | Claude Code、Cursor | Codex、GitHub Copilot |
| 第三方路由 | OpenRouter(anthropic/claude-haiku-5.5) |
OpenRouter(openai/gpt-6-luna) |
| API 模型 ID | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 的云覆盖更广,而 Luna 借助 ChatGPT 拥有更大的消费级触达面。API 模型 ID 分别为 claude-haiku-5-5 与 gpt-6-luna。
发起您的首个 API 调用
两者使用不同的 SDK,因此切换不仅要改模型字符串,还要更换客户端:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)有关密钥与成本的完整讲解,请参见我们的Claude API 完整指南。
结语
起初我以为这是个简单的选择:同价而基准更强,那就选 Haiku。测试之后,我会换个说法:当任务足够难、需要它的额外能力时,用 Haiku 5.5,比如智能体、浏览器自动化或开放性工作;当任务简单且重复时,用 GPT-6 Luna,因为相同答案更省钱。我也承认这只是小样本,真实效果会有差异。
对我而言,收获更多是关于价目表,而非这两款模型。相同的每词元价格几乎没告诉我实际要付多少钱。如果您在意成本,请把自己的任务分别跑一遍,然后看账单。
如果您想动手构建,推荐我们的Introduction to Claude Models课程或OpenAI Fundamentals技能路径。