Anthropic ने हाल ही में Claude Haiku 5.5 लॉन्च किया, और यह OpenAI के लिए सीधी चुनौती थी। Anthropic की साझा की गई बेंचमार्क तालिका में जहाँ-जहाँ दोनों दिखते हैं, हर पंक्ति पर Haiku 5.5 GPT-6 Luna से आगे है। और Anthropic ने Haiku 5.5 की कीमत बिल्कुल Luna के समान रखी: प्रति 10 लाख इनपुट टोकन $0.10 और प्रति 10 लाख आउटपुट टोकन $0.50। कागज पर तुलना आसान है। Haiku 5.5 GPT-6 Luna से बेहतर है, और कीमत भी वही है।
यही पहली नज़र का निष्कर्ष है। लेकिन "प्रति टोकन वही कीमत" का मतलब "प्रति काम वही कीमत" नहीं होता। एक ही काम के लिए मॉडल अलग-अलग संख्या में टोकन पढ़ते और लिखते हैं। तो मैंने सोचा, क्यों न जांच लें: अगर मैं दोनों मॉडलों को एक-सा काम दूँ, तो क्या वाकई उनकी लागत बराबर आती है? और अगर नहीं, तो क्या मेरी राय बदलेगी?
TL;DR
- Anthropic के बेंचमार्क में कंप्यूटर उपयोग और टर्मिनल कार्यों पर बड़े अंतर से आगे रहकर Claude Haiku 5.5 अधिक सक्षम एजेंट है।
- कागज पर Haiku 5.5 जीतता है: समान कीमत पर बेहतर बेंचमार्क। लेकिन मेरे लागत परीक्षण में (स्पॉइलर), Luna ने लगभग आधी रकम में वही जवाब दिए।
- सीख: समान प्रति-टोकन कीमतें, टोकनाइज़र, तर्क-लंबाई और लंबे प्रॉम्प्ट के अधिभार से असली लागत के फर्क छिपा सकती हैं।
Claude Haiku 5.5 क्या है?
Claude Haiku 5.5, Anthropic का सबसे छोटा और सबसे तेज़ मॉडल है, जिसे 7 अक्टूबर, 2026 को Claude 5.5 परिवार के अंतिम सदस्य के रूप में जारी किया गया।
Anthropic इसे उच्च-वॉल्यूम, लेटेंसी-संवेदी काम—जैसे वर्गीकरण, निष्कर्षण, रूटिंग, और Sonnet 5.5 या Opus 5.5 के अंतर्गत सबएजेंट के रूप में चलाने—के लिए सुझाता है, और यह कीमत की सीढ़ी के निचले पायदान पर अनुकूली सोच और कंप्यूटर उपयोग लेकर आता है।
हमारा Claude Haiku 5.5 गाइड लॉन्च और Haiku 4.5 के मुकाबले हमारे हैंड्स-ऑन टेस्ट को कवर करता है।
GPT-6 Luna क्या है?
GPT-6 Luna, OpenAI का सबसे कुशल मॉडल है, जिसे 22 सितंबर, 2026 को GPT-6 परिवार के सबसे छोटे स्तर के रूप में, Astra और Sol के नीचे, जारी किया गया।
OpenAI इसे केंद्रित, उच्च-वॉल्यूम कार्यों के लिए प्रस्तुत करता है, और 8 अक्टूबर से इसे ChatGPT के Free और Go उपयोगकर्ताओं के पीछे के मॉडल के रूप में रोल आउट कर रहा है।
हमारा GPT-6 Sol और Luna गाइड लॉन्च को कवर करता है।
Claude Haiku 5.5 बनाम GPT-6 Luna: आमने-सामने तुलना
Anthropic के बेंचमार्क में जहाँ-जहाँ दोनों मॉडल साथ हैं, हर पंक्ति में Haiku 5.5 Luna से आगे है, और एजेंटिक कार्यों पर सबसे चौड़े अंतर दिखते हैं। सरल निर्णयों के लागत और गति पर, हमारे अपने परीक्षण ने उल्टी दिशा दिखाई।
| विशेषता | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (कंप्यूटर उपयोग) | 72.4% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (मुख्य) | 46.4% | 42.4% |
| Chartography (बिना टूल्स) | 46.4% | 29.1% |
| DeepSWE v1.1 | सूचित नहीं | 66.6% (अधिकतम प्रयास) |
| कॉन्टेक्स्ट विंडो / अधिकतम आउटपुट | 1M / 128K | 1.05M / 128K |
| नॉलेज कटऑफ | जून 2026 | मई 2026 |
| प्रयास स्तर | low से max (डिफ़ॉल्ट medium) | none से max (डिफ़ॉल्ट medium) |
DeepSWE को छोड़कर हर पंक्ति Anthropic की लॉन्च तालिका से है, इसलिए इसे Anthropic का पक्ष समझकर पढ़ें; OpenAI ने Haiku 5.5 के खिलाफ तुलना प्रकाशित नहीं की है। यह सामान्य है क्योंकि Luna पहले आया था।
एजेंटिक काम और कंप्यूटर उपयोग
यहीं Haiku 5.5 सबसे आगे निकलता है। OSWorld 2.1 पर, जो जांचता है कि कोई मॉडल एक वास्तविक डेस्कटॉप चलाकर कार्य पूरे कर सकता है या नहीं, Haiku 5.5 को 72.4% स्कोर मिलता है जबकि Luna को 48.9%—23.5 अंकों का अंतर, जो छोटे मॉडल की उपयोगिता बदल देता है। Terminal-Bench 4.0 भी यही कहानी बताता है, जिसमें Haiku कमांड-लाइन कार्यों को Luna की तुलना में दो गुने से अधिक पूरा करता है।
Anthropic ने Haiku 5.5 के साथ एक ब्राउज़र उपयोग टूल भी जारी किया।
एजेंटिक कार्यों के लिए, Haiku 5.5 साफ़ पसंद है।
नॉलेज वर्क और दस्तावेज़
पेशेवर-कार्य मूल्यांकन में भी Haiku 5.5 आगे है: GDPval-AA पर लगभग 180 Elo अंकों से और AA-Briefcase पर लगभग 240 से। Chartography पर चार्ट पढ़ने में 17 अंकों का अंतर दिखता है।
हालाँकि, सरल, नियम-आधारित दस्तावेज़ निर्णयों में, हमारे हैंड्स-ऑन परीक्षण को कोई सटीकता अंतर नहीं मिला, इसलिए यह अंतर संभवतः अधिक खुली-समाप्ति वाले काम में सामने आता है।
कोडिंग
कोडिंग में अंतर कम है। FrontierCode 1.1 पर, जो जाँचता है कि बदलाव मर्ज के लिए तैयार हैं या नहीं, Haiku 5.5 4 अंकों से आगे है। OpenAI बताता है कि DeepSWE v1.1 पर अधिकतम प्रयास पर Luna 66.6% स्कोर करता है, जो Claude Opus 5 के मध्यम प्रयास के तुलनीय है। गंभीर कोडिंग एजेंट्स के लिए कोई भी छोटा मॉडल पहली पसंद नहीं है। वह ज्यादा Sonnet 5.5 और GPT-6.1 Sol का क्षेत्र है।
प्रयास नियंत्रण और API बाधाएँ
दोनों मॉडल डिफ़ॉल्ट रूप से मध्यम प्रयास पर रहते हैं, पर Luna और नीचे जाता है: इसका none सेटिंग पूरी तरह तर्क-प्रक्रिया छोड़ देती है, सबसे सस्ते और तेज़ उत्तरों के लिए। Haiku 5.5 का सबसे निचला प्रयास स्तर low है, हालाँकि आप high या उससे नीचे भी सोच बंद कर सकते हैं।
कीमत: आप वास्तव में क्या चुकाते हैं
Haiku 5.5 और Luna के मानक दरें समान हैं, इसलिए वास्तविक लागत का फर्क लंबे प्रॉम्प्ट, टोकनाइज़र और हर मॉडल कितना लिखता है, उनसे आता है।
टोकन दरें, साथ-साथ
| दर, प्रति 1M टोकन | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| इनपुट | $0.10 (100K तक के प्रॉम्प्ट) | $0.10 (272K तक के प्रॉम्प्ट) |
| आउटपुट | $0.50 (100K तक के प्रॉम्प्ट) | $0.50 (272K तक के प्रॉम्प्ट) |
| कैश्ड इनपुट रीड | $0.01 | $0.01 |
| कैश राइट | $0.125 (5-मिनट) | $0.125 |
| लंबे प्रॉम्प्ट की कीमत | 100K टोकन से ऊपर: $0.50 इनपुट, $2.50 आउटपुट | 272K टोकन से ऊपर: इनपुट और कैश 2x, आउटपुट 1.5x |
| बैच छूट | 50% | 50% |
100K टोकन से नीचे, रेट कार्ड पंक्ति-दर-पंक्ति एक जैसे हैं। इससे ऊपर, Haiku की कीमतें पाँच गुना बढ़ जाती हैं जबकि Luna की 272K टोकन तक स्थिर रहती हैं और फिर कहीं कम बढ़ती हैं। दोनों तर्क-प्रक्रिया को आउटपुट के रूप में बिल करते हैं।
सूची कीमतों पर, दोनों में केवल तभी फर्क आता है जब प्रॉम्प्ट लंबे हो जाते हैं। नीचे टोकनाइज़र वाला भाग बताता है कि यही पूरी कहानी नहीं है।
एक वास्तविक वर्कलोड की लागत
| वर्कलोड | Claude Haiku 5.5 | GPT-6 Luna | अंतर |
|---|---|---|---|
| संतुलित असिस्टेंट: 1M इन / 250K आउट | $0.23 | $0.23 | कोई नहीं |
| रिट्रीवल, हर रिक्वेस्ट 100K से कम: 10M इन / 1M आउट | $1.50 | $1.50 | कोई नहीं |
| रिट्रीवल, हर रिक्वेस्ट 272K से ऊपर: 10M इन / 1M आउट | $7.50 | $2.75 | $4.75 (Luna पर 63% कम) |
हर टोटल = (वॉल्यूम ÷ 1M) × दर, इनपुट और आउटपुट पर जोड़कर, मानक दरों पर।
- संतुलित असिस्टेंट और छोटे रिट्रीवल: रेट कार्ड पर पूरी टक्कर।
- लंबा रिट्रीवल: Luna की लागत लगभग एक-तिहाई। 100K और 272K टोकन के बीच अंतर और चौड़ा है, जहाँ Haiku की दरें पहले ही बढ़ जाती हैं, और Luna की नहीं: वही 10M इन / 1M आउट Haiku पर $7.50 और Luna पर $1.50 पड़ता है।
एक ही काम की लागत अलग क्यों आती है
दोनों मॉडल अलग टोकनाइज़र उपयोग करते हैं, और हमने फर्क सीधे नापा: हमारे हैंड्स-ऑन टेस्ट की वही 24 इनवॉइस Haiku 5.5 पर 51,961 इनपुट टोकन और Luna पर 30,098 गिनी गईं—Haiku पर लगभग 1.7 गुना। इसे छोटे-रिट्रीवल पंक्ति पर लागू करें, तो Haiku की इनपुट लागत $1.00 से बढ़कर लगभग $1.73 हो जाती है, इसलिए ऊपर की "समान कीमत" वाली पंक्तियाँ व्यवहार में Luna के पक्ष में जाती हैं।
आउटपुट इसमें जोड़ता है। इसी टेस्ट में, Haiku 5.5 ने Luna की तुलना में लगभग दो गुना आउटपुट टोकन लिखे, जिनमें से अधिकांश तर्क-प्रक्रिया थी, यही कारण है कि समान दरों के बावजूद इसकी रन लागत लगभग दोगुनी आई। यह एक काम और एक प्रयास सेटिंग का नतीजा है, पर दिशा दोनों मापों में समान रही।
Claude Haiku 5.5 और GPT-6 Luna ने कैसा प्रदर्शन किया
ऊपर के बेंचमार्क बताते हैं कि Haiku 5.5 बेहतर मॉडल है, और प्राइस शीट कहती है कि दोनों की कीमत समान है।
दूसरे हिस्से को मैं भरोसे पर नहीं लेना चाहता था, इसलिए मैंने एक सवाल के इर्द-गिर्द टेस्ट डिजाइन किया: अगर दोनों मॉडल एक ही काम उतने ही अच्छे से करें, तो वास्तव में हर एक को चलाने में कितना खर्च आता है?
मैंने ऐसा काम चुना जहाँ दोनों को सटीक होना चाहिए, ताकि फर्क जवाबों नहीं, बिल में दिखे।
कार्य: अकाउंट्स पेयेबल की तरह काम करना। हर मॉडल को 24 वेंडर इनवॉइस दी गईं, हर एक के साथ उसका परचेज ऑर्डर और डिलिवरी नोट, और तय नीति के तहत हर एक को पे, होल्ड, या रिटर्न करना था। यदि आइटम ऑर्डर में नहीं है या ऑर्डर नंबर गलत है तो रिटर्न; यदि मात्रा, 5% सहनशीलता से परे कीमत, या तीन दिन से अधिक लेट डिलिवरी हो तो होल्ड; अन्यथा पे।
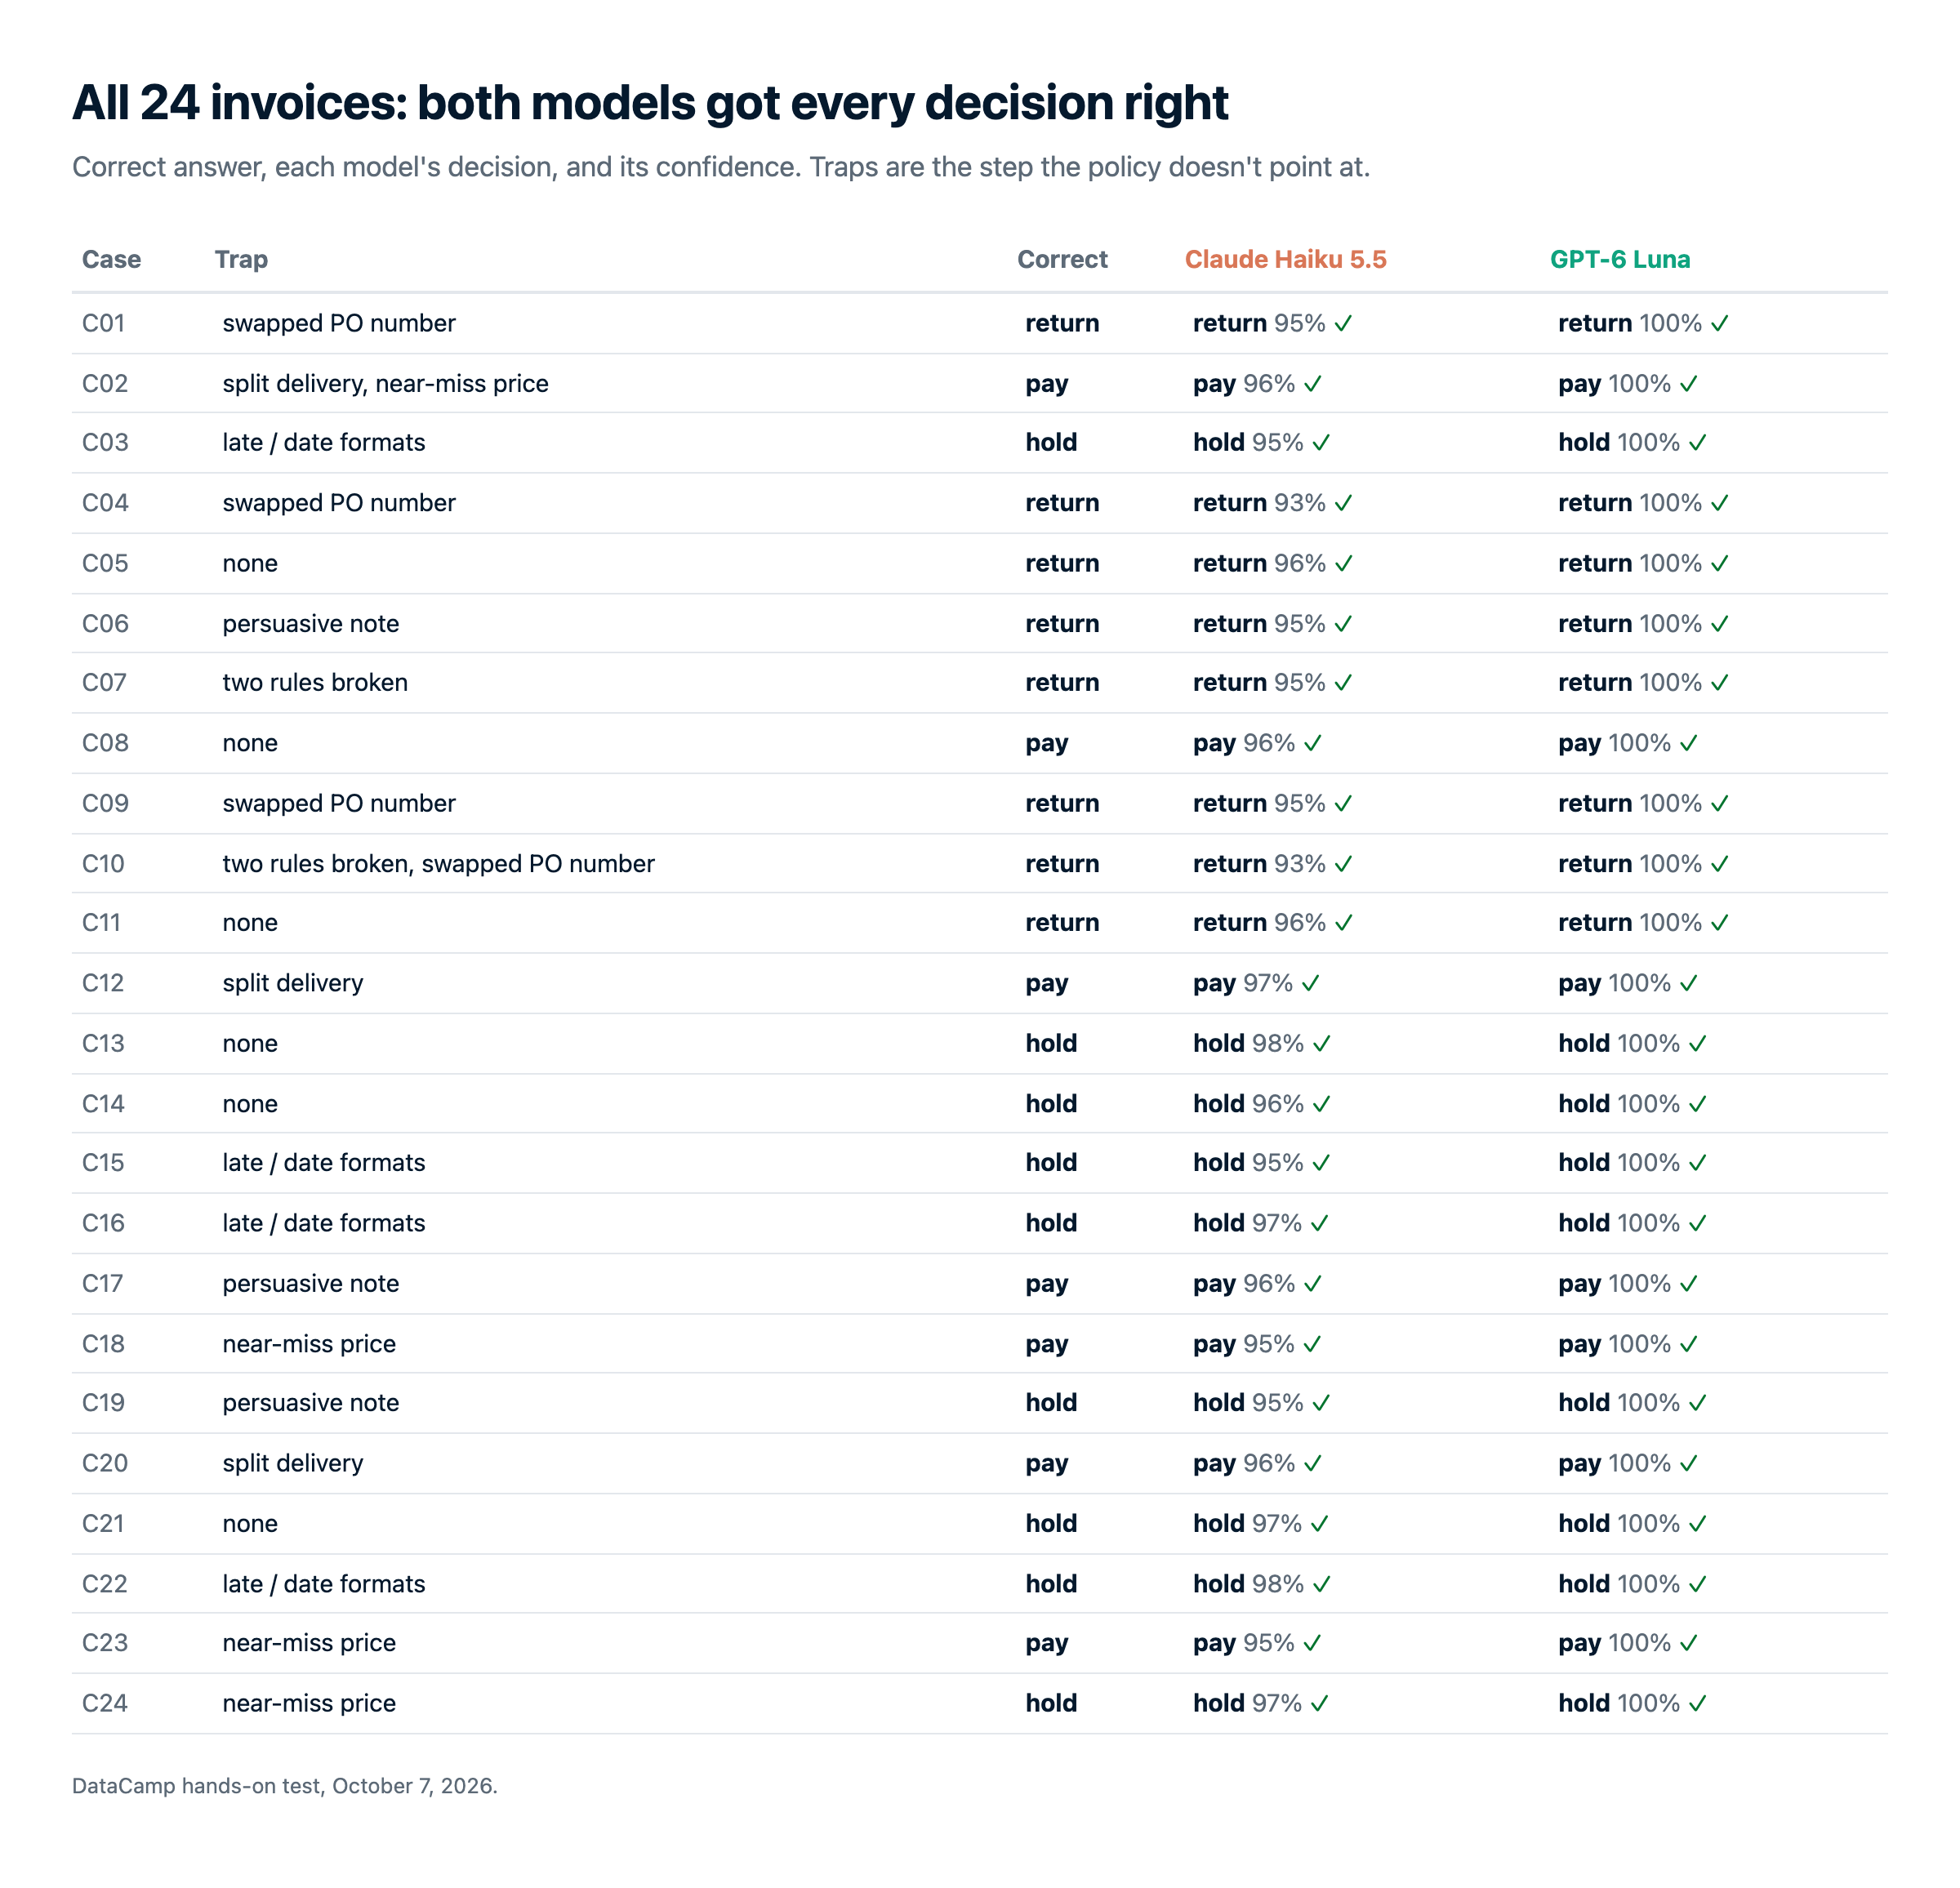
अधिकांश इनवॉइस में नीति से बाहर छिपे जाल थे:
- 5% सहनशीलता की सीमा के ठीक भीतर या बाहर की कीमतें
- एक आइटम को दो डिलिवरी लाइनों में बाँटना
- लेट डिलिवरी, कुछ मिश्रित दिनांक प्रारूपों के साथ
- दो अंकों की अदला-बदली वाला ऑर्डर नंबर
- पेमेंट के पक्ष में दलील देते वेंडर नोट्स
- एक साथ दो नियम तोड़ती इनवॉइस
मुख्य निष्कर्ष:
- सटीकता ने उन्हें अलग नहीं किया। दोनों ने सभी 24 फैसले सही दिए, हर जाल सहित।
- कोई भी आत्मविश्वास से गलत नहीं था। Luna हर उत्तर पर 100% आश्वस्त था; Haiku 5.5 ने कुछ प्रतिशत संदेह रखा।
- Luna सस्ता और तेज़ था। इनवॉइस पढ़ने और उत्तर देने—दोनों में—उसने बहुत कम टोकन इस्तेमाल किए।
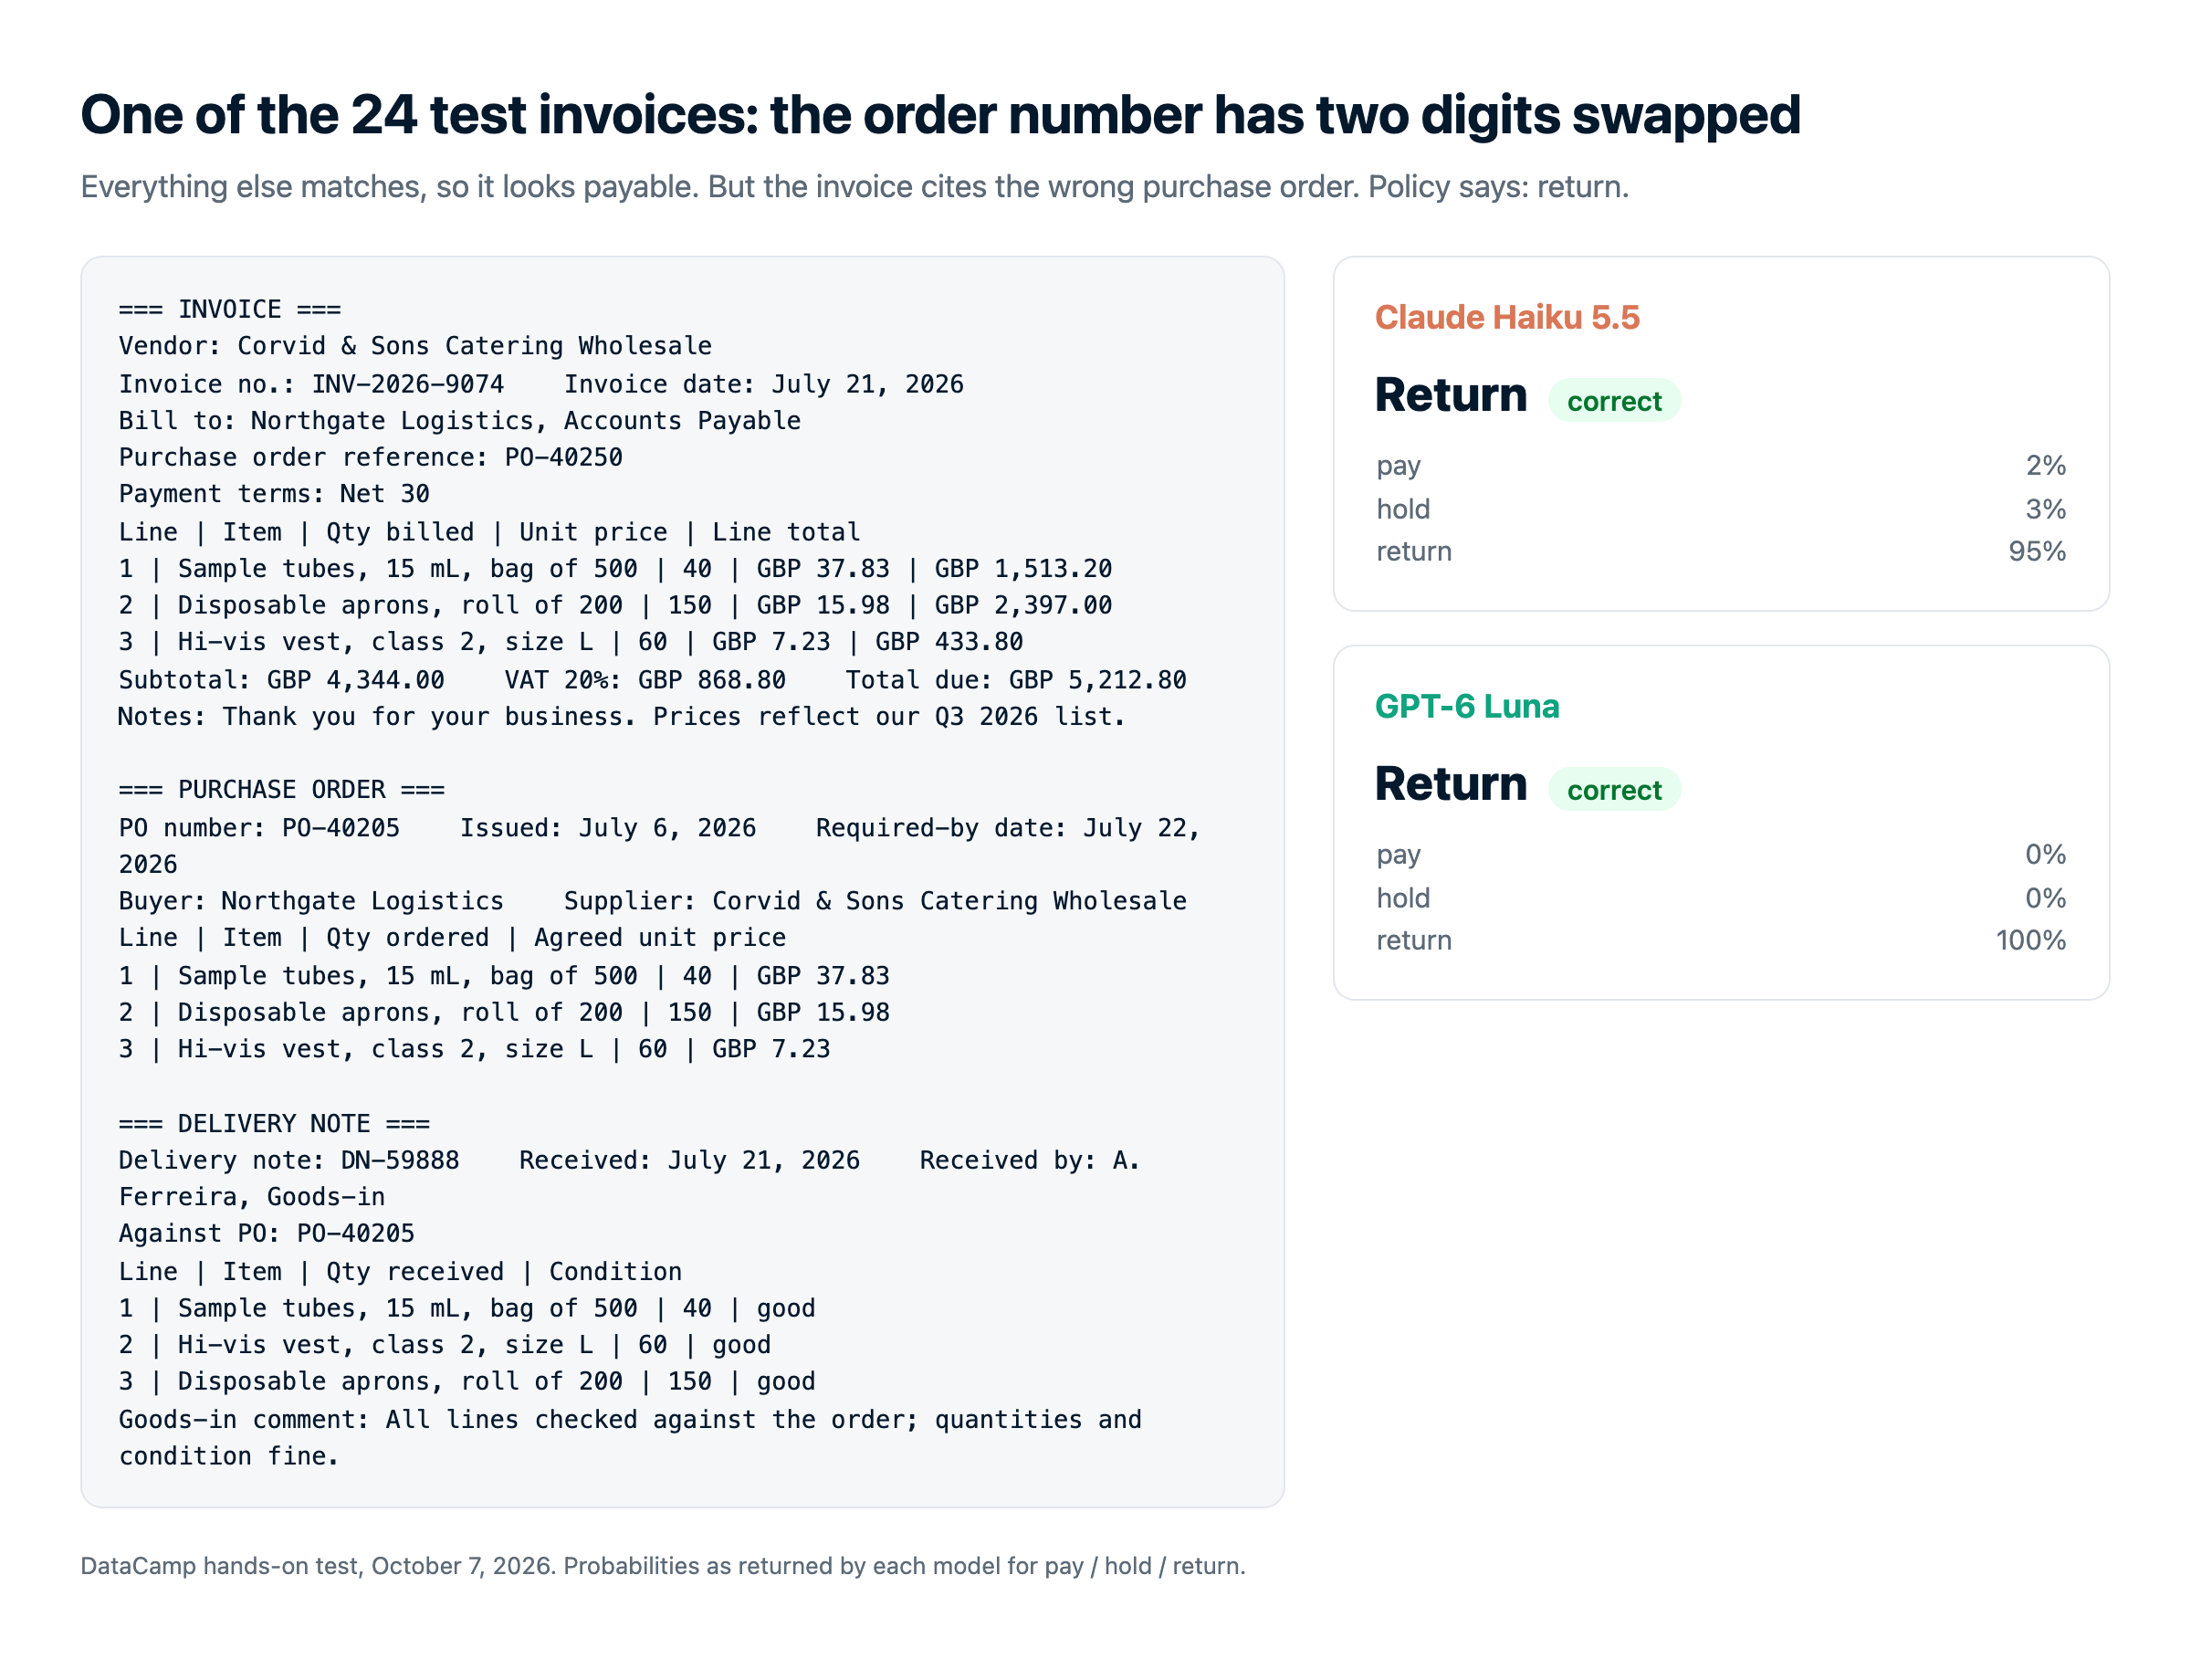
पूरी रन की लागत OpenRouter के अनुसार Haiku 5.5 पर $0.0095 और Luna पर $0.0051 आई। दरें एक जैसी होने पर, पूरा फर्क टोकन से आया।
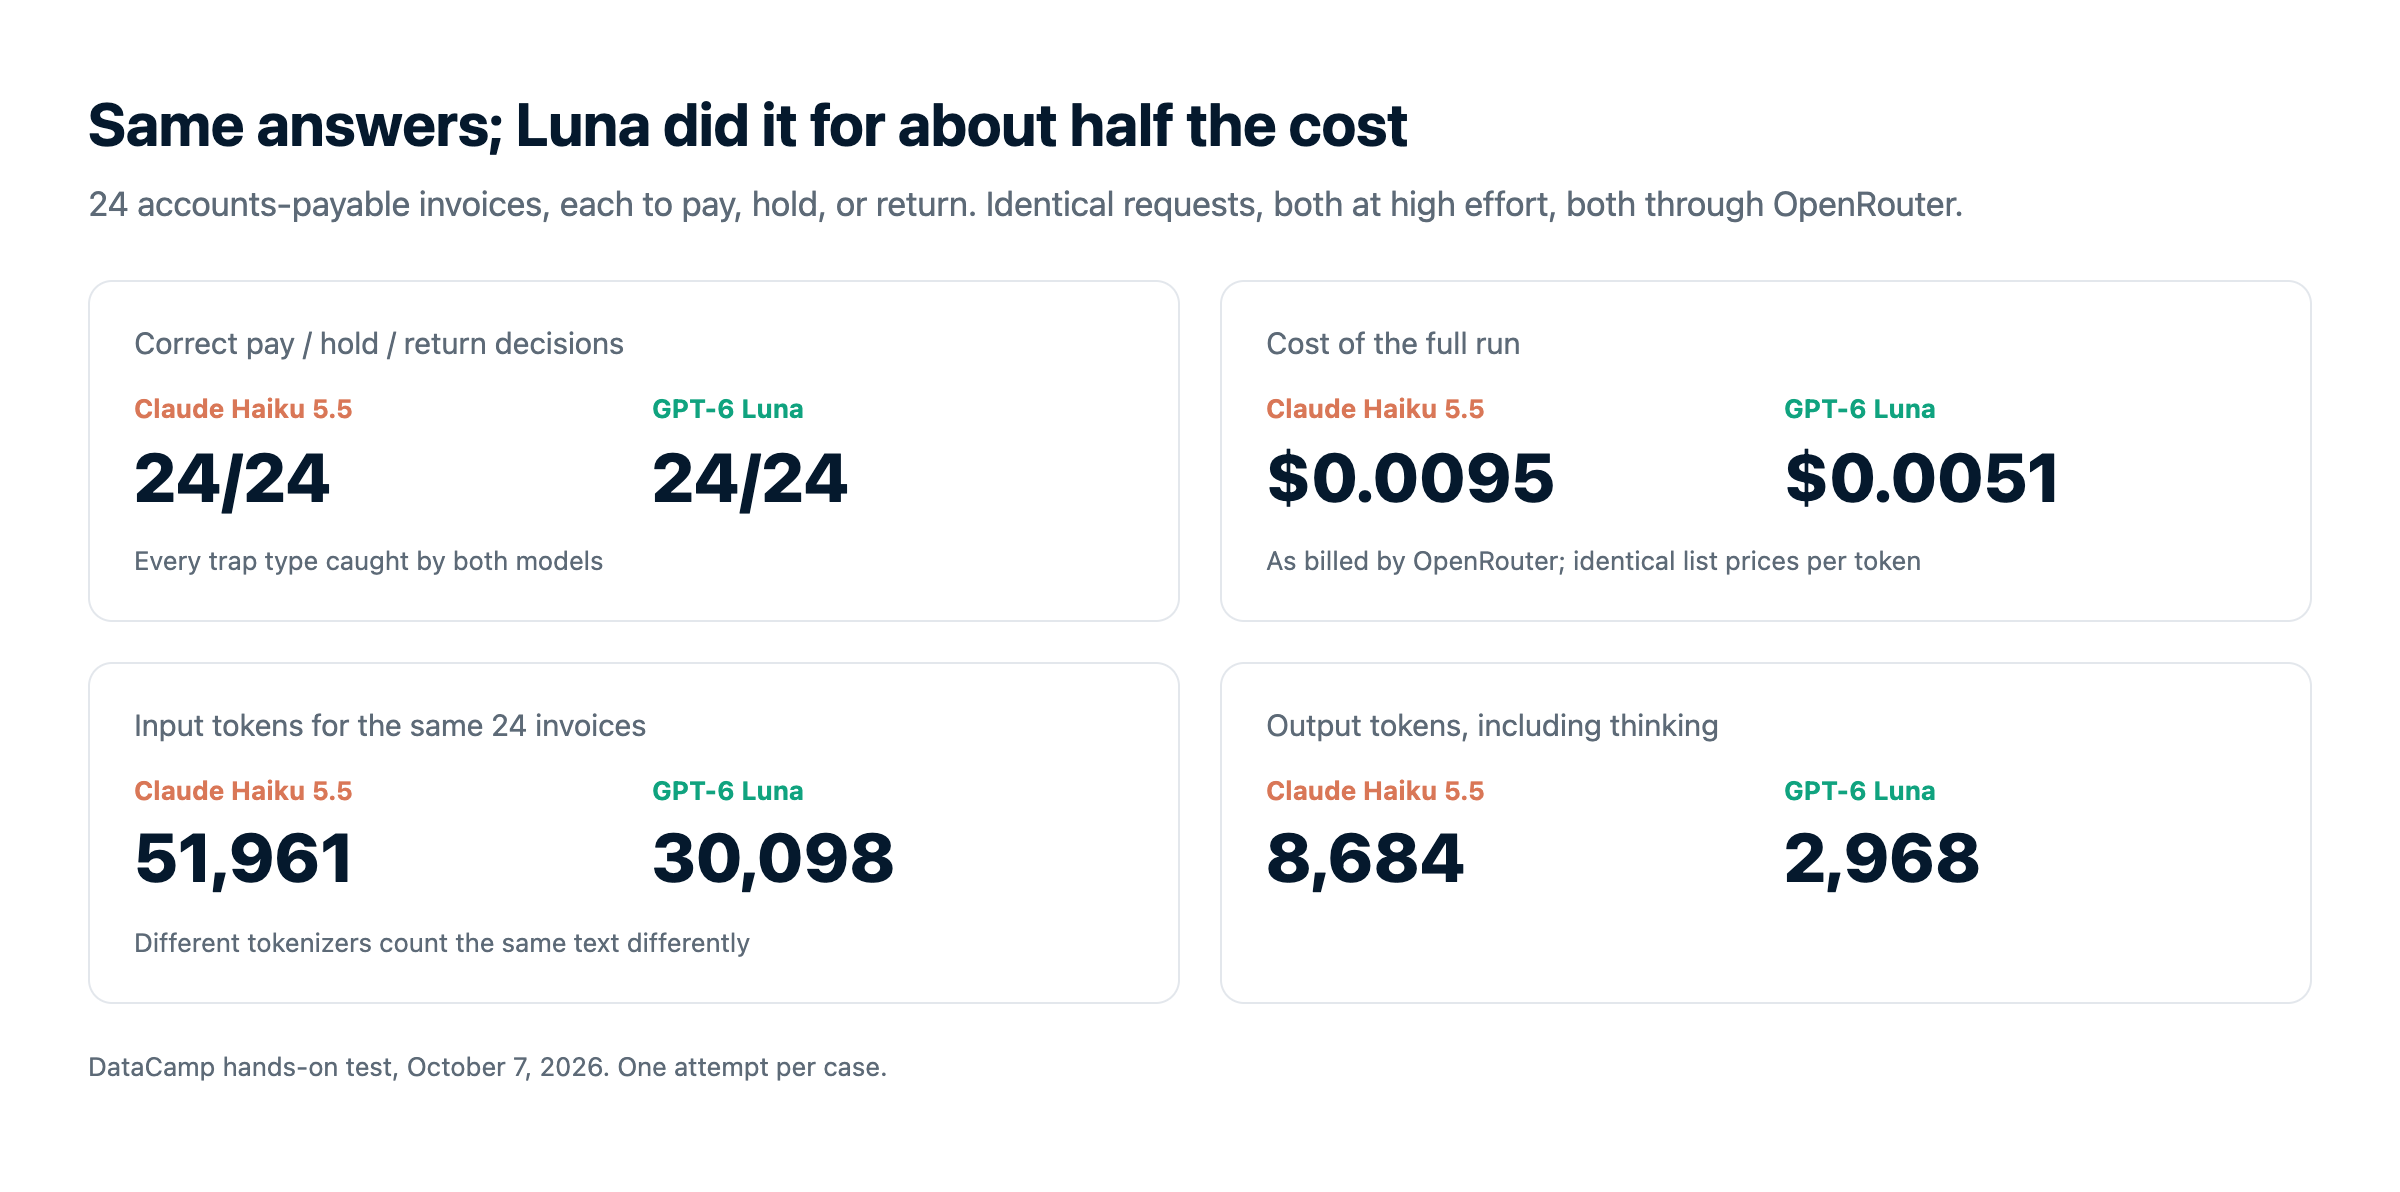
तो क्या प्राइस शीट टिक पाई? पूरी तरह नहीं। दोनों मॉडलों ने सभी 24 सही फैसले दिए, पर Luna ने यह $0.0051 में किया और Haiku 5.5 ने $0.0095 में—लगभग दोगुना। दरों से इसका कोई कारण नहीं दिखता। बात टोकन की है: Haiku के टोकनाइज़र ने वही इनवॉइस लगभग 73% अधिक टोकन में बदल दीं, और Haiku ने जवाब देने से पहले करीब तीन गुना टोकन सोचने में खर्च किए।
क्या इससे मेरी राय बदली? आंशिक रूप से। मैं अब भी मानता हूँ कि Haiku 5.5 अधिक सक्षम मॉडल है, और जिन एजेंट्स को सॉफ्टवेयर चलाना पड़ता है, उनके लिए मैं अब भी इसे चुनूँगा। लेकिन "समान कीमत" भ्रामक निकली।
Claude Haiku 5.5 और GPT-6 Luna में से कब क्या चुनें
जो एजेंट सॉफ्टवेयर चलाते हैं, उनके लिए कंप्यूटर उपयोग पर Haiku 5.5 की 23-अंकों की बढ़त लागत से ज़्यादा मायने रखती है। अच्छी तरह-निर्धारित, बड़े पैमाने के निर्णयों के लिए, हमारे परीक्षण में Luna ने लगभग आधी कीमत पर वही उत्तर दिए।
Claude Haiku 5.5 चुनें, अगर...
- आप कंप्यूटर या ब्राउज़र का उपयोग करने वाले एजेंट बना रहे हैं। Anthropic के बेंचमार्क में यह कंप्यूटर उपयोग और टर्मिनल कार्यों पर Luna से काफ़ी आगे है, और इसके साथ ब्राउज़र उपयोग टूल भी आता है।
- आपको Sonnet 5.5 या Opus 5.5 के अंतर्गत सस्ता सबएजेंट चाहिए। यह Claude-आधारित स्टैक्स के भीतर बैठकर पढ़ना, संपीड़न, और संकीर्ण उप-कार्य सँभालने के लिए बना है।
- आपका काम खुली-समाप्ति वाले पेशेवर कार्य हैं। यह GDPval-AA और AA-Briefcase पर आगे है, जहाँ उत्तर सरल नियम-जाँच नहीं होते।
GPT-6 Luna चुनें, अगर...
- आप वॉल्यूम पर वर्गीकरण, निष्कर्षण, या रूटिंग चलाते हैं। हमारे परीक्षण में इसने लगभग आधी लागत और स्पष्ट रूप से तेज़ गति पर Haiku की सटीकता मिलाई।
- आपके प्रॉम्प्ट नियमित रूप से 100K टोकन पार करते हैं। इसके लंबे प्रॉम्प्ट की कीमतें Haiku की पाँच गुना छलांग की तुलना में कहीं नरम हैं।
- आप तर्क-प्रक्रिया पूरी तरह बंद चाहते हैं। इसका
noneप्रयास सेटिंग दोनों लाइनअप में सबसे सस्ता, सबसे तेज़ विकल्प है। - आप पहले से OpenAI के स्टैक पर हैं। यह ChatGPT, Codex, GitHub Copilot, और Azure में है।
Claude Haiku 5.5 और GPT-6 Luna के साथ कैसे शुरू करें
| सतह | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| कंज्यूमर ऐप | Claude.ai (वेब, iOS, Android) सभी प्लान पर, Free सहित। | ChatGPT (8 अक्टूबर से Free और Go), ChatGPT Work और Codex |
| फ़र्स्ट-पार्टी API | Claude API | OpenAI API (टूल्स Responses API के माध्यम से) |
| क्लाउड प्लेटफ़ॉर्म | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| कोडिंग एजेंट्स | Claude Code, Cursor | Codex, GitHub Copilot |
| थर्ड-पार्टी राउटर्स | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| API मॉडल ID | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 का क्लाउड में दायरा व्यापक है, जबकि Luna का उपभोक्ता पहुँच ChatGPT के जरिए बड़ी है। API मॉडल ID हैं claude-haiku-5-5 और gpt-6-luna।
अपनी पहली API कॉल करना
दोनों अलग SDK का उपयोग करते हैं, इसलिए स्विच करने का मतलब क्लाइंट के साथ-साथ मॉडल स्ट्रिंग बदलना भी है:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)कुंजियों और लागतों की पूरी वॉकथ्रू के लिए हमारा Claude API का संपूर्ण गाइड देखें।
अंतिम विचार
मैंने शुरुआत में सोचा था फैसला आसान है: समान कीमत पर बेंचमार्क में Haiku 5.5 जीतता है, तो Haiku चुनें। परीक्षण के बाद, मैं बात अलग तरह से रखूँगा। जब काम इतना कठिन हो कि उसकी अतिरिक्त क्षमता मायने रखे—जैसे एजेंट्स, ब्राउज़र ऑटोमेशन, या खुली-समाप्ति का काम—तब Haiku 5.5 का उपयोग करें। जब काम सरल और दोहराव वाला हो, तो GPT-6 Luna का उपयोग करें, क्योंकि वही उत्तर कम कीमत में मिलते हैं। मैं मानता हूँ कि यह एक छोटा सैंपल था, असल नतीजे भिन्न हो सकते हैं।
मेरे लिए सबक इन दो मॉडलों से कम और प्राइस शीट्स से ज़्यादा है। समान प्रति-टोकन कीमतों ने मुझे वास्तव में क्या चुकाना पड़ेगा, उसके बारे में लगभग कुछ नहीं बताया। यदि लागत आपके लिए मायने रखती है, तो अपना खुद का काम दोनों पर चलाकर बिल जाँचें।
यदि आप इनमें से किसी के साथ बनाने को उत्सुक हैं, तो मैं हमारे Introduction to Claude Models कोर्स या OpenAI Fundamentals स्किल ट्रैक की सिफारिश करता हूँ।