Anthropic lanceerde onlangs Claude Haiku 5.5, en dat was een tik naar OpenAI. In de benchmarktabel die Anthropic deelde, staat Haiku 5.5 voor op GPT-6 Luna op elke rij waar beide voorkomen. En Anthropic zette Haiku 5.5 precies op dezelfde prijs als OpenAI Luna: $0,10 per miljoen inputtokens en $0,50 per miljoen outputtokens. Op papier is de vergelijking eenvoudig. Haiku 5.5 is beter dan GPT-6 Luna, en het kost hetzelfde.
Dat is de eerste indruk. Maar "dezelfde prijs per token" is niet hetzelfde als "dezelfde prijs per klus". Modellen lezen en schrijven verschillende aantallen tokens voor dezelfde taak. Dus ik was benieuwd: als ik beide modellen hetzelfde werk geef, kosten ze dan echt evenveel? En zo niet, zou dat mijn oordeel veranderen?
TL;DR
- Claude Haiku 5.5 is de capabelere agent, met grote voorsprongen op computergebruik en terminaltaken in Anthropics benchmarks.
- Op papier wint Haiku 5.5: betere benchmarks voor dezelfde prijs. Maar in mijn kostentest (spoiler), gaf Luna dezelfde antwoorden voor ongeveer de helft van het geld.
- De les: Identieke per-token prijzen kunnen echte kostengaten verbergen door tokenizers, redeneer-lengte en toeslagen voor lange prompts.
Wat is Claude Haiku 5.5?
Claude Haiku 5.5 is Anthropics kleinste en snelste model, uitgebracht op 7 oktober 2026 als het laatste lid van de Claude 5.5-familie.
Anthropic positioneert het voor werk met hoge volumes en lage latentie, zoals classificatie, extractie, routering en als subagent onder Sonnet 5.5 of Opus 5.5, en het brengt adaptief denken en computergebruik naar de onderkant van de prijsladder.
Onze Claude Haiku 5.5-gids behandelt de lancering en onze praktijktest tegenover Haiku 4.5.
Wat is GPT-6 Luna?
GPT-6 Luna is OpenAI’s meest efficiënte model, uitgebracht op 22 september 2026 als de kleinste laag van de GPT-6-familie, onder Astra en Sol.
OpenAI positioneert het voor gerichte taken met hoge volumes, en rolt het uit als het model achter ChatGPT voor Free- en Go-gebruikers vanaf 8 oktober.
Onze GPT-6 Sol- en Luna-gids behandelt de lancering.
Claude Haiku 5.5 vs. GPT-6 Luna: vergelijking head-to-head
Anthropics benchmarks plaatsen Haiku 5.5 voor Luna op elke rij die beide modellen delen, met de grootste verschillen op agenttaken. Bij kosten en snelheid voor eenvoudige beslissingen wees onze eigen test juist de andere kant op.
| Kenmerk | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (computergebruik) | 72,4% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 16,4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46,4% | 42,4% |
| Chartography (zonder tools) | 46,4% | 29,1% |
| DeepSWE v1.1 | Niet gerapporteerd | 66,6% (maximale inzet) |
| Contextvenster / max. output | 1M / 128K | 1,05M / 128K |
| Knowledge cutoff | juni 2026 | mei 2026 |
| Inspanningsniveaus | laag tot max (standaard medium) | geen tot max (standaard medium) |
Elke rij behalve DeepSWE komt uit Anthropics lanceringstabel, dus lees dit als Anthropics onderbouwing; OpenAI heeft geen vergelijking gepubliceerd tegen Haiku 5.5. Dat is logisch, want Luna kwam eerst.
Agentwerk en computergebruik
Hier loopt Haiku 5.5 het verst uit. Op OSWorld 2.1, dat test of een model taken kan voltooien door een echte desktop te bedienen, scoort Haiku 5.5 72,4% tegen Luna’s 48,9%, een kloof van 23,5 punten die verandert waar een klein model nuttig voor is. Terminal-Bench 4.0 vertelt hetzelfde verhaal, waarbij Haiku meer dan twee keer zoveel command-line taken voltooit.
Anthropic leverde ook een tool voor browsergebruik mee met Haiku 5.5.
Voor agentwerk is Haiku 5.5 de duidelijke keuze.
Kenniswerk en documenten
Haiku 5.5 loopt ook voor op evaluaties van professionele taken: circa 180 Elo-punten op GDPval-AA en circa 240 op AA-Briefcase. Grafieklezen op Chartography laat een verschil van 17 punten zien.
Bij eenvoudigere, regelgebonden documentbeslissingen vonden we in onze praktijktest echter geen nauwkeurigheidsverschil, dus de kloof zal vooral zichtbaar zijn bij open-einde werk.
Coding
Coding ligt dichter bij elkaar. Op FrontierCode 1.1, dat beoordeelt of wijzigingen klaar zijn om te mergen, leidt Haiku 5.5 met 4 punten. OpenAI rapporteert Luna op 66,6% op DeepSWE v1.1 bij maximale inzet, vergelijkbaar met Claude Opus 5 bij gemiddelde inzet. Geen van beide kleine modellen is de eerste keuze voor serieuze codeeragents. Dat is eerder het domein van Sonnet 5.5 en GPT-6.1 Sol.
Inspanningsinstellingen en API-beperkingen
Beide modellen staan standaard op medium, maar Luna gaat lager: de none-stand slaat redeneren volledig over voor de goedkoopste, snelste antwoorden. Het laagste inspanningsniveau van Haiku 5.5 is low, al kun je denken nog steeds uitzetten bij high of lager.
Prijzen: wat je echt betaalt
Haiku 5.5 en Luna hebben identieke standaardtarieven, dus de echte kostenverschillen komen van lange prompts, tokenizers en hoeveel elk model schrijft.
Tokenprijzen naast elkaar
| Tarief, per 1M tokens | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Input | $0,10 (prompts tot 100K) | $0,10 (prompts tot 272K) |
| Output | $0,50 (prompts tot 100K) | $0,50 (prompts tot 272K) |
| Gecachte inputlees | $0,01 | $0,01 |
| Cache-write | $0,125 (5 minuten) | $0,125 |
| Prijzen voor lange prompts | Boven 100K tokens: $0,50 input, $2,50 output | Boven 272K tokens: 2x input en cache, 1,5x output |
| Batchkorting | 50% | 50% |
Onder 100K tokens zijn de tariefkaarten regel voor regel hetzelfde. Daarboven schieten Haiku’s prijzen vijfvoudig omhoog, terwijl Luna vlak blijft tot 272K tokens en dan veel minder stijgt. Beide rekenen redeneren als output.
Tegen lijstprijzen lopen de twee pas uiteen zodra prompts lang worden. De tokenizersectie hieronder laat zien waarom dat niet het hele verhaal is.
Wat een echte workload kost
| Workload | Claude Haiku 5.5 | GPT-6 Luna | Verschil |
|---|---|---|---|
| Gebalanceerde assistent: 1M in / 250K uit | $0,23 | $0,23 | Geen |
| Retrieval, per request onder 100K: 10M in / 1M uit | $1,50 | $1,50 | Geen |
| Retrieval, per request boven 272K: 10M in / 1M uit | $7,50 | $2,75 | $4,75 (63% goedkoper op Luna) |
Elke totaalprijs is (volume ÷ 1M) × tarief, opgeteld over input en output, tegen standaardtarieven.
- Gebalanceerde assistent en korte retrieval: exact gelijk op de tariefkaart.
- Lange retrieval: Luna kost ongeveer een derde. De kloof is nog groter tussen 100K en 272K tokens, waar Haiku al het hogere tarief betaalt en Luna niet: dezelfde 10M in / 1M uit kost $7,50 op Haiku tegenover $1,50 op Luna.
Waarom dezelfde taak verschillende bedragen kost
De twee modellen gebruiken verschillende tokenizers, en we hebben het verschil direct gemeten: dezelfde 24 facturen in onze praktijktest telden als 51.961 inputtokens op Haiku 5.5 en 30.098 op Luna, ongeveer 1,7 keer zoveel op Haiku. Toegepast op de rij met korte retrieval tilt dat Haiku’s inputkosten van $1,00 naar circa $1,73, dus de "dezelfde prijs"-rijen hierboven vallen in de praktijk uit in het voordeel van Luna.
Output telt mee. In dezelfde test schreef Haiku 5.5 ongeveer twee keer zoveel outputtokens als Luna, vooral redenering, waardoor de run bijna twee keer zo duur werd ondanks identieke tarieven. Dat is één taak bij één inspanningsstand, maar de richting is consistent in beide metingen.
Hoe Claude Haiku 5.5 en GPT-6 Luna presteerden
De benchmarks hierboven zeggen dat Haiku 5.5 het betere model is, en het prijsoverzicht zegt dat de twee hetzelfde kosten.
Dat tweede wilde ik niet op goed vertrouwen aannemen, dus ik ontwierp een test rond één vraag: als beide modellen dezelfde klus even goed doen, wat kost het draaien van elk model dan echt?
Ik koos een klus waar beide accuraat zouden moeten zijn, zodat elk verschil op de rekening zou verschijnen en niet in de antwoorden.
De taak: optreden als crediteurenadministratie. Elk model kreeg 24 leveranciersfacturen, elk met de bijbehorende inkooporder en pakbon, en moest per stuk betalen, aanhouden of retour sturen onder een vast beleid. Retour als een item niet op de order staat of het ordernummer verkeerd is; aanhouden als een hoeveelheid, een prijs buiten 5% tolerantie of een levering meer dan drie dagen te laat is; anders betalen.
De meeste facturen verstopten een valstrik waar het beleid niet direct op wijst:
- Prijzen net binnen of net buiten de 5% tolerantie
- Eén item gesplitst over twee leveringsregels
- Late leveringen, sommige met gemengde datumformaten
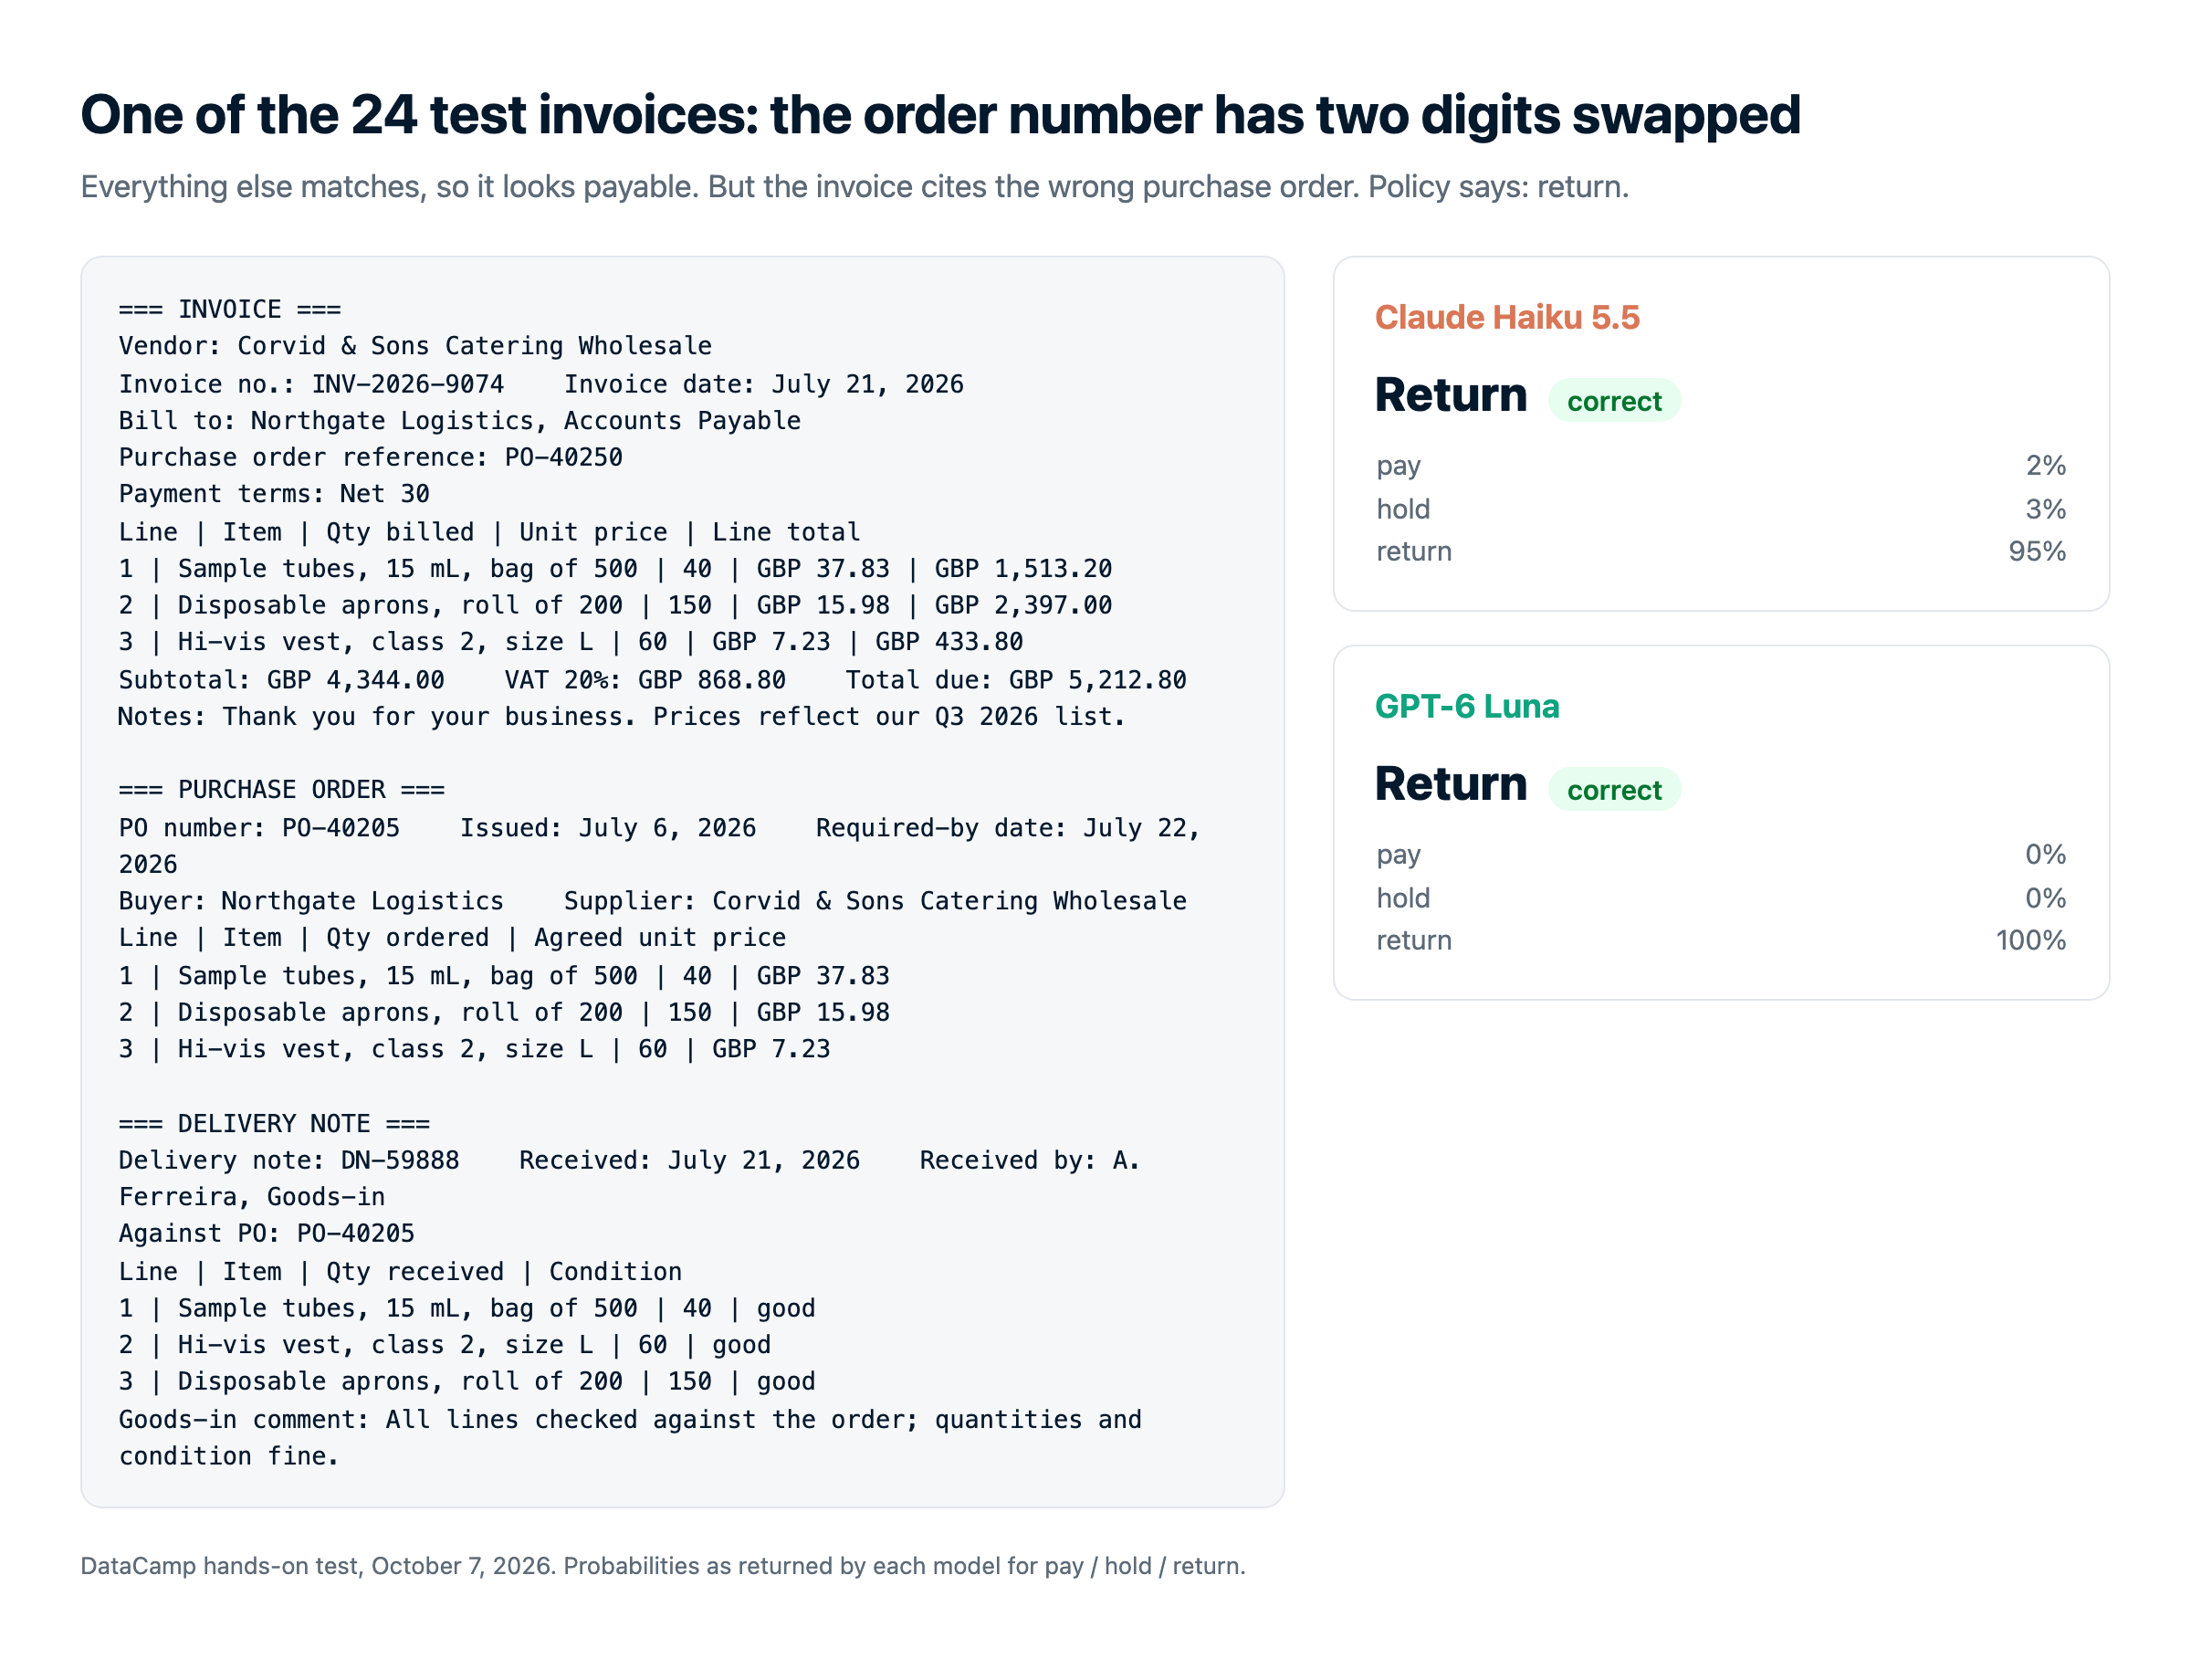
- Een ordernummer met twee omgewisselde cijfers
- Leveranciersnotities die pleiten voor betaling
- Facturen die twee regels tegelijk schenden
De belangrijkste bevindingen:
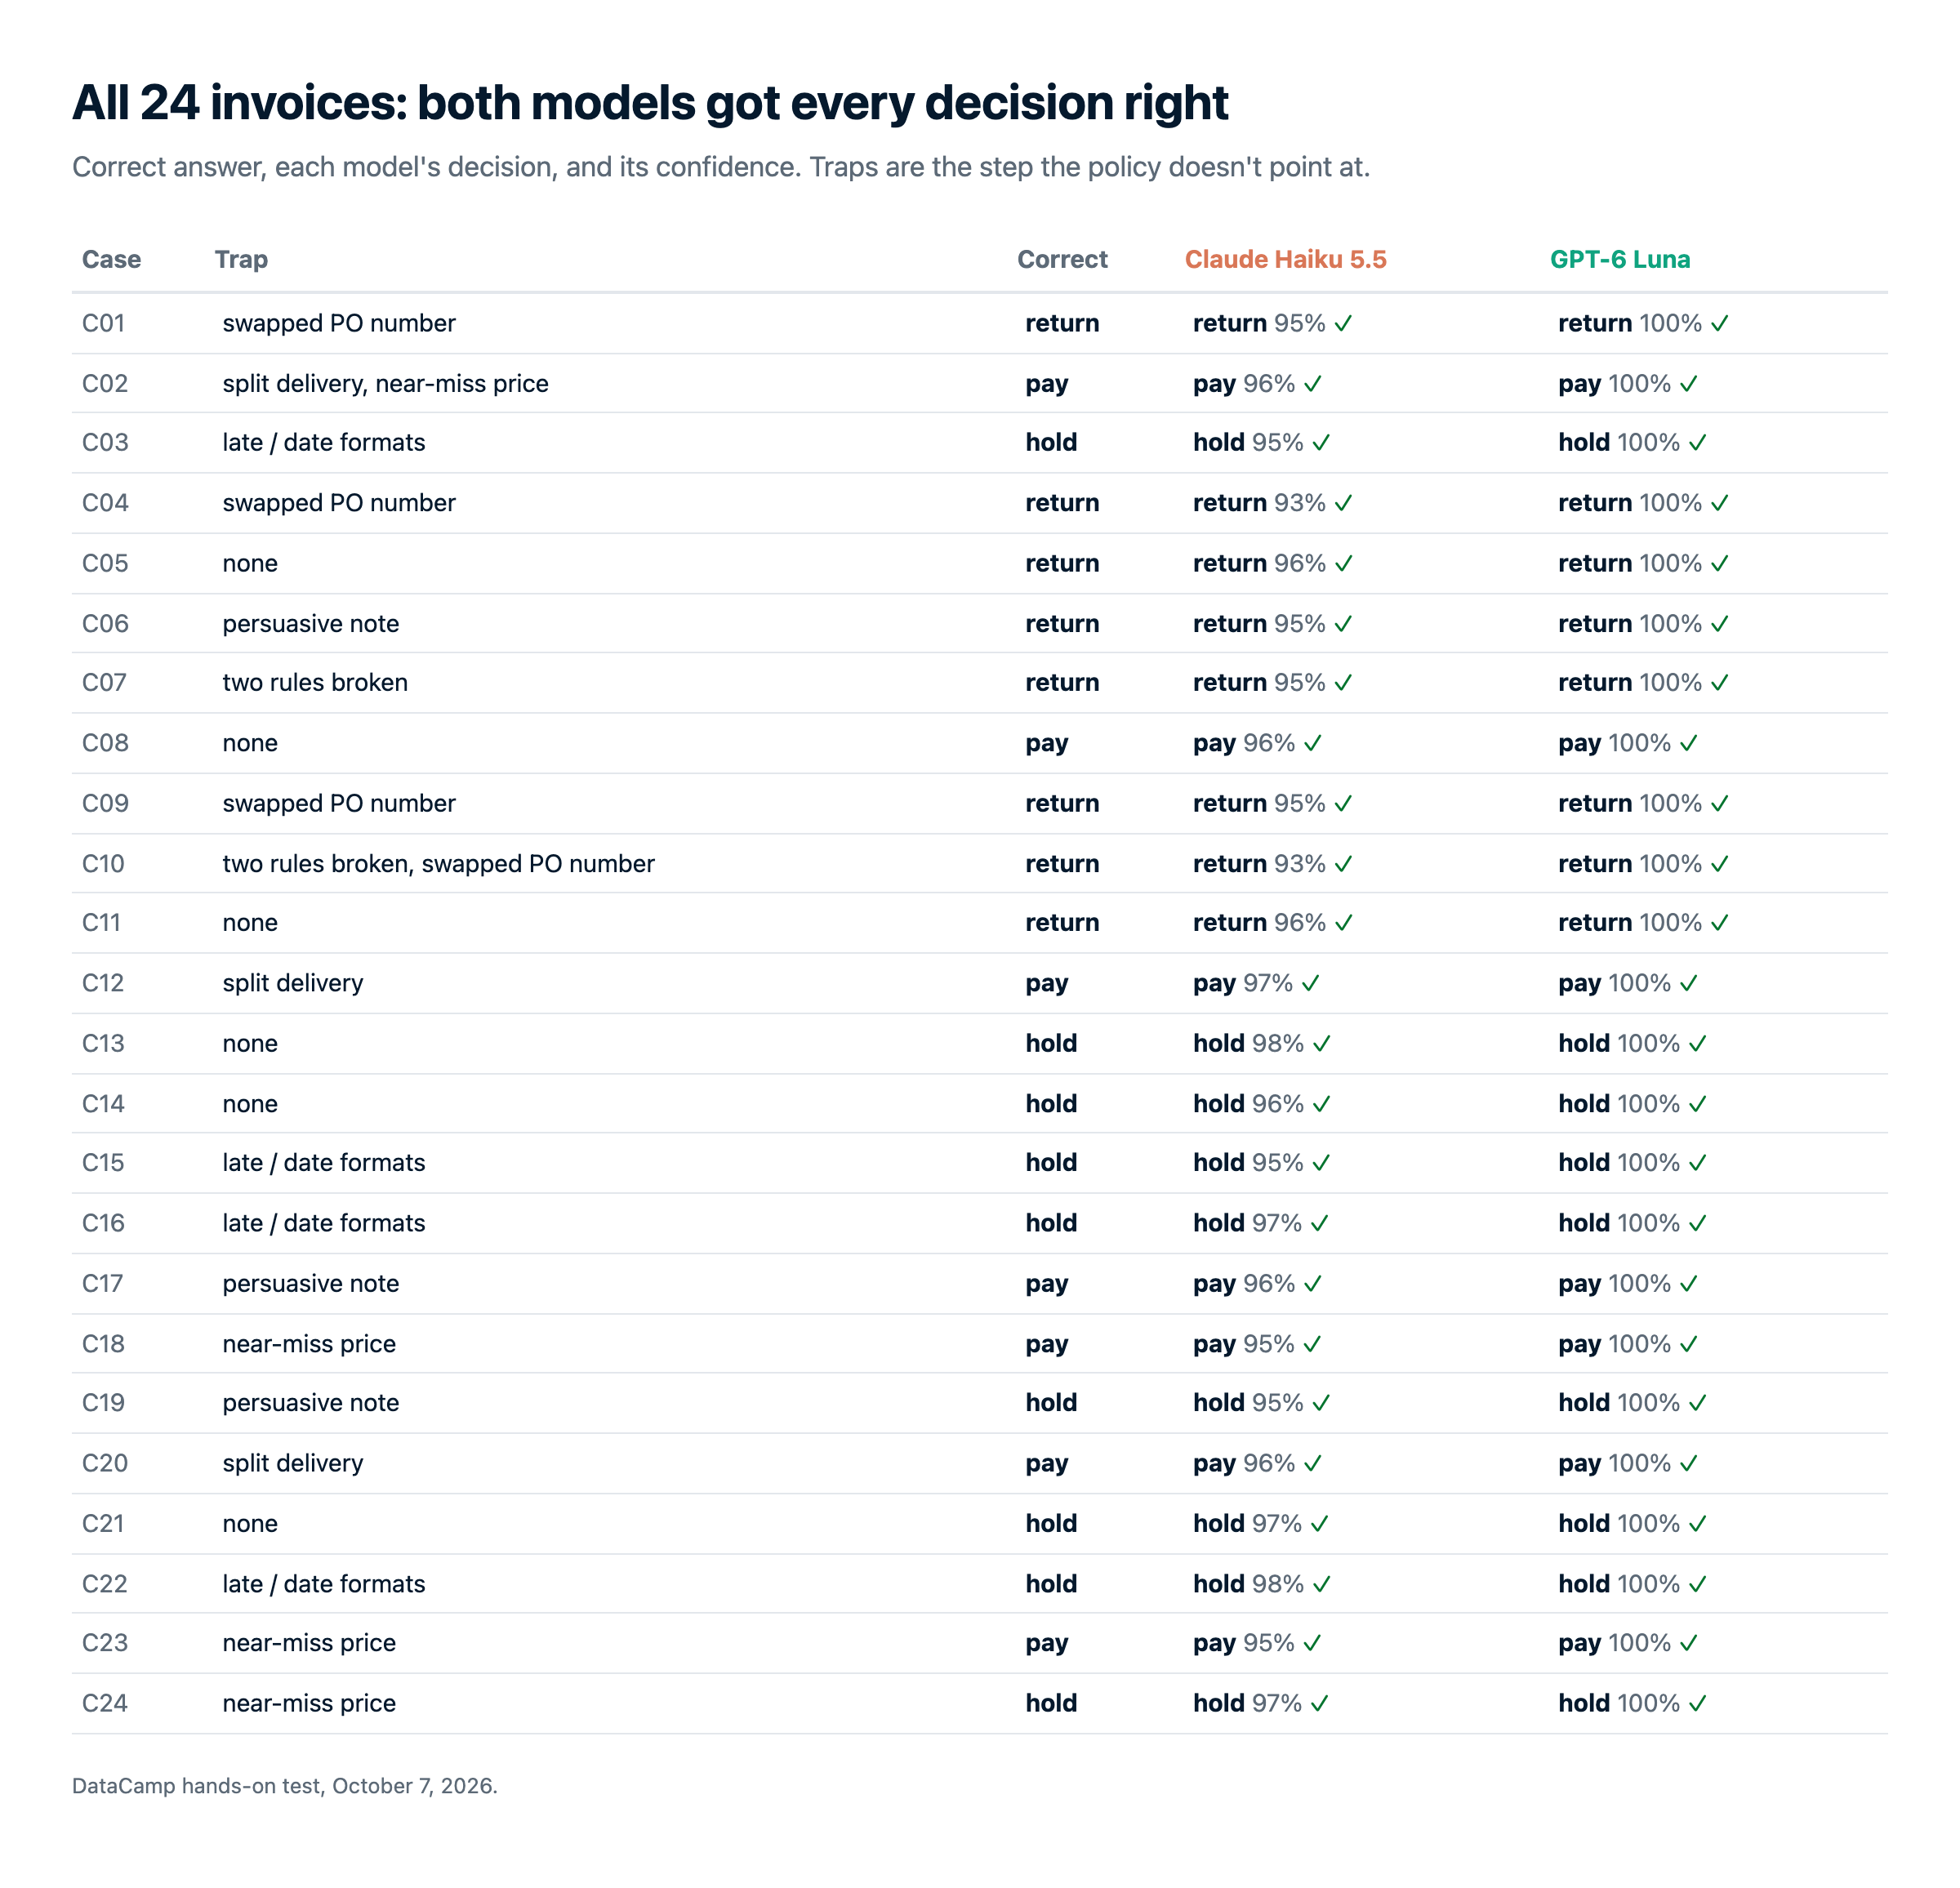
- Nauwkeurigheid onderscheidde ze niet. Beide hadden alle 24 beslissingen goed, inclusief elke valstrik.
- Geen van beide was zelfverzekerd fout. Luna was 100% zeker van elk antwoord; Haiku 5.5 hield een paar procent twijfel.
- Luna was goedkoper en sneller. Het had veel minder tokens nodig, zowel om de facturen te lezen als om te antwoorden.
De volledige run kostte $0,0095 op Haiku 5.5 en $0,0051 op Luna, zoals gefactureerd door OpenRouter. Met identieke tarieven komt het hele verschil door tokens.
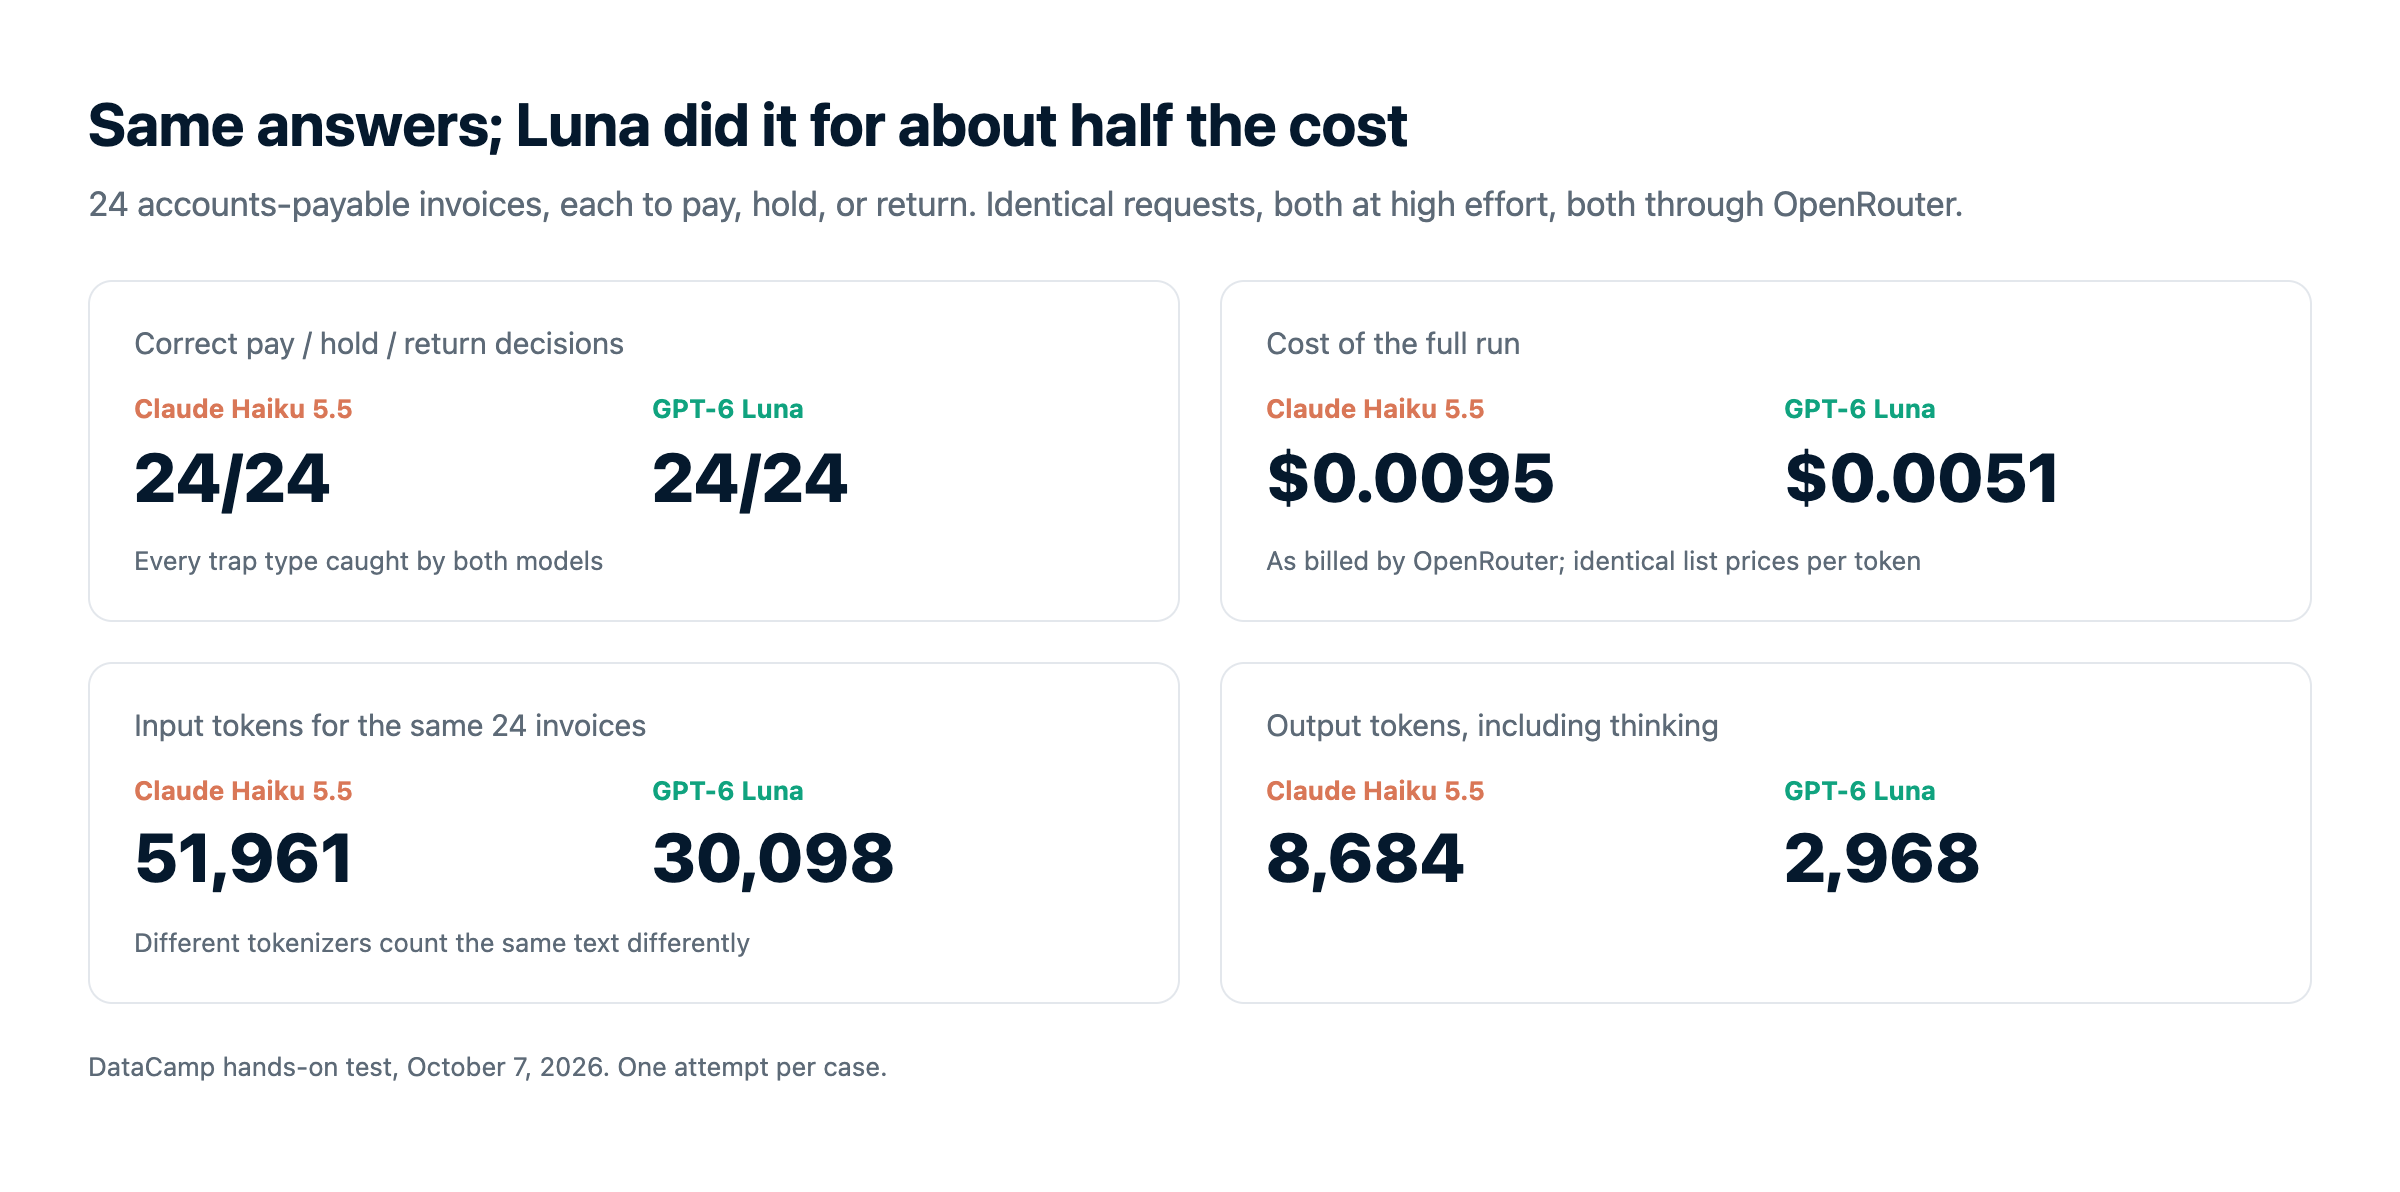
Hield het prijsoverzicht stand? Niet helemaal. Beide modellen deden alle 24 juiste beoordelingen, maar Luna deed het voor $0,0051 en Haiku 5.5 voor $0,0095, bijna het dubbele. Niets aan de tarieven verklaart dat. Het komt neer op tokens: Haiku’s tokenizer maakte van dezelfde facturen circa 73% meer tokens, en Haiku besteedde circa drie keer zoveel tokens aan denken vóór het antwoord.
Veranderde dat mijn mening? Gedeeltelijk. Ik vind nog steeds dat Haiku 5.5 het capabelere model is, en voor agents die software moeten bedienen, zou ik het nog steeds kiezen. Maar "dezelfde prijs" bleek misleidend.
Wanneer kies je Claude Haiku 5.5 vs GPT-6 Luna
Voor agents die software bedienen, weegt Haiku 5.5’s voorsprong van 23 punten op computergebruik zwaarder dan kosten. Voor goed gespecificeerde beslissingen op schaal gaf Luna in onze test dezelfde antwoorden voor ongeveer de halve prijs.
Kies Claude Haiku 5.5 als...
- Je agents bouwt die een computer of browser gebruiken. Het ligt ver voor op Luna bij computergebruik en terminaltaken in Anthropics benchmarks, en wordt geleverd met een tool voor browsergebruik.
- Je een goedkope subagent onder Sonnet 5.5 of Opus 5.5 nodig hebt. Het is gebouwd om binnen Claude-stacks te draaien en lezen, comprimeren en smalle subtaken af te handelen.
- Je werk open-einde, professionele taken zijn. Het leidt op GDPval-AA en AA-Briefcase, waar antwoorden niet simpele regelchecks zijn.
Kies GPT-6 Luna als...
- Je classificatie, extractie of routering op schaal draait. In onze test evenaarde het Haiku’s nauwkeurigheid voor ongeveer de halve kosten en merkbaar sneller.
- Je prompts regelmatig boven 100K tokens uitkomen. De prijzen voor lange prompts zijn veel milder dan Haiku’s vijfvoudige sprong.
- Je redeneren helemaal uit wilt. De
none-inspanningstand is de goedkoopste, snelste optie in beide line-ups. - Je al op OpenAI’s stack zit. Het zit in ChatGPT, Codex, GitHub Copilot en Azure.
Hoe je start met Claude Haiku 5.5 en GPT-6 Luna
| Surface | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Consumentenapp | Claude.ai (web, iOS, Android) op alle plannen, inclusief Free. | ChatGPT (Free en Go vanaf 8 oktober), ChatGPT Work en Codex |
| Eigen API | Claude API | OpenAI API (tools via de Responses API) |
| Cloudplatforms | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Codeeragents | Claude Code, Cursor | Codex, GitHub Copilot |
| Routers van derden | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| API-model-ID | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 heeft een bredere clouddekking, terwijl Luna een groter consumentenbereik heeft via ChatGPT. De API-model-ID’s zijn claude-haiku-5-5 en gpt-6-luna.
Je eerste API-call maken
De twee gebruiken verschillende SDK’s, dus overstappen betekent zowel de client als de modelstring wijzigen:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Voor een volledige walkthrough van keys en kosten, zie onze complete gids voor de Claude API.
Slotgedachten
Ik begon met het idee dat dit een makkelijke keuze was: Haiku 5.5 wint de benchmarks voor dezelfde prijs, dus kies Haiku. Na testen zou ik het anders formuleren. Gebruik Haiku 5.5 als de klus lastig genoeg is dat de extra capaciteit telt, zoals agents, browserautomatisering of open-einde werk. Gebruik GPT-6 Luna als de klus simpel en repetitief is, omdat dezelfde antwoorden minder kosten. Ik erken dat dit een kleine steekproef was en dat praktijkresultaten zullen variëren.
De les die ik meeneem gaat over prijsoverzichten, niet over deze twee modellen. Identieke per-token prijzen zeiden me bijna niets over wat ik daadwerkelijk zou betalen. Als kosten voor jou belangrijk zijn, laat je eigen taak door beide lopen en controleer de rekening.
Als je met een van beide wilt bouwen, raad ik onze cursus Introduction to Claude Models aan of het skill track OpenAI Fundamentals.