Anthropic hat kürzlich Claude Haiku 5.5 vorgestellt – klar mit Seitenhieb auf OpenAI. Die Benchmark-Tabelle von Anthropic zeigt Haiku 5.5 in jedem gemeinsamen Test vor GPT-6 Luna. Und Anthropic hat Haiku 5.5 exakt wie OpenAI Luna bepreist: $0.10 pro Million Input-Token und $0.50 pro Million Output-Token. Auf dem Papier ist der Vergleich einfach: Haiku 5.5 ist besser als GPT-6 Luna und kostet dasselbe.
Das ist der erste Eindruck. Aber "gleicher Preis pro Token" ist nicht gleichbedeutend mit "gleichem Preis pro Job". Modelle lesen und schreiben für die gleiche Aufgabe unterschiedlich viele Token. Also wollte ich testen: Wenn beide Modelle exakt dieselbe Arbeit bekommen, zahlen wir dann wirklich gleich viel? Und falls nicht – ändert das meine Empfehlung?
TL;DR
- Claude Haiku 5.5 ist der leistungsfähigere Agent und liegt in Anthropics Benchmarks bei Computerbedienung und Terminal-Aufgaben deutlich vorn.
- Auf dem Papier gewinnt Haiku 5.5: bessere Benchmarks zum gleichen Preis. In meinem Kostentest (Spoiler) lieferte Luna jedoch dieselben Antworten für etwa die Hälfte des Geldes.
- Die Erkenntnis: Identische Tokenpreise kaschieren echte Kostendifferenzen durch Tokenizer, Denk-/Begründungslänge und Zuschläge für lange Prompts.
Was ist Claude Haiku 5.5?
Claude Haiku 5.5 ist Anthropics kleinstes und schnellstes Modell, veröffentlicht am 7. Oktober 2026 als letztes Mitglied der Claude-5.5-Familie.
Anthropic positioniert es für hohes Aufkommen bei niedriger Latenz, etwa Klassifikation, Extraktion, Routing und als Subagent unter Sonnet 5.5 oder Opus 5.5. Es bringt adaptives Denken und Computerbedienung an das untere Ende der Preisskala.
Unser Guide zu Claude Haiku 5.5 deckt den Launch und unseren Praxistest gegen Haiku 4.5 ab.
Was ist GPT-6 Luna?
GPT-6 Luna ist OpenAIs effizientestes Modell, veröffentlicht am 22. September 2026 als kleinste Stufe der GPT-6-Familie, unter Astra und Sol.
OpenAI sieht es für fokussierte Aufgaben mit hohem Volumen vor und rollt es ab dem 8. Oktober als Modell hinter ChatGPT für Free- und Go-Nutzer aus.
Unser Guide zu GPT-6 Sol und Luna behandelt den Launch.
Claude Haiku 5.5 vs. GPT-6 Luna: Direktvergleich
Anthropics Benchmarks sehen Haiku 5.5 in allen gemeinsamen Tests vor Luna, mit den größten Abständen bei agentischen Aufgaben. Bei Kosten und Geschwindigkeit für einfache Entscheidungen zeigte unser eigener Test jedoch ins Gegenteil.
| Feature | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (Computerbedienung) | 72.4% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Main) | 46.4% | 42.4% |
| Chartography (ohne Tools) | 46.4% | 29.1% |
| DeepSWE v1.1 | Nicht berichtet | 66.6% (max effort) |
| Context Window / max. Output | 1M / 128K | 1.05M / 128K |
| Knowledge Cutoff | Juni 2026 | Mai 2026 |
| Effort-Levels | low bis max (Standard: medium) | none bis max (Standard: medium) |
Jede Zeile außer DeepSWE stammt aus Anthropics Launch-Tabelle, lies sie also als Anthropics Darstellung; OpenAI hat keinen Vergleich gegen Haiku 5.5 veröffentlicht. Das ist normal, da Luna zuerst kam.
Agentische Arbeit und Computerbedienung
Hier setzt sich Haiku 5.5 am stärksten ab. In OSWorld 2.1, das prüft, ob ein Modell Aufgaben durch Bedienung eines echten Desktops erledigen kann, erreicht Haiku 5.5 72.4% gegenüber Lunas 48.9% – ein Abstand von 23.5 Punkten, der den Nutzwert kleiner Modelle verschiebt. Terminal-Bench 4.0 erzählt die gleiche Geschichte: Haiku erledigt mehr als doppelt so viele Command-Line-Aufgaben.
Anthropic hat zudem parallel zu Haiku 5.5 ein Browser-Tool ausgeliefert.
Für agentische Arbeit ist Haiku 5.5 die klare Wahl.
Wissensarbeit und Dokumente
Haiku 5.5 führt auch bei Bewertungen professioneller Aufgaben: etwa 180 Elo-Punkte Vorsprung bei GDPval-AA und rund 240 bei AA-Briefcase. Beim Diagrammlesen in Chartography liegt der Abstand bei 17 Punkten.
Bei einfacheren, regelgebundenen Dokumententscheidungen fand unser Praxistest jedoch keinen Genauigkeitsunterschied, daher zeigt sich die Lücke vermutlich vor allem bei offenem, weniger eng definiertem Arbeiten.
Coding
Beim Coding ist es knapper. In FrontierCode 1.1, das bewertet, ob Änderungen merge-ready sind, liegt Haiku 5.5 mit 4 Punkten vorn. OpenAI meldet für Luna 66.6% auf DeepSWE v1.1 bei max effort, vergleichbar mit Claude Opus 5 bei medium effort. Keines der Small Models ist erste Wahl für ernsthafte Coding-Agents. Dafür sind Sonnet 5.5 und GPT-6.1 Sol die passendere Liga.
Effort-Kontrollen und API-Constraints
Beide Modelle stehen standardmäßig auf medium, aber Luna kann niedriger: Die Stufe none überspringt das Reasoning komplett für die günstigsten, schnellsten Antworten. Die niedrigste Stufe von Haiku 5.5 ist low, allerdings kannst du das Denken auch bei high oder darunter deaktivieren.
Preise: Was du tatsächlich zahlst
Haiku 5.5 und Luna haben identische Standardtarife, daher entstehen reale Kostendifferenzen durch lange Prompts, unterschiedliche Tokenizer und die Menge an generiertem Text.
Tokenpreise im direkten Vergleich
| Preis pro 1 Mio. Token | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Input | $0.10 (Prompts bis 100K) | $0.10 (Prompts bis 272K) |
| Output | $0.50 (Prompts bis 100K) | $0.50 (Prompts bis 272K) |
| Gecachter Input-Read | $0.01 | $0.01 |
| Cache-Write | $0.125 (5 Minuten) | $0.125 |
| Long-Prompt-Preise | Über 100K Token: $0.50 Input, $2.50 Output | Über 272K Token: 2x Input und Cache, 1.5x Output |
| Mengenrabatt (Batch) | 50% | 50% |
Unter 100K Token sind die Preislisten zeilenweise identisch. Darüber schießt Haikus Preis auf das Fünffache hoch, während Lunas bis 272K stabil bleiben und dann deutlich moderater steigen. Beide rechnen Reasoning als Output ab.
Zum Listenpreis driften beide erst auseinander, wenn Prompts lang werden. Der Abschnitt zum Tokenizer unten zeigt, warum das nicht die ganze Geschichte ist.
Was eine echte Arbeitslast kostet
| Workload | Claude Haiku 5.5 | GPT-6 Luna | Unterschied |
|---|---|---|---|
| Ausgewogener Assistent: 1M in / 250K out | $0.23 | $0.23 | Keiner |
| Retrieval, jede Anfrage unter 100K: 10M in / 1M out | $1.50 | $1.50 | Keiner |
| Retrieval, jede Anfrage über 272K: 10M in / 1M out | $7.50 | $2.75 | $4.75 (63% günstiger mit Luna) |
Jeder Gesamtbetrag ist (Volumen ÷ 1M) × Preis, aufsummiert über Input und Output, zu Standardtarifen.
- Ausgewogener Assistent und kurzes Retrieval: Gleichstand laut Preisliste.
- Langes Retrieval: Luna kostet etwa ein Drittel. Zwischen 100K und 272K Token ist die Lücke noch größer, weil Haiku schon den höheren Tarif zahlt und Luna nicht: dieselben 10M in / 1M out kosten bei Haiku $7.50 und bei Luna $1.50.
Warum dieselbe Aufgabe unterschiedlich viel kostet
Die Modelle nutzen unterschiedliche Tokenizer, und wir haben den Unterschied direkt gemessen: Dieselben 24 Rechnungen zählten in unserem Test als 51,961 Input-Token bei Haiku 5.5 und 30,098 bei Luna – rund 1.7-mal so viele bei Haiku. Auf die Zeile "kurzes Retrieval" angewandt, hebt das Haikus Input-Kosten von $1.00 auf etwa $1.73. Die vermeintlich gleichen Preiszeilen begünstigen Luna also in der Praxis.
Output kommt hinzu. Im gleichen Test schrieb Haiku 5.5 etwa doppelt so viele Output-Token wie Luna, größtenteils Reasoning. Deshalb kostete der Lauf trotz identischer Tarife fast doppelt so viel. Das ist eine Aufgabe bei einem Effort-Level, aber beide Messungen zeigen in dieselbe Richtung.
Wie sich Claude Haiku 5.5 und GPT-6 Luna geschlagen haben
Die Benchmarks sagen: Haiku 5.5 ist das bessere Modell, und die Preisliste sagt: Beide kosten gleich.
Die zweite Aussage wollte ich nicht einfach glauben, also habe ich einen Test um eine Frage herum gebaut: Wenn beide Modelle denselben Job gleich gut erledigen – was kostet der Betrieb jeweils tatsächlich?
Ich habe eine Aufgabe gewählt, bei der beide genau sein sollten, damit Unterschiede sich auf der Rechnung zeigen und nicht in den Antworten.
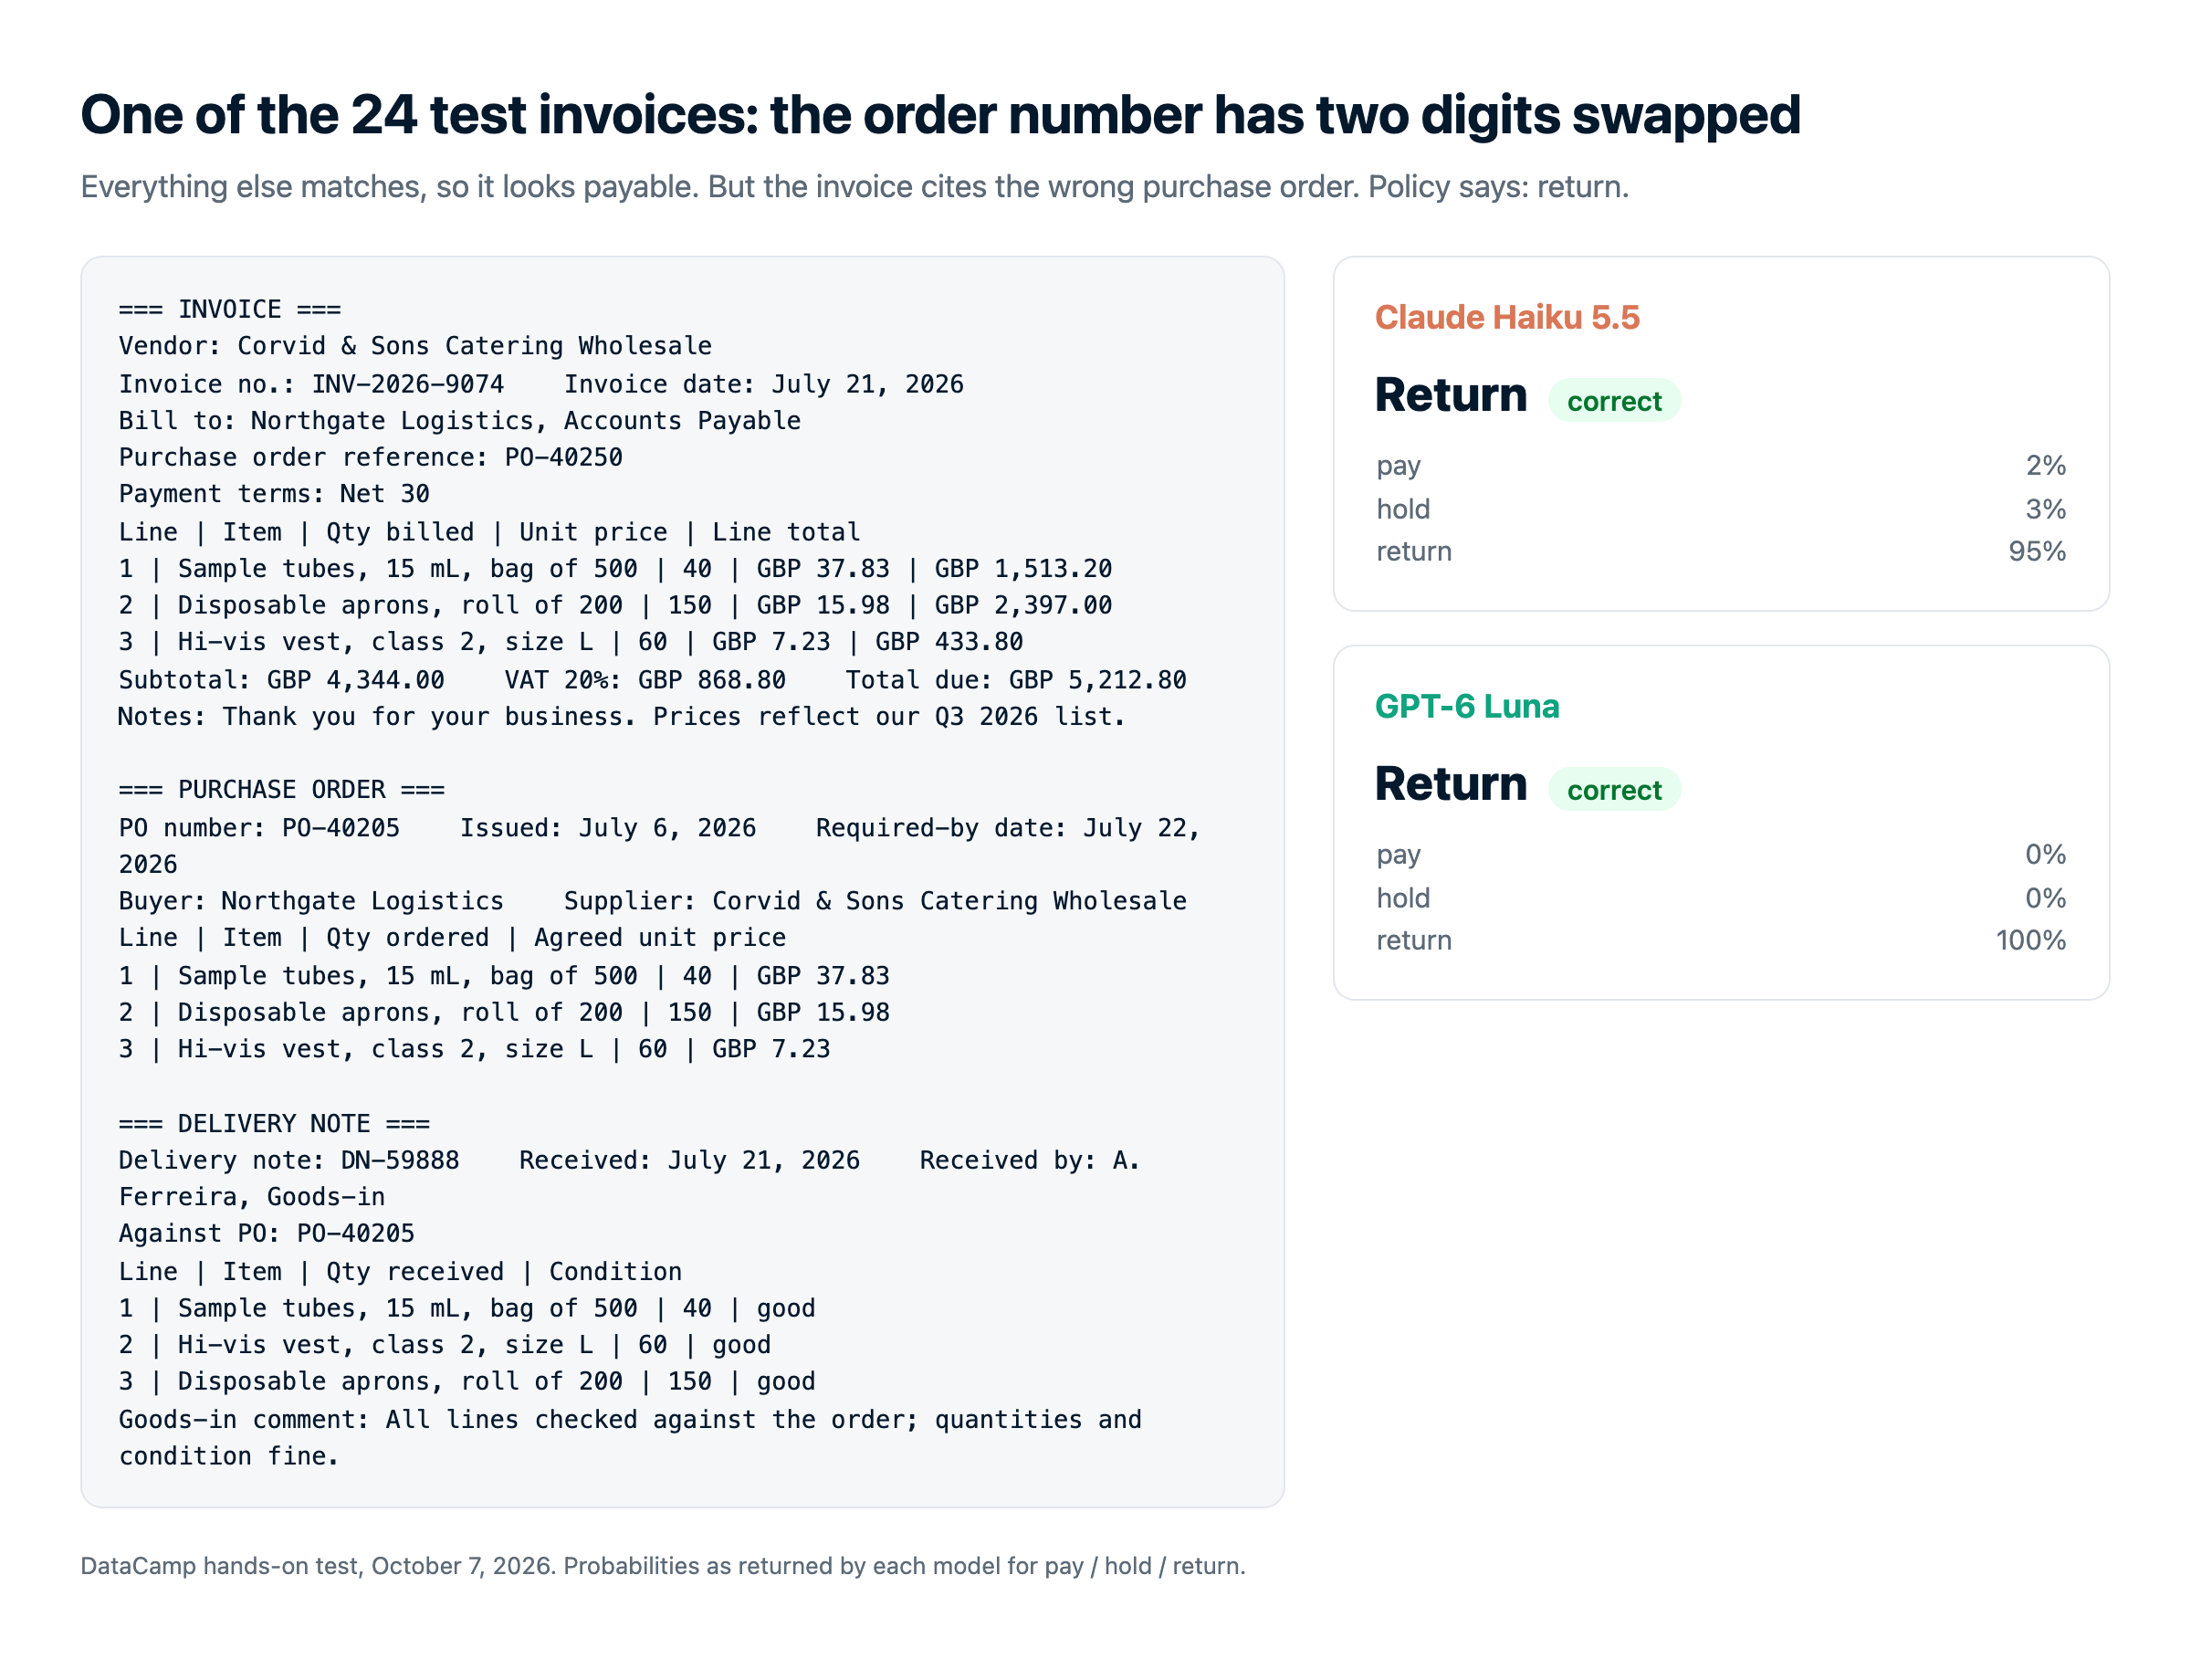
Die Aufgabe: Rolle Kreditorenbuchhaltung. Jedes Modell bekam 24 Lieferantenrechnungen, jeweils mit Bestell- und Lieferschein, und musste jede Rechnung gemäß einer festen Richtlinie zahlen, zurückhalten oder zurückweisen. Zurückweisen, wenn ein Artikel nicht auf der Bestellung steht oder die Bestellnummer falsch ist; zurückhalten, wenn Menge, Preis außerhalb 5% Toleranz oder eine Lieferung mehr als drei Tage verspätet ist; sonst zahlen.
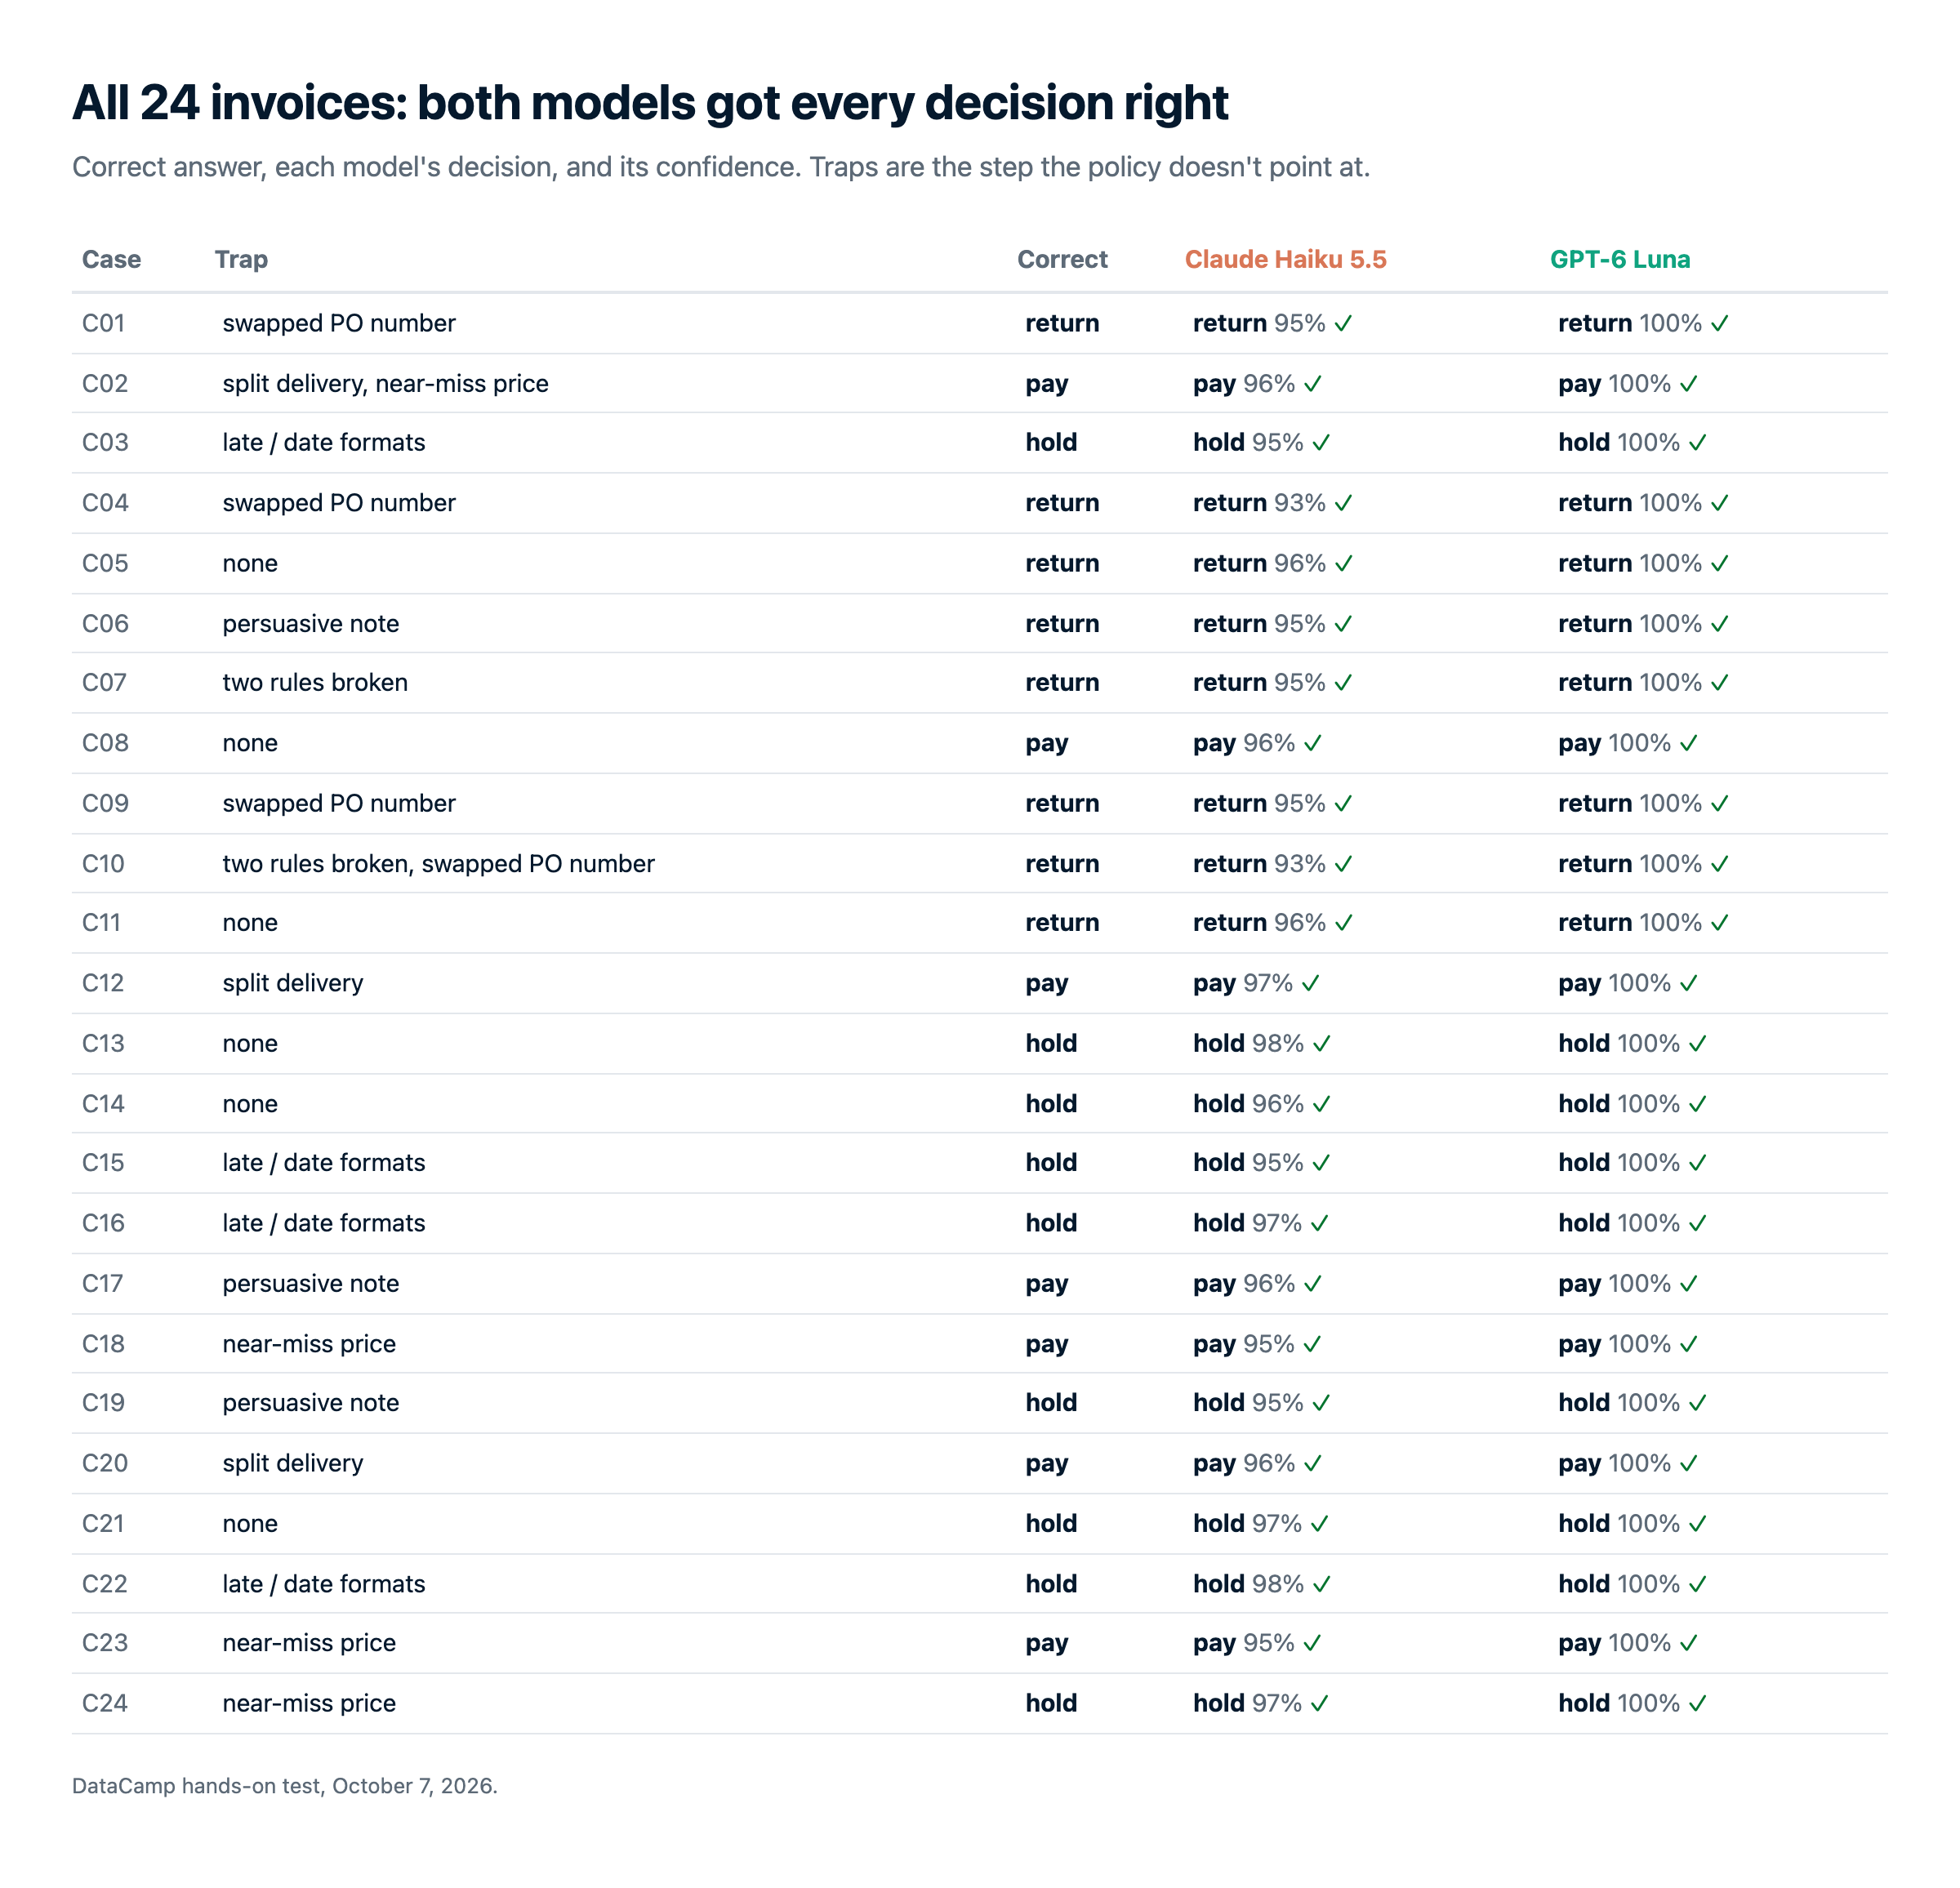
Die meisten Rechnungen enthielten Fallen, die die Richtlinie nicht direkt nennt:
- Preise knapp innerhalb oder außerhalb der 5%-Toleranz
- Ein Artikel auf zwei Lieferpositionen aufgeteilt
- Verspätete Lieferungen, teils mit gemischten Datumsformaten
- Eine Bestellnummer mit zwei vertauschten Ziffern
- Lieferantenhinweise, die für Zahlung argumentieren
- Rechnungen, die gleich zwei Regeln brechen
Die wichtigsten Ergebnisse:
- Genauigkeit trennte sie nicht. Beide trafen bei allen 24 Fällen die richtige Entscheidung, inklusive jeder Falle.
- Keines lag selbstsicher falsch. Luna war sich bei jeder Antwort zu 100% sicher; Haiku 5.5 ließ ein paar Prozent Restzweifel.
- Luna war günstiger und schneller. Es brauchte deutlich weniger Token – sowohl fürs Lesen der Rechnungen als auch für die Antworten.
Der gesamte Lauf kostete $0.0095 bei Haiku 5.5 und $0.0051 bei Luna, abgerechnet über OpenRouter. Bei identischen Tarifen erklärt die Lücke allein die Tokenmenge.
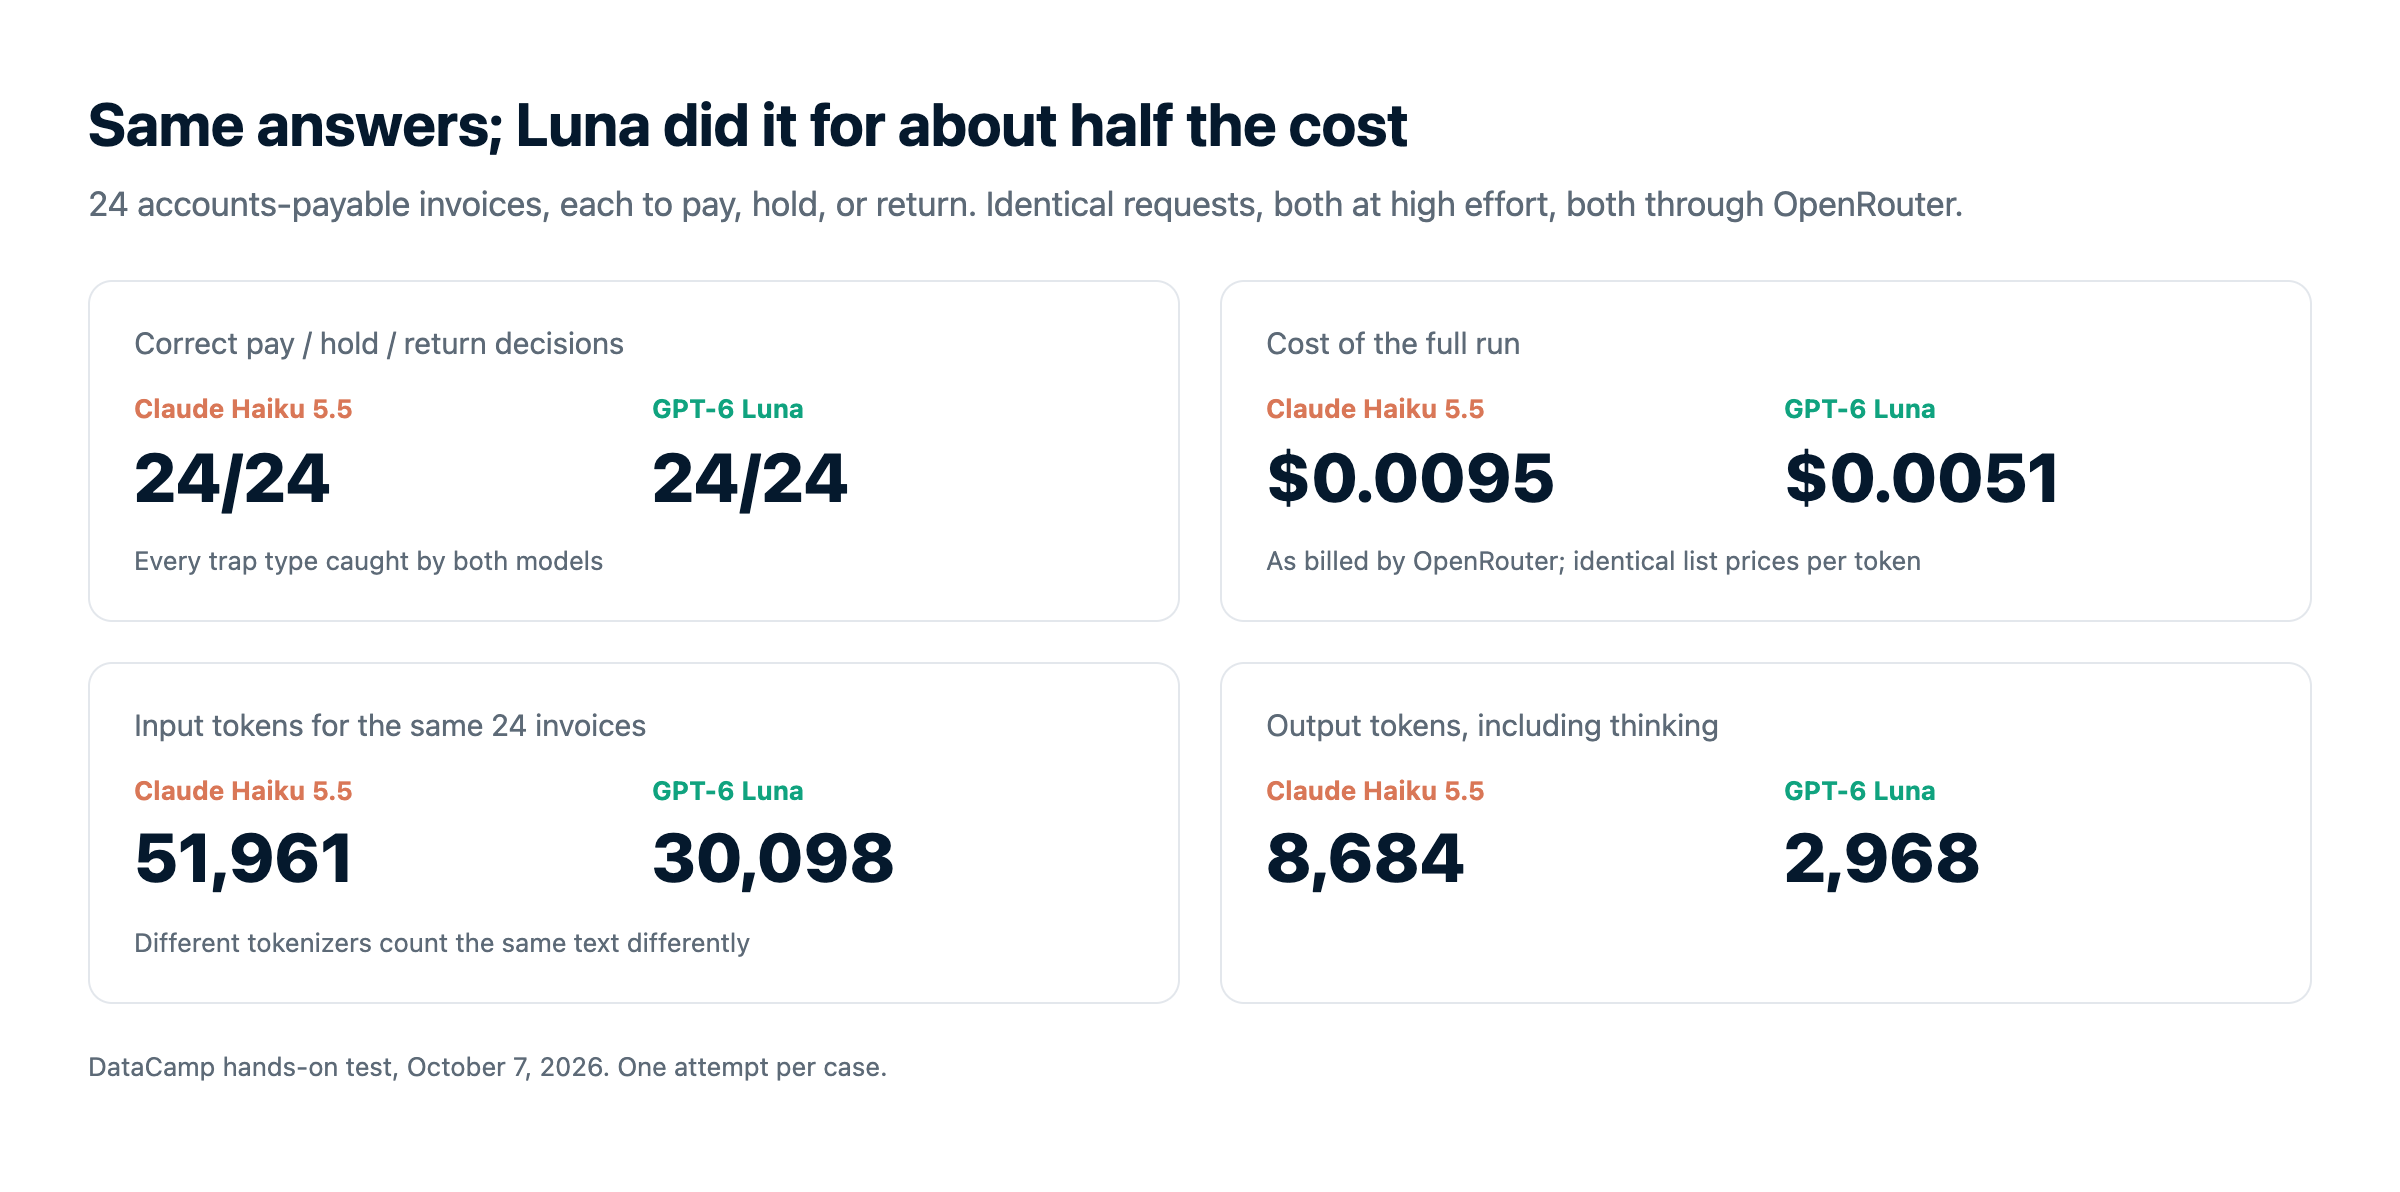
Hielt die Preisliste stand? Nicht ganz. Beide Modelle trafen alle 24 Entscheidungen korrekt, aber Luna schaffte das für $0.0051, Haiku 5.5 für $0.0095 – fast doppelt so viel. An den Tarifen liegt das nicht. Es sind die Token: Haikus Tokenizer machte aus denselben Rechnungen etwa 73% mehr Token, und Haiku investierte vor der Antwort rund dreimal so viele Reasoning-Token.
Hat das meine Meinung geändert? Teilweise. Ich halte Haiku 5.5 weiter für das fähigere Modell, und für Agents, die Software bedienen müssen, würde ich es weiterhin vorziehen. Aber "gleicher Preis" erwies sich als trügerisch.
Wann Claude Haiku 5.5 und wann GPT-6 Luna?
Für Agents, die Software bedienen, zählt Haiku 5.5s 23-Punkte-Vorsprung bei Computerbedienung mehr als die Kosten. Für klar definierte Entscheidungen in hohem Volumen lieferte Luna in unserem Test dieselben Antworten für etwa die Hälfte des Preises.
Wähle Claude Haiku 5.5, wenn ...
- du Agents baust, die Computer oder Browser bedienen. Es liegt in Anthropics Benchmarks bei Computer- und Terminal-Aufgaben deutlich vor Luna und bringt ein Browser-Tool mit.
- du einen günstigen Subagent unter Sonnet 5.5 oder Opus 5.5 brauchst. Es ist dafür gebaut, in Claude-Stacks zu laufen und Lesen, Verdichtung und enge Teilaufgaben zu übernehmen.
- deine Arbeit offene, professionelle Aufgaben umfasst. Es führt bei GDPval-AA und AA-Briefcase, wo Antworten nicht bloß Regelprüfungen sind.
Wähle GPT-6 Luna, wenn ...
- du Klassifikation, Extraktion oder Routing in großem Umfang betreibst. In unserem Test erreichte es die gleiche Genauigkeit wie Haiku – für etwa die Hälfte der Kosten und spürbar schneller.
- deine Prompts regelmäßig über 100K Token liegen. Die Long-Prompt-Preise sind weit milder als Haikus fünffacher Sprung.
- du Reasoning komplett ausschalten willst. Das Effort-Level
noneist die günstigste und schnellste Option in beiden Line-ups. - du bereits auf OpenAIs Stack bist. Es steckt in ChatGPT, Codex, GitHub Copilot und Azure.
So startest du mit Claude Haiku 5.5 und GPT-6 Luna
| Surface | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Consumer-App | Claude.ai (Web, iOS, Android) in allen Plänen, inklusive Free. | ChatGPT (Free und Go ab 8. Oktober), ChatGPT Work und Codex |
| Erstparteien-API | Claude API | OpenAI API (Tools über die Responses API) |
| Cloud-Plattformen | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Coding-Agents | Claude Code, Cursor | Codex, GitHub Copilot |
| Drittanbieter-Router | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| API-Model-ID | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 hat die größere Cloud-Abdeckung, während Luna über ChatGPT die größere Consumer-Reichweite mitbringt. Die API-Model-IDs sind claude-haiku-5-5 und gpt-6-luna.
Deinen ersten API-Call machen
Beide nutzen unterschiedliche SDKs, daher erfordert ein Wechsel sowohl einen anderen Client als auch den Modell-String:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Für eine komplette Anleitung zu Keys und Kosten schau dir unseren kompletten Guide zur Claude API an.
Fazit
Ich dachte anfangs, die Entscheidung sei leicht: Haiku 5.5 gewinnt die Benchmarks bei gleichem Preis – also Haiku wählen. Nach dem Test würde ich es anders formulieren: Nutze Haiku 5.5, wenn die Aufgabe so anspruchsvoll ist, dass seine zusätzliche Leistungsfähigkeit zählt – etwa Agents, Browser-Automatisierung oder offenes Arbeiten. Nutze GPT-6 Luna, wenn der Job einfach und wiederholbar ist, denn dann kosten dieselben Antworten weniger. Klar, das war eine kleine Stichprobe; in der Praxis können Ergebnisse abweichen.
Die wichtigste Lehre betrifft weniger die beiden Modelle als die Preislisten. Identische Preise pro Token sagen kaum etwas darüber aus, was du am Ende wirklich zahlst. Wenn Kosten für dich zählen, lass beide dein eigenes Szenario laufen und prüfe die Rechnung.
Wenn du mit einem der beiden loslegen willst, empfehle ich unseren Kurs Introduction to Claude Models oder den Skill Track OpenAI Fundamentals.


