Anthropic vừa ra mắt Claude Haiku 5.5, như một lời thách thức gửi tới OpenAI. Bảng benchmark Anthropic công bố cho thấy Haiku 5.5 vượt GPT-6 Luna ở mọi hàng nơi cả hai cùng xuất hiện. Anthropic cũng định giá Haiku 5.5 y hệt Luna của OpenAI: $0.10 cho mỗi triệu token đầu vào và $0.50 cho mỗi triệu token đầu ra. Trên giấy tờ, so sánh rất đơn giản. Haiku 5.5 tốt hơn GPT-6 Luna và giá như nhau.
Đó là kết luận nhanh. Nhưng "giá theo token giống nhau" không đồng nghĩa với "giá theo công việc giống nhau". Các mẫu sẽ đọc và viết số token khác nhau cho cùng một nhiệm vụ. Vậy nên tôi nghĩ sẽ thú vị nếu kiểm tra: nếu tôi giao cùng một khối việc cho cả hai, chúng thực sự có chi phí như nhau không? Và nếu không, liệu tôi có đổi ý?
TL;DR
- Claude Haiku 5.5 là tác nhân mạnh hơn, dẫn sâu ở bài toán dùng máy tính và tác vụ terminal trong benchmark của Anthropic.
- Trên giấy tờ, Haiku 5.5 thắng: benchmark tốt hơn với cùng mức giá. Nhưng trong bài test chi phí của tôi (tiết lộ trước), Luna cho câu trả lời tương đương với khoảng một nửa chi phí.
- Bài học: Giá theo token giống hệt có thể che giấu chênh lệch chi phí thực từ tokenizer, độ dài suy luận và phụ phí cho prompt dài.
Claude Haiku 5.5 là gì?
Claude Haiku 5.5 là mẫu nhỏ nhất và nhanh nhất của Anthropic, phát hành ngày 7 tháng 10, 2026, là thành viên cuối của dòng Claude 5.5.
Anthropic định vị model này cho khối lượng lớn, nhạy độ trễ như phân loại, trích xuất, định tuyến, và chạy như một tiểu tác nhân dưới Sonnet 5.5 hoặc Opus 5.5; đồng thời mang tư duy thích ứng và khả năng dùng máy tính xuống mức giá thấp nhất.
Hướng dẫn Claude Haiku 5.5 của chúng tôi bao quát buổi ra mắt và thử nghiệm thực tế so với Haiku 4.5.
GPT-6 Luna là gì?
GPT-6 Luna là mẫu hiệu quả nhất của OpenAI, phát hành ngày 22 tháng 9, 2026, là bậc nhỏ nhất trong họ GPT-6, dưới Astra và Sol.
OpenAI định vị Luna cho các tác vụ tập trung, khối lượng lớn, và sẽ triển khai làm model phía sau ChatGPT cho người dùng Free và Go từ ngày 8 tháng 10.
Hướng dẫn GPT-6 Sol và Luna của chúng tôi bao quát buổi ra mắt.
Claude Haiku 5.5 vs. GPT-6 Luna: Đối đầu trực tiếp
Benchmark của Anthropic đặt Haiku 5.5 dẫn Luna ở mọi hàng cả hai cùng có, với khoảng cách lớn nhất ở tác vụ agentic. Về chi phí và tốc độ cho quyết định đơn giản, thử nghiệm của chúng tôi lại cho kết quả ngược.
| Tính năng | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (dùng máy tính) | 72.4% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 16.4% |
| GDPval-AA v2.1 (Elo) | 1620 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 1336 |
| FrontierCode 1.1 (Chính) | 46.4% | 42.4% |
| Chartography (không dùng công cụ) | 46.4% | 29.1% |
| DeepSWE v1.1 | Không báo cáo | 66.6% (mức nỗ lực tối đa) |
| Cửa sổ ngữ cảnh / đầu ra tối đa | 1M / 128K | 1.05M / 128K |
| Mốc kiến thức | Tháng 6/2026 | Tháng 5/2026 |
| Mức nỗ lực | thấp đến tối đa (mặc định trung bình) | không đến tối đa (mặc định trung bình) |
Mọi hàng trừ DeepSWE đều đến từ bảng ra mắt của Anthropic, nên hãy xem đó là lập luận của Anthropic; OpenAI chưa công bố so sánh với Haiku 5.5. Điều này bình thường vì Luna ra trước.
Công việc agentic và dùng máy tính
Đây là nơi Haiku 5.5 vượt xa nhất. Trên OSWorld 2.1, bài kiểm tra khả năng hoàn thành nhiệm vụ bằng cách vận hành một máy tính để bàn thực, Haiku 5.5 đạt 72.4% so với 48.9% của Luna, khoảng cách 23.5 điểm làm thay đổi phạm vi hữu ích của một mẫu nhỏ. Terminal-Bench 4.0 kể câu chuyện tương tự, với Haiku hoàn thành hơn gấp đôi số tác vụ dòng lệnh.
Anthropic cũng phát hành một công cụ dùng trình duyệt cùng với Haiku 5.5.
Cho công việc agentic, Haiku 5.5 là lựa chọn rõ ràng.
Công việc tri thức và tài liệu
Haiku 5.5 cũng dẫn trên các đánh giá tác vụ chuyên nghiệp: hơn khoảng 180 điểm Elo trên GDPval-AA và khoảng 240 trên AA-Briefcase. Đọc biểu đồ trên Chartography cho thấy chênh 17 điểm.
Tuy nhiên, với các quyết định tài liệu đơn giản, ràng buộc bằng quy tắc, thử nghiệm thực tế của chúng tôi không thấy khác biệt độ chính xác, nên khoảng cách có lẽ chủ yếu xuất hiện ở công việc mở.
Lập trình
Lập trình sít sao hơn. Trên FrontierCode 1.1, chấm xem thay đổi đã sẵn sàng để merge chưa, Haiku 5.5 dẫn 4 điểm. OpenAI báo Luna đạt 66.6% trên DeepSWE v1.1 ở mức nỗ lực tối đa, tương đương Claude Opus 5 ở mức trung bình. Cả hai mẫu nhỏ đều không phải lựa chọn hàng đầu cho tác nhân lập trình nghiêm túc. Việc đó hợp hơn với Sonnet 5.5 và GPT-6.1 Sol.
Điều khiển nỗ lực và ràng buộc API
Cả hai mặc định ở mức nỗ lực trung bình, nhưng Luna xuống thấp hơn: thiết lập none bỏ qua hoàn toàn suy luận để có câu trả lời rẻ và nhanh nhất. Mức nỗ lực thấp nhất của Haiku 5.5 là low, dù bạn vẫn có thể tắt suy nghĩ ở high hoặc thấp hơn.
Giá: số tiền bạn thực sự trả
Haiku 5.5 và Luna có biểu giá tiêu chuẩn giống hệt, nên khác biệt chi phí thực đến từ prompt dài, tokenizer và lượng model viết ra.
Tỷ lệ theo token đặt cạnh nhau
| Tỷ lệ, trên mỗi 1M token | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Đầu vào | $0.10 (prompt đến 100K) | $0.10 (prompt đến 272K) |
| Đầu ra | $0.50 (prompt đến 100K) | $0.50 (prompt đến 272K) |
| Đọc cache | $0.01 | $0.01 |
| Ghi cache | $0.125 (5 phút) | $0.125 |
| Giá cho prompt dài | Trên 100K token: $0.50 đầu vào, $2.50 đầu ra | Trên 272K token: gấp 2 lần đầu vào và cache, 1.5 lần đầu ra |
| Giảm giá lô | 50% | 50% |
Dưới 100K token, bảng giá giống nhau từng dòng. Vượt mức này, giá Haiku tăng gấp năm lần, trong khi Luna giữ nguyên đến 272K token rồi tăng ít hơn nhiều. Cả hai đều tính phần suy luận vào đầu ra.
Theo giá niêm yết, hai bên chỉ chênh khi prompt dài. Phần tokenizer bên dưới cho thấy vì sao đó chưa phải toàn bộ câu chuyện.
Chi phí của một khối công việc thực
| Khối công việc | Claude Haiku 5.5 | GPT-6 Luna | Chênh lệch |
|---|---|---|---|
| Trợ lý cân bằng: 1M vào / 250K ra | $0.23 | $0.23 | Không |
| Truy xuất, mỗi yêu cầu dưới 100K: 10M vào / 1M ra | $1.50 | $1.50 | Không |
| Truy xuất, mỗi yêu cầu trên 272K: 10M vào / 1M ra | $7.50 | $2.75 | $4.75 (Luna rẻ hơn 63%) |
Mỗi tổng là (khối lượng ÷ 1M) × tỷ lệ, cộng giữa đầu vào và đầu ra, theo giá tiêu chuẩn.
- Trợ lý cân bằng và truy xuất ngắn: hòa tuyệt đối trên bảng giá.
- Truy xuất dài: Luna tốn khoảng một phần ba. Khoảng cách còn rộng hơn giữa 100K và 272K token, khi Haiku đã bị tính mức cao hơn còn Luna thì chưa: cùng 10M vào / 1M ra tốn $7.50 trên Haiku so với $1.50 trên Luna.
Vì sao cùng một tác vụ lại có chi phí khác nhau
Hai model dùng tokenizer khác nhau, và chúng tôi đo trực tiếp chênh lệch: cùng 24 hóa đơn trong thử nghiệm thực tế tính thành 51,961 token đầu vào trên Haiku 5.5 và 30,098 trên Luna, tức khoảng 1.7 lần nhiều hơn trên Haiku. Áp vào hàng truy xuất ngắn, điều đó nâng chi phí đầu vào của Haiku từ $1.00 lên khoảng $1.73, nên các hàng "giá như nhau" ở trên trên thực tế nghiêng về Luna.
Đầu ra còn cộng thêm. Trong cùng thử nghiệm, Haiku 5.5 viết khoảng gấp đôi token đầu ra so với Luna, chủ yếu là phần suy luận, đó là lý do chi phí chạy gần gấp đôi dù giá niêm yết giống nhau. Đó là một tác vụ ở một mức nỗ lực, nhưng hướng chênh lệch nhất quán ở cả hai phép đo.
Kết quả hoạt động của Claude Haiku 5.5 và GPT-6 Luna
Các benchmark phía trên nói Haiku 5.5 là model tốt hơn, và bảng giá nói hai bên có chi phí như nhau.
Tôi không muốn tin điều thứ hai chỉ bằng niềm tin, nên đã thiết kế một bài test xoay quanh một câu hỏi: nếu cả hai model làm cùng một việc tốt như nhau, thì mỗi bên thực sự tốn bao nhiêu để chạy?
Tôi chọn một công việc mà cả hai đều nên chính xác, để mọi khác biệt hiện lên trên hóa đơn chứ không phải trong câu trả lời.
Nhiệm vụ: đóng vai bộ phận phải trả. Mỗi model nhận 24 hóa đơn nhà cung cấp, mỗi hóa đơn kèm đơn đặt hàng và phiếu giao hàng tương ứng, và phải quyết định thanh toán, giữ lại, hay trả lại theo một chính sách cố định. Trả lại nếu món hàng không có trong đơn hoặc sai số đơn; giữ lại nếu sai số lượng, giá vượt dung sai 5%, hoặc giao hàng trễ hơn ba ngày; còn lại thì thanh toán.
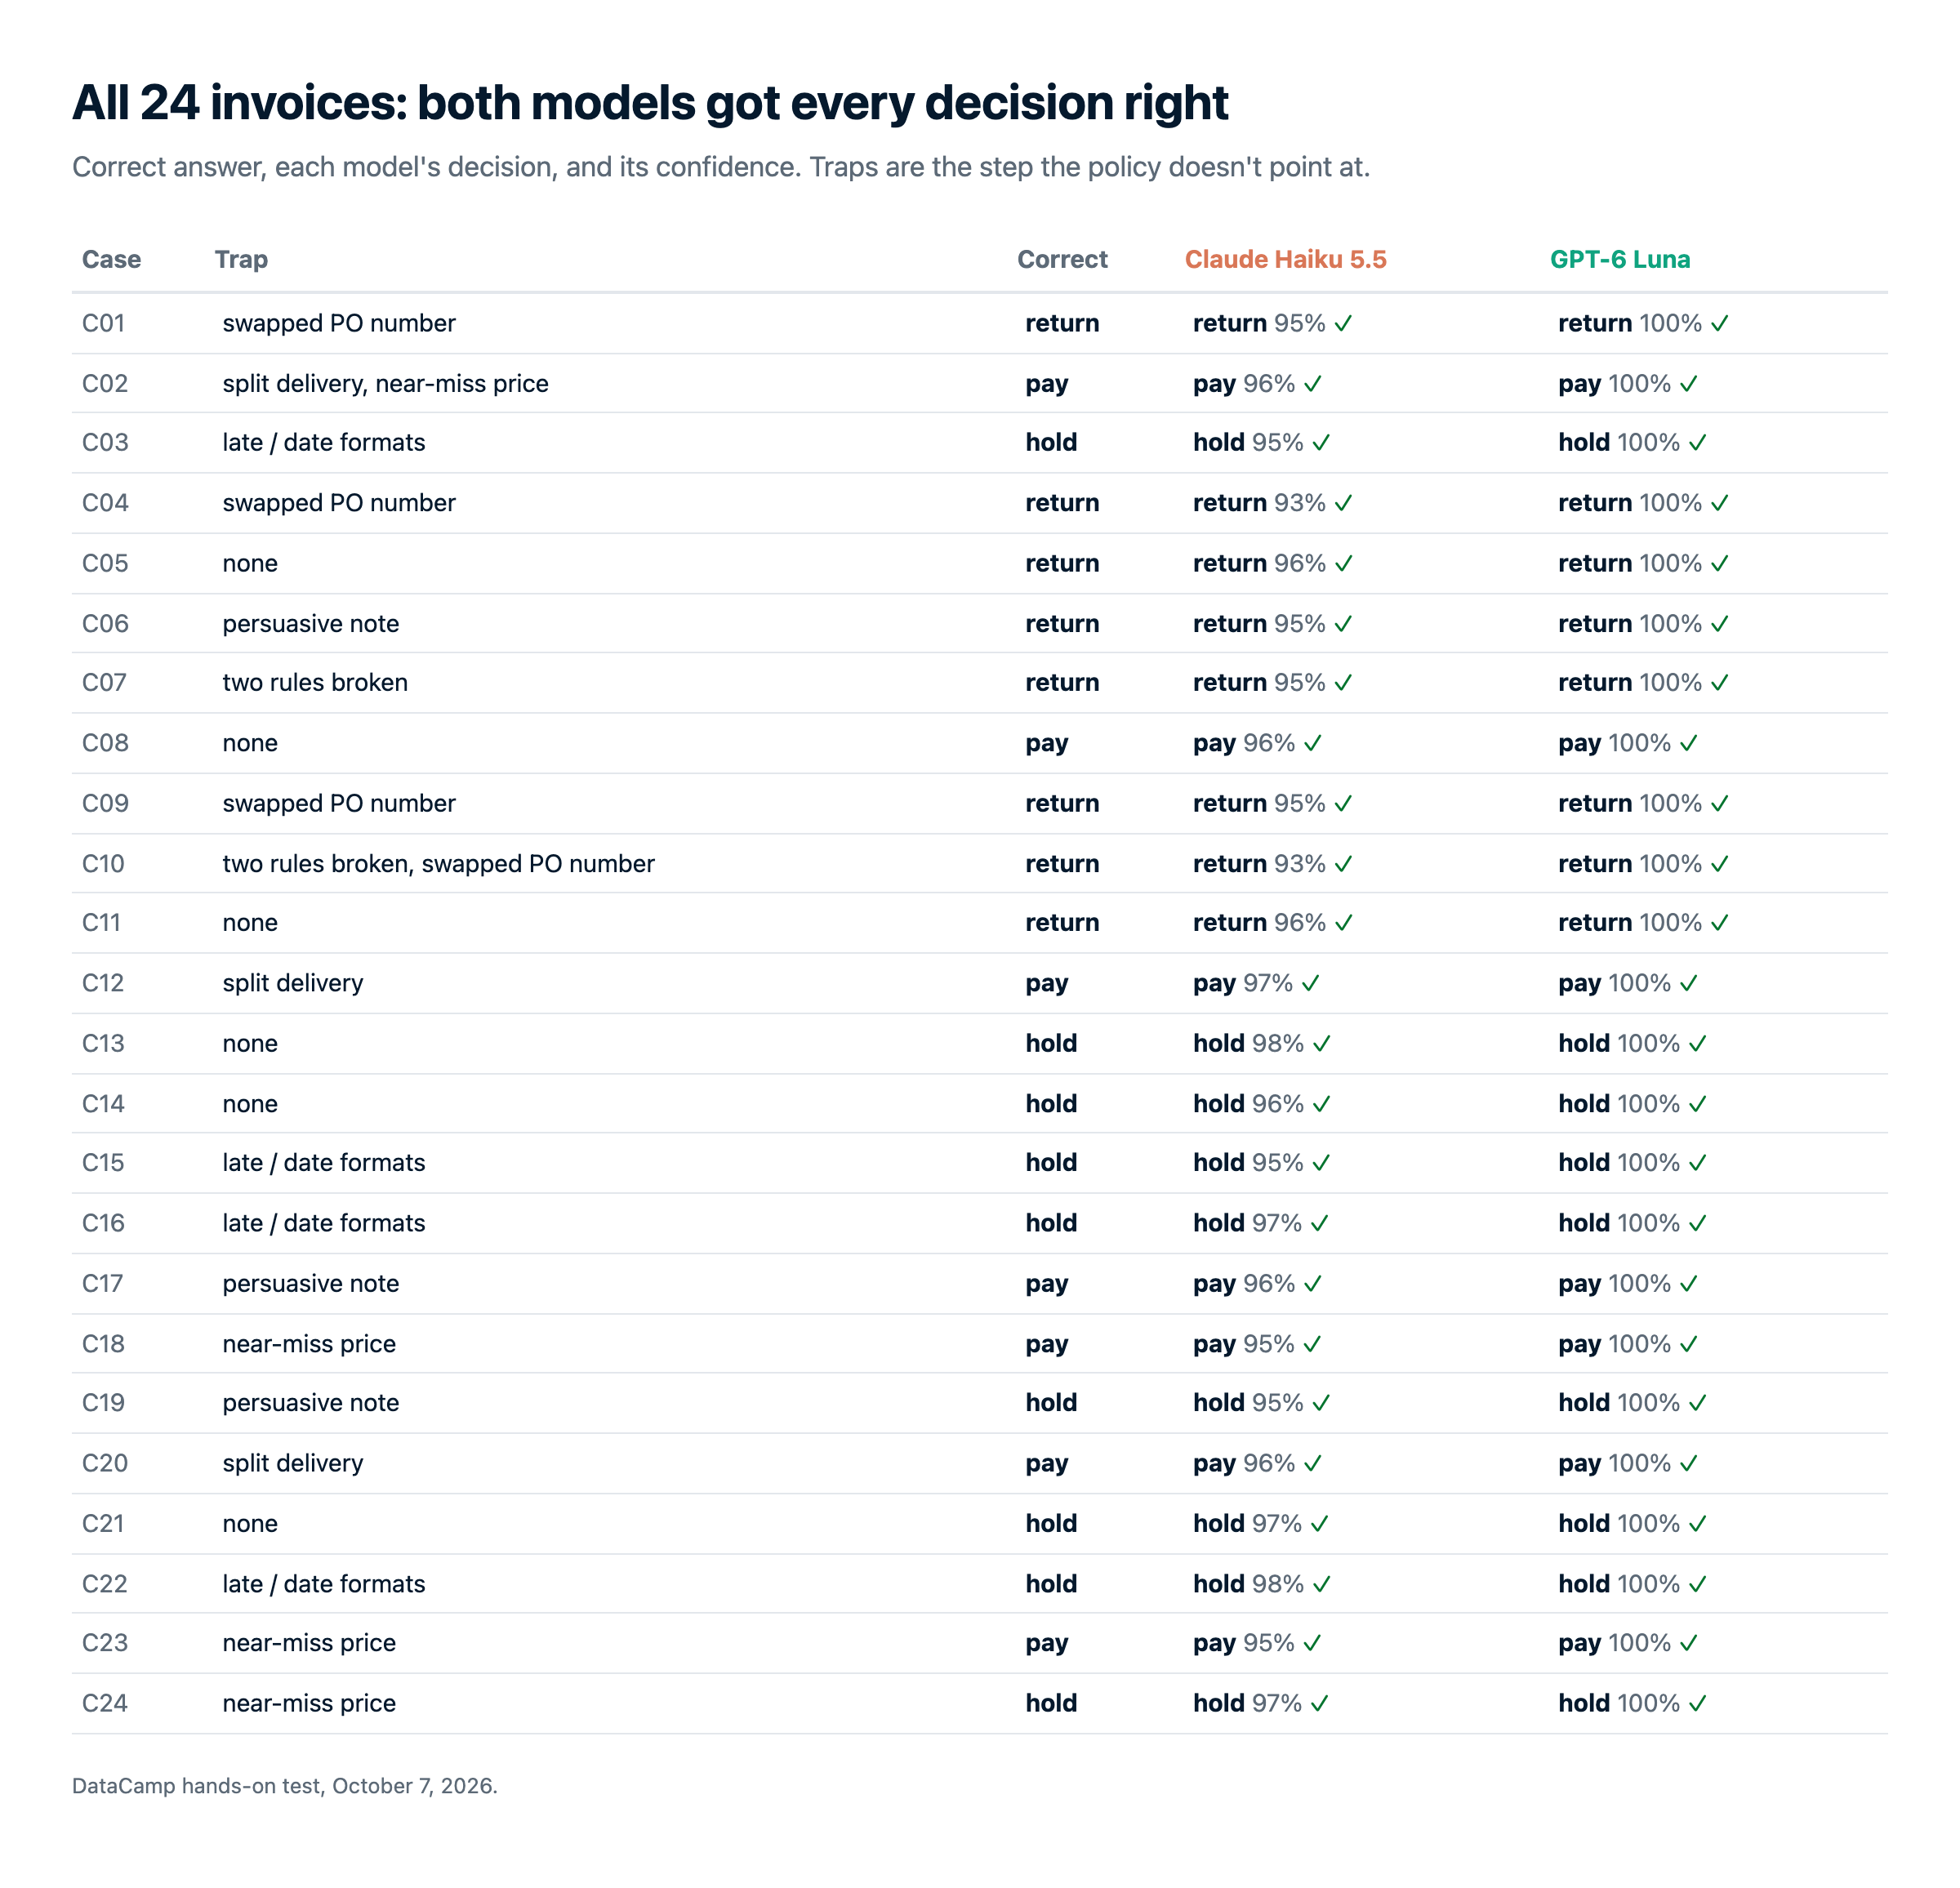
Phần lớn hóa đơn giấu bẫy mà chính sách không chỉ rõ:
- Giá vừa trong hoặc vượt sát ngưỡng dung sai 5%
- Một mặt hàng bị tách thành hai dòng giao
- Giao trễ, có mẫu định dạng ngày tháng lẫn lộn
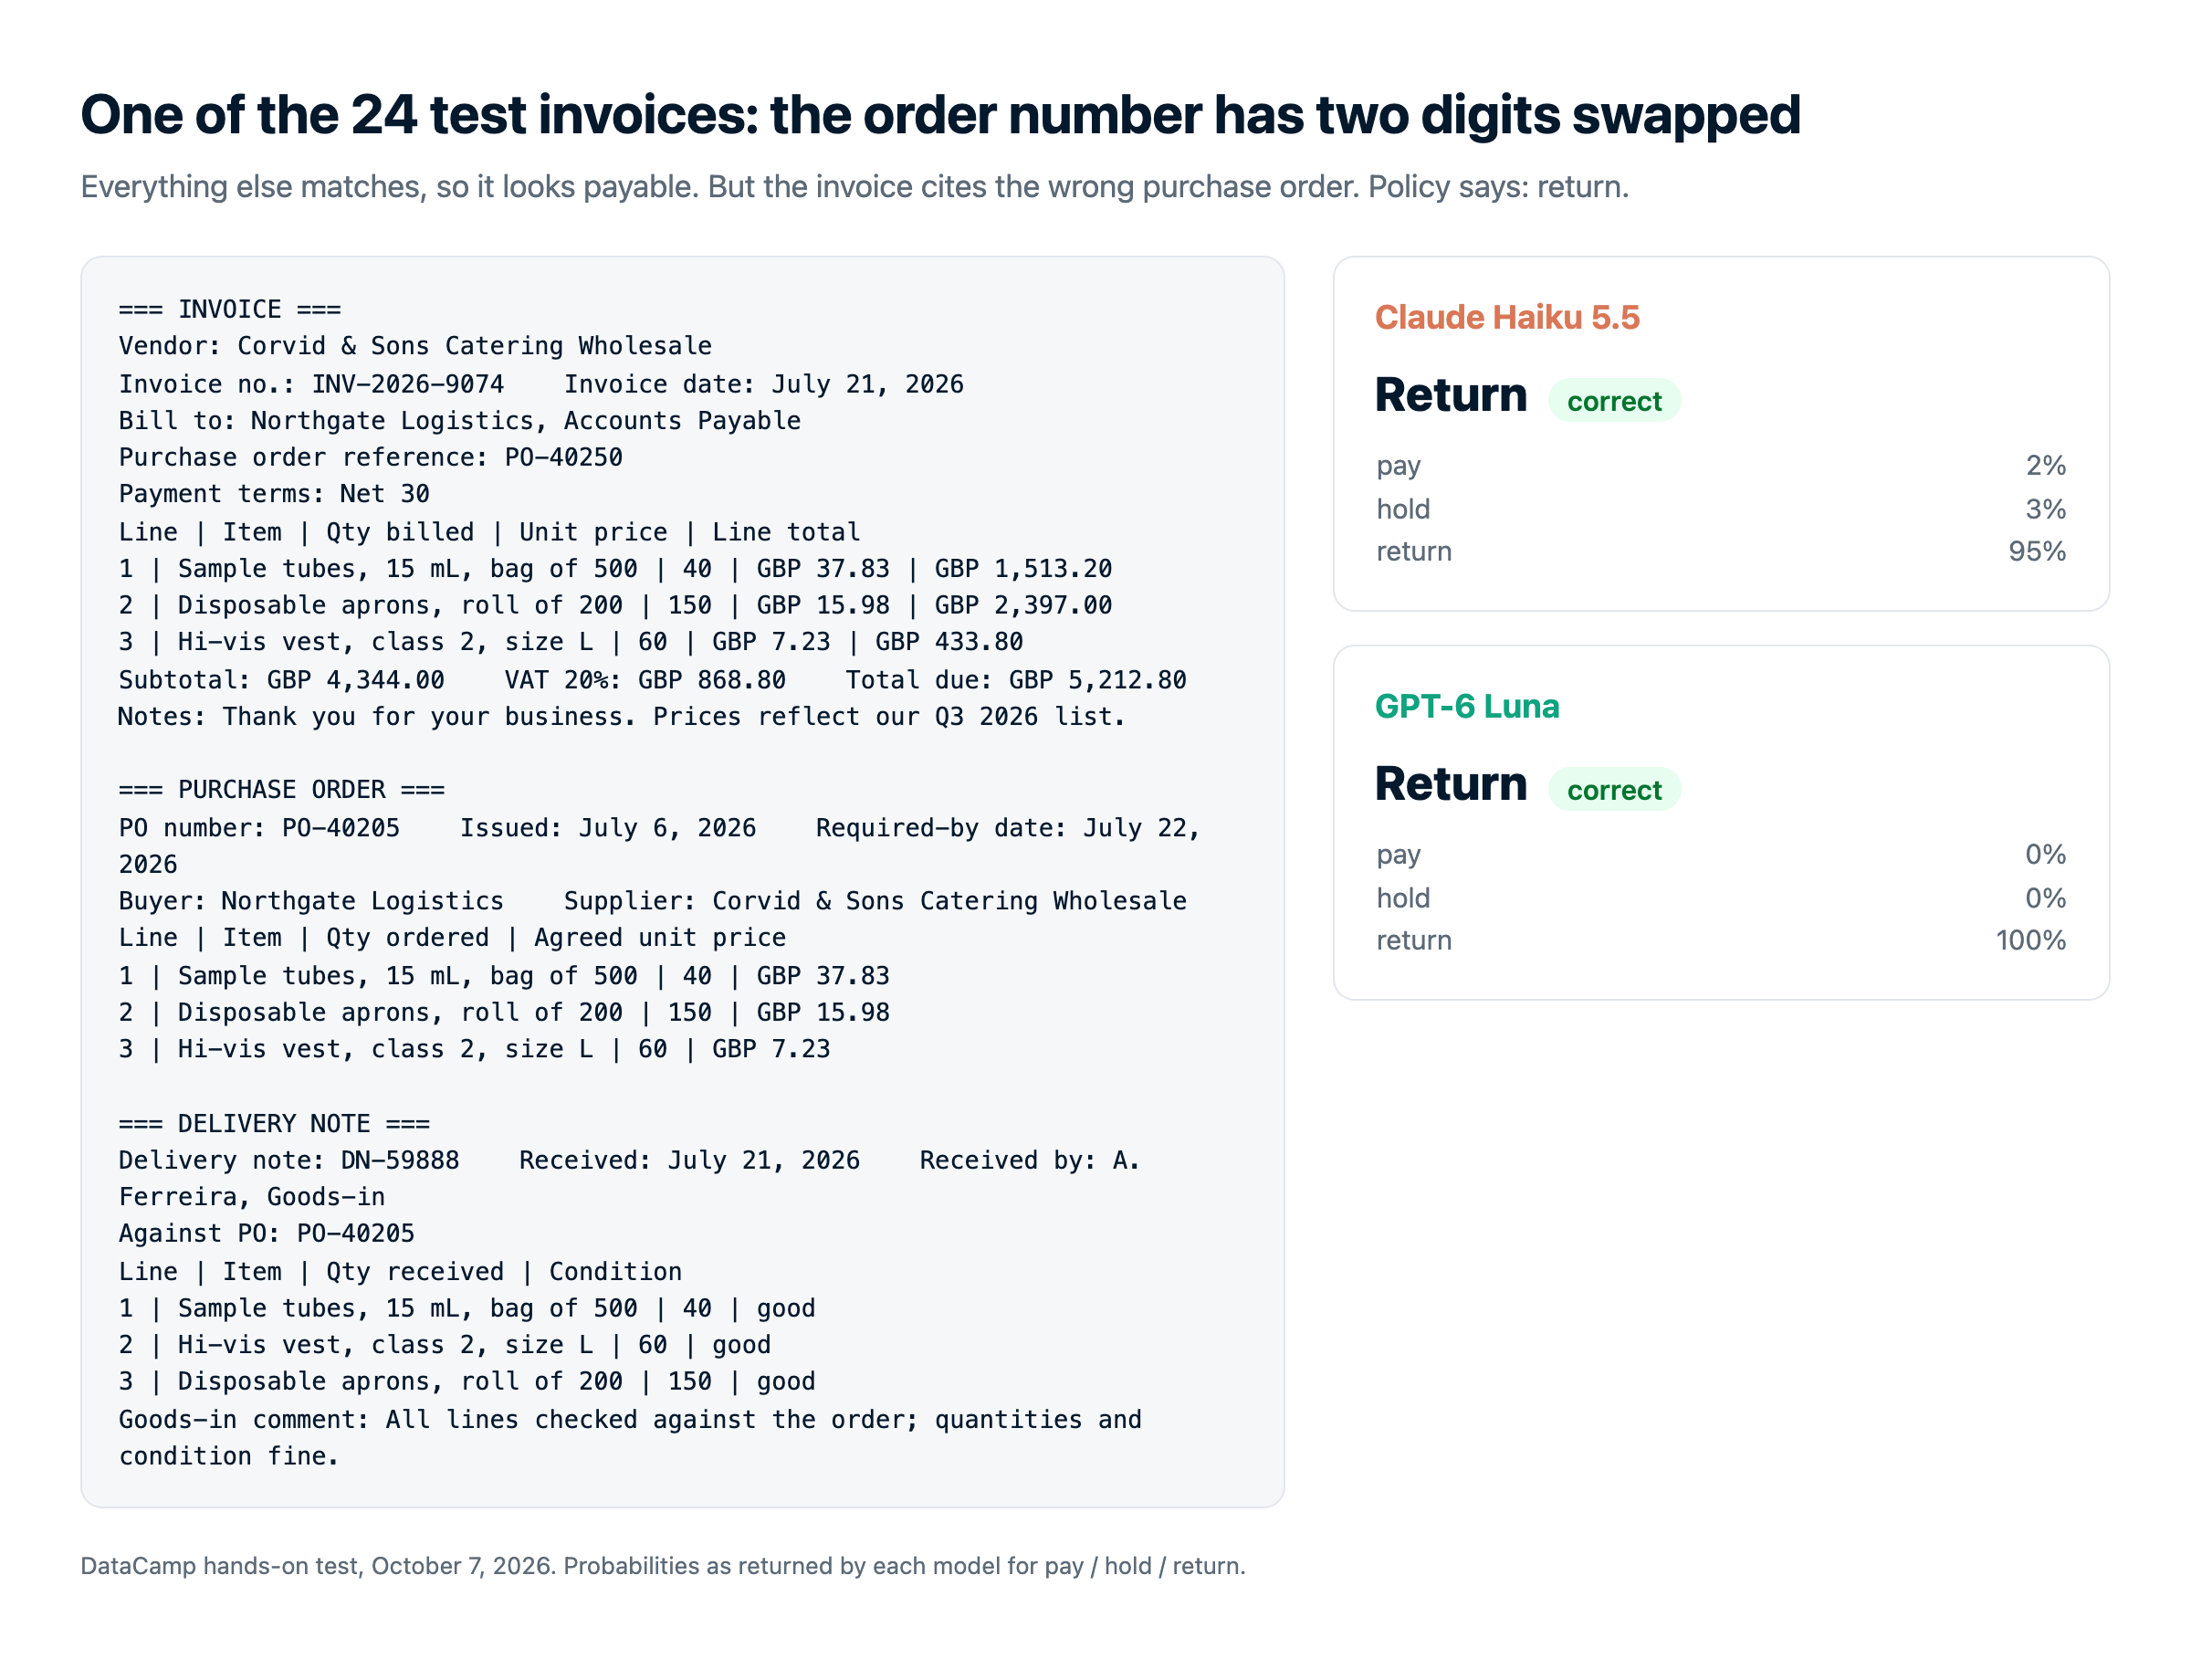
- Số đơn đặt hàng bị tráo hai chữ số
- Ghi chú từ nhà cung cấp lập luận đòi thanh toán
- Hóa đơn vi phạm hai quy tắc cùng lúc
Kết quả chính:
- Độ chính xác không phân định được. Cả hai đều ra đúng 24/24 quyết định, kể cả mọi bẫy.
- Không bên nào sai một cách tự tin. Luna tự tin 100% cho mọi câu trả lời; Haiku 5.5 giữ lại vài phần trăm nghi ngờ.
- Luna rẻ hơn và nhanh hơn. Nó cần ít token hơn nhiều, cả để đọc hóa đơn lẫn để trả lời.
Toàn bộ lượt chạy tốn $0.0095 trên Haiku 5.5 và $0.0051 trên Luna, theo hóa đơn của OpenRouter. Với mức giá giống hệt, toàn bộ chênh lệch đến từ token.
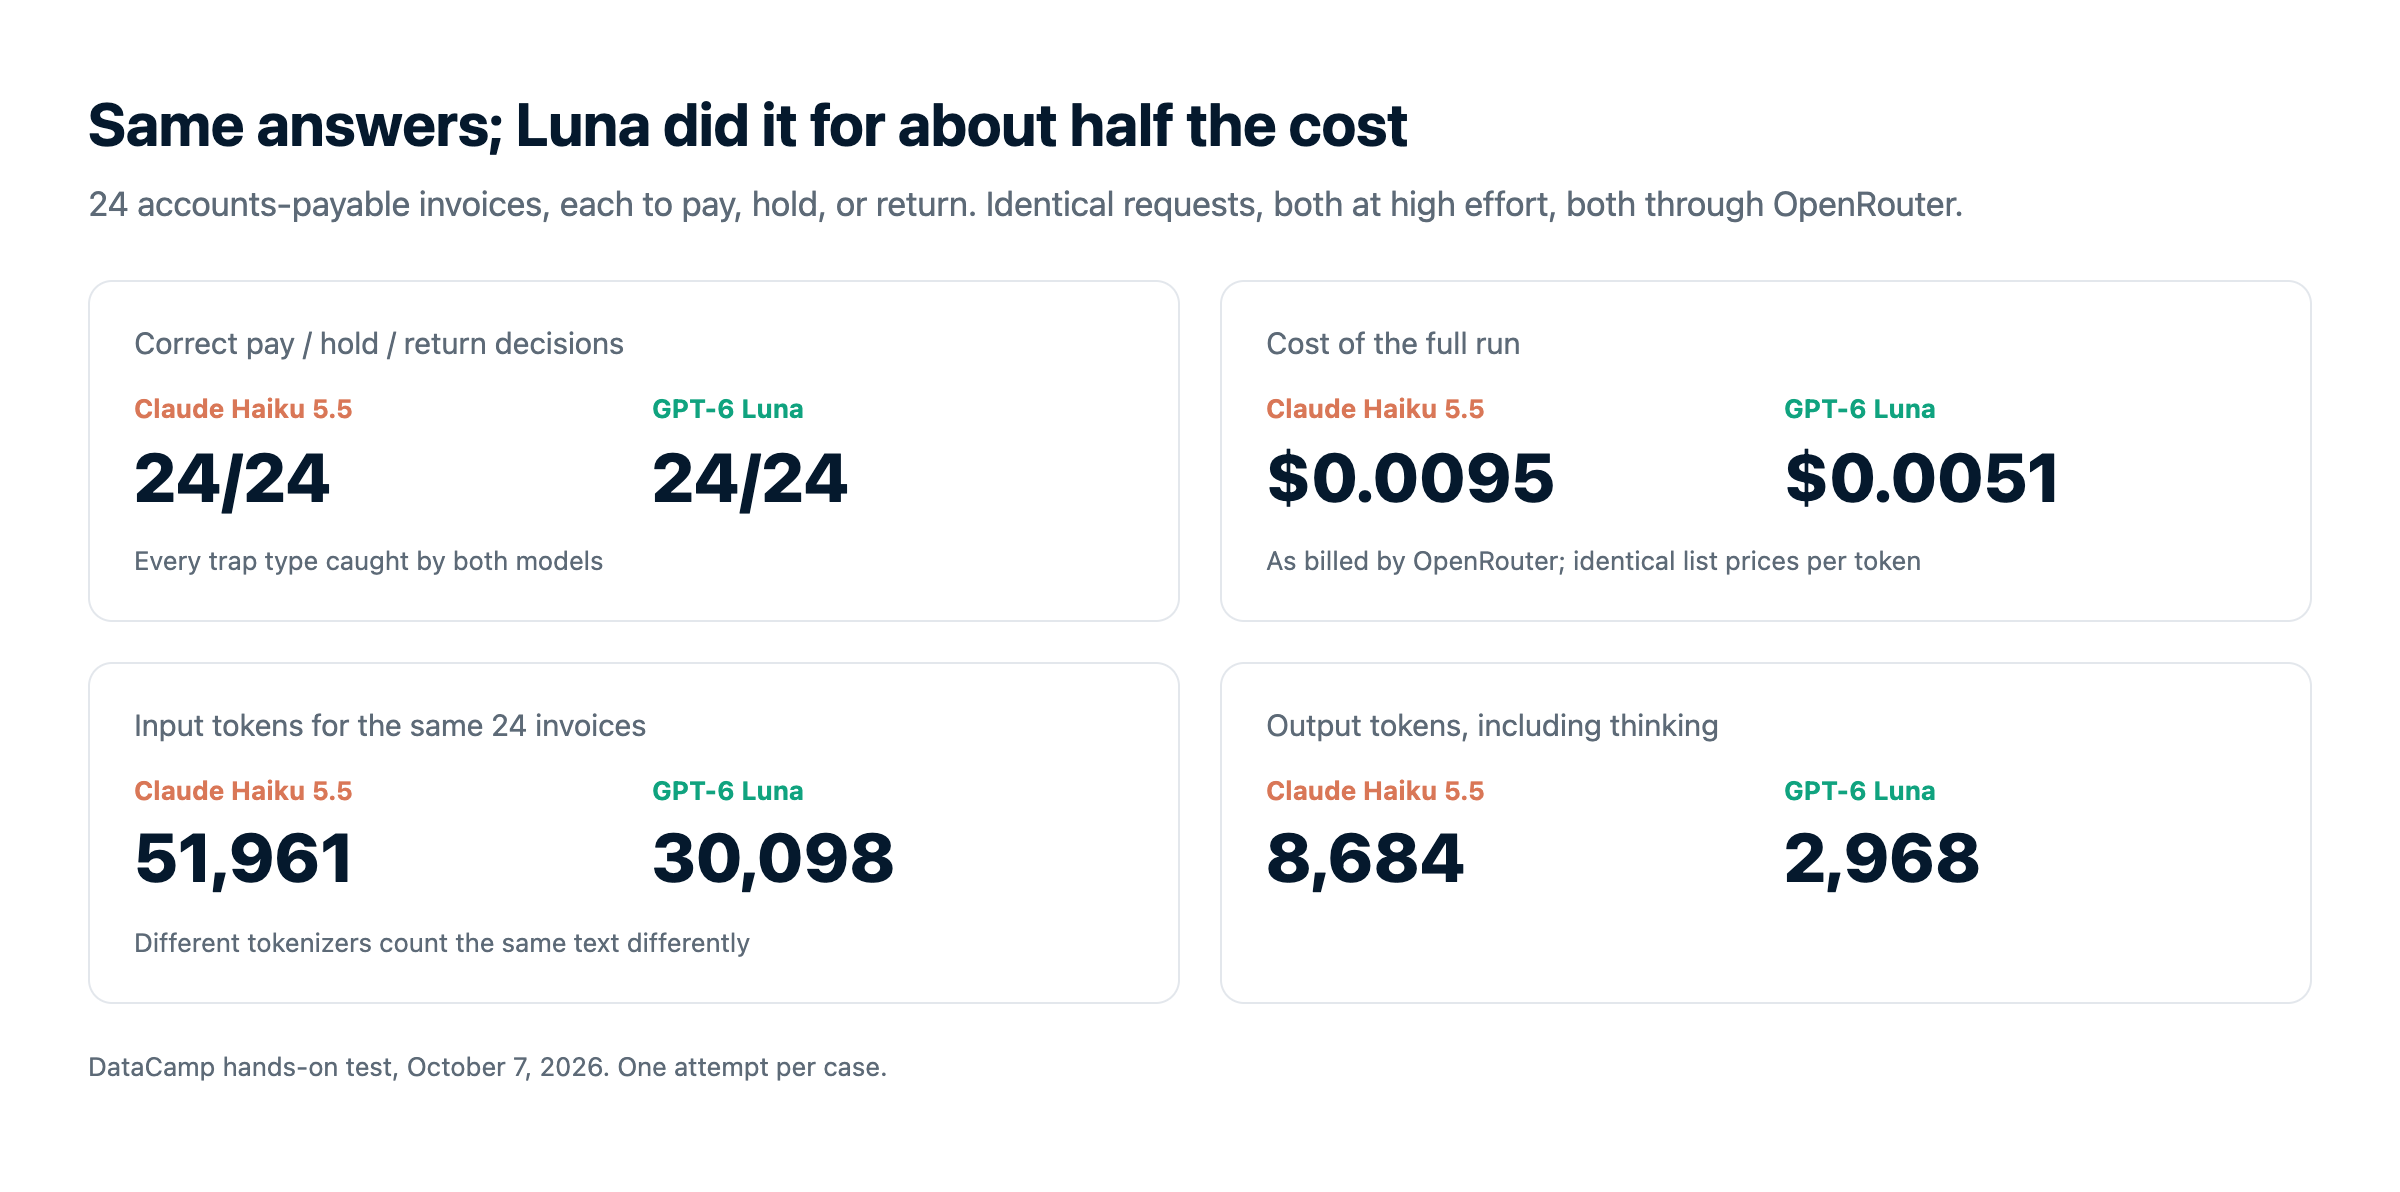
Vậy bảng giá có đứng vững? Không hẳn. Cả hai đều đưa ra 24 quyết định đúng, nhưng Luna làm điều đó với $0.0051 còn Haiku 5.5 là $0.0095, gần gấp đôi. Không có gì trong biểu giá giải thích điều này. Tất cả là do token: tokenizer của Haiku biến cùng số hóa đơn thành nhiều hơn khoảng 73% token, và Haiku tiêu khoảng gấp ba số token để suy nghĩ trước khi trả lời.
Điều đó có khiến tôi đổi ý? Một phần. Tôi vẫn nghĩ Haiku 5.5 là model mạnh hơn, và cho tác nhân cần vận hành phần mềm, tôi vẫn chọn nó. Nhưng "giá như nhau" hóa ra gây hiểu lầm.
Khi nào nên chọn Claude Haiku 5.5 và khi nào chọn GPT-6 Luna
Với tác nhân vận hành phần mềm, khoảng cách 23 điểm của Haiku 5.5 ở khả năng dùng máy tính quan trọng hơn chi phí. Với các quyết định xác định tốt ở quy mô lớn, Luna trong thử nghiệm của chúng tôi cho cùng câu trả lời với khoảng một nửa chi phí.
Chọn Claude Haiku 5.5 nếu...
- Bạn xây tác nhân dùng máy tính hoặc trình duyệt. Nó dẫn Luna một khoảng lớn ở khả năng dùng máy tính và tác vụ terminal trong benchmark của Anthropic, và đi kèm công cụ dùng trình duyệt.
- Bạn cần một tiểu tác nhân rẻ dưới Sonnet 5.5 hoặc Opus 5.5. Nó được thiết kế để ngồi trong stack dựa trên Claude và xử lý đọc, nén và các tiểu nhiệm vụ hẹp.
- Công việc của bạn là tác vụ chuyên nghiệp mở. Nó dẫn trên GDPval-AA và AA-Briefcase, nơi câu trả lời không chỉ là kiểm tra quy tắc đơn giản.
Chọn GPT-6 Luna nếu...
- Bạn chạy phân loại, trích xuất hoặc định tuyến ở quy mô lớn. Trong thử nghiệm của chúng tôi, nó khớp độ chính xác của Haiku với chi phí khoảng một nửa và nhanh hơn đáng kể.
- Prompt của bạn thường vượt 100K token. Giá cho prompt dài của nó nhẹ nhàng hơn nhiều so với cú nhảy gấp năm lần của Haiku.
- Bạn muốn tắt hẳn suy luận. Thiết lập nỗ lực
nonelà phương án rẻ và nhanh nhất ở cả hai dải sản phẩm. - Bạn đã ở trong stack OpenAI. Nó có mặt trong ChatGPT, Codex, GitHub Copilot và Azure.
Cách bắt đầu với Claude Haiku 5.5 và GPT-6 Luna
| Bề mặt | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Ứng dụng người dùng | Claude.ai (web, iOS, Android) trên mọi gói, kể cả Miễn phí. | ChatGPT (Miễn phí và Go từ ngày 8/10), ChatGPT Work và Codex |
| API chính chủ | Claude API | OpenAI API (công cụ qua Responses API) |
| Nền tảng đám mây | Amazon Bedrock, Google Cloud, Microsoft Foundry | Azure AI Foundry |
| Tác nhân lập trình | Claude Code, Cursor | Codex, GitHub Copilot |
| Router bên thứ ba | OpenRouter (anthropic/claude-haiku-5.5) |
OpenRouter (openai/gpt-6-luna) |
| ID model API | claude-haiku-5-5 |
gpt-6-luna |
Haiku 5.5 có độ phủ đám mây rộng hơn, còn Luna có tầm với người dùng lớn hơn qua ChatGPT. ID model API là claude-haiku-5-5 và gpt-6-luna.
Thực hiện cuộc gọi API đầu tiên
Hai bên dùng SDK khác nhau, nên chuyển đổi đồng nghĩa đổi cả client lẫn chuỗi model:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=1024,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
reasoning={"effort": "low"},
input="Classify this ticket as billing, bug, or feature request: ...",
)
print(response.output_text)Để có hướng dẫn đầy đủ về khóa và chi phí, xem hướng dẫn hoàn chỉnh về Claude API của chúng tôi.
Kết luận
Lúc đầu tôi nghĩ đây là một lựa chọn dễ: Haiku 5.5 thắng benchmark với cùng mức giá, vậy hãy chọn Haiku. Sau khi thử nghiệm, tôi sẽ nói khác đi. Dùng Haiku 5.5 khi công việc đủ khó để năng lực vượt trội của nó phát huy tác dụng, như tác nhân, tự động hóa trình duyệt, hoặc công việc mở. Dùng GPT-6 Luna khi công việc đơn giản và lặp lại, vì câu trả lời tương đương sẽ rẻ hơn. Tôi thừa nhận đây là mẫu nhỏ, và thực tế có thể khác biệt.
Bài học tôi rút ra là về bảng giá, không phải hai model này. Giá theo token giống hệt nói với tôi gần như chẳng gì về số tiền tôi sẽ thực sự trả. Nếu chi phí quan trọng với bạn, hãy chạy chính tác vụ của mình qua cả hai và xem hóa đơn.
Nếu bạn muốn bắt tay xây dựng với một trong hai, tôi gợi ý khóa Introduction to Claude Models hoặc lộ trình kỹ năng OpenAI Fundamentals.
