Kurs
ggplot2 ile Veri Görselleştirmeye Giriş
4 sa
191.2K
Bu eğitimde, R programlama dilinde histogram oluşturma ve özelleştirme süreçlerini adım adım göstereceğim. Histogram nedir, verinizi nasıl hazırlarsınız, temel bir histogramı nasıl kurarsınız ve renkleri, etiketleri, bölmeleri (bins) ile eksen sınırlarını nasıl ayarlarsınız gibi konuları ele alacağız.
Ek paketler olmadan base R programlama dilini kullanacağız. Bu yaklaşım, ek paketlerin kullanılmasının mümkün olmadığı durumlarda veya hızlı keşif amaçlı analizler yapmak istediğinizde özellikle yararlıdır. Diğer durumlarda, ggplot2 kullanmayı düşünebilirsiniz; bunun için R'de ggplot2 ile Histogram Nasıl Yapılır başlıklı eğitimimize bakabilirsiniz.
Ek paket olmadan base R'de temel bir histogram oluşturmak için hist(x) kullanın
Görünümü col (dolgu rengi), border (çerçeve), main (başlık), xlab ve ylab ile özelleştirin
breaks argümanı ile bölmeyi kontrol edin: bir sayı, kesim noktaları vektörü veya bir yöntem adı ("Sturges", "Scott", "Freedman-Diaconis") geçirin
Betimsel istatistikleri ortalama için abline() ve yoğunluk eğrisi için lines(density()) ile üst üste çizin
Gruplandırılmış veya yayın kalitesinde histogramlar için ggplot2'ye geçin
Histogram, sürekli (sayısal) değişkenler üzerinde frekans dağılımlarını gösteren bir grafiktir. Histogramlar, verideki gözlem sayılarını değişkenin kapsadığı aralıklar içinde görmemizi sağlar.
Histogramlar çubuk grafiklere benzer görünür. İkisi arasındaki temel fark; çubuk grafiklerin belirli bir kategori veya ayrık değişken için bir değeri göstermesi, histogramın ise sürekli değişkenler için frekansları görselleştirmesidir.
Farklı konut ilanlarına ait, evin büyüklüğü, oda sayısı, fiyatı ve konum bilgileri gibi ayrıntıları içeren şu konut veri setini kullanacağız. Veriyi read.csv() fonksiyonu ile doğrudan URL'den okuyabilir veya csv dosyasını indirip yerel depolamadan okuyabiliriz. Ayrıca bu eğitimde ilgilendiğimiz sütunları (price ve condition) saklamak istediğimizi belirtebiliriz.
home_data <- read.csv("https://raw.githubusercontent.com/rashida048/Datasets/master/home_data.csv")[ ,c('price', 'condition')]İlk birkaç satıra head() fonksiyonunu kullanarak bakalım.
head(home_data, 5)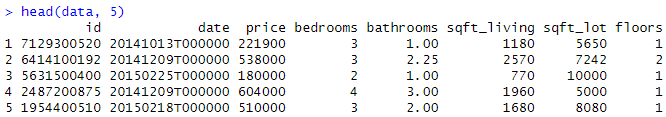
Şimdi, veri setimizdeki fiyat dağılımına bakmak için hist() fonksiyonunu kullanarak bir histogram oluşturacağız.
hist(home_data$price)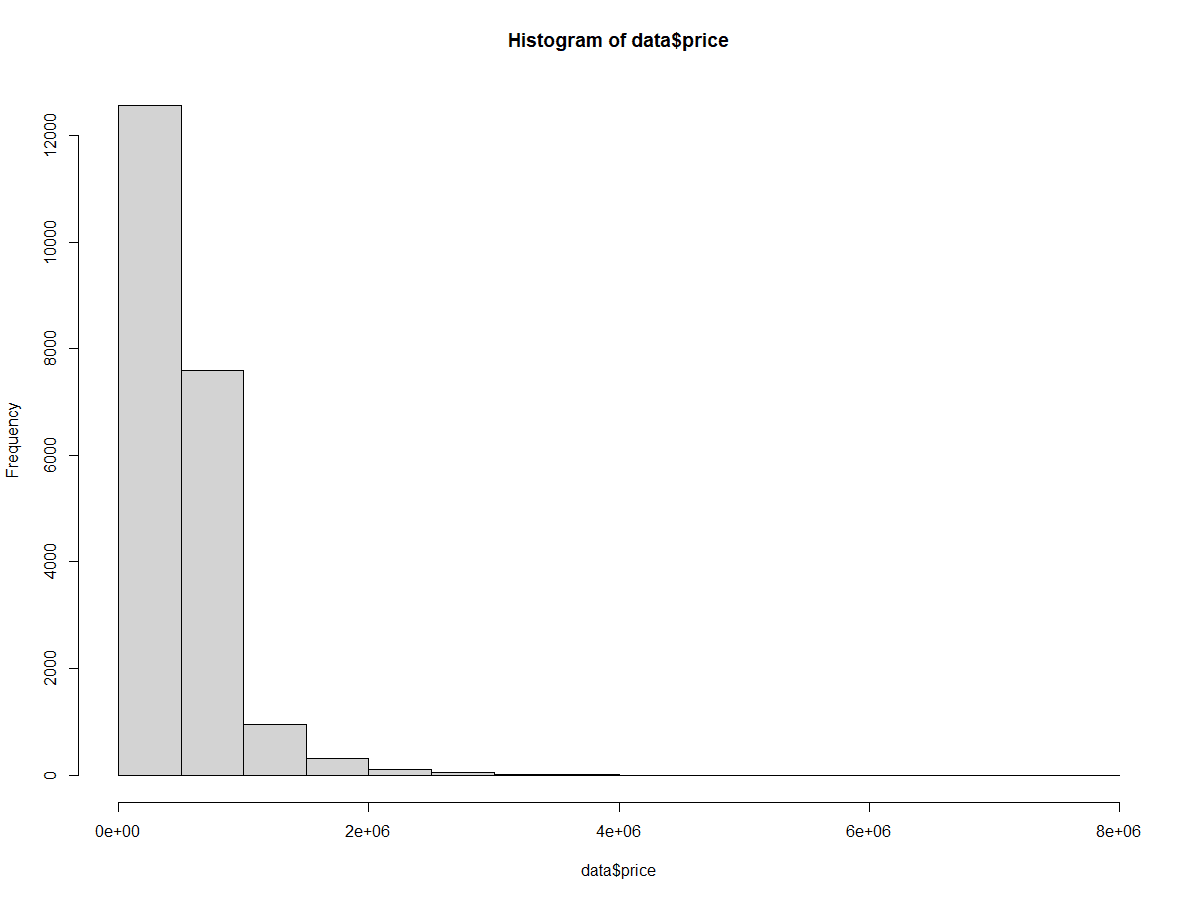
Temel konut fiyatları histogramı. Görsel: Yazar.
Histogram üzerine betimsel istatistikler eklemek için abline() fonksiyonunu kullanabiliriz. Bu, grafiğe dikey bir çizgi ekler.
v argümanını dikey çizginin x eksenindeki konumuna ayarlayın. Burada, mean() ile ortalama konut fiyatını alıyoruz.
col argümanı çizgi rengini ayarlar; burada kırmızı.
lwd argümanı çizgi kalınlığını ayarlar. 3 değeri, çizgiyi daha belirgin görmek için kalınlaştırır.
hist(home_data$price)

abline(v = mean(home_data$price), col='red', lwd = 3)Histogram üzerine bir olasılık yoğunluğu çizgisi eklemek için önce y eksenini yoğunluğa göre ölçeklendirmeliyiz. hist() çağrısında probability argümanını TRUE olarak ayarlıyoruz.
Olasılık yoğunluğu çizgisi, olasılık yoğunluğu eğrisinin konumunu hesaplayan density() ile ve bu çizgiyi mevcut grafiğe ekleyen lines() kombinasyonu ile yapılır.
hist(home_data$price, probability = TRUE)
abline(v = mean(home_data$price), col='red', lwd = 3)
lines(density(home_data$price), col = 'green', lwd = 3)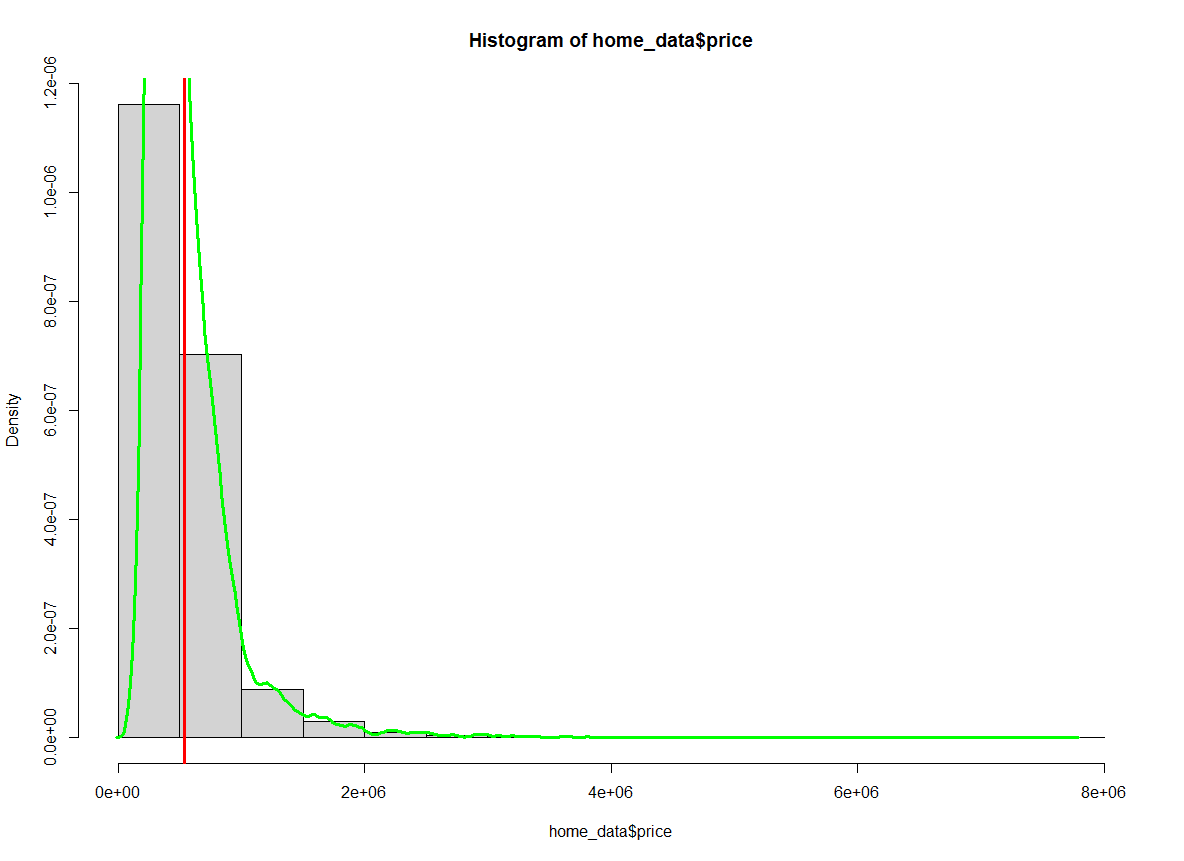
Ortalaması vurgulanmış konut fiyatları histogramı. Görsel: Yazar.
Y eksenindeki sayıların değiştiğine dikkat edin.
hist() fonksiyonunun col parametresi çubukların dolgu rengini, border ise kenar çizgilerinin rengini ayarlar. Burada dolguyu maviye, kenarları beyaza ayarlayacağım.
hist(home_data$price, col = 'blue', border = "white")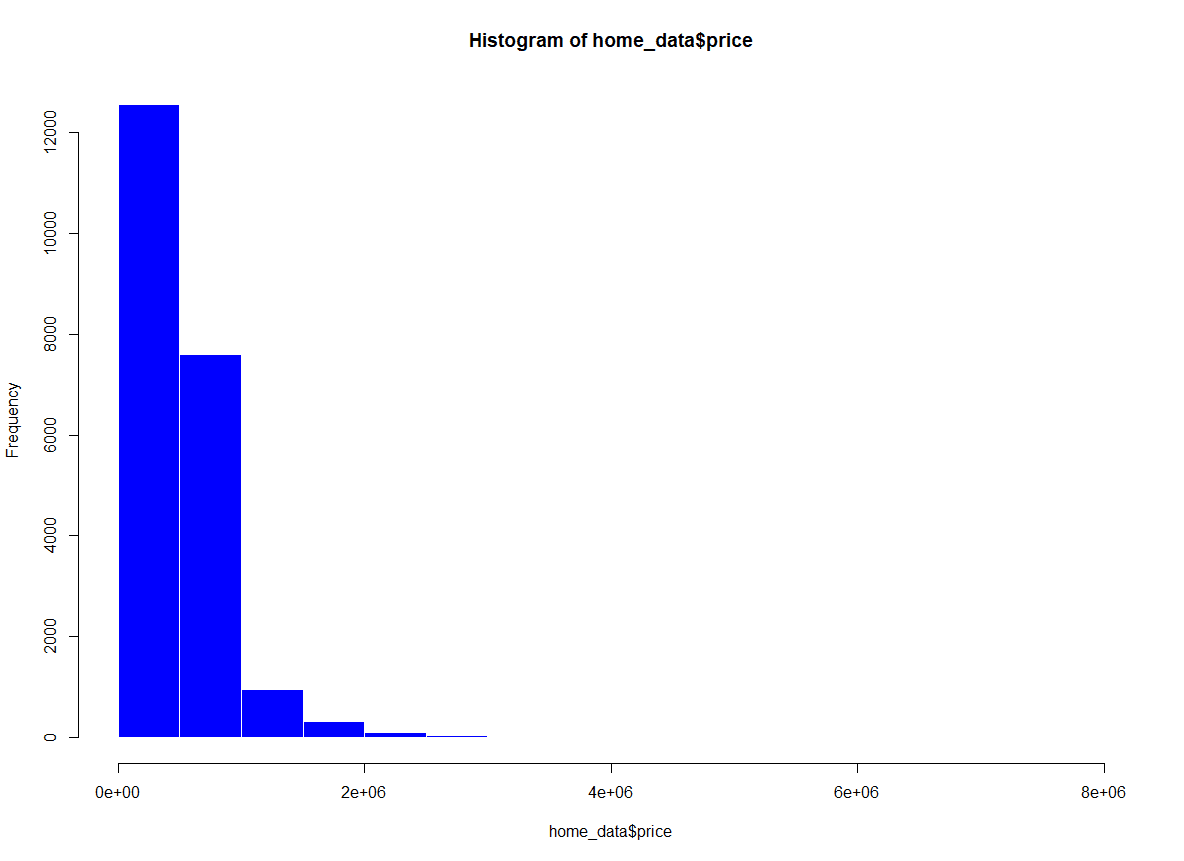 Renk eklenmiş konut fiyatları histogramı. Görsel: Yazar.
Grafikteki etiketleri değiştirerek onu daha okunur ve sunuma uygun hale getirebiliriz. Özellikle grafiği başkalarıyla paylaşıyorsanız faydalıdır.
xlab x ekseni etiketini ayarlar
ylab y ekseni etiketini ayarlar
main grafik başlığını ayarlar
hist(home_data$price, xlab = 'Price (USD)', ylab = 'Number of Listings', main = 'Distribution of House Prices')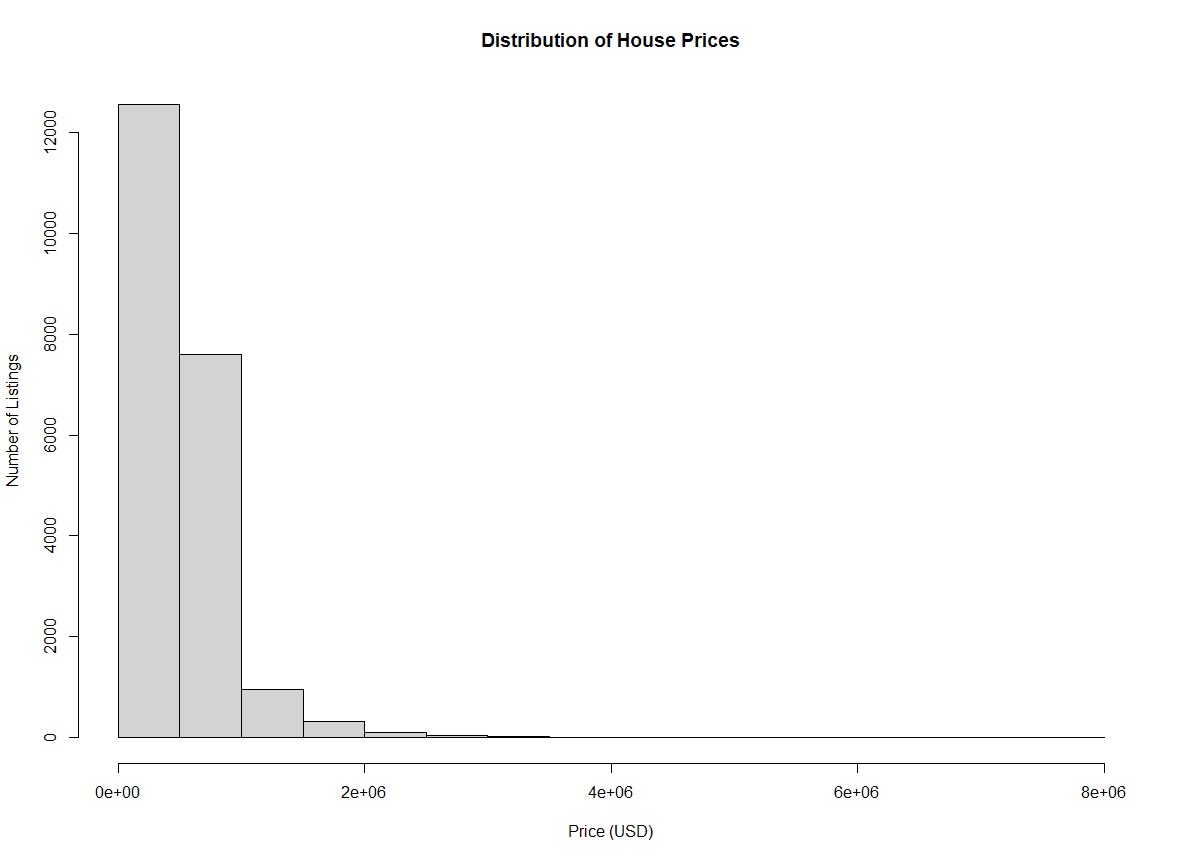 Eksen etiketli konut fiyatları histogramı. Görsel: Yazar.
Varsayılan argümanlarla, fiyat aralığı boyunca konut fiyatlarının tam dağılımını görmek zordur. İlk birkaç bölmede yoğunlaştıklarını görebiliyoruz, ancak çok açıklayıcı değiller.
breaks parametresiyle daha fazla bölme ekleyebiliriz. Bu argümanla, kullanılacak belirli kesim noktalarının bir vektörünü, kesim noktalarını hesaplayan bir fonksiyonu, istediğimiz bölme sayısını veya hücre sayısını hesaplayan bir fonksiyonu geçebiliriz.
Bu örnekte, istediğimiz bölme sayısını geçeceğiz. Bu sayı, grafikte göstermek istediğiniz şeye bağlı olarak bağlama özgüdür.
hist(home_data$price, breaks = 100) Bölme genişliği değiştirilmiş konut fiyatları histogramı. Görsel: Yazar.
breaks 100 olarak ayarlandığında, ilk birkaç kovadaki (bucket) dağılımı çok daha net görebiliyoruz.
Ayrıca, histogramda en uygun bölmeleri hesaplamak için yaygın hesaplama adlarını da breaks özniteliğine argüman olarak belirtebiliriz. Varsayılan olarak hist() “Sturges” yöntemini kullanır. Burada yöntemi açıkça belirtiyoruz.
hist(home_data$price, breaks = "Sturges") Sturges yöntemini kullanan konut fiyatları histogramı. Görsel: Yazar.
Ayrıca, Scott Yöntemi'ni kullanmak için breaks özniteliğine “Scott” da geçebiliriz.
hist(home_data$price, breaks = "Scott")
Scott yöntemini kullanan konut fiyatları histogramı. Görsel: Yazar.
Son olarak, Freedman-Diaconis (FD) yöntemini de kullanabiliriz.
hist(home_data$price, breaks = "Freedman-Diaconis") Freedman-Diaconis yöntemini kullanan konut fiyatları histogramı. Görsel: Yazar.
Aşağıdaki tablo, hist() içinde mevcut olan üç adlandırılmış break yöntemini özetler. Varsayılan Sturges'tir.
| Yöntem | Nasıl çalışır | En uygun |
|---|---|---|
| Sturges | Bin sayısı = 1 + log₂(n). Verinin kabaca normal olduğunu varsayar. | Yaklaşık normal dağılıma sahip küçük ve orta boy veri setleri |
| Scott | Bin genişliği = 3.49 × sd × n⁻¹ᐟ³. Entegre ortalama kare hatayı en aza indirir. | Varyansın önemli olduğu normal dağılımlı veriler |
| Freedman-Diaconis | Bin genişliği = 2 × IQR × n⁻¹ᐟ³. Standart sapma yerine çeyrekler arası aralığı kullanır. | Çarpık veriler veya aykırı değerlere sahip dağılımlar |
İlgilendiğimiz verilere yakınlaştırmak için grafiğin x ekseni sınırlarını xlim argümanı ile ayarlayabiliriz. Örneğin, tüm grafiği gördüğümüzde ortaya çıkan uzun kuyruk yerine, bazen dağılımın merkezi kısmına odaklanmak faydalıdır.
Y ekseni sınırlarını değiştirmek de mümkündür (ylim argümanı ile), ancak histogramlar için otomatik hesaplanan değerler neredeyse her zaman idealdir.
0 ile 2 milyon $ arasındaki fiyatlara yakınlaştıracağız.
hist(home_data$price, breaks = 100, xlim = c(0, 2000000)) Eksen sınırları değiştirilmiş konut fiyatları histogramı. Görsel: Yazar.
R ile daha rahat hale geldikçe, estetik, yerleşim ve etkileşim üzerinde daha fazla kontrol sunan özel görselleştirme paketlerini deneyebilirsiniz. R'de çizim yapmak için çok popüler ve kolay kullanımlı bir kütüphane olan ggplot2 bulunmaktadır. Aşağıda, evdeki yatak odası sayısına göre fiyat dağılımlarına ilginç bir bakış oluşturuyoruz.
 ggplot2 kullanılarak oluşturulan konut fiyatları histogramı. Görsel: Yazar.
ggplot2, R'deki en yaygın kullanılan görselleştirme paketidir. Onunla histogram oluşturmayı R'de ggplot2 ile Histogram Nasıl Yapılır eğitimimizde öğrenebilir veya daha geniş bir giriş için ggplot2 ile Grafikler eğitimini inceleyebilirsiniz. Daha derine inmek için Introduction to ggplot2 ve Intermediate ggplot2 kurslarımıza göz atın.
Bu eğitimde, histogramların sürekli değişkenlerin dağılımlarına bakmak için harika görselleştirmeler olduğunu gördük. R'de histogramın nasıl yapılacağını, histogramın üzerine özet istatistiklerin nasıl çizileceğini, eksen başlıkları, renk, x eksenini nasıl bölümlendirdiğimiz ve eksenlere sınır koyma gibi grafiğin özelliklerinin nasıl özelleştirileceğini öğrendik. Son olarak, ggplot2 kütüphanesinin bazı imkanlarını gösterdik.
DataCamp'te daha fazla okuma ve kaynak için etkileşimli kurslarımıza göz atın:
DataCamp ile R Öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




