想拿到理想岗位并提升您的深度学习技能?这篇文章就是为您准备的。我们汇总了 20 道深度学习岗位常见面试题及答案,只需稍加练习,便可助您在面试中脱颖而出。
通用深度学习面试题
通用题通常考察您对该领域的理解、它与其他 AI 方向的区别、如何将真实世界问题与深度学习方案衔接,以及对其挑战与局限的认知。
1. 什么是深度学习?
深度学习是机器学习与整体人工智能的一个子领域。它通过基于人工神经网络的大型模型在数据上进行训练。
模型能够通过自动发现数据中复杂的模式与特征,学习解决具有挑战性的预测与推断任务(如分类、回归、图像中的目标识别等)。其灵感源于对人脑复杂内部结构的模拟。
我们的 Understanding Artificial Intelligence 课程系统讲解 AI 的各个子领域及可解决的任务,包括深度学习。
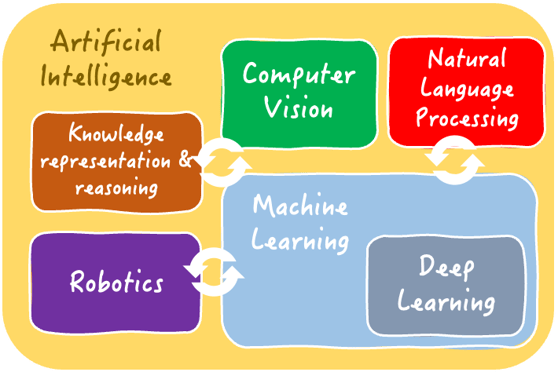
人工智能相互关联的领域 | Iván Palomares
2. 何时应优先选择深度学习而非传统机器学习方案?
当数据高度复杂时(如非结构化或高维数据),深度学习表现突出。
对于数据量极大、或需要捕捉细微模式的任务,深度学习也常是首选:它往往能提取并理解机器学习方法可能无法发现的有意义特征。
以下是适合用深度学习求解的一些问题示例:
- 动物或植物物种的图像分类
- 股票价格的长期预测
- 图像中的人脸识别
- 语音识别、机器翻译等自然语言处理任务
但要注意,对于许多更简单的任务与数据集,轻量级机器学习模型(如决策树、回归器)可能已绰绰有余,且更易、更经济地训练与部署,因此反而是更好的选择。
深度学习模型通常需要扎实的数据准备与处理能力;因此,您可能会发现这篇关于数据工程面试的文章很有帮助。
3. 您会如何为您的问题与数据选择合适的深度学习方法?
选择合适的深度学习方法取决于多重因素,如数据性质、问题复杂度与可用算力资源等。
以下步骤是帮助您做出这一关键选择的简明有效“配方”:
- 对数据特征进行全面分析。是结构化还是非结构化?是否存在时间或空间依赖?您的模型要预测的目标变量是什么?
- 基于数据分析,选择最合适的深度学习架构类型。例如,卷积神经网络(CNN)擅长处理视觉数据,而循环神经网络(RNN)在序列数据上更有效。
- 考虑模型可解释性、可扩展性以及可用于训练的标注数据量等因素。不同的深度学习架构对这些方面的支持程度各不相同。
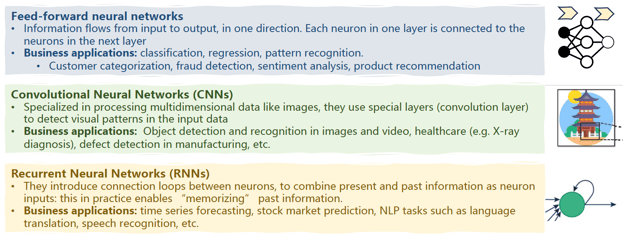
三种常见深度学习架构及其应用 | Iván Palomares
4. 您会如何为分类任务设计深度学习方案?
为特定任务(如分类)定制深度学习架构,需要选择合适的神经元层数与规模,以及合适的激活函数。
这些决策通常基于数据特性。对于图像分类,您可能在架构中使用多层卷积层,以捕捉颜色(及其组合)、形状、边缘等视觉模式。
位于架构最末端的顶层(模型头)也需与任务匹配,必须能够产生期望的输出。
例如,在将小鸡图像分类到具体鸟类物种的图像分类问题中,最后几层应采用softmax 激活函数以输出各类别概率,从而判断被分析图像最可能属于哪一种鸟类。
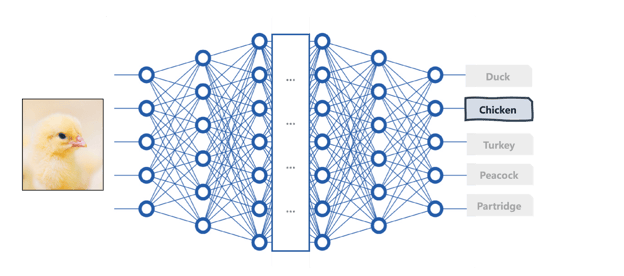
用于图像分类的深度学习架构 | Iván Palomares
5. 深度学习模型常见挑战有哪些,您如何应对?
在实际落地中,深度学习模型常见的阻碍包括过拟合、梯度消失与爆炸、以及训练所需的大量标注数据。好消息是,伴随持续研究,已有多种应对思路。
除这些问题定制的方案外,还应建立常规的模型监控与微调机制,确保长期性能。
应届毕业生的深度学习面试题
如果您是应届毕业生,或正在寻找第一份深度学习相关工作,可能会被问到检验基础知识与在实验环境中训练、评估模型的实操技能的问题。
1. 什么是激活函数?为什么它们在深度学习模型设计中至关重要?
激活函数是现代深度神经网络架构中使用的数学函数。它们在神经元层面上,将多个输入映射为输出并传递到下一层神经元。
激活函数之所以关键,是因为它们引入非线性,这对于模型在训练中学习数据中的复杂关系与模式至关重要。
否则,模型只能通过连续的线性组合学习到接近线性的模式——就像经典的线性回归模型!
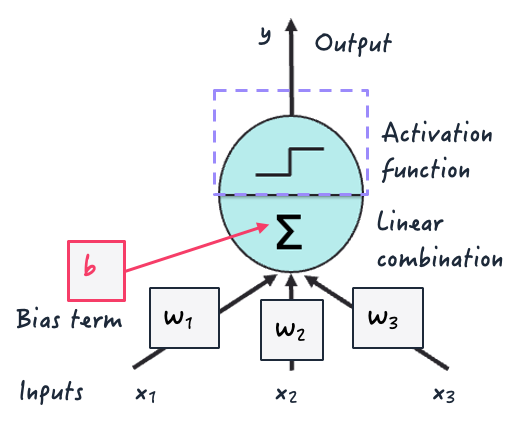
人工神经元中的激活函数 | Iván Palomares
常见的激活函数包括逻辑函数(logit)、双曲正切(tanh)与修正线性单元(ReLU)等,如下图所示。
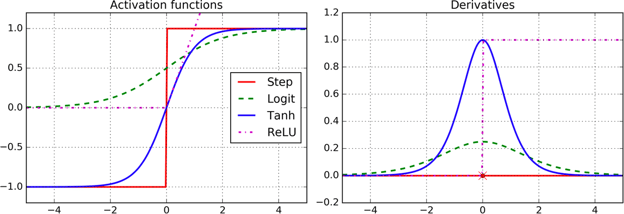
激活函数示例 | 图片来源 Aurelien Geron (O’Reilly)
2. 您会如何评估深度学习模型的性能?
深度学习模型的性能可结合具体任务,采用通用的机器学习指标进行评估。
对于分类,可使用准确率、精确率、召回率、F1 分数与 AUC 等指标。对于回归,可使用如均方根误差(RMSE)等误差指标。
利用这些指标将模型预测与真实标签或基线模型进行对比评测。对于更高级的模型与应用(如 NLP),还可使用任务特定指标:如翻译的 BLEU、摘要的 ROUGE 等。
3. 深度学习在商业与工业中的应用有哪些示例?
深度学习广泛应用于真实世界的诸多场景,例如:
- 自动驾驶在道路上的图像与目标识别
- 客户支持聊天机器人的自然语言处理与理解
- 零售个性化推荐的预测分析
- 基于 X 光图像的医学诊断
深度学习工程面试题
面向工程方向的深度学习岗位面试,会重点关注编程框架、库与工具等方面。
1. 您会如何用 TensorFlow 构建一个用于图像分类的简单前馈神经网络?
在 TensorFlow 中构建简单的前馈神经网络做图像分类,可以先使用 Sequential API 按层定义模型架构。
这包括为每层指定合适的神经元数量与激活函数,并在最终输出层使用 softmax 激活。
随后编译模型,指定合适的损失函数(如分类交叉熵)、优化器(如 Adam)与验证指标,然后在训练集上按设定轮数训练。训练完成后,在验证集上评估其性能。
TensorFlow 通常与 Keras API 搭配使用,完成 Advanced Deep Learning with Keras 课程后,您将能熟练掌握。
2. 请描述您在 PyTorch 中通过正则化技术应对模型过拟合的思路
在 PyTorch 中处理过拟合的常见策略,是在损失函数中加入L1 或 L2 正则化惩罚项。
或者,引入 dropout 层,在训练中随机失活部分神经元,防止模型过度依赖数据中的特定特征。
上述两种策略可与早停结合:当验证性能开始下降时结束训练。
想提升您的 PyTorch 技能?欢迎学习 Introduction to Deep Learning in the PyTorch 课程。
3. 举例说明如何使用迁移学习对预训练模型进行微调以适配新任务
VGG、BERT、ResNet 等都是可用于迁移学习与微调的知名预训练模型。具体过程通常是替换模型头部(即最终分类层),使之适配目标任务。
在完成这一小幅架构调整后,使用较低学习率在新数据集上继续训练,使权重适应新任务,同时尽可能保留预训练模型先前学到的主要特征。
计算机视觉方向的深度学习面试题
以下是与构建或管理计算机视觉深度学习方案(如图像处理应用)相关的潜在面试问题。
1. 解释卷积神经网络,并将其应用到三个典型用例。
CNN 是面向视觉数据的专用深度学习架构。其卷积层堆叠及对图像数据的操作,模仿了动物大脑的视觉皮层。
CNN 擅长图像分类、目标检测与图像分割。以下是每种任务的简要用例:
- 图像分类:判断一张图像里是狗还是猫,用于自动化宠物识别与监测系统。
- 目标检测:使自动驾驶车辆能够实时定位并识别行人。
- 图像分割:在医学图像中勾勒肿瘤边界,以便准确诊断与治疗癌症患者。
2. 说明卷积层与池化层在 CNN 中的作用
CNN 中的卷积层负责在输入图像上提取特征。它们通过一组可学习的权重(滤波器或核)来检测边缘、形状、纹理等模式及其空间信息与关系,从而学习分层的视觉表征。
同时,池化层对卷积层输出的特征图(中间图像表征)进行下采样。也就是说,在尽可能保留关键信息的前提下,降低其原始空间维度或分辨率。
在 CNN 中交替叠加卷积层与池化层,有助于增强对输入变化的鲁棒性、降低训练与推理时的计算复杂度,并有助于防止过拟合等问题。
3. 计算机视觉任务中的深度学习模型常见挑战有哪些?
在深度学习模型的常见挑战与局限中,以下问题在计算机视觉模型(如 CNN)中尤为突出:
- 数据量与质量:计算机视觉的深度学习模型需要非常大的标注数据集才能得到良好训练;同时数据质量也要过关:高分辨率、低噪声、避免模糊或过曝等。
- 过拟合:CNN 容易记住视觉训练数据中的噪声或特定(有时不相关)细节,导致泛化能力差。
- 计算资源:深度 CNN 架构因层数多、可训练参数多,训练时需要大量算力。许多模型需要 GPU 与大内存才能顺畅训练。
- 可解释性:在图像识别等复杂任务中,理解模型如何做出(尤其是错误的)预测仍具挑战。
NLP 方向的深度学习面试题
以下是与在 NLP 应用中利用深度学习技术相关的潜在面试问题。
1. 注意力机制如何提升 NLP 任务中的深度学习模型性能?
Transformers 是突破性的深度学习架构家族,也是当前应对各类复杂 NLP 问题的主流方案。注意力机制是支撑大型语言模型(LLM,如 BERT 与 GPT)Transformer 架构的核心,极大推动了其成功。
Transformer 能捕捉输入文本中元素之间的复杂模式、上下文信息与长程依赖,显著克服了以往方案(如 RNN 的记忆受限)的问题。
注意力机制本质上会对序列中每个 token 的重要性赋权,而无需逐 token 顺序处理。
这一关键组件使文本分类、文本生成与文本摘要等任务取得重大进步,并推动了 LLM 与整体 AI 领域的变革。
Datacamp 的 Introduction to LLMs in Python 课程,不仅传授构建与应用 LLM 的实用技能,还系统讲解 LLM 与 Transformer 架构的核心概念。
2. 在 NLP 语境下,模型预训练与微调分别意味着什么?
模型预训练是指在大规模语料(数百万至数十亿文本)上训练深度学习模型(如用于文本分类的 BERT),以学习通用的语言表征。
模型微调则是将预训练模型用于特定下游 NLP 应用(如酒店点评情感分析),并在该任务上细化其已学参数。
由于微调通常面向具体用例,因此常使用较小且领域相关的标注文本数据集,仅对模型部分权重进行适配,从而学习目标任务的细微差别;相较从零训练模型,这既降低计算成本,也减少数据需求,同时提升特定场景的效果。
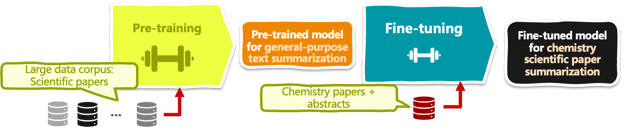
以化学论文摘要为例的 LLM 预训练与微调 | Iván Palomares
BERT 的架构是原始编码器-解码器 Transformer 的简化变体,称为仅编码器 Transformer。
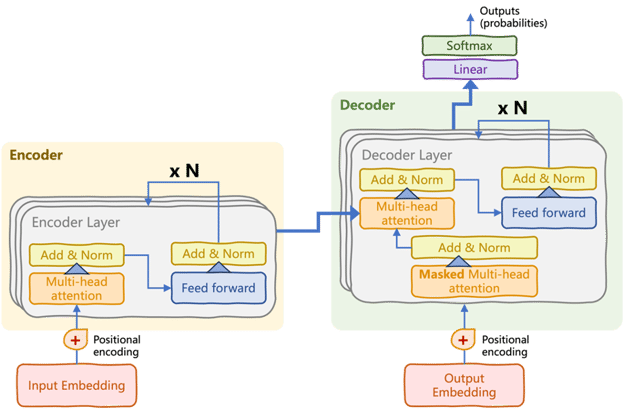
原始 Transformer 架构,由编码器与解码器堆叠组成 | Introduction to LLMs in Python(Iván Palomares)
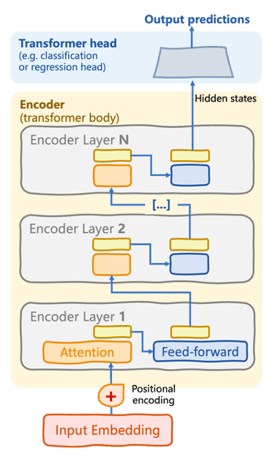
BERT 等模型使用的仅编码器 Transformer 架构 | Introduction to LLMs in Python(Iván Palomares)
编码器堆叠由多个编码器层组成(见上图)。每个编码器层内包含自注意力子层与前馈神经网络。BERT 的语言理解关键在于编码器内部迭代应用的双向注意力流,可在输入序列中同时捕捉双向的词语依赖。前馈神经连接将这些已学依赖“编织”成更复杂的语言模式。
除仅编码器 Transformer 的一般特性外,BERT 还采用了掩码语言建模(MLM)。该机制在预训练阶段随机掩盖部分词语,迫使模型基于上下文来预测被掩盖词,从而学习语言。
高级深度学习面试题
最后,我们来看三个面向高级深度学习岗位的可能问题。
1. 面对标注数据有限的问题,您会如何设计与实现深度学习模型?
在训练数据有限的常见情形下,可采用以下组合策略以最大化模型表现:
- 利用迁移学习,在与原模型训练领域相近的任务上微调预训练模型。
- 探索半监督与自监督学习,以获取规模更大的未标注数据。
- 通过数据增强与生成式模型,生成合成样本以充实原有标注集。
- 使用主动学习方法,在未标注样本上向用户发起查询以获取新增标注。
2. 在真实生产环境中大规模部署深度学习模型时,有哪三点重要考量?
在生产环境中大规模部署深度学习方案,需要关注多方面因素,其中三点为:
- 模型可扩展性与性能至关重要,需要高效架构与优化方法以应对实时的大规模数据流。
- 鲁棒性与可靠性同样关键,需要建立测试与验证流程,确保跨时间与不同场景的一致表现。
- 确保数据隐私与安全标准以及合规性,以保护敏感信息。这些是实现负责任系统行为与赢得用户信任的关键。
此外,硬件与网络基础设施、系统监控,以及与现有软件框架的无缝集成也是重要考量。
3. 您如何看待深度学习的最新进展将在应用与更广泛影响层面塑造该领域的未来?
近期的深度学习突破有潜力深刻重塑众多行业,甚至催生新行业。
注意力机制驱动的Transformer 架构与LLM正革新 NLP,大幅拓展任务边界,并通过对话式 AI、问答等方式,使人机交互更为智能。近年来引入的检索增强生成(RAG)进一步帮助 LLM 产出更真实、可溯源的语言。
强化学习因其原理模仿人类学习的基本机制而前景广阔。与深度学习架构(尤其是生成对抗网络等生成式模型)的结合,是当下学术研究前沿。OpenAI、Google、Microsoft 等巨头正将二者融合,推出可生成“逼真”多模态内容的突破性方案。
这些与其他进展极大推动了 AI 的普及,因此将目光投向 AI 伦理、法律与监管十分必要,以确保深度学习方案在社会层面产生积极影响。
总结
综观这些常见面试题,不难发现,成功的关键在于理论基础、扎实的实操能力,以及紧跟前沿的学习习惯。
深度学习不仅仅是算法、模型与架构设计的选择,更是为真实世界的数据问题寻找最佳解法。
持续学习至关重要。Datacamp 提供系统的 Deep Learning in Python 技能路径,以及两个面向应用的深度学习路径:图像处理与自然语言处理。这些路径为您提供结构化的进阶路线,助您为下一次面试做好准备。
最后,如果您在寻找更通用的面试准备建议,不妨阅读这篇关于机器学习面试题的文章结尾部分。由于深度学习是机器学习的子领域,将这些通用建议与本文梳理的 20 道深度学习问题结合起来,定能助您更好地备战。


想拿到理想岗位并提升您的深度学习技能?这篇文章就是为您准备的。我们汇总了 20 道深度学习岗位常见面试题及答案,只需稍加练习,便可助您在面试中脱颖而出。
通用深度学习面试题
通用题通常考察您对该领域的理解、它与其他 AI 方向的区别、如何将真实世界问题与深度学习方案衔接,以及对其挑战与局限的认知。
1. 什么是深度学习?
深度学习是机器学习与整体人工智能的一个子领域。它通过基于人工神经网络的大型模型在数据上进行训练。
模型能够通过自动发现数据中复杂的模式与特征,学习解决具有挑战性的预测与推断任务(如分类、回归、图像中的目标识别等)。其灵感源于对人脑复杂内部结构的模拟。
我们的 Understanding Artificial Intelligence 课程系统讲解 AI 的各个子领域及可解决的任务,包括深度学习。
人工智能相互关联的领域 | Iván Palomares
2. 何时应优先选择深度学习而非传统机器学习方案?
当数据高度复杂时(如非结构化或高维数据),深度学习表现突出。
对于数据量极大、或需要捕捉细微模式的任务,深度学习也常是首选:它往往能提取并理解机器学习方法可能无法发现的有意义特征。
以下是适合用深度学习求解的一些问题示例:
但要注意,对于许多更简单的任务与数据集,轻量级机器学习模型(如决策树、回归器)可能已绰绰有余,且更易、更经济地训练与部署,因此反而是更好的选择。
深度学习模型通常需要扎实的数据准备与处理能力;因此,您可能会发现这篇关于数据工程面试的文章很有帮助。
3. 您会如何为您的问题与数据选择合适的深度学习方法?
选择合适的深度学习方法取决于多重因素,如数据性质、问题复杂度与可用算力资源等。
以下步骤是帮助您做出这一关键选择的简明有效“配方”:
三种常见深度学习架构及其应用 | Iván Palomares
4. 您会如何为分类任务设计深度学习方案?
为特定任务(如分类)定制深度学习架构,需要选择合适的神经元层数与规模,以及合适的激活函数。
这些决策通常基于数据特性。对于图像分类,您可能在架构中使用多层卷积层,以捕捉颜色(及其组合)、形状、边缘等视觉模式。
位于架构最末端的顶层(模型头)也需与任务匹配,必须能够产生期望的输出。
例如,在将小鸡图像分类到具体鸟类物种的图像分类问题中,最后几层应采用softmax 激活函数以输出各类别概率,从而判断被分析图像最可能属于哪一种鸟类。
用于图像分类的深度学习架构 | Iván Palomares
5. 深度学习模型常见挑战有哪些,您如何应对?
在实际落地中,深度学习模型常见的阻碍包括过拟合、梯度消失与爆炸、以及训练所需的大量标注数据。好消息是,伴随持续研究,已有多种应对思路。
除这些问题定制的方案外,还应建立常规的模型监控与微调机制,确保长期性能。
应届毕业生的深度学习面试题
如果您是应届毕业生,或正在寻找第一份深度学习相关工作,可能会被问到检验基础知识与在实验环境中训练、评估模型的实操技能的问题。
1. 什么是激活函数?为什么它们在深度学习模型设计中至关重要?
激活函数是现代深度神经网络架构中使用的数学函数。它们在神经元层面上,将多个输入映射为输出并传递到下一层神经元。
激活函数之所以关键,是因为它们引入非线性,这对于模型在训练中学习数据中的复杂关系与模式至关重要。
否则,模型只能通过连续的线性组合学习到接近线性的模式——就像经典的线性回归模型!
人工神经元中的激活函数 | Iván Palomares
常见的激活函数包括逻辑函数(logit)、双曲正切(tanh)与修正线性单元(ReLU)等,如下图所示。
激活函数示例 | 图片来源 Aurelien Geron (O’Reilly)
2. 您会如何评估深度学习模型的性能?
深度学习模型的性能可结合具体任务,采用通用的机器学习指标进行评估。
对于分类,可使用准确率、精确率、召回率、F1 分数与 AUC 等指标。对于回归,可使用如均方根误差(RMSE)等误差指标。
利用这些指标将模型预测与真实标签或基线模型进行对比评测。对于更高级的模型与应用(如 NLP),还可使用任务特定指标:如翻译的 BLEU、摘要的 ROUGE 等。
3. 深度学习在商业与工业中的应用有哪些示例?
深度学习广泛应用于真实世界的诸多场景,例如:
深度学习工程面试题
面向工程方向的深度学习岗位面试,会重点关注编程框架、库与工具等方面。
1. 您会如何用 TensorFlow 构建一个用于图像分类的简单前馈神经网络?
在 TensorFlow 中构建简单的前馈神经网络做图像分类,可以先使用 Sequential API 按层定义模型架构。
这包括为每层指定合适的神经元数量与激活函数,并在最终输出层使用 softmax 激活。
随后编译模型,指定合适的损失函数(如分类交叉熵)、优化器(如 Adam)与验证指标,然后在训练集上按设定轮数训练。训练完成后,在验证集上评估其性能。
TensorFlow 通常与 Keras API 搭配使用,完成 Advanced Deep Learning with Keras 课程后,您将能熟练掌握。
2. 请描述您在 PyTorch 中通过正则化技术应对模型过拟合的思路
在 PyTorch 中处理过拟合的常见策略,是在损失函数中加入L1 或 L2 正则化惩罚项。
或者,引入 dropout 层,在训练中随机失活部分神经元,防止模型过度依赖数据中的特定特征。
上述两种策略可与早停结合:当验证性能开始下降时结束训练。
想提升您的 PyTorch 技能?欢迎学习 Introduction to Deep Learning in the PyTorch 课程。
3. 举例说明如何使用迁移学习对预训练模型进行微调以适配新任务
VGG、BERT、ResNet 等都是可用于迁移学习与微调的知名预训练模型。具体过程通常是替换模型头部(即最终分类层),使之适配目标任务。
在完成这一小幅架构调整后,使用较低学习率在新数据集上继续训练,使权重适应新任务,同时尽可能保留预训练模型先前学到的主要特征。
计算机视觉方向的深度学习面试题
以下是与构建或管理计算机视觉深度学习方案(如图像处理应用)相关的潜在面试问题。
1. 解释卷积神经网络,并将其应用到三个典型用例。
CNN 是面向视觉数据的专用深度学习架构。其卷积层堆叠及对图像数据的操作,模仿了动物大脑的视觉皮层。
CNN 擅长图像分类、目标检测与图像分割。以下是每种任务的简要用例:
2. 说明卷积层与池化层在 CNN 中的作用
CNN 中的卷积层负责在输入图像上提取特征。它们通过一组可学习的权重(滤波器或核)来检测边缘、形状、纹理等模式及其空间信息与关系,从而学习分层的视觉表征。
同时,池化层对卷积层输出的特征图(中间图像表征)进行下采样。也就是说,在尽可能保留关键信息的前提下,降低其原始空间维度或分辨率。
在 CNN 中交替叠加卷积层与池化层,有助于增强对输入变化的鲁棒性、降低训练与推理时的计算复杂度,并有助于防止过拟合等问题。
3. 计算机视觉任务中的深度学习模型常见挑战有哪些?
在深度学习模型的常见挑战与局限中,以下问题在计算机视觉模型(如 CNN)中尤为突出:
NLP 方向的深度学习面试题
以下是与在 NLP 应用中利用深度学习技术相关的潜在面试问题。
1. 注意力机制如何提升 NLP 任务中的深度学习模型性能?
Transformers 是突破性的深度学习架构家族,也是当前应对各类复杂 NLP 问题的主流方案。注意力机制是支撑大型语言模型(LLM,如 BERT 与 GPT)Transformer 架构的核心,极大推动了其成功。
Transformer 能捕捉输入文本中元素之间的复杂模式、上下文信息与长程依赖,显著克服了以往方案(如 RNN 的记忆受限)的问题。
注意力机制本质上会对序列中每个 token 的重要性赋权,而无需逐 token 顺序处理。
这一关键组件使文本分类、文本生成与文本摘要等任务取得重大进步,并推动了 LLM 与整体 AI 领域的变革。
Datacamp 的 Introduction to LLMs in Python 课程,不仅传授构建与应用 LLM 的实用技能,还系统讲解 LLM 与 Transformer 架构的核心概念。
2. 在 NLP 语境下,模型预训练与微调分别意味着什么?
模型预训练是指在大规模语料(数百万至数十亿文本)上训练深度学习模型(如用于文本分类的 BERT),以学习通用的语言表征。
模型微调则是将预训练模型用于特定下游 NLP 应用(如酒店点评情感分析),并在该任务上细化其已学参数。
由于微调通常面向具体用例,因此常使用较小且领域相关的标注文本数据集,仅对模型部分权重进行适配,从而学习目标任务的细微差别;相较从零训练模型,这既降低计算成本,也减少数据需求,同时提升特定场景的效果。
以化学论文摘要为例的 LLM 预训练与微调 | Iván Palomares
3. 您能描述类似 BERT 的 Transformer 架构及其可解决的 NLP 任务类型吗?
BERT 的架构是原始编码器-解码器 Transformer 的简化变体,称为仅编码器 Transformer。
原始 Transformer 架构,由编码器与解码器堆叠组成 | Introduction to LLMs in Python(Iván Palomares)
BERT 等模型使用的仅编码器 Transformer 架构 | Introduction to LLMs in Python(Iván Palomares)
编码器堆叠由多个编码器层组成(见上图)。每个编码器层内包含自注意力子层与前馈神经网络。BERT 的语言理解关键在于编码器内部迭代应用的双向注意力流,可在输入序列中同时捕捉双向的词语依赖。前馈神经连接将这些已学依赖“编织”成更复杂的语言模式。
除仅编码器 Transformer 的一般特性外,BERT 还采用了掩码语言建模(MLM)。该机制在预训练阶段随机掩盖部分词语,迫使模型基于上下文来预测被掩盖词,从而学习语言。
高级深度学习面试题
最后,我们来看三个面向高级深度学习岗位的可能问题。
1. 面对标注数据有限的问题,您会如何设计与实现深度学习模型?
在训练数据有限的常见情形下,可采用以下组合策略以最大化模型表现:
2. 在真实生产环境中大规模部署深度学习模型时,有哪三点重要考量?
在生产环境中大规模部署深度学习方案,需要关注多方面因素,其中三点为:
此外,硬件与网络基础设施、系统监控,以及与现有软件框架的无缝集成也是重要考量。
3. 您如何看待深度学习的最新进展将在应用与更广泛影响层面塑造该领域的未来?
近期的深度学习突破有潜力深刻重塑众多行业,甚至催生新行业。
注意力机制驱动的Transformer 架构与LLM正革新 NLP,大幅拓展任务边界,并通过对话式 AI、问答等方式,使人机交互更为智能。近年来引入的检索增强生成(RAG)进一步帮助 LLM 产出更真实、可溯源的语言。
强化学习因其原理模仿人类学习的基本机制而前景广阔。与深度学习架构(尤其是生成对抗网络等生成式模型)的结合,是当下学术研究前沿。OpenAI、Google、Microsoft 等巨头正将二者融合,推出可生成“逼真”多模态内容的突破性方案。
这些与其他进展极大推动了 AI 的普及,因此将目光投向 AI 伦理、法律与监管十分必要,以确保深度学习方案在社会层面产生积极影响。
总结
综观这些常见面试题,不难发现,成功的关键在于理论基础、扎实的实操能力,以及紧跟前沿的学习习惯。
深度学习不仅仅是算法、模型与架构设计的选择,更是为真实世界的数据问题寻找最佳解法。
持续学习至关重要。Datacamp 提供系统的 Deep Learning in Python 技能路径,以及两个面向应用的深度学习路径:图像处理与自然语言处理。这些路径为您提供结构化的进阶路线,助您为下一次面试做好准备。
最后,如果您在寻找更通用的面试准备建议,不妨阅读这篇关于机器学习面试题的文章结尾部分。由于深度学习是机器学习的子领域,将这些通用建议与本文梳理的 20 道深度学习问题结合起来,定能助您更好地备战。