Mencari panduan untuk meraih peran impian dan mempertajam keterampilan deep learning Anda? Tidak perlu mencari lagi. Artikel ini menawarkan jawaban atas 20 pertanyaan wawancara umum untuk posisi deep learning, membantu Anda tampil unggul dalam wawancara hanya dengan sedikit latihan.
Pertanyaan Umum Wawancara Deep Learning
Pertanyaan deep learning umum biasanya berkaitan dengan pemahaman bidangnya, apa yang membedakannya dari area AI lainnya, menghubungkan masalah dunia nyata dengan solusi deep learning, serta memahami tantangan dan keterbatasannya.
1. Apa itu deep learning?
Deep learning adalah subbidang dari machine learning dan AI secara keseluruhan. Ini melibatkan pelatihan model besar berbasis jaringan saraf buatan pada data.
Model-model tersebut belajar menyelesaikan tugas prediksi dan inferensi yang menantang (seperti klasifikasi, regresi, pengenalan objek dalam gambar, dll.) dengan secara otomatis menemukan pola dan fitur kompleks yang mendasari data. Hal ini terjadi dengan meniru struktur internal yang kompleks di otak manusia.
Kursus Understanding Artificial Intelligence kami menguraikan secara komprehensif area dan tugas AI yang dapat diselesaikan, termasuk deep learning.
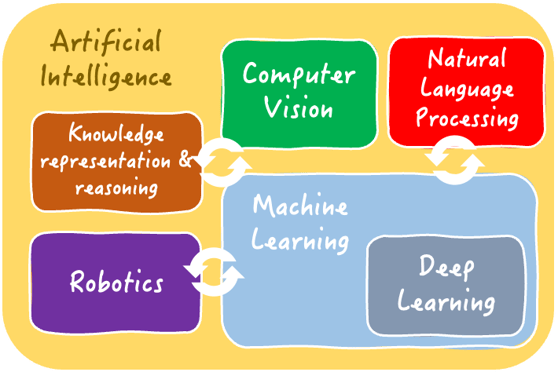
Area Kecerdasan Buatan yang saling terkait | Iván Palomares
2. Kapan Anda sebaiknya memilih deep learning dibanding solusi machine learning?
Solusi deep learning menonjol pada masalah dengan data berkompleksitas tinggi, misalnya data tidak terstruktur atau berdimensi tinggi.
Ini juga menjadi pilihan utama untuk masalah dengan jumlah data yang sangat besar atau yang memerlukan penangkapan pola yang halus: sering kali, deep learning berhasil mengekstrak dan memahami fitur data yang bermakna yang mungkin tidak ditemukan oleh pendekatan machine learning.
Berikut beberapa contoh masalah yang dapat diselesaikan oleh solusi deep learning:
- Mengklasifikasikan gambar spesies hewan atau tumbuhan
- Prediksi jangka panjang harga pasar saham
- Pengenalan wajah dalam gambar
- Tugas pemrosesan bahasa alami seperti pengenalan suara, penerjemahan bahasa, dan lainnya
Namun, perlu diingat bahwa untuk banyak tugas dan dataset yang lebih sederhana, model machine learning yang ringan seperti decision tree dan regressor sering kali sudah lebih dari cukup, sehingga menjadi pilihan lebih baik dibanding model deep learning karena lebih mudah dan murah untuk dilatih dan diterapkan.
Model deep learning biasanya menuntut keterampilan persiapan dan pemrosesan data yang matang; oleh karena itu Anda mungkin menemukan artikel berikut tentang wawancara data engineering bermanfaat.
3. Bagaimana Anda memilih pendekatan deep learning yang tepat untuk masalah dan data Anda?
Memutuskan pendekatan deep learning yang sesuai bergantung pada beberapa faktor, seperti sifat data, kompleksitas masalah, dan sumber daya komputasi yang tersedia.
Langkah-langkah berikut adalah resep sederhana namun efektif untuk membantu Anda membuat pilihan penting ini:
- Lakukan analisis menyeluruh terhadap fitur data Anda. Apakah data terstruktur atau tidak terstruktur? Apakah ada ketergantungan temporal atau spasial? Variabel target mana yang ingin Anda prediksi dengan model Anda?
- Berdasarkan analisis data, pilih jenis arsitektur deep learning yang paling sesuai. Misalnya, convolutional neural network (CNN) unggul dalam memproses data visual, sedangkan recurrent neural network (RNN) sangat efektif pada data berurutan.
- Pertimbangkan faktor tambahan seperti interpretabilitas model, skalabilitas, dan ketersediaan data berlabel untuk pelatihan. Berbagai arsitektur deep learning mengakomodasi aspek-aspek ini pada tingkat yang berbeda.
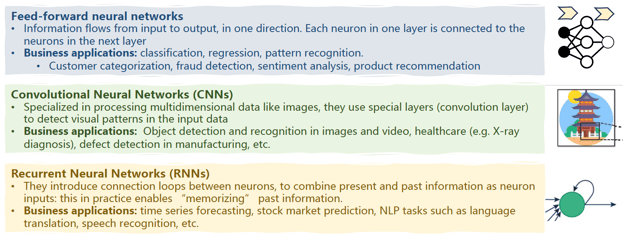
Tiga arsitektur deep learning umum dan penerapannya | Iván Palomares
4. Bagaimana Anda merancang arsitektur deep learning untuk klasifikasi?
Merancang arsitektur deep learning yang disesuaikan untuk tugas spesifik seperti klasifikasi mencakup pemilihan jumlah dan ukuran lapisan neuron yang tepat, serta memilih fungsi aktivasi yang sesuai.
Keputusan ini biasanya dibuat berdasarkan karakteristik data. Untuk klasifikasi gambar, Anda mungkin menggunakan tumpukan lapisan konvolusi dalam arsitektur untuk menangkap pola visual seperti warna (atau kombinasi warna), bentuk, tepi, dll.
Lapisan teratas yang terletak di akhir arsitektur deep learning Anda (model head) juga bergantung pada tugas Anda, karena harus dirancang untuk menghasilkan keluaran yang diinginkan.
Sebagai contoh, untuk masalah klasifikasi gambar seperti mengklasifikasikan gambar anak ayam ke dalam spesies burung, lapisan terakhir ini sebaiknya memiliki fungsi aktivasi softmax yang menghasilkan probabilitas kelas untuk menentukan kelas spesies burung yang paling mungkin dari gambar yang dianalisis.
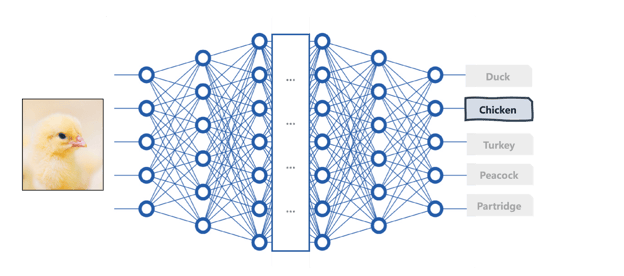
Arsitektur deep learning untuk klasifikasi gambar | Iván Palomares
5. Apa saja tantangan umum pada model deep learning, dan bagaimana cara mengatasinya?
Tantangan yang sering menghambat penerapan model deep learning di dunia nyata mencakup overfitting, vanishing dan exploding gradients, serta kebutuhan akan sejumlah besar data berlabel untuk pelatihan. Kabar baiknya, berkat upaya riset yang berkelanjutan, ada pendekatan untuk mengatasinya.
- Overfitting terjadi saat model belajar dengan cara "terlalu menghafal" tampilan data pelatihan, sehingga kemudian kesulitan melakukan inferensi yang benar pada data baru yang belum pernah dilihat. Untuk mengatasinya, ada teknik yang berfokus pada pengurangan kompleksitas model, seperti regularisasi atau membatasi seberapa banyak model belajar dari data, misalnya melalui early stopping.
- Vanishing dan exploding gradients terkait dengan masalah konvergensi menuju solusi yang tidak optimal selama proses pembaruan bobot yang mendasari pelatihan. Gradient clipping dan fungsi aktivasi lanjutan dapat membantu mengurangi masalah ini.
- Jika tantangannya adalah terbatasnya data berlabel, cobalah mengeksplorasi teknik transfer learning dan augmentasi data untuk memanfaatkan model pra-latih atau menghasilkan data sintetis.
Di atas solusi spesifik masalah, pastikan Anda menetapkan mekanisme pemantauan dan penyetelan model secara berkala untuk memastikan kinerja yang baik dalam jangka panjang.
Pertanyaan Wawancara Deep Learning untuk Lulusan Baru
Jika Anda lulusan baru atau mencari posisi deep learning pertama di pasar kerja, Anda dapat mengharapkan pertanyaan yang menguji perolehan pengetahuan dasar dan keterampilan praktis dalam melatih dan mengevaluasi model deep learning dalam setting eksperimental.
1. Apa itu fungsi aktivasi, dan mengapa fungsinya krusial dalam merancang model deep learning?
Fungsi aktivasi adalah fungsi matematis yang digunakan di semua arsitektur jaringan saraf dalam modern. Ini terjadi pada tingkat neuron, selama proses pemetaan beberapa masukan neuron menjadi nilai keluaran yang dikirim ke neuron di lapisan berikutnya.
Fungsi aktivasi sangat penting dalam model deep learning karena memperkenalkan non-linearitas, yang penting untuk memungkinkan model belajar hubungan dan pola kompleks dalam data selama pelatihan.
Jika tidak, model hanya akan mempelajari sedikit lebih dari pola linearitas dari data dengan menerapkan kombinasi linear beruntun dari masukan — seperti yang dilakukan model regresi linear klasik!
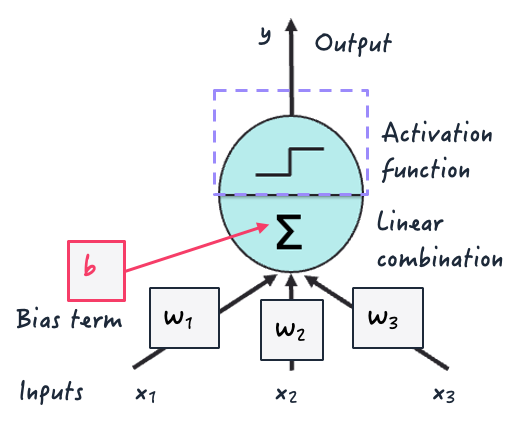
Fungsi aktivasi di dalam neuron buatan | Iván Palomares
Contoh fungsi aktivasi populer adalah logistik (logit), tangen hiperbolik (tanh), dan rectified linear unit (ReLU) seperti ditunjukkan di bawah.
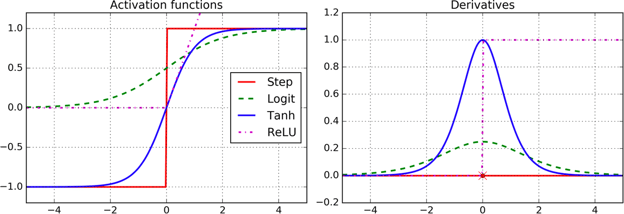
Contoh fungsi aktivasi | Gambar oleh Aurelien Geron (O’Reilly)
2. Bagaimana Anda mengevaluasi kinerja model deep learning?
Kinerja model deep learning dapat dievaluasi menggunakan metrik machine learning umum yang bergantung pada tugasnya.
Untuk klasifikasi, pertimbangkan metrik seperti akurasi, presisi, recall, F1-score, dan Area Under the Curve (AUC). Sementara itu, untuk regresi, kita dapat menggunakan metrik galat seperti Root Mean Square Error (RMSE).
Metrik-metrik ini harus digunakan untuk membandingkan prediksi model dengan label ground truth atau model baseline. Untuk model dan aplikasi yang lebih maju seperti NLP, ada beragam metrik khusus tugas bahasa seperti skor BLEU untuk penerjemahan, skor ROUGE untuk peringkasan, dan seterusnya.
3. Apa saja contoh penggunaan deep learning di bisnis dan industri?
Deep learning digunakan di berbagai aplikasi dunia nyata, beberapa di antaranya adalah:
- Pengenalan gambar dan objek di jalan untuk kendaraan otonom
- Pemrosesan dan pemahaman bahasa alami untuk chatbot dukungan pelanggan
- Analitik prediktif untuk rekomendasi yang dipersonalisasi di ritel
- Diagnosis medis berdasarkan citra rontgen
Pertanyaan Wawancara Rekayasa Deep Learning
Pertanyaan wawancara untuk peran deep learning berfokus pada rekayasa akan menyoroti aspek seperti kerangka pemrograman, pustaka, dan alat.
1. Bagaimana Anda menggunakan TensorFlow untuk membangun jaringan saraf feedforward sederhana untuk klasifikasi gambar?
Untuk membangun jaringan saraf feed-forward sederhana untuk klasifikasi gambar di TensorFlow, kita dapat mulai dengan mendefinisikan arsitektur model lapis demi lapis menggunakan TensorFlow Sequential API.
Ini mencakup menentukan jumlah neuron dan fungsi aktivasi yang sesuai per lapisan serta mendefinisikan lapisan akhir (lapisan keluaran) dengan aktivasi softmax.
Kemudian, kita akan mengompilasi model dengan menentukan fungsi loss yang sesuai seperti categorical cross-entropy, optimizer seperti Adam, dan metrik validasi sebelum melatihnya pada data pelatihan selama sejumlah epoch tertentu. Setelah model dibangun, kinerjanya pada set validasi dapat dievaluasi.
TensorFlow umum digunakan bersama Keras API, yang dapat Anda kuasai setelah menyelesaikan kursus Advanced Deep Learning with Keras.
2. Jelaskan pendekatan Anda menangani overfitting pada model deep learning melalui teknik regularisasi di PyTorch
Untuk menangani overfitting pada model deep learning yang diimplementasikan dengan PyTorch, strategi umum adalah memasukkan teknik regularisasi seperti regularisasi L1 atau L2 dengan menambahkan istilah penalti ke fungsi loss.
Sebagai alternatif, lapisan dropout dapat diperkenalkan untuk menonaktifkan neuron secara acak selama pelatihan; ini mencegah model terlalu bergantung pada fitur tertentu yang diekstraksi dari data.
Kedua strategi ini dapat dikombinasikan dengan early stopping untuk mengakhiri pelatihan ketika kinerja validasi mulai menurun.
Tertarik mengasah keterampilan PyTorch Anda? Pastikan untuk melihat kursus Introduction to Deep Learning in the PyTorch ini.
3. Berikan contoh penggunaan transfer learning untuk fine-tuning model deep learning pra-latih pada tugas baru
VGG, BERT, atau ResNet adalah contoh terkenal dari model pra-latih yang dapat dimuat untuk keperluan transfer learning dan fine-tuning. Secara spesifik, prosesnya melibatkan penggantian model head, yaitu lapisan klasifikasi akhir, dengan yang baru yang sesuai dengan tugas target.
Setelah perubahan struktural kecil pada arsitektur model ini, kita lanjutkan melatih ulang pada dataset baru menggunakan laju pembelajaran rendah untuk menyesuaikan bobot model dengan tugas baru sementara fitur utama yang awalnya dipelajari oleh model pra-latih sebagian besar dipertahankan.
Pertanyaan Wawancara Deep Learning untuk Computer Vision
Berikut adalah beberapa pertanyaan potensial yang mungkin diajukan pewawancara untuk posisi yang melibatkan pembangunan atau pengelolaan solusi deep learning di computer vision seperti aplikasi pemrosesan gambar.
1. Jelaskan convolutional neural network dan terapkan konsepnya pada tiga kasus penggunaan khas.
CNN adalah arsitektur deep learning khusus untuk memproses data visual. Tumpukan lapisan konvolusinya dan operasi yang mendasari pada data gambar dirancang untuk meniru korteks visual pada otak hewan.
CNN unggul pada tugas seperti klasifikasi gambar, deteksi objek, dan segmentasi gambar. Berikut deskripsi singkat kasus penggunaan untuk masing-masing tugas ini:
- Klasifikasi gambar: mengidentifikasi apakah sebuah gambar menampilkan anjing atau kucing untuk sistem identifikasi dan pemantauan hewan peliharaan otomatis.
- Deteksi objek: memungkinkan pelokalan dan pengenalan pejalan kaki secara real-time oleh kendaraan otonom.
- Segmentasi gambar: menggambarkan batas tumor dalam citra medis untuk mendiagnosis dan merawat pasien kanker secara akurat.
2. Jelaskan peran lapisan konvolusi dan pooling pada CNN
Lapisan konvolusi pada CNN bertugas mengekstraksi fitur pada gambar masukan. Lapisan ini menerapkan sekumpulan bobot yang dapat dipelajari yang disebut filter atau kernel untuk mendeteksi pola dan fitur seperti tepi, bentuk, dan tekstur beserta informasi serta hubungan spasialnya, sehingga mempelajari representasi visual hierarkis.
Sementara itu, lapisan pooling melakukan downsampling peta fitur (representasi gambar intermediate) keluaran lapisan konvolusi. Dengan kata lain, dimensi spasial atau resolusi aslinya dikurangi sementara informasi penting yang diekstrak dipertahankan.
Menggabungkan lapisan konvolusi berurutan dengan lapisan pooling dalam CNN membantu meningkatkan ketangguhan terhadap variasi masukan, mengurangi kompleksitas komputasi saat pelatihan dan inferensi, serta membantu mencegah masalah seperti overfitting.
3. Apa saja tantangan umum pada model deep learning yang dilatih untuk tugas computer vision?
Di antara tantangan dan keterbatasan biasa pada model deep learning, contoh berikut menjadi sangat menonjol pada model untuk computer vision seperti CNN:
- Kuantitas dan kualitas data: Model deep learning untuk computer vision memerlukan dataset berlabel yang sangat besar agar dapat dilatih dengan baik. Data ini juga harus memiliki kualitas yang memadai: gambar beresolusi tinggi dan bebas noise, bebas dari masalah seperti blur atau over-exposure, dll.
- Overfitting: CNN rentan menghafal noise atau detail spesifik (terkadang tidak relevan) dalam data pelatihan visual, sehingga menghasilkan generalisasi yang buruk.
- Sumber daya komputasi: Melatih arsitektur CNN yang dalam memerlukan sumber daya komputasi yang besar karena jumlah lapisan dan parameter terlatihnya yang banyak. Banyak di antaranya memerlukan GPU dan kapasitas memori besar untuk pelatihan yang lancar.
- Interpretabilitas: Memahami bagaimana model membuat prediksi (terutama yang salah) dalam tugas kompleks seperti pengenalan gambar masih menjadi tantangan.
Pertanyaan Wawancara Deep Learning untuk NLP
Berikut beberapa pertanyaan potensial yang mungkin diajukan pewawancara untuk posisi yang melibatkan pemanfaatan teknologi deep learning dalam aplikasi NLP.
1. Bagaimana mekanisme attention meningkatkan kinerja model deep learning untuk tugas NLP?
Transformer adalah keluarga arsitektur deep learning terobosan dan menjadi state-of-the-art saat ini untuk menangani berbagai masalah NLP yang menantang. Mekanisme attention sangat penting bagi arsitektur transformer yang menjadi dasar Large Language Model (LLM) seperti BERT dan GPT dan sangat berperan atas keberhasilan mereka.
Transformer memiliki kemampuan menangkap pola kompleks, informasi kontekstual, dan ketergantungan jarak jauh antar elemen dalam teks masukan, secara signifikan mengatasi masalah pada solusi sebelumnya seperti keterbatasan memori pada RNN (Recurrent Neural Network).
Mekanisme attention pada dasarnya membobotkan pentingnya setiap token dalam sebuah urutan, tanpa perlu memprosesnya token demi token.
Komponen penting dari transformer ini menghasilkan kemajuan signifikan dalam tugas seperti klasifikasi teks, pembangkitan bahasa, dan peringkasan teks, serta merevolusi area LLM dan AI secara keseluruhan.
Kursus Datacamp tentang Introduction to LLMs in Python membekali Anda tidak hanya dengan keterampilan praktis untuk membangun dan memanfaatkan LLM, tetapi juga pemahaman yang kuat tentang konsep utama seputar LLM dan arsitektur transformer.
2. Apa yang dimaksud dengan pre-training model dan fine-tuning model bagi arsitektur dan data deep learning dalam konteks NLP?
Pre-training model melatih model deep learning, seperti BERT, untuk klasifikasi teks, pada korpus data teks yang sangat besar (jutaan hingga miliaran contoh teks) guna mempelajari representasi bahasa untuk pemahaman bahasa umum.
Fine-tuning model, di sisi lain, melibatkan pengambilan model pra-latih dan menyetel ulang parameter yang telah dipelajarinya pada aplikasi NLP hilir tertentu, misalnya analisis sentimen ulasan hotel.
Karena fine-tuning biasanya ditujukan pada kasus penggunaan spesifik, ini memerlukan penggunaan dataset kecil dan khusus domain dari contoh teks berlabel, sehingga menyesuaikan bobot pada bagian-bagian model untuk mempelajari nuansa tugas target dan meningkatkan kinerja model dalam konteks tersebut tanpa biaya komputasi dan kebutuhan data untuk melatih model dari awal.
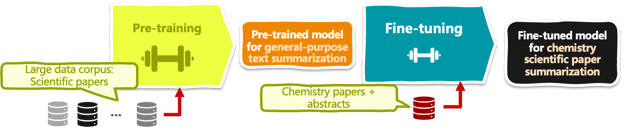
Contoh pre-training dan fine-tuning LLM untuk peringkasan makalah kimia | Iván Palomares
Arsitektur BERT adalah varian yang disederhanakan dari transformer encoder-decoder asli, disebut transformer hanya-encoder.
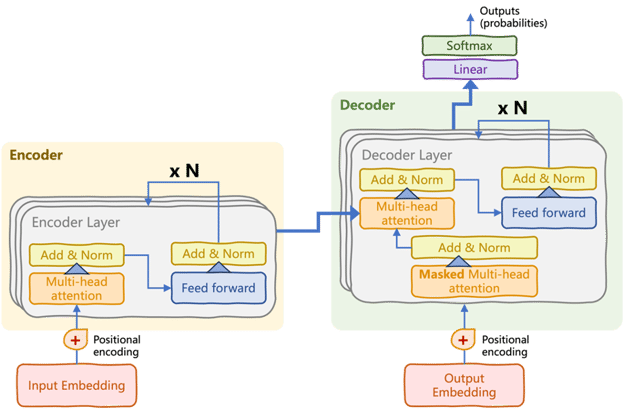
Arsitektur transformer asli, terbagi menjadi tumpukan encoder dan decoder | Introduction to LLMs in Python (Iván Palomares)
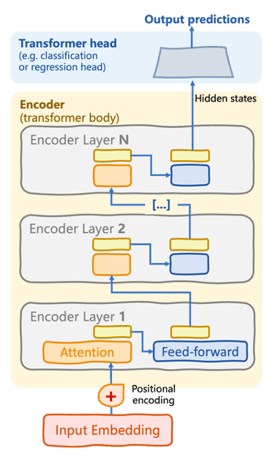
Arsitektur transformer hanya-encoder yang digunakan oleh model seperti BERT | Introduction to LLMs in Python (Iván Palomares)
Tumpukan encoder terdiri dari beberapa lapisan encoder (lihat diagram di atas). Dalam setiap lapisan, terdapat (sub)lapisan mekanisme self-attention dan jaringan saraf feedforward. Kunci proses pemahaman bahasa yang dilakukan BERT terletak pada aliran attention dua arah yang diterapkan berulang di dalam encoder, sehingga ketergantungan antar kata dalam sebuah urutan masukan ditangkap dalam kedua arah. Koneksi saraf feedforward "mengikat" ketergantungan yang dipelajari ini menjadi pola bahasa yang lebih kompleks.
Selain karakteristik umum transformer hanya-encoder ini, BERT dicirikan oleh pengintegrasian pendekatan Masked Language Modelling (MLM). Mekanisme ini digunakan selama pre-training untuk menutupi beberapa kata secara acak, sehingga memaksa model belajar memprediksi kata yang ditutupi berdasarkan pemahaman konteks di sekitarnya.
Pertanyaan Wawancara Deep Learning Tingkat Lanjut
Mari akhiri dengan tiga pertanyaan yang mungkin diajukan jika melamar peran deep learning tingkat lanjut.
1. Bagaimana Anda merancang dan mengimplementasikan model deep learning untuk masalah dengan data berlabel terbatas?
Strategi gabungan berikut dapat diimplementasikan untuk memaksimalkan kinerja model deep learning ketika menghadapi masalah umum berupa data pelatihan yang terbatas:
- Manfaatkan transfer learning dengan melakukan fine-tuning model pra-latih pada tugas khusus domain yang serupa dengan yang dilatih oleh model asli.
- Eksplorasi pembelajaran semi-terawasi dan pembelajaran swa-terawasi untuk memanfaatkan dataset yang sebagian besar tidak berlabel.
- Augmentasi data dan model generatif dapat membantu menghasilkan contoh data sintetis untuk memperkaya set berlabel asli.
- Metodologi active learning dapat digunakan untuk meminta pengguna memberikan sampel berlabel tambahan pada himpunan data tidak berlabel.
2. Dapatkah Anda menyebutkan tiga pertimbangan penting saat menerapkan model deep learning dalam skala besar di lingkungan produksi dunia nyata?
Menerapkan solusi deep learning dalam skala besar di lingkungan produksi menuntut perhatian pada beberapa pertimbangan, tiga di antaranya adalah:
- Skalabilitas dan kinerja model sangat krusial, memerlukan arsitektur dan pendekatan optimasi yang efisien untuk menangani aliran data besar secara real-time.
- Ketangguhan dan keandalan penting, dengan menetapkan prosedur pengujian dan validasi untuk menjamin kinerja yang konsisten dari waktu ke waktu dan di berbagai skenario.
- Memastikan standar privasi dan keamanan data serta kepatuhan regulasi untuk melindungi informasi sensitif. Ini adalah aspek vital guna mematuhi perilaku sistem yang bertanggung jawab dan penggunaan sistem deep learning serta meraih kepercayaan pengguna.
Pertimbangan penting lainnya untuk menerapkan model deep learning ke produksi mencakup infrastruktur perangkat keras dan jaringan, pemantauan sistem, dan integrasi tanpa hambatan dengan kerangka perangkat lunak yang ada.
3. Bagaimana Anda membayangkan kemajuan terbaru dalam deep learning akan membentuk masa depan bidang ini dalam hal aplikasi dan dampak yang lebih luas?
Terobosan deep learning terbaru berpotensi membentuk ulang banyak industri secara mendalam dan bahkan menciptakan yang baru.
Mekanisme attention yang digunakan dalam arsitektur transformer di balik LLM merevolusi bidang NLP, secara signifikan mendorong batas tugas NLP dan memungkinkan interaksi manusia-mesin yang lebih canggih melalui solusi AI percakapan, tanya jawab, dan banyak lagi. Penyertaan terbaru Retrieval Augmented Generation (RAG) semakin membantu LLM menghasilkan bahasa yang faktual dan berbasis bukti.
Reinforcement learning adalah salah satu tren AI paling menjanjikan karena prinsipnya meniru dasar cara manusia belajar. Integrasinya dengan arsitektur deep learning, khususnya model generatif seperti generative adversarial networks, berada di garis depan riset akademik saat ini. Nama besar seperti OpenAI, Google, dan Microsoft menggabungkan dua domain AI ini dalam solusi terbaru yang mampu menghasilkan konten "mirip nyata" dalam berbagai format.
Kemajuan terbaru ini dan lainnya telah secara drastis mendemokratisasi penggunaan AI oleh masyarakat, sehingga penting untuk menyoroti etika AI, aspek hukum, dan regulasi sebagai isu kunci untuk memastikan dampak bermanfaat dari solusi deep learning di seluruh masyarakat.
Penutup
Sebagai penutup eksplorasi pertanyaan wawancara deep learning yang umum, satu pengamatan jelas adalah bahwa kunci sukses bergantung pada perpaduan landasan teoretis, penguasaan keterampilan praktis yang kuat, dan tetap mengikuti perkembangan terbaru.
Deep learning bukan hanya tentang algoritme, model, dan pilihan desain arsitektur. Ini tentang mengidentifikasi solusi terbaik untuk menyelesaikan masalah data dunia nyata.
Dan belajar berkelanjutan adalah kuncinya. Datacamp menawarkan jalur keterampilan Deep Learning in Python yang menyeluruh serta dua jalur berorientasi aplikasi deep learning: pemrosesan gambar dan pemrosesan bahasa alami. Jalur-jalur ini menawarkan peta jalan terstruktur untuk meningkatkan keterampilan deep learning Anda, memastikan kesiapan untuk wawancara berikutnya.
Terakhir, lihat bagian akhir artikel ini tentang pertanyaan wawancara machine learning jika Anda mencari panduan umum tentang cara mempersiapkan wawancara deep learning. Karena deep learning adalah subbidang machine learning, memadukan panduan umum tersebut dengan 20 pertanyaan deep learning yang telah kita ulas di sini pasti akan membantu persiapan Anda.


 Dario Radečić · 15 min

 Javier Canales Luna · 14 min

 David Woods · 13 min


Mencari panduan untuk meraih peran impian dan mempertajam keterampilan deep learning Anda? Tidak perlu mencari lagi. Artikel ini menawarkan jawaban atas 20 pertanyaan wawancara umum untuk posisi deep learning, membantu Anda tampil unggul dalam wawancara hanya dengan sedikit latihan.
Pertanyaan Umum Wawancara Deep Learning
Pertanyaan deep learning umum biasanya berkaitan dengan pemahaman bidangnya, apa yang membedakannya dari area AI lainnya, menghubungkan masalah dunia nyata dengan solusi deep learning, serta memahami tantangan dan keterbatasannya.
1. Apa itu deep learning?
Deep learning adalah subbidang dari machine learning dan AI secara keseluruhan. Ini melibatkan pelatihan model besar berbasis jaringan saraf buatan pada data.
Model-model tersebut belajar menyelesaikan tugas prediksi dan inferensi yang menantang (seperti klasifikasi, regresi, pengenalan objek dalam gambar, dll.) dengan secara otomatis menemukan pola dan fitur kompleks yang mendasari data. Hal ini terjadi dengan meniru struktur internal yang kompleks di otak manusia.
Kursus Understanding Artificial Intelligence kami menguraikan secara komprehensif area dan tugas AI yang dapat diselesaikan, termasuk deep learning.
Area Kecerdasan Buatan yang saling terkait | Iván Palomares
2. Kapan Anda sebaiknya memilih deep learning dibanding solusi machine learning?
Solusi deep learning menonjol pada masalah dengan data berkompleksitas tinggi, misalnya data tidak terstruktur atau berdimensi tinggi.
Ini juga menjadi pilihan utama untuk masalah dengan jumlah data yang sangat besar atau yang memerlukan penangkapan pola yang halus: sering kali, deep learning berhasil mengekstrak dan memahami fitur data yang bermakna yang mungkin tidak ditemukan oleh pendekatan machine learning.
Berikut beberapa contoh masalah yang dapat diselesaikan oleh solusi deep learning:
Namun, perlu diingat bahwa untuk banyak tugas dan dataset yang lebih sederhana, model machine learning yang ringan seperti decision tree dan regressor sering kali sudah lebih dari cukup, sehingga menjadi pilihan lebih baik dibanding model deep learning karena lebih mudah dan murah untuk dilatih dan diterapkan.
Model deep learning biasanya menuntut keterampilan persiapan dan pemrosesan data yang matang; oleh karena itu Anda mungkin menemukan artikel berikut tentang wawancara data engineering bermanfaat.
3. Bagaimana Anda memilih pendekatan deep learning yang tepat untuk masalah dan data Anda?
Memutuskan pendekatan deep learning yang sesuai bergantung pada beberapa faktor, seperti sifat data, kompleksitas masalah, dan sumber daya komputasi yang tersedia.
Langkah-langkah berikut adalah resep sederhana namun efektif untuk membantu Anda membuat pilihan penting ini:
Tiga arsitektur deep learning umum dan penerapannya | Iván Palomares
4. Bagaimana Anda merancang arsitektur deep learning untuk klasifikasi?
Merancang arsitektur deep learning yang disesuaikan untuk tugas spesifik seperti klasifikasi mencakup pemilihan jumlah dan ukuran lapisan neuron yang tepat, serta memilih fungsi aktivasi yang sesuai.
Keputusan ini biasanya dibuat berdasarkan karakteristik data. Untuk klasifikasi gambar, Anda mungkin menggunakan tumpukan lapisan konvolusi dalam arsitektur untuk menangkap pola visual seperti warna (atau kombinasi warna), bentuk, tepi, dll.
Lapisan teratas yang terletak di akhir arsitektur deep learning Anda (model head) juga bergantung pada tugas Anda, karena harus dirancang untuk menghasilkan keluaran yang diinginkan.
Sebagai contoh, untuk masalah klasifikasi gambar seperti mengklasifikasikan gambar anak ayam ke dalam spesies burung, lapisan terakhir ini sebaiknya memiliki fungsi aktivasi softmax yang menghasilkan probabilitas kelas untuk menentukan kelas spesies burung yang paling mungkin dari gambar yang dianalisis.
Arsitektur deep learning untuk klasifikasi gambar | Iván Palomares
5. Apa saja tantangan umum pada model deep learning, dan bagaimana cara mengatasinya?
Tantangan yang sering menghambat penerapan model deep learning di dunia nyata mencakup overfitting, vanishing dan exploding gradients, serta kebutuhan akan sejumlah besar data berlabel untuk pelatihan. Kabar baiknya, berkat upaya riset yang berkelanjutan, ada pendekatan untuk mengatasinya.
Di atas solusi spesifik masalah, pastikan Anda menetapkan mekanisme pemantauan dan penyetelan model secara berkala untuk memastikan kinerja yang baik dalam jangka panjang.
Pertanyaan Wawancara Deep Learning untuk Lulusan Baru
Jika Anda lulusan baru atau mencari posisi deep learning pertama di pasar kerja, Anda dapat mengharapkan pertanyaan yang menguji perolehan pengetahuan dasar dan keterampilan praktis dalam melatih dan mengevaluasi model deep learning dalam setting eksperimental.
1. Apa itu fungsi aktivasi, dan mengapa fungsinya krusial dalam merancang model deep learning?
Fungsi aktivasi adalah fungsi matematis yang digunakan di semua arsitektur jaringan saraf dalam modern. Ini terjadi pada tingkat neuron, selama proses pemetaan beberapa masukan neuron menjadi nilai keluaran yang dikirim ke neuron di lapisan berikutnya.
Fungsi aktivasi sangat penting dalam model deep learning karena memperkenalkan non-linearitas, yang penting untuk memungkinkan model belajar hubungan dan pola kompleks dalam data selama pelatihan.
Jika tidak, model hanya akan mempelajari sedikit lebih dari pola linearitas dari data dengan menerapkan kombinasi linear beruntun dari masukan — seperti yang dilakukan model regresi linear klasik!
Fungsi aktivasi di dalam neuron buatan | Iván Palomares
Contoh fungsi aktivasi populer adalah logistik (logit), tangen hiperbolik (tanh), dan rectified linear unit (ReLU) seperti ditunjukkan di bawah.
Contoh fungsi aktivasi | Gambar oleh Aurelien Geron (O’Reilly)
2. Bagaimana Anda mengevaluasi kinerja model deep learning?
Kinerja model deep learning dapat dievaluasi menggunakan metrik machine learning umum yang bergantung pada tugasnya.
Untuk klasifikasi, pertimbangkan metrik seperti akurasi, presisi, recall, F1-score, dan Area Under the Curve (AUC). Sementara itu, untuk regresi, kita dapat menggunakan metrik galat seperti Root Mean Square Error (RMSE).
Metrik-metrik ini harus digunakan untuk membandingkan prediksi model dengan label ground truth atau model baseline. Untuk model dan aplikasi yang lebih maju seperti NLP, ada beragam metrik khusus tugas bahasa seperti skor BLEU untuk penerjemahan, skor ROUGE untuk peringkasan, dan seterusnya.
3. Apa saja contoh penggunaan deep learning di bisnis dan industri?
Deep learning digunakan di berbagai aplikasi dunia nyata, beberapa di antaranya adalah:
Pertanyaan Wawancara Rekayasa Deep Learning
Pertanyaan wawancara untuk peran deep learning berfokus pada rekayasa akan menyoroti aspek seperti kerangka pemrograman, pustaka, dan alat.
1. Bagaimana Anda menggunakan TensorFlow untuk membangun jaringan saraf feedforward sederhana untuk klasifikasi gambar?
Untuk membangun jaringan saraf feed-forward sederhana untuk klasifikasi gambar di TensorFlow, kita dapat mulai dengan mendefinisikan arsitektur model lapis demi lapis menggunakan TensorFlow Sequential API.
Ini mencakup menentukan jumlah neuron dan fungsi aktivasi yang sesuai per lapisan serta mendefinisikan lapisan akhir (lapisan keluaran) dengan aktivasi softmax.
Kemudian, kita akan mengompilasi model dengan menentukan fungsi loss yang sesuai seperti categorical cross-entropy, optimizer seperti Adam, dan metrik validasi sebelum melatihnya pada data pelatihan selama sejumlah epoch tertentu. Setelah model dibangun, kinerjanya pada set validasi dapat dievaluasi.
TensorFlow umum digunakan bersama Keras API, yang dapat Anda kuasai setelah menyelesaikan kursus Advanced Deep Learning with Keras.
2. Jelaskan pendekatan Anda menangani overfitting pada model deep learning melalui teknik regularisasi di PyTorch
Untuk menangani overfitting pada model deep learning yang diimplementasikan dengan PyTorch, strategi umum adalah memasukkan teknik regularisasi seperti regularisasi L1 atau L2 dengan menambahkan istilah penalti ke fungsi loss.
Sebagai alternatif, lapisan dropout dapat diperkenalkan untuk menonaktifkan neuron secara acak selama pelatihan; ini mencegah model terlalu bergantung pada fitur tertentu yang diekstraksi dari data.
Kedua strategi ini dapat dikombinasikan dengan early stopping untuk mengakhiri pelatihan ketika kinerja validasi mulai menurun.
Tertarik mengasah keterampilan PyTorch Anda? Pastikan untuk melihat kursus Introduction to Deep Learning in the PyTorch ini.
3. Berikan contoh penggunaan transfer learning untuk fine-tuning model deep learning pra-latih pada tugas baru
VGG, BERT, atau ResNet adalah contoh terkenal dari model pra-latih yang dapat dimuat untuk keperluan transfer learning dan fine-tuning. Secara spesifik, prosesnya melibatkan penggantian model head, yaitu lapisan klasifikasi akhir, dengan yang baru yang sesuai dengan tugas target.
Setelah perubahan struktural kecil pada arsitektur model ini, kita lanjutkan melatih ulang pada dataset baru menggunakan laju pembelajaran rendah untuk menyesuaikan bobot model dengan tugas baru sementara fitur utama yang awalnya dipelajari oleh model pra-latih sebagian besar dipertahankan.
Pertanyaan Wawancara Deep Learning untuk Computer Vision
Berikut adalah beberapa pertanyaan potensial yang mungkin diajukan pewawancara untuk posisi yang melibatkan pembangunan atau pengelolaan solusi deep learning di computer vision seperti aplikasi pemrosesan gambar.
1. Jelaskan convolutional neural network dan terapkan konsepnya pada tiga kasus penggunaan khas.
CNN adalah arsitektur deep learning khusus untuk memproses data visual. Tumpukan lapisan konvolusinya dan operasi yang mendasari pada data gambar dirancang untuk meniru korteks visual pada otak hewan.
CNN unggul pada tugas seperti klasifikasi gambar, deteksi objek, dan segmentasi gambar. Berikut deskripsi singkat kasus penggunaan untuk masing-masing tugas ini:
2. Jelaskan peran lapisan konvolusi dan pooling pada CNN
Lapisan konvolusi pada CNN bertugas mengekstraksi fitur pada gambar masukan. Lapisan ini menerapkan sekumpulan bobot yang dapat dipelajari yang disebut filter atau kernel untuk mendeteksi pola dan fitur seperti tepi, bentuk, dan tekstur beserta informasi serta hubungan spasialnya, sehingga mempelajari representasi visual hierarkis.
Sementara itu, lapisan pooling melakukan downsampling peta fitur (representasi gambar intermediate) keluaran lapisan konvolusi. Dengan kata lain, dimensi spasial atau resolusi aslinya dikurangi sementara informasi penting yang diekstrak dipertahankan.
Menggabungkan lapisan konvolusi berurutan dengan lapisan pooling dalam CNN membantu meningkatkan ketangguhan terhadap variasi masukan, mengurangi kompleksitas komputasi saat pelatihan dan inferensi, serta membantu mencegah masalah seperti overfitting.
3. Apa saja tantangan umum pada model deep learning yang dilatih untuk tugas computer vision?
Di antara tantangan dan keterbatasan biasa pada model deep learning, contoh berikut menjadi sangat menonjol pada model untuk computer vision seperti CNN:
Pertanyaan Wawancara Deep Learning untuk NLP
Berikut beberapa pertanyaan potensial yang mungkin diajukan pewawancara untuk posisi yang melibatkan pemanfaatan teknologi deep learning dalam aplikasi NLP.
1. Bagaimana mekanisme attention meningkatkan kinerja model deep learning untuk tugas NLP?
Transformer adalah keluarga arsitektur deep learning terobosan dan menjadi state-of-the-art saat ini untuk menangani berbagai masalah NLP yang menantang. Mekanisme attention sangat penting bagi arsitektur transformer yang menjadi dasar Large Language Model (LLM) seperti BERT dan GPT dan sangat berperan atas keberhasilan mereka.
Transformer memiliki kemampuan menangkap pola kompleks, informasi kontekstual, dan ketergantungan jarak jauh antar elemen dalam teks masukan, secara signifikan mengatasi masalah pada solusi sebelumnya seperti keterbatasan memori pada RNN (Recurrent Neural Network).
Mekanisme attention pada dasarnya membobotkan pentingnya setiap token dalam sebuah urutan, tanpa perlu memprosesnya token demi token.
Komponen penting dari transformer ini menghasilkan kemajuan signifikan dalam tugas seperti klasifikasi teks, pembangkitan bahasa, dan peringkasan teks, serta merevolusi area LLM dan AI secara keseluruhan.
Kursus Datacamp tentang Introduction to LLMs in Python membekali Anda tidak hanya dengan keterampilan praktis untuk membangun dan memanfaatkan LLM, tetapi juga pemahaman yang kuat tentang konsep utama seputar LLM dan arsitektur transformer.
2. Apa yang dimaksud dengan pre-training model dan fine-tuning model bagi arsitektur dan data deep learning dalam konteks NLP?
Pre-training model melatih model deep learning, seperti BERT, untuk klasifikasi teks, pada korpus data teks yang sangat besar (jutaan hingga miliaran contoh teks) guna mempelajari representasi bahasa untuk pemahaman bahasa umum.
Fine-tuning model, di sisi lain, melibatkan pengambilan model pra-latih dan menyetel ulang parameter yang telah dipelajarinya pada aplikasi NLP hilir tertentu, misalnya analisis sentimen ulasan hotel.
Karena fine-tuning biasanya ditujukan pada kasus penggunaan spesifik, ini memerlukan penggunaan dataset kecil dan khusus domain dari contoh teks berlabel, sehingga menyesuaikan bobot pada bagian-bagian model untuk mempelajari nuansa tugas target dan meningkatkan kinerja model dalam konteks tersebut tanpa biaya komputasi dan kebutuhan data untuk melatih model dari awal.
Contoh pre-training dan fine-tuning LLM untuk peringkasan makalah kimia | Iván Palomares
3. Dapatkah Anda menjelaskan arsitektur model transformer seperti BERT dan jenis tugas NLP yang dapat ditanganinya?
Arsitektur BERT adalah varian yang disederhanakan dari transformer encoder-decoder asli, disebut transformer hanya-encoder.
Arsitektur transformer asli, terbagi menjadi tumpukan encoder dan decoder | Introduction to LLMs in Python (Iván Palomares)
Arsitektur transformer hanya-encoder yang digunakan oleh model seperti BERT | Introduction to LLMs in Python (Iván Palomares)
Tumpukan encoder terdiri dari beberapa lapisan encoder (lihat diagram di atas). Dalam setiap lapisan, terdapat (sub)lapisan mekanisme self-attention dan jaringan saraf feedforward. Kunci proses pemahaman bahasa yang dilakukan BERT terletak pada aliran attention dua arah yang diterapkan berulang di dalam encoder, sehingga ketergantungan antar kata dalam sebuah urutan masukan ditangkap dalam kedua arah. Koneksi saraf feedforward "mengikat" ketergantungan yang dipelajari ini menjadi pola bahasa yang lebih kompleks.
Selain karakteristik umum transformer hanya-encoder ini, BERT dicirikan oleh pengintegrasian pendekatan Masked Language Modelling (MLM). Mekanisme ini digunakan selama pre-training untuk menutupi beberapa kata secara acak, sehingga memaksa model belajar memprediksi kata yang ditutupi berdasarkan pemahaman konteks di sekitarnya.
Pertanyaan Wawancara Deep Learning Tingkat Lanjut
Mari akhiri dengan tiga pertanyaan yang mungkin diajukan jika melamar peran deep learning tingkat lanjut.
1. Bagaimana Anda merancang dan mengimplementasikan model deep learning untuk masalah dengan data berlabel terbatas?
Strategi gabungan berikut dapat diimplementasikan untuk memaksimalkan kinerja model deep learning ketika menghadapi masalah umum berupa data pelatihan yang terbatas:
2. Dapatkah Anda menyebutkan tiga pertimbangan penting saat menerapkan model deep learning dalam skala besar di lingkungan produksi dunia nyata?
Menerapkan solusi deep learning dalam skala besar di lingkungan produksi menuntut perhatian pada beberapa pertimbangan, tiga di antaranya adalah:
Pertimbangan penting lainnya untuk menerapkan model deep learning ke produksi mencakup infrastruktur perangkat keras dan jaringan, pemantauan sistem, dan integrasi tanpa hambatan dengan kerangka perangkat lunak yang ada.
3. Bagaimana Anda membayangkan kemajuan terbaru dalam deep learning akan membentuk masa depan bidang ini dalam hal aplikasi dan dampak yang lebih luas?
Terobosan deep learning terbaru berpotensi membentuk ulang banyak industri secara mendalam dan bahkan menciptakan yang baru.
Mekanisme attention yang digunakan dalam arsitektur transformer di balik LLM merevolusi bidang NLP, secara signifikan mendorong batas tugas NLP dan memungkinkan interaksi manusia-mesin yang lebih canggih melalui solusi AI percakapan, tanya jawab, dan banyak lagi. Penyertaan terbaru Retrieval Augmented Generation (RAG) semakin membantu LLM menghasilkan bahasa yang faktual dan berbasis bukti.
Reinforcement learning adalah salah satu tren AI paling menjanjikan karena prinsipnya meniru dasar cara manusia belajar. Integrasinya dengan arsitektur deep learning, khususnya model generatif seperti generative adversarial networks, berada di garis depan riset akademik saat ini. Nama besar seperti OpenAI, Google, dan Microsoft menggabungkan dua domain AI ini dalam solusi terbaru yang mampu menghasilkan konten "mirip nyata" dalam berbagai format.
Kemajuan terbaru ini dan lainnya telah secara drastis mendemokratisasi penggunaan AI oleh masyarakat, sehingga penting untuk menyoroti etika AI, aspek hukum, dan regulasi sebagai isu kunci untuk memastikan dampak bermanfaat dari solusi deep learning di seluruh masyarakat.
Penutup
Sebagai penutup eksplorasi pertanyaan wawancara deep learning yang umum, satu pengamatan jelas adalah bahwa kunci sukses bergantung pada perpaduan landasan teoretis, penguasaan keterampilan praktis yang kuat, dan tetap mengikuti perkembangan terbaru.
Deep learning bukan hanya tentang algoritme, model, dan pilihan desain arsitektur. Ini tentang mengidentifikasi solusi terbaik untuk menyelesaikan masalah data dunia nyata.
Dan belajar berkelanjutan adalah kuncinya. Datacamp menawarkan jalur keterampilan Deep Learning in Python yang menyeluruh serta dua jalur berorientasi aplikasi deep learning: pemrosesan gambar dan pemrosesan bahasa alami. Jalur-jalur ini menawarkan peta jalan terstruktur untuk meningkatkan keterampilan deep learning Anda, memastikan kesiapan untuk wawancara berikutnya.
Terakhir, lihat bagian akhir artikel ini tentang pertanyaan wawancara machine learning jika Anda mencari panduan umum tentang cara mempersiapkan wawancara deep learning. Karena deep learning adalah subbidang machine learning, memadukan panduan umum tersebut dengan 20 pertanyaan deep learning yang telah kita ulas di sini pasti akan membantu persiapan Anda.