Zoek je houvast om je droombaan te bemachtigen en je deep-learningvaardigheden aan te scherpen? Zoek niet verder. In dit artikel vind je antwoorden op 20 veelvoorkomende sollicitatievragen voor deep-learningfuncties, zodat je met een beetje oefening kunt excelleren tijdens interviews.
Algemene sollicitatievragen over deep learning
Algemene vragen over deep learning gaan meestal over begrip van het vakgebied, wat het onderscheidt van andere AI-domeinen, het koppelen van real‑world problemen aan deep‑learningsoplossingen en het inzicht in bijbehorende uitdagingen en beperkingen.
1. Wat is deep learning?
Deep learning is een deelgebied van machine learning en AI als geheel. Het houdt in dat grote modellen op basis van kunstmatige neurale netwerken worden getraind op data.
De modellen leren lastige voorspellings- en inferentietaken op te lossen (zoals classificatie, regressie, objectherkenning in beelden, enz.) door automatisch complexe patronen en kenmerken in de data te ontdekken. Dit gebeurt door de complexe interne structuren in het menselijk brein na te bootsen.
Onze cursus Understanding Artificial Intelligence ontrafelt de domeinen en oplosbare taken van AI, waaronder deep learning, op een begrijpelijke manier.
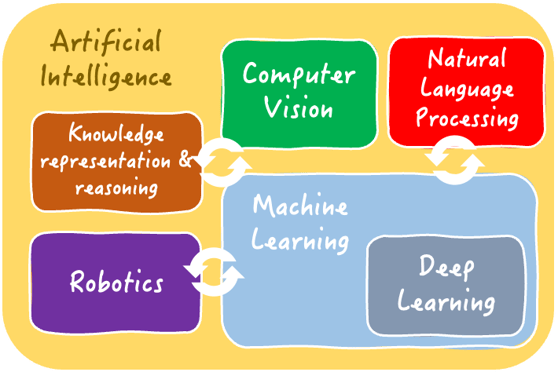
De onderling verbonden domeinen van Artificial Intelligence | Iván Palomares
2. Wanneer kies je voor deep learning in plaats van machine-learningoplossingen?
Deep‑learningsoplossingen blinken uit bij problemen waarbij de data hoge complexiteit heeft, bijvoorbeeld ongestructureerde of hoog-dimensionale data.
Het is ook de voorkeursoptie voor problemen met enorme hoeveelheden data of wanneer subtiele patronen moeten worden vastgelegd: vaak slagen ze erin betekenisvolle kenmerken uit data te extraheren en te begrijpen die machine‑learningbenaderingen mogelijk missen.
Hier zijn enkele voorbeelden van problemen die met deep learning oplosbaar zijn:
- Beelden van dier- of plantensoorten classificeren
- Langetermijnvoorspellingen van beurskoersen
- Gezichtsherkenning in afbeeldingen
- Natural language processing‑taken zoals spraakherkenning, taalvertaling en meer
Let wel: voor veel eenvoudigere taken en datasets zijn lichte machine‑learningmodellen zoals beslisbomen en regressiemodellen vaak ruim voldoende, waardoor ze een betere keuze zijn dan deep‑learningmodellen omdat ze eenvoudiger en goedkoper te trainen en te implementeren zijn.
Deep‑learningmodellen vragen doorgaans om grondige vaardigheden in datapreparatie en -verwerking; daarom kan het volgende artikel over data-engineeringinterviews nuttig zijn.
3. Hoe kies je de juiste deep-learningaanpak voor jouw probleem en data?
De keuze voor een geschikte deep‑learningaanpak hangt af van verschillende factoren, zoals de aard van de data, de complexiteit van het probleem en de beschikbare rekenbronnen.
De volgende stappen vormen een eenvoudige maar effectieve leidraad om deze belangrijke keuze te maken:
- Voer een grondige analyse uit van je datakenmerken. Is het gestructureerd of ongestructureerd? Zijn er temporele of ruimtelijke afhankelijkheden? Wat is/zijn de targetvariabele(n) die je met je model wilt voorspellen?
- Kies op basis van de data‑analyse het meest geschikte type deep‑learningarchitectuur. Zo blinken convolutionele neurale netwerken (CNN's) uit in het verwerken van visuele data, terwijl recurrente neurale netwerken (RNN's) bijzonder effectief zijn voor sequentiële data.
- Overweeg aanvullende factoren zoals modeluitlegbaarheid, schaalbaarheid en de beschikbaarheid van gelabelde data voor training. Verschillende deep‑learningarchitecturen gaan in uiteenlopende mate met deze aspecten om.
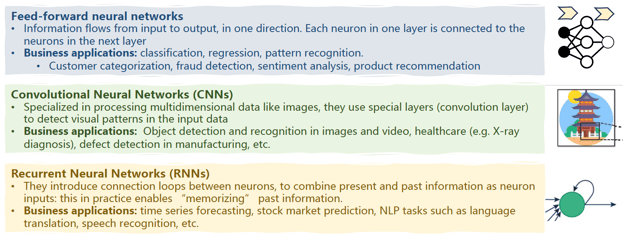
Drie veelvoorkomende deep‑learningarchitecturen en hun toepassingen | Iván Palomares
4. Hoe zou je een deep‑learningsoplossing voor classificatie ontwerpen?
Het ontwerpen van een deep‑learningarchitectuur voor een specifieke taak zoals classificatie houdt in dat je het juiste aantal en de juiste grootte van lagen met neuronen kiest, evenals de passende activatiefuncties.
Deze beslissingen zijn doorgaans gebaseerd op de kenmerken van de data. Voor beeldclassificatie kun je bijvoorbeeld een stapel convolutionele lagen gebruiken om visuele patronen vast te leggen zoals kleuren (of kleurcombinaties), vormen, randen, enz.
De bovenste laag aan het einde van je deep‑learningarchitectuur (de modelkop) hangt ook af van je taak, omdat die zo ontworpen moet zijn dat de gewenste output wordt geproduceerd.
Voor een beeldclassificatietaak zoals het indelen van kuikens in vogelsoorten, moeten deze laatste lagen bijvoorbeeld een softmax‑activatiefunctie hebben die klassewaarschijnlijkheden uitgeeft om te bepalen tot welke vogelsoort de geanalyseerde afbeelding het meest waarschijnlijk behoort.
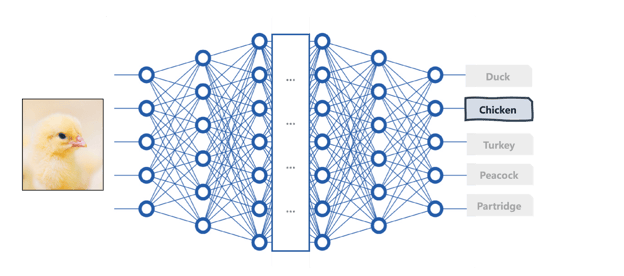
Een deep‑learningarchitectuur voor beeldclassificatie | Iván Palomares
5. Wat zijn enkele veelvoorkomende uitdagingen bij deep‑learningmodellen en hoe pak je die aan?
Veelvoorkomende uitdagingen die het succesvol toepassen van deep‑learningmodellen in de praktijk kunnen belemmeren, zijn overfitting, verdwijnende en exploderende gradiënten en de noodzaak van grote hoeveelheden gelabelde data voor training. Goed nieuws: dankzij doorlopend onderzoek bestaan er aanpakken om dit te adresseren.
- Overfitting treedt op wanneer een model zo leert dat het de trainingsdata "te veel uit het hoofd leert", waardoor het moeite heeft om correcte inferenties te doen op toekomstige, ongeziene data. Om dit aan te pakken zijn er technieken gericht op het verminderen van de modelcomplexiteit, zoals regularisatie, of het beperken van hoeveel het model leert uit de data, bijvoorbeeld via early stopping.
- Verdwijnende en exploderende gradiënten houden verband met convergentieproblemen naar niet‑optimale oplossingen tijdens het bijwerken van gewichten in het trainingsproces. Gradient clipping en geavanceerde activatiefuncties kunnen dit probleem helpen beperken.
- Als de uitdaging beperkte gelabelde data is, verken dan transfer learning en data‑augmentatie om respectievelijk voorgetrainde modellen te benutten of synthetische data te genereren.
Naast deze probleemgerichte oplossingen is het belangrijk om regelmatige modelmonitoring en -fijnafstelling in te richten om langdurig goede prestaties te borgen.
Sollicitatievragen deep learning voor pas afgestudeerden
Als je net bent afgestudeerd of je eerste deep‑learningfunctie zoekt, kun je vragen verwachten die je basiskennis en praktische vaardigheden testen in het trainen en evalueren van deep‑learningmodellen in een experimentele setting.
1. Wat zijn activatiefuncties en waarom zijn ze cruciaal bij het ontwerpen van deep‑learningmodellen?
Activatiefuncties zijn wiskundige functies die in alle moderne deep‑neural‑networkarchitecturen worden gebruikt. Dit gebeurt op neuronniveau, tijdens het omzetten van meerdere neuroninvoeren naar een uitvoerwaarde die wordt doorgegeven aan neuronen in de volgende laag.
Ze zijn cruciaal in deep‑learningmodellen omdat ze non‑lineariteit introduceren, wat essentieel is om tijdens training complexe relaties en patronen in de data te leren.
Zonder die functies zouden ze nauwelijks meer dan lineaire patronen uit de data leren door opeenvolgende lineaire combinaties van invoeren toe te passen — net zoals klassieke lineaire regressiemodellen dat doen!
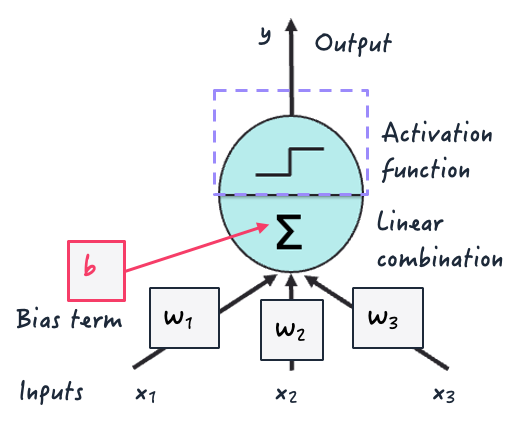
Activatiefunctie binnen een kunstmatig neuron | Iván Palomares
Voorbeelden van populaire activatiefuncties zijn de logistische (logit), hyperbolische tangens (tanh) en rectified linear unit (ReLU), zoals hieronder afgebeeld.
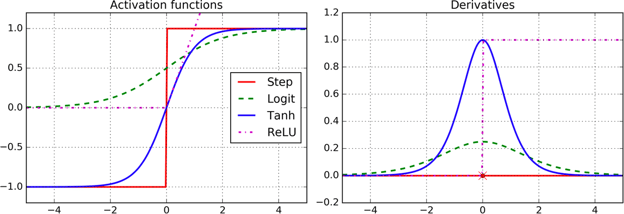
Voorbeelden van activatiefuncties | Afbeelding door Aurelien Geron (O’Reilly)
2. Hoe zou je de prestaties van een deep‑learningmodel evalueren?
De prestaties van deep‑learningmodellen kunnen worden geëvalueerd met gangbare machine‑learningmetrics, afhankelijk van de taak.
Voor classificatie kun je kijken naar metrics zoals nauwkeurigheid (accuracy), precisie, recall, F1‑score en Area Under the Curve (AUC). Voor regressie gebruiken we foutmaten zoals Root Mean Square Error (RMSE).
Deze metrics gebruik je om modelvoorspellingen te benchmarken tegen ground‑truthlabels of basismodellen. Voor geavanceerde modellen en toepassingen zoals NLP zijn er taakspecifieke metriek zoals BLEU‑score voor vertaling, ROUGE‑score voor samenvatting, enzovoort.
3. Wat zijn enkele voorbeelden van hoe deep learning wordt ingezet in het bedrijfsleven en de industrie?
Deep learning wordt gebruikt in een breed scala aan real‑world toepassingen, waaronder:
- Beeld- en objectherkenning op de weg voor autonome voertuigen
- Natural language processing en -begrip voor klantenservicechatbots
- Predictive analytics voor gepersonaliseerde aanbevelingen in retail
- Medische diagnose op basis van röntgenbeelden
Sollicitatievragen voor deep‑learningengineering
Vragen voor een engineeringgerichte deep‑learningrol richten zich op zaken als programmeerframeworks, libraries en tools.
1. Hoe zou je TensorFlow gebruiken om een eenvoudig feedforward neuronaal netwerk voor beeldclassificatie te bouwen?
Om in TensorFlow een eenvoudig feed‑forward neuronaal netwerk voor beeldclassificatie te bouwen, kun je beginnen met het laag‑voor‑laag definiëren van de modelarchitectuur met de TensorFlow Sequential API.
Dit omvat het specificeren van het juiste aantal neuronen en activatiefuncties per laag en het definiëren van de uiteindelijke laag (outputlaag) met softmax‑activatie.
Vervolgens compileer je het model met een geschikte verliesfunctie zoals categorische cross‑entropy, een optimizer zoals Adam en validatiemetriek, voordat je het traint op de trainingsdata gedurende een bepaald aantal epochs. Zodra het model is gebouwd, kun je de prestaties op de validatieset evalueren.
TensorFlow wordt vaak gebruikt samen met de Keras‑API, die je onder de knie krijgt na het volgen van de cursus Advanced Deep Learning with Keras.
2. Beschrijf je aanpak om overfitting in een deep‑learningmodel te behandelen via regularisatietechnieken in PyTorch
Om overfitting in een deep‑learningmodel in PyTorch aan te pakken, is een gangbare strategie het opnemen van regularisatietechnieken zoals L1‑ of L2‑regularisatie met straftermen die aan de verliesfunctie worden toegevoegd.
Daarnaast kun je dropoutlagen introduceren om tijdens training willekeurig neuronen uit te schakelen; dit voorkomt dat het model te veel vertrouwt op specifieke kenmerken die uit de data zijn gehaald.
Deze twee strategieën kun je combineren met early stopping om de training te beëindigen zodra de validatieprestatie begint te verslechteren.
Wil je je PyTorch‑skills aanscherpen? Bekijk dan zeker de cursus Introduction to Deep Learning in the PyTorch.
3. Geef een voorbeeld van transfer learning om een voorgetraind deep‑learningmodel te fine‑tunen voor een nieuwe taak
VGG, BERT of ResNet zijn bekende voorbeelden van voorgetrainde modellen die je kunt laden voor transfer learning en fine‑tuning. Concreet houdt het proces in dat je de modelkop, oftewel de laatste classificatielaag, vervangt door een nieuwe die past bij de doeltaak.
Na deze kleine structurele wijziging in de modelarchitectuur train je het opnieuw op een nieuwe dataset met een lage learning rate, zodat de modelgewichten zich aanpassen aan de nieuwe taak terwijl de belangrijkste kenmerken die het voorgetrainde model oorspronkelijk heeft geleerd grotendeels behouden blijven.
Sollicitatievragen deep learning voor computervisie
De volgende vragen kan een interviewer stellen voor een functie waarin je deep‑learningsoplossingen voor computervisie bouwt of beheert, zoals beeldverwerkingstoepassingen.
1. Leg convolutionele neurale netwerken uit en pas het concept toe op drie typische use‑cases.
CNN's zijn gespecialiseerde deep‑learningarchitecturen voor het verwerken van visuele data. Hun stapel convolutionele lagen en onderliggende operaties op beelddata zijn ontworpen om de visuele cortex in dierenhersenen na te bootsen.
CNN's blinken uit in taken zoals beeldclassificatie, objectdetectie en beeldsegmentatie. Hier is een korte use‑casebeschrijving voor elk van deze taken:
- Beeldclassificatie: bepaalt of een afbeelding een hond of een kat toont voor geautomatiseerde systemen voor huisdieridentificatie en -monitoring.
- Objectdetectie: maakt realtime lokalisatie en herkenning van voetgangers mogelijk door autonome voertuigen.
- Beeldsegmentatie: geeft tumorranden weer in medische beelden om kankerpatiënten nauwkeurig te diagnosticeren en te behandelen.
2. Beschrijf de rol van convolution- en poolinglagen in CNN's
Convolutionlagen in CNN's zijn verantwoordelijk voor feature‑extractie op invoerbeelden. Ze passen een set leerbare gewichten toe, filters of kernels genoemd, om patronen en kenmerken te detecteren zoals randen, vormen en texturen, samen met hun ruimtelijke informatie en relaties, en leren zo hiërarchische visuele representaties.
Ondertussen downsamplen poolinglagen featuremaps (intermediaire beeldrepresentaties) die door convolutionele lagen worden gegenereerd. Met andere woorden: hun oorspronkelijke ruimtelijke dimensie of resolutie wordt verkleind terwijl belangrijke informatie behouden blijft.
Het combineren van opeenvolgende convolutionlagen met poolinglagen in een CNN verhoogt de robuustheid tegen variaties in invoer, vermindert de rekencomplexiteit tijdens training en inferentie en helpt problemen zoals overfitting te voorkomen.
3. Wat zijn enkele veelvoorkomende uitdagingen bij deep‑learningmodellen die zijn getraind voor computervisie?
Onder de gebruikelijke uitdagingen en beperkingen van deep‑learningmodellen vallen de volgende voorbeelden extra op bij modellen voor computervisie zoals CNN's:
- Hoeveelheid en kwaliteit van data: Deep‑learningmodellen voor computervisie vereisen zeer grote gelabelde datasets om goed te kunnen trainen. Deze data moeten ook voldoende kwaliteit hebben: hoge resolutie en ruisvrije beelden, zonder problemen zoals wazigheid of overbelichting, enz.
- Overfitting: CNN's kunnen de neiging hebben om ruis of specifieke (soms irrelevante) details in visuele trainingsdata te memoriseren, wat tot slechte generalisatie leidt.
- Rekenmiddelen: Het trainen van diepe CNN‑architecturen vereist aanzienlijke rekenkracht vanwege het grote aantal lagen en trainbare parameters. Veel modellen hebben GPU's en grote geheugencapaciteit nodig voor soepel trainen.
- Uitlegbaarheid: Begrijpen hoe modellen voorspellingen doen (vooral foutieve) bij complexe taken zoals beeldherkenning blijft een uitdaging.
Sollicitatievragen deep learning voor NLP
Hier zijn enkele mogelijke vragen die een interviewer kan stellen voor een functie waarbij je deep‑learningtechnologieën inzet in NLP‑toepassingen.
1. Hoe verbeteren attention‑mechanismen de prestaties van deep‑learningmodellen voor NLP‑taken?
Transformers zijn een baanbrekende familie van deep‑learningarchitecturen en de huidige state‑of‑the‑art voor een breed scala aan uitdagende NLP‑problemen. Attention‑mechanismen zijn cruciaal voor transformerarchitecturen die ten grondslag liggen aan Large Language Models (LLM's) zoals BERT en GPT en bepalen grotendeels hun succes.
Transformers kunnen complexe patronen, contextuele informatie en langetermijnafhankelijkheden tussen elementen van een invoertekst vastleggen, waarmee ze problemen van eerdere oplossingen — zoals beperkte geheugenlengte in RNN's (Recurrent Neural Networks) — aanzienlijk overwinnen.
Attention‑mechanismen wegen in essentie het belang van elk token in een sequentie, zonder dat die token‑voor‑token verwerkt hoeft te worden.
Deze belangrijke component van transformers heeft geleid tot grote vooruitgang in taken zoals tekstclassificatie, taal‑generatie en samenvatting, en heeft het domein van LLM's en AI als geheel getransformeerd.
De Datacamp‑cursus Introduction to LLMs in Python leert je niet alleen praktische skills om LLM's te bouwen en te benutten, maar ook de kernconcepten rond LLM's en transformerarchitecturen.
2. Wat houden modelpre‑training en model‑fine‑tuning in voor deep‑learningarchitecturen en data in de context van NLP?
Modelpre‑training traint een deep‑learningmodel, zoals BERT voor tekstclassificatie, op een grote tekstcorpus (miljoenen tot miljarden voorbeeldteksten) om taalrepresentaties te leren voor algemeen taalbegrip.
Model‑fine‑tuning houdt daarentegen in dat je een voorgetraind model neemt en de geleerde parameters bijstelt voor een specifieke downstream NLP‑toepassing, bijvoorbeeld sentimentanalyse van hotelreviews.
Omdat fine‑tuning doorgaans op specifieke use‑cases is gericht, vereist dit een kleine, domeinspecifieke dataset met gelabelde tekstvoorbeelden, zodat de gewichten in delen van het model zich aanpassen aan de nuances van de doeltaak. Zo verbeter je de modelprestatie in die specifieke context, zonder de rekenkosten en data‑eisen van trainen vanaf nul.
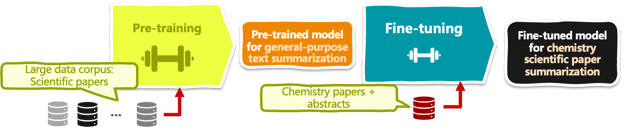
Voorbeeld van modelpre‑training en fine‑tuning van een LLM voor het samenvatten van chemie‑artikelen | Iván Palomares
De architectuur van BERT is een vereenvoudigde variant van de oorspronkelijke encoder‑decodertransformer, de zogeheten enkel‑encodertransformer.
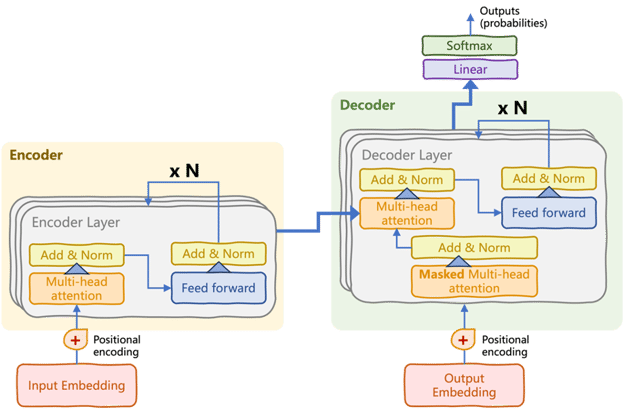
De oorspronkelijke transformerarchitectuur, opgedeeld in encoder- en decoderstacks | Introduction to LLMs in Python (Iván Palomares)
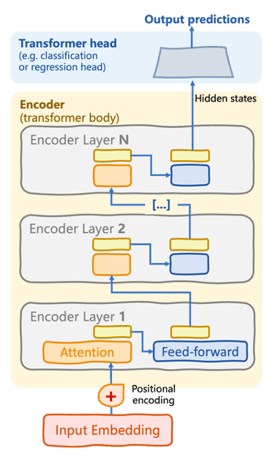
Enkel‑encoderarchitectuur gebruikt door modellen zoals BERT | Introduction to LLMs in Python (Iván Palomares)
De encoderstack bestaat uit meerdere encoderlagen (zie het bovenstaande diagram). Binnen elke laag zijn er (sub)lagen met self‑attentionmechanismen en feed‑forward neurale netwerken. De sleutel tot het taalbegrip van BERT ligt in de bidirectionele attention‑stroom die iteratief in de encoder wordt toegepast, zodat afhankelijkheden tussen woorden in een invoersequentie in beide richtingen worden vastgelegd. Feed‑forward neurale verbindingen "smeden" deze geleerde afhankelijkheden samen tot complexere taalpatronen.
Naast dit algemene kenmerk van enkel‑encodertransformers wordt BERT gekenmerkt door het toepassen van Masked Language Modelling (MLM). Dit mechanisme wordt tijdens pre‑training gebruikt om willekeurig woorden te maskeren, zodat het model gedwongen wordt gemaskeerde woorden te voorspellen op basis van begrip van de omliggende context.
Geavanceerde sollicitatievragen over deep learning
Laten we afsluiten met drie vragen die je kunt krijgen als je solliciteert naar een geavanceerde deep‑learningrol.
1. Hoe zou je een deep‑learningmodel ontwerpen en implementeren voor een probleem met beperkt gelabelde data?
De volgende gecombineerde strategie kun je inzetten om de prestaties van een deep‑learningmodel te maximaliseren bij het veelvoorkomende probleem van beperkte trainingsdata:
- Gebruik transfer learning door voorgetrainde modellen te fine‑tunen op een soortgelijke domeinspecifieke taak als waarvoor het oorspronkelijke model is getraind.
- Verken semi‑supervised en self‑supervised learning om optimaal gebruik te maken van grotendeels ongelabelde datasets.
- Data‑augmentatie en generatieve modellen kunnen helpen om synthetische data te genereren om de oorspronkelijke gelabelde set te verrijken.
- Active‑learningmethodologieën kunnen worden gebruikt om gebruikers te bevragen en extra gelabelde voorbeelden te verkrijgen op een set ongelabelde data.
2. Kun je drie belangrijke aandachtspunten noemen bij het uitrollen van deep‑learningmodellen op schaal in productieomgevingen?
Het uitrollen van deep‑learningsoplossingen op schaal in productie vergt aandacht voor verschillende aspecten, waarvan er drie zijn:
- Modelschaalbaarheid en prestaties zijn cruciaal; efficiënte architecturen en optimalisatie‑aanpakken zijn nodig om realtime grote datastromen te verwerken.
- Robuustheid en betrouwbaarheid zijn essentieel; richt test- en validatieprocedures in om consistente prestaties door de tijd en in verschillende scenario's te garanderen.
- Zorg voor normen rond dataprivacy en -beveiliging en regulatoire naleving om gevoelige informatie te beschermen. Dit is vitaal voor verantwoord systeemgedrag en het winnen van vertrouwen van gebruikers.
Andere belangrijke overwegingen bij productie‑deployments van deep‑learningmodellen zijn hardware- en netwerkinfrastructuur, systeemmonitoring en naadloze integratie met bestaande softwareframeworks.
3. Hoe zie je dat recente vooruitgang in deep learning de toekomst van het vakgebied kan vormen qua toepassingen en bredere impact?
Recente doorbraken in deep learning hebben het potentieel om talloze sectoren ingrijpend te veranderen en zelfs nieuwe industrieën te creëren.
Attention‑mechanismen in de transformerarchitecturen achter LLM's revolutioneren het NLP‑veld, verleggen de grenzen van NLP‑taken en maken geavanceerdere mens‑machine‑interacties mogelijk via conversational AI, vraag‑antwoordsystemen en veel meer. De recente toevoeging van Retrieval Augmented Generation (RAG) helpt LLM's bovendien om waarheidsgetrouwe en onderbouwde taal te produceren.
Reinforcement learning is een van de meest veelbelovende AI‑trends omdat de principes de basis van menselijk leren nabootsen. De integratie met deep‑learningarchitecturen, met name generatieve modellen zoals generative adversarial networks, staat centraal in het wetenschappelijk onderzoek van vandaag. Grote namen als OpenAI, Google en Microsoft combineren deze twee AI‑domeinen in baanbrekende oplossingen die "levensechte" content in meerdere formaten kunnen genereren.
Deze en andere recente ontwikkelingen hebben het gebruik van AI door de samenleving drastisch gedemocratiseerd, waardoor het belangrijk is om te focussen op AI‑ethiek, juridische aspecten en regulering als sleutelthema om een positieve impact van deep‑learningsoplossingen op de samenleving te waarborgen.
Afronding
Samenvattend: bij het beantwoorden van veelvoorkomende sollicitatievragen over deep learning draait succes om een mix van theoretische basis, sterke praktische vaardigheden en up‑to‑date blijven met de nieuwste ontwikkelingen.
Deep learning gaat niet alleen over algoritmes, modellen en architectuurkeuzes. Het draait om het vinden van de beste oplossingen voor echte dataproblemen.
En blijven leren is key. Datacamp biedt een uitgebreid Deep Learning in Python skill‑track en twee toepassingsgerichte tracks: image processing en natural language processing. Deze tracks bieden een gestructureerde routekaart om je deep‑learningvaardigheden te versterken, zodat je klaar bent voor je volgende interview.
Bekijk tot slot de laatste secties van dit artikel over sollicitatievragen voor machine learning als je op zoek bent naar algemene richtlijnen om je voor te bereiden op je deep‑learninginterview. Omdat deep learning een subveld van machine learning is, helpt het zeker om die algemene richtlijnen te combineren met de 20 deep‑learningvragen die we hier hebben doorgenomen.



 Adel Nehme · 15 min
Zoek je houvast om je droombaan te bemachtigen en je deep-learningvaardigheden aan te scherpen? Zoek niet verder. In dit artikel vind je antwoorden op 20 veelvoorkomende sollicitatievragen voor deep-learningfuncties, zodat je met een beetje oefening kunt excelleren tijdens interviews.
Algemene sollicitatievragen over deep learning
Algemene vragen over deep learning gaan meestal over begrip van het vakgebied, wat het onderscheidt van andere AI-domeinen, het koppelen van real‑world problemen aan deep‑learningsoplossingen en het inzicht in bijbehorende uitdagingen en beperkingen.
1. Wat is deep learning?
Deep learning is een deelgebied van machine learning en AI als geheel. Het houdt in dat grote modellen op basis van kunstmatige neurale netwerken worden getraind op data.
De modellen leren lastige voorspellings- en inferentietaken op te lossen (zoals classificatie, regressie, objectherkenning in beelden, enz.) door automatisch complexe patronen en kenmerken in de data te ontdekken. Dit gebeurt door de complexe interne structuren in het menselijk brein na te bootsen.
Onze cursus Understanding Artificial Intelligence ontrafelt de domeinen en oplosbare taken van AI, waaronder deep learning, op een begrijpelijke manier.
De onderling verbonden domeinen van Artificial Intelligence | Iván Palomares
2. Wanneer kies je voor deep learning in plaats van machine-learningoplossingen?
Deep‑learningsoplossingen blinken uit bij problemen waarbij de data hoge complexiteit heeft, bijvoorbeeld ongestructureerde of hoog-dimensionale data.
Het is ook de voorkeursoptie voor problemen met enorme hoeveelheden data of wanneer subtiele patronen moeten worden vastgelegd: vaak slagen ze erin betekenisvolle kenmerken uit data te extraheren en te begrijpen die machine‑learningbenaderingen mogelijk missen.
Hier zijn enkele voorbeelden van problemen die met deep learning oplosbaar zijn:
Let wel: voor veel eenvoudigere taken en datasets zijn lichte machine‑learningmodellen zoals beslisbomen en regressiemodellen vaak ruim voldoende, waardoor ze een betere keuze zijn dan deep‑learningmodellen omdat ze eenvoudiger en goedkoper te trainen en te implementeren zijn.
Deep‑learningmodellen vragen doorgaans om grondige vaardigheden in datapreparatie en -verwerking; daarom kan het volgende artikel over data-engineeringinterviews nuttig zijn.
3. Hoe kies je de juiste deep-learningaanpak voor jouw probleem en data?
De keuze voor een geschikte deep‑learningaanpak hangt af van verschillende factoren, zoals de aard van de data, de complexiteit van het probleem en de beschikbare rekenbronnen.
De volgende stappen vormen een eenvoudige maar effectieve leidraad om deze belangrijke keuze te maken:
Drie veelvoorkomende deep‑learningarchitecturen en hun toepassingen | Iván Palomares
4. Hoe zou je een deep‑learningsoplossing voor classificatie ontwerpen?
Het ontwerpen van een deep‑learningarchitectuur voor een specifieke taak zoals classificatie houdt in dat je het juiste aantal en de juiste grootte van lagen met neuronen kiest, evenals de passende activatiefuncties.
Deze beslissingen zijn doorgaans gebaseerd op de kenmerken van de data. Voor beeldclassificatie kun je bijvoorbeeld een stapel convolutionele lagen gebruiken om visuele patronen vast te leggen zoals kleuren (of kleurcombinaties), vormen, randen, enz.
De bovenste laag aan het einde van je deep‑learningarchitectuur (de modelkop) hangt ook af van je taak, omdat die zo ontworpen moet zijn dat de gewenste output wordt geproduceerd.
Voor een beeldclassificatietaak zoals het indelen van kuikens in vogelsoorten, moeten deze laatste lagen bijvoorbeeld een softmax‑activatiefunctie hebben die klassewaarschijnlijkheden uitgeeft om te bepalen tot welke vogelsoort de geanalyseerde afbeelding het meest waarschijnlijk behoort.
Een deep‑learningarchitectuur voor beeldclassificatie | Iván Palomares
5. Wat zijn enkele veelvoorkomende uitdagingen bij deep‑learningmodellen en hoe pak je die aan?
Veelvoorkomende uitdagingen die het succesvol toepassen van deep‑learningmodellen in de praktijk kunnen belemmeren, zijn overfitting, verdwijnende en exploderende gradiënten en de noodzaak van grote hoeveelheden gelabelde data voor training. Goed nieuws: dankzij doorlopend onderzoek bestaan er aanpakken om dit te adresseren.
Naast deze probleemgerichte oplossingen is het belangrijk om regelmatige modelmonitoring en -fijnafstelling in te richten om langdurig goede prestaties te borgen.
Sollicitatievragen deep learning voor pas afgestudeerden
Als je net bent afgestudeerd of je eerste deep‑learningfunctie zoekt, kun je vragen verwachten die je basiskennis en praktische vaardigheden testen in het trainen en evalueren van deep‑learningmodellen in een experimentele setting.
1. Wat zijn activatiefuncties en waarom zijn ze cruciaal bij het ontwerpen van deep‑learningmodellen?
Activatiefuncties zijn wiskundige functies die in alle moderne deep‑neural‑networkarchitecturen worden gebruikt. Dit gebeurt op neuronniveau, tijdens het omzetten van meerdere neuroninvoeren naar een uitvoerwaarde die wordt doorgegeven aan neuronen in de volgende laag.
Ze zijn cruciaal in deep‑learningmodellen omdat ze non‑lineariteit introduceren, wat essentieel is om tijdens training complexe relaties en patronen in de data te leren.
Zonder die functies zouden ze nauwelijks meer dan lineaire patronen uit de data leren door opeenvolgende lineaire combinaties van invoeren toe te passen — net zoals klassieke lineaire regressiemodellen dat doen!
Activatiefunctie binnen een kunstmatig neuron | Iván Palomares
Voorbeelden van populaire activatiefuncties zijn de logistische (logit), hyperbolische tangens (tanh) en rectified linear unit (ReLU), zoals hieronder afgebeeld.
Voorbeelden van activatiefuncties | Afbeelding door Aurelien Geron (O’Reilly)
2. Hoe zou je de prestaties van een deep‑learningmodel evalueren?
De prestaties van deep‑learningmodellen kunnen worden geëvalueerd met gangbare machine‑learningmetrics, afhankelijk van de taak.
Voor classificatie kun je kijken naar metrics zoals nauwkeurigheid (accuracy), precisie, recall, F1‑score en Area Under the Curve (AUC). Voor regressie gebruiken we foutmaten zoals Root Mean Square Error (RMSE).
Deze metrics gebruik je om modelvoorspellingen te benchmarken tegen ground‑truthlabels of basismodellen. Voor geavanceerde modellen en toepassingen zoals NLP zijn er taakspecifieke metriek zoals BLEU‑score voor vertaling, ROUGE‑score voor samenvatting, enzovoort.
3. Wat zijn enkele voorbeelden van hoe deep learning wordt ingezet in het bedrijfsleven en de industrie?
Deep learning wordt gebruikt in een breed scala aan real‑world toepassingen, waaronder:
Sollicitatievragen voor deep‑learningengineering
Vragen voor een engineeringgerichte deep‑learningrol richten zich op zaken als programmeerframeworks, libraries en tools.
1. Hoe zou je TensorFlow gebruiken om een eenvoudig feedforward neuronaal netwerk voor beeldclassificatie te bouwen?
Om in TensorFlow een eenvoudig feed‑forward neuronaal netwerk voor beeldclassificatie te bouwen, kun je beginnen met het laag‑voor‑laag definiëren van de modelarchitectuur met de TensorFlow Sequential API.
Dit omvat het specificeren van het juiste aantal neuronen en activatiefuncties per laag en het definiëren van de uiteindelijke laag (outputlaag) met softmax‑activatie.
Vervolgens compileer je het model met een geschikte verliesfunctie zoals categorische cross‑entropy, een optimizer zoals Adam en validatiemetriek, voordat je het traint op de trainingsdata gedurende een bepaald aantal epochs. Zodra het model is gebouwd, kun je de prestaties op de validatieset evalueren.
TensorFlow wordt vaak gebruikt samen met de Keras‑API, die je onder de knie krijgt na het volgen van de cursus Advanced Deep Learning with Keras.
2. Beschrijf je aanpak om overfitting in een deep‑learningmodel te behandelen via regularisatietechnieken in PyTorch
Om overfitting in een deep‑learningmodel in PyTorch aan te pakken, is een gangbare strategie het opnemen van regularisatietechnieken zoals L1‑ of L2‑regularisatie met straftermen die aan de verliesfunctie worden toegevoegd.
Daarnaast kun je dropoutlagen introduceren om tijdens training willekeurig neuronen uit te schakelen; dit voorkomt dat het model te veel vertrouwt op specifieke kenmerken die uit de data zijn gehaald.
Deze twee strategieën kun je combineren met early stopping om de training te beëindigen zodra de validatieprestatie begint te verslechteren.
Wil je je PyTorch‑skills aanscherpen? Bekijk dan zeker de cursus Introduction to Deep Learning in the PyTorch.
3. Geef een voorbeeld van transfer learning om een voorgetraind deep‑learningmodel te fine‑tunen voor een nieuwe taak
VGG, BERT of ResNet zijn bekende voorbeelden van voorgetrainde modellen die je kunt laden voor transfer learning en fine‑tuning. Concreet houdt het proces in dat je de modelkop, oftewel de laatste classificatielaag, vervangt door een nieuwe die past bij de doeltaak.
Na deze kleine structurele wijziging in de modelarchitectuur train je het opnieuw op een nieuwe dataset met een lage learning rate, zodat de modelgewichten zich aanpassen aan de nieuwe taak terwijl de belangrijkste kenmerken die het voorgetrainde model oorspronkelijk heeft geleerd grotendeels behouden blijven.
Sollicitatievragen deep learning voor computervisie
De volgende vragen kan een interviewer stellen voor een functie waarin je deep‑learningsoplossingen voor computervisie bouwt of beheert, zoals beeldverwerkingstoepassingen.
1. Leg convolutionele neurale netwerken uit en pas het concept toe op drie typische use‑cases.
CNN's zijn gespecialiseerde deep‑learningarchitecturen voor het verwerken van visuele data. Hun stapel convolutionele lagen en onderliggende operaties op beelddata zijn ontworpen om de visuele cortex in dierenhersenen na te bootsen.
CNN's blinken uit in taken zoals beeldclassificatie, objectdetectie en beeldsegmentatie. Hier is een korte use‑casebeschrijving voor elk van deze taken:
2. Beschrijf de rol van convolution- en poolinglagen in CNN's
Convolutionlagen in CNN's zijn verantwoordelijk voor feature‑extractie op invoerbeelden. Ze passen een set leerbare gewichten toe, filters of kernels genoemd, om patronen en kenmerken te detecteren zoals randen, vormen en texturen, samen met hun ruimtelijke informatie en relaties, en leren zo hiërarchische visuele representaties.
Ondertussen downsamplen poolinglagen featuremaps (intermediaire beeldrepresentaties) die door convolutionele lagen worden gegenereerd. Met andere woorden: hun oorspronkelijke ruimtelijke dimensie of resolutie wordt verkleind terwijl belangrijke informatie behouden blijft.
Het combineren van opeenvolgende convolutionlagen met poolinglagen in een CNN verhoogt de robuustheid tegen variaties in invoer, vermindert de rekencomplexiteit tijdens training en inferentie en helpt problemen zoals overfitting te voorkomen.
3. Wat zijn enkele veelvoorkomende uitdagingen bij deep‑learningmodellen die zijn getraind voor computervisie?
Onder de gebruikelijke uitdagingen en beperkingen van deep‑learningmodellen vallen de volgende voorbeelden extra op bij modellen voor computervisie zoals CNN's:
Sollicitatievragen deep learning voor NLP
Hier zijn enkele mogelijke vragen die een interviewer kan stellen voor een functie waarbij je deep‑learningtechnologieën inzet in NLP‑toepassingen.
1. Hoe verbeteren attention‑mechanismen de prestaties van deep‑learningmodellen voor NLP‑taken?
Transformers zijn een baanbrekende familie van deep‑learningarchitecturen en de huidige state‑of‑the‑art voor een breed scala aan uitdagende NLP‑problemen. Attention‑mechanismen zijn cruciaal voor transformerarchitecturen die ten grondslag liggen aan Large Language Models (LLM's) zoals BERT en GPT en bepalen grotendeels hun succes.
Transformers kunnen complexe patronen, contextuele informatie en langetermijnafhankelijkheden tussen elementen van een invoertekst vastleggen, waarmee ze problemen van eerdere oplossingen — zoals beperkte geheugenlengte in RNN's (Recurrent Neural Networks) — aanzienlijk overwinnen.
Attention‑mechanismen wegen in essentie het belang van elk token in een sequentie, zonder dat die token‑voor‑token verwerkt hoeft te worden.
Deze belangrijke component van transformers heeft geleid tot grote vooruitgang in taken zoals tekstclassificatie, taal‑generatie en samenvatting, en heeft het domein van LLM's en AI als geheel getransformeerd.
De Datacamp‑cursus Introduction to LLMs in Python leert je niet alleen praktische skills om LLM's te bouwen en te benutten, maar ook de kernconcepten rond LLM's en transformerarchitecturen.
2. Wat houden modelpre‑training en model‑fine‑tuning in voor deep‑learningarchitecturen en data in de context van NLP?
Modelpre‑training traint een deep‑learningmodel, zoals BERT voor tekstclassificatie, op een grote tekstcorpus (miljoenen tot miljarden voorbeeldteksten) om taalrepresentaties te leren voor algemeen taalbegrip.
Model‑fine‑tuning houdt daarentegen in dat je een voorgetraind model neemt en de geleerde parameters bijstelt voor een specifieke downstream NLP‑toepassing, bijvoorbeeld sentimentanalyse van hotelreviews.
Omdat fine‑tuning doorgaans op specifieke use‑cases is gericht, vereist dit een kleine, domeinspecifieke dataset met gelabelde tekstvoorbeelden, zodat de gewichten in delen van het model zich aanpassen aan de nuances van de doeltaak. Zo verbeter je de modelprestatie in die specifieke context, zonder de rekenkosten en data‑eisen van trainen vanaf nul.
Voorbeeld van modelpre‑training en fine‑tuning van een LLM voor het samenvatten van chemie‑artikelen | Iván Palomares
3. Kun je de architectuur beschrijven van een transformermodel zoals BERT en de soorten NLP‑taken die het kan aanpakken?
De architectuur van BERT is een vereenvoudigde variant van de oorspronkelijke encoder‑decodertransformer, de zogeheten enkel‑encodertransformer.
De oorspronkelijke transformerarchitectuur, opgedeeld in encoder- en decoderstacks | Introduction to LLMs in Python (Iván Palomares)
Enkel‑encoderarchitectuur gebruikt door modellen zoals BERT | Introduction to LLMs in Python (Iván Palomares)
De encoderstack bestaat uit meerdere encoderlagen (zie het bovenstaande diagram). Binnen elke laag zijn er (sub)lagen met self‑attentionmechanismen en feed‑forward neurale netwerken. De sleutel tot het taalbegrip van BERT ligt in de bidirectionele attention‑stroom die iteratief in de encoder wordt toegepast, zodat afhankelijkheden tussen woorden in een invoersequentie in beide richtingen worden vastgelegd. Feed‑forward neurale verbindingen "smeden" deze geleerde afhankelijkheden samen tot complexere taalpatronen.
Naast dit algemene kenmerk van enkel‑encodertransformers wordt BERT gekenmerkt door het toepassen van Masked Language Modelling (MLM). Dit mechanisme wordt tijdens pre‑training gebruikt om willekeurig woorden te maskeren, zodat het model gedwongen wordt gemaskeerde woorden te voorspellen op basis van begrip van de omliggende context.
Geavanceerde sollicitatievragen over deep learning
Laten we afsluiten met drie vragen die je kunt krijgen als je solliciteert naar een geavanceerde deep‑learningrol.
1. Hoe zou je een deep‑learningmodel ontwerpen en implementeren voor een probleem met beperkt gelabelde data?
De volgende gecombineerde strategie kun je inzetten om de prestaties van een deep‑learningmodel te maximaliseren bij het veelvoorkomende probleem van beperkte trainingsdata:
2. Kun je drie belangrijke aandachtspunten noemen bij het uitrollen van deep‑learningmodellen op schaal in productieomgevingen?
Het uitrollen van deep‑learningsoplossingen op schaal in productie vergt aandacht voor verschillende aspecten, waarvan er drie zijn:
Andere belangrijke overwegingen bij productie‑deployments van deep‑learningmodellen zijn hardware- en netwerkinfrastructuur, systeemmonitoring en naadloze integratie met bestaande softwareframeworks.
3. Hoe zie je dat recente vooruitgang in deep learning de toekomst van het vakgebied kan vormen qua toepassingen en bredere impact?
Recente doorbraken in deep learning hebben het potentieel om talloze sectoren ingrijpend te veranderen en zelfs nieuwe industrieën te creëren.
Attention‑mechanismen in de transformerarchitecturen achter LLM's revolutioneren het NLP‑veld, verleggen de grenzen van NLP‑taken en maken geavanceerdere mens‑machine‑interacties mogelijk via conversational AI, vraag‑antwoordsystemen en veel meer. De recente toevoeging van Retrieval Augmented Generation (RAG) helpt LLM's bovendien om waarheidsgetrouwe en onderbouwde taal te produceren.
Reinforcement learning is een van de meest veelbelovende AI‑trends omdat de principes de basis van menselijk leren nabootsen. De integratie met deep‑learningarchitecturen, met name generatieve modellen zoals generative adversarial networks, staat centraal in het wetenschappelijk onderzoek van vandaag. Grote namen als OpenAI, Google en Microsoft combineren deze twee AI‑domeinen in baanbrekende oplossingen die "levensechte" content in meerdere formaten kunnen genereren.
Deze en andere recente ontwikkelingen hebben het gebruik van AI door de samenleving drastisch gedemocratiseerd, waardoor het belangrijk is om te focussen op AI‑ethiek, juridische aspecten en regulering als sleutelthema om een positieve impact van deep‑learningsoplossingen op de samenleving te waarborgen.
Afronding
Samenvattend: bij het beantwoorden van veelvoorkomende sollicitatievragen over deep learning draait succes om een mix van theoretische basis, sterke praktische vaardigheden en up‑to‑date blijven met de nieuwste ontwikkelingen.
Deep learning gaat niet alleen over algoritmes, modellen en architectuurkeuzes. Het draait om het vinden van de beste oplossingen voor echte dataproblemen.
En blijven leren is key. Datacamp biedt een uitgebreid Deep Learning in Python skill‑track en twee toepassingsgerichte tracks: image processing en natural language processing. Deze tracks bieden een gestructureerde routekaart om je deep‑learningvaardigheden te versterken, zodat je klaar bent voor je volgende interview.
Bekijk tot slot de laatste secties van dit artikel over sollicitatievragen voor machine learning als je op zoek bent naar algemene richtlijnen om je voor te bereiden op je deep‑learninginterview. Omdat deep learning een subveld van machine learning is, helpt het zeker om die algemene richtlijnen te combineren met de 20 deep‑learningvragen die we hier hebben doorgenomen.