Kurs
Einführung in Deep Learning mit Python
4 Std.
264.7K
Suchst du nach Orientierung, um deinen Traumjob zu landen und deine Deep‑Learning‑Skills zu schärfen? Dann bist du hier richtig. Dieser Artikel liefert dir Antworten auf 20 typische Interviewfragen rund um Deep Learning und hilft dir, mit etwas Übung im Vorstellungsgespräch zu überzeugen.
Allgemeine Fragen zu Deep Learning zielen meist darauf ab, das Feld zu verstehen, es von anderen Bereichen der KI abzugrenzen, reale Probleme mit Deep‑Learning‑Lösungen zu verknüpfen und ihre Herausforderungen und Grenzen zu kennen.
Deep Learning ist ein Teilgebiet des maschinellen Lernens und der KI insgesamt. Dabei werden große, auf künstlichen neuronalen Netzen basierende Modelle mit Daten trainiert.
Die Modelle lernen, anspruchsvolle Vorhersage- und Inferenzaufgaben (z. B. Klassifikation, Regression, Objekterkennung in Bildern usw.) zu lösen, indem sie automatisch komplexe Muster und Merkmale in den Daten entdecken. Das geschieht, indem sie die komplexen inneren Strukturen menschlicher Gehirne nachahmen.
Unser Kurs Understanding Artificial Intelligence entmystifiziert die Bereiche und Aufgaben der KI, einschließlich Deep Learning, umfassend.
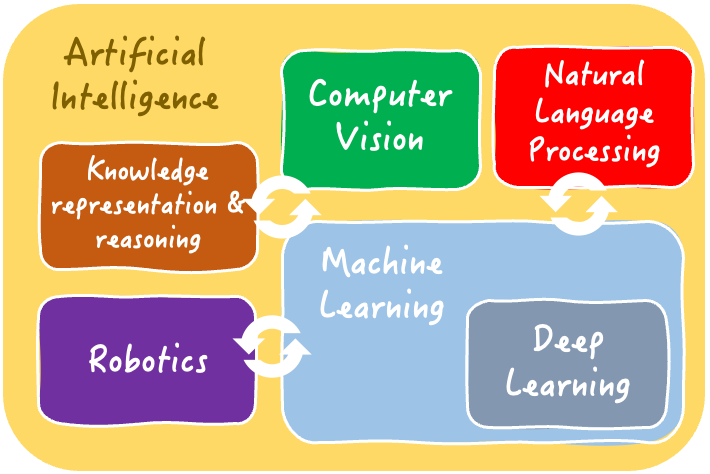
Die miteinander verzahnten Bereiche der Künstlichen Intelligenz | Iván Palomares
Deep‑Learning‑Ansätze spielen ihre Stärken bei hochkomplexen Daten aus, etwa bei unstrukturierten oder hochdimensionalen Daten.
Sie sind auch die bevorzugte Wahl bei sehr großen Datenmengen oder wenn feinste Muster erfasst werden müssen: Häufig gelingt es ihnen, aussagekräftige Datenmerkmale zu extrahieren und zu verstehen, die klassische Machine‑Learning‑Verfahren nicht finden.
Typische Problemstellungen, die sich mit Deep Learning lösen lassen:
Beachte jedoch: Für viele einfachere Aufgaben und Datensätze reichen leichte Machine‑Learning‑Modelle wie Entscheidungsbäume oder Regressionsmodelle völlig aus. Sie sind oft die bessere Wahl, weil sie einfacher und günstiger zu trainieren und bereitzustellen sind.
Deep‑Learning‑Modelle erfordern in der Regel gründliche Datenaufbereitung und ‑verarbeitung. Daher könnte dir der folgende Artikel zu Data‑Engineering‑Interviews weiterhelfen.
Die Wahl eines geeigneten Deep‑Learning‑Ansatzes hängt von mehreren Faktoren ab, etwa der Art der Daten, der Komplexität des Problems und den verfügbaren Rechenressourcen.
Die folgenden Schritte sind ein einfaches, aber wirksames Rezept für diese wichtige Entscheidung:
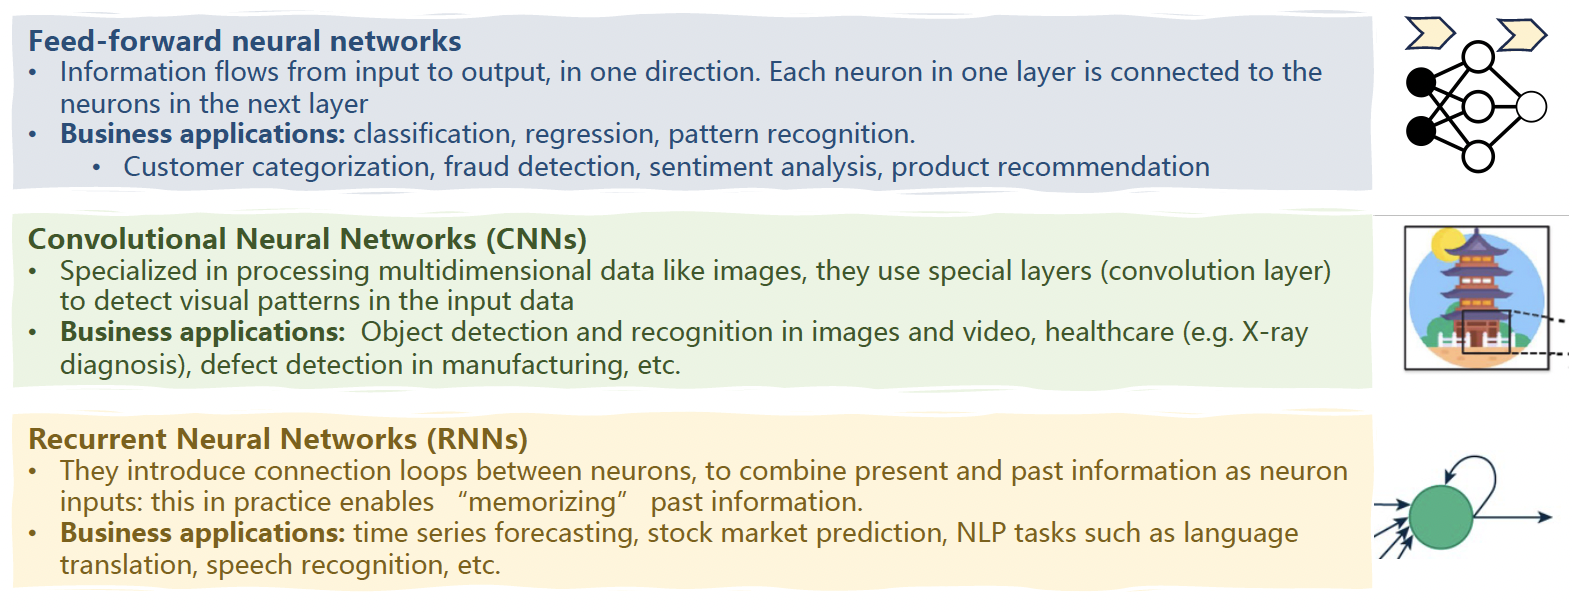
Drei gängige Deep‑Learning‑Architekturen und ihre Einsatzfelder | Iván Palomares
Das Design einer auf eine konkrete Aufgabe wie die Klassifikation zugeschnittenen Architektur umfasst die Wahl der passenden Anzahl und Größe von Neuronenschichten sowie geeigneter Aktivierungsfunktionen.
Diese Entscheidungen hängen typischerweise von den Eigenschaften der Daten ab. Für Bildklassifikation nutzt du zum Beispiel einen Stapel aus Convolution‑Schichten, um visuelle Muster wie Farben (und Farbkombinationen), Formen, Kanten usw. zu erfassen.
Die oberste, abschließende Schicht deiner Deep‑Learning‑Architektur (der Model Head) hängt ebenfalls von der Aufgabe ab, da sie das gewünschte Ausgabeformat erzeugen muss.
Bei einer Bildklassifikation, etwa der Zuordnung von Kükenbildern zu Vogelarten, sollten die letzten Schichten beispielsweise eine Softmax‑Aktivierungsfunktion haben, die Klassenwahrscheinlichkeiten ausgibt, um die wahrscheinlichste Vogelart zu bestimmen.
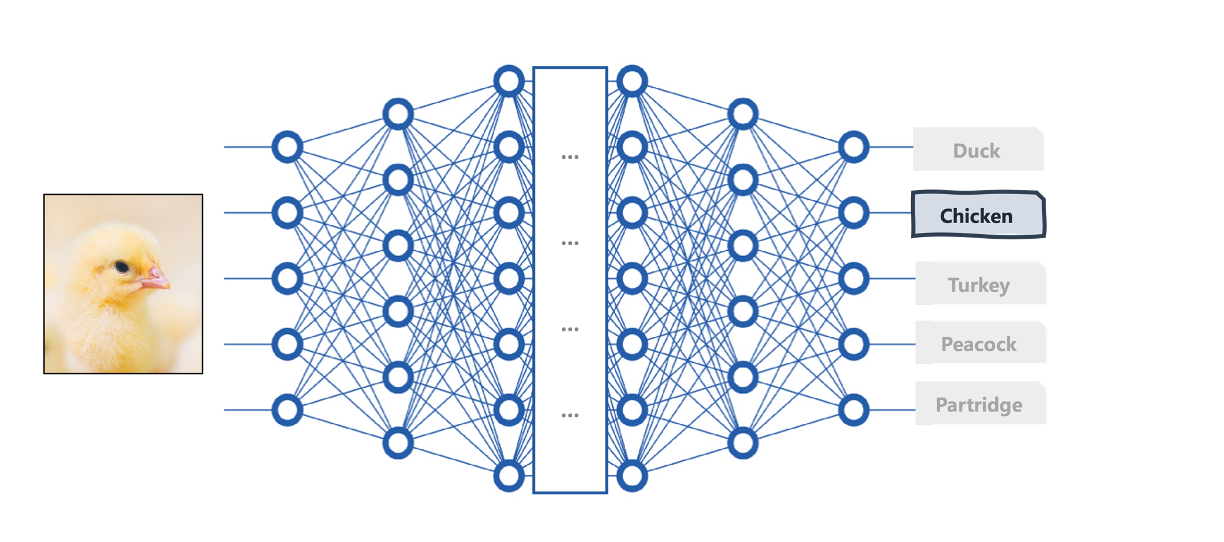
Eine Deep‑Learning‑Architektur für Bildklassifikation | Iván Palomares
Häufige Hürden für erfolgreiche Praxisanwendungen sind Overfitting, verschwindende und explodierende Gradienten sowie der Bedarf an großen Mengen gelabelter Trainingsdaten. Die gute Nachricht: Dank intensiver Forschung gibt es bewährte Gegenmaßnahmen.
Unabhängig von problembezogenen Lösungen solltest du regelmäßiges Monitoring und Feintuning etablieren, um die Performance langfristig zu sichern.
Wenn du frisch von der Uni kommst oder deine erste Deep‑Learning‑Position anstrebst, kannst du mit Fragen rechnen, die deine Grundlagen und deine Praxiskompetenz beim Trainieren und Evaluieren von Modellen im Experiment testen.
Aktivierungsfunktionen sind mathematische Funktionen, die in allen modernen tiefen neuronalen Netzen verwendet werden. Sie wirken auf Neuronenebene, wenn mehrere Eingaben zu einem Ausgabewert abgebildet werden, der an die nächste Schicht weitergegeben wird.
Sie sind entscheidend, weil sie Nichtlinearität einführen – unerlässlich, damit Modelle während des Trainings komplexe Zusammenhänge und Muster in den Daten lernen können.
Ohne sie würden Modelle kaum mehr als lineare Zusammenhänge lernen, indem sie sukzessive lineare Kombinationen der Inputs bilden – so wie klassische lineare Regressionsmodelle!
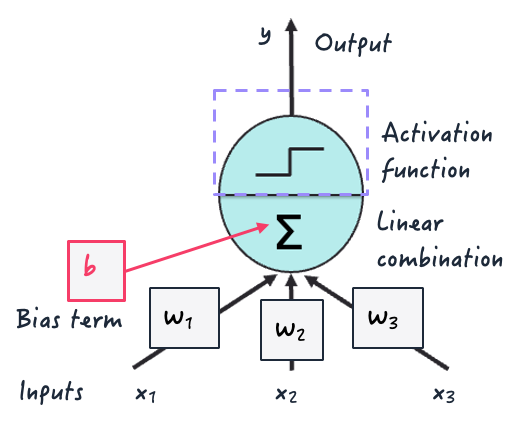
Aktivierungsfunktion in einem künstlichen Neuron | Iván Palomares
Beliebte Beispiele sind die logistische (Logit‑), die hyperbolische Tangens‑ (tanh) und die ReLU‑Aktivierung, wie unten dargestellt.
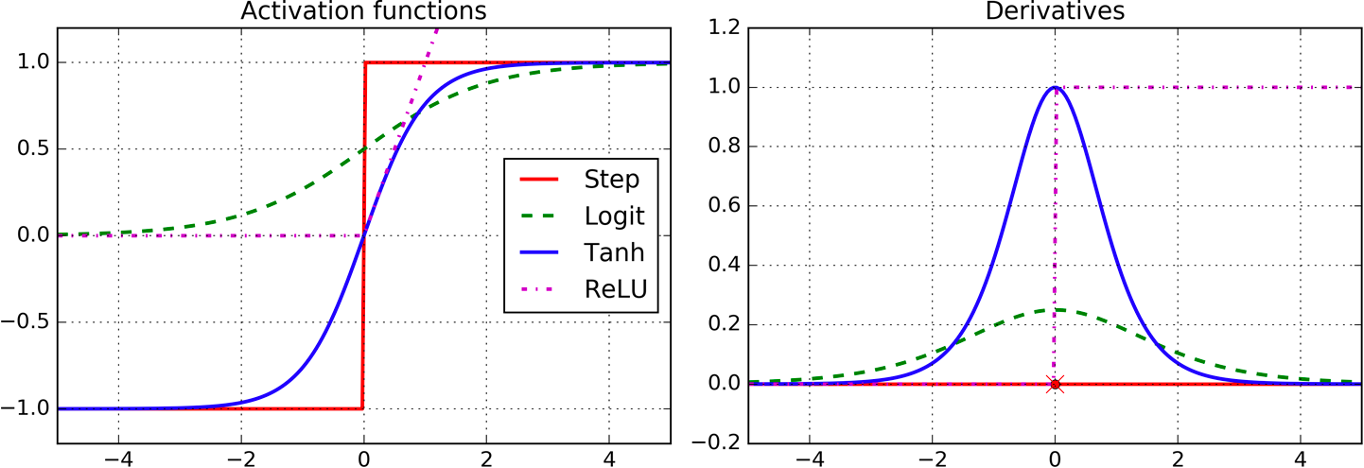
Beispiele für Aktivierungsfunktionen | Bild von Aurelien Geron (O’Reilly)
Die Leistung von Deep‑Learning‑Modellen wird mit üblichen Machine‑Learning‑Metriken bewertet – abhängig von der Aufgabe.
Für Klassifikation kommen Kennzahlen wie Accuracy, Precision, Recall, F1‑Score und die Fläche unter der Kurve (AUC) infrage. Für Regression eignen sich Fehlermetriken wie der Root Mean Square Error (RMSE).
Diese Metriken dienen dazu, Modellvorhersagen mit den Ground‑Truth‑Labels oder Baseline‑Modellen zu vergleichen. Für fortgeschrittene Modelle und Anwendungen wie NLP gibt es aufgabenspezifische Metriken wie BLEU für Übersetzung, ROUGE für Zusammenfassung usw.
Deep Learning kommt in einer breiten Palette realer Anwendungen zum Einsatz, zum Beispiel:
Fragen für eine Deep‑Learning‑Rolle mit Engineering‑Fokus drehen sich um Frameworks, Bibliotheken und Tools.
Für ein einfaches Feedforward‑Netz in TensorFlow definierst du die Architektur Schicht für Schicht mit der TensorFlow‑Sequential‑API.
Dazu gehören die passende Anzahl Neuronen und Aktivierungsfunktionen pro Schicht sowie eine Ausgabeschicht mit Softmax‑Aktivierung.
Anschließend kompilierst du das Modell mit einer geeigneten Loss‑Funktion wie kategorischer Kreuzentropie, einem Optimierer wie Adam und Validierungsmetriken, bevor du es über eine definierte Zahl an Epochen trainierst. Danach bewertest du die Performance auf dem Validierungssatz.
TensorFlow wird oft zusammen mit der Keras‑API genutzt, die du im Kurs Advanced Deep Learning with Keras meistern kannst.
Um Overfitting in einem PyTorch‑Modell zu reduzieren, bietet sich der Einsatz von Regularisierung an, etwa L1‑ oder L2‑Regularisierung durch Strafterme in der Loss‑Funktion.
Alternativ lassen sich Dropout‑Schichten einsetzen, die während des Trainings Neuronen zufällig deaktivieren. So verhindert man, dass sich das Modell zu stark auf einzelne Merkmale verlässt.
Beide Strategien kann man mit Early Stopping kombinieren, um das Training zu beenden, sobald die Validierungsleistung nachlässt.
Du willst deine PyTorch‑Skills ausbauen? Dann sieh dir den Kurs Introduction to Deep Learning in the PyTorch an.
VGG, BERT oder ResNet sind bekannte vortrainierte Modelle, die sich für Transfer Learning und Fine‑Tuning eignen. Konkret ersetzt man den Model Head, also die finale Klassifikationsschicht, durch eine neue, die zur Zielaufgabe passt.
Nach dieser kleinen strukturellen Anpassung wird das Modell mit einer niedrigen Lernrate auf einem neuen Datensatz weitertrainiert, um die Gewichte an die neue Aufgabe anzupassen, während die vom vortrainierten Modell gelernten Hauptmerkmale weitgehend erhalten bleiben.
Für Rollen, in denen du Deep‑Learning‑Lösungen in der Bildverarbeitung wie Image‑Processing‑Anwendungen entwickelst oder betreust, könnten dir unter anderem diese Fragen begegnen.
CNNs sind spezialisierte Deep‑Learning‑Architekturen für visuelle Daten. Ihre Stapel aus Convolution‑Schichten und die zugrunde liegenden Operationen ahmen den visuellen Kortex von Tieren nach.
CNNs glänzen bei Aufgaben wie Bildklassifikation, Objekterkennung und Bildsegmentierung. Hier je ein kurzer Use Case:
Convolution‑Schichten extrahieren Merkmale aus Eingabebildern. Mithilfe lernbarer Gewichte (Filter/Kerne) erkennen sie Muster wie Kanten, Formen und Texturen sowie deren räumliche Beziehungen und lernen hierarchische Repräsentationen.
Pooling‑Schichten hingegen reduzieren (downsamplen) die Feature‑Maps, also die von den Convolution‑Schichten erzeugten Zwischenrepräsentationen. Die räumliche Auflösung wird verringert, während wichtige Informationen erhalten bleiben.
Die Kombination mehrerer Convolution‑ mit Pooling‑Schichten erhöht die Robustheit gegenüber Eingabevariationen, senkt die Rechenlast beim Training und in der Inferenz und hilft, Overfitting zu vermeiden.
Neben den allgemeinen Grenzen von Deep‑Learning‑Modellen treten bei Computer‑Vision‑Modellen wie CNNs besonders folgende Punkte hervor:
Für Positionen, in denen Deep‑Learning‑Technologien in NLP‑Anwendungen genutzt werden, könnten unter anderem diese Fragen gestellt werden.
Transformer sind eine bahnbrechende Familie von Architekturen und aktuell der State of the Art für viele anspruchsvolle NLP‑Probleme. Aufmerksamkeitsmechanismen sind das Herzstück von Transformern, die großen Sprachmodellen (LLMs) wie BERT und GPT zugrunde liegen, und maßgeblich für ihren Erfolg verantwortlich.
Transformer können komplexe Muster, Kontextinformationen und Langzeitabhängigkeiten in Texten erfassen und überwinden damit die Beschränkungen früherer Ansätze wie die begrenzte „Erinnerung“ von RNNs (Recurrent Neural Networks).
Aufmerksamkeitsmechanismen gewichten im Kern die Bedeutung jedes Tokens in einer Sequenz, ohne sie strikt Token für Token verarbeiten zu müssen.
Diese zentrale Komponente der Transformer hat Aufgaben wie Textklassifikation, Sprachgenerierung und Textzusammenfassung stark vorangebracht und das Feld der LLMs und der KI insgesamt revolutioniert.
Der Datacamp‑Kurs Introduction to LLMs in Python vermittelt dir nicht nur praktische Skills zum Aufbau und Einsatz von LLMs, sondern auch ein solides Verständnis der Konzepte rund um LLMs und Transformer‑Architekturen.
Model Pre‑Training trainiert ein Deep‑Learning‑Modell, etwa BERT für Textklassifikation, auf einem großen Textkorpus (Millionen bis Milliarden Beispiele), um allgemeine Sprachrepräsentationen zu lernen.
Model Fine‑Tuning bedeutet, ein vortrainiertes Modell für eine konkrete nachgelagerte NLP‑Aufgabe weiterzuentwickeln, z. B. Sentiment‑Analyse von Hotelbewertungen.
Da Fine‑Tuning auf spezifische Use Cases zielt, nutzt man dafür in der Regel kleinere, domänenspezifische Datensätze mit Labels. So werden Gewichte in Teilen des Modells an die Nuancen der Zielaufgabe angepasst, und die Leistung im jeweiligen Kontext verbessert sich – ohne den Daten- und Rechenaufwand eines Trainings von Grund auf.
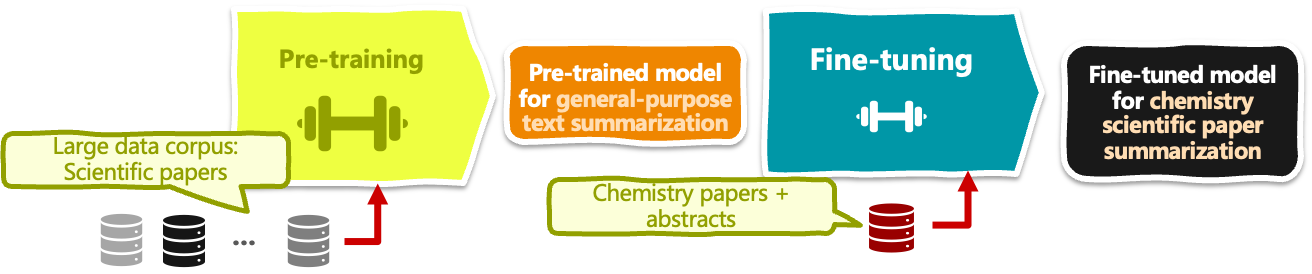
Beispiel für Pretraining und Fine‑Tuning eines LLMs zur Zusammenfassung chemischer Fachartikel | Iván Palomares
BERTs Architektur ist eine vereinfachte Variante des ursprünglichen Encoder‑Decoder‑Transformers, ein sogenannter reiner Encoder‑Transformer.
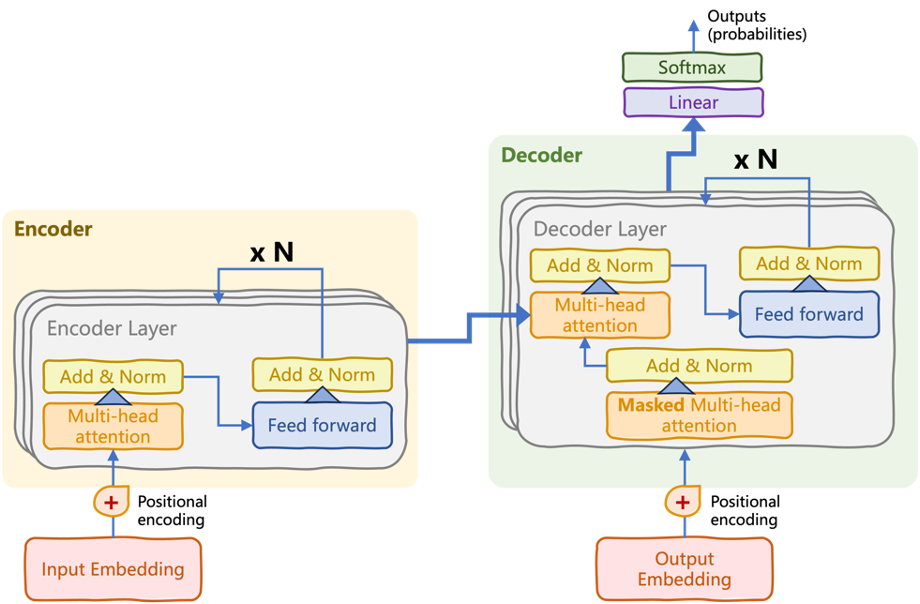
Die ursprüngliche Transformer‑Architektur mit Encoder- und Decoder‑Stapel | Introduction to LLMs in Python (Iván Palomares)
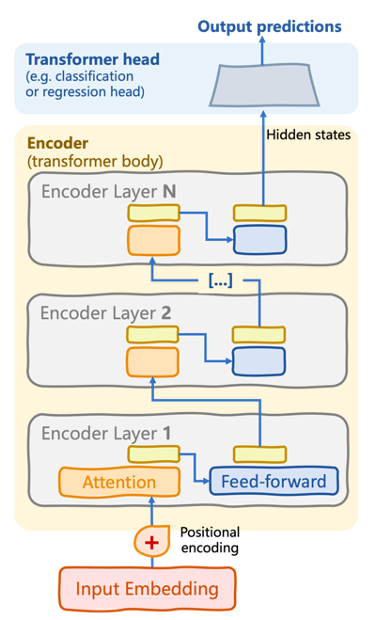
Encoder‑only‑Architektur wie bei BERT | Introduction to LLMs in Python (Iván Palomares)
Der Encoder‑Stapel besteht aus mehreren Encoder‑Schichten (siehe Diagramm). In jeder Schicht gibt es (Teil‑)Schichten für Self‑Attention und Feedforward‑Netze. Der Schlüssel zu BERTs Sprachverständnis ist der bidirektionale Aufmerksamkeitsfluss im Encoder, der Abhängigkeiten zwischen Wörtern in beide Richtungen erfasst. Feedforward‑Verbindungen „verknüpfen“ diese Abhängigkeiten zu komplexeren Sprachmustern.
Neben diesem generellen Merkmal reiner Encoder‑Transformer nutzt BERT Masked Language Modeling (MLM). Beim Pretraining werden dabei zufällig Wörter maskiert, sodass das Modell lernt, sie aus dem umgebenden Kontext zu erschließen.
Zum Abschluss drei Fragen, die dir für eine Senior‑ oder Expert‑Rolle begegnen könnten.
Um bei begrenzten Trainingsdaten das Optimum herauszuholen, bietet sich eine Kombination folgender Strategien an:
Beim skalierbaren Einsatz in der Produktion sind unter anderem diese drei Punkte zentral:
Weitere wichtige Aspekte sind Hardware- und Netzwerkinfrastruktur, Systemmonitoring sowie die nahtlose Integration in bestehende Softwarelandschaften.
Jüngste Durchbrüche im Deep Learning können zahlreiche Branchen tiefgreifend verändern – und neue entstehen lassen.
Aufmerksamkeitsmechanismen in den Transformer‑Architekturen hinter LLMs revolutionieren NLP, verschieben die Grenzen dessen, was möglich ist, und ermöglichen durch Conversational‑AI, Question‑Answering und mehr deutlich reifere Mensch‑Maschine‑Interaktionen. Die jüngste Integration von Retrieval Augmented Generation (RAG) hilft LLMs zusätzlich, wahrheitsgemäße, beleggestützte Antworten zu liefern.
Reinforcement Learning gilt als einer der vielversprechendsten KI‑Trends, weil seine Prinzipien dem menschlichen Lernen ähneln. In Kombination mit Deep‑Learning‑Architekturen, insbesondere generativen Modellen wie Generative Adversarial Networks, steht es im Fokus aktueller Forschung. Größen wie OpenAI, Google und Microsoft vereinen beide Felder in wegweisenden Lösungen, die täuschend echte Inhalte in verschiedenen Formaten erzeugen.
Diese und andere Fortschritte haben die Nutzung von KI stark demokratisiert. Deshalb rücken KI‑Ethik, Rechtsrahmen und Regulierung noch stärker in den Fokus, um einen positiven gesellschaftlichen Impact von Deep‑Learning‑Lösungen sicherzustellen.
Unterm Strich zeigt sich: Der Erfolg im Interview hängt von einer Mischung aus theoretischem Fundament, starker Praxiserfahrung und einem aktuellen Kenntnisstand ab.
Deep Learning dreht sich nicht nur um Algorithmen, Modelle und Architekturentscheidungen. Es geht darum, die besten Lösungen für reale Datenprobleme zu finden.
Und Lernen hört nie auf. Datacamp bietet einen umfassenden Deep Learning in Python Lernpfad sowie zwei anwendungsorientierte Tracks: Image Processing und Natural Language Processing. Diese Tracks geben dir einen klaren Lernplan, um deine Deep‑Learning‑Kompetenzen auszubauen – und dich fit fürs nächste Interview zu machen.
Wenn du generelle Tipps zur Vorbereitung suchst, wirf zum Schluss noch einen Blick auf die letzten Abschnitte dieses Artikels zu Machine‑Learning‑Interviewfragen. Da Deep Learning ein Teilbereich von Machine Learning ist, hilft dir die Kombination dieser allgemeinen Leitlinien mit den 20 Deep‑Learning‑Fragen aus diesem Beitrag garantiert weiter.
Starte heute mit deiner Deep‑Learning‑Reise durch!
Kurs
Lernpfad
Blog
Nisha Arya Ahmed
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.


