Curso
Introducción al Deep Learning en Python
4 h
264.7K
¿Buscas orientación para conseguir tu puesto soñado y afinar tus habilidades en deep learning? Estás en el lugar adecuado. Este artículo reúne respuestas a 20 preguntas habituales en entrevistas para roles de deep learning, para que puedas brillar con un poco de práctica.
Las preguntas generales suelen evaluar tu comprensión del campo, qué lo diferencia de otras áreas de la IA, cómo conectas problemas reales con soluciones de deep learning y si entiendes sus retos y limitaciones.
El deep learning es una subárea del aprendizaje automático y de la IA en su conjunto. Consiste en entrenar grandes modelos basados en redes neuronales artificiales con datos.
Estos modelos aprenden a resolver tareas complejas de predicción e inferencia (como clasificación, regresión, reconocimiento de objetos en imágenes, etc.) al descubrir automáticamente patrones y características complejas presentes en los datos. Lo logran imitando ciertas estructuras internas del cerebro humano.
Nuestro curso Understanding Artificial Intelligence desmitifica de forma integral las áreas y tareas abordables de la IA, incluido el deep learning.
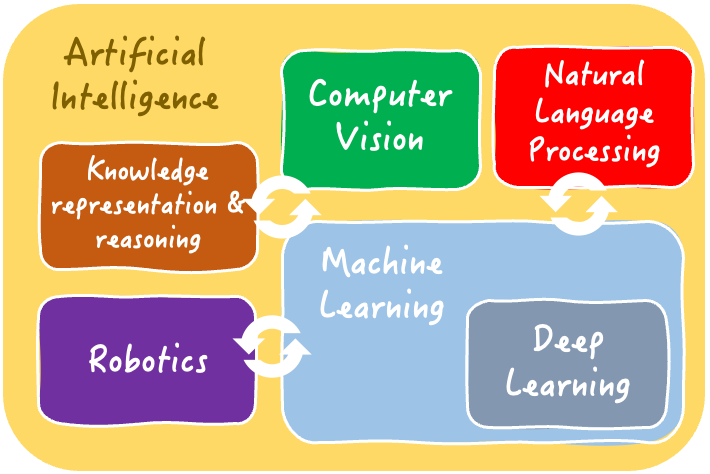
Áreas interrelacionadas de la inteligencia artificial | Iván Palomares
El deep learning destaca en problemas donde los datos son de alta complejidad, por ejemplo, datos no estructurados o de gran dimensionalidad.
También es la opción preferida cuando hay cantidades masivas de datos o es necesario captar patrones sutiles: a menudo consigue extraer y entender rasgos relevantes que los enfoques clásicos de machine learning pueden pasar por alto.
Algunos ejemplos de problemas adecuados para deep learning:
Eso sí, para muchas tareas y conjuntos de datos más simples, modelos ligeros de machine learning como árboles de decisión o regresores pueden ser más que suficientes, y resultan una mejor opción que los modelos de deep learning por su menor coste y facilidad de entrenamiento y despliegue.
Los modelos de deep learning suelen exigir una preparación y un procesado de datos minuciosos; por ello, puede resultarte útil este artículo sobre entrevistas de ingeniería de datos.
Elegir un enfoque adecuado de deep learning depende de varios factores, como la naturaleza de los datos, la complejidad del problema y los recursos de computación disponibles.
Estos pasos son una receta sencilla y eficaz para ayudarte a decidir:
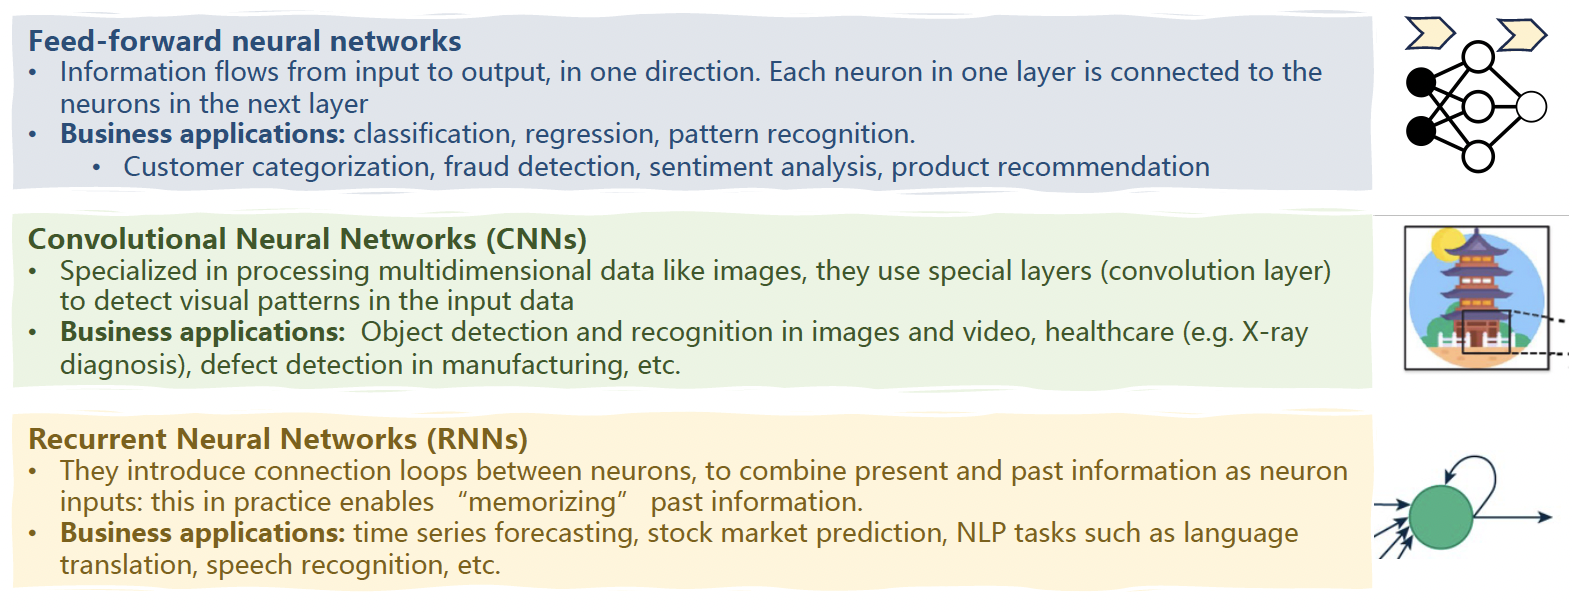
Tres arquitecturas habituales de deep learning y sus aplicaciones | Iván Palomares
Diseñar una arquitectura de deep learning para una tarea concreta como la clasificación implica elegir el número y tamaño de capas de neuronas adecuados, así como las funciones de activación correctas.
Estas decisiones suelen basarse en las características de los datos. Para clasificación de imágenes, puedes usar un bloque de capas convolucionales para captar patrones visuales como colores (y sus combinaciones), formas, bordes, etc.
La capa superior situada al final de tu arquitectura (la cabeza del modelo) también depende de la tarea, ya que debe producir la salida deseada.
Por ejemplo, en un problema de clasificación de imágenes como clasificar fotos de polluelos por especie de ave, estas últimas capas deberían usar una función de activación softmax que devuelva probabilidades por clase para determinar la especie más probable a la que pertenece la imagen analizada.
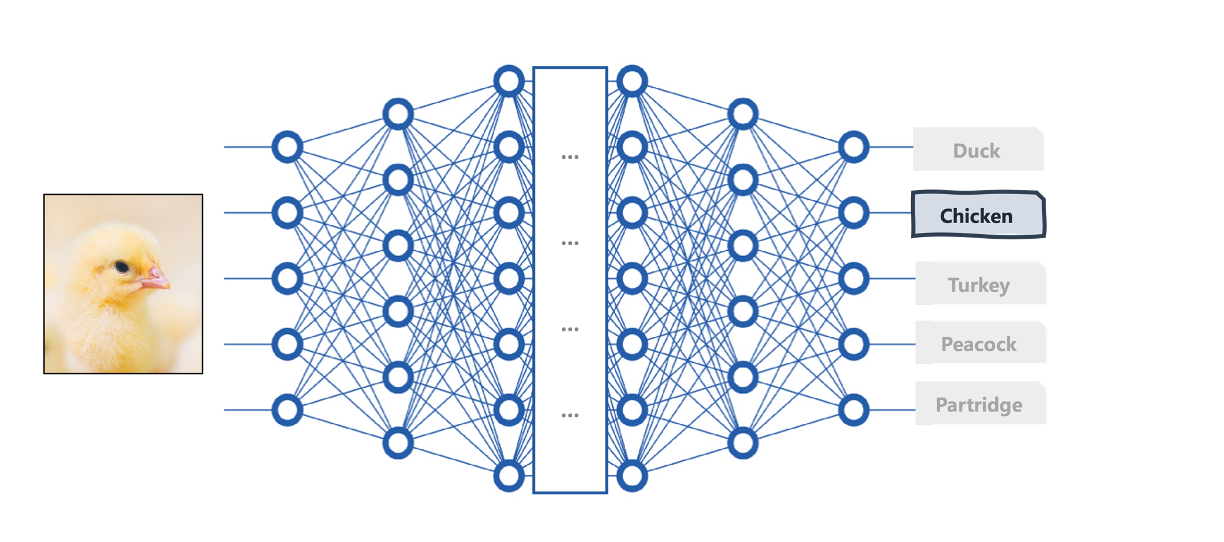
Una arquitectura de deep learning para clasificación de imágenes | Iván Palomares
Entre los retos frecuentes que pueden dificultar el éxito en producción están el sobreajuste, la desaparición o explosión del gradiente y la necesidad de grandes volúmenes de datos etiquetados. La buena noticia es que la investigación ha propuesto enfoques para mitigarlos.
Además de estas soluciones, establece mecanismos de monitorización y reajuste periódicos para garantizar un buen rendimiento a largo plazo.
Si eres recién graduado o buscas tu primer puesto en deep learning, es probable que te pregunten sobre fundamentos y habilidades prácticas para entrenar y evaluar modelos en un entorno experimental.
Las funciones de activación son funciones matemáticas presentes en todas las arquitecturas modernas de redes neuronales profundas. Operan a nivel de neurona, al mapear varias entradas hacia un valor de salida que se transmite a la siguiente capa.
Son cruciales porque introducen no linealidad, imprescindible para que el modelo pueda aprender relaciones y patrones complejos durante el entrenamiento.
De lo contrario, aprendería poco más que patrones lineales mediante combinaciones lineales sucesivas de entradas, ¡como ocurre en la regresión lineal clásica!
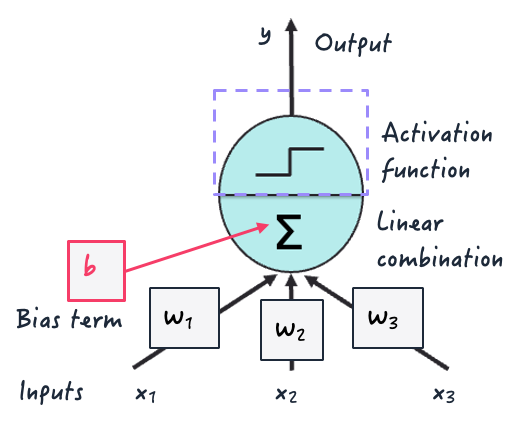
Función de activación dentro de una neurona artificial | Iván Palomares
Ejemplos populares son la logística (logit), la tangente hiperbólica (tanh) y la unidad lineal rectificada (ReLU), como se muestra abajo.
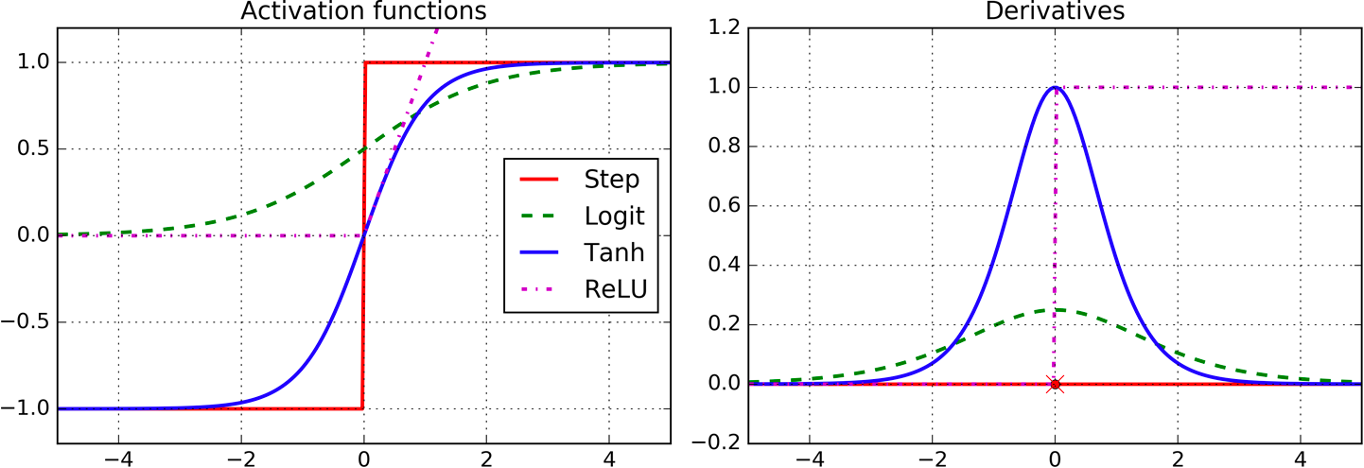
Ejemplos de funciones de activación | Imagen de Aurelien Geron (O’Reilly)
El rendimiento puede evaluarse con métricas típicas de machine learning según la tarea.
Para clasificación, usa métricas como accuracy, precisión, recall, F1 y área bajo la curva (AUC). Para regresión, métricas de error como Root Mean Square Error (RMSE).
Estas métricas sirven para comparar las predicciones con las etiquetas reales o con modelos de referencia. En aplicaciones avanzadas como PLN, existen métricas específicas: BLEU para traducción, ROUGE para resumen, etc.
El deep learning se aplica en multitud de casos reales, por ejemplo:
En roles de ingeniería, las preguntas se centran en frameworks, librerías y herramientas.
Para construir una red feedforward simple en TensorFlow para clasificación de imágenes, empezaríamos definiendo la arquitectura capa a capa con la API Sequential.
Esto incluye especificar el número de neuronas y funciones de activación por capa y definir la capa final (salida) con activación softmax.
Luego compilaríamos el modelo indicando una función de pérdida adecuada como la entropía cruzada categórica, un optimizador como Adam y métricas de validación, antes de entrenarlo durante cierto número de épocas. Una vez construido, evaluaríamos su rendimiento en el conjunto de validación.
TensorFlow suele usarse junto con la API de Keras, que podrás dominar con el curso Advanced Deep Learning with Keras.
Para combatir el sobreajuste en un modelo implementado con PyTorch, una estrategia común es incorporar técnicas de regularización como L1 o L2 añadiendo términos de penalización a la función de pérdida.
Alternativamente, se pueden introducir capas de dropout que desactiven neuronas aleatoriamente durante el entrenamiento; así se evita que el modelo dependa en exceso de rasgos específicos.
Estas dos estrategias pueden combinarse con early stopping para finalizar el entrenamiento cuando la validación empiece a empeorar.
¿Quieres afinar tus habilidades con PyTorch? Echa un vistazo al curso Introduction to Deep Learning in the PyTorch.
VGG, BERT o ResNet son ejemplos conocidos de modelos preentrenados que pueden cargarse para transferencia y ajuste fino. En concreto, el proceso consiste en reemplazar la cabeza del modelo, es decir, la última capa de clasificación, por otra adaptada a la nueva tarea.
Tras este pequeño cambio estructural, se vuelve a entrenar con un conjunto de datos nuevo usando una tasa de aprendizaje baja para adaptar los pesos a la tarea objetivo conservando en gran medida las características generales aprendidas por el modelo original.
Estas son algunas preguntas que podrían hacerte si el puesto implica desarrollar o gestionar soluciones de visión por computador, como aplicaciones de procesado de imágenes.
Las CNN son arquitecturas especializadas para procesar datos visuales. Su pila de capas de convolución y las operaciones sobre imágenes están diseñadas para emular la corteza visual de los animales.
Las CNN sobresalen en tareas como clasificación de imágenes, detección de objetos y segmentación de imágenes. Aquí tienes un caso de uso para cada una:
Las capas de convolución extraen características de las imágenes de entrada. Aplican pesos aprendibles llamados filtros o kernels para detectar patrones como bordes, formas y texturas junto con su información y relaciones espaciales, aprendiendo así representaciones jerárquicas.
Por su parte, las capas de pooling reducen (downsampling) los mapas de características generados por las capas de convolución. Es decir, disminuyen la resolución espacial manteniendo la información importante.
Combinar capas de convolución y pooling aumenta la robustez ante variaciones en la entrada, reduce la complejidad computacional en entrenamiento e inferencia y ayuda a evitar el sobreajuste.
Entre los retos y limitaciones habituales, destacan especialmente en modelos como las CNN:
A continuación, algunas preguntas que podrían plantearte para un puesto que implique aprovechar deep learning en aplicaciones de PLN.
Los transformers son una familia revolucionaria de arquitecturas y el estado del arte para abordar problemas de PLN. Los mecanismos de atención son fundamentales en los transformers que sustentan los LLM como BERT y GPT y son en gran parte responsables de su éxito.
Los transformers capturan patrones complejos, contexto e incluso dependencias a largo alcance entre elementos de un texto de entrada, superando limitaciones de soluciones previas como la memoria reducida de las RNN.
En esencia, los mecanismos de atención ponderan la importancia de cada token de la secuencia sin necesidad de procesarla token a token.
Este componente clave ha impulsado grandes avances en clasificación de texto, generación y resumen, y ha revolucionado los LLM y la IA en general.
El curso de Datacamp Introduction to LLMs in Python te dota de habilidades prácticas para construir y aprovechar LLM y de una base sólida sobre sus conceptos y la arquitectura transformer.
El preentrenamiento entrena un modelo, como BERT para clasificación de texto, con un gran corpus (de millones a miles de millones de textos) para aprender representaciones del lenguaje de uso general.
El ajuste fino, en cambio, parte de un modelo preentrenado y ajusta sus parámetros en una aplicación específica, p. ej., análisis de sentimiento de reseñas de hoteles.
Como el ajuste fino se dirige a casos de uso concretos, emplea un conjunto pequeño y específico del dominio con ejemplos etiquetados, adaptando los pesos en partes del modelo para aprender los matices de la tarea objetivo y mejorar el rendimiento sin el coste y los datos de entrenar desde cero.
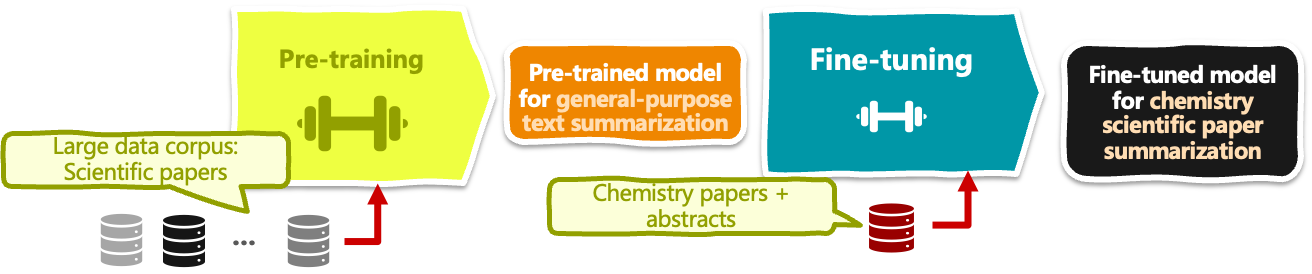
Ejemplo de preentrenamiento y ajuste fino de un LLM para resumir artículos de química | Iván Palomares
La arquitectura de BERT es una variante simplificada del transformer codificador-decodificador original, llamada transformer solo codificador.
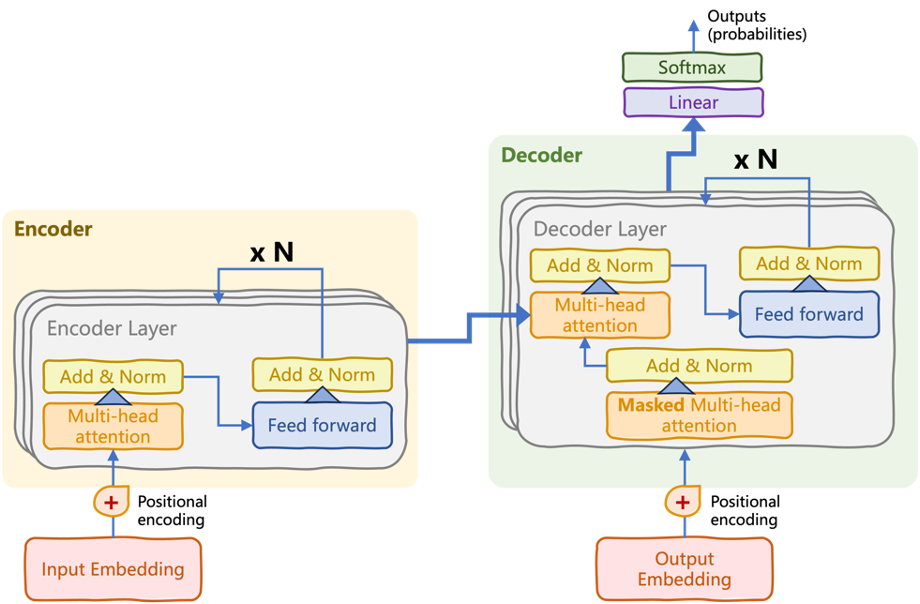
Arquitectura original de transformer, con pilas de codificador y decodificador | Introduction to LLMs in Python (Iván Palomares)
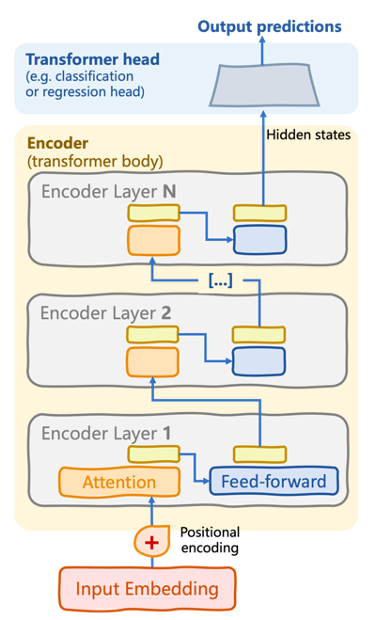
Arquitectura de transformer solo codificador usada por modelos como BERT | Introduction to LLMs in Python (Iván Palomares)
La pila de codificadores consta de múltiples capas. En cada una hay subcapas de autoatención y redes neuronales feedforward. La clave del entendimiento del lenguaje en BERT está en la atención bidireccional aplicada iterativamente en el codificador, de modo que se capturan dependencias entre palabras en ambas direcciones. Las conexiones feedforward "trenzan" estas dependencias en patrones de lenguaje más complejos.
Además, BERT incorpora Masked Language Modelling (MLM). Durante el preentrenamiento, enmascara palabras al azar, obligando al modelo a predecirlas a partir del contexto.
Cerramos con tres preguntas que pueden aparecer si optas a un puesto avanzado.
Puedes combinar estas estrategias para maximizar el rendimiento cuando los datos etiquetados escasean:
Desplegar soluciones a escala exige tener en cuenta, entre otras, estas tres consideraciones:
Otros aspectos clave son la infraestructura de hardware y red, la monitorización del sistema y la integración fluida con marcos de software existentes.
Los últimos avances en deep learning pueden transformar profundamente numerosos sectores e incluso crear otros nuevos.
Los mecanismos de atención usados en las arquitecturas transformer detrás de los LLM están revolucionando el PLN, ampliando sus límites y habilitando interacciones humano-máquina mucho más sofisticadas mediante IA conversacional, preguntas-respuestas y más. La incorporación reciente de Retrieval Augmented Generation (RAG) ayuda además a que los LLM produzcan lenguaje veraz y con soporte en evidencias.
El aprendizaje por refuerzo es una de las tendencias más prometedoras, pues imita principios básicos del aprendizaje humano. Su integración con arquitecturas profundas, en particular modelos generativos como las redes generativas antagónicas, está en la vanguardia de la investigación. Grandes actores como OpenAI, Google y Microsoft combinan ambos campos en soluciones capaces de generar contenido verosímil en múltiples formatos.
Estos y otros avances han democratizado drásticamente el uso de la IA, por lo que conviene poner el foco en ética, aspectos legales y regulación para asegurar un impacto positivo del deep learning en la sociedad.
En resumen, para triunfar necesitas una mezcla de fundamentos teóricos, dominio práctico y estar al día de los últimos avances.
El deep learning no va solo de algoritmos, modelos y elecciones de arquitectura. Se trata de encontrar las mejores soluciones para problemas reales basados en datos.
Y el aprendizaje continuo es clave. Datacamp ofrece un itinerario de Deep Learning in Python y dos itinerarios orientados a aplicaciones: image processing y natural language processing. Estos itinerarios te ofrecen una hoja de ruta estructurada para llevar tus habilidades de deep learning al siguiente nivel y llegar listo a tu próxima entrevista.
Por último, echa un vistazo a las secciones finales de este artículo sobre preguntas de entrevista de machine learning si buscas pautas generales para preparar tu entrevista de deep learning. Como el deep learning es una subdisciplina del machine learning, combinar esas pautas con las 20 preguntas revisadas aquí te ayudará a prepararte.
¡Continúa hoy tu camino en deep learning!
Curso
Programa
blog
Abid Ali Awan
15 min
blog
Austin Chia
15 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
9 min