Curso
Introdução a Deep Learning em Python
4 h
264.6K
Quer dicas para conquistar a vaga dos sonhos e lapidar suas habilidades em deep learning? Você chegou ao lugar certo. Este artigo traz respostas para 20 perguntas comuns de entrevistas para posições em deep learning, ajudando você a mandar bem com um pouco de prática.
As perguntas gerais costumam avaliar seu entendimento do campo, o que o diferencia de outras áreas da IA, como conectar problemas reais a soluções de deep learning e compreender seus desafios e limitações.
Deep learning é uma subárea de machine learning e da IA como um todo. Envolve treinar modelos grandes, baseados em redes neurais artificiais, com dados.
Esses modelos aprendem a resolver tarefas desafiadoras de predição e inferência (como classificação, regressão, reconhecimento de objetos em imagens, etc.) ao descobrir automaticamente padrões e atributos complexos presentes nos dados. Isso acontece ao mimetizar estruturas internas complexas do cérebro humano.
Nosso curso Understanding Artificial Intelligence desmistifica de forma abrangente as áreas e tarefas da IA que podem ser resolvidas, incluindo deep learning.
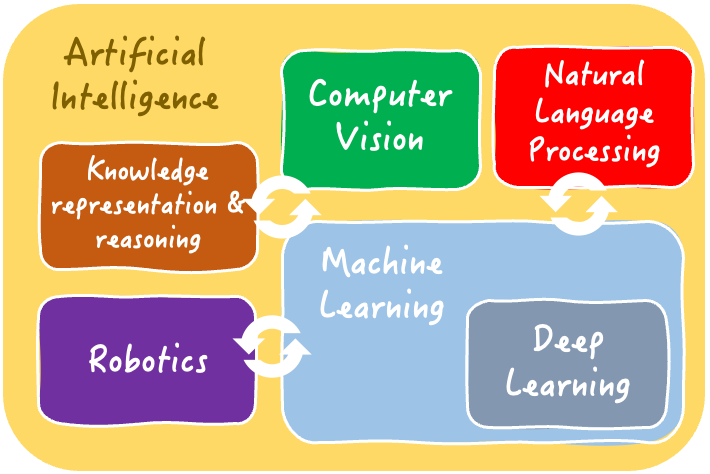
As áreas inter-relacionadas da inteligência artificial | Iván Palomares
Soluções de deep learning se destacam quando os dados têm alta complexidade, por exemplo, dados não estruturados ou de alta dimensionalidade.
Também é a escolha preferida para problemas com volumes massivos de dados ou que exigem capturar padrões sutis: muitas vezes, conseguem extrair e entender atributos relevantes que abordagens de machine learning podem não encontrar.
Alguns exemplos de problemas resolvidos com deep learning:
Atenção: para muitas tarefas e conjuntos de dados mais simples, modelos leves de machine learning, como árvores de decisão e regressões, podem ser mais do que suficientes — e acabam sendo melhor escolha do que modelos de deep learning por serem mais fáceis e baratos de treinar e colocar em produção.
Modelos de deep learning geralmente exigem preparo e processamento de dados mais cuidadosos; por isso, este artigo sobre entrevistas de engenharia de dados pode ser útil.
Escolher a abordagem adequada depende de fatores como a natureza dos dados, a complexidade do problema e os recursos computacionais disponíveis.
Os passos abaixo formam uma receita simples e eficaz para ajudar nessa decisão:
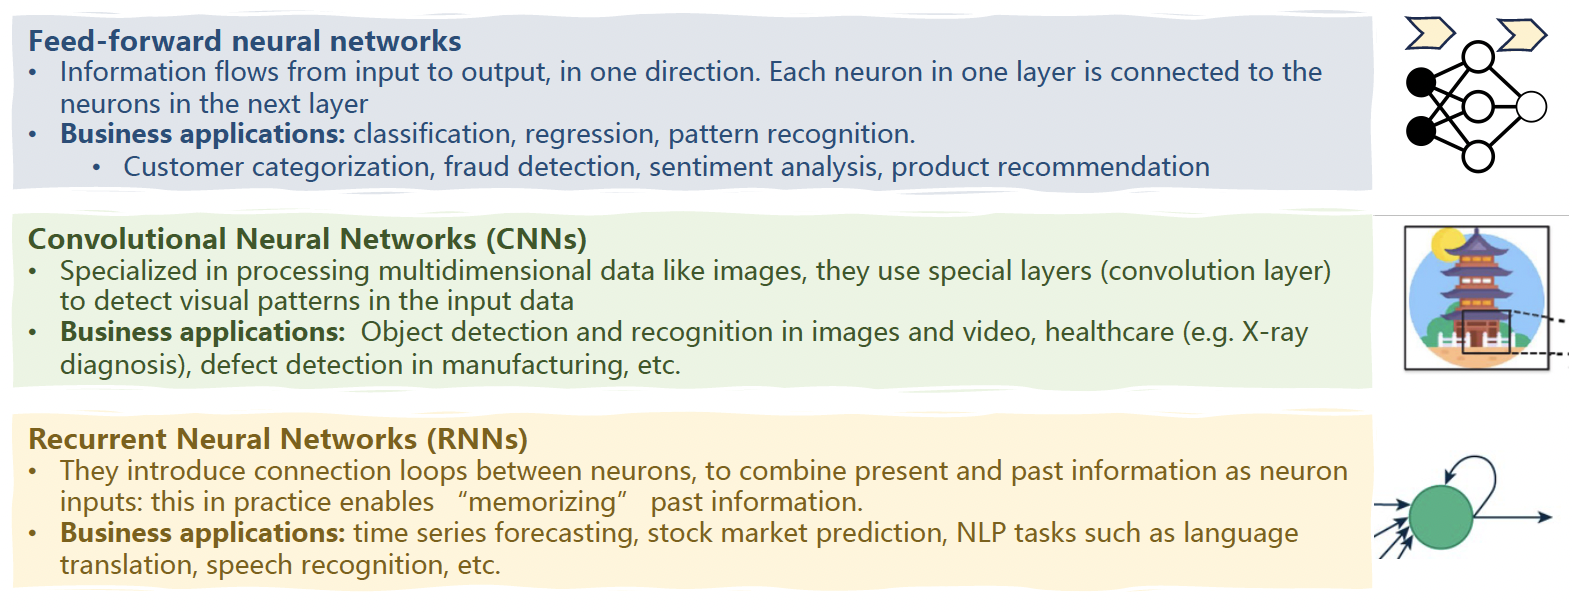
Três arquiteturas comuns de deep learning e suas aplicações | Iván Palomares
Projetar uma arquitetura de deep learning para uma tarefa específica como classificação envolve definir a quantidade e o tamanho das camadas de neurônios, além de escolher as funções de ativação corretas.
Essas decisões geralmente se baseiam nas características dos dados. Para classificação de imagens, você pode usar um conjunto de camadas convolucionais na arquitetura para capturar padrões visuais como cores (e combinações de cores), formas, bordas etc.
A camada no topo, ao final da arquitetura (o model head), também depende da tarefa, pois precisa ser desenhada para produzir a saída desejada.
Por exemplo, em um problema de classificar fotos de pintinhos por espécie de ave, as últimas camadas devem usar uma função de ativação softmax que gera probabilidades por classe para determinar a espécie mais provável à qual a imagem pertence.
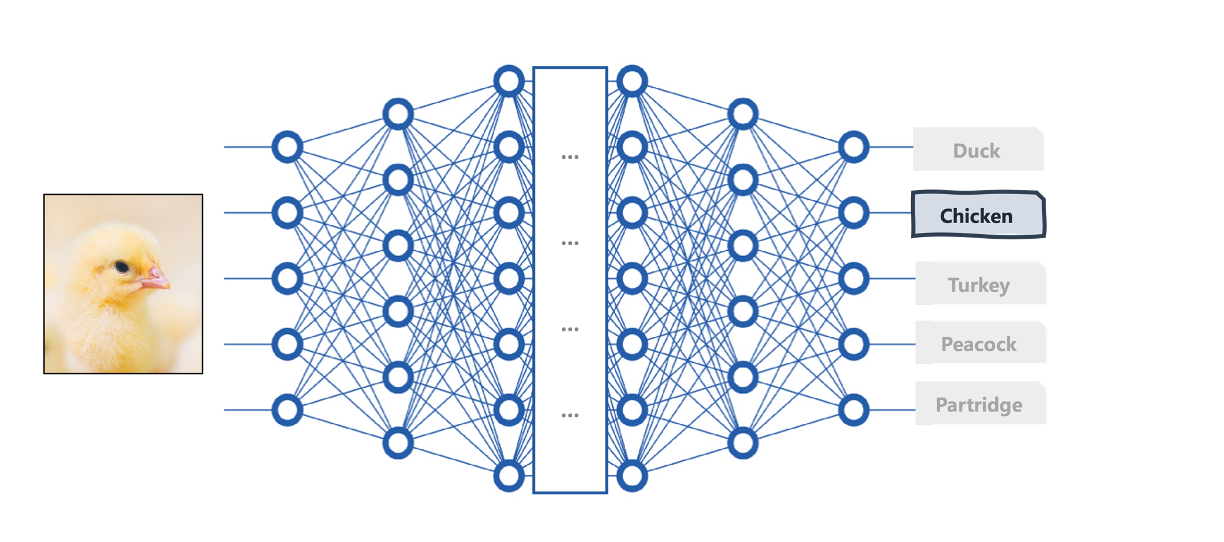
Uma arquitetura de deep learning para classificação de imagens | Iván Palomares
Desafios frequentes que podem atrapalhar a aplicação bem-sucedida de modelos de deep learning no mundo real incluem overfitting, gradientes que desaparecem ou explodem, e a necessidade de grandes volumes de dados rotulados para treino. A boa notícia é que, graças à pesquisa contínua, existem abordagens para lidar com isso.
Além dessas soluções específicas, estabeleça rotinas de monitoramento e ajuste fino do modelo para garantir bom desempenho no longo prazo.
Se você é recém-formado ou busca sua primeira posição em deep learning, espere perguntas que testem seu domínio de fundamentos e habilidades práticas para treinar e avaliar modelos em ambiente experimental.
Funções de ativação são funções matemáticas usadas em todas as arquiteturas modernas de redes neurais profundas. Elas atuam no nível do neurônio, mapeando vários inputs em um valor de saída que é enviado aos neurônios da próxima camada.
São cruciais porque introduzem não linearidade, essencial para que o modelo aprenda relações e padrões complexos nos dados durante o treinamento.
Sem elas, o modelo aprenderia pouco mais do que padrões lineares, aplicando combinações lineares sucessivas — como na regressão linear clássica.
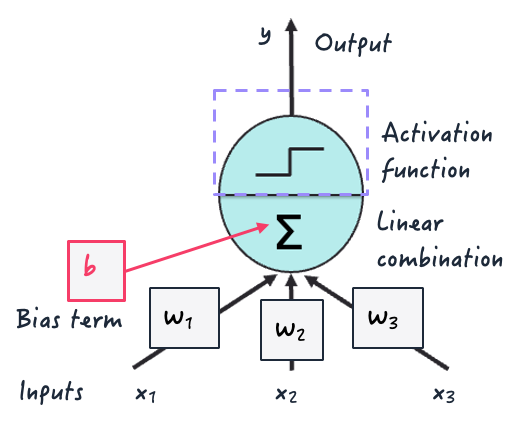
Função de ativação dentro de um neurônio artificial | Iván Palomares
Exemplos populares incluem a logística (logit), a tangente hiperbólica (tanh) e a unidade linear retificada (ReLU), como mostrado abaixo.
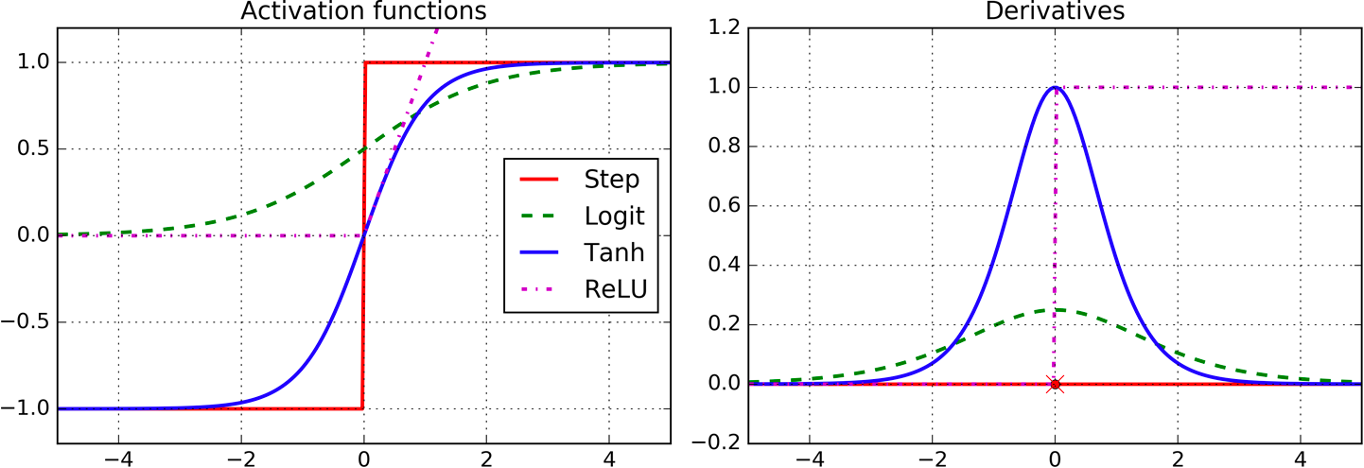
Exemplos de funções de ativação | Imagem de Aurelien Geron (O’Reilly)
O desempenho pode ser avaliado com métricas comuns de machine learning, dependendo da tarefa.
Para classificação, considere acurácia, precisão, recall, F1-score e AUC (Área sob a Curva). Para regressão, podemos usar métricas de erro como RMSE (Root Mean Square Error).
Use essas métricas para comparar as previsões do modelo com os rótulos verdadeiros ou com modelos de baseline. Para aplicações mais avançadas, como PLN, há métricas específicas, como BLEU para tradução, ROUGE para sumarização, e assim por diante.
Deep learning é usado em um amplo espectro de aplicações reais, como:
Para cargos com foco em engenharia, as perguntas tendem a abordar frameworks, bibliotecas e ferramentas de programação.
Para construir uma rede feedforward simples no TensorFlow para classificação de imagens, podemos começar definindo a arquitetura camada a camada usando a API Sequential do TensorFlow.
Isso inclui especificar o número de neurônios e as funções de ativação por camada e definir a camada final (saída) com ativação softmax.
Em seguida, compilamos o modelo definindo uma função de perda adequada, como entropia cruzada categórica, um otimizador como Adam e métricas de validação, antes de treiná-lo por um número de épocas. Depois de treinado, avaliamos o desempenho no conjunto de validação.
TensorFlow é frequentemente usado com a API Keras, que você dominará ao concluir o curso Advanced Deep Learning with Keras.
Para lidar com overfitting em um modelo implementado em PyTorch, uma estratégia comum é incorporar técnicas de regularização, como L1 ou L2, adicionando termos de penalização à função de perda.
Alternativamente, camadas de dropout podem ser incluídas para desativar neurônios aleatoriamente durante o treino, evitando que o modelo dependa excessivamente de atributos específicos dos dados.
Essas duas estratégias podem ser combinadas com early stopping para encerrar o treinamento quando a validação começar a piorar.
Quer aprimorar suas habilidades em PyTorch? Confira o curso Introduction to Deep Learning in the PyTorch.
VGG, BERT e ResNet são exemplos conhecidos de modelos pré-treinados que podem ser carregados para transfer learning e fine-tuning. Em geral, o processo envolve substituir o model head, isto é, a camada final de classificação, por uma nova adequada à tarefa-alvo.
Após essa pequena mudança estrutural, prosseguimos com o re-treinamento em um novo dataset usando uma taxa de aprendizado baixa, para adaptar os pesos à nova tarefa preservando grande parte dos atributos já aprendidos pelo modelo pré-treinado.
A seguir, algumas perguntas que podem aparecer para posições que envolvem criar ou gerenciar soluções de visão computacional com deep learning, como aplicações de processamento de imagens.
CNNs são arquiteturas especializadas para processar dados visuais. Seu conjunto de camadas convolucionais e operações sobre imagens foi projetado para imitar o córtex visual de animais.
CNNs mandam bem em tarefas como classificação de imagens, detecção de objetos e segmentação de imagens. Veja um breve exemplo para cada uma:
Camadas de convolução extraem atributos das imagens de entrada. Elas aplicam pesos aprendíveis — filtros ou kernels — para detectar padrões e atributos como bordas, formas e texturas, preservando informações e relações espaciais e aprendendo representações hierárquicas.
Já as camadas de pooling reduzem (downsample) os mapas de atributos gerados pelas convoluções. Em outras palavras, diminuem a dimensão espacial ou resolução, mantendo informações relevantes.
Combinar convolução e pooling ao longo da CNN aumenta a robustez a variações nas entradas, reduz a complexidade computacional no treino e na inferência e ajuda a evitar overfitting.
Dentre os desafios e limitações usuais, alguns ficam especialmente evidentes em modelos de visão computacional como CNNs:
Aqui estão algumas perguntas que podem surgir em posições que usam deep learning em aplicações de PLN.
Transformers são uma família revolucionária de arquiteturas e o estado da arte para uma ampla gama de problemas de PLN. Mecanismos de atenção são peça-chave nos transformers que sustentam LLMs como BERT e GPT e são, em grande parte, responsáveis pelo sucesso desses modelos.
Transformers capturam padrões complexos, contexto e dependências de longo alcance entre elementos do texto, superando limitações de abordagens anteriores, como a memória restrita das RNNs (Redes Neurais Recorrentes).
Mecanismos de atenção essencialmente ponderam a importância de cada token na sequência, sem exigir processamento token a token.
Esse componente levou a avanços significativos em tarefas como classificação de texto, geração de linguagem e sumarização, revolucionando a área de LLMs e a IA como um todo.
O curso da Datacamp Introduction to LLMs in Python capacita você não só com habilidades práticas para construir e usar LLMs, mas também com uma base sólida dos principais conceitos por trás de LLMs e transformers.
Pré-treinamento treina um modelo, como o BERT para classificação de texto, em um grande corpus (de milhões a bilhões de exemplos) para aprender representações linguísticas de uso geral.
Fine-tuning, por sua vez, pega um modelo pré-treinado e ajusta seus parâmetros em uma aplicação específica de PLN, por exemplo, análise de sentimento de avaliações de hotéis.
Como o fine-tuning mira casos de uso específicos, usa um dataset menor e de domínio específico, com textos rotulados, adaptando os pesos em partes do modelo para aprender as nuances da tarefa-alvo e melhorar o desempenho sem o custo computacional e a demanda de dados de treinar do zero.
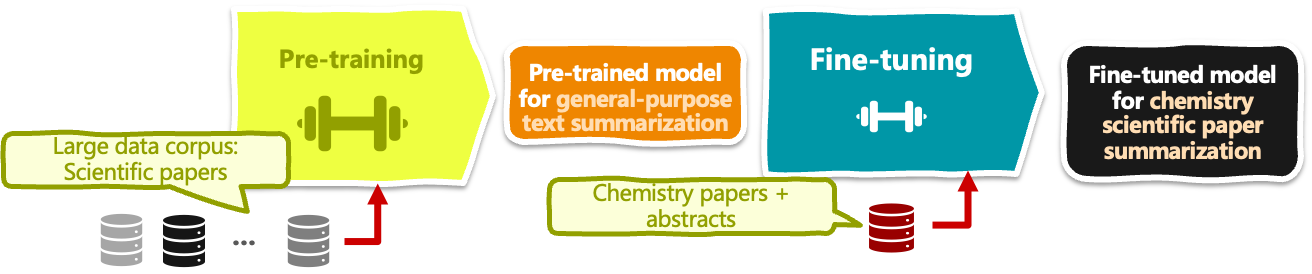
Exemplo de pré-treinamento e fine-tuning de um LLM para sumarização de artigos de química | Iván Palomares
A arquitetura do BERT é uma variante simplificada do transformer original encoder-decoder, chamada de transformer apenas com encoder.
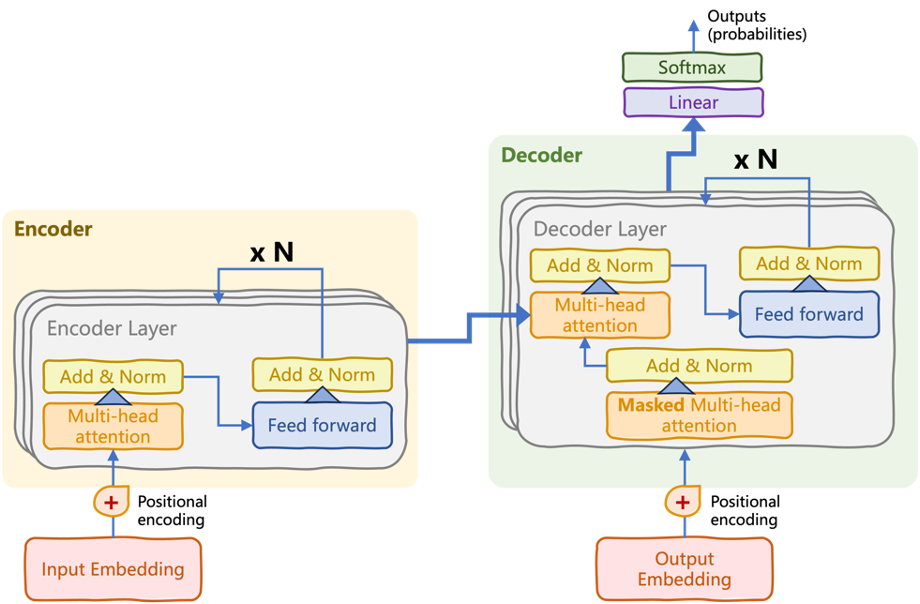
A arquitetura original do transformer, dividida em pilhas de encoder e decoder | Introduction to LLMs in Python (Iván Palomares)
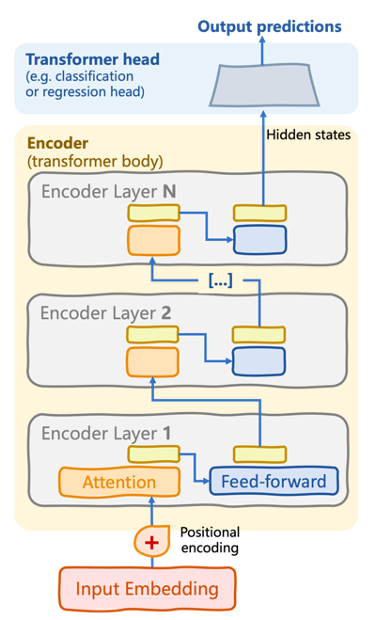
Arquitetura de transformer apenas com encoder usada por modelos como o BERT | Introduction to LLMs in Python (Iván Palomares)
A pilha de encoder consiste em múltiplas camadas de encoder (veja o diagrama). Em cada camada, há (sub)camadas de autoatenção e redes neurais feedforward. O segredo do entendimento de linguagem no BERT está no fluxo de atenção bidirecional aplicado iterativamente no encoder, capturando dependências entre palavras em ambas as direções. As conexões feedforward “amarram” essas dependências em padrões linguísticos mais complexos.
Além dessa característica geral dos transformers apenas com encoder, o BERT incorpora Masked Language Modelling (MLM). No pré-treinamento, algumas palavras são mascaradas aleatoriamente, forçando o modelo a prever os termos mascarados com base no contexto.
Para encerrar, três perguntas que podem aparecer em entrevistas para posições mais avançadas.
A estratégia combinada abaixo ajuda a maximizar o desempenho quando há poucos dados de treino:
Implantar soluções em produção em escala exige atenção a vários pontos, entre eles:
Outros pontos importantes incluem infraestrutura de hardware e rede, monitoramento do sistema e integração fluida com frameworks de software existentes.
Avanços recentes têm potencial para transformar profundamente diversos setores — e até criar novos.
Mecanismos de atenção usados nas arquiteturas transformer por trás de LLMs estão revolucionando o PLN, ampliando significativamente os limites das tarefas da área e possibilitando interações humano-máquina mais sofisticadas, com IA conversacional, perguntas e respostas e muito mais. A adoção do Retrieval Augmented Generation (RAG) vem ajudando LLMs a produzir linguagem mais fiel e baseada em evidências.
Reinforcement learning é uma das tendências mais promissoras, por mimetizar como humanos aprendem. Sua integração com arquiteturas de deep learning, especialmente modelos generativos como GANs, está na fronteira da pesquisa. Gigantes como OpenAI, Google e Microsoft combinam esses domínios em soluções capazes de gerar conteúdo “quase real” em múltiplos formatos.
Esses e outros avanços democratizaram o uso da IA. Por isso, ética, aspectos legais e regulação devem estar no foco para garantir um impacto positivo do deep learning na sociedade.
Concluindo esta revisão das perguntas comuns de entrevista sobre deep learning, o segredo do sucesso está na combinação de fundamentos teóricos, domínio prático e atualização constante.
Deep learning não é só sobre algoritmos, modelos e escolhas de arquitetura. É sobre encontrar as melhores soluções para problemas reais de dados.
E aprender continuamente é essencial. A Datacamp oferece uma trilha de habilidades Deep Learning in Python completa e duas trilhas voltadas à aplicação: image processing e natural language processing. Elas oferecem um roadmap estruturado para levar suas habilidades em deep learning ao próximo nível e chegar preparado para a próxima entrevista.
Por fim, confira as seções finais deste artigo sobre perguntas de entrevista de machine learning se você busca orientações gerais de preparação. Como deep learning é um subcampo de machine learning, combinar essas dicas com as 20 perguntas que vimos aqui vai turbinar seu preparo.
Continue sua jornada em deep learning hoje mesmo!
Curso
Programa
blog
Abid Ali Awan
15 min
blog
Hesam Sheikh Hassani
15 min
blog
Austin Chia
15 min
blog
Nisha Arya Ahmed
15 min
blog
Srujana Maddula
15 min
blog
Tim Lu
9 min