Cerchi una guida per ottenere il lavoro dei tuoi sogni e affinare le tue competenze di deep learning? Sei nel posto giusto. Questo articolo offre le risposte a 20 domande comuni dei colloqui per posizioni in deep learning, aiutandoti a brillare durante i colloqui con un po' di pratica.
Domande generali sul deep learning
Le domande generali sul deep learning di solito riguardano la comprensione del campo, cosa lo distingue da altre aree dell'IA, come collegare problemi reali a soluzioni di deep learning e comprenderne sfide e limitazioni.
1. Che cos'è il deep learning?
Il deep learning è una sottoarea del machine learning e, più in generale, dell'IA. Consiste nell'addestrare grandi modelli basati su reti neurali artificiali sui dati.
I modelli imparano a risolvere compiti complessi di previsione e inferenza (come classificazione, regressione, riconoscimento di oggetti nelle immagini, ecc.) scoprendo automaticamente pattern e caratteristiche complesse alla base dei dati. Ciò avviene imitando le strutture interne complesse dei cervelli umani.
Il nostro corso Understanding Artificial Intelligence chiarisce in modo completo le aree e i compiti risolvibili dell'IA, incluso il deep learning.
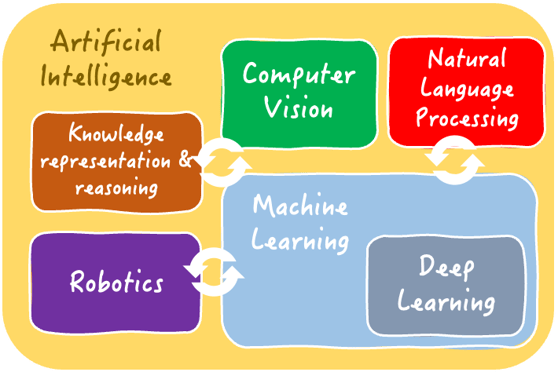
Le aree interconnesse dell'Intelligenza Artificiale | Iván Palomares
2. Quando dovresti scegliere il deep learning rispetto a soluzioni di machine learning?
Le soluzioni di deep learning si distinguono in problemi in cui i dati hanno elevata complessità, ad esempio dati non strutturati o ad alta dimensionalità.
Sono anche la scelta preferita per problemi con enormi quantità di dati o che richiedono di catturare pattern sottili: spesso riescono a estrarre e comprendere caratteristiche significative dei dati che gli approcci di machine learning potrebbero non individuare.
Ecco alcuni esempi di problemi risolvibili con soluzioni di deep learning:
- Classificazione di immagini di specie animali o vegetali
- Previsioni a lungo termine dei prezzi di borsa
- Riconoscimento facciale nelle immagini
- Attività di elaborazione del linguaggio naturale come riconoscimento vocale, traduzione e altro
Attenzione, però: per molti compiti e dataset più semplici, modelli di machine learning leggeri come alberi decisionali e regressori possono essere più che sufficienti, rendendoli una scelta migliore dei modelli di deep learning perché più facili ed economici da addestrare e distribuire.
I modelli di deep learning richiedono in genere solide competenze di preparazione e trasformazione dei dati; perciò potresti trovare utile il seguente articolo sulle interviste di data engineering.
3. Come sceglieresti l'approccio di deep learning giusto per il tuo problema e i tuoi dati?
Decidere un approccio di deep learning adeguato dipende da diversi fattori, come la natura dei dati, la complessità del problema e le risorse di calcolo disponibili.
I seguenti passaggi sono una ricetta semplice ma efficace per aiutarti a fare questa scelta importante:
- Esegui un'analisi approfondita delle caratteristiche dei tuoi dati. Sono strutturati o non strutturati? Ci sono dipendenze temporali o spaziali? Quali sono le variabili target che vuoi predire con il tuo modello?
- In base all'analisi dei dati, seleziona il tipo di architettura di deep learning più adatta. Ad esempio, le reti neurali convoluzionali (CNN) eccellono nell'elaborazione di dati visivi, mentre le reti neurali ricorrenti (RNN) sono particolarmente efficaci sui dati sequenziali.
- Considera fattori aggiuntivi come interpretablità del modello, scalabilità e disponibilità di dati etichettati per l'addestramento. Diverse architetture di deep learning gestiscono questi aspetti in misura diversa.
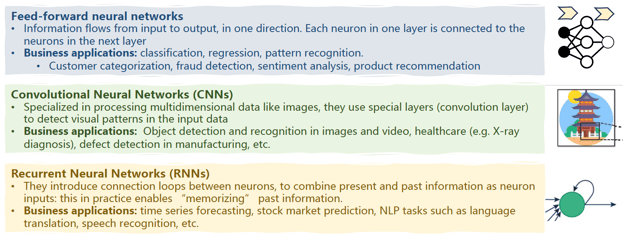
Tre architetture comuni di deep learning e le loro applicazioni | Iván Palomares
4. Come progetteresti un'architettura di deep learning per la classificazione?
Progettare un'architettura di deep learning su misura per un compito specifico come la classificazione implica scegliere il numero e la dimensione appropriati degli strati di neuroni, oltre alle corrette funzioni di attivazione.
Queste decisioni si basano tipicamente sulle caratteristiche dei dati. Per la classificazione di immagini, potresti usare una pila di strati convoluzionali nella tua architettura per catturare pattern visivi come colori (o combinazioni di colori), forme, bordi, ecc.
Lo strato superiore situato alla fine della tua architettura di deep learning (model head) dipende anche dal compito da svolgere, poiché deve essere progettato per produrre l'output desiderato.
Ad esempio, per un problema di classificazione di immagini come classificare immagini di pulcini in specie di uccelli, questi ultimi strati dovrebbero avere una funzione di attivazione softmax che restituisca le probabilità di classe per determinare la specie di uccello più probabile a cui appartiene l'immagine analizzata.
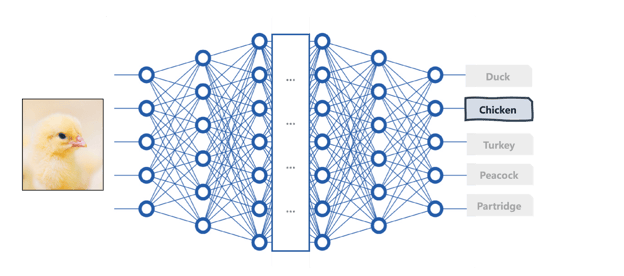
Un'architettura di deep learning per la classificazione di immagini | Iván Palomares
5. Quali sono alcune sfide comuni nei modelli di deep learning e come le affronteresti?
Sfide frequenti che possono ostacolare l'applicazione reale dei modelli di deep learning includono overfitting, gradienti che svaniscono o esplodono e la necessità di grandi quantità di dati etichettati per l'addestramento. La buona notizia è che, grazie alla ricerca continua, esistono approcci per affrontarle.
- L'overfitting si verifica quando un modello impara in modo tale da "memorizzare eccessivamente" l'aspetto dei dati di addestramento, e poi fatica a eseguire inferenze corrette su dati futuri e mai visti. Per affrontarlo, esistono tecniche mirate a ridurre la complessità del modello, come la regolarizzazione o a limitare quanto il modello impari dai dati, ad esempio tramite early stopping.
- I gradienti che svaniscono o esplodono sono legati a problemi di convergenza verso soluzioni non ottimali durante il processo di aggiornamento dei pesi alla base dell'addestramento. Il clipping del gradiente e le funzioni di attivazione avanzate possono aiutare a mitigare questo problema.
- Se la sfida riguarda pochi dati etichettati, prova a esplorare il transfer learning e le tecniche di data augmentation per sfruttare modelli pre-addestrati o generare dati sintetici, rispettivamente.
Oltre a queste soluzioni specifiche, assicurati di predisporre meccanismi regolari di monitoraggio e fine-tuning del modello per garantire buone prestazioni nel lungo periodo.
Domande di colloquio sul deep learning per neolaureati
Se sei un neolaureato o stai cercando la tua prima posizione in deep learning, potresti aspettarti domande che valutano l'acquisizione delle basi teoriche e abilità pratiche nell'addestrare e valutare modelli di deep learning in contesti sperimentali.
1. Cosa sono le funzioni di attivazione e perché sono fondamentali nella progettazione di modelli di deep learning?
Le funzioni di attivazione sono funzioni matematiche utilizzate in tutte le moderne architetture di reti neurali profonde. Agiscono a livello di neurone, durante il processo di mappatura di più input del neurone in un valore di output inviato ai neuroni dello strato successivo.
Sono cruciali nei modelli di deep learning perché introducono non linearità, elemento vitale per permettere loro di apprendere relazioni e pattern complessi nei dati durante l'addestramento.
Altrimenti, apprenderebbero poco più che pattern di linearità dai dati applicando successive combinazioni lineari degli input, proprio come fanno i classici modelli di regressione lineare!
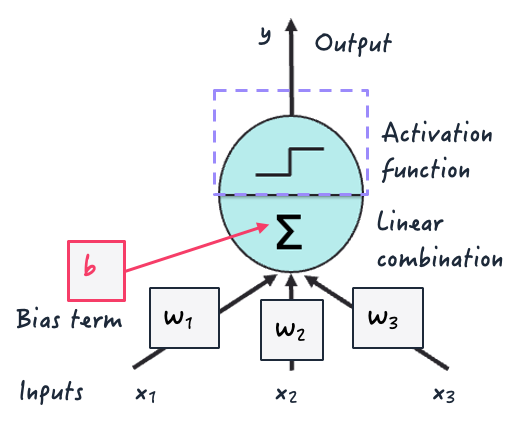
Funzione di attivazione all'interno di un neurone artificiale | Iván Palomares
Esempi di funzioni di attivazione popolari sono la logistica (logit), la tangente iperbolica (tanh) e la ReLU (rectified linear unit), come mostrato di seguito.
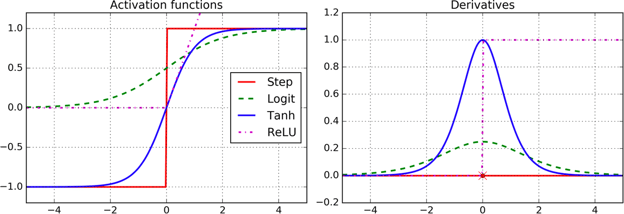
Esempi di funzioni di attivazione | Immagine di Aurelien Geron (O'Reilly)
2. Come valuteresti le prestazioni di un modello di deep learning?
Le prestazioni dei modelli di deep learning possono essere valutate utilizzando metriche comuni del machine learning, a seconda del compito.
Per la classificazione, considera metriche come accuratezza, precisione, richiamo, F1-score e Area Under the Curve (AUC). Per la regressione, invece, possiamo usare metriche d'errore come la Root Mean Square Error (RMSE).
Queste metriche dovrebbero essere utilizzate per confrontare le previsioni del modello con le etichette di verità a terra o con modelli baseline. Per modelli e applicazioni più avanzati, come l'NLP, esistono metriche specifiche per i vari compiti linguistici, come il punteggio BLEU per la traduzione, ROUGE per il riassunto, e così via.
3. Quali sono alcuni esempi di uso del deep learning nel business e nell'industria?
Il deep learning è utilizzato in un'ampia gamma di applicazioni reali, tra cui:
- Riconoscimento di immagini e oggetti sulle strade per veicoli autonomi
- Elaborazione e comprensione del linguaggio naturale per chatbot di assistenza clienti
- Analisi predittiva per raccomandazioni personalizzate nel retail
- Diagnosi medica su immagini ai raggi X
Domande di colloquio per l'ingegneria del deep learning
Le domande per un ruolo di deep learning con focus ingegneristico si concentreranno su aspetti come framework di programmazione, librerie e strumenti.
1. Come useresti TensorFlow per costruire una semplice rete neurale feedforward per la classificazione di immagini?
Per costruire una semplice rete neurale feed-forward per la classificazione di immagini in TensorFlow, si può iniziare definendo l'architettura del modello strato per strato usando la Sequential API di TensorFlow.
Ciò include specificare il numero appropriato di neuroni e le funzioni di attivazione per strato e definire lo strato finale (strato di output) con attivazione softmax.
Poi si compila il modello specificando una funzione di perdita adatta, come la categorical cross-entropy, un ottimizzatore come Adam e le metriche di validazione, prima di addestrarlo sui dati di training per un numero definito di epoche. Una volta costruito il modello, se ne può valutare la performance sul set di validazione.
TensorFlow è comunemente usato insieme all'API Keras, che potrai padroneggiare completando il corso Advanced Deep Learning with Keras.
2. Descrivi il tuo approccio per gestire l'overfitting in un modello di deep learning tramite tecniche di regolarizzazione in PyTorch
Per gestire l'overfitting in un modello di deep learning implementato con PyTorch, una strategia comune è incorporare tecniche di regolarizzazione come la regolarizzazione L1 o L2 con termini di penalità aggiunti alla funzione di perdita.
In alternativa, si possono introdurre strati di dropout per disattivare casualmente neuroni durante l'addestramento; questo impedisce al modello di fare eccessivo affidamento su caratteristiche specifiche estratte dai dati.
Queste due strategie possono essere combinate con l'early stopping per terminare l'addestramento quando le prestazioni in validazione iniziano a peggiorare.
Vuoi affinare le tue competenze in PyTorch? Allora dai un'occhiata al corso Introduction to Deep Learning in the PyTorch.
3. Facci un esempio di uso del transfer learning per mettere a punto un modello di deep learning pre-addestrato su un nuovo compito
VGG, BERT o ResNet sono esempi noti di modelli pre-addestrati che possono essere caricati per il transfer learning e il fine-tuning. In particolare, il processo prevede la sostituzione della model head, cioè lo strato finale di classificazione, con uno nuovo adatto al compito target.
Dopo questa piccola modifica strutturale all'architettura del modello, si procede a riaddestrarlo su un nuovo dataset utilizzando un learning rate basso per adattare i pesi del modello al nuovo compito, mantenendo per lo più le caratteristiche principali apprese in origine dai modelli pre-addestrati.
Domande di colloquio sul deep learning per la Computer Vision
Di seguito alcune possibili domande che l'intervistatore potrebbe farti per una posizione che prevede la creazione o la gestione di soluzioni di deep learning in computer vision, come le applicazioni di elaborazione delle immagini.
1. Spiega le reti neurali convoluzionali e applica il concetto a tre casi d'uso tipici.
Le CNN sono architetture di deep learning specializzate per l'elaborazione di dati visivi. La loro pila di strati convoluzionali e le operazioni sottostanti sui dati di immagine sono progettate per imitare la corteccia visiva dei cervelli animali.
Le CNN eccellono in compiti come classificazione di immagini, rilevamento di oggetti e segmentazione di immagini. Ecco una breve descrizione di caso d'uso per ciascuno di questi compiti:
- Classificazione di immagini: identifica se un'immagine mostra un cane o un gatto per sistemi automatizzati di identificazione e monitoraggio degli animali domestici.
- Rilevamento di oggetti: consente a veicoli autonomi di individuare e riconoscere in tempo reale i pedoni.
- Segmentazione di immagini: delinea i confini dei tumori nelle immagini mediche per diagnosticare e trattare con precisione i pazienti oncologici.
2. Descrivi il ruolo degli strati di convoluzione e pooling nelle CNN
Gli strati di convoluzione nelle CNN sono responsabili dell'estrazione delle caratteristiche dalle immagini in input. Applicano un insieme di pesi apprendibili chiamati filtri o kernel per individuare pattern e caratteristiche come bordi, forme e texture insieme alle loro informazioni e relazioni spaziali, apprendendo così rappresentazioni visive gerarchiche.
Nel frattempo, gli strati di pooling effettuano il downsampling delle feature map (rappresentazioni intermedie dell'immagine) prodotte dagli strati convoluzionali. In altre parole, ne riducono la dimensione spaziale o risoluzione mantenendo comunque le informazioni importanti estratte.
Combinare successivi strati di convoluzione con strati di pooling in una CNN aiuta ad aumentare la robustezza alle variazioni negli input, riduce la complessità computazionale in fase di training e inferenza e contribuisce a prevenire problemi come l'overfitting.
3. Quali sono alcune sfide comuni dei modelli di deep learning addestrati per compiti di computer vision?
Tra le solite sfide e limitazioni dei modelli di deep learning, i seguenti esempi risultano particolarmente accentuati nei modelli per computer vision come le CNN:
- Quantità e qualità dei dati: i modelli di deep learning per la computer vision richiedono dataset etichettati molto grandi per essere addestrati correttamente. Questi dati devono anche avere sufficiente qualità: immagini ad alta risoluzione e prive di rumore, senza problemi come sfocatura o sovraesposizione, ecc.
- Overfitting: le CNN possono tendere a memorizzare il rumore o dettagli specifici (a volte irrilevanti) nei dati visivi di training, portando a una scarsa generalizzazione.
- Risorse computazionali: l'addestramento di architetture CNN profonde richiede notevoli risorse di calcolo a causa dell'elevato numero di strati e parametri addestrabili. Molte di esse richiedono GPU e grandi quantità di memoria per un training fluido.
- Interpretabilità: comprendere come i modelli fanno le previsioni (in particolare quelle errate) in compiti complessi come il riconoscimento di immagini resta una sfida.
Domande di colloquio sul deep learning per l'NLP
Ecco alcune possibili domande che l'intervistatore potrebbe farti per una posizione che prevede l'impiego di tecnologie di deep learning in applicazioni NLP.
1. In che modo i meccanismi di attenzione migliorano le prestazioni dei modelli di deep learning per compiti NLP?
I transformer sono una famiglia rivoluzionaria di architetture di deep learning e lo stato dell'arte attuale per affrontare un'ampia gamma di problemi NLP impegnativi. I meccanismi di attenzione sono fondamentali per le architetture transformer alla base dei Large Language Models (LLM) come BERT e GPT e sono in gran parte responsabili del loro successo.
I transformer hanno la capacità di catturare pattern complessi, informazioni contestuali e dipendenze a lungo raggio tra gli elementi di un testo in input, superando significativamente problemi riscontrati in soluzioni precedenti come la memoria limitata delle RNN (Recurrent Neural Networks).
I meccanismi di attenzione in sostanza pesano l'importanza di ogni token in una sequenza, senza la necessità di elaborarla token per token.
Questa componente cruciale dei transformer ha portato a progressi significativi in compiti come classificazione del testo, generazione del linguaggio e riassunto, e ha rivoluzionato l'area degli LLM e dell'IA nel suo complesso.
Il corso di Datacamp Introduction to LLMs in Python ti fornisce non solo competenze pratiche per costruire e sfruttare gli LLM, ma anche una solida comprensione dei concetti principali che riguardano gli LLM e le architetture transformer.
2. Cosa comportano il pre-training e il fine-tuning del modello per le architetture di deep learning e i dati nel contesto dell'NLP?
Il pre-training del modello addestra un modello di deep learning, come BERT per la classificazione del testo, su un ampio corpus di dati testuali (da milioni a miliardi di testi di esempio) per apprendere rappresentazioni linguistiche per la comprensione del linguaggio di uso generale.
Il fine-tuning del modello, invece, consiste nel prendere un modello pre-addestrato e mettere a punto i parametri appresi su una specifica applicazione NLP a valle, ad esempio l'analisi del sentiment delle recensioni di hotel.
Poiché il fine-tuning è in genere mirato a casi d'uso specifici, richiede l'uso di un piccolo dataset di esempi di testo etichettati e specifici del dominio, adattando così i pesi in parti del modello per apprendere le sfumature del compito target e migliorare le prestazioni del modello in quello specifico contesto, senza i costi computazionali e i requisiti di dati dell'addestramento da zero.
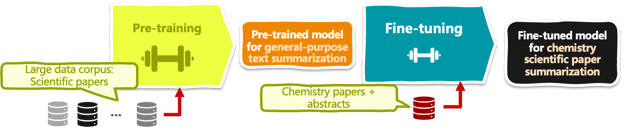
Esempio di pre-training del modello e fine-tuning di un LLM per il riassunto di articoli di chimica | Iván Palomares
L'architettura di BERT è una variante semplificata del transformer encoder-decoder originale, detta transformer solo-encoder.
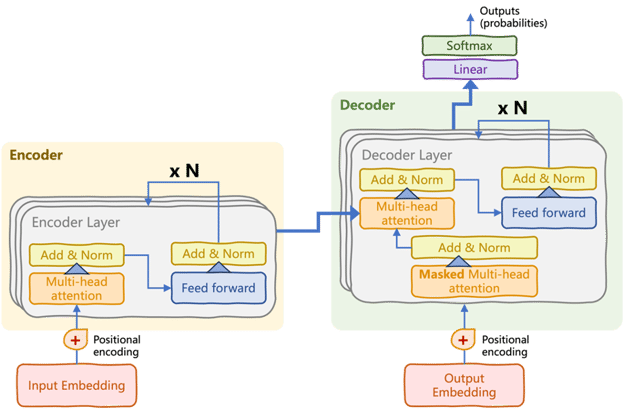
L'architettura transformer originale, suddivisa in stack di encoder e decoder | Introduction to LLMs in Python (Iván Palomares)
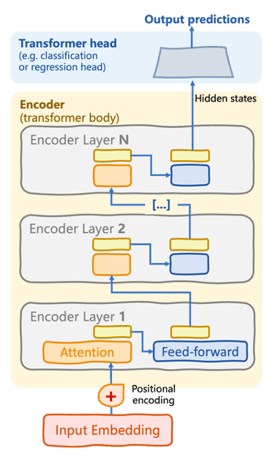
Architettura transformer solo-encoder usata da modelli come BERT | Introduction to LLMs in Python (Iván Palomares)
Lo stack di encoder è costituito da più layer di encoder (vedi diagramma sopra). All'interno di ogni layer ci sono (sotto)strati di meccanismi di self-attention e reti neurali feedforward. La chiave del processo di comprensione del linguaggio svolto da BERT risiede nel flusso di attenzione bidirezionale applicato iterativamente nell'encoder, tale per cui le dipendenze tra le parole in una sequenza di input vengono catturate in entrambe le direzioni. Le connessioni neurali feedforward "mettono insieme" queste dipendenze apprese in pattern linguistici più complessi.
Oltre a questa caratteristica generale dei transformer solo-encoder, BERT si distingue per l'inclusione di un approccio di Masked Language Modelling (MLM). Questo meccanismo viene usato durante il pre-training per mascherare casualmente alcune parole, costringendo il modello a imparare a prevedere le parole mascherate in base alla comprensione del contesto che le circonda.
Domande di colloquio avanzate sul deep learning
Concludiamo con tre domande che potresti ricevere se ti candidi per un ruolo avanzato nel deep learning.
1. Come progetteresti e implementeresti un modello di deep learning per un problema con pochi dati etichettati?
La seguente strategia combinata può essere implementata per massimizzare le prestazioni del modello di deep learning quando ci si trova di fronte al comune problema di dati di training limitati:
- Sfruttare il transfer learning mettendo a punto modelli pre-addestrati su un compito specifico di dominio simile a quello per cui il modello originale era stato addestrato.
- Esplorare l'apprendimento semi-supervisionato e l'apprendimento self-supervisionato per ottenere per lo più dataset non etichettati.
- La data augmentation e i modelli generativi possono aiutare a generare esempi di dati sintetici per arricchire il set etichettato originale.
- Le metodologie di active learning possono essere usate per interpellare gli utenti e ottenere campioni etichettati aggiuntivi a partire da un insieme di dati non etichettati.
2. Puoi elencare tre considerazioni importanti quando si distribuiscono modelli di deep learning su larga scala in ambienti di produzione reali?
Distribuire soluzioni di deep learning su larga scala in contesti di produzione richiede attenzione a diverse considerazioni, tra cui tre sono:
- Scalabilità e prestazioni del modello sono critiche e richiedono architetture efficienti e approcci di ottimizzazione per gestire flussi di dati elevati in tempo reale.
- Robustezza e affidabilità sono fondamentali, istituendo procedure di test e validazione per garantire prestazioni coerenti nel tempo e tra diversi scenari.
- Garantire standard di privacy e sicurezza dei dati nonché la conformità normativa per salvaguardare le informazioni sensibili. Questi sono aspetti vitali per assicurare un comportamento responsabile del sistema e l'uso del sistema di deep learning, e per conquistare la fiducia degli utenti.
Altre considerazioni importanti per la messa in produzione di modelli di deep learning includono l'infrastruttura hardware e di rete, il monitoraggio del sistema e l'integrazione senza soluzione di continuità con i framework software esistenti.
3. Come immagini che i recenti progressi nel deep learning possano plasmare il futuro del campo in termini di applicazioni e impatto più ampio?
Le recenti scoperte nel deep learning hanno il potenziale di rimodellare profondamente numerose industrie e persino crearne di nuove.
I meccanismi di attenzione usati nelle architetture transformer alla base degli LLM stanno rivoluzionando il campo dell'NLP, spostando significativamente i confini dei compiti NLP e abilitando interazioni uomo-macchina più sofisticate attraverso soluzioni di AI conversazionale, question answering e molto altro. La recente inclusione della Retrieval Augmented Generation (RAG) sta ulteriormente aiutando gli LLM a produrre linguaggio veritiero e basato su evidenze.
Il reinforcement learning è una delle tendenze più promettenti dell'IA poiché i suoi principi imitano le basi dell'apprendimento umano. La sua integrazione con le architetture di deep learning, in particolare i modelli generativi come le generative adversarial networks, è all'avanguardia della ricerca accademica odierna. Big come OpenAI, Google e Microsoft combinano questi due domini dell'IA nelle loro più recenti soluzioni rivoluzionarie capaci di generare contenuti "quasi reali" in più formati.
Questi e altri progressi recenti hanno drasticamente democratizzato l'uso dell'IA da parte della società; pertanto è opportuno puntare l'attenzione su etica dell'IA, aspetti legali e regolamentazione come temi chiave su cui lavorare per garantire un impatto benefico delle soluzioni di deep learning nella società.
Per concludere
Per concludere questa panoramica delle domande comuni nei colloqui sul deep learning, un'osservazione ovvia è che la chiave del successo risiede in un mix di basi teoriche, solida padronanza delle abilità pratiche e aggiornamento costante sugli ultimi progressi.
Il deep learning non riguarda solo algoritmi, modelli e scelte di progettazione dell'architettura. Riguarda l'identificazione delle migliori soluzioni per risolvere problemi reali sui dati.
E l'apprendimento continuo è fondamentale. Datacamp offre un completo skill track Deep Learning in Python oltre a due percorsi orientati alle applicazioni di deep learning: image processing e natural language processing. Questi percorsi offrono una roadmap strutturata per migliorare le tue competenze di deep learning, assicurandoti la giusta preparazione per il prossimo colloquio.
Infine, consulta le sezioni finali di questo articolo sulle domande dei colloqui di machine learning se cerchi linee guida generali su come prepararti al tuo colloquio di deep learning. Poiché il deep learning è un sottoinsieme del machine learning, unire quelle linee guida generali alle 20 domande sul deep learning che abbiamo esaminato qui ti aiuterà sicuramente a prepararti.



 Abid Ali Awan · 15 min


 Tim Lu · 12 min
Cerchi una guida per ottenere il lavoro dei tuoi sogni e affinare le tue competenze di deep learning? Sei nel posto giusto. Questo articolo offre le risposte a 20 domande comuni dei colloqui per posizioni in deep learning, aiutandoti a brillare durante i colloqui con un po' di pratica.
Domande generali sul deep learning
Le domande generali sul deep learning di solito riguardano la comprensione del campo, cosa lo distingue da altre aree dell'IA, come collegare problemi reali a soluzioni di deep learning e comprenderne sfide e limitazioni.
1. Che cos'è il deep learning?
Il deep learning è una sottoarea del machine learning e, più in generale, dell'IA. Consiste nell'addestrare grandi modelli basati su reti neurali artificiali sui dati.
I modelli imparano a risolvere compiti complessi di previsione e inferenza (come classificazione, regressione, riconoscimento di oggetti nelle immagini, ecc.) scoprendo automaticamente pattern e caratteristiche complesse alla base dei dati. Ciò avviene imitando le strutture interne complesse dei cervelli umani.
Il nostro corso Understanding Artificial Intelligence chiarisce in modo completo le aree e i compiti risolvibili dell'IA, incluso il deep learning.
Le aree interconnesse dell'Intelligenza Artificiale | Iván Palomares
2. Quando dovresti scegliere il deep learning rispetto a soluzioni di machine learning?
Le soluzioni di deep learning si distinguono in problemi in cui i dati hanno elevata complessità, ad esempio dati non strutturati o ad alta dimensionalità.
Sono anche la scelta preferita per problemi con enormi quantità di dati o che richiedono di catturare pattern sottili: spesso riescono a estrarre e comprendere caratteristiche significative dei dati che gli approcci di machine learning potrebbero non individuare.
Ecco alcuni esempi di problemi risolvibili con soluzioni di deep learning:
Attenzione, però: per molti compiti e dataset più semplici, modelli di machine learning leggeri come alberi decisionali e regressori possono essere più che sufficienti, rendendoli una scelta migliore dei modelli di deep learning perché più facili ed economici da addestrare e distribuire.
I modelli di deep learning richiedono in genere solide competenze di preparazione e trasformazione dei dati; perciò potresti trovare utile il seguente articolo sulle interviste di data engineering.
3. Come sceglieresti l'approccio di deep learning giusto per il tuo problema e i tuoi dati?
Decidere un approccio di deep learning adeguato dipende da diversi fattori, come la natura dei dati, la complessità del problema e le risorse di calcolo disponibili.
I seguenti passaggi sono una ricetta semplice ma efficace per aiutarti a fare questa scelta importante:
Tre architetture comuni di deep learning e le loro applicazioni | Iván Palomares
4. Come progetteresti un'architettura di deep learning per la classificazione?
Progettare un'architettura di deep learning su misura per un compito specifico come la classificazione implica scegliere il numero e la dimensione appropriati degli strati di neuroni, oltre alle corrette funzioni di attivazione.
Queste decisioni si basano tipicamente sulle caratteristiche dei dati. Per la classificazione di immagini, potresti usare una pila di strati convoluzionali nella tua architettura per catturare pattern visivi come colori (o combinazioni di colori), forme, bordi, ecc.
Lo strato superiore situato alla fine della tua architettura di deep learning (model head) dipende anche dal compito da svolgere, poiché deve essere progettato per produrre l'output desiderato.
Ad esempio, per un problema di classificazione di immagini come classificare immagini di pulcini in specie di uccelli, questi ultimi strati dovrebbero avere una funzione di attivazione softmax che restituisca le probabilità di classe per determinare la specie di uccello più probabile a cui appartiene l'immagine analizzata.
Un'architettura di deep learning per la classificazione di immagini | Iván Palomares
5. Quali sono alcune sfide comuni nei modelli di deep learning e come le affronteresti?
Sfide frequenti che possono ostacolare l'applicazione reale dei modelli di deep learning includono overfitting, gradienti che svaniscono o esplodono e la necessità di grandi quantità di dati etichettati per l'addestramento. La buona notizia è che, grazie alla ricerca continua, esistono approcci per affrontarle.
Oltre a queste soluzioni specifiche, assicurati di predisporre meccanismi regolari di monitoraggio e fine-tuning del modello per garantire buone prestazioni nel lungo periodo.
Domande di colloquio sul deep learning per neolaureati
Se sei un neolaureato o stai cercando la tua prima posizione in deep learning, potresti aspettarti domande che valutano l'acquisizione delle basi teoriche e abilità pratiche nell'addestrare e valutare modelli di deep learning in contesti sperimentali.
1. Cosa sono le funzioni di attivazione e perché sono fondamentali nella progettazione di modelli di deep learning?
Le funzioni di attivazione sono funzioni matematiche utilizzate in tutte le moderne architetture di reti neurali profonde. Agiscono a livello di neurone, durante il processo di mappatura di più input del neurone in un valore di output inviato ai neuroni dello strato successivo.
Sono cruciali nei modelli di deep learning perché introducono non linearità, elemento vitale per permettere loro di apprendere relazioni e pattern complessi nei dati durante l'addestramento.
Altrimenti, apprenderebbero poco più che pattern di linearità dai dati applicando successive combinazioni lineari degli input, proprio come fanno i classici modelli di regressione lineare!
Funzione di attivazione all'interno di un neurone artificiale | Iván Palomares
Esempi di funzioni di attivazione popolari sono la logistica (logit), la tangente iperbolica (tanh) e la ReLU (rectified linear unit), come mostrato di seguito.
Esempi di funzioni di attivazione | Immagine di Aurelien Geron (O'Reilly)
2. Come valuteresti le prestazioni di un modello di deep learning?
Le prestazioni dei modelli di deep learning possono essere valutate utilizzando metriche comuni del machine learning, a seconda del compito.
Per la classificazione, considera metriche come accuratezza, precisione, richiamo, F1-score e Area Under the Curve (AUC). Per la regressione, invece, possiamo usare metriche d'errore come la Root Mean Square Error (RMSE).
Queste metriche dovrebbero essere utilizzate per confrontare le previsioni del modello con le etichette di verità a terra o con modelli baseline. Per modelli e applicazioni più avanzati, come l'NLP, esistono metriche specifiche per i vari compiti linguistici, come il punteggio BLEU per la traduzione, ROUGE per il riassunto, e così via.
3. Quali sono alcuni esempi di uso del deep learning nel business e nell'industria?
Il deep learning è utilizzato in un'ampia gamma di applicazioni reali, tra cui:
Domande di colloquio per l'ingegneria del deep learning
Le domande per un ruolo di deep learning con focus ingegneristico si concentreranno su aspetti come framework di programmazione, librerie e strumenti.
1. Come useresti TensorFlow per costruire una semplice rete neurale feedforward per la classificazione di immagini?
Per costruire una semplice rete neurale feed-forward per la classificazione di immagini in TensorFlow, si può iniziare definendo l'architettura del modello strato per strato usando la Sequential API di TensorFlow.
Ciò include specificare il numero appropriato di neuroni e le funzioni di attivazione per strato e definire lo strato finale (strato di output) con attivazione softmax.
Poi si compila il modello specificando una funzione di perdita adatta, come la categorical cross-entropy, un ottimizzatore come Adam e le metriche di validazione, prima di addestrarlo sui dati di training per un numero definito di epoche. Una volta costruito il modello, se ne può valutare la performance sul set di validazione.
TensorFlow è comunemente usato insieme all'API Keras, che potrai padroneggiare completando il corso Advanced Deep Learning with Keras.
2. Descrivi il tuo approccio per gestire l'overfitting in un modello di deep learning tramite tecniche di regolarizzazione in PyTorch
Per gestire l'overfitting in un modello di deep learning implementato con PyTorch, una strategia comune è incorporare tecniche di regolarizzazione come la regolarizzazione L1 o L2 con termini di penalità aggiunti alla funzione di perdita.
In alternativa, si possono introdurre strati di dropout per disattivare casualmente neuroni durante l'addestramento; questo impedisce al modello di fare eccessivo affidamento su caratteristiche specifiche estratte dai dati.
Queste due strategie possono essere combinate con l'early stopping per terminare l'addestramento quando le prestazioni in validazione iniziano a peggiorare.
Vuoi affinare le tue competenze in PyTorch? Allora dai un'occhiata al corso Introduction to Deep Learning in the PyTorch.
3. Facci un esempio di uso del transfer learning per mettere a punto un modello di deep learning pre-addestrato su un nuovo compito
VGG, BERT o ResNet sono esempi noti di modelli pre-addestrati che possono essere caricati per il transfer learning e il fine-tuning. In particolare, il processo prevede la sostituzione della model head, cioè lo strato finale di classificazione, con uno nuovo adatto al compito target.
Dopo questa piccola modifica strutturale all'architettura del modello, si procede a riaddestrarlo su un nuovo dataset utilizzando un learning rate basso per adattare i pesi del modello al nuovo compito, mantenendo per lo più le caratteristiche principali apprese in origine dai modelli pre-addestrati.
Domande di colloquio sul deep learning per la Computer Vision
Di seguito alcune possibili domande che l'intervistatore potrebbe farti per una posizione che prevede la creazione o la gestione di soluzioni di deep learning in computer vision, come le applicazioni di elaborazione delle immagini.
1. Spiega le reti neurali convoluzionali e applica il concetto a tre casi d'uso tipici.
Le CNN sono architetture di deep learning specializzate per l'elaborazione di dati visivi. La loro pila di strati convoluzionali e le operazioni sottostanti sui dati di immagine sono progettate per imitare la corteccia visiva dei cervelli animali.
Le CNN eccellono in compiti come classificazione di immagini, rilevamento di oggetti e segmentazione di immagini. Ecco una breve descrizione di caso d'uso per ciascuno di questi compiti:
2. Descrivi il ruolo degli strati di convoluzione e pooling nelle CNN
Gli strati di convoluzione nelle CNN sono responsabili dell'estrazione delle caratteristiche dalle immagini in input. Applicano un insieme di pesi apprendibili chiamati filtri o kernel per individuare pattern e caratteristiche come bordi, forme e texture insieme alle loro informazioni e relazioni spaziali, apprendendo così rappresentazioni visive gerarchiche.
Nel frattempo, gli strati di pooling effettuano il downsampling delle feature map (rappresentazioni intermedie dell'immagine) prodotte dagli strati convoluzionali. In altre parole, ne riducono la dimensione spaziale o risoluzione mantenendo comunque le informazioni importanti estratte.
Combinare successivi strati di convoluzione con strati di pooling in una CNN aiuta ad aumentare la robustezza alle variazioni negli input, riduce la complessità computazionale in fase di training e inferenza e contribuisce a prevenire problemi come l'overfitting.
3. Quali sono alcune sfide comuni dei modelli di deep learning addestrati per compiti di computer vision?
Tra le solite sfide e limitazioni dei modelli di deep learning, i seguenti esempi risultano particolarmente accentuati nei modelli per computer vision come le CNN:
Domande di colloquio sul deep learning per l'NLP
Ecco alcune possibili domande che l'intervistatore potrebbe farti per una posizione che prevede l'impiego di tecnologie di deep learning in applicazioni NLP.
1. In che modo i meccanismi di attenzione migliorano le prestazioni dei modelli di deep learning per compiti NLP?
I transformer sono una famiglia rivoluzionaria di architetture di deep learning e lo stato dell'arte attuale per affrontare un'ampia gamma di problemi NLP impegnativi. I meccanismi di attenzione sono fondamentali per le architetture transformer alla base dei Large Language Models (LLM) come BERT e GPT e sono in gran parte responsabili del loro successo.
I transformer hanno la capacità di catturare pattern complessi, informazioni contestuali e dipendenze a lungo raggio tra gli elementi di un testo in input, superando significativamente problemi riscontrati in soluzioni precedenti come la memoria limitata delle RNN (Recurrent Neural Networks).
I meccanismi di attenzione in sostanza pesano l'importanza di ogni token in una sequenza, senza la necessità di elaborarla token per token.
Questa componente cruciale dei transformer ha portato a progressi significativi in compiti come classificazione del testo, generazione del linguaggio e riassunto, e ha rivoluzionato l'area degli LLM e dell'IA nel suo complesso.
Il corso di Datacamp Introduction to LLMs in Python ti fornisce non solo competenze pratiche per costruire e sfruttare gli LLM, ma anche una solida comprensione dei concetti principali che riguardano gli LLM e le architetture transformer.
2. Cosa comportano il pre-training e il fine-tuning del modello per le architetture di deep learning e i dati nel contesto dell'NLP?
Il pre-training del modello addestra un modello di deep learning, come BERT per la classificazione del testo, su un ampio corpus di dati testuali (da milioni a miliardi di testi di esempio) per apprendere rappresentazioni linguistiche per la comprensione del linguaggio di uso generale.
Il fine-tuning del modello, invece, consiste nel prendere un modello pre-addestrato e mettere a punto i parametri appresi su una specifica applicazione NLP a valle, ad esempio l'analisi del sentiment delle recensioni di hotel.
Poiché il fine-tuning è in genere mirato a casi d'uso specifici, richiede l'uso di un piccolo dataset di esempi di testo etichettati e specifici del dominio, adattando così i pesi in parti del modello per apprendere le sfumature del compito target e migliorare le prestazioni del modello in quello specifico contesto, senza i costi computazionali e i requisiti di dati dell'addestramento da zero.
Esempio di pre-training del modello e fine-tuning di un LLM per il riassunto di articoli di chimica | Iván Palomares
3. Puoi descrivere l'architettura di un modello transformer come BERT e i tipi di compiti NLP che può affrontare?
L'architettura di BERT è una variante semplificata del transformer encoder-decoder originale, detta transformer solo-encoder.
L'architettura transformer originale, suddivisa in stack di encoder e decoder | Introduction to LLMs in Python (Iván Palomares)
Architettura transformer solo-encoder usata da modelli come BERT | Introduction to LLMs in Python (Iván Palomares)
Lo stack di encoder è costituito da più layer di encoder (vedi diagramma sopra). All'interno di ogni layer ci sono (sotto)strati di meccanismi di self-attention e reti neurali feedforward. La chiave del processo di comprensione del linguaggio svolto da BERT risiede nel flusso di attenzione bidirezionale applicato iterativamente nell'encoder, tale per cui le dipendenze tra le parole in una sequenza di input vengono catturate in entrambe le direzioni. Le connessioni neurali feedforward "mettono insieme" queste dipendenze apprese in pattern linguistici più complessi.
Oltre a questa caratteristica generale dei transformer solo-encoder, BERT si distingue per l'inclusione di un approccio di Masked Language Modelling (MLM). Questo meccanismo viene usato durante il pre-training per mascherare casualmente alcune parole, costringendo il modello a imparare a prevedere le parole mascherate in base alla comprensione del contesto che le circonda.
Domande di colloquio avanzate sul deep learning
Concludiamo con tre domande che potresti ricevere se ti candidi per un ruolo avanzato nel deep learning.
1. Come progetteresti e implementeresti un modello di deep learning per un problema con pochi dati etichettati?
La seguente strategia combinata può essere implementata per massimizzare le prestazioni del modello di deep learning quando ci si trova di fronte al comune problema di dati di training limitati:
2. Puoi elencare tre considerazioni importanti quando si distribuiscono modelli di deep learning su larga scala in ambienti di produzione reali?
Distribuire soluzioni di deep learning su larga scala in contesti di produzione richiede attenzione a diverse considerazioni, tra cui tre sono:
Altre considerazioni importanti per la messa in produzione di modelli di deep learning includono l'infrastruttura hardware e di rete, il monitoraggio del sistema e l'integrazione senza soluzione di continuità con i framework software esistenti.
3. Come immagini che i recenti progressi nel deep learning possano plasmare il futuro del campo in termini di applicazioni e impatto più ampio?
Le recenti scoperte nel deep learning hanno il potenziale di rimodellare profondamente numerose industrie e persino crearne di nuove.
I meccanismi di attenzione usati nelle architetture transformer alla base degli LLM stanno rivoluzionando il campo dell'NLP, spostando significativamente i confini dei compiti NLP e abilitando interazioni uomo-macchina più sofisticate attraverso soluzioni di AI conversazionale, question answering e molto altro. La recente inclusione della Retrieval Augmented Generation (RAG) sta ulteriormente aiutando gli LLM a produrre linguaggio veritiero e basato su evidenze.
Il reinforcement learning è una delle tendenze più promettenti dell'IA poiché i suoi principi imitano le basi dell'apprendimento umano. La sua integrazione con le architetture di deep learning, in particolare i modelli generativi come le generative adversarial networks, è all'avanguardia della ricerca accademica odierna. Big come OpenAI, Google e Microsoft combinano questi due domini dell'IA nelle loro più recenti soluzioni rivoluzionarie capaci di generare contenuti "quasi reali" in più formati.
Questi e altri progressi recenti hanno drasticamente democratizzato l'uso dell'IA da parte della società; pertanto è opportuno puntare l'attenzione su etica dell'IA, aspetti legali e regolamentazione come temi chiave su cui lavorare per garantire un impatto benefico delle soluzioni di deep learning nella società.
Per concludere
Per concludere questa panoramica delle domande comuni nei colloqui sul deep learning, un'osservazione ovvia è che la chiave del successo risiede in un mix di basi teoriche, solida padronanza delle abilità pratiche e aggiornamento costante sugli ultimi progressi.
Il deep learning non riguarda solo algoritmi, modelli e scelte di progettazione dell'architettura. Riguarda l'identificazione delle migliori soluzioni per risolvere problemi reali sui dati.
E l'apprendimento continuo è fondamentale. Datacamp offre un completo skill track Deep Learning in Python oltre a due percorsi orientati alle applicazioni di deep learning: image processing e natural language processing. Questi percorsi offrono una roadmap strutturata per migliorare le tue competenze di deep learning, assicurandoti la giusta preparazione per il prossimo colloquio.
Infine, consulta le sezioni finali di questo articolo sulle domande dei colloqui di machine learning se cerchi linee guida generali su come prepararti al tuo colloquio di deep learning. Poiché il deep learning è un sottoinsieme del machine learning, unire quelle linee guida generali alle 20 domande sul deep learning che abbiamo esaminato qui ti aiuterà sicuramente a prepararti.