作为一名为数据团队提供MLOps平台支持并参与设计可扩展基础设施的人,我亲眼见证了数据湖在当今数据技术栈中的关键作用。
与传统数据仓库不同,后者要求数据在入库前必须清洗并结构化,数据湖允许以原始、杂乱、非结构化的形式存储一切。这种灵活性为数据驱动的应用与用例打开了无限可能。数据湖让您能够将来自各类来源的数据集中到一个地方,以便进一步分析并用于人工智能。
在本文中,我将解释什么是数据湖、其工作机制、适用场景,以及它与更传统方案的对比。
理解数据湖的概念
在讨论技术架构或用例之前,首先需要弄清数据湖是什么,以及它与更传统的存储系统有何不同。
本节将定义这一概念,拆解其关键特性,并将其与更为结构化的数据仓库进行比较。
如果您想进一步了解优秀的数据战略如何助力企业,我推荐课程 Data Strategy。
数据湖的定义
数据湖是一个集中式存储库,可在任意规模下存储结构化、半结构化和非结构化数据。
您可以从各种来源摄取原始数据,并在需要处理或分析之前保持其原始格式不变。
与通常要求预定义模式(写时建模,schema-on-write)的数据库或数据仓库不同,数据湖采用读时建模(schema-on-read)方式。也就是说,只有在进行分析访问数据时才会应用结构,从而为团队在后续解释和转换数据时提供更大的灵活性。
核心特性
数据湖具备以下核心特性:
- 可扩展性:数据湖面向横向扩展设计。无论您存储的是 TB 级还是 PB 级数据,基于云的对象存储(如 Amazon S3 或 Azure Data Lake Storage)都能轻松扩容而无需担心容量。
- 读时建模(Schema-on-read):存储数据时无需定义模式。相反,数据科学家、分析师或工程师可在检索或转换时根据用例应用不同的模式。
- 原始数据存储:数据湖以原生格式保留各类数据,包括 CSV 文件、JSON 日志、音频、视频或传感器数据。
- 支持多样数据类型:您可以在同一位置存储结构化数据(如 SQL 表)、半结构化数据(如 XML、JSON)和非结构化数据(如图像、PDF、文本)。
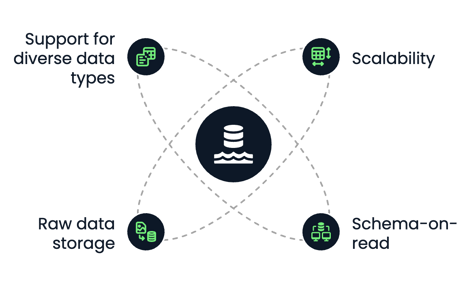
数据湖的核心特性。作者供图。
与数据仓库的比较
数据湖与数据仓库都用于存储和分析数据,但二者在结构、性能和用例方面存在显著差异。
如果您对数据仓库还不熟悉并想了解更多,我推荐课程 Data Warehousing Concepts 以及文章 What Is a Data Warehouse 和 Data Warehouse Architecture: Trends, Tools, and Techniques。
来看一下它们的不同之处:
|
Feature
|
Data Lake
|
Data Warehouse
|
|
Data type
|
Structured, semi-structured, unstructured
|
Structured only
|
|
Storage format
|
Raw (file objects)
|
Processed (tables, rows, columns)
|
|
Schema
|
Schema-on-read
|
Schema-on-write
|
|
Cost
|
Low-cost storage
|
More expensive per GB
|
|
Use case
|
Machine learning, big data, and raw data storage
|
Business intelligence, structured analytics
|
|
Performance
|
Flexible, depends on the compute engine
|
Optimized for fast SQL queries
|
在实践中,许多现代数据战略会将两者结合使用:用数据湖作为原始数据存储的基础,再用数据仓库进行结构化报表与商业智能。
此外,还有一种称为数据湖仓(data lakehouse)的混合方案。文章 What is a Data Lakehouse? Architecture, Technology & Use Cases 有更全面的说明。
数据湖架构的组成部分
良好的数据湖架构对于让原始数据可用于下游分析、机器学习与报表至关重要。
本节将分解现代数据湖的五大关键层,从数据摄取到治理。
数据摄取层
摄取层负责将来自各种来源的数据引入数据湖。这些来源包括内部系统(如数据库或 CRM)、外部 API、或物联网设备与日志。
三种主要摄取模式:
- 批处理摄取:定期(如每晚)批量加载数据。
- 流式摄取:实时数据流,如点击流或传感器数据。
- 混合摄取:批处理与流式结合,这是企业环境中的常见做法。
常见摄取工具包括:
- 用于流处理的 Apache Kafka 与 AWS Kinesis
- 用于批量 ETL 的 Apache NiFi、Flume,以及 AWS Glue
灵活的摄取层确保数据快速到达,并能处理多种格式与不同速度。
存储层
数据被摄取后,会存放在数据湖的原始区。存储层通常构建在云对象存储之上,具备弹性扩展、冗余与成本效益。
常见选项包括:
- Amazon S3
- Azure Data Lake Storage
- Google Cloud Storage
对于希望将数据存放在自家数据中心、私有云中的公司,也有对应方案。
例如,可以在自有基础设施中部署 MinIO。MinIO 本身为开源项目,并提供与 Amazon S3 兼容的 API。
存储层的关键特性包括:
- 持久性与可用性:数据会在多个区域自动复制。
- 存储与计算分离:您可以根据需求独立扩展计算能力。
- 数据分层:为归档数据提供冷存储,为高频访问数据提供热存储。
以原始格式存储数据,有助于保留其用于未来处理和分析的全部潜力。
目录与元数据管理
没有元数据,数据湖就会沦为“数据沼泽”,因为您将无法再次高效地找到并使用数据。
目录与元数据层通过记录以下信息为混乱带来秩序:
该层通过为所有可用数据集建立索引,并实现搜索与访问控制,来确保可发现性与可用性。常见工具包括:
- AWS Glue Data Catalog
- Apache Hive Metastore
- Apache Atlas
- DataHub
健全的元数据系统对于协作、治理与运营效率至关重要。
处理与分析层
在该层,原始数据被处理并转化为洞见。处理层支持从基础转换到高级分析与机器学习的多种操作。
典型流程包括:
该层通常同时包含批处理与实时计算,既支持探索性数据分析,也支持生产工作负载。
安全与治理
健壮的数据湖架构必须内置保护敏感数据与确保合规的机制。这一部分至关重要,因为数据湖通常包含大量敏感数据,一旦泄露,将对所属企业造成伤害。
该层的关键功能包括:
- 身份与访问管理(IAM):限制谁可以查看或修改数据。
- 加密:传输中(TLS)与静态存储的加密。
- 数据脱敏与匿名化:用于处理可识别个人身份的信息。
- 审计与监控:用于追溯与合规。
常用工具与服务:
- AWS Lake Formation
- Apache Ranger
- Azure Purview
安全往往决定数据湖能否用于金融、医疗或军工等受监管行业。
数据湖的常见用例
当规模、灵活性与多样数据类型至关重要时,数据湖尤其适用。它们是各行业现代数据驱动运营与应用的基础。
本节将探讨一些最常见且影响深远的用例,在这些场景中数据湖发挥着核心作用。
大数据分析
数据湖最广为人知的用途之一,是支持大规模数据分析。
由于数据湖可以存储原始形态的数据,组织无需在分析前对每个数据集进行清洗或结构化处理。这非常适合收集日志、传感器数据或点击流等传统系统难以承载或变化过快的数据。
数据湖让您能够:
- 同时分析历史数据与实时数据
- 在 PB 级数据集上运行自定义查询
- 以单一真实来源支持跨部门分析
像Amazon Athena 或 Google BigQuery 这样的工具可以直接在数据湖中查询数据,而无需复杂转换或将数据移至他处。
机器学习与人工智能
数据湖与机器学习和人工智能工作流高度契合。
它们为以下需求提供理想环境:
- 以多种格式存储训练数据集(如 CSV、Parquet、图像等)
- 保留更为完整的原始数据,便于更灵活地探索、试验并快速迭代机器学习模型
- 驱动可在海量数据上迭代的自动化 ML 流水线
与其将模型局限于仓库中预清洗的数据,数据科学家可以访问更丰富的原始数据,更自由地试验并更快迭代。这在自然语言处理(NLP)、计算机视觉与时间序列预测等领域尤为有用。
如果您想了解 Databricks 湖仓方案在 AI 中的应用,我推荐阅读 A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists。
集中式数据归档
许多组织将数据湖用于长期存储与归档。
得益于云对象存储的低成本,长期保存多年运营数据成为经济上可行的选择——这些数据或许不需要日常使用,但仍需为合规与审计、趋势分析、预测或未来 ML 模型训练所用。
大多数云对象存储方案支持存储分层,既可将很少访问的数据归档,又能保持数据湖精简高效。
数据科学试验
数据湖让数据科学家能够不受束缚地探索原始数据。
无论您是在构建快速原型、验证新假设,还是进行探索性数据分析(EDA),数据湖都能灵活地让您访问:
- 原始的非结构化数据(如 PDF、邮件、文本文件)
- 半结构化格式(如 JSON、XML 或日志)
- 传统数据库难以容纳的海量数据集
这一试验层对创新至关重要。数据湖让您以新方式探索数据集,而无需向数据工程团队提交工单,或等待仓库中的清洗版数据。
数据湖的优势与挑战
尽管数据湖为现代数据工作流提供了强大能力,但也伴随独特挑战。在采用数据湖架构之前,了解两方面内容至关重要。本节我将讨论主要优势、常见陷阱及其应对之道。
数据湖的优势
数据湖最大的优势在于其灵活性。您无需一开始就受制于特定的模式或数据模型,这在处理快速变化或不断演进的数据集时尤为出色。
主要优势包括:
- 可扩展性: 数据湖基于云原生存储构建,可轻松扩展,无论是 GB 级还是 PB 级存储需求。
- 支持所有数据类型:同一平台可存储结构化(SQL 表)、半结构化(JSON、XML)与非结构化(文本、图像、视频)数据。
- 成本效益:云对象存储(如 Amazon S3)的每 GB 成本显著低于传统数据库或仓库的存储。
- 解耦架构:计算与存储分离,可独立扩展分析工作负载而不受数据存储影响。
- 增强分析能力:数据湖存储原始、未处理的数据,支持更全面且灵活的分析,包括机器学习与预测分析。
- 改进决策制定:数据湖能够支持更深入、更全面的数据分析,从而在组织内形成更有依据的决策。
- 消除数据孤岛:数据湖通过整合各来源数据到集中存储库,帮助打破数据孤岛。
在我参与的项目中,这种集中化显著降低了数据孤岛,并大幅提升了跨团队协作。
关键挑战
数据湖功能强大,但也存在需要管理的关键挑战。如果放任不管,它们会很快变得杂乱无章、难以使用,即所谓“数据沼泽”。
常见挑战包括:
- 缺乏结构:没有预定义模式,数据可能难以查询、文档化或治理。
- 数据质量问题:由于以原始形式摄取,质量较差或不完整的数据可能直到下游才被发现。
- 元数据与可发现性缺口:缺少强大的编目系统,用户可能不知道有哪些数据或如何使用。
- 复杂的治理:在高度灵活的环境中,实施访问控制、审计与合规更为困难。
这些问题会削弱对数据湖的信任,并降低其在企业内部的采用率。
如何缓解这些挑战
最成功的数据湖通常具备强有力的元数据与生命周期管理实践。
以下做法可降低风险并保持数据湖健康:
- 实施数据目录:如 AWS Glue 或 DataHub 等工具有助于维护可发现性、模式定义与血缘追踪。
- 使用标准化命名与文件夹结构:建立一致性,减少团队困惑。
- 采用数据校验与画像工具:在摄取时保障质量,并定期复核数据。
- 自动化生命周期策略:根据保留期自动将过时数据转移至冷存储或删除。
- 实施稳健的访问控制与加密:通过 IAM 策略、基于角色的访问,以及静态与传输加密保护敏感数据。
通过从一开始就设计清晰的架构,并建立稳固的治理结构,数据湖就能始终作为资产而非负担。
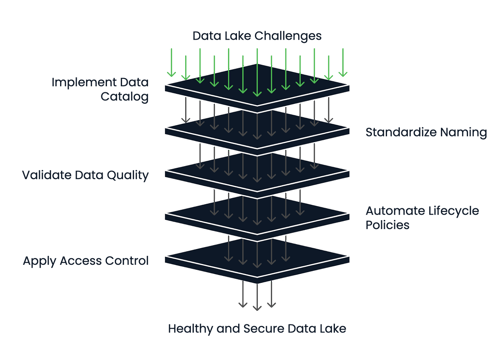
数据湖健康管理框架。作者供图。
主流数据湖技术
随着数据湖在现代数据架构中的重要性不断提升,围绕其构建与支持的技术也日益丰富。这些工具涵盖云原生平台、开源生态以及与分析方案的集成。接下来,我将介绍最流行的工具。
云原生方案
云服务商提供用于构建与维护数据湖的全托管服务。对于寻求规模、耐久性以及与其他云服务深度集成的团队而言,这些平台通常是起点。
常见云原生方案包括:
- Amazon S3 + AWS Lake Formation:S3 提供对象存储,Lake Formation 负责权限、编目与治理。
- Azure Data Lake Storage:将 Blob 存储与类 HDFS 能力结合。
- Google Cloud Storage(GCS):GCS 具有很高的持久性,并与 BigQuery、Vertex AI 在分析与 ML 工作负载方面深度集成。
这些服务在弹性、成本效率与安全性方面高度优化,非常适合企业级数据湖。
开源工具
开源技术具备更高的灵活性与可扩展性,尤其适合希望避免供应商锁定或运行于混合/多云环境的团队。
常见方案包括:
- Apache Hadoop:最早的数据湖框架之一。尽管如今在新项目中使用较少,但它为分布式数据存储与处理奠定了基础。
- Delta Lake:由 Databricks 开发,为云对象存储引入 ACID 事务、版本管理与模式约束。
- Apache Iceberg:提供原子操作、隐藏分区以及历史数据“时间穿梭”查询能力。
- Presto:分布式 SQL 查询引擎,可在不移动数据的情况下,对存储于 S3、HDFS 或其他来源的数据运行快速交互式查询。
这些工具常与更广泛的数据平台集成,适合构建自定义或模块化解决方案的工程团队。
如果您想更深入比较 Apache Iceberg 与 Delta Lake 的差异,我推荐阅读 Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases。
与分析平台的集成
当数据湖与分析与可视化工具集成,用以提炼洞见并推动业务决策时,其价值才能真正体现。因此,在选择最终方案之前,应提前确认数据湖需要与哪些分析平台进行集成。
常见分析平台包括:
- Databricks:将数据湖存储与数据工程、机器学习和分析的协作式工作区结合使用。原生支持 Delta Lake。
- Snowflake:尽管传统上是数据仓库,Snowflake 也可查询云存储中的外部数据(通过 Snowpipe 或外部表),成为一种混合湖仓方案。
- Power BI、Tableau:这些 BI 工具可直接连接数据湖,或通过 Athena、BigQuery 等查询引擎进行连接,以在原始或半结构化数据之上实现仪表板与报表。
如果您想进一步了解 Databricks,我推荐 Introduction to Databricks 课程。
在选择技术时,务必与您团队的专长、数据战略以及所需的灵活性或抽象层级保持一致。
结语
数据湖通过提供灵活、可扩展的原始与半结构化数据基础,助力组织构建强大的机器学习应用与实时仪表板。
本文介绍了数据湖的概念、关键组成部分及其适用场景;讨论了灵活性与可扩展性等优势,以及数据治理与“数据沼泽”风险等挑战,并说明了规避方法。最后,我们还涉及了构建数据湖的流行技术,包括云平台与开源工具。
基于我在 MLOps、AI 基础设施与云原生数据系统方面的工作经验,我见证了良好架构的数据湖如何改变团队协作与创新的方式。但我也见过治理不善的数据湖如何迅速变为负担,难以驾驭。
如果您的组织处理复杂、多样或大规模数据,并希望实现更快速的试验、更丰富的分析或推进 AI 开发,数据湖或许正是您所需要的。
如果您想进一步学习,Understanding Modern Data Architecture 课程是很好的起点。


作为一名为数据团队提供MLOps平台支持并参与设计可扩展基础设施的人,我亲眼见证了数据湖在当今数据技术栈中的关键作用。
与传统数据仓库不同,后者要求数据在入库前必须清洗并结构化,数据湖允许以原始、杂乱、非结构化的形式存储一切。这种灵活性为数据驱动的应用与用例打开了无限可能。数据湖让您能够将来自各类来源的数据集中到一个地方,以便进一步分析并用于人工智能。
在本文中,我将解释什么是数据湖、其工作机制、适用场景,以及它与更传统方案的对比。
理解数据湖的概念
在讨论技术架构或用例之前,首先需要弄清数据湖是什么,以及它与更传统的存储系统有何不同。
本节将定义这一概念,拆解其关键特性,并将其与更为结构化的数据仓库进行比较。
如果您想进一步了解优秀的数据战略如何助力企业,我推荐课程 Data Strategy。
数据湖的定义
数据湖是一个集中式存储库,可在任意规模下存储结构化、半结构化和非结构化数据。
您可以从各种来源摄取原始数据,并在需要处理或分析之前保持其原始格式不变。
与通常要求预定义模式(写时建模,schema-on-write)的数据库或数据仓库不同,数据湖采用读时建模(schema-on-read)方式。也就是说,只有在进行分析访问数据时才会应用结构,从而为团队在后续解释和转换数据时提供更大的灵活性。
核心特性
数据湖具备以下核心特性:
数据湖的核心特性。作者供图。
与数据仓库的比较
数据湖与数据仓库都用于存储和分析数据,但二者在结构、性能和用例方面存在显著差异。
如果您对数据仓库还不熟悉并想了解更多,我推荐课程 Data Warehousing Concepts 以及文章 What Is a Data Warehouse 和 Data Warehouse Architecture: Trends, Tools, and Techniques。
来看一下它们的不同之处:
Feature
Data Lake
Data Warehouse
Data type
Structured, semi-structured, unstructured
Structured only
Storage format
Raw (file objects)
Processed (tables, rows, columns)
Schema
Schema-on-read
Schema-on-write
Cost
Low-cost storage
More expensive per GB
Use case
Machine learning, big data, and raw data storage
Business intelligence, structured analytics
Performance
Flexible, depends on the compute engine
Optimized for fast SQL queries
在实践中,许多现代数据战略会将两者结合使用:用数据湖作为原始数据存储的基础,再用数据仓库进行结构化报表与商业智能。
此外,还有一种称为数据湖仓(data lakehouse)的混合方案。文章 What is a Data Lakehouse? Architecture, Technology & Use Cases 有更全面的说明。
数据湖架构的组成部分
良好的数据湖架构对于让原始数据可用于下游分析、机器学习与报表至关重要。
本节将分解现代数据湖的五大关键层,从数据摄取到治理。
数据摄取层
摄取层负责将来自各种来源的数据引入数据湖。这些来源包括内部系统(如数据库或 CRM)、外部 API、或物联网设备与日志。
三种主要摄取模式:
常见摄取工具包括:
灵活的摄取层确保数据快速到达,并能处理多种格式与不同速度。
存储层
数据被摄取后,会存放在数据湖的原始区。存储层通常构建在云对象存储之上,具备弹性扩展、冗余与成本效益。
常见选项包括:
对于希望将数据存放在自家数据中心、私有云中的公司,也有对应方案。
例如,可以在自有基础设施中部署 MinIO。MinIO 本身为开源项目,并提供与 Amazon S3 兼容的 API。
存储层的关键特性包括:
以原始格式存储数据,有助于保留其用于未来处理和分析的全部潜力。
目录与元数据管理
没有元数据,数据湖就会沦为“数据沼泽”,因为您将无法再次高效地找到并使用数据。
目录与元数据层通过记录以下信息为混乱带来秩序:
该层通过为所有可用数据集建立索引,并实现搜索与访问控制,来确保可发现性与可用性。常见工具包括:
健全的元数据系统对于协作、治理与运营效率至关重要。
处理与分析层
在该层,原始数据被处理并转化为洞见。处理层支持从基础转换到高级分析与机器学习的多种操作。
典型流程包括:
该层通常同时包含批处理与实时计算,既支持探索性数据分析,也支持生产工作负载。
安全与治理
健壮的数据湖架构必须内置保护敏感数据与确保合规的机制。这一部分至关重要,因为数据湖通常包含大量敏感数据,一旦泄露,将对所属企业造成伤害。
该层的关键功能包括:
常用工具与服务:
安全往往决定数据湖能否用于金融、医疗或军工等受监管行业。
数据湖的常见用例
当规模、灵活性与多样数据类型至关重要时,数据湖尤其适用。它们是各行业现代数据驱动运营与应用的基础。
本节将探讨一些最常见且影响深远的用例,在这些场景中数据湖发挥着核心作用。
大数据分析
数据湖最广为人知的用途之一,是支持大规模数据分析。
由于数据湖可以存储原始形态的数据,组织无需在分析前对每个数据集进行清洗或结构化处理。这非常适合收集日志、传感器数据或点击流等传统系统难以承载或变化过快的数据。
数据湖让您能够:
像Amazon Athena 或 Google BigQuery 这样的工具可以直接在数据湖中查询数据,而无需复杂转换或将数据移至他处。
机器学习与人工智能
数据湖与机器学习和人工智能工作流高度契合。
它们为以下需求提供理想环境:
与其将模型局限于仓库中预清洗的数据,数据科学家可以访问更丰富的原始数据,更自由地试验并更快迭代。这在自然语言处理(NLP)、计算机视觉与时间序列预测等领域尤为有用。
如果您想了解 Databricks 湖仓方案在 AI 中的应用,我推荐阅读 A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists。
集中式数据归档
许多组织将数据湖用于长期存储与归档。
得益于云对象存储的低成本,长期保存多年运营数据成为经济上可行的选择——这些数据或许不需要日常使用,但仍需为合规与审计、趋势分析、预测或未来 ML 模型训练所用。
大多数云对象存储方案支持存储分层,既可将很少访问的数据归档,又能保持数据湖精简高效。
数据科学试验
数据湖让数据科学家能够不受束缚地探索原始数据。
无论您是在构建快速原型、验证新假设,还是进行探索性数据分析(EDA),数据湖都能灵活地让您访问:
这一试验层对创新至关重要。数据湖让您以新方式探索数据集,而无需向数据工程团队提交工单,或等待仓库中的清洗版数据。
数据湖的优势与挑战
尽管数据湖为现代数据工作流提供了强大能力,但也伴随独特挑战。在采用数据湖架构之前,了解两方面内容至关重要。本节我将讨论主要优势、常见陷阱及其应对之道。
数据湖的优势
数据湖最大的优势在于其灵活性。您无需一开始就受制于特定的模式或数据模型,这在处理快速变化或不断演进的数据集时尤为出色。
主要优势包括:
在我参与的项目中,这种集中化显著降低了数据孤岛,并大幅提升了跨团队协作。
关键挑战
数据湖功能强大,但也存在需要管理的关键挑战。如果放任不管,它们会很快变得杂乱无章、难以使用,即所谓“数据沼泽”。
常见挑战包括:
这些问题会削弱对数据湖的信任,并降低其在企业内部的采用率。
如何缓解这些挑战
最成功的数据湖通常具备强有力的元数据与生命周期管理实践。
以下做法可降低风险并保持数据湖健康:
通过从一开始就设计清晰的架构,并建立稳固的治理结构,数据湖就能始终作为资产而非负担。
数据湖健康管理框架。作者供图。
主流数据湖技术
随着数据湖在现代数据架构中的重要性不断提升,围绕其构建与支持的技术也日益丰富。这些工具涵盖云原生平台、开源生态以及与分析方案的集成。接下来,我将介绍最流行的工具。
云原生方案
云服务商提供用于构建与维护数据湖的全托管服务。对于寻求规模、耐久性以及与其他云服务深度集成的团队而言,这些平台通常是起点。
常见云原生方案包括:
这些服务在弹性、成本效率与安全性方面高度优化,非常适合企业级数据湖。
开源工具
开源技术具备更高的灵活性与可扩展性,尤其适合希望避免供应商锁定或运行于混合/多云环境的团队。
常见方案包括:
这些工具常与更广泛的数据平台集成,适合构建自定义或模块化解决方案的工程团队。
如果您想更深入比较 Apache Iceberg 与 Delta Lake 的差异,我推荐阅读 Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases。
与分析平台的集成
当数据湖与分析与可视化工具集成,用以提炼洞见并推动业务决策时,其价值才能真正体现。因此,在选择最终方案之前,应提前确认数据湖需要与哪些分析平台进行集成。
常见分析平台包括:
如果您想进一步了解 Databricks,我推荐 Introduction to Databricks 课程。
在选择技术时,务必与您团队的专长、数据战略以及所需的灵活性或抽象层级保持一致。
结语
数据湖通过提供灵活、可扩展的原始与半结构化数据基础,助力组织构建强大的机器学习应用与实时仪表板。
本文介绍了数据湖的概念、关键组成部分及其适用场景;讨论了灵活性与可扩展性等优势,以及数据治理与“数据沼泽”风险等挑战,并说明了规避方法。最后,我们还涉及了构建数据湖的流行技术,包括云平台与开源工具。
基于我在 MLOps、AI 基础设施与云原生数据系统方面的工作经验,我见证了良好架构的数据湖如何改变团队协作与创新的方式。但我也见过治理不善的数据湖如何迅速变为负担,难以驾驭。
如果您的组织处理复杂、多样或大规模数据,并希望实现更快速的试验、更丰富的分析或推进 AI 开发,数据湖或许正是您所需要的。
如果您想进一步学习,Understanding Modern Data Architecture 课程是很好的起点。