Als iemand die datateams heeft ondersteund met MLOps-platfforms en hielp bij het ontwerpen van schaalbare infrastructuren, heb ik uit eerste hand gezien hoe cruciaal data lakes zijn in de huidige datastack.
In tegenstelling tot traditionele datawarehouses, die vereisen dat data schoon en gestructureerd is vóór opslag, kun je in data lakes alles opslaan in ruwe, rommelige en ongestructureerde formaten. Die flexibiliteit opent een wereld aan mogelijkheden voor datagedreven applicaties en use cases. Een data lake stelt je in staat data uit diverse bronnen te verzamelen en op één plek op te slaan, waar het verder kan worden geanalyseerd en gebruikt voor AI.
In dit artikel leg ik uit wat een data lake is, hoe het werkt, wanneer je het gebruikt en hoe het zich verhoudt tot meer traditionele oplossingen.
Het concept van een data lake begrijpen
Voordat we de technische architectuur of use cases bespreken, is het essentieel om te begrijpen wat een data lake is en wat het onderscheidt van meer traditionele opslagsystemen.
Deze sectie definieert het concept, licht de belangrijkste kenmerken toe en vergelijkt het met de meer gestructureerde wereld van datawarehouses.
Ik raad de cursus Data Strategy aan als je meer wilt leren over hoe een goed doordachte datastrategie bedrijven kan helpen.
Definitie van een data lake
Een data lake is een centrale opslagplaats die al je gestructureerde, semigestructureerde en ongestructureerde data op elke schaal opslaat.
Je kunt ruwe data uit verschillende bronnen binnenhalen en die in het originele formaat bewaren totdat je ze moet verwerken of analyseren.
In tegenstelling tot databases of datawarehouses, die doorgaans een vooraf gedefinieerd schema vereisen (schema-on-write), gebruiken data lakes een schema-on-read-benadering. Dit betekent dat de structuur pas wordt toegepast wanneer de data voor analyse wordt benaderd, waardoor teams later flexibel zijn in het interpreteren en transformeren van de data.
Kernkenmerken
Een data lake heeft de volgende kernkenmerken:
- Schaalbaarheid: Data lakes zijn gebouwd om horizontaal te schalen. Of je nu terabytes of petabytes aan data opslaat, cloudgebaseerde objectopslag zoals Amazon S3 of Azure Data Lake Storage maakt groeien eenvoudig zonder je zorgen te maken over capaciteit.
- Schema-on-read: Je hoeft het schema niet te definiëren wanneer je de data opslaat. In plaats daarvan kunnen data scientists, analisten of engineers verschillende schema’s toepassen afhankelijk van de use case bij het ophalen of transformeren.
- Opslag van ruwe data: Data lakes behouden alle datatypen in hun oorspronkelijke formaat, of het nu CSV-bestanden, JSON-logs, audiobestanden, video’s of sensordata zijn.
- Ondersteuning voor diverse datatypen: Je kunt gestructureerde (bijv. SQL-tabellen), semigestructureerde (bijv. XML, JSON) en ongestructureerde data (bijv. afbeeldingen, pdf’s, tekst) op één plek opslaan.
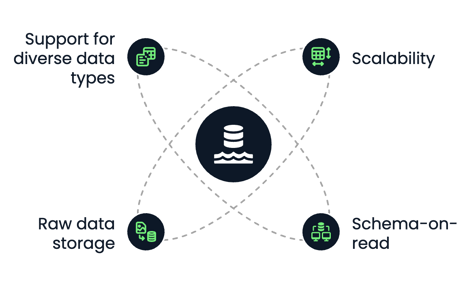
Kernkenmerken van data lakes. Afbeelding door de auteur.
Vergelijking met datawarehouses
Data lakes en datawarehouses worden gebruikt om data op te slaan en te analyseren. Toch verschillen ze aanzienlijk in structuur, prestaties en use cases.
Als je nieuw bent met datawarehouses en meer wilt leren, raad ik de cursus Data Warehousing Concepts en de artikelen What Is a Data Warehouse en Data Warehouse Architecture: Trends, Tools, and Techniques aan.
Laten we zien hoe ze verschillen:
|
Kenmerk
|
Data lake
|
Datawarehouse
|
|
Datatype
|
Gestructureerd, semigestructureerd, ongestructureerd
|
Alleen gestructureerd
|
|
Opslagformaat
|
Ruw (bestandsobjecten)
|
Verwerkt (tabellen, rijen, kolommen)
|
|
Schema
|
Schema-on-read
|
Schema-on-write
|
|
Kosten
|
Goedkope opslag
|
Duurder per GB
|
|
Use case
|
Machine learning, big data en opslag van ruwe data
|
Business intelligence, gestructureerde analytics
|
|
Prestaties
|
Flexibel, afhankelijk van de compute-engine
|
Geoptimaliseerd voor snelle SQL-queries
|
In de praktijk combineren veel moderne datastrategieën beide: data lakes als basis voor opslag van ruwe data en datawarehouses voor gestructureerde rapportage en business intelligence.
Er is ook een hybride oplossing, een data lakehouse. Het artikel What is a Data Lakehouse? Architecture, Technology & Use Cases legt dit uitgebreider uit.
Componenten van een data lake-architectuur
Een goed ontworpen data lake-architectuur is essentieel om ruwe data bruikbaar en toegankelijk te maken voor downstream analytics, machine learning en rapportage.
Deze sectie splitst de vijf belangrijkste lagen van een modern data lake uit, van intake tot governance.
Data-ingestielaag
De ingestielaag haalt data uit verschillende bronnen het data lake in. Dit kunnen interne systemen zijn (zoals databases of CRM’s), externe API’s of IoT-apparaten en logs.
Er zijn drie hoofdmodi voor ingestie:
- Batch-ingestie: Data periodiek (zoals ’s nachts) in batches laden.
- Stream-ingestie: Real-time datastromen, zoals clickstream- of sensordata.
- Hybride ingestie: Een combinatie van batch en stream, wat veel voorkomt in enterprise-omgevingen.
Gangbare ingestietools zijn onder meer:
- Apache Kafka en AWS Kinesis voor streaming
- Apache NiFi, Flume, en AWS Glue voor batch-ETL
Een flexibele ingestielaag zorgt ervoor dat data snel binnenkomt en een verscheidenheid aan formaten en snelheden aankan.
Opslaglaag
Wanneer data is binnengehaald, wordt die opgeslagen in de ruwe zone van het data lake. De opslaglaag is meestal gebaseerd op cloudobjectopslag, die elastische schaalbaarheid, redundantie en kostenefficiëntie biedt.
Populaire opties zijn:
- Amazon S3
- Azure Data Lake Storage
- Google Cloud Storage
Er zijn echter ook opties voor bedrijven die hun data in hun on-premise clouds willen opslaan die in hun datacenters worden gehost.
Zo kun je bijvoorbeeld MinIO in je infrastructuur installeren. MinIO zelf is open-source en biedt een Amazon S3-compatibele API.
Belangrijke functies van een opslaglaag zijn:
- Duurzaamheid en beschikbaarheid: Data wordt automatisch over regio’s gerepliceerd.
- Scheiding van opslag en compute: Je kunt compute onafhankelijk opschalen op basis van de vraag.
- Data-tiering: Biedt cold storage voor archivering en hot storage voor vaak geraadpleegde data.
Data in het oorspronkelijke formaat opslaan betekent dat je alle potentie bewaart voor toekomstige verwerking en analyse.
Zonder metadata verandert een data lake in een data swamp, omdat het onmogelijk is je data terug te vinden en er efficiënt mee te werken.
De catalogus- en metadata-laag brengt structuur in de chaos door het bijhouden van:
- Dataschema
- Datalocatie en partitionering
- Herkomst en versiebeheer
Deze laag zorgt voor vindbaarheid en bruikbaarheid door alle beschikbare datasets te indexeren en zoek- en toegangscontrole mogelijk te maken. Standaardtools voor deze laag zijn onder meer:
- AWS Glue Data Catalog
- Apache Hive Metastore
- Apache Atlas
- DataHub
Een degelijk metadatasysteem is essentieel voor samenwerking, governance en operationele efficiëntie.
Verwerkings- en analytilaag
Dit is de laag waar ruwe data wordt verwerkt en omgezet in inzichten. De verwerkingslaag ondersteunt uiteenlopende operaties, van basistransformaties tot geavanceerde analytics en machine learning.
Typische workflows omvatten:
- ETL/ELT-pijplijnen voor datacleaning en normalisatie
- SQL-querying
- Machine learning-pijplijnen
Deze laag omvat vaak batch- en realtimecomputing en maakt zowel exploratieve data-analyse als productie-workloads mogelijk.
Beveiliging en governance
Een robuuste data lake-architectuur moet ingebouwde mechanismen hebben om gevoelige data te beschermen en compliance te waarborgen. Dit onderdeel is cruciaal, omdat data lakes meestal veel gevoelige data bevatten die, wanneer gecompromitteerd, het bedrijf kan schaden waartoe ze behoren.
Essentiële functies van die laag zijn onder meer:
- Identity and Access Management (IAM): Beperk wie data kan zien of wijzigen.
- Versleuteling: Versleuteling tijdens transport (TLS) en in rust.
- Datamasking en anonimisatie: Voor het omgaan met persoonsgegevens.
- Audit en monitoring: Voor traceerbaarheid en compliance.
Populaire tools en services:
- AWS Lake Formation
- Apache Ranger
- Azure Purview
Beveiliging bepaalt vaak of een data lake kan worden gebruikt in gereguleerde sectoren zoals financiën, gezondheidszorg of het leger.
Veelvoorkomende use cases voor data lakes
Data lakes zijn zeer geschikt voor use cases waarin schaal, flexibiliteit en diverse datatypen essentieel zijn. Ze vormen de basis voor moderne datagedreven operaties en applicaties in allerlei sectoren.
In deze sectie verkennen we enkele van de meest voorkomende en impactvolle use cases waarin data lakes een centrale rol spelen.
Big data-analytics
Een van de bekendste toepassingen van data lakes is het mogelijk maken van grootschalige data-analyse.
Omdat data lakes data in ruwe vorm kunnen opslaan, hoeven organisaties niet elk dataset vooraf te schonen of te structureren voor analyse. Dit is ideaal bij het verzamelen van logs, sensordata of clickstreams, die te groot of te snel veranderend zijn voor traditionele systemen.
Data lakes maken het mogelijk om:
- Historische data naast realtime data te analyseren
- Aangepaste queries uit te voeren op datasets op petabyteschaal
- Cross-functionele analytics mogelijk te maken met één bron van waarheid
Tools zoals Amazon Athena of Google BigQuery kunnen data direct in het lake bevragen zonder complexe transformaties of het verplaatsen van data.
Machine learning en AI
Data lakes passen perfect bij workflows voor machine learning en AI.
Ze bieden de ideale omgeving voor:
- Het opslaan van trainingsdatasets in meerdere formaten (bijv. CSV, Parquet, afbeeldingen, enz.)
- Het bewaren van ruwe en dus meer volledige data, wat meer flexibiliteit biedt bij het verkennen, experimenteren en itereren op ML-modellen
- Het aandrijven van geautomatiseerde ML-pijplijnen die over enorme hoeveelheden data itereren
In plaats van modellen te beperken tot vooraf opgeschoonde data uit een warehouse, kunnen data scientists rijke, ruwe data gebruiken om vrijer te experimenteren en sneller te itereren. Dit is vooral nuttig in domeinen zoals natural language processing (NLP), computervisie en tijdreeksvoorspelling.
Als je een voorbeeld wilt van hoe de Databricks Lakehouse-oplossing voor AI kan worden gebruikt, raad ik aan om A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists te lezen.
Gecentraliseerde data-archivering
Veel organisaties gebruiken data lakes voor langdurige opslag en archivering.
Dankzij de lage kosten van cloudobjectopslag is het economisch haalbaar om jarenlang operationele data op te slaan die misschien niet dagelijks wordt gebruikt, maar wel toegankelijk moet blijven voor compliance- en auditdoeleinden, trendanalyse, forecasting of het trainen van toekomstige ML-modellen.
De meeste cloudobjectopslagoplossingen stellen je in staat opslag te tieren om zelden geraadpleegde data te archiveren en het lake slank en efficiënt te houden.
Data science-experimentatie
Data lakes geven data scientists de ruimte om ruwe data zonder beperkingen te verkennen.
Of je nu snel een prototype bouwt, een nieuwe hypothese test of exploratieve data-analyse (EDA) uitvoert, het lake geeft je flexibele toegang tot:
- Ruwe ongestructureerde data (zoals pdf’s, e-mails, tekstbestanden)
- Semigestructureerde formaten (zoals JSON, XML of logs)
- Enorme datasets die niet in een traditionele DB zouden passen
Deze experimenteerlaag is essentieel voor innovatie. Data lakes laten je datasets op nieuwe manieren verkennen zonder tickets in te dienen bij het data engineering-team of te wachten op een opgeschoonde versie in het warehouse.
Voordelen en uitdagingen van data lakes
Hoewel data lakes krachtige mogelijkheden bieden voor moderne dataworkflows, kennen ze ook specifieke uitdagingen. Beide kanten begrijpen is essentieel voordat je een data lake-architectuur adopteert. In deze sectie bespreek ik de belangrijkste voordelen, veelvoorkomende valkuilen en hoe je die overwint.
Voordelen van data lakes
Het grootste voordeel van een data lake is de flexibiliteit. Je zit niet vanaf het begin vast aan een specifiek schema of datamodel, wat ideaal is bij snel veranderende of evoluerende datasets.
Hier zijn enkele belangrijke voordelen:
- Schaalbaarheid: Data lakes zijn gebouwd op cloud-native opslag die moeiteloos schaalt, of je nu gigabytes of petabytes opslaat.
- Ondersteuning voor alle datatypen: Gestructureerde (SQL-tabellen), semigestructureerde (JSON, XML) en ongestructureerde (tekst, afbeeldingen, video) data kunnen op hetzelfde platform worden opgeslagen.
- Kostenefficiëntie: Cloudobjectopslag (bijv. Amazon S3) is aanzienlijk goedkoper dan de opslag die door traditionele databases of warehouses wordt gebruikt.
- Losjes gekoppelde architectuur: Compute en opslag zijn gescheiden, zodat je analytische workloads onafhankelijk van de dataopslag kunt schalen.
- Verbeterde analytics: Data lakes slaan ruwe, onbewerkte data op en maken meer uitgebreide en flexibele data-analyse mogelijk, inclusief machine learning en voorspellende analytics.
- Betere besluitvorming: Data lakes kunnen diepgaandere en completere data-analyse mogelijk maken, wat leidt tot beter onderbouwde beslissingen in de hele organisatie.
- Afschaffen van datasilo’s: Data lakes helpen datasilo’s af te breken door data uit verschillende bronnen te consolideren in één centrale opslagplaats.
In projecten waar ik aan heb gewerkt, heeft deze centralisatie datasilo’s verminderd en de samenwerking tussen teams aanzienlijk verbeterd.
Belangrijkste uitdagingen
Data lakes zijn krachtig, maar er zijn enkele belangrijke uitdagingen die moeten worden beheerd. Zonder beheer raken ze snel ongeorganiseerd en onbruikbaar, een staat die vaak een data swamp wordt genoemd.
Enkele veelvoorkomende uitdagingen zijn:
- Gebrek aan structuur: Zonder vooraf gedefinieerde schema’s kan data lastig te bevragen, documenteren of besturen zijn.
- Datakwaliteitsproblemen: Omdat data in ruwe vorm wordt binnengehaald, kan data van slechte kwaliteit of onvolledige data onopgemerkt blijven tot downstream.
- Hiaten in metadata en vindbaarheid: Zonder een sterk catalogiseringssysteem weten gebruikers misschien niet welke data er is of hoe die te gebruiken.
- Complexe governance: Toegangscontrole, auditability en compliance borgen is lastiger in een flexibele omgeving.
Deze problemen kunnen het vertrouwen in het data lake verminderen en de adoptie binnen het bedrijf remmen.
Hoe de uitdagingen te beperken
De meest succesvolle data lakes hebben sterk metadata- en levenscyclusbeheer.
Zo verklein je risico’s en houd je je data lake gezond:
- Implementeer een datacatalogus: Tools zoals AWS Glue of DataHub helpen vindbaarheid, schemadefinities en herkomsttracking te behouden.
- Gebruik gestandaardiseerde naamgeving en mapstructuren: Dit creëert consistentie en vermindert verwarring bij teams.
- Pas tools voor datavalidatie en -profilering toe: Borg kwaliteit tijdens ingestie en valideer periodiek opnieuw.
- Automatiseer lifecycle-beleid: Verplaats verouderde data automatisch naar cold storage of verwijder die na een gedefinieerde bewaartermijn.
- Hanteer robuuste toegangscontrole en versleuteling: Gebruik IAM-beleid, rolgebaseerde toegang en versleuteling in rust en tijdens transport om gevoelige data te beschermen.
Een data lake kan een asset blijven en geen liability worden door vanaf het begin een schone architectuur te ontwerpen en stevige governancestructuren op te zetten.
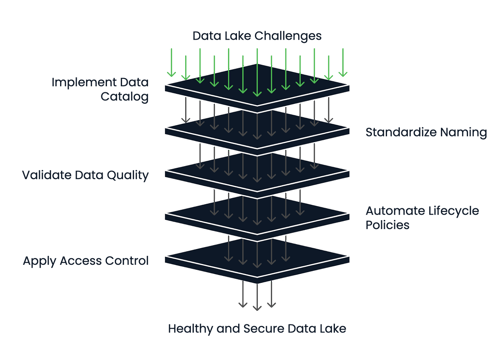
Framework voor beheer van de gezondheid van data lakes. Afbeelding door de auteur.
Populaire data lake-technologieën
Met het groeiende belang van data lakes in moderne data-architectuur is er een breed scala aan technologieën ontstaan om ze te ondersteunen. Deze tools beslaan cloud-native platforms, open-source ecosystemen en integraties met analytics-oplossingen. In deze sectie neem ik je mee langs de populairste tools.
Cloud-native oplossingen
Cloudproviders bieden volledig beheerde services voor het bouwen en onderhouden van data lakes. Deze platforms zijn vaak het startpunt voor teams die schaal, duurzaamheid en nauwe integratie met andere clouddiensten zoeken.
Populaire cloud-native oplossingen zijn onder meer:
- Amazon S3 + AWS Lake Formation: S3 biedt objectopslag, terwijl Lake Formation permissies, catalogisering en governance afhandelt.
- Azure Data Lake Storage: Combineert blobopslag met HDFS-achtige mogelijkheden.
- Google Cloud Storage (GCS): GCS is zeer duurzaam en integreert goed met BigQuery en Vertex AI voor analytics- en ML-workloads.
Deze services zijn geoptimaliseerd voor elasticiteit, kostenefficiëntie en beveiliging, waardoor ze ideaal zijn voor data lakes op enterpriseniveau.
Open-sourcetechnologieën bieden flexibiliteit en uitbreidbaarheid, vooral voor teams die vendor lock-in willen vermijden of in hybride/multi-cloudomgevingen opereren.
Populaire oplossingen zijn onder meer:
- Apache Hadoop: Een van de oorspronkelijke data lake-frameworks. Hoewel minder gebruikelijk voor nieuwe projecten, legde het de basis voor gedistribueerde dataopslag en -verwerking.
- Delta Lake: Ontwikkeld door Databricks, voegt Delta Lake ACID-transacties, versiebeheer en schemahandhaving toe aan cloudobjectopslag.
- Apache Iceberg: Iceberg biedt atomaire operaties, verborgen partitionering en time travel voor het bevragen van historische data.
- Presto: Een gedistribueerde SQL-queryengine waarmee je snelle, interactieve queries kunt uitvoeren op data in S3, HDFS of andere bronnen zonder de data te verplaatsen.
Deze tools integreren vaak in bredere dataplatforms en zijn favoriet bij engineeringteams die op maat gemaakte of modulaire oplossingen bouwen.
Als je de verschillen tussen Apache Iceberg en Delta Lake gedetailleerder wilt verkennen, raad ik aan om Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases te lezen.
Een data lake wordt waardevol wanneer het is geïntegreerd met analytics- en visualisatietools die helpen inzichten te halen en zakelijke beslissingen te sturen. Controleer daarom vóór de definitieve selectie altijd vooraf met welke analytics-platforms de data lake-oplossing moet integreren.
Populaire analytics-platforms zijn onder meer:
- Databricks: Combineert data lake-opslag met een samenwerkingsruimte voor data engineering, machine learning en analytics. Het ondersteunt Delta Lake out of the box.
- Snowflake: Hoewel traditioneel een datawarehouse, kan Snowflake externe data in cloudopslag bevragen (via Snowpipe of externe tabellen), waardoor het een hybride lakehouse-oplossing is.
- Power BI, Tableau: Deze BI-tools kunnen verbinding maken met data lakes, direct of via query-engines zoals Athena of BigQuery, en zo dashboards en rapportages bovenop ruwe of semigestructureerde data mogelijk maken.
Als je meer wilt leren over Databricks, raad ik de cursus Introduction to Databricks aan.
Bij het kiezen van technologieën is het essentieel ze af te stemmen op de expertise van je team, je datastrategie en het niveau van flexibiliteit of abstractie dat je nodig hebt.
Conclusie
Data lakes stellen organisaties in staat robuuste machine learning-applicaties en realtime dashboards te bouwen door een flexibele, schaalbare basis van ruwe en semigestructureerde data te bieden.
In dit artikel hebben we besproken wat een data lake is, de belangrijkste componenten en wanneer je er een gebruikt. We bespraken voordelen zoals flexibiliteit en schaalbaarheid, uitdagingen zoals datagovernance en het risico op een "data swamp", en hoe je die voorkomt. Tot slot bespraken we populaire technologieën voor het bouwen van data lakes, waaronder cloudplatforms en open-sourcetools.
Uit mijn ervaring met MLOps, AI-infrastructuur en cloud-native datasystemen heb ik gezien hoe een goed gearticuleerd data lake de manier waarop teams samenwerken en innoveren kan transformeren. Maar ik heb ook gezien hoe snel een slecht bestuurd data lake een liability kan worden, en hoe lastig het kan zijn om erdoorheen te navigeren.
Als je organisatie met complexe, diverse of grootschalige data werkt en snellere experimentatie, rijkere analytics of AI-ontwikkeling wil mogelijk maken, dan is een data lake misschien precies wat je nodig hebt.
De cursus Understanding Modern Data Architecture is een uitstekend eerste vertrekpunt als je meer wilt leren.




Als iemand die datateams heeft ondersteund met MLOps-platfforms en hielp bij het ontwerpen van schaalbare infrastructuren, heb ik uit eerste hand gezien hoe cruciaal data lakes zijn in de huidige datastack.
In tegenstelling tot traditionele datawarehouses, die vereisen dat data schoon en gestructureerd is vóór opslag, kun je in data lakes alles opslaan in ruwe, rommelige en ongestructureerde formaten. Die flexibiliteit opent een wereld aan mogelijkheden voor datagedreven applicaties en use cases. Een data lake stelt je in staat data uit diverse bronnen te verzamelen en op één plek op te slaan, waar het verder kan worden geanalyseerd en gebruikt voor AI.
In dit artikel leg ik uit wat een data lake is, hoe het werkt, wanneer je het gebruikt en hoe het zich verhoudt tot meer traditionele oplossingen.
Het concept van een data lake begrijpen
Voordat we de technische architectuur of use cases bespreken, is het essentieel om te begrijpen wat een data lake is en wat het onderscheidt van meer traditionele opslagsystemen.
Deze sectie definieert het concept, licht de belangrijkste kenmerken toe en vergelijkt het met de meer gestructureerde wereld van datawarehouses.
Ik raad de cursus Data Strategy aan als je meer wilt leren over hoe een goed doordachte datastrategie bedrijven kan helpen.
Definitie van een data lake
Een data lake is een centrale opslagplaats die al je gestructureerde, semigestructureerde en ongestructureerde data op elke schaal opslaat.
Je kunt ruwe data uit verschillende bronnen binnenhalen en die in het originele formaat bewaren totdat je ze moet verwerken of analyseren.
In tegenstelling tot databases of datawarehouses, die doorgaans een vooraf gedefinieerd schema vereisen (schema-on-write), gebruiken data lakes een schema-on-read-benadering. Dit betekent dat de structuur pas wordt toegepast wanneer de data voor analyse wordt benaderd, waardoor teams later flexibel zijn in het interpreteren en transformeren van de data.
Kernkenmerken
Een data lake heeft de volgende kernkenmerken:
Kernkenmerken van data lakes. Afbeelding door de auteur.
Vergelijking met datawarehouses
Data lakes en datawarehouses worden gebruikt om data op te slaan en te analyseren. Toch verschillen ze aanzienlijk in structuur, prestaties en use cases.
Als je nieuw bent met datawarehouses en meer wilt leren, raad ik de cursus Data Warehousing Concepts en de artikelen What Is a Data Warehouse en Data Warehouse Architecture: Trends, Tools, and Techniques aan.
Laten we zien hoe ze verschillen:
Kenmerk
Data lake
Datawarehouse
Datatype
Gestructureerd, semigestructureerd, ongestructureerd
Alleen gestructureerd
Opslagformaat
Ruw (bestandsobjecten)
Verwerkt (tabellen, rijen, kolommen)
Schema
Schema-on-read
Schema-on-write
Kosten
Goedkope opslag
Duurder per GB
Use case
Machine learning, big data en opslag van ruwe data
Business intelligence, gestructureerde analytics
Prestaties
Flexibel, afhankelijk van de compute-engine
Geoptimaliseerd voor snelle SQL-queries
In de praktijk combineren veel moderne datastrategieën beide: data lakes als basis voor opslag van ruwe data en datawarehouses voor gestructureerde rapportage en business intelligence.
Er is ook een hybride oplossing, een data lakehouse. Het artikel What is a Data Lakehouse? Architecture, Technology & Use Cases legt dit uitgebreider uit.
Componenten van een data lake-architectuur
Een goed ontworpen data lake-architectuur is essentieel om ruwe data bruikbaar en toegankelijk te maken voor downstream analytics, machine learning en rapportage.
Deze sectie splitst de vijf belangrijkste lagen van een modern data lake uit, van intake tot governance.
Data-ingestielaag
De ingestielaag haalt data uit verschillende bronnen het data lake in. Dit kunnen interne systemen zijn (zoals databases of CRM’s), externe API’s of IoT-apparaten en logs.
Er zijn drie hoofdmodi voor ingestie:
Gangbare ingestietools zijn onder meer:
Een flexibele ingestielaag zorgt ervoor dat data snel binnenkomt en een verscheidenheid aan formaten en snelheden aankan.
Opslaglaag
Wanneer data is binnengehaald, wordt die opgeslagen in de ruwe zone van het data lake. De opslaglaag is meestal gebaseerd op cloudobjectopslag, die elastische schaalbaarheid, redundantie en kostenefficiëntie biedt.
Populaire opties zijn:
Er zijn echter ook opties voor bedrijven die hun data in hun on-premise clouds willen opslaan die in hun datacenters worden gehost.
Zo kun je bijvoorbeeld MinIO in je infrastructuur installeren. MinIO zelf is open-source en biedt een Amazon S3-compatibele API.
Belangrijke functies van een opslaglaag zijn:
Data in het oorspronkelijke formaat opslaan betekent dat je alle potentie bewaart voor toekomstige verwerking en analyse.
Catalogus en metadatabeheer
Zonder metadata verandert een data lake in een data swamp, omdat het onmogelijk is je data terug te vinden en er efficiënt mee te werken.
De catalogus- en metadata-laag brengt structuur in de chaos door het bijhouden van:
Deze laag zorgt voor vindbaarheid en bruikbaarheid door alle beschikbare datasets te indexeren en zoek- en toegangscontrole mogelijk te maken. Standaardtools voor deze laag zijn onder meer:
Een degelijk metadatasysteem is essentieel voor samenwerking, governance en operationele efficiëntie.
Verwerkings- en analytilaag
Dit is de laag waar ruwe data wordt verwerkt en omgezet in inzichten. De verwerkingslaag ondersteunt uiteenlopende operaties, van basistransformaties tot geavanceerde analytics en machine learning.
Typische workflows omvatten:
Deze laag omvat vaak batch- en realtimecomputing en maakt zowel exploratieve data-analyse als productie-workloads mogelijk.
Beveiliging en governance
Een robuuste data lake-architectuur moet ingebouwde mechanismen hebben om gevoelige data te beschermen en compliance te waarborgen. Dit onderdeel is cruciaal, omdat data lakes meestal veel gevoelige data bevatten die, wanneer gecompromitteerd, het bedrijf kan schaden waartoe ze behoren.
Essentiële functies van die laag zijn onder meer:
Populaire tools en services:
Beveiliging bepaalt vaak of een data lake kan worden gebruikt in gereguleerde sectoren zoals financiën, gezondheidszorg of het leger.
Veelvoorkomende use cases voor data lakes
Data lakes zijn zeer geschikt voor use cases waarin schaal, flexibiliteit en diverse datatypen essentieel zijn. Ze vormen de basis voor moderne datagedreven operaties en applicaties in allerlei sectoren.
In deze sectie verkennen we enkele van de meest voorkomende en impactvolle use cases waarin data lakes een centrale rol spelen.
Big data-analytics
Een van de bekendste toepassingen van data lakes is het mogelijk maken van grootschalige data-analyse.
Omdat data lakes data in ruwe vorm kunnen opslaan, hoeven organisaties niet elk dataset vooraf te schonen of te structureren voor analyse. Dit is ideaal bij het verzamelen van logs, sensordata of clickstreams, die te groot of te snel veranderend zijn voor traditionele systemen.
Data lakes maken het mogelijk om:
Tools zoals Amazon Athena of Google BigQuery kunnen data direct in het lake bevragen zonder complexe transformaties of het verplaatsen van data.
Machine learning en AI
Data lakes passen perfect bij workflows voor machine learning en AI.
Ze bieden de ideale omgeving voor:
In plaats van modellen te beperken tot vooraf opgeschoonde data uit een warehouse, kunnen data scientists rijke, ruwe data gebruiken om vrijer te experimenteren en sneller te itereren. Dit is vooral nuttig in domeinen zoals natural language processing (NLP), computervisie en tijdreeksvoorspelling.
Als je een voorbeeld wilt van hoe de Databricks Lakehouse-oplossing voor AI kan worden gebruikt, raad ik aan om A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists te lezen.
Gecentraliseerde data-archivering
Veel organisaties gebruiken data lakes voor langdurige opslag en archivering.
Dankzij de lage kosten van cloudobjectopslag is het economisch haalbaar om jarenlang operationele data op te slaan die misschien niet dagelijks wordt gebruikt, maar wel toegankelijk moet blijven voor compliance- en auditdoeleinden, trendanalyse, forecasting of het trainen van toekomstige ML-modellen.
De meeste cloudobjectopslagoplossingen stellen je in staat opslag te tieren om zelden geraadpleegde data te archiveren en het lake slank en efficiënt te houden.
Data science-experimentatie
Data lakes geven data scientists de ruimte om ruwe data zonder beperkingen te verkennen.
Of je nu snel een prototype bouwt, een nieuwe hypothese test of exploratieve data-analyse (EDA) uitvoert, het lake geeft je flexibele toegang tot:
Deze experimenteerlaag is essentieel voor innovatie. Data lakes laten je datasets op nieuwe manieren verkennen zonder tickets in te dienen bij het data engineering-team of te wachten op een opgeschoonde versie in het warehouse.
Voordelen en uitdagingen van data lakes
Hoewel data lakes krachtige mogelijkheden bieden voor moderne dataworkflows, kennen ze ook specifieke uitdagingen. Beide kanten begrijpen is essentieel voordat je een data lake-architectuur adopteert. In deze sectie bespreek ik de belangrijkste voordelen, veelvoorkomende valkuilen en hoe je die overwint.
Voordelen van data lakes
Het grootste voordeel van een data lake is de flexibiliteit. Je zit niet vanaf het begin vast aan een specifiek schema of datamodel, wat ideaal is bij snel veranderende of evoluerende datasets.
Hier zijn enkele belangrijke voordelen:
In projecten waar ik aan heb gewerkt, heeft deze centralisatie datasilo’s verminderd en de samenwerking tussen teams aanzienlijk verbeterd.
Belangrijkste uitdagingen
Data lakes zijn krachtig, maar er zijn enkele belangrijke uitdagingen die moeten worden beheerd. Zonder beheer raken ze snel ongeorganiseerd en onbruikbaar, een staat die vaak een data swamp wordt genoemd.
Enkele veelvoorkomende uitdagingen zijn:
Deze problemen kunnen het vertrouwen in het data lake verminderen en de adoptie binnen het bedrijf remmen.
Hoe de uitdagingen te beperken
De meest succesvolle data lakes hebben sterk metadata- en levenscyclusbeheer.
Zo verklein je risico’s en houd je je data lake gezond:
Een data lake kan een asset blijven en geen liability worden door vanaf het begin een schone architectuur te ontwerpen en stevige governancestructuren op te zetten.
Framework voor beheer van de gezondheid van data lakes. Afbeelding door de auteur.
Populaire data lake-technologieën
Met het groeiende belang van data lakes in moderne data-architectuur is er een breed scala aan technologieën ontstaan om ze te ondersteunen. Deze tools beslaan cloud-native platforms, open-source ecosystemen en integraties met analytics-oplossingen. In deze sectie neem ik je mee langs de populairste tools.
Cloud-native oplossingen
Cloudproviders bieden volledig beheerde services voor het bouwen en onderhouden van data lakes. Deze platforms zijn vaak het startpunt voor teams die schaal, duurzaamheid en nauwe integratie met andere clouddiensten zoeken.
Populaire cloud-native oplossingen zijn onder meer:
Deze services zijn geoptimaliseerd voor elasticiteit, kostenefficiëntie en beveiliging, waardoor ze ideaal zijn voor data lakes op enterpriseniveau.
Open-sourcetools
Open-sourcetechnologieën bieden flexibiliteit en uitbreidbaarheid, vooral voor teams die vendor lock-in willen vermijden of in hybride/multi-cloudomgevingen opereren.
Populaire oplossingen zijn onder meer:
Deze tools integreren vaak in bredere dataplatforms en zijn favoriet bij engineeringteams die op maat gemaakte of modulaire oplossingen bouwen.
Als je de verschillen tussen Apache Iceberg en Delta Lake gedetailleerder wilt verkennen, raad ik aan om Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases te lezen.
Integratie met analytics-platforms
Een data lake wordt waardevol wanneer het is geïntegreerd met analytics- en visualisatietools die helpen inzichten te halen en zakelijke beslissingen te sturen. Controleer daarom vóór de definitieve selectie altijd vooraf met welke analytics-platforms de data lake-oplossing moet integreren.
Populaire analytics-platforms zijn onder meer:
Als je meer wilt leren over Databricks, raad ik de cursus Introduction to Databricks aan.
Bij het kiezen van technologieën is het essentieel ze af te stemmen op de expertise van je team, je datastrategie en het niveau van flexibiliteit of abstractie dat je nodig hebt.
Conclusie
Data lakes stellen organisaties in staat robuuste machine learning-applicaties en realtime dashboards te bouwen door een flexibele, schaalbare basis van ruwe en semigestructureerde data te bieden.
In dit artikel hebben we besproken wat een data lake is, de belangrijkste componenten en wanneer je er een gebruikt. We bespraken voordelen zoals flexibiliteit en schaalbaarheid, uitdagingen zoals datagovernance en het risico op een "data swamp", en hoe je die voorkomt. Tot slot bespraken we populaire technologieën voor het bouwen van data lakes, waaronder cloudplatforms en open-sourcetools.
Uit mijn ervaring met MLOps, AI-infrastructuur en cloud-native datasystemen heb ik gezien hoe een goed gearticuleerd data lake de manier waarop teams samenwerken en innoveren kan transformeren. Maar ik heb ook gezien hoe snel een slecht bestuurd data lake een liability kan worden, en hoe lastig het kan zijn om erdoorheen te navigeren.
Als je organisatie met complexe, diverse of grootschalige data werkt en snellere experimentatie, rijkere analytics of AI-ontwikkeling wil mogelijk maken, dan is een data lake misschien precies wat je nodig hebt.
De cursus Understanding Modern Data Architecture is een uitstekend eerste vertrekpunt als je meer wilt leren.