एक ऐसे व्यक्ति के रूप में, जिसने डेटा टीमों को MLOps प्लेटफॉर्म्स में सहयोग दिया है और स्केलेबल इंफ्रास्ट्रक्चर डिज़ाइन करने में मदद की है, मैंने प्रत्यक्ष रूप से देखा है कि आज के डेटा स्टैक में डेटा लेक कितने महत्वपूर्ण हैं।
पारंपरिक डेटा वेयरहाउस के विपरीत, जिनमें स्टोरेज से पहले डेटा का साफ और संरचित होना आवश्यक होता है, डेटा लेक आपको हर चीज़ को कच्चे, असंगठित और अनस्ट्रक्चर्ड फ़ॉर्मेट में स्टोर करने देते हैं। यह लचीलापन डेटा-चालित एप्लिकेशंस और उपयोग के मामलों के लिए असीम संभावनाएँ खोलता है। डेटा लेक आपको विभिन्न स्रोतों से डेटा को एक जगह इकट्ठा करने और स्टोर करने देता है, जहाँ इसे आगे विश्लेषण किया जा सकता है और AI के लिए इस्तेमाल किया जा सकता है।
इस लेख में, मैं समझाऊँगा कि डेटा लेक क्या है, यह कैसे काम करता है, कब इसका उपयोग करना चाहिए, और यह पारंपरिक समाधानों की तुलना में कैसा है।
डेटा लेक की अवधारणा को समझना
तकनीकी आर्किटेक्चर या उपयोग मामलों पर चर्चा करने से पहले यह समझना आवश्यक है कि डेटा लेक क्या है और इसे पारंपरिक स्टोरेज सिस्टम्स से क्या अलग करता है।
यह अनुभाग इस अवधारणा को परिभाषित करता है, इसकी प्रमुख विशेषताओं को समझाता है, और इसे अधिक संरचित डेटा वेयरहाउस की दुनिया से तुलना करता है।
मैं Data Strategy कोर्स की सिफारिश करता हूँ यदि आप सीखना चाहते हैं कि एक सुचारु डेटा रणनीति व्यवसायों की कैसे मदद कर सकती है।
डेटा लेक की परिभाषा
डेटा लेक एक केंद्रीकृत रिपॉज़िटरी है जो आपके सभी संरचित, अर्ध-संरचित और असंरचित डेटा को किसी भी पैमाने पर स्टोर करता है।
आप विभिन्न स्रोतों से कच्चा डेटा इन्गेस्ट कर सकते हैं और इसे उसके मूल फ़ॉर्मेट में रख सकते हैं, जब तक कि आपको इसे प्रोसेस या विश्लेषित करने की आवश्यकता न हो।
डेटाबेस या डेटा वेयरहाउस, जो आमतौर पर एक पूर्व-परिभाषित स्कीमा (schema-on-write) की मांग करते हैं, के विपरीत, डेटा लेक schema-on-read दृष्टिकोण का उपयोग करते हैं। इसका अर्थ है कि संरचना केवल तब लागू होती है जब डेटा को विश्लेषण हेतु एक्सेस किया जाता है, जिससे टीमों को बाद में डेटा की व्याख्या और रूपांतरण में लचीलापन मिलता है।
मुख्य विशेषताएँ
डेटा लेक में निम्नलिखित मुख्य विशेषताएँ होती हैं:
- स्केलेबिलिटी: डेटा लेक क्षैतिज रूप से स्केल करने के लिए बनाए गए हैं। चाहे आप टेराबाइट्स या पेटाबाइट्स डेटा स्टोर कर रहे हों, Amazon S3 या Azure Data Lake Storage जैसे क्लाउड-आधारित ऑब्जेक्ट स्टोरेज समाधान क्षमता की चिंता किए बिना बढ़ना आसान बनाते हैं।
- Schema-on-read: डेटा स्टोर करते समय आपको स्कीमा परिभाषित करने की ज़रूरत नहीं होती। इसके बजाय, डेटा वैज्ञानिक, विश्लेषक, या इंजीनियर पुनर्प्राप्ति या रूपांतरण के दौरान उपयोग मामले के अनुसार अलग-अलग स्कीमा लागू कर सकते हैं।
- कच्चा डेटा स्टोरेज: डेटा लेक सभी प्रकार के डेटा को उनके नैटिव फ़ॉर्मेट में रखते हैं, चाहे वे CSV फाइलें हों, JSON लॉग्स, ऑडियो फाइलें, वीडियो, या सेंसर डेटा।
- विविध डेटा प्रकारों का समर्थन: आप एक ही स्थान पर संरचित (जैसे SQL टेबल्स), अर्ध-संरचित (जैसे XML, JSON), और असंरचित डेटा (जैसे इमेज, PDF, टेक्स्ट) स्टोर कर सकते हैं।
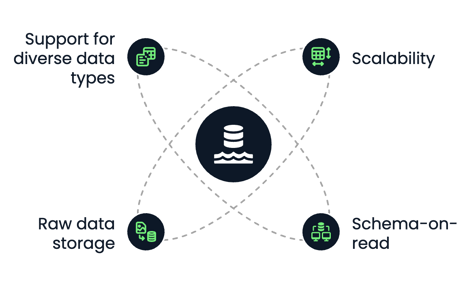
डेटा लेक की मुख्य विशेषताएँ। चित्र: लेखक द्वारा।
डेटा वेयरहाउस के साथ तुलना
डेटा लेक और डेटा वेयरहाउस दोनों का उपयोग डेटा को स्टोर करने और विश्लेषण के लिए किया जाता है। फिर भी, वे संरचना, प्रदर्शन और उपयोग मामलों में काफी भिन्न हैं।
यदि आप डेटा वेयरहाउस में नए हैं और अधिक सीखना चाहते हैं, तो मैं Data Warehousing Concepts कोर्स और What Is a Data Warehouse तथा Data Warehouse Architecture: Trends, Tools, and Techniques लेखों की सिफारिश करता हूँ।
आइए देखें कि वे कैसे अलग हैं:
|
विशेषता
|
डेटा लेक
|
डेटा वेयरहाउस
|
|
डेटा प्रकार
|
संरचित, अर्ध-संरचित, असंरचित
|
केवल संरचित
|
|
स्टोरेज फ़ॉर्मेट
|
कच्चा (फ़ाइल ऑब्जेक्ट्स)
|
प्रोसेस्ड (टेबल्स, रोज़, कॉलम्स)
|
|
स्कीमा
|
Schema-on-read
|
Schema-on-write
|
|
लागत
|
लो-कॉस्ट स्टोरेज
|
प्रति GB अधिक महंगा
|
|
उपयोग मामला
|
मशीन लर्निंग, बिग डेटा, और कच्चा डेटा स्टोरेज
|
बिज़नेस इंटेलिजेंस, संरचित एनालिटिक्स
|
|
प्रदर्शन
|
लचीला, कंप्यूट इंजन पर निर्भर
|
तेज़ SQL क्वेरीज़ के लिए ऑप्टिमाइज़्ड
|
व्यवहार में, कई आधुनिक डेटा रणनीतियाँ दोनों को मिलाती हैं: कच्चे डेटा स्टोरेज के लिए डेटा लेक का उपयोग और संरचित रिपोर्टिंग तथा बिज़नेस इंटेलिजेंस के लिए डेटा वेयरहाउस।
एक हाइब्रिड समाधान भी है जिसे डेटा लेकहाउस कहा जाता है। लेख What is a Data Lakehouse? Architecture, Technology & Use Cases इसे और विस्तार से समझाता है।
डेटा लेक आर्किटेक्चर के घटक
एक अच्छे से डिज़ाइन किया गया डेटा लेक आर्किटेक्चर आवश्यक है ताकि कच्चा डेटा डाउनस्ट्रीम एनालिटिक्स, मशीन लर्निंग, और रिपोर्टिंग के लिए उपयोगी और सुलभ बन सके।
यह अनुभाग आधुनिक डेटा लेक की पाँच प्रमुख परतों को इन्गेस्टन से लेकर गवर्नेंस तक समझाता है।
डेटा इन्गेस्टन लेयर
इन्गेस्टन लेयर विभिन्न स्रोतों से डेटा को डेटा लेक में लाती है। इन स्रोतों में आंतरिक सिस्टम (जैसे डेटाबेस या CRM), बाहरी API, या IoT डिवाइस और लॉग्स शामिल हैं।
तीन प्रमुख इन्गेस्टन मोड हैं:
- बैच इन्गेस्टन: डेटा को समय-समय पर (जैसे रात में) बैच में लोड करना।
- स्ट्रीम इन्गेस्टन: रीयल-टाइम डेटा फ़्लो, जैसे क्लिकस्ट्रीम या सेंसर डेटा।
- हाइब्रिड इन्गेस्टन: बैच और स्ट्रीम दोनों का संयोजन, जो एंटरप्राइज़ परिवेश में आम है।
मानक इन्गेस्टन टूल्स में शामिल हैं:
- स्ट्रीमिंग के लिए Apache Kafka और AWS Kinesis
- Apache NiFi, Flume, और बैच ETL के लिए AWS Glue
एक लचीला इन्गेस्टन लेयर सुनिश्चित करता है कि डेटा जल्दी पहुँचे और विभिन्न फ़ॉर्मैट्स और वेगों को संभाल सके।
स्टोरेज लेयर
जब डेटा इन्गेस्ट किया जाता है, तो इसे डेटा लेक के रॉ ज़ोन में स्टोर किया जाता है। स्टोरेज लेयर आमतौर पर क्लाउड ऑब्जेक्ट स्टोरेज पर निर्मित होती है, जो इलास्टिक स्केलिंग, रेडंडेंसी और लागत-दक्षता प्रदान करती है।
लोकप्रिय विकल्पों में शामिल हैं:
- Amazon S3
- Azure Data Lake Storage
- Google Cloud Storage
हालाँकि, उन कंपनियों के लिए भी विकल्प हैं जो अपना डेटा अपने डेटा सेंटर्स में होस्ट की गई ऑन-प्रिमाइसेज़ क्लाउड्स में स्टोर करना चाहती हैं।
उदाहरण के लिए, कोई अपने इंफ्रास्ट्रक्चर में MinIO इंस्टॉल कर सकता है। MinIO स्वयं ओपन-सोर्स है और Amazon S3-कम्पैटिबल API प्रदान करता है।
स्टोरेज लेयर की प्रमुख विशेषताओं में शामिल हैं:
- दृढ़ता और उपलब्धता: डेटा स्वतः ही क्षेत्रों में प्रतिकृत किया जाता है।
- स्टोरेज और कंप्यूट का पृथक्करण: आप माँग के आधार पर कंप्यूट को स्वतंत्र रूप से स्केल कर सकते हैं।
- डेटा टियरिंग: आर्काइव हेतु कोल्ड स्टोरेज और बार-बार एक्सेस होने वाले डेटा के लिए हॉट स्टोरेज की सुविधा देता है।
डेटा को उसके मूल फ़ॉर्मेट में स्टोर करने से आप भविष्य की प्रोसेसिंग और विश्लेषण के लिए उसकी पूरी क्षमता को बनाए रख सकते हैं।
कैटलॉग और मेटाडेटा प्रबंधन
मेटाडेटा के बिना, डेटा लेक एक डेटा स्वैम्प बन जाता है, क्योंकि अपने डेटा को फिर से ढूँढ़ना और उसके साथ कुशलता से काम करना असंभव हो जाता है।
कैटलॉग और मेटाडेटा लेयर अव्यवस्था में संरचना लाते हैं, जो निम्न का रिकॉर्ड रखते हैं:
- डेटा स्कीमा
- डेटा का स्थान और पार्टिशनिंग
- लीनिएज और वर्ज़निंग
यह लेयर सभी उपलब्ध डेटासेट्स को इंडेक्स कर और खोज व एक्सेस कंट्रोल सक्षम कर खोजयोग्यता और उपयोगिता सुनिश्चित करती है। इस लेयर के मानक टूल्स में शामिल हैं:
- AWS Glue Data Catalog
- Apache Hive Metastore
- Apache Atlas
- DataHub
सहयोग, गवर्नेंस, और परिचालन दक्षता के लिए एक सुदृढ़ मेटाडेटा सिस्टम आवश्यक है।
प्रोसेसिंग और एनालिटिक्स लेयर
यहीं कच्चा डेटा प्रोसेस होकर इनसाइट्स में बदलता है। प्रोसेसिंग लेयर बेसिक ट्रांसफॉर्मेशन्स से लेकर उन्नत एनालिटिक्स और मशीन लर्निंग तक विभिन्न ऑपरेशंस का समर्थन करती है।
सामान्य वर्कफ़्लो में शामिल हैं:
- ETL/ELT पाइपलाइंस डेटा सफाई और सामान्यीकरण के लिए
- SQL क्वेरीइंग
- मशीन लर्निंग पाइपलाइंस
यह लेयर अक्सर बैच और रीयल-टाइम कंप्यूटिंग दोनों शामिल करती है, जो अन्वेषणात्मक डेटा विश्लेषण और प्रोडक्शन वर्कलोड्स को सक्षम बनाती है।
सुरक्षा और गवर्नेंस
मजबूत डेटा लेक आर्किटेक्चर में संवेदनशील डेटा की सुरक्षा और अनुपालन सुनिश्चित करने के लिए इन-बिल्ट तंत्र होना चाहिए। यह भाग महत्वपूर्ण है, क्योंकि डेटा लेक में प्रायः बहुत-सा संवेदनशील डेटा होता है, जो समझौता होने पर संबंधित व्यवसाय को नुकसान पहुँचा सकता है।
उस लेयर की आवश्यक विशेषताओं में शामिल हैं:
- Identity and access management (IAM): कौन डेटा देख या संशोधित कर सकता है, इसे प्रतिबंधित करें।
- एन्क्रिप्शन: इन-ट्रांज़िट (TLS) और एट-रेस्ट एन्क्रिप्शन।
- डेटा मास्किंग और अनामीकरण: व्यक्तिगत पहचान योग्य जानकारी को संभालने के लिए।
- ऑडिटिंग और मॉनिटरिंग: ट्रेसबिलिटी और अनुपालन हेतु।
लोकप्रिय टूल्स और सेवाएँ:
- AWS Lake Formation
- Apache Ranger
- Azure Purview
सुरक्षा अक्सर यह निर्धारित करती है कि क्या डेटा लेक का उपयोग वित्त, हेल्थकेयर या रक्षा जैसी विनियमित उद्योगों में किया जा सकता है।
डेटा लेक के सामान्य उपयोग मामले
डेटा लेक उन उपयोग मामलों के लिए उपयुक्त हैं जहाँ पैमाना, लचीलापन और विविध डेटा प्रकार आवश्यक हैं। वे विभिन्न उद्योगों में आधुनिक डेटा-चालित संचालन और एप्लिकेशंस की नींव के रूप में कार्य करते हैं।
इस अनुभाग में, हम कुछ सबसे सामान्य और प्रभावशाली उपयोग मामलों का अन्वेषण करेंगे जहाँ डेटा लेक केंद्रीय भूमिका निभाते हैं।
बिग डेटा एनालिटिक्स
डेटा लेक के सबसे प्रसिद्ध उपयोगों में से एक बड़े पैमाने पर डेटा एनालिटिक्स को सक्षम करना है।
क्योंकि डेटा लेक डेटा को उसके कच्चे रूप में स्टोर कर सकते हैं, संगठनों को विश्लेषण से पहले हर डेटासेट को साफ़ या संरचित करने की चिंता नहीं करनी पड़ती। यह लॉग्स, सेंसर डेटा, या क्लिकस्ट्रीम एकत्र करते समय आदर्श है, जो पारंपरिक सिस्टम्स के लिए बहुत बड़े या तेज़ी से बदलने वाले होते हैं।
डेटा लेक निम्न संभव बनाते हैं:
- ऐतिहासिक डेटा का रीयल-टाइम डेटा के साथ विश्लेषण
- पेटाबाइट-स्केल डेटासेट्स पर कस्टम क्वेरी चलाना
- सिंगल सोर्स ऑफ़ ट्रुथ के साथ विभागों के बीच एनालिटिक्स सक्षम करना
उपकरण जैसे Amazon Athena या Google BigQuery डेटा को सीधे लेक में क्वेरी कर सकते हैं, बिना जटिल ट्रांसफॉर्मेशन्स या डेटा को कहीं और ले जाए बिना।
मशीन लर्निंग और AI
डेटा लेक मशीन लर्निंग और AI वर्कफ़्लो के लिए एकदम उपयुक्त हैं।
वे निम्न के लिए आदर्श वातावरण प्रदान करते हैं:
- कई फ़ॉर्मेट्स (जैसे, CSV, Parquet, इमेज आदि) में ट्रेनिंग डेटासेट्स स्टोर करना
- कच्चा और इसलिए अधिक व्यापक डेटा रखना, जिससे ML मॉडलों पर खोज, प्रयोग और पुनरावृत्ति में अधिक लचीलापन मिलता है
- बड़े पैमाने पर डेटा पर इटरेट करने वाली स्वचालित ML पाइपलाइंस को शक्ति देना
वेयरहाउस से पूर्व-साफ़ किए गए डेटा तक मॉडलों को सीमित करने के बजाय, डेटा वैज्ञानिक समृद्ध, कच्चे डेटा तक पहुँच कर अधिक स्वतंत्र रूप से प्रयोग कर सकते हैं और तेज़ी से इटरेट कर सकते हैं। यह विशेष रूप से NLP, कंप्यूटर विज़न, और टाइम-सीरीज़ फोरकास्टिंग जैसे डोमेन्स में उपयोगी है।
यदि आप देखना चाहते हैं कि Databricks Lakehouse समाधान का AI के लिए कैसे उपयोग किया जा सकता है, तो मैं सिफारिश करता हूँ कि A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists पढ़ें।
केंद्रीकृत डेटा आर्काइविंग
कई संगठन दीर्घकालिक स्टोरेज और आर्काइविंग के लिए डेटा लेक का उपयोग करते हैं।
क्लाउड ऑब्जेक्ट स्टोरेज की कम लागत के कारण, वर्षों का परिचालन डेटा स्टोर करना आर्थिक रूप से संभव है, जिसे रोज़ाना उपयोग नहीं किया जाता, लेकिन अनुपालन और ऑडिट उद्देश्यों, ट्रेंड विश्लेषण, पूर्वानुमान, या भविष्य के ML मॉडलों को प्रशिक्षित करने के लिए सुलभ रहना आवश्यक है।
अधिकांश क्लाउड ऑब्जेक्ट स्टोरेज समाधान आपको स्टोरेज को टियर करने की अनुमति देते हैं ताकि शायद ही एक्सेस किए जाने वाले डेटा को आर्काइव किया जा सके, जबकि लेक को हल्का और कुशल रखा जा सके।
डेटा साइंस प्रयोग
डेटा लेक डेटा वैज्ञानिकों को बिना बाधाओं के कच्चे डेटा का अन्वेषण करने में सक्षम बनाते हैं।
चाहे आप एक त्वरित प्रोटोटाइप बना रहे हों, कोई नया परिकल्पना जाँच रहे हों, या अन्वेषणात्मक डेटा विश्लेषण (EDA) चला रहे हों, लेक आपको लचीली पहुँच देता है:
- कच्चा असंरचित डेटा (जैसे PDFs, ईमेल, टेक्स्ट फाइलें)
- अर्ध-संरचित फ़ॉर्मैट्स (जैसे JSON, XML, या लॉग्स)
- विशाल डेटासेट्स जो पारंपरिक DB में फिट नहीं होंगे
यह प्रयोगात्मक लेयर नवाचार के लिए आवश्यक है। डेटा लेक आपको नए तरीकों से डेटासेट्स का अन्वेषण करने देते हैं, बिना डेटा इंजीनियरिंग टीम को टिकट सबमिट किए या वेयरहाउस में साफ़ किए गए संस्करण की प्रतीक्षा किए।
डेटा लेक के लाभ और चुनौतियाँ
जहाँ डेटा लेक आधुनिक डेटा वर्कफ़्लो के लिए शक्तिशाली क्षमताएँ प्रदान करते हैं, वहीं इनमें विशिष्ट चुनौतियाँ भी हैं। डेटा लेक आर्किटेक्चर अपनाने से पहले दोनों पहलुओं को समझना आवश्यक है। इस अनुभाग में, मैं मुख्य लाभों, आम खामियों और उन्हें कैसे दूर करें, पर चर्चा करूँगा।
डेटा लेक के लाभ
डेटा लेक का सबसे बड़ा लाभ इसका लचीलापन है। आप शुरुआत से किसी विशिष्ट स्कीमा या डेटा मॉडल से बँधे नहीं होते, जो तेज़ी से बदलते या विकसित होते डेटासेट्स के साथ काम करते समय उत्कृष्ट है।
यहाँ कुछ प्रमुख लाभ हैं:
- स्केलेबिलिटी: डेटा लेक क्लाउड-नेटिव स्टोरेज पर आधारित होते हैं जो आसानी से स्केल करते हैं, चाहे आप गीगाबाइट्स स्टोर करें या पेटाबाइट्स।
- सभी डेटा प्रकारों का समर्थन: संरचित (SQL टेबल्स), अर्ध-संरचित (JSON, XML), और असंरचित (टेक्स्ट, इमेज, वीडियो) डेटा एक ही प्लेटफ़ॉर्म में स्टोर किए जा सकते हैं।
- लागत-दक्षता: क्लाउड ऑब्जेक्ट स्टोरेज (जैसे Amazon S3) पारंपरिक डेटाबेस या वेयरहाउस द्वारा उपयोग किए जाने वाले स्टोरेज से काफी सस्ता है।
- डिकपल्ड आर्किटेक्चर: कंप्यूट और स्टोरेज अलग होते हैं, जिससे एनालिटिक्स वर्कलोड्स को डेटा स्टोरेज से स्वतंत्र रूप से स्केल किया जा सकता है।
- उन्नत एनालिटिक्स: डेटा लेक कच्चा, अनप्रोसेस्ड डेटा स्टोर करते हैं और अधिक व्यापक व लचीला डेटा विश्लेषण, जिसमें मशीन लर्निंग और प्रेडिक्टिव एनालिटिक्स शामिल हैं, सक्षम करते हैं।
- बेहतर निर्णय-निर्माण: डेटा लेक गहन और व्यापक डेटा विश्लेषण को सक्षम कर सकते हैं, जिससे संगठन भर में बेहतर-सूचित निर्णय होते हैं।
- डेटा साइलो का उन्मूलन: डेटा लेक विभिन्न स्रोतों से डेटा को एकल, केंद्रीकृत रिपॉज़िटरी में समेकित करके डेटा साइलो तोड़ने में मदद करते हैं।
जिन प्रोजेक्ट्स पर मैंने काम किया है, उनमें इस केंद्रीकरण ने डेटा साइलो को कम किया है और क्रॉस-टीम सहयोग को उल्लेखनीय रूप से सुधारा है।
मुख्य चुनौतियाँ
डेटा लेक शक्तिशाली हैं, फिर भी कुछ प्रमुख चुनौतियाँ हैं जिन्हें मैनेज करना होता है। यदि इन्हें मैनेज न किया जाए, तो वे जल्दी ही अव्यवस्थित और अनुपयोगी हो सकते हैं, जिसे अक्सर डेटा स्वैम्प कहा जाता है।
कुछ सामान्य चुनौतियाँ शामिल हैं:
- संरचना का अभाव: पूर्वनिर्धारित स्कीमा के बिना, डेटा को क्वेरी करना, डॉक्यूमेंट करना या गवर्न करना कठिन हो सकता है।
- डेटा गुणवत्ता संबंधी मुद्दे: क्योंकि डेटा कच्चे रूप में इन्गेस्ट होता है, निम्न-गुणवत्ता या अपूर्ण डेटा डाउनस्ट्रीम तक अनदेखा रह सकता है।
- मेटाडेटा और खोजयोग्यता की कमी: एक मजबूत कैटलॉगिंग सिस्टम के बिना, उपयोगकर्ताओं को यह पता नहीं चल सकता कि कौन-सा डेटा मौजूद है या उसका उपयोग कैसे करें।
- जटिल गवर्नेंस: एक लचीले वातावरण में एक्सेस कंट्रोल, ऑडिटेबिलिटी और अनुपालन सुनिश्चित करना अधिक कठिन होता है।
ये समस्याएँ डेटा लेक में विश्वास को कम कर सकती हैं और व्यवसाय भर में अपनाने को घटा सकती हैं।
चुनौतियों को कैसे कम करें
सबसे सफल डेटा लेक में मजबूत मेटाडेटा और लाइफसाइकिल प्रबंधन प्रथाएँ होती हैं।
जोखिम कम करने और अपने डेटा लेक को स्वस्थ रखने के लिए ये कदम उठाएँ:
- डेटा कैटलॉग लागू करें: AWS Glue या DataHub जैसे टूल्स खोजयोग्यता, स्कीमा परिभाषाएँ और लीनिएज ट्रैकिंग बनाए रखने में मदद करते हैं।
- मानकीकृत नेमिंग और फ़ोल्डर संरचनाएँ उपयोग करें: यह स्थिरता बनाता है और टीम की भ्रम की स्थिति घटाता है।
- डेटा वैलिडेशन और प्रोफाइलिंग टूल्स अपनाएँ: इन्गेस्टन के दौरान गुणवत्ता सुनिश्चित करें और समय-समय पर डेटा को फिर से वैलिडेट करें।
- लाइफसाइकिल नीतियों का स्वचालन करें: पुराना डेटा स्वतः कोल्ड स्टोरेज में ले जाएँ या परिभाषित रिटेंशन अवधि के बाद हटा दें।
- मजबूत एक्सेस कंट्रोल और एन्क्रिप्शन लागू करें: संवेदनशील डेटा की सुरक्षा हेतु IAM नीतियाँ, रोल-आधारित एक्सेस, और एट-रेस्ट व इन-ट्रांज़िट एन्क्रिप्शन का उपयोग करें।
शुरुआत से एक साफ़-सुथरा आर्किटेक्चर डिज़ाइन कर और सुदृढ़ गवर्नेंस संरचनाएँ स्थापित कर, डेटा लेक एक संपत्ति बना रह सकता है, दायित्व नहीं।
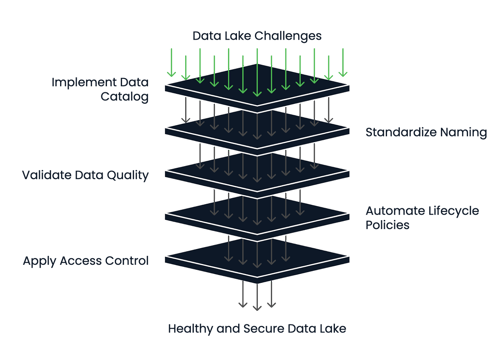
डेटा लेक हेल्थ मैनेजमेंट फ़्रेमवर्क। चित्र: लेखक द्वारा।
लोकप्रिय डेटा लेक तकनीकें
आधुनिक डेटा आर्किटेक्चर में डेटा लेक के बढ़ते महत्व के साथ, उन्हें समर्थन देने के लिए व्यापक तकनीकों का उदय हुआ है। ये टूल्स क्लाउड-नेटिव प्लेटफ़ॉर्म, ओपन-सोर्स इकोसिस्टम, और एनालिटिक्स समाधानों के साथ इंटीग्रेशन्स तक फैले हैं। इस अनुभाग में, मैं आपको सबसे लोकप्रिय टूल्स से परिचित कराऊँगा।
क्लाउड-नेटिव समाधान
क्लाउड प्रदाता डेटा लेक बनाने और बनाए रखने के लिए पूर्ण-प्रबंधित सेवाएँ प्रदान करते हैं। ये प्लेटफ़ॉर्म अक्सर उन टीमों के लिए शुरुआती बिंदु होते हैं जो स्केल, दृढ़ता, और अन्य क्लाउड सेवाओं के साथ कड़े इंटीग्रेशन की तलाश में होती हैं।
लोकप्रिय क्लाउड-नेटिव समाधानों में शामिल हैं:
- Amazon S3 + AWS Lake Formation: S3 ऑब्जेक्ट स्टोरेज प्रदान करता है, जबकि Lake Formation परमिशन्स, कैटलॉगिंग और गवर्नेंस संभालता है।
- Azure Data Lake Storage: ब्लॉब स्टोरेज को HDFS-जैसी क्षमताओं के साथ संयोजित करता है।
- Google Cloud Storage (GCS): GCS अत्यंत टिकाऊ है और एनालिटिक्स व ML वर्कलोड्स के लिए BigQuery और Vertex AI के साथ अच्छी तरह एकीकृत होता है।
ये सेवाएँ इलास्टिसिटी, लागत-दक्षता, और सुरक्षा के लिए ऑप्टिमाइज़्ड हैं, जिससे ये एंटरप्राइज़-स्केल डेटा लेक के लिए आदर्श बनती हैं।
ओपन-सोर्स टूल्स
ओपन-सोर्स तकनीकें लचीलापन और विस्तारशीलता जोड़ती हैं, खासकर उन टीमों के लिए जो वेंडर लॉक-इन से बचना चाहती हैं या हाइब्रिड/मल्टी-क्लाउड परिवेश में काम करना चाहती हैं।
लोकप्रिय समाधान शामिल हैं:
- Apache Hadoop: मूल डेटा लेक फ़्रेमवर्क्स में से एक। यद्यपि नए प्रोजेक्ट्स के लिए आज कम सामान्य है, इसने वितरित डेटा स्टोरेज और प्रोसेसिंग की नींव रखी।
- Delta Lake: Databricks द्वारा विकसित, Delta Lake क्लाउड ऑब्जेक्ट स्टोरेज में ACID ट्रांज़ैक्शन्स, वर्ज़निंग और स्कीमा एन्फोर्समेंट जोड़ता है।
- Apache Iceberg: Iceberg एटॉमिक ऑपरेशंस, हिडन पार्टिशनिंग और ऐतिहासिक डेटा की क्वेरी के लिए टाइम ट्रैवल प्रदान करता है।
- Presto: एक वितरित SQL क्वेरी इंजन, जो S3, HDFS या अन्य स्रोतों में स्टोर डेटा पर, बिना डेटा को मूव किए, तेज़, इंटरैक्टिव क्वेरी चलाने देता है।
ये टूल्स अक्सर व्यापक डेटा प्लेटफ़ॉर्म्स में इंटीग्रेट होते हैं और कस्टम या मॉड्यूलर समाधान बनाने वाली इंजीनियरिंग टीमों द्वारा पसंद किए जाते हैं।
यदि आप Apache Iceberg और Delta Lake के बीच के अंतर को और विस्तार से खोजना चाहते हैं, तो मैं सिफारिश करता हूँ कि Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases पढ़ें।
एनालिटिक्स प्लेटफ़ॉर्म्स के साथ इंटीग्रेशन
जब डेटा लेक को ऐसे एनालिटिक्स और विज़ुअलाइज़ेशन टूल्स के साथ इंटीग्रेट किया जाता है जो इनसाइट्स निकालने और व्यावसायिक निर्णयों को प्रेरित करने में मदद करते हैं, तब यह मूल्यवान बनता है। इसलिए, अंतिम समाधान चुनने से पहले, यह हमेशा पहले से जाँच लेना चाहिए कि डेटा लेक समाधान किन एनालिटिक्स प्लेटफ़ॉर्म्स के साथ इंटीग्रेट होना चाहिए।
लोकप्रिय एनालिटिक्स प्लेटफ़ॉर्म्स में शामिल हैं:
- Databricks: डेटा इंजीनियरिंग, मशीन लर्निंग, और एनालिटिक्स के लिए एक सहयोगी वर्कस्पेस के साथ डेटा लेक स्टोरेज को संयोजित करता है। यह Delta Lake को बॉक्स से बाहर सपोर्ट करता है।
- Snowflake: पारंपरिक रूप से भले ही डेटा वेयरहाउस हो, Snowflake क्लाउड स्टोरेज में बाहरी डेटा (Snowpipe या एक्सटर्नल टेबल्स के माध्यम से) क्वेरी कर सकता है, जिससे यह एक हाइब्रिड लेकहाउस समाधान बन जाता है।
- Power BI, Tableau: ये BI टूल्स सीधे या Athena या BigQuery जैसे क्वेरी इंजनों के माध्यम से डेटा लेक से कनेक्ट हो सकते हैं, जिससे रॉ या अर्ध-संरचित डेटा के ऊपर डैशबोर्डिंग और रिपोर्टिंग संभव हो जाती है।
यदि आप Databricks के बारे में अधिक सीखना चाहते हैं, तो मैं Introduction to Databricks कोर्स की सिफारिश करता हूँ।
तकनीकें चुनते समय, उन्हें आपकी टीम की विशेषज्ञता, आपकी डेटा रणनीति, और आपको आवश्यक लचीलेपन या एब्स्ट्रैक्शन के स्तर के साथ संरेखित करना आवश्यक है।
निष्कर्ष
डेटा लेक लचीला, स्केलेबल, कच्चा और अर्ध-संरचित डेटा आधार प्रदान करके संगठनों को मजबूत मशीन लर्निंग एप्लिकेशंस और रीयल-टाइम डैशबोर्ड बनाने में सक्षम बनाते हैं।
इस लेख में, हमने देखा कि डेटा लेक क्या है, इसके प्रमुख घटक क्या हैं, और कब इसका उपयोग करना चाहिए। हमने लचीलापन और स्केलेबिलिटी जैसे लाभों, डेटा गवर्नेंस और "डेटा स्वैम्प" के जोखिम जैसी चुनौतियों, और उनसे कैसे बचें, पर चर्चा की। अंत में, हमने डेटा लेक बनाने के लिए लोकप्रिय तकनीकों को कवर किया, जिनमें क्लाउड प्लेटफ़ॉर्म्स और ओपन-सोर्स टूल्स शामिल हैं।
MLOps, AI इंफ्रास्ट्रक्चर, और क्लाउड-नेटिव डेटा सिस्टम्स में काम करने के अपने अनुभव से, मैंने देखा है कि एक अच्छे से अभिकल्पित डेटा लेक टीमों के सहयोग और नवाचार के तरीके को कैसे बदल सकता है। लेकिन मैंने यह भी देखा है कि एक खराब शासित डेटा लेक कितनी जल्दी दायित्व बन सकता है, और उसमें नेविगेट करना कितना कठिन हो सकता है।
यदि आपका संगठन जटिल, विविध, या बड़े पैमाने के डेटा को संभालता है और तेज़ प्रयोग, समृद्ध एनालिटिक्स, या AI विकास सक्षम करना चाहता है, तो डेटा लेक ही शायद आपकी ज़रूरत है।
यदि आप और सीखना चाहते हैं, तो Understanding Modern Data Architecture कोर्स एक बेहतरीन शुरुआती पड़ाव है।


एक ऐसे व्यक्ति के रूप में, जिसने डेटा टीमों को MLOps प्लेटफॉर्म्स में सहयोग दिया है और स्केलेबल इंफ्रास्ट्रक्चर डिज़ाइन करने में मदद की है, मैंने प्रत्यक्ष रूप से देखा है कि आज के डेटा स्टैक में डेटा लेक कितने महत्वपूर्ण हैं।
पारंपरिक डेटा वेयरहाउस के विपरीत, जिनमें स्टोरेज से पहले डेटा का साफ और संरचित होना आवश्यक होता है, डेटा लेक आपको हर चीज़ को कच्चे, असंगठित और अनस्ट्रक्चर्ड फ़ॉर्मेट में स्टोर करने देते हैं। यह लचीलापन डेटा-चालित एप्लिकेशंस और उपयोग के मामलों के लिए असीम संभावनाएँ खोलता है। डेटा लेक आपको विभिन्न स्रोतों से डेटा को एक जगह इकट्ठा करने और स्टोर करने देता है, जहाँ इसे आगे विश्लेषण किया जा सकता है और AI के लिए इस्तेमाल किया जा सकता है।
इस लेख में, मैं समझाऊँगा कि डेटा लेक क्या है, यह कैसे काम करता है, कब इसका उपयोग करना चाहिए, और यह पारंपरिक समाधानों की तुलना में कैसा है।
डेटा लेक की अवधारणा को समझना
तकनीकी आर्किटेक्चर या उपयोग मामलों पर चर्चा करने से पहले यह समझना आवश्यक है कि डेटा लेक क्या है और इसे पारंपरिक स्टोरेज सिस्टम्स से क्या अलग करता है।
यह अनुभाग इस अवधारणा को परिभाषित करता है, इसकी प्रमुख विशेषताओं को समझाता है, और इसे अधिक संरचित डेटा वेयरहाउस की दुनिया से तुलना करता है।
मैं Data Strategy कोर्स की सिफारिश करता हूँ यदि आप सीखना चाहते हैं कि एक सुचारु डेटा रणनीति व्यवसायों की कैसे मदद कर सकती है।
डेटा लेक की परिभाषा
डेटा लेक एक केंद्रीकृत रिपॉज़िटरी है जो आपके सभी संरचित, अर्ध-संरचित और असंरचित डेटा को किसी भी पैमाने पर स्टोर करता है।
आप विभिन्न स्रोतों से कच्चा डेटा इन्गेस्ट कर सकते हैं और इसे उसके मूल फ़ॉर्मेट में रख सकते हैं, जब तक कि आपको इसे प्रोसेस या विश्लेषित करने की आवश्यकता न हो।
डेटाबेस या डेटा वेयरहाउस, जो आमतौर पर एक पूर्व-परिभाषित स्कीमा (schema-on-write) की मांग करते हैं, के विपरीत, डेटा लेक schema-on-read दृष्टिकोण का उपयोग करते हैं। इसका अर्थ है कि संरचना केवल तब लागू होती है जब डेटा को विश्लेषण हेतु एक्सेस किया जाता है, जिससे टीमों को बाद में डेटा की व्याख्या और रूपांतरण में लचीलापन मिलता है।
मुख्य विशेषताएँ
डेटा लेक में निम्नलिखित मुख्य विशेषताएँ होती हैं:
डेटा लेक की मुख्य विशेषताएँ। चित्र: लेखक द्वारा।
डेटा वेयरहाउस के साथ तुलना
डेटा लेक और डेटा वेयरहाउस दोनों का उपयोग डेटा को स्टोर करने और विश्लेषण के लिए किया जाता है। फिर भी, वे संरचना, प्रदर्शन और उपयोग मामलों में काफी भिन्न हैं।
यदि आप डेटा वेयरहाउस में नए हैं और अधिक सीखना चाहते हैं, तो मैं Data Warehousing Concepts कोर्स और What Is a Data Warehouse तथा Data Warehouse Architecture: Trends, Tools, and Techniques लेखों की सिफारिश करता हूँ।
आइए देखें कि वे कैसे अलग हैं:
विशेषता
डेटा लेक
डेटा वेयरहाउस
डेटा प्रकार
संरचित, अर्ध-संरचित, असंरचित
केवल संरचित
स्टोरेज फ़ॉर्मेट
कच्चा (फ़ाइल ऑब्जेक्ट्स)
प्रोसेस्ड (टेबल्स, रोज़, कॉलम्स)
स्कीमा
Schema-on-read
Schema-on-write
लागत
लो-कॉस्ट स्टोरेज
प्रति GB अधिक महंगा
उपयोग मामला
मशीन लर्निंग, बिग डेटा, और कच्चा डेटा स्टोरेज
बिज़नेस इंटेलिजेंस, संरचित एनालिटिक्स
प्रदर्शन
लचीला, कंप्यूट इंजन पर निर्भर
तेज़ SQL क्वेरीज़ के लिए ऑप्टिमाइज़्ड
व्यवहार में, कई आधुनिक डेटा रणनीतियाँ दोनों को मिलाती हैं: कच्चे डेटा स्टोरेज के लिए डेटा लेक का उपयोग और संरचित रिपोर्टिंग तथा बिज़नेस इंटेलिजेंस के लिए डेटा वेयरहाउस।
एक हाइब्रिड समाधान भी है जिसे डेटा लेकहाउस कहा जाता है। लेख What is a Data Lakehouse? Architecture, Technology & Use Cases इसे और विस्तार से समझाता है।
डेटा लेक आर्किटेक्चर के घटक
एक अच्छे से डिज़ाइन किया गया डेटा लेक आर्किटेक्चर आवश्यक है ताकि कच्चा डेटा डाउनस्ट्रीम एनालिटिक्स, मशीन लर्निंग, और रिपोर्टिंग के लिए उपयोगी और सुलभ बन सके।
यह अनुभाग आधुनिक डेटा लेक की पाँच प्रमुख परतों को इन्गेस्टन से लेकर गवर्नेंस तक समझाता है।
डेटा इन्गेस्टन लेयर
इन्गेस्टन लेयर विभिन्न स्रोतों से डेटा को डेटा लेक में लाती है। इन स्रोतों में आंतरिक सिस्टम (जैसे डेटाबेस या CRM), बाहरी API, या IoT डिवाइस और लॉग्स शामिल हैं।
तीन प्रमुख इन्गेस्टन मोड हैं:
मानक इन्गेस्टन टूल्स में शामिल हैं:
एक लचीला इन्गेस्टन लेयर सुनिश्चित करता है कि डेटा जल्दी पहुँचे और विभिन्न फ़ॉर्मैट्स और वेगों को संभाल सके।
स्टोरेज लेयर
जब डेटा इन्गेस्ट किया जाता है, तो इसे डेटा लेक के रॉ ज़ोन में स्टोर किया जाता है। स्टोरेज लेयर आमतौर पर क्लाउड ऑब्जेक्ट स्टोरेज पर निर्मित होती है, जो इलास्टिक स्केलिंग, रेडंडेंसी और लागत-दक्षता प्रदान करती है।
लोकप्रिय विकल्पों में शामिल हैं:
हालाँकि, उन कंपनियों के लिए भी विकल्प हैं जो अपना डेटा अपने डेटा सेंटर्स में होस्ट की गई ऑन-प्रिमाइसेज़ क्लाउड्स में स्टोर करना चाहती हैं।
उदाहरण के लिए, कोई अपने इंफ्रास्ट्रक्चर में MinIO इंस्टॉल कर सकता है। MinIO स्वयं ओपन-सोर्स है और Amazon S3-कम्पैटिबल API प्रदान करता है।
स्टोरेज लेयर की प्रमुख विशेषताओं में शामिल हैं:
डेटा को उसके मूल फ़ॉर्मेट में स्टोर करने से आप भविष्य की प्रोसेसिंग और विश्लेषण के लिए उसकी पूरी क्षमता को बनाए रख सकते हैं।
कैटलॉग और मेटाडेटा प्रबंधन
मेटाडेटा के बिना, डेटा लेक एक डेटा स्वैम्प बन जाता है, क्योंकि अपने डेटा को फिर से ढूँढ़ना और उसके साथ कुशलता से काम करना असंभव हो जाता है।
कैटलॉग और मेटाडेटा लेयर अव्यवस्था में संरचना लाते हैं, जो निम्न का रिकॉर्ड रखते हैं:
यह लेयर सभी उपलब्ध डेटासेट्स को इंडेक्स कर और खोज व एक्सेस कंट्रोल सक्षम कर खोजयोग्यता और उपयोगिता सुनिश्चित करती है। इस लेयर के मानक टूल्स में शामिल हैं:
सहयोग, गवर्नेंस, और परिचालन दक्षता के लिए एक सुदृढ़ मेटाडेटा सिस्टम आवश्यक है।
प्रोसेसिंग और एनालिटिक्स लेयर
यहीं कच्चा डेटा प्रोसेस होकर इनसाइट्स में बदलता है। प्रोसेसिंग लेयर बेसिक ट्रांसफॉर्मेशन्स से लेकर उन्नत एनालिटिक्स और मशीन लर्निंग तक विभिन्न ऑपरेशंस का समर्थन करती है।
सामान्य वर्कफ़्लो में शामिल हैं:
यह लेयर अक्सर बैच और रीयल-टाइम कंप्यूटिंग दोनों शामिल करती है, जो अन्वेषणात्मक डेटा विश्लेषण और प्रोडक्शन वर्कलोड्स को सक्षम बनाती है।
सुरक्षा और गवर्नेंस
मजबूत डेटा लेक आर्किटेक्चर में संवेदनशील डेटा की सुरक्षा और अनुपालन सुनिश्चित करने के लिए इन-बिल्ट तंत्र होना चाहिए। यह भाग महत्वपूर्ण है, क्योंकि डेटा लेक में प्रायः बहुत-सा संवेदनशील डेटा होता है, जो समझौता होने पर संबंधित व्यवसाय को नुकसान पहुँचा सकता है।
उस लेयर की आवश्यक विशेषताओं में शामिल हैं:
लोकप्रिय टूल्स और सेवाएँ:
सुरक्षा अक्सर यह निर्धारित करती है कि क्या डेटा लेक का उपयोग वित्त, हेल्थकेयर या रक्षा जैसी विनियमित उद्योगों में किया जा सकता है।
डेटा लेक के सामान्य उपयोग मामले
डेटा लेक उन उपयोग मामलों के लिए उपयुक्त हैं जहाँ पैमाना, लचीलापन और विविध डेटा प्रकार आवश्यक हैं। वे विभिन्न उद्योगों में आधुनिक डेटा-चालित संचालन और एप्लिकेशंस की नींव के रूप में कार्य करते हैं।
इस अनुभाग में, हम कुछ सबसे सामान्य और प्रभावशाली उपयोग मामलों का अन्वेषण करेंगे जहाँ डेटा लेक केंद्रीय भूमिका निभाते हैं।
बिग डेटा एनालिटिक्स
डेटा लेक के सबसे प्रसिद्ध उपयोगों में से एक बड़े पैमाने पर डेटा एनालिटिक्स को सक्षम करना है।
क्योंकि डेटा लेक डेटा को उसके कच्चे रूप में स्टोर कर सकते हैं, संगठनों को विश्लेषण से पहले हर डेटासेट को साफ़ या संरचित करने की चिंता नहीं करनी पड़ती। यह लॉग्स, सेंसर डेटा, या क्लिकस्ट्रीम एकत्र करते समय आदर्श है, जो पारंपरिक सिस्टम्स के लिए बहुत बड़े या तेज़ी से बदलने वाले होते हैं।
डेटा लेक निम्न संभव बनाते हैं:
उपकरण जैसे Amazon Athena या Google BigQuery डेटा को सीधे लेक में क्वेरी कर सकते हैं, बिना जटिल ट्रांसफॉर्मेशन्स या डेटा को कहीं और ले जाए बिना।
मशीन लर्निंग और AI
डेटा लेक मशीन लर्निंग और AI वर्कफ़्लो के लिए एकदम उपयुक्त हैं।
वे निम्न के लिए आदर्श वातावरण प्रदान करते हैं:
वेयरहाउस से पूर्व-साफ़ किए गए डेटा तक मॉडलों को सीमित करने के बजाय, डेटा वैज्ञानिक समृद्ध, कच्चे डेटा तक पहुँच कर अधिक स्वतंत्र रूप से प्रयोग कर सकते हैं और तेज़ी से इटरेट कर सकते हैं। यह विशेष रूप से NLP, कंप्यूटर विज़न, और टाइम-सीरीज़ फोरकास्टिंग जैसे डोमेन्स में उपयोगी है।
यदि आप देखना चाहते हैं कि Databricks Lakehouse समाधान का AI के लिए कैसे उपयोग किया जा सकता है, तो मैं सिफारिश करता हूँ कि A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists पढ़ें।
केंद्रीकृत डेटा आर्काइविंग
कई संगठन दीर्घकालिक स्टोरेज और आर्काइविंग के लिए डेटा लेक का उपयोग करते हैं।
क्लाउड ऑब्जेक्ट स्टोरेज की कम लागत के कारण, वर्षों का परिचालन डेटा स्टोर करना आर्थिक रूप से संभव है, जिसे रोज़ाना उपयोग नहीं किया जाता, लेकिन अनुपालन और ऑडिट उद्देश्यों, ट्रेंड विश्लेषण, पूर्वानुमान, या भविष्य के ML मॉडलों को प्रशिक्षित करने के लिए सुलभ रहना आवश्यक है।
अधिकांश क्लाउड ऑब्जेक्ट स्टोरेज समाधान आपको स्टोरेज को टियर करने की अनुमति देते हैं ताकि शायद ही एक्सेस किए जाने वाले डेटा को आर्काइव किया जा सके, जबकि लेक को हल्का और कुशल रखा जा सके।
डेटा साइंस प्रयोग
डेटा लेक डेटा वैज्ञानिकों को बिना बाधाओं के कच्चे डेटा का अन्वेषण करने में सक्षम बनाते हैं।
चाहे आप एक त्वरित प्रोटोटाइप बना रहे हों, कोई नया परिकल्पना जाँच रहे हों, या अन्वेषणात्मक डेटा विश्लेषण (EDA) चला रहे हों, लेक आपको लचीली पहुँच देता है:
यह प्रयोगात्मक लेयर नवाचार के लिए आवश्यक है। डेटा लेक आपको नए तरीकों से डेटासेट्स का अन्वेषण करने देते हैं, बिना डेटा इंजीनियरिंग टीम को टिकट सबमिट किए या वेयरहाउस में साफ़ किए गए संस्करण की प्रतीक्षा किए।
डेटा लेक के लाभ और चुनौतियाँ
जहाँ डेटा लेक आधुनिक डेटा वर्कफ़्लो के लिए शक्तिशाली क्षमताएँ प्रदान करते हैं, वहीं इनमें विशिष्ट चुनौतियाँ भी हैं। डेटा लेक आर्किटेक्चर अपनाने से पहले दोनों पहलुओं को समझना आवश्यक है। इस अनुभाग में, मैं मुख्य लाभों, आम खामियों और उन्हें कैसे दूर करें, पर चर्चा करूँगा।
डेटा लेक के लाभ
डेटा लेक का सबसे बड़ा लाभ इसका लचीलापन है। आप शुरुआत से किसी विशिष्ट स्कीमा या डेटा मॉडल से बँधे नहीं होते, जो तेज़ी से बदलते या विकसित होते डेटासेट्स के साथ काम करते समय उत्कृष्ट है।
यहाँ कुछ प्रमुख लाभ हैं:
जिन प्रोजेक्ट्स पर मैंने काम किया है, उनमें इस केंद्रीकरण ने डेटा साइलो को कम किया है और क्रॉस-टीम सहयोग को उल्लेखनीय रूप से सुधारा है।
मुख्य चुनौतियाँ
डेटा लेक शक्तिशाली हैं, फिर भी कुछ प्रमुख चुनौतियाँ हैं जिन्हें मैनेज करना होता है। यदि इन्हें मैनेज न किया जाए, तो वे जल्दी ही अव्यवस्थित और अनुपयोगी हो सकते हैं, जिसे अक्सर डेटा स्वैम्प कहा जाता है।
कुछ सामान्य चुनौतियाँ शामिल हैं:
ये समस्याएँ डेटा लेक में विश्वास को कम कर सकती हैं और व्यवसाय भर में अपनाने को घटा सकती हैं।
चुनौतियों को कैसे कम करें
सबसे सफल डेटा लेक में मजबूत मेटाडेटा और लाइफसाइकिल प्रबंधन प्रथाएँ होती हैं।
जोखिम कम करने और अपने डेटा लेक को स्वस्थ रखने के लिए ये कदम उठाएँ:
शुरुआत से एक साफ़-सुथरा आर्किटेक्चर डिज़ाइन कर और सुदृढ़ गवर्नेंस संरचनाएँ स्थापित कर, डेटा लेक एक संपत्ति बना रह सकता है, दायित्व नहीं।
डेटा लेक हेल्थ मैनेजमेंट फ़्रेमवर्क। चित्र: लेखक द्वारा।
लोकप्रिय डेटा लेक तकनीकें
आधुनिक डेटा आर्किटेक्चर में डेटा लेक के बढ़ते महत्व के साथ, उन्हें समर्थन देने के लिए व्यापक तकनीकों का उदय हुआ है। ये टूल्स क्लाउड-नेटिव प्लेटफ़ॉर्म, ओपन-सोर्स इकोसिस्टम, और एनालिटिक्स समाधानों के साथ इंटीग्रेशन्स तक फैले हैं। इस अनुभाग में, मैं आपको सबसे लोकप्रिय टूल्स से परिचित कराऊँगा।
क्लाउड-नेटिव समाधान
क्लाउड प्रदाता डेटा लेक बनाने और बनाए रखने के लिए पूर्ण-प्रबंधित सेवाएँ प्रदान करते हैं। ये प्लेटफ़ॉर्म अक्सर उन टीमों के लिए शुरुआती बिंदु होते हैं जो स्केल, दृढ़ता, और अन्य क्लाउड सेवाओं के साथ कड़े इंटीग्रेशन की तलाश में होती हैं।
लोकप्रिय क्लाउड-नेटिव समाधानों में शामिल हैं:
ये सेवाएँ इलास्टिसिटी, लागत-दक्षता, और सुरक्षा के लिए ऑप्टिमाइज़्ड हैं, जिससे ये एंटरप्राइज़-स्केल डेटा लेक के लिए आदर्श बनती हैं।
ओपन-सोर्स टूल्स
ओपन-सोर्स तकनीकें लचीलापन और विस्तारशीलता जोड़ती हैं, खासकर उन टीमों के लिए जो वेंडर लॉक-इन से बचना चाहती हैं या हाइब्रिड/मल्टी-क्लाउड परिवेश में काम करना चाहती हैं।
लोकप्रिय समाधान शामिल हैं:
ये टूल्स अक्सर व्यापक डेटा प्लेटफ़ॉर्म्स में इंटीग्रेट होते हैं और कस्टम या मॉड्यूलर समाधान बनाने वाली इंजीनियरिंग टीमों द्वारा पसंद किए जाते हैं।
यदि आप Apache Iceberg और Delta Lake के बीच के अंतर को और विस्तार से खोजना चाहते हैं, तो मैं सिफारिश करता हूँ कि Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases पढ़ें।
एनालिटिक्स प्लेटफ़ॉर्म्स के साथ इंटीग्रेशन
जब डेटा लेक को ऐसे एनालिटिक्स और विज़ुअलाइज़ेशन टूल्स के साथ इंटीग्रेट किया जाता है जो इनसाइट्स निकालने और व्यावसायिक निर्णयों को प्रेरित करने में मदद करते हैं, तब यह मूल्यवान बनता है। इसलिए, अंतिम समाधान चुनने से पहले, यह हमेशा पहले से जाँच लेना चाहिए कि डेटा लेक समाधान किन एनालिटिक्स प्लेटफ़ॉर्म्स के साथ इंटीग्रेट होना चाहिए।
लोकप्रिय एनालिटिक्स प्लेटफ़ॉर्म्स में शामिल हैं:
यदि आप Databricks के बारे में अधिक सीखना चाहते हैं, तो मैं Introduction to Databricks कोर्स की सिफारिश करता हूँ।
तकनीकें चुनते समय, उन्हें आपकी टीम की विशेषज्ञता, आपकी डेटा रणनीति, और आपको आवश्यक लचीलेपन या एब्स्ट्रैक्शन के स्तर के साथ संरेखित करना आवश्यक है।
निष्कर्ष
डेटा लेक लचीला, स्केलेबल, कच्चा और अर्ध-संरचित डेटा आधार प्रदान करके संगठनों को मजबूत मशीन लर्निंग एप्लिकेशंस और रीयल-टाइम डैशबोर्ड बनाने में सक्षम बनाते हैं।
इस लेख में, हमने देखा कि डेटा लेक क्या है, इसके प्रमुख घटक क्या हैं, और कब इसका उपयोग करना चाहिए। हमने लचीलापन और स्केलेबिलिटी जैसे लाभों, डेटा गवर्नेंस और "डेटा स्वैम्प" के जोखिम जैसी चुनौतियों, और उनसे कैसे बचें, पर चर्चा की। अंत में, हमने डेटा लेक बनाने के लिए लोकप्रिय तकनीकों को कवर किया, जिनमें क्लाउड प्लेटफ़ॉर्म्स और ओपन-सोर्स टूल्स शामिल हैं।
MLOps, AI इंफ्रास्ट्रक्चर, और क्लाउड-नेटिव डेटा सिस्टम्स में काम करने के अपने अनुभव से, मैंने देखा है कि एक अच्छे से अभिकल्पित डेटा लेक टीमों के सहयोग और नवाचार के तरीके को कैसे बदल सकता है। लेकिन मैंने यह भी देखा है कि एक खराब शासित डेटा लेक कितनी जल्दी दायित्व बन सकता है, और उसमें नेविगेट करना कितना कठिन हो सकता है।
यदि आपका संगठन जटिल, विविध, या बड़े पैमाने के डेटा को संभालता है और तेज़ प्रयोग, समृद्ध एनालिटिक्स, या AI विकास सक्षम करना चाहता है, तो डेटा लेक ही शायद आपकी ज़रूरत है।
यदि आप और सीखना चाहते हैं, तो Understanding Modern Data Architecture कोर्स एक बेहतरीन शुरुआती पड़ाव है।