Avendo supportato team data con piattaforme di MLOps e avendo contribuito a progettare infrastrutture scalabili, ho visto in prima persona quanto i data lake siano cruciali nell’attuale data stack.
A differenza dei tradizionali data warehouse, che richiedono dati puliti e strutturati prima dell’archiviazione, i data lake ti permettono di memorizzare tutto in formati grezzi, disordinati e non strutturati. Questa flessibilità sblocca un mondo di possibilità per applicazioni e casi d’uso data-driven. Un data lake ti consente di raccogliere e conservare dati da varie fonti in un unico posto, dove possono essere analizzati ulteriormente e usati per l’AI.
In questo articolo ti spiegherò cos’è un data lake, come funziona, quando usarlo e come si confronta con soluzioni più tradizionali.
Comprendere il concetto di data lake
Prima di parlare di architetture tecniche o casi d’uso, è essenziale capire cos’è un data lake e cosa lo distingue dai sistemi di archiviazione più tradizionali.
Questa sezione definisce il concetto, ne scompone le caratteristiche chiave e lo confronta con il mondo più strutturato dei data warehouse.
Ti consiglio il corso Data Strategy se vuoi approfondire come una strategia dati ben progettata può aiutare le aziende.
Definizione di data lake
Un data lake è un repository centralizzato che memorizza tutti i tuoi dati strutturati, semi-strutturati e non strutturati a qualsiasi scala.
Puoi acquisire dati grezzi da varie fonti e mantenerli nel loro formato originale finché non hai bisogno di elaborarli o analizzarli.
A differenza di database o data warehouse, che in genere richiedono uno schema predefinito (schema-on-write), i data lake adottano un approccio schema-on-read. Significa che la struttura viene applicata solo quando i dati vengono acceduti per l’analisi, offrendo ai team flessibilità nell’interpretare e trasformare i dati in un secondo momento.
Caratteristiche principali
Un data lake presenta le seguenti caratteristiche principali:
- Scalabilità: i data lake sono progettati per scalare orizzontalmente. Che tu stia archiviando terabyte o petabyte di dati, soluzioni di object storage in cloud come Amazon S3 o Azure Data Lake Storage rendono facile crescere senza preoccuparti della capacità.
- Schema-on-read: non devi definire lo schema quando archivi i dati. Invece, data scientist, analisti o ingegneri possono applicare schemi diversi a seconda del caso d’uso durante il recupero o la trasformazione.
- Archiviazione di dati grezzi: i data lake conservano tutti i tipi di dati nel loro formato nativo, che si tratti di file CSV, log JSON, file audio, video o dati da sensori.
- Supporto per tipi di dati eterogenei: puoi archiviare in un unico posto dati strutturati (es. tabelle SQL), semi-strutturati (es. XML, JSON) e non strutturati (es. immagini, PDF, testo).
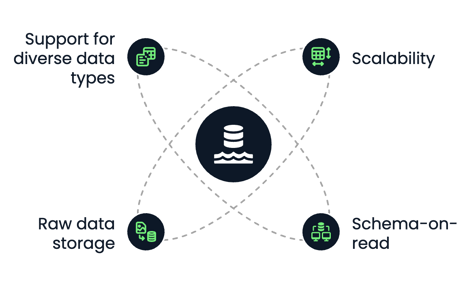
Caratteristiche principali dei data lake. Immagine dell’Autore.
Confronto con i data warehouse
I data lake e i data warehouse vengono usati per archiviare e analizzare dati. Tuttavia, differiscono in modo significativo per struttura, prestazioni e casi d’uso.
Se sei alle prime armi con i data warehouse e vuoi saperne di più, ti consiglio il corso Data Warehousing Concepts e gli articoli What Is a Data Warehouse e Data Warehouse Architecture: Trends, Tools, and Techniques.
Vediamo in cosa si differenziano:
|
Caratteristica
|
Data lake
|
Data warehouse
|
|
Tipo di dato
|
Strutturato, semi-strutturato, non strutturato
|
Solo strutturato
|
|
Formato di archiviazione
|
Grezzo (file oggetto)
|
Processato (tabelle, righe, colonne)
|
|
Schema
|
Schema-on-read
|
Schema-on-write
|
|
Costo
|
Storage a basso costo
|
Più costoso per GB
|
|
Caso d’uso
|
Machine learning, big data e archiviazione di dati grezzi
|
Business intelligence, analytics strutturati
|
|
Prestazioni
|
Flessibili, dipendono dal motore di calcolo
|
Ottimizzate per query SQL veloci
|
Nella pratica, molte strategie dati moderne combinano entrambe: usando i data lake come base per l’archiviazione dei dati grezzi e i data warehouse per reportistica strutturata e business intelligence.
Esiste anche una soluzione ibrida chiamata data lakehouse. L’articolo What is a Data Lakehouse? Architecture, Technology & Use Cases la spiega più approfonditamente.
Componenti di un’architettura di data lake
Un’architettura di data lake ben progettata è essenziale per rendere i dati grezzi utilizzabili e accessibili ad analytics, machine learning e reporting a valle.
Questa sezione suddivide i cinque livelli chiave di un data lake moderno, dall’ingestione alla governance.
Livello di ingestione dati
Il livello di ingestione porta i dati da varie fonti nel data lake. Queste fonti includono sistemi interni (come database o CRM), API esterne o dispositivi IoT e log.
Esistono tre modalità principali di ingestione:
- Ingestione batch: caricamento periodico dei dati (ad esempio notturno) in batch.
- Ingestione in streaming: flussi di dati in tempo reale, come clickstream o dati da sensori.
- Ingestione ibrida: una combinazione di batch e streaming, comune negli ambienti enterprise.
Strumenti standard di ingestione includono:
- Apache Kafka e AWS Kinesis per lo streaming
- Apache NiFi, Flume, e AWS Glue per ETL batch
Un livello di ingestione flessibile assicura che i dati arrivino rapidamente e gestisce una varietà di formati e velocità.
Livello di storage
Quando i dati vengono acquisiti, sono archiviati nella raw zone del data lake. Il livello di storage è di solito costruito su object storage in cloud, che offre scalabilità elastica, ridondanza ed efficienza dei costi.
Opzioni popolari includono:
- Amazon S3
- Azure Data Lake Storage
- Google Cloud Storage
Esistono però anche opzioni per aziende che vogliono archiviare i propri dati nei cloud on-premise ospitati nei loro data center.
Si può, ad esempio, installare MinIO nella propria infrastruttura. MinIO è open source e offre un’API compatibile con Amazon S3.
Le funzionalità chiave di un livello di storage includono:
- Durabilità e disponibilità: i dati sono replicati automaticamente tra regioni.
- Separazione di storage e compute: puoi scalare il calcolo in modo indipendente in base alla domanda.
- Tiering dei dati: consente cold storage per archiviazione e hot storage per dati ad accesso frequente.
Archiviare i dati nel loro formato originale ti permette di conservarne tutto il potenziale per elaborazioni e analisi future.
Senza metadati, un data lake diventa una palude di dati, perché è impossibile ritrovare i dati e lavorarci in modo efficiente.
Il livello di catalogo e metadati porta struttura nel caos tenendo traccia di:
- Schema dei dati
- Posizione e partizionamento dei dati
- Lineage e versioning
Questo livello garantisce reperibilità e usabilità indicizzando tutti i dataset disponibili e abilitando ricerca e controllo degli accessi. Strumenti standard per questo livello includono:
- AWS Glue Data Catalog
- Apache Hive Metastore
- Apache Atlas
- DataHub
Un buon sistema di metadati è essenziale per collaborazione, governance ed efficienza operativa.
Livello di processing e analytics
È il livello in cui i dati grezzi vengono processati e trasformati in insight. Il livello di processing supporta varie operazioni, dalle trasformazioni di base all’analisi avanzata e al machine learning.
Flussi di lavoro tipici includono:
- Pipeline ETL/ELT per pulizia e normalizzazione dei dati
- Query SQL
- Pipeline di machine learning
Questo livello spesso include calcolo batch e in tempo reale, abilitando analisi esplorativa e carichi di lavoro in produzione.
Sicurezza e governance
Un’architettura di data lake solida deve integrare meccanismi per proteggere i dati sensibili e garantire la conformità. Questa parte è cruciale, poiché i data lake contengono spesso molti dati sensibili che, se compromessi, potrebbero danneggiare l’azienda a cui appartengono.
Le funzionalità essenziali di questo livello includono:
- Identity and Access Management (IAM): limita chi può vedere o modificare i dati.
- Crittografia: crittografia in transito (TLS) e a riposo.
- Mascheramento e anonimizzazione dei dati: per gestire informazioni personali identificabili.
- Auditing e monitoraggio: per tracciabilità e conformità.
Strumenti e servizi popolari:
- AWS Lake Formation
- Apache Ranger
- Azure Purview
La sicurezza spesso determina se un data lake può essere usato in settori regolamentati come finanza, sanità o ambito militare.
Casi d’uso comuni dei data lake
I data lake sono ideali per casi d’uso in cui scala, flessibilità e varietà di tipi di dati sono essenziali. Rappresentano la base per operazioni e applicazioni moderne basate sui dati in diversi settori.
In questa sezione esploreremo alcuni dei casi d’uso più comuni e di impatto in cui i data lake svolgono un ruolo centrale.
Big data analytics
Uno degli utilizzi più noti dei data lake è abilitare analytics su larga scala.
Poiché i data lake possono memorizzare i dati in forma grezza, le organizzazioni non devono più preoccuparsi di pulire o strutturare ogni dataset prima dell’analisi. Questo è ideale quando si raccolgono log, dati da sensori o clickstream, troppo grandi o in rapido cambiamento per i sistemi tradizionali.
I data lake rendono possibile:
- Analizzare dati storici insieme a dati in tempo reale
- Eseguire query personalizzate su dataset a scala petabyte
- Abilitare analytics trasversali ai reparti con un’unica fonte di verità
Strumenti come Amazon Athena o Google BigQuery possono interrogare i dati direttamente nel lake senza richiedere trasformazioni complesse o lo spostamento dei dati altrove.
Machine learning e AI
I data lake sono perfetti per i workflow di machine learning e AI.
Offrono l’ambiente ideale per:
- Archiviare dataset di training in più formati (es. CSV, Parquet, immagini, ecc.)
- Mantenere dati grezzi e quindi più completi, consentendo maggiore flessibilità nell’esplorare, sperimentare e iterare sui modelli di ML
- Alimentare pipeline di ML automatizzate che iterano su volumi massivi di dati
Invece di limitare i modelli a dati pre-puliti da un warehouse, i data scientist possono accedere a dati ricchi e grezzi per sperimentare più liberamente e iterare più velocemente. È particolarmente utile in ambiti come NLP, computer vision e forecasting di serie temporali.
Se vuoi un esempio di come la soluzione Databricks Lakehouse possa essere usata per l’AI, ti consiglio di leggere A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists.
Archiviazione centralizzata dei dati
Molte organizzazioni usano i data lake per l’archiviazione a lungo termine.
Grazie al basso costo dell’object storage in cloud, è economicamente sostenibile archiviare anni di dati operativi che potrebbero non essere usati quotidianamente ma devono rimanere accessibili per conformità e audit, analisi di trend, forecasting o per addestrare futuri modelli di ML.
La maggior parte delle soluzioni di object storage in cloud permette di effettuare il tiering, così da archiviare i dati raramente accessi mantenendo il lake snello ed efficiente.
Sperimentazione in data science
I data lake danno potere ai data scientist di esplorare i dati grezzi senza vincoli.
Che tu stia costruendo un prototipo veloce, testando una nuova ipotesi o eseguendo analisi esplorative (EDA), il lake ti offre accesso flessibile a:
- Dati grezzi non strutturati (come PDF, email, file di testo)
- Formati semi-strutturati (come JSON, XML o log)
- Dataset enormi che non entrerebbero in un DB tradizionale
Questo livello di sperimentazione è essenziale per l’innovazione. I data lake ti permettono di esplorare i dataset in modi nuovi senza dover aprire ticket al team di data engineering o aspettare una versione pulita nel warehouse.
Vantaggi e sfide dei data lake
Sebbene i data lake offrano capacità potenti per i workflow dati moderni, presentano anche sfide specifiche. Comprendere entrambi gli aspetti è essenziale prima di adottare un’architettura di data lake. In questa sezione discuterò i principali benefici, le insidie comuni e come superarle.
Benefici dei data lake
Il vantaggio più significativo di un data lake è la flessibilità. Non sei vincolato da subito a uno schema o a un modello dati specifico, il che è ottimo quando lavori con dataset in rapida evoluzione.
Ecco alcuni benefici chiave:
- Scalabilità: i data lake si basano su storage cloud-native che scala senza sforzo, che tu stia archiviando gigabyte o petabyte.
- Supporto per tutti i tipi di dati: dati strutturati (tabelle SQL), semi-strutturati (JSON, XML) e non strutturati (testo, immagini, video) possono essere archiviati sulla stessa piattaforma.
- Convenienza economica: l’object storage in cloud (ad es. Amazon S3) è significativamente più economico dello storage usato da database o warehouse tradizionali.
- Architettura disaccoppiata: compute e storage sono separati per scalare i carichi analitici in modo indipendente dallo storage dei dati.
- Analytics avanzati: i data lake memorizzano dati grezzi e non elaborati e abilitano analisi più complete e flessibili, incluso machine learning e predictive analytics.
- Decisioni migliori: i data lake possono abilitare analisi più profonde e complete, portando a decisioni meglio informate in tutta l’organizzazione.
- Eliminazione dei silos di dati: i data lake aiutano ad abbattere i silos consolidando dati da varie fonti in un unico repository centralizzato.
Nei progetti a cui ho lavorato, questa centralizzazione ha ridotto i silos e migliorato notevolmente la collaborazione cross-team.
Sfide principali
I data lake sono potenti, ma presentano alcune sfide chiave da gestire. Se trascurati, possono diventare rapidamente disorganizzati e inutilizzabili, uno stato spesso chiamato data swamp.
Alcune sfide comuni includono:
- Mancanza di struttura: senza schemi predefiniti, i dati possono essere difficili da interrogare, documentare o governare.
- Problemi di qualità dei dati: poiché i dati vengono acquisiti in forma grezza, dati di scarsa qualità o incompleti possono passare inosservati fino a valle.
- Lacune in metadati e reperibilità: senza un forte sistema di catalogazione, gli utenti potrebbero non sapere quali dati esistono o come usarli.
- Governance complessa: garantire controllo degli accessi, auditabilità e conformità è più difficile in un ambiente flessibile.
Questi problemi possono ridurre la fiducia nel data lake e frenarne l’adozione in azienda.
Come mitigare le sfide
I data lake di maggior successo hanno pratiche solide di gestione dei metadati e del ciclo di vita.
Ecco come ridurre il rischio e mantenere il tuo data lake in salute:
- Implementa un data catalog: strumenti come AWS Glue o DataHub aiutano a mantenere reperibilità, definizioni di schema e tracciamento della lineage.
- Usa convenzioni standard di naming e struttura delle cartelle: crea coerenza e riduce la confusione tra i team.
- Adotta strumenti di validazione e profilazione dei dati: assicurati della qualità durante l’ingestione e rivalida periodicamente i dati.
- Automatizza le policy di ciclo di vita: sposta automaticamente i dati obsoleti nel cold storage o eliminali dopo un periodo di conservazione definito.
- Applica controllo degli accessi e crittografia robusti: per proteggere i dati sensibili, usa policy IAM, accesso basato su ruoli e crittografia a riposo e in transito.
Un data lake può rimanere un asset e non diventare un rischio progettando un’architettura pulita fin dall’inizio e istituendo solide strutture di governance.
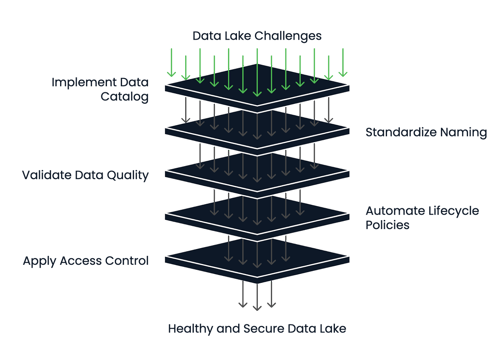
Framework di gestione della salute del data lake. Immagine dell’Autore.
Tecnologie popolari per i data lake
Con la crescente importanza dei data lake nelle architetture dati moderne, è emersa un’ampia gamma di tecnologie a supporto. Questi strumenti spaziano da piattaforme cloud-native, ecosistemi open source e integrazioni con soluzioni di analytics. In questa sezione ti guiderò tra gli strumenti più popolari.
Soluzioni cloud-native
I provider cloud offrono servizi completamente gestiti per costruire e mantenere data lake. Queste piattaforme sono spesso il punto di partenza per team che cercano scala, durabilità e integrazione stretta con altri servizi cloud.
Soluzioni cloud-native popolari includono:
- Amazon S3 + AWS Lake Formation: S3 fornisce object storage, mentre Lake Formation gestisce permessi, catalogazione e governance.
- Azure Data Lake Storage: combina blob storage con funzionalità simili a HDFS.
- Google Cloud Storage (GCS): GCS è altamente durevole e si integra bene con BigQuery e Vertex AI per carichi di lavoro di analytics e ML.
Questi servizi sono ottimizzati per elasticità, convenienza economica e sicurezza, rendendoli ideali per data lake a scala enterprise.
Strumenti open source
Le tecnologie open source aggiungono flessibilità ed estendibilità, specialmente per team che vogliono evitare il lock-in del fornitore o operare in ambienti ibridi/multi-cloud.
Soluzioni popolari includono:
- Apache Hadoop: uno dei framework originali per i data lake. Sebbene oggi sia meno comune per nuovi progetti, ha posto le basi per archiviazione ed elaborazione distribuite dei dati.
- Delta Lake: sviluppato da Databricks, aggiunge transazioni ACID, versioning e enforcement dello schema all’object storage in cloud.
- Apache Iceberg: Iceberg offre operazioni atomiche, partizionamento nascosto e time travel per interrogare dati storici.
- Presto: un motore di query SQL distribuito che consente query veloci e interattive su dati archiviati in S3, HDFS o altre sorgenti senza spostare i dati.
Questi strumenti spesso si integrano in piattaforme dati più ampie e sono apprezzati dai team di ingegneria che costruiscono soluzioni personalizzate o modulari.
Se vuoi esplorare più nel dettaglio le differenze tra Apache Iceberg e Delta Lake, ti consiglio di leggere Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases.
Un data lake diventa prezioso quando è integrato con strumenti di analytics e visualizzazione che aiutano a estrarre insight e guidare decisioni di business. Pertanto, prima di selezionare la soluzione finale, è sempre opportuno verificare in anticipo con quali piattaforme di analytics la soluzione di data lake dovrà integrarsi.
Piattaforme di analytics popolari includono:
- Databricks: combina storage di data lake con uno spazio di lavoro collaborativo per data engineering, machine learning e analytics. Supporta Delta Lake già out of the box.
- Snowflake: sebbene tradizionalmente un data warehouse, Snowflake può interrogare dati esterni nello storage cloud (tramite Snowpipe o tabelle esterne), diventando una soluzione lakehouse ibrida.
- Power BI, Tableau: questi strumenti di BI possono connettersi ai data lake direttamente o tramite motori di query come Athena o BigQuery, abilitando dashboarding e reporting su dati grezzi o semi-strutturati.
Se vuoi saperne di più su Databricks, ti consiglio il corso Introduction to Databricks.
Quando scegli le tecnologie, è essenziale allinearle all’expertise del tuo team, alla tua strategia dati e al livello di flessibilità o astrazione di cui hai bisogno.
Conclusione
I data lake consentono alle organizzazioni di costruire applicazioni di machine learning robuste e dashboard in tempo reale offrendo una base dati flessibile, scalabile, grezza e semi-strutturata.
In questo articolo abbiamo esplorato cos’è un data lake, i suoi componenti chiave e quando usarne uno. Abbiamo discusso i benefici come flessibilità e scalabilità, le sfide come la governance dei dati e il rischio di una "palude di dati", e come evitarle. Infine, abbiamo trattato le tecnologie più popolari per costruire data lake, incluse piattaforme cloud e strumenti open source.
Dalla mia esperienza in MLOps, infrastrutture AI e sistemi dati cloud-native, ho visto come un data lake ben architettato possa trasformare il modo in cui i team collaborano e innovano. Ma ho anche visto quanto rapidamente un data lake mal governato possa diventare un rischio, rendendo difficile orientarsi.
Se la tua organizzazione gestisce dati complessi, eterogenei o su larga scala e vuole abilitare sperimentazione più rapida, analytics più ricchi o sviluppo di AI, un data lake potrebbe essere proprio ciò di cui hai bisogno.
Il corso Understanding Modern Data Architecture è un ottimo primo passo se vuoi saperne di più.





Avendo supportato team data con piattaforme di MLOps e avendo contribuito a progettare infrastrutture scalabili, ho visto in prima persona quanto i data lake siano cruciali nell’attuale data stack.
A differenza dei tradizionali data warehouse, che richiedono dati puliti e strutturati prima dell’archiviazione, i data lake ti permettono di memorizzare tutto in formati grezzi, disordinati e non strutturati. Questa flessibilità sblocca un mondo di possibilità per applicazioni e casi d’uso data-driven. Un data lake ti consente di raccogliere e conservare dati da varie fonti in un unico posto, dove possono essere analizzati ulteriormente e usati per l’AI.
In questo articolo ti spiegherò cos’è un data lake, come funziona, quando usarlo e come si confronta con soluzioni più tradizionali.
Comprendere il concetto di data lake
Prima di parlare di architetture tecniche o casi d’uso, è essenziale capire cos’è un data lake e cosa lo distingue dai sistemi di archiviazione più tradizionali.
Questa sezione definisce il concetto, ne scompone le caratteristiche chiave e lo confronta con il mondo più strutturato dei data warehouse.
Ti consiglio il corso Data Strategy se vuoi approfondire come una strategia dati ben progettata può aiutare le aziende.
Definizione di data lake
Un data lake è un repository centralizzato che memorizza tutti i tuoi dati strutturati, semi-strutturati e non strutturati a qualsiasi scala.
Puoi acquisire dati grezzi da varie fonti e mantenerli nel loro formato originale finché non hai bisogno di elaborarli o analizzarli.
A differenza di database o data warehouse, che in genere richiedono uno schema predefinito (schema-on-write), i data lake adottano un approccio schema-on-read. Significa che la struttura viene applicata solo quando i dati vengono acceduti per l’analisi, offrendo ai team flessibilità nell’interpretare e trasformare i dati in un secondo momento.
Caratteristiche principali
Un data lake presenta le seguenti caratteristiche principali:
Caratteristiche principali dei data lake. Immagine dell’Autore.
Confronto con i data warehouse
I data lake e i data warehouse vengono usati per archiviare e analizzare dati. Tuttavia, differiscono in modo significativo per struttura, prestazioni e casi d’uso.
Se sei alle prime armi con i data warehouse e vuoi saperne di più, ti consiglio il corso Data Warehousing Concepts e gli articoli What Is a Data Warehouse e Data Warehouse Architecture: Trends, Tools, and Techniques.
Vediamo in cosa si differenziano:
Caratteristica
Data lake
Data warehouse
Tipo di dato
Strutturato, semi-strutturato, non strutturato
Solo strutturato
Formato di archiviazione
Grezzo (file oggetto)
Processato (tabelle, righe, colonne)
Schema
Schema-on-read
Schema-on-write
Costo
Storage a basso costo
Più costoso per GB
Caso d’uso
Machine learning, big data e archiviazione di dati grezzi
Business intelligence, analytics strutturati
Prestazioni
Flessibili, dipendono dal motore di calcolo
Ottimizzate per query SQL veloci
Nella pratica, molte strategie dati moderne combinano entrambe: usando i data lake come base per l’archiviazione dei dati grezzi e i data warehouse per reportistica strutturata e business intelligence.
Esiste anche una soluzione ibrida chiamata data lakehouse. L’articolo What is a Data Lakehouse? Architecture, Technology & Use Cases la spiega più approfonditamente.
Componenti di un’architettura di data lake
Un’architettura di data lake ben progettata è essenziale per rendere i dati grezzi utilizzabili e accessibili ad analytics, machine learning e reporting a valle.
Questa sezione suddivide i cinque livelli chiave di un data lake moderno, dall’ingestione alla governance.
Livello di ingestione dati
Il livello di ingestione porta i dati da varie fonti nel data lake. Queste fonti includono sistemi interni (come database o CRM), API esterne o dispositivi IoT e log.
Esistono tre modalità principali di ingestione:
Strumenti standard di ingestione includono:
Un livello di ingestione flessibile assicura che i dati arrivino rapidamente e gestisce una varietà di formati e velocità.
Livello di storage
Quando i dati vengono acquisiti, sono archiviati nella raw zone del data lake. Il livello di storage è di solito costruito su object storage in cloud, che offre scalabilità elastica, ridondanza ed efficienza dei costi.
Opzioni popolari includono:
Esistono però anche opzioni per aziende che vogliono archiviare i propri dati nei cloud on-premise ospitati nei loro data center.
Si può, ad esempio, installare MinIO nella propria infrastruttura. MinIO è open source e offre un’API compatibile con Amazon S3.
Le funzionalità chiave di un livello di storage includono:
Archiviare i dati nel loro formato originale ti permette di conservarne tutto il potenziale per elaborazioni e analisi future.
Catalogo e gestione dei metadati
Senza metadati, un data lake diventa una palude di dati, perché è impossibile ritrovare i dati e lavorarci in modo efficiente.
Il livello di catalogo e metadati porta struttura nel caos tenendo traccia di:
Questo livello garantisce reperibilità e usabilità indicizzando tutti i dataset disponibili e abilitando ricerca e controllo degli accessi. Strumenti standard per questo livello includono:
Un buon sistema di metadati è essenziale per collaborazione, governance ed efficienza operativa.
Livello di processing e analytics
È il livello in cui i dati grezzi vengono processati e trasformati in insight. Il livello di processing supporta varie operazioni, dalle trasformazioni di base all’analisi avanzata e al machine learning.
Flussi di lavoro tipici includono:
Questo livello spesso include calcolo batch e in tempo reale, abilitando analisi esplorativa e carichi di lavoro in produzione.
Sicurezza e governance
Un’architettura di data lake solida deve integrare meccanismi per proteggere i dati sensibili e garantire la conformità. Questa parte è cruciale, poiché i data lake contengono spesso molti dati sensibili che, se compromessi, potrebbero danneggiare l’azienda a cui appartengono.
Le funzionalità essenziali di questo livello includono:
Strumenti e servizi popolari:
La sicurezza spesso determina se un data lake può essere usato in settori regolamentati come finanza, sanità o ambito militare.
Casi d’uso comuni dei data lake
I data lake sono ideali per casi d’uso in cui scala, flessibilità e varietà di tipi di dati sono essenziali. Rappresentano la base per operazioni e applicazioni moderne basate sui dati in diversi settori.
In questa sezione esploreremo alcuni dei casi d’uso più comuni e di impatto in cui i data lake svolgono un ruolo centrale.
Big data analytics
Uno degli utilizzi più noti dei data lake è abilitare analytics su larga scala.
Poiché i data lake possono memorizzare i dati in forma grezza, le organizzazioni non devono più preoccuparsi di pulire o strutturare ogni dataset prima dell’analisi. Questo è ideale quando si raccolgono log, dati da sensori o clickstream, troppo grandi o in rapido cambiamento per i sistemi tradizionali.
I data lake rendono possibile:
Strumenti come Amazon Athena o Google BigQuery possono interrogare i dati direttamente nel lake senza richiedere trasformazioni complesse o lo spostamento dei dati altrove.
Machine learning e AI
I data lake sono perfetti per i workflow di machine learning e AI.
Offrono l’ambiente ideale per:
Invece di limitare i modelli a dati pre-puliti da un warehouse, i data scientist possono accedere a dati ricchi e grezzi per sperimentare più liberamente e iterare più velocemente. È particolarmente utile in ambiti come NLP, computer vision e forecasting di serie temporali.
Se vuoi un esempio di come la soluzione Databricks Lakehouse possa essere usata per l’AI, ti consiglio di leggere A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists.
Archiviazione centralizzata dei dati
Molte organizzazioni usano i data lake per l’archiviazione a lungo termine.
Grazie al basso costo dell’object storage in cloud, è economicamente sostenibile archiviare anni di dati operativi che potrebbero non essere usati quotidianamente ma devono rimanere accessibili per conformità e audit, analisi di trend, forecasting o per addestrare futuri modelli di ML.
La maggior parte delle soluzioni di object storage in cloud permette di effettuare il tiering, così da archiviare i dati raramente accessi mantenendo il lake snello ed efficiente.
Sperimentazione in data science
I data lake danno potere ai data scientist di esplorare i dati grezzi senza vincoli.
Che tu stia costruendo un prototipo veloce, testando una nuova ipotesi o eseguendo analisi esplorative (EDA), il lake ti offre accesso flessibile a:
Questo livello di sperimentazione è essenziale per l’innovazione. I data lake ti permettono di esplorare i dataset in modi nuovi senza dover aprire ticket al team di data engineering o aspettare una versione pulita nel warehouse.
Vantaggi e sfide dei data lake
Sebbene i data lake offrano capacità potenti per i workflow dati moderni, presentano anche sfide specifiche. Comprendere entrambi gli aspetti è essenziale prima di adottare un’architettura di data lake. In questa sezione discuterò i principali benefici, le insidie comuni e come superarle.
Benefici dei data lake
Il vantaggio più significativo di un data lake è la flessibilità. Non sei vincolato da subito a uno schema o a un modello dati specifico, il che è ottimo quando lavori con dataset in rapida evoluzione.
Ecco alcuni benefici chiave:
Nei progetti a cui ho lavorato, questa centralizzazione ha ridotto i silos e migliorato notevolmente la collaborazione cross-team.
Sfide principali
I data lake sono potenti, ma presentano alcune sfide chiave da gestire. Se trascurati, possono diventare rapidamente disorganizzati e inutilizzabili, uno stato spesso chiamato data swamp.
Alcune sfide comuni includono:
Questi problemi possono ridurre la fiducia nel data lake e frenarne l’adozione in azienda.
Come mitigare le sfide
I data lake di maggior successo hanno pratiche solide di gestione dei metadati e del ciclo di vita.
Ecco come ridurre il rischio e mantenere il tuo data lake in salute:
Un data lake può rimanere un asset e non diventare un rischio progettando un’architettura pulita fin dall’inizio e istituendo solide strutture di governance.
Framework di gestione della salute del data lake. Immagine dell’Autore.
Tecnologie popolari per i data lake
Con la crescente importanza dei data lake nelle architetture dati moderne, è emersa un’ampia gamma di tecnologie a supporto. Questi strumenti spaziano da piattaforme cloud-native, ecosistemi open source e integrazioni con soluzioni di analytics. In questa sezione ti guiderò tra gli strumenti più popolari.
Soluzioni cloud-native
I provider cloud offrono servizi completamente gestiti per costruire e mantenere data lake. Queste piattaforme sono spesso il punto di partenza per team che cercano scala, durabilità e integrazione stretta con altri servizi cloud.
Soluzioni cloud-native popolari includono:
Questi servizi sono ottimizzati per elasticità, convenienza economica e sicurezza, rendendoli ideali per data lake a scala enterprise.
Strumenti open source
Le tecnologie open source aggiungono flessibilità ed estendibilità, specialmente per team che vogliono evitare il lock-in del fornitore o operare in ambienti ibridi/multi-cloud.
Soluzioni popolari includono:
Questi strumenti spesso si integrano in piattaforme dati più ampie e sono apprezzati dai team di ingegneria che costruiscono soluzioni personalizzate o modulari.
Se vuoi esplorare più nel dettaglio le differenze tra Apache Iceberg e Delta Lake, ti consiglio di leggere Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases.
Integrazione con piattaforme di analytics
Un data lake diventa prezioso quando è integrato con strumenti di analytics e visualizzazione che aiutano a estrarre insight e guidare decisioni di business. Pertanto, prima di selezionare la soluzione finale, è sempre opportuno verificare in anticipo con quali piattaforme di analytics la soluzione di data lake dovrà integrarsi.
Piattaforme di analytics popolari includono:
Se vuoi saperne di più su Databricks, ti consiglio il corso Introduction to Databricks.
Quando scegli le tecnologie, è essenziale allinearle all’expertise del tuo team, alla tua strategia dati e al livello di flessibilità o astrazione di cui hai bisogno.
Conclusione
I data lake consentono alle organizzazioni di costruire applicazioni di machine learning robuste e dashboard in tempo reale offrendo una base dati flessibile, scalabile, grezza e semi-strutturata.
In questo articolo abbiamo esplorato cos’è un data lake, i suoi componenti chiave e quando usarne uno. Abbiamo discusso i benefici come flessibilità e scalabilità, le sfide come la governance dei dati e il rischio di una "palude di dati", e come evitarle. Infine, abbiamo trattato le tecnologie più popolari per costruire data lake, incluse piattaforme cloud e strumenti open source.
Dalla mia esperienza in MLOps, infrastrutture AI e sistemi dati cloud-native, ho visto come un data lake ben architettato possa trasformare il modo in cui i team collaborano e innovano. Ma ho anche visto quanto rapidamente un data lake mal governato possa diventare un rischio, rendendo difficile orientarsi.
Se la tua organizzazione gestisce dati complessi, eterogenei o su larga scala e vuole abilitare sperimentazione più rapida, analytics più ricchi o sviluppo di AI, un data lake potrebbe essere proprio ciò di cui hai bisogno.
Il corso Understanding Modern Data Architecture è un ottimo primo passo se vuoi saperne di più.