MLOps platformlarıyla veri ekiplerini destekleyen ve ölçeklenebilir altyapılar tasarlamaya yardımcı olan biri olarak, veri göllerinin günümüz veri yığınında ne kadar kritik olduğunu bizzat gördüm.
Veri depolamadan önce verinin temiz ve yapılandırılmış olmasını gerektiren geleneksel veri ambarlarının aksine, veri gölleri her şeyi ham, dağınık ve yapılandırılmamış biçimlerde saklamanıza olanak tanır. Bu esneklik, veri odaklı uygulamalar ve kullanım alanları için bir olasılıklar dünyasının kapısını açar. Bir veri gölü, verileri farklı kaynaklardan tek bir yerde toplamanıza ve saklamanıza, ardından daha ileri analiz ve yapay zeka için kullanmanıza olanak sağlar.
Bu yazıda, veri gölünün ne olduğunu, nasıl çalıştığını, ne zaman kullanılması gerektiğini ve daha geleneksel çözümlerle nasıl karşılaştırıldığını açıklayacağım.
Veri Gölü Kavramını Anlamak
Teknik mimariyi veya kullanım alanlarını tartışmadan önce, bir veri gölünün ne olduğunu ve onu daha geleneksel depolama sistemlerinden ayıran noktaları anlamak önemlidir.
Bu bölüm kavramı tanımlar, temel özelliklerini açıklar ve onu daha yapılandırılmış veri ambarları dünyasıyla karşılaştırır.
Daha fazlasını öğrenmek isterseniz Data Strategy kursunu öneririm; iyi tasarlanmış bir veri stratejisinin işletmelere nasıl yardımcı olabileceğini ele alır.
Veri gölü tanımı
Veri gölü, yapılandırılmış, yarı yapılandırılmış ve yapılandırılmamış tüm verilerinizi herhangi bir ölçekte saklayan merkezi bir depodur.
Çeşitli kaynaklardan ham veriyi alabilir ve işlemeye ya da analiz etmeye ihtiyaç duyana kadar orijinal formatında tutabilirsiniz.
Genellikle önceden tanımlı bir şema (yazımda şema) gerektiren veritabanları veya veri ambarlarının aksine, veri gölleri okuma anında şema yaklaşımını kullanır. Bu, yapının yalnızca veri analiz için erişildiğinde uygulandığı anlamına gelir; bu da ekiplerin veriyi daha sonra yorumlama ve dönüştürmede esneklik kazanmasını sağlar.
Temel özellikler
Bir veri gölü aşağıdaki temel özelliklerle gelir:
- Ölçeklenebilirlik: Veri gölleri yatayda ölçeklenecek şekilde tasarlanır. İster terabaytlar ister petabaytlar depoluyor olun, Amazon S3 veya Azure Data Lake Storage gibi bulut tabanlı nesne depolama çözümleri, kapasite endişesi olmadan büyümeyi kolaylaştırır.
- Okuma anında şema: Veriyi depolarken şema tanımlamanız gerekmez. Bunun yerine veri bilimciler, analistler veya mühendisler, geri çağırma veya dönüşüm sırasında kullanım senaryosuna bağlı olarak farklı şemalar uygulayabilir.
- Ham veri depolama: Veri gölleri tüm veri türlerini yerel formatında tutar; CSV dosyaları, JSON günlükleri, ses dosyaları, videolar veya sensör verileri fark etmeksizin.
- Çeşitli veri türlerine destek: Yapılandırılmış (ör. SQL tabloları), yarı yapılandırılmış (ör. XML, JSON) ve yapılandırılmamış (ör. görseller, PDF’ler, metin) verileri tek bir yerde saklayabilirsiniz.
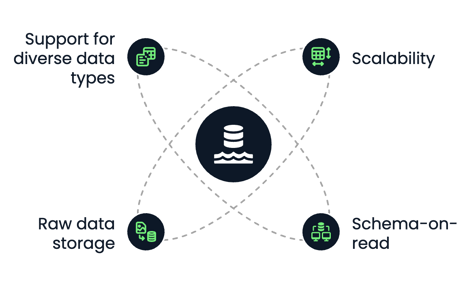
Veri göllerinin temel özellikleri. Görsel: Yazar.
Veri ambarlarıyla karşılaştırma
Veri gölleri ve veri ambarları, verileri depolamak ve analiz etmek için kullanılır. Ancak yapı, performans ve kullanım alanları açısından önemli ölçüde farklıdırlar.
Veri ambarlarına yeniyseniz ve daha fazlasını öğrenmek isterseniz, Data Warehousing Concepts kursunu ve Veri Ambarı Nedir ile Veri Ambarı Mimarisi: Trendler, Araçlar ve Teknikler makalelerini öneririm.
Bakalım nasıl farklılaşıyorlar:
|
Özellik
|
Veri Gölü
|
Veri Ambarı
|
|
Veri türü
|
Yapılandırılmış, yarı yapılandırılmış, yapılandırılmamış
|
Yalnızca yapılandırılmış
|
|
Depolama formatı
|
Ham (dosya nesneleri)
|
İşlenmiş (tablolar, satırlar, sütunlar)
|
|
Şema
|
Okuma anında şema
|
Yazımda şema
|
|
Maliyet
|
Düşük maliyetli depolama
|
GB başına daha pahalı
|
|
Kullanım alanı
|
Makine öğrenimi, büyük veri ve ham veri depolama
|
İş zekâsı, yapılandırılmış analitik
|
|
Performans
|
Esnek, hesaplama motoruna bağlı
|
Hızlı SQL sorguları için optimize edilmiştir
|
Uygulamada, birçok modern veri stratejisi her ikisini birleştirir: ham veri depolama için veri göllerini, yapılandırılmış raporlama ve iş zekâsı için veri ambarlarını kullanır.
Ayrıca veri gölü ile veri ambarını birleştiren bir hibrit çözüm olan veri lakehouse da vardır. Data Lakehouse Nedir? Mimari, Teknoloji ve Kullanım Alanları makalesi bunu daha kapsamlı açıklar.
Veri Gölü Mimarisi Bileşenleri
İyi tasarlanmış bir veri gölü mimarisi, ham veriyi aşağı akıştaki analitik, makine öğrenimi ve raporlama için kullanılabilir ve erişilebilir kılmak açısından esastır.
Bu bölüm, yutmadan yönetişime kadar modern bir veri gölünün beş ana katmanını açıklar.
Veri yutma katmanı
Yutma katmanı, veriyi çeşitli kaynaklardan veri gölüne getirir. Bu kaynaklar; iç sistemler (veritabanları veya CRM’ler gibi), harici API’ler ya da IoT cihazları ve günlükleri olabilir.
Üç ana yutma modu vardır:
- Toplu yutma: Veriyi periyodik olarak (örneğin gecelik) toplu halde yükleme.
- Akış yutma: Tıklama akışı veya sensör verisi gibi gerçek zamanlı veri akışları.
- Hibrit yutma: Kurumsal ortamlarda yaygın olan, hem toplu hem akışın bir kombinasyonu.
Standart yutma araçları şunları içerir:
- Akış için Apache Kafka ve AWS Kinesis
- Apache NiFi, Flume ve toplu ETL için AWS Glue
Esnek bir yutma katmanı, verinin hızlı gelmesini ve çeşitli formatlar ile hızları kaldırabilmeyi sağlar.
Depolama katmanı
Veri yutulduğunda, veri gölünün ham bölgesinde saklanır. Depolama katmanı genellikle esnek ölçekleme, yedeklilik ve maliyet verimliliği sunan bulut nesne depolama üzerinde kurulur.
Popüler seçenekler şunlardır:
- Amazon S3
- Azure Data Lake Storage
- Google Cloud Storage
Ancak verilerini kendi veri merkezlerinde barındırdıkları şirket içi bulutlarda saklamak isteyen şirketler için de seçenekler mevcuttur.
Örneğin, kendi altyapılarına MinIO kurulabilir. MinIO açık kaynaklıdır ve Amazon S3 ile uyumlu bir API sunar.
Depolama katmanının temel özellikleri şunlardır:
- Dayanıklılık ve erişilebilirlik: Veri bölgeler arasında otomatik olarak çoğaltılır.
- Depolama ve hesaplamanın ayrılması: Talebe göre hesaplamayı bağımsızca ölçekleyebilirsiniz.
- Veri katmanlama: Seyrek erişilen veriler için soğuk depolama, sık erişilen veriler için sıcak depolama sağlar.
Veriyi orijinal formatında saklamak, gelecekteki işleme ve analiz için tüm potansiyelini korumanıza olanak tanır.
Meta veri olmadan, bir veri gölü veri bataklığına dönüşür; çünkü verinizi yeniden bulmak ve onunla verimli çalışmak imkânsız hale gelir.
Katalog ve meta veri katmanı; şunları takip ederek kaosa yapı kazandırır:
- Veri şeması
- Veri konumu ve bölümleme
- Soy ağacı ve sürümlendirme
Bu katman, mevcut tüm veri kümelerini dizinleyerek ve arama ile erişim kontrolünü mümkün kılarak keşfedilebilirliği ve kullanılabilirliği sağlar. Bu katman için standart araçlar şunlardır:
- AWS Glue Data Catalog
- Apache Hive Metastore
- Apache Atlas
- DataHub
Sağlam bir meta veri sistemi; işbirliği, yönetişim ve operasyonel verimlilik için gereklidir.
İşleme ve analitik katmanı
Ham verinin işlendiği ve içgörüye dönüştürüldüğü katman burasıdır. İşleme katmanı, temel dönüşümlerden ileri analitik ve makine öğrenimine kadar çeşitli işlemleri destekler.
Tipik iş akışları şunları içerir:
- ETL/ELT boru hatları ile veri temizleme ve normalleştirme
- SQL sorgulama
- Makine öğrenimi boru hatları
Bu katman genellikle hem toplu hem gerçek zamanlı hesaplamayı içerir ve keşif amaçlı veri analizi ile üretim iş yüklerini mümkün kılar.
Güvenlik ve yönetişim
Sağlam bir veri gölü mimarisi, hassas verileri korumak ve uyumluluğu sağlamak için yerleşik mekanizmalara sahip olmalıdır. Bu kısım kritik önemdedir; çünkü veri göllerinde çoğunlukla çok sayıda hassas veri bulunur ve bunların tehlikeye girmesi, ait oldukları işletmeye zarar verebilir.
Bu katmanın temel özellikleri şunlardır:
- Kimlik ve erişim yönetimi (IAM): Veriyi kimlerin görebileceğini veya değiştirebileceğini kısıtlama.
- Şifreleme: Aktarımda (TLS) ve beklemede şifreleme.
- Veri maskeleme ve anonimleştirme: Kişisel olarak tanımlanabilir bilgilerin işlenmesi için.
- Denetim ve izleme: İzlenebilirlik ve uyumluluk için.
Popüler araç ve hizmetler:
- AWS Lake Formation
- Apache Ranger
- Azure Purview
Güvenlik, finans, sağlık veya askeriye gibi düzenlemeye tabi sektörlerde veri gölünün kullanılabilir olup olmadığını çoğu zaman belirler.
Veri Gölleri için Yaygın Kullanım Alanları
Veri gölleri, ölçek, esneklik ve çeşitli veri türlerinin kritik olduğu kullanım alanları için uygundur. Sektörler genelinde modern, veri odaklı operasyon ve uygulamaların temelini oluştururlar.
Bu bölümde, veri göllerinin merkezi rol oynadığı en yaygın ve etkili kullanım alanlarından bazılarını inceleyeceğiz.
Büyük veri analitiği
Veri göllerinin en bilinen kullanım alanlarından biri, büyük ölçekli veri analizini mümkün kılmasıdır.
Veri gölleri veriyi ham haliyle depolayabildiği için, kuruluşların analize geçmeden önce her veri kümesini temizleme veya yapılandırma derdi kalmaz. Bu, geleneksel sistemler için fazla büyük veya hızlı değişen günlükler, sensör verileri veya tıklama akışları toplanırken idealdir.
Veri gölleri şunları mümkün kılar:
- Geçmiş verileri gerçek zamanlı verilerle birlikte analiz etmek
- Petabayt ölçeğindeki veri kümeleri üzerinde özel sorgular çalıştırmak
- Tek bir doğru kaynağıyla bölümler arası analitiği etkinleştirmek
Amazon Athena veya Google BigQuery gibi araçlar, veriyi karmaşık dönüşümler gerektirmeden ya da başka bir yere taşımadan doğrudan göl içinde sorgulayabilir.
Makine öğrenimi ve yapay zeka
Veri gölleri, makine öğrenimi ve yapay zeka iş akışları için mükemmel bir eşleşmedir.
Şunlar için ideal bir ortam sağlarlar:
- Eğitim veri kümelerini birden çok formatta saklamak (ör. CSV, Parquet, görseller vb.)
- Ham ve dolayısıyla daha kapsamlı veriyi tutmak; bu da ML modellerinde keşif, deneme ve yineleme esnekliği sağlar
- Muazzam veri hacimleri üzerinde yineleyen otomatik ML boru hatlarını beslemek
Modelleri bir ambarın önceden temizlenmiş verileriyle sınırlamak yerine, veri bilimciler zengin, ham verilere erişerek daha özgürce deney yapabilir ve daha hızlı yineleyebilir. Bu, özellikle doğal dil işleme (NLP), bilgisayarlı görü ve zaman serisi tahmini gibi alanlarda faydalıdır.
Databricks Lakehouse çözümünün yapay zekâ için nasıl kullanılabileceğine bir örnek görmek isterseniz, şunu okumanızı öneririm: Veri Bilimciler için Kapsamlı Databricks Lakehouse AI Rehberi.
Merkezi veri arşivleme
Birçok kuruluş, uzun vadeli depolama ve arşivleme için veri göllerini kullanır.
Bulut nesne depolamanın düşük maliyeti sayesinde, günlük kullanılmasa bile uyumluluk ve denetim amaçları, trend analizi, tahmin veya gelecekteki ML modellerinin eğitimi için erişilebilir olması gereken yıllarca operasyonel veriyi ekonomik olarak saklamak mümkündür.
Çoğu bulut nesne depolama çözümü, nadiren erişilen verileri arşivlemek için katmanlama yapmanıza, gölü ise yalın ve verimli tutmanıza olanak tanır.
Veri bilimi denemeleri
Veri gölleri, veri bilimcilerin kısıtlama olmaksızın ham veriyi keşfetmesini sağlar.
İster hızlı bir prototip geliştiriyor, ister yeni bir hipotezi test ediyor, ister keşif amaçlı veri analizi (EDA) yürütüyor olun; göl size şunlara esnek erişim sunar:
- Ham yapılandırılmamış veri (PDF’ler, e-postalar, metin dosyaları gibi)
- Yarı yapılandırılmış formatlar (JSON, XML veya günlükler gibi)
- Geleneksel bir veritabanına sığmayacak kadar büyük veri kümeleri
Bu deneme katmanı, inovasyon için gereklidir. Veri gölleri, veri mühendisliği ekibine talep oluşturmanıza veya ambarın temizlenmiş bir sürümünü beklemenize gerek kalmadan veri kümelerini yeni yollarla keşfetmenizi sağlar.
Veri Göllerinin Faydaları ve Zorlukları
Veri gölleri modern veri iş akışları için güçlü yetenekler sunsa da kendilerine özgü zorlukları da vardır. Bir veri gölü mimarisini benimsemeden önce her iki yönü de anlamak esastır. Bu bölümde, başlıca faydaları, yaygın tuzakları ve bunların nasıl aşılacağını tartışacağım.
Veri göllerinin faydaları
Bir veri gölünün en büyük avantajı esnekliğidir. Başından itibaren belirli bir şemaya veya veri modeline bağlı değilsiniz; bu da hızla değişen veya evrilen veri kümeleriyle çalışırken harikadır.
İşte bazı temel faydalar:
- Ölçeklenebilirlik: Veri gölleri, gigabaytlardan petabaytlara kadar zahmetsizce ölçeklenen bulut yerlisi depolama üzerinde kurulur.
- Tüm veri türlerine destek: Yapılandırılmış (SQL tabloları), yarı yapılandırılmış (JSON, XML) ve yapılandırılmamış (metin, görsel, video) veriler aynı platformda saklanabilir.
- Maliyet etkinliği: Bulut nesne depolama (ör. Amazon S3), geleneksel veritabanları veya ambarların kullandığı depolamaya kıyasla önemli ölçüde daha ucuzdur.
- Ayrık mimari: Hesaplama ve depolama ayrıdır; analitik iş yükleri, veri depolamadan bağımsız olarak ölçeklenir.
- Gelişmiş analitik: Veri gölleri ham, işlenmemiş verileri saklar ve makine öğrenimi ile öngörüsel analitik dâhil daha kapsamlı ve esnek analizleri mümkün kılar.
- İyileştirilmiş karar alma: Veri gölleri, kurum genelinde daha iyi bilgilendirilmiş kararlara yol açan daha derin ve kapsamlı analizleri mümkün kılar.
- Veri silolarının ortadan kaldırılması: Veri gölleri, çeşitli kaynaklardan verileri tek bir merkezi depoda birleştirerek veri silolarını kırmaya yardımcı olur.
Çalıştığım projelerde, bu merkezileştirme veri silolarını azalttı ve ekipler arası işbirliğini önemli ölçüde iyileştirdi.
Başlıca zorluklar
Veri gölleri güçlüdür; ancak yönetilmesi gereken bazı temel zorluklar vardır. Yönetimsiz bırakıldıklarında hızla dağınık ve kullanışsız hâle gelebilirler; buna sıklıkla veri bataklığı denir.
Yaygın zorluklardan bazıları şunlardır:
- Yapı eksikliği: Önceden tanımlı şemalar olmadan veriyi sorgulamak, belgelendirmek veya yönetmek zor olabilir.
- Veri kalitesi sorunları: Veri ham halde yutulduğundan, düşük kaliteli veya eksik veriler aşağı akışa kadar fark edilmeyebilir.
- Meta veri ve keşfedilebilirlik boşlukları: Güçlü bir kataloglama sistemi olmadan kullanıcılar hangi verilerin mevcut olduğunu veya nasıl kullanılacağını bilemeyebilir.
- Karmaşık yönetişim: Esnek bir ortamda erişim kontrolü, denetlenebilirlik ve uyumluluğu sağlamak daha zordur.
Bu sorunlar, veri gölüne duyulan güveni ve kurum genelindeki benimsemeyi azaltabilir.
Zorluklar nasıl hafifletilir
En başarılı veri gölleri, güçlü meta veri ve yaşam döngüsü yönetimi uygulamalarına sahiptir.
İşte riski nasıl azaltıp veri gölünüzü sağlıklı tutabileceğiniz:
- Bir veri kataloğu uygulayın: AWS Glue veya DataHub gibi araçlar, keşfedilebilirliği, şema tanımlarını ve soy ağacı takibini sürdürmeye yardımcı olur.
- Standart adlandırma ve klasör yapıları kullanın: Bu, tutarlılık oluşturur ve ekip karmaşasını azaltır.
- Veri doğrulama ve profilleme araçlarını benimseyin: Yutma sırasında kaliteyi güvence altına alın ve periyodik olarak yeniden doğrulayın.
- Yaşam döngüsü politikalarını otomatikleştirin: Bayat verileri otomatik olarak soğuk depolamaya taşıyın veya tanımlı bir saklama süresi sonrasında silin.
- Sağlam erişim kontrolü ve şifreleme uygulayın: Hassas verileri korumak için IAM politikaları, rol tabanlı erişim ve beklemede/aktarımda şifreleme kullanın.
Başından itibaren temiz bir mimari tasarlayarak ve sağlam yönetişim yapıları oluşturarak bir veri gölünün varlık olarak kalmasını ve yük hâline gelmemesini sağlayabilirsiniz.
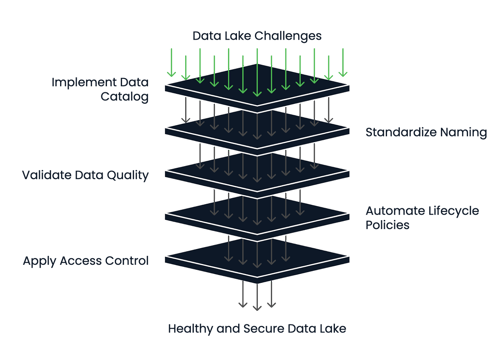
Veri gölü sağlık yönetimi çerçevesi. Görsel: Yazar.
Popüler Veri Gölü Teknolojileri
Veri göllerinin modern veri mimarisindeki önemi arttıkça, onları desteklemek için geniş bir teknoloji yelpazesi ortaya çıktı. Bu araçlar; bulut yerlisi platformlardan açık kaynak ekosistemlerine ve analitik çözümlerle entegrasyonlara kadar uzanır. Bu bölümde en popüler araçları ele alacağım.
Bulut yerlisi çözümler
Bulut sağlayıcıları, veri gölleri kurmak ve sürdürmek için tamamen yönetilen hizmetler sunar. Bu platformlar, ölçek, dayanıklılık ve diğer bulut servisleriyle sıkı entegrasyon arayan ekipler için genellikle başlangıç noktasıdır.
Popüler bulut yerlisi çözümler şunlardır:
- Amazon S3 + AWS Lake Formation: S3 nesne depolama sağlar; Lake Formation ise izinler, kataloglama ve yönetişimi ele alır.
- Azure Data Lake Storage: Blob depolamayı HDFS benzeri yeteneklerle birleştirir.
- Google Cloud Storage (GCS): GCS yüksek dayanıklıdır ve analitik ve ML iş yükleri için BigQuery ve Vertex AI ile iyi entegre olur.
Bu hizmetler esneklik, maliyet etkinliği ve güvenlik için optimize edilmiştir; kurumsal ölçekli veri gölleri için idealdir.
Açık kaynak araçlar
Açık kaynak teknolojiler, özellikle satıcıya bağımlılıktan kaçınmak veya hibrit/çoklu bulut ortamlarında çalışmak isteyen ekipler için esneklik ve genişletilebilirlik sağlar.
Popüler çözümler şunlardır:
- Apache Hadoop: Orijinal veri gölü çerçevelerinden biridir. Yeni projelerde bugün daha az yaygın olsa da, dağıtık veri depolama ve işlemenin temelini atmıştır.
- Delta Lake: Databricks tarafından geliştirilen Delta Lake, bulut nesne depolamaya ACID işlemleri, sürümlendirme ve şema zorlaması ekler.
- Apache Iceberg: Iceberg, atomik işlemler, gizli bölümleme ve geçmiş verileri sorgulamak için zaman yolculuğu sunar.
- Presto: Veriyi taşımadan S3, HDFS veya diğer kaynaklarda saklanan veriler üzerinde hızlı, etkileşimli sorgular yapmanızı sağlayan dağıtık bir SQL sorgu motoru.
Bu araçlar sıklıkla daha geniş veri platformlarına entegre edilir ve özel veya modüler çözümler inşa eden mühendislik ekipleri tarafından tercih edilir.
Apache Iceberg ile Delta Lake arasındaki farkları daha ayrıntılı keşfetmek isterseniz, şunu okumanızı öneririm: Apache Iceberg vs. Delta Lake: Özellikler, Farklar ve Kullanım Alanları.
Bir veri gölü, içgörüleri çıkarmaya ve iş kararlarını yönlendirmeye yardımcı olan analitik ve görselleştirme araçlarıyla entegre edildiğinde değer kazanır. Bu nedenle, nihai çözüm seçilmeden önce veri gölü çözümünün hangi analitik platformlarla entegre edilmesi gerektiği önceden mutlaka kontrol edilmelidir.
Popüler analitik platformlar şunlardır:
- Databricks: Veri gölü depolamasını, veri mühendisliği, makine öğrenimi ve analitik için işbirlikçi bir çalışma alanıyla birleştirir. Kutudan Delta Lake desteğiyle gelir.
- Snowflake: Geleneksel olarak bir veri ambarı olsa da Snowflake, bulut depolamadaki harici verileri (Snowpipe veya harici tablolar aracılığıyla) sorgulayabilir ve bu da onu hibrit bir lakehouse çözümü yapar.
- Power BI, Tableau: Bu BI araçları, doğrudan veya Athena ya da BigQuery gibi sorgu motorları üzerinden veri göllerine bağlanarak ham veya yarı yapılandırılmış veriler üzerinde panolar ve raporlar üretir.
Databricks hakkında daha fazla bilgi edinmek isterseniz, şu kursu öneririm: Introduction to Databricks.
Teknolojileri seçerken, bunların ekibinizin uzmanlığı, veri stratejiniz ve ihtiyaç duyduğunuz esneklik veya soyutlama düzeyiyle uyumlu olmasını sağlamak esastır.
Sonuç
Veri gölleri, esnek, ölçeklenebilir, ham ve yarı yapılandırılmış bir veri temeli sunarak kuruluşların sağlam makine öğrenimi uygulamaları ve gerçek zamanlı panolar oluşturmasını sağlar.
Bu yazıda, veri gölünün ne olduğunu, temel bileşenlerini ve ne zaman kullanılacağını inceledik. Esneklik ve ölçeklenebilirlik gibi faydaları, veri yönetişimi ve "veri bataklığı" riski gibi zorlukları ve bunlardan nasıl kaçınılacağını tartıştık. Son olarak, bulut platformları ve açık kaynak araçlar dâhil veri gölleri inşa etmek için popüler teknolojileri ele aldık.
MLOps, yapay zekâ altyapısı ve bulut yerlisi veri sistemleri genelindeki deneyimime dayanarak, iyi tasarlanmış bir veri gölünün ekiplerin nasıl işbirliği yaptığı ve yenilik yaptığı biçimini nasıl dönüştürebileceğini gördüm. Ancak kötü yönetilen bir veri gölünün ne kadar hızlı bir yük hâline gelebileceğini ve içinde gezinmenin nasıl zorlaşabileceğini de gördüm.
Kuruluşunuz karmaşık, çeşitli veya büyük ölçekli verileri işliyor ve daha hızlı denemeler, daha zengin analitik veya yapay zekâ geliştirme imkânı sağlamak istiyorsa, bir veri gölü tam da ihtiyacınız olan şey olabilir.
Understanding Modern Data Architecture kursu daha fazlasını öğrenmek için harika bir ilk duraktır.





MLOps platformlarıyla veri ekiplerini destekleyen ve ölçeklenebilir altyapılar tasarlamaya yardımcı olan biri olarak, veri göllerinin günümüz veri yığınında ne kadar kritik olduğunu bizzat gördüm.
Veri depolamadan önce verinin temiz ve yapılandırılmış olmasını gerektiren geleneksel veri ambarlarının aksine, veri gölleri her şeyi ham, dağınık ve yapılandırılmamış biçimlerde saklamanıza olanak tanır. Bu esneklik, veri odaklı uygulamalar ve kullanım alanları için bir olasılıklar dünyasının kapısını açar. Bir veri gölü, verileri farklı kaynaklardan tek bir yerde toplamanıza ve saklamanıza, ardından daha ileri analiz ve yapay zeka için kullanmanıza olanak sağlar.
Bu yazıda, veri gölünün ne olduğunu, nasıl çalıştığını, ne zaman kullanılması gerektiğini ve daha geleneksel çözümlerle nasıl karşılaştırıldığını açıklayacağım.
Veri Gölü Kavramını Anlamak
Teknik mimariyi veya kullanım alanlarını tartışmadan önce, bir veri gölünün ne olduğunu ve onu daha geleneksel depolama sistemlerinden ayıran noktaları anlamak önemlidir.
Bu bölüm kavramı tanımlar, temel özelliklerini açıklar ve onu daha yapılandırılmış veri ambarları dünyasıyla karşılaştırır.
Daha fazlasını öğrenmek isterseniz Data Strategy kursunu öneririm; iyi tasarlanmış bir veri stratejisinin işletmelere nasıl yardımcı olabileceğini ele alır.
Veri gölü tanımı
Veri gölü, yapılandırılmış, yarı yapılandırılmış ve yapılandırılmamış tüm verilerinizi herhangi bir ölçekte saklayan merkezi bir depodur.
Çeşitli kaynaklardan ham veriyi alabilir ve işlemeye ya da analiz etmeye ihtiyaç duyana kadar orijinal formatında tutabilirsiniz.
Genellikle önceden tanımlı bir şema (yazımda şema) gerektiren veritabanları veya veri ambarlarının aksine, veri gölleri okuma anında şema yaklaşımını kullanır. Bu, yapının yalnızca veri analiz için erişildiğinde uygulandığı anlamına gelir; bu da ekiplerin veriyi daha sonra yorumlama ve dönüştürmede esneklik kazanmasını sağlar.
Temel özellikler
Bir veri gölü aşağıdaki temel özelliklerle gelir:
Veri göllerinin temel özellikleri. Görsel: Yazar.
Veri ambarlarıyla karşılaştırma
Veri gölleri ve veri ambarları, verileri depolamak ve analiz etmek için kullanılır. Ancak yapı, performans ve kullanım alanları açısından önemli ölçüde farklıdırlar.
Veri ambarlarına yeniyseniz ve daha fazlasını öğrenmek isterseniz, Data Warehousing Concepts kursunu ve Veri Ambarı Nedir ile Veri Ambarı Mimarisi: Trendler, Araçlar ve Teknikler makalelerini öneririm.
Bakalım nasıl farklılaşıyorlar:
Özellik
Veri Gölü
Veri Ambarı
Veri türü
Yapılandırılmış, yarı yapılandırılmış, yapılandırılmamış
Yalnızca yapılandırılmış
Depolama formatı
Ham (dosya nesneleri)
İşlenmiş (tablolar, satırlar, sütunlar)
Şema
Okuma anında şema
Yazımda şema
Maliyet
Düşük maliyetli depolama
GB başına daha pahalı
Kullanım alanı
Makine öğrenimi, büyük veri ve ham veri depolama
İş zekâsı, yapılandırılmış analitik
Performans
Esnek, hesaplama motoruna bağlı
Hızlı SQL sorguları için optimize edilmiştir
Uygulamada, birçok modern veri stratejisi her ikisini birleştirir: ham veri depolama için veri göllerini, yapılandırılmış raporlama ve iş zekâsı için veri ambarlarını kullanır.
Ayrıca veri gölü ile veri ambarını birleştiren bir hibrit çözüm olan veri lakehouse da vardır. Data Lakehouse Nedir? Mimari, Teknoloji ve Kullanım Alanları makalesi bunu daha kapsamlı açıklar.
Veri Gölü Mimarisi Bileşenleri
İyi tasarlanmış bir veri gölü mimarisi, ham veriyi aşağı akıştaki analitik, makine öğrenimi ve raporlama için kullanılabilir ve erişilebilir kılmak açısından esastır.
Bu bölüm, yutmadan yönetişime kadar modern bir veri gölünün beş ana katmanını açıklar.
Veri yutma katmanı
Yutma katmanı, veriyi çeşitli kaynaklardan veri gölüne getirir. Bu kaynaklar; iç sistemler (veritabanları veya CRM’ler gibi), harici API’ler ya da IoT cihazları ve günlükleri olabilir.
Üç ana yutma modu vardır:
Standart yutma araçları şunları içerir:
Esnek bir yutma katmanı, verinin hızlı gelmesini ve çeşitli formatlar ile hızları kaldırabilmeyi sağlar.
Depolama katmanı
Veri yutulduğunda, veri gölünün ham bölgesinde saklanır. Depolama katmanı genellikle esnek ölçekleme, yedeklilik ve maliyet verimliliği sunan bulut nesne depolama üzerinde kurulur.
Popüler seçenekler şunlardır:
Ancak verilerini kendi veri merkezlerinde barındırdıkları şirket içi bulutlarda saklamak isteyen şirketler için de seçenekler mevcuttur.
Örneğin, kendi altyapılarına MinIO kurulabilir. MinIO açık kaynaklıdır ve Amazon S3 ile uyumlu bir API sunar.
Depolama katmanının temel özellikleri şunlardır:
Veriyi orijinal formatında saklamak, gelecekteki işleme ve analiz için tüm potansiyelini korumanıza olanak tanır.
Katalog ve meta veri yönetimi
Meta veri olmadan, bir veri gölü veri bataklığına dönüşür; çünkü verinizi yeniden bulmak ve onunla verimli çalışmak imkânsız hale gelir.
Katalog ve meta veri katmanı; şunları takip ederek kaosa yapı kazandırır:
Bu katman, mevcut tüm veri kümelerini dizinleyerek ve arama ile erişim kontrolünü mümkün kılarak keşfedilebilirliği ve kullanılabilirliği sağlar. Bu katman için standart araçlar şunlardır:
Sağlam bir meta veri sistemi; işbirliği, yönetişim ve operasyonel verimlilik için gereklidir.
İşleme ve analitik katmanı
Ham verinin işlendiği ve içgörüye dönüştürüldüğü katman burasıdır. İşleme katmanı, temel dönüşümlerden ileri analitik ve makine öğrenimine kadar çeşitli işlemleri destekler.
Tipik iş akışları şunları içerir:
Bu katman genellikle hem toplu hem gerçek zamanlı hesaplamayı içerir ve keşif amaçlı veri analizi ile üretim iş yüklerini mümkün kılar.
Güvenlik ve yönetişim
Sağlam bir veri gölü mimarisi, hassas verileri korumak ve uyumluluğu sağlamak için yerleşik mekanizmalara sahip olmalıdır. Bu kısım kritik önemdedir; çünkü veri göllerinde çoğunlukla çok sayıda hassas veri bulunur ve bunların tehlikeye girmesi, ait oldukları işletmeye zarar verebilir.
Bu katmanın temel özellikleri şunlardır:
Popüler araç ve hizmetler:
Güvenlik, finans, sağlık veya askeriye gibi düzenlemeye tabi sektörlerde veri gölünün kullanılabilir olup olmadığını çoğu zaman belirler.
Veri Gölleri için Yaygın Kullanım Alanları
Veri gölleri, ölçek, esneklik ve çeşitli veri türlerinin kritik olduğu kullanım alanları için uygundur. Sektörler genelinde modern, veri odaklı operasyon ve uygulamaların temelini oluştururlar.
Bu bölümde, veri göllerinin merkezi rol oynadığı en yaygın ve etkili kullanım alanlarından bazılarını inceleyeceğiz.
Büyük veri analitiği
Veri göllerinin en bilinen kullanım alanlarından biri, büyük ölçekli veri analizini mümkün kılmasıdır.
Veri gölleri veriyi ham haliyle depolayabildiği için, kuruluşların analize geçmeden önce her veri kümesini temizleme veya yapılandırma derdi kalmaz. Bu, geleneksel sistemler için fazla büyük veya hızlı değişen günlükler, sensör verileri veya tıklama akışları toplanırken idealdir.
Veri gölleri şunları mümkün kılar:
Amazon Athena veya Google BigQuery gibi araçlar, veriyi karmaşık dönüşümler gerektirmeden ya da başka bir yere taşımadan doğrudan göl içinde sorgulayabilir.
Makine öğrenimi ve yapay zeka
Veri gölleri, makine öğrenimi ve yapay zeka iş akışları için mükemmel bir eşleşmedir.
Şunlar için ideal bir ortam sağlarlar:
Modelleri bir ambarın önceden temizlenmiş verileriyle sınırlamak yerine, veri bilimciler zengin, ham verilere erişerek daha özgürce deney yapabilir ve daha hızlı yineleyebilir. Bu, özellikle doğal dil işleme (NLP), bilgisayarlı görü ve zaman serisi tahmini gibi alanlarda faydalıdır.
Databricks Lakehouse çözümünün yapay zekâ için nasıl kullanılabileceğine bir örnek görmek isterseniz, şunu okumanızı öneririm: Veri Bilimciler için Kapsamlı Databricks Lakehouse AI Rehberi.
Merkezi veri arşivleme
Birçok kuruluş, uzun vadeli depolama ve arşivleme için veri göllerini kullanır.
Bulut nesne depolamanın düşük maliyeti sayesinde, günlük kullanılmasa bile uyumluluk ve denetim amaçları, trend analizi, tahmin veya gelecekteki ML modellerinin eğitimi için erişilebilir olması gereken yıllarca operasyonel veriyi ekonomik olarak saklamak mümkündür.
Çoğu bulut nesne depolama çözümü, nadiren erişilen verileri arşivlemek için katmanlama yapmanıza, gölü ise yalın ve verimli tutmanıza olanak tanır.
Veri bilimi denemeleri
Veri gölleri, veri bilimcilerin kısıtlama olmaksızın ham veriyi keşfetmesini sağlar.
İster hızlı bir prototip geliştiriyor, ister yeni bir hipotezi test ediyor, ister keşif amaçlı veri analizi (EDA) yürütüyor olun; göl size şunlara esnek erişim sunar:
Bu deneme katmanı, inovasyon için gereklidir. Veri gölleri, veri mühendisliği ekibine talep oluşturmanıza veya ambarın temizlenmiş bir sürümünü beklemenize gerek kalmadan veri kümelerini yeni yollarla keşfetmenizi sağlar.
Veri Göllerinin Faydaları ve Zorlukları
Veri gölleri modern veri iş akışları için güçlü yetenekler sunsa da kendilerine özgü zorlukları da vardır. Bir veri gölü mimarisini benimsemeden önce her iki yönü de anlamak esastır. Bu bölümde, başlıca faydaları, yaygın tuzakları ve bunların nasıl aşılacağını tartışacağım.
Veri göllerinin faydaları
Bir veri gölünün en büyük avantajı esnekliğidir. Başından itibaren belirli bir şemaya veya veri modeline bağlı değilsiniz; bu da hızla değişen veya evrilen veri kümeleriyle çalışırken harikadır.
İşte bazı temel faydalar:
Çalıştığım projelerde, bu merkezileştirme veri silolarını azalttı ve ekipler arası işbirliğini önemli ölçüde iyileştirdi.
Başlıca zorluklar
Veri gölleri güçlüdür; ancak yönetilmesi gereken bazı temel zorluklar vardır. Yönetimsiz bırakıldıklarında hızla dağınık ve kullanışsız hâle gelebilirler; buna sıklıkla veri bataklığı denir.
Yaygın zorluklardan bazıları şunlardır:
Bu sorunlar, veri gölüne duyulan güveni ve kurum genelindeki benimsemeyi azaltabilir.
Zorluklar nasıl hafifletilir
En başarılı veri gölleri, güçlü meta veri ve yaşam döngüsü yönetimi uygulamalarına sahiptir.
İşte riski nasıl azaltıp veri gölünüzü sağlıklı tutabileceğiniz:
Başından itibaren temiz bir mimari tasarlayarak ve sağlam yönetişim yapıları oluşturarak bir veri gölünün varlık olarak kalmasını ve yük hâline gelmemesini sağlayabilirsiniz.
Veri gölü sağlık yönetimi çerçevesi. Görsel: Yazar.
Popüler Veri Gölü Teknolojileri
Veri göllerinin modern veri mimarisindeki önemi arttıkça, onları desteklemek için geniş bir teknoloji yelpazesi ortaya çıktı. Bu araçlar; bulut yerlisi platformlardan açık kaynak ekosistemlerine ve analitik çözümlerle entegrasyonlara kadar uzanır. Bu bölümde en popüler araçları ele alacağım.
Bulut yerlisi çözümler
Bulut sağlayıcıları, veri gölleri kurmak ve sürdürmek için tamamen yönetilen hizmetler sunar. Bu platformlar, ölçek, dayanıklılık ve diğer bulut servisleriyle sıkı entegrasyon arayan ekipler için genellikle başlangıç noktasıdır.
Popüler bulut yerlisi çözümler şunlardır:
Bu hizmetler esneklik, maliyet etkinliği ve güvenlik için optimize edilmiştir; kurumsal ölçekli veri gölleri için idealdir.
Açık kaynak araçlar
Açık kaynak teknolojiler, özellikle satıcıya bağımlılıktan kaçınmak veya hibrit/çoklu bulut ortamlarında çalışmak isteyen ekipler için esneklik ve genişletilebilirlik sağlar.
Popüler çözümler şunlardır:
Bu araçlar sıklıkla daha geniş veri platformlarına entegre edilir ve özel veya modüler çözümler inşa eden mühendislik ekipleri tarafından tercih edilir.
Apache Iceberg ile Delta Lake arasındaki farkları daha ayrıntılı keşfetmek isterseniz, şunu okumanızı öneririm: Apache Iceberg vs. Delta Lake: Özellikler, Farklar ve Kullanım Alanları.
Analitik platformlarla entegrasyon
Bir veri gölü, içgörüleri çıkarmaya ve iş kararlarını yönlendirmeye yardımcı olan analitik ve görselleştirme araçlarıyla entegre edildiğinde değer kazanır. Bu nedenle, nihai çözüm seçilmeden önce veri gölü çözümünün hangi analitik platformlarla entegre edilmesi gerektiği önceden mutlaka kontrol edilmelidir.
Popüler analitik platformlar şunlardır:
Databricks hakkında daha fazla bilgi edinmek isterseniz, şu kursu öneririm: Introduction to Databricks.
Teknolojileri seçerken, bunların ekibinizin uzmanlığı, veri stratejiniz ve ihtiyaç duyduğunuz esneklik veya soyutlama düzeyiyle uyumlu olmasını sağlamak esastır.
Sonuç
Veri gölleri, esnek, ölçeklenebilir, ham ve yarı yapılandırılmış bir veri temeli sunarak kuruluşların sağlam makine öğrenimi uygulamaları ve gerçek zamanlı panolar oluşturmasını sağlar.
Bu yazıda, veri gölünün ne olduğunu, temel bileşenlerini ve ne zaman kullanılacağını inceledik. Esneklik ve ölçeklenebilirlik gibi faydaları, veri yönetişimi ve "veri bataklığı" riski gibi zorlukları ve bunlardan nasıl kaçınılacağını tartıştık. Son olarak, bulut platformları ve açık kaynak araçlar dâhil veri gölleri inşa etmek için popüler teknolojileri ele aldık.
MLOps, yapay zekâ altyapısı ve bulut yerlisi veri sistemleri genelindeki deneyimime dayanarak, iyi tasarlanmış bir veri gölünün ekiplerin nasıl işbirliği yaptığı ve yenilik yaptığı biçimini nasıl dönüştürebileceğini gördüm. Ancak kötü yönetilen bir veri gölünün ne kadar hızlı bir yük hâline gelebileceğini ve içinde gezinmenin nasıl zorlaşabileceğini de gördüm.
Kuruluşunuz karmaşık, çeşitli veya büyük ölçekli verileri işliyor ve daha hızlı denemeler, daha zengin analitik veya yapay zekâ geliştirme imkânı sağlamak istiyorsa, bir veri gölü tam da ihtiyacınız olan şey olabilir.
Understanding Modern Data Architecture kursu daha fazlasını öğrenmek için harika bir ilk duraktır.