Sebagai seseorang yang telah mendukung tim data dengan platform MLOps dan membantu merancang infrastruktur yang dapat diskalakan, saya melihat langsung betapa krusialnya data lake dalam data stack masa kini.
Berbeda dengan data warehouse tradisional, yang mengharuskan data bersih dan terstruktur sebelum disimpan, data lake memungkinkan Anda menyimpan semuanya dalam format mentah, berantakan, dan tidak terstruktur. Fleksibilitas ini membuka banyak kemungkinan untuk aplikasi dan use case berbasis data. Data lake memungkinkan Anda mengumpulkan dan menyimpan data dari berbagai sumber di satu tempat, di mana data tersebut dapat dianalisis lebih lanjut dan digunakan untuk AI.
Dalam artikel ini, saya akan menjelaskan apa itu data lake, cara kerjanya, kapan menggunakannya, dan bagaimana perbandingannya dengan solusi yang lebih tradisional.
Memahami Konsep Data Lake
Sebelum membahas arsitektur teknis atau use case, penting untuk memahami apa itu data lake dan apa yang membedakannya dari sistem penyimpanan yang lebih tradisional.
Bagian ini mendefinisikan konsepnya, menguraikan karakteristik utamanya, dan membandingkannya dengan dunia data warehouse yang lebih terstruktur.
Saya merekomendasikan kursus Data Strategy jika Anda ingin mempelajari lebih lanjut bagaimana strategi data yang dirancang dengan baik dapat membantu bisnis.
Definisi data lake
Data lake adalah repositori terpusat yang menyimpan semua data terstruktur, semi-terstruktur, dan tidak terstruktur Anda pada skala apa pun.
Anda dapat mengimpor data mentah dari berbagai sumber dan menyimpannya dalam format aslinya hingga Anda perlu memproses atau menganalisisnya.
Berbeda dengan database atau data warehouse, yang umumnya memerlukan skema yang telah ditentukan (schema-on-write), data lake menggunakan pendekatan schema-on-read. Artinya, struktur hanya diterapkan saat data diakses untuk analisis, memberi tim fleksibilitas untuk menafsirkan dan mentransformasi data di kemudian hari.
Karakteristik inti
Data lake memiliki karakteristik inti berikut:
- Skalabilitas: Data lake dibangun untuk menskalakan secara horizontal. Baik Anda menyimpan terabita maupun petabita data, solusi penyimpanan objek berbasis cloud seperti Amazon S3 atau Azure Data Lake Storage memudahkan pertumbuhan tanpa khawatir kapasitas.
- Schema-on-read: Anda tidak perlu mendefinisikan skema saat menyimpan data. Sebagai gantinya, data scientist, analis, atau engineer dapat menerapkan skema berbeda sesuai use case saat pengambilan atau transformasi.
- Penyimpanan data mentah: Data lake mempertahankan semua jenis data dalam format aslinya, baik file CSV, log JSON, file audio, video, maupun data sensor.
- Dukungan untuk beragam jenis data: Anda dapat menyimpan data terstruktur (mis., tabel SQL), semi-terstruktur (mis., XML, JSON), dan tidak terstruktur (mis., gambar, PDF, teks) di satu tempat.
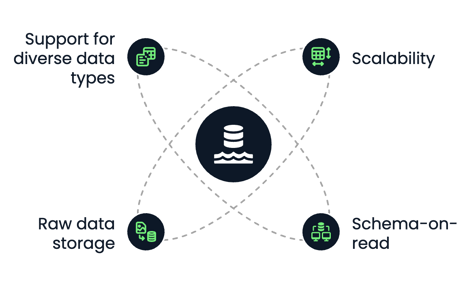
Karakteristik inti data lake. Gambar oleh Penulis.
Perbandingan dengan data warehouse
Data lake dan data warehouse digunakan untuk menyimpan dan menganalisis data. Namun, keduanya sangat berbeda dalam struktur, performa, dan use case.
Jika Anda baru mengenal data warehouse dan ingin mempelajari lebih lanjut, saya merekomendasikan kursus Data Warehousing Concepts dan artikel What Is a Data Warehouse serta Data Warehouse Architecture: Trends, Tools, and Techniques.
Mari kita lihat perbedaannya:
|
Fitur
|
Data Lake
|
Data Warehouse
|
|
Jenis data
|
Terstruktur, semi-terstruktur, tidak terstruktur
|
Hanya terstruktur
|
|
Format penyimpanan
|
Mentah (objek file)
|
Terproses (tabel, baris, kolom)
|
|
Skema
|
Schema-on-read
|
Schema-on-write
|
|
Biaya
|
Penyimpanan berbiaya rendah
|
Lebih mahal per GB
|
|
Use case
|
Machine learning, big data, dan penyimpanan data mentah
|
Business intelligence, analitik terstruktur
|
|
Performa
|
Fleksibel, bergantung pada mesin komputasi
|
Dioptimalkan untuk kueri SQL cepat
|
Dalam praktiknya, banyak strategi data modern menggabungkan keduanya: menggunakan data lake sebagai fondasi penyimpanan data mentah dan data warehouse untuk pelaporan terstruktur dan business intelligence.
Ada juga solusi hibrida yang disebut data lakehouse. Artikel What is a Data Lakehouse? Architecture, Technology & Use Cases menjelaskannya lebih lengkap.
Komponen Arsitektur Data Lake
Arsitektur data lake yang dirancang dengan baik sangat penting agar data mentah dapat digunakan dan diakses untuk analitik lanjutan, machine learning, dan pelaporan.
Bagian ini menguraikan lima lapisan kunci data lake modern, dari ingestion hingga tata kelola.
Lapisan ingestion data
Lapisan ingestion membawa data dari berbagai sumber ke dalam data lake. Sumber-sumber ini mencakup sistem internal (seperti database atau CRM), API eksternal, atau perangkat IoT dan log.
Ada tiga mode ingestion utama:
- Batch ingestion: Memuat data secara berkala (misalnya setiap malam) dalam bentuk batch.
- Stream ingestion: Aliran data real-time, seperti clickstream atau data sensor.
- Hybrid ingestion: Kombinasi batch dan stream, yang umum di lingkungan enterprise.
Alat ingestion standar meliputi:
- Apache Kafka dan AWS Kinesis untuk streaming
- Apache NiFi, Flume, dan AWS Glue untuk ETL batch
Lapisan ingestion yang fleksibel memastikan data tiba dengan cepat dan dapat menangani berbagai format serta kecepatan.
Lapisan penyimpanan
Saat data diingest, data disimpan di zona mentah data lake. Lapisan penyimpanan biasanya dibangun di atas penyimpanan objek cloud, yang menawarkan skalabilitas elastis, redundansi, dan efisiensi biaya.
Opsi populer meliputi:
- Amazon S3
- Azure Data Lake Storage
- Google Cloud Storage
Namun, ada juga opsi bagi perusahaan yang ingin menyimpan data mereka di cloud on-premise yang dihosting di data center mereka.
Sebagai contoh, seseorang dapat memasang MinIO di infrastruktur mereka. MinIO sendiri bersifat open-source dan menawarkan API yang kompatibel dengan Amazon S3.
Fitur utama dari lapisan penyimpanan meliputi:
- Daya tahan dan ketersediaan: Data direplikasi secara otomatis lintas region.
- Pemisahan penyimpanan dan komputasi: Anda dapat menskalakan komputasi secara independen berdasarkan permintaan.
- Data tiering: Memungkinkan cold storage untuk arsip dan hot storage untuk data yang sering diakses.
Menyimpan data dalam format aslinya memungkinkan Anda mempertahankan seluruh potensinya untuk pemrosesan dan analisis di masa depan.
Tanpa metadata, data lake berubah menjadi data swamp, karena mustahil menemukan data Anda kembali dan mengerjakannya secara efisien.
Lapisan katalog dan metadata membawa struktur ke kekacauan dengan melacak:
- Skema data
- Lokasi data dan partisi
- Lineage dan versioning
Lapisan ini memastikan kemudahan penemuan dan kegunaan dengan mengindeks semua dataset yang tersedia serta memungkinkan pencarian dan kontrol akses. Alat standar untuk lapisan ini meliputi:
- AWS Glue Data Catalog
- Apache Hive Metastore
- Apache Atlas
- DataHub
Sistem metadata yang baik sangat penting untuk kolaborasi, tata kelola, dan efisiensi operasional.
Lapisan pemrosesan dan analitik
Inilah lapisan tempat data mentah diproses dan diubah menjadi insight. Lapisan pemrosesan mendukung berbagai operasi, dari transformasi mendasar hingga analitik lanjutan dan machine learning.
Alur kerja yang umum meliputi:
- Pipeline ETL/ELT untuk pembersihan dan normalisasi data
- Kueri SQL
- Pipeline machine learning
Lapisan ini sering mencakup komputasi batch dan real-time, memungkinkan exploratory data analysis dan beban kerja produksi.
Keamanan dan tata kelola
Arsitektur data lake yang tangguh harus memiliki mekanisme bawaan untuk melindungi data sensitif dan memastikan kepatuhan. Bagian ini krusial, karena data lake umumnya berisi banyak data sensitif yang, jika dikompromikan, dapat merugikan bisnis pemiliknya.
Fitur penting dari lapisan tersebut meliputi:
- Identity and access management (IAM): Membatasi siapa yang dapat melihat atau mengubah data.
- Enkripsi: Enkripsi in-transit (TLS) dan at-rest.
- Masking dan anonimisasi data: Untuk menangani informasi yang dapat diidentifikasi secara pribadi.
- Audit dan pemantauan: Untuk ketertelusuran dan kepatuhan.
Alat dan layanan populer:
- AWS Lake Formation
- Apache Ranger
- Azure Purview
Keamanan sering menentukan apakah data lake dapat digunakan di industri teregulasi seperti keuangan, kesehatan, atau militer.
Use Case Umum untuk Data Lake
Data lake sangat cocok untuk use case di mana skala, fleksibilitas, dan beragam jenis data sangat penting. Data lake menjadi fondasi bagi operasi dan aplikasi modern berbasis data di berbagai industri.
Di bagian ini, kita akan mengeksplorasi beberapa use case paling umum dan berdampak di mana data lake berperan sentral.
Big data analytics
Salah satu penggunaan data lake yang paling dikenal adalah memungkinkan analitik data berskala besar.
Karena data lake dapat menyimpan data dalam bentuk mentah, organisasi tidak lagi perlu khawatir membersihkan atau menstrukturkan setiap dataset sebelum analisis. Ini ideal saat mengumpulkan log, data sensor, atau clickstream, yang terlalu besar atau cepat berubah untuk sistem tradisional.
Data lake memungkinkan Anda untuk:
- Menganalisis data historis bersama data real-time
- Menjalankan kueri kustom pada dataset berskala petabita
- Memungkinkan analitik lintas departemen dengan satu sumber kebenaran
Alat seperti Amazon Athena atau Google BigQuery dapat mengkueri data langsung di lake tanpa memerlukan transformasi kompleks atau memindahkan data ke tempat lain.
Machine learning dan AI
Data lake sangat cocok untuk alur kerja machine learning dan AI.
Data lake menyediakan lingkungan ideal untuk:
- Menyimpan dataset pelatihan dalam berbagai format (mis., CSV, Parquet, gambar, dll.)
- Menyimpan data mentah yang karenanya lebih komprehensif, memungkinkan fleksibilitas lebih besar untuk mengeksplorasi, bereksperimen, dan mengiterasi model ML
- Mendayagunakan pipeline ML otomatis yang melakukan iterasi atas volume data masif
Alih-alih membatasi model pada data yang sudah dibersihkan dari warehouse, data scientist dapat mengakses data mentah yang kaya untuk bereksperimen lebih bebas dan beriterasi lebih cepat. Ini sangat berguna di domain seperti natural language processing (NLP), computer vision, dan peramalan deret waktu.
Jika Anda ingin contoh bagaimana solusi Databricks Lakehouse dapat digunakan untuk AI, saya merekomendasikan membaca A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists.
Pengarsipan data terpusat
Banyak organisasi menggunakan data lake untuk penyimpanan jangka panjang dan pengarsipan.
Berkat biaya rendah penyimpanan objek cloud, secara ekonomis memungkinkan untuk menyimpan data operasional bertahun-tahun yang mungkin tidak digunakan setiap hari tetapi tetap perlu diakses untuk tujuan kepatuhan dan audit, analisis tren, peramalan, atau pelatihan model ML di masa depan.
Sebagian besar solusi penyimpanan objek cloud memungkinkan Anda melakukan tiering penyimpanan untuk mengarsipkan data yang jarang diakses sambil menjaga lake tetap ramping dan efisien.
Eksperimen data science
Data lake memberdayakan data scientist untuk mengeksplorasi data mentah tanpa batasan.
Baik Anda membuat prototipe cepat, menguji hipotesis baru, atau menjalankan exploratory data analysis (EDA), lake memberi Anda akses fleksibel ke:
- Data tidak terstruktur mentah (seperti PDF, email, file teks)
- Format semi-terstruktur (seperti JSON, XML, atau log)
- Dataset masif yang tidak muat di database tradisional
Lapisan eksperimen ini penting untuk inovasi. Data lake memungkinkan Anda mengeksplorasi dataset dengan cara baru tanpa perlu mengajukan tiket ke tim data engineering atau menunggu versi yang sudah dibersihkan di warehouse.
Manfaat dan Tantangan Data Lake
Walau data lake menyediakan kapabilitas kuat untuk alur kerja data modern, data lake juga memiliki tantangan unik. Memahami kedua sisi ini penting sebelum mengadopsi arsitektur data lake. Di bagian ini, saya akan membahas manfaat utama, jebakan umum, dan cara mengatasinya.
Manfaat data lake
Keuntungan terbesar data lake adalah fleksibilitasnya. Anda tidak terikat pada skema atau model data tertentu sejak awal, yang sangat baik saat bekerja dengan dataset yang cepat berubah atau berkembang.
Berikut beberapa manfaat kunci:
- Skalabilitas: Data lake dibangun di atas penyimpanan cloud-native yang menskalakan tanpa hambatan, baik Anda menyimpan gigabita maupun petabita.
- Dukungan untuk semua jenis data: Data terstruktur (tabel SQL), semi-terstruktur (JSON, XML), dan tidak terstruktur (teks, gambar, video) dapat disimpan dalam platform yang sama.
- Efisiensi biaya: Penyimpanan objek cloud (mis., Amazon S3) jauh lebih murah dibanding penyimpanan yang digunakan database atau warehouse tradisional.
- Arsitektur terlepas (decoupled): Komputasi dan penyimpanan dipisahkan sehingga beban analitik dapat diskalakan secara independen dari penyimpanan data.
- Analitik yang ditingkatkan: Data lake menyimpan data mentah yang belum diproses dan memungkinkan analisis data yang lebih komprehensif dan fleksibel, termasuk machine learning dan analitik prediktif.
- Pengambilan keputusan yang lebih baik: Data lake dapat memungkinkan analisis data yang lebih mendalam dan komprehensif, menghasilkan keputusan yang lebih tepat di seluruh organisasi.
- Penghapusan silo data: Data lake membantu memecah silo data dengan mengonsolidasikan data dari berbagai sumber ke satu repositori terpusat.
Dalam proyek yang saya kerjakan, sentralisasi ini telah mengurangi silo data dan meningkatkan kolaborasi lintas tim secara signifikan.
Tantangan utama
Data lake itu kuat, namun ada beberapa tantangan utama yang harus dikelola. Jika tidak dikelola, data lake dapat dengan cepat menjadi tidak teratur dan tidak dapat digunakan, kondisi yang sering disebut data swamp.
Beberapa tantangan umum meliputi:
- Kurangnya struktur: Tanpa skema yang telah ditentukan, data bisa sulit diquery, didokumentasikan, atau ditata kelolanya.
- Masalah kualitas data: Karena data diingest dalam bentuk mentah, data berkualitas buruk atau tidak lengkap dapat tidak terdeteksi hingga tahapan hilir.
- Kesenjangan metadata dan ketertemuan (discoverability): Tanpa sistem pengatalogan yang kuat, pengguna mungkin tidak tahu data apa yang ada atau cara menggunakannya.
- Tata kelola yang kompleks: Memastikan kontrol akses, keteraudit-an, dan kepatuhan lebih sulit dalam lingkungan yang fleksibel.
Masalah-masalah ini dapat mengurangi kepercayaan pada data lake dan menurunkan adopsi di seluruh bisnis.
Cara memitigasi tantangan
Data lake yang paling sukses memiliki praktik metadata dan manajemen siklus hidup yang kuat.
Berikut cara mengurangi risiko dan menjaga kesehatan data lake Anda:
- Implementasikan katalog data: Alat seperti AWS Glue atau DataHub membantu menjaga ketertemuan, definisi skema, dan pelacakan lineage.
- Gunakan penamaan dan struktur folder standar: Ini menciptakan konsistensi dan mengurangi kebingungan tim.
- Adaptasikan alat validasi dan pemrofilan data: Pastikan kualitas saat ingestion dan lakukan validasi ulang berkala.
- Otomatiskan kebijakan siklus hidup: Secara otomatis pindahkan data usang ke cold storage atau hapus setelah periode retensi yang ditentukan.
- Terapkan kontrol akses dan enkripsi yang kuat: Untuk melindungi data sensitif, gunakan kebijakan IAM, akses berbasis peran, serta enkripsi at rest dan in transit.
Data lake dapat tetap menjadi aset dan bukan liabilitas dengan merancang arsitektur yang bersih sejak awal dan menetapkan struktur tata kelola yang solid.
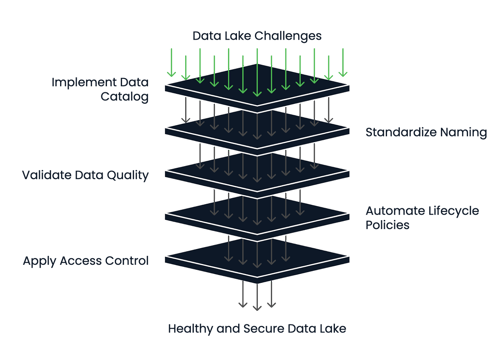
Kerangka kerja manajemen kesehatan data lake. Gambar oleh Penulis.
Teknologi Data Lake Populer
Dengan meningkatnya pentingnya data lake dalam arsitektur data modern, beragam teknologi telah muncul untuk mendukungnya. Alat-alat ini mencakup platform cloud-native, ekosistem open-source, dan integrasi dengan solusi analitik. Di bagian ini, saya akan membahas alat-alat paling populer.
Solusi cloud-native
Penyedia cloud menawarkan layanan terkelola penuh untuk membangun dan memelihara data lake. Platform ini sering menjadi titik awal bagi tim yang mencari skala, daya tahan, dan integrasi erat dengan layanan cloud lainnya.
Solusi cloud-native populer meliputi:
- Amazon S3 + AWS Lake Formation: S3 menyediakan penyimpanan objek, sementara Lake Formation menangani perizinan, pengatalogan, dan tata kelola.
- Azure Data Lake Storage: Menggabungkan blob storage dengan kapabilitas mirip HDFS.
- Google Cloud Storage (GCS): GCS sangat tahan lama dan terintegrasi baik dengan BigQuery dan Vertex AI untuk beban kerja analitik dan ML.
Layanan ini dioptimalkan untuk elastisitas, efisiensi biaya, dan keamanan, menjadikannya ideal untuk data lake skala enterprise.
Alat open-source
Teknologi open-source menambah fleksibilitas dan ekstensibilitas, terutama bagi tim yang ingin menghindari ketergantungan vendor atau beroperasi di lingkungan hybrid/multi-cloud.
Solusi populer meliputi:
- Apache Hadoop: Salah satu kerangka kerja data lake awal. Walau kini kurang umum untuk proyek baru, Hadoop meletakkan dasar bagi penyimpanan dan pemrosesan data terdistribusi.
- Delta Lake: Dikembangkan oleh Databricks, Delta Lake menambahkan transaksi ACID, versioning, dan penegakan skema ke penyimpanan objek cloud.
- Apache Iceberg: Iceberg menawarkan operasi atomik, partisi tersembunyi, dan time travel untuk mengkueri data historis.
- Presto: Mesin kueri SQL terdistribusi yang memungkinkan Anda menjalankan kueri cepat dan interaktif pada data yang disimpan di S3, HDFS, atau sumber lain tanpa memindahkan data.
Alat-alat ini sering terintegrasi ke dalam platform data yang lebih luas dan disukai oleh tim engineering yang membangun solusi kustom atau modular.
Jika Anda ingin mengeksplorasi perbedaan antara Apache Iceberg dan Delta Lake lebih detail, saya merekomendasikan membaca Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases.
Data lake menjadi bernilai saat diintegrasikan dengan alat analitik dan visualisasi yang membantu mengekstrak insight dan mendorong keputusan bisnis. Oleh karena itu, sebelum memilih solusi akhir, sebaiknya selalu periksa sejak awal dengan platform analitik mana solusi data lake harus diintegrasikan.
Platform analitik populer meliputi:
- Databricks: Menggabungkan penyimpanan data lake dengan ruang kerja kolaboratif untuk data engineering, machine learning, dan analitik. Databricks mendukung Delta Lake secara bawaan.
- Snowflake: Meskipun secara tradisional adalah data warehouse, Snowflake dapat mengkueri data eksternal di penyimpanan cloud (melalui Snowpipe atau tabel eksternal), menjadikannya solusi lakehouse hibrida.
- Power BI, Tableau: Alat BI ini dapat terhubung ke data lake secara langsung atau melalui mesin kueri seperti Athena atau BigQuery, memungkinkan pembuatan dasbor dan pelaporan di atas data mentah atau semi-terstruktur.
Jika Anda ingin mempelajari lebih lanjut tentang Databricks, saya merekomendasikan kursus Introduction to Databricks.
Saat memilih teknologi, penting untuk menyelaraskannya dengan keahlian tim Anda, strategi data Anda, dan tingkat fleksibilitas atau abstraksi yang Anda butuhkan.
Kesimpulan
Data lake memberdayakan organisasi untuk membangun aplikasi machine learning yang andal dan dasbor real-time dengan menyediakan fondasi data mentah dan semi-terstruktur yang fleksibel serta skalabel.
Dalam artikel ini, kita mengeksplorasi apa itu data lake, komponen utamanya, dan kapan menggunakannya. Kita membahas manfaat seperti fleksibilitas dan skalabilitas, tantangan seperti tata kelola data dan risiko "data swamp," serta cara menghindarinya. Terakhir, kita membahas teknologi populer untuk membangun data lake, termasuk platform cloud dan alat open-source.
Dari pengalaman saya bekerja di MLOps, infrastruktur AI, dan sistem data cloud-native, saya melihat bagaimana data lake yang berarsitektur baik dapat mentransformasi cara tim berkolaborasi dan berinovasi. Namun saya juga melihat betapa cepatnya data lake yang ditata kelola buruk dapat menjadi liabilitas, dan menavigasinya menjadi sulit.
Jika organisasi Anda menangani data yang kompleks, beragam, atau berskala besar dan ingin memungkinkan eksperimen lebih cepat, analitik yang lebih kaya, atau pengembangan AI, data lake mungkin tepat yang Anda butuhkan.
Kursus Understanding Modern Data Architecture adalah tempat awal yang bagus jika Anda ingin belajar lebih lanjut.




Sebagai seseorang yang telah mendukung tim data dengan platform MLOps dan membantu merancang infrastruktur yang dapat diskalakan, saya melihat langsung betapa krusialnya data lake dalam data stack masa kini.
Berbeda dengan data warehouse tradisional, yang mengharuskan data bersih dan terstruktur sebelum disimpan, data lake memungkinkan Anda menyimpan semuanya dalam format mentah, berantakan, dan tidak terstruktur. Fleksibilitas ini membuka banyak kemungkinan untuk aplikasi dan use case berbasis data. Data lake memungkinkan Anda mengumpulkan dan menyimpan data dari berbagai sumber di satu tempat, di mana data tersebut dapat dianalisis lebih lanjut dan digunakan untuk AI.
Dalam artikel ini, saya akan menjelaskan apa itu data lake, cara kerjanya, kapan menggunakannya, dan bagaimana perbandingannya dengan solusi yang lebih tradisional.
Memahami Konsep Data Lake
Sebelum membahas arsitektur teknis atau use case, penting untuk memahami apa itu data lake dan apa yang membedakannya dari sistem penyimpanan yang lebih tradisional.
Bagian ini mendefinisikan konsepnya, menguraikan karakteristik utamanya, dan membandingkannya dengan dunia data warehouse yang lebih terstruktur.
Saya merekomendasikan kursus Data Strategy jika Anda ingin mempelajari lebih lanjut bagaimana strategi data yang dirancang dengan baik dapat membantu bisnis.
Definisi data lake
Data lake adalah repositori terpusat yang menyimpan semua data terstruktur, semi-terstruktur, dan tidak terstruktur Anda pada skala apa pun.
Anda dapat mengimpor data mentah dari berbagai sumber dan menyimpannya dalam format aslinya hingga Anda perlu memproses atau menganalisisnya.
Berbeda dengan database atau data warehouse, yang umumnya memerlukan skema yang telah ditentukan (schema-on-write), data lake menggunakan pendekatan schema-on-read. Artinya, struktur hanya diterapkan saat data diakses untuk analisis, memberi tim fleksibilitas untuk menafsirkan dan mentransformasi data di kemudian hari.
Karakteristik inti
Data lake memiliki karakteristik inti berikut:
Karakteristik inti data lake. Gambar oleh Penulis.
Perbandingan dengan data warehouse
Data lake dan data warehouse digunakan untuk menyimpan dan menganalisis data. Namun, keduanya sangat berbeda dalam struktur, performa, dan use case.
Jika Anda baru mengenal data warehouse dan ingin mempelajari lebih lanjut, saya merekomendasikan kursus Data Warehousing Concepts dan artikel What Is a Data Warehouse serta Data Warehouse Architecture: Trends, Tools, and Techniques.
Mari kita lihat perbedaannya:
Fitur
Data Lake
Data Warehouse
Jenis data
Terstruktur, semi-terstruktur, tidak terstruktur
Hanya terstruktur
Format penyimpanan
Mentah (objek file)
Terproses (tabel, baris, kolom)
Skema
Schema-on-read
Schema-on-write
Biaya
Penyimpanan berbiaya rendah
Lebih mahal per GB
Use case
Machine learning, big data, dan penyimpanan data mentah
Business intelligence, analitik terstruktur
Performa
Fleksibel, bergantung pada mesin komputasi
Dioptimalkan untuk kueri SQL cepat
Dalam praktiknya, banyak strategi data modern menggabungkan keduanya: menggunakan data lake sebagai fondasi penyimpanan data mentah dan data warehouse untuk pelaporan terstruktur dan business intelligence.
Ada juga solusi hibrida yang disebut data lakehouse. Artikel What is a Data Lakehouse? Architecture, Technology & Use Cases menjelaskannya lebih lengkap.
Komponen Arsitektur Data Lake
Arsitektur data lake yang dirancang dengan baik sangat penting agar data mentah dapat digunakan dan diakses untuk analitik lanjutan, machine learning, dan pelaporan.
Bagian ini menguraikan lima lapisan kunci data lake modern, dari ingestion hingga tata kelola.
Lapisan ingestion data
Lapisan ingestion membawa data dari berbagai sumber ke dalam data lake. Sumber-sumber ini mencakup sistem internal (seperti database atau CRM), API eksternal, atau perangkat IoT dan log.
Ada tiga mode ingestion utama:
Alat ingestion standar meliputi:
Lapisan ingestion yang fleksibel memastikan data tiba dengan cepat dan dapat menangani berbagai format serta kecepatan.
Lapisan penyimpanan
Saat data diingest, data disimpan di zona mentah data lake. Lapisan penyimpanan biasanya dibangun di atas penyimpanan objek cloud, yang menawarkan skalabilitas elastis, redundansi, dan efisiensi biaya.
Opsi populer meliputi:
Namun, ada juga opsi bagi perusahaan yang ingin menyimpan data mereka di cloud on-premise yang dihosting di data center mereka.
Sebagai contoh, seseorang dapat memasang MinIO di infrastruktur mereka. MinIO sendiri bersifat open-source dan menawarkan API yang kompatibel dengan Amazon S3.
Fitur utama dari lapisan penyimpanan meliputi:
Menyimpan data dalam format aslinya memungkinkan Anda mempertahankan seluruh potensinya untuk pemrosesan dan analisis di masa depan.
Katalog dan manajemen metadata
Tanpa metadata, data lake berubah menjadi data swamp, karena mustahil menemukan data Anda kembali dan mengerjakannya secara efisien.
Lapisan katalog dan metadata membawa struktur ke kekacauan dengan melacak:
Lapisan ini memastikan kemudahan penemuan dan kegunaan dengan mengindeks semua dataset yang tersedia serta memungkinkan pencarian dan kontrol akses. Alat standar untuk lapisan ini meliputi:
Sistem metadata yang baik sangat penting untuk kolaborasi, tata kelola, dan efisiensi operasional.
Lapisan pemrosesan dan analitik
Inilah lapisan tempat data mentah diproses dan diubah menjadi insight. Lapisan pemrosesan mendukung berbagai operasi, dari transformasi mendasar hingga analitik lanjutan dan machine learning.
Alur kerja yang umum meliputi:
Lapisan ini sering mencakup komputasi batch dan real-time, memungkinkan exploratory data analysis dan beban kerja produksi.
Keamanan dan tata kelola
Arsitektur data lake yang tangguh harus memiliki mekanisme bawaan untuk melindungi data sensitif dan memastikan kepatuhan. Bagian ini krusial, karena data lake umumnya berisi banyak data sensitif yang, jika dikompromikan, dapat merugikan bisnis pemiliknya.
Fitur penting dari lapisan tersebut meliputi:
Alat dan layanan populer:
Keamanan sering menentukan apakah data lake dapat digunakan di industri teregulasi seperti keuangan, kesehatan, atau militer.
Use Case Umum untuk Data Lake
Data lake sangat cocok untuk use case di mana skala, fleksibilitas, dan beragam jenis data sangat penting. Data lake menjadi fondasi bagi operasi dan aplikasi modern berbasis data di berbagai industri.
Di bagian ini, kita akan mengeksplorasi beberapa use case paling umum dan berdampak di mana data lake berperan sentral.
Big data analytics
Salah satu penggunaan data lake yang paling dikenal adalah memungkinkan analitik data berskala besar.
Karena data lake dapat menyimpan data dalam bentuk mentah, organisasi tidak lagi perlu khawatir membersihkan atau menstrukturkan setiap dataset sebelum analisis. Ini ideal saat mengumpulkan log, data sensor, atau clickstream, yang terlalu besar atau cepat berubah untuk sistem tradisional.
Data lake memungkinkan Anda untuk:
Alat seperti Amazon Athena atau Google BigQuery dapat mengkueri data langsung di lake tanpa memerlukan transformasi kompleks atau memindahkan data ke tempat lain.
Machine learning dan AI
Data lake sangat cocok untuk alur kerja machine learning dan AI.
Data lake menyediakan lingkungan ideal untuk:
Alih-alih membatasi model pada data yang sudah dibersihkan dari warehouse, data scientist dapat mengakses data mentah yang kaya untuk bereksperimen lebih bebas dan beriterasi lebih cepat. Ini sangat berguna di domain seperti natural language processing (NLP), computer vision, dan peramalan deret waktu.
Jika Anda ingin contoh bagaimana solusi Databricks Lakehouse dapat digunakan untuk AI, saya merekomendasikan membaca A Comprehensive Guide to Databricks Lakehouse AI For Data Scientists.
Pengarsipan data terpusat
Banyak organisasi menggunakan data lake untuk penyimpanan jangka panjang dan pengarsipan.
Berkat biaya rendah penyimpanan objek cloud, secara ekonomis memungkinkan untuk menyimpan data operasional bertahun-tahun yang mungkin tidak digunakan setiap hari tetapi tetap perlu diakses untuk tujuan kepatuhan dan audit, analisis tren, peramalan, atau pelatihan model ML di masa depan.
Sebagian besar solusi penyimpanan objek cloud memungkinkan Anda melakukan tiering penyimpanan untuk mengarsipkan data yang jarang diakses sambil menjaga lake tetap ramping dan efisien.
Eksperimen data science
Data lake memberdayakan data scientist untuk mengeksplorasi data mentah tanpa batasan.
Baik Anda membuat prototipe cepat, menguji hipotesis baru, atau menjalankan exploratory data analysis (EDA), lake memberi Anda akses fleksibel ke:
Lapisan eksperimen ini penting untuk inovasi. Data lake memungkinkan Anda mengeksplorasi dataset dengan cara baru tanpa perlu mengajukan tiket ke tim data engineering atau menunggu versi yang sudah dibersihkan di warehouse.
Manfaat dan Tantangan Data Lake
Walau data lake menyediakan kapabilitas kuat untuk alur kerja data modern, data lake juga memiliki tantangan unik. Memahami kedua sisi ini penting sebelum mengadopsi arsitektur data lake. Di bagian ini, saya akan membahas manfaat utama, jebakan umum, dan cara mengatasinya.
Manfaat data lake
Keuntungan terbesar data lake adalah fleksibilitasnya. Anda tidak terikat pada skema atau model data tertentu sejak awal, yang sangat baik saat bekerja dengan dataset yang cepat berubah atau berkembang.
Berikut beberapa manfaat kunci:
Dalam proyek yang saya kerjakan, sentralisasi ini telah mengurangi silo data dan meningkatkan kolaborasi lintas tim secara signifikan.
Tantangan utama
Data lake itu kuat, namun ada beberapa tantangan utama yang harus dikelola. Jika tidak dikelola, data lake dapat dengan cepat menjadi tidak teratur dan tidak dapat digunakan, kondisi yang sering disebut data swamp.
Beberapa tantangan umum meliputi:
Masalah-masalah ini dapat mengurangi kepercayaan pada data lake dan menurunkan adopsi di seluruh bisnis.
Cara memitigasi tantangan
Data lake yang paling sukses memiliki praktik metadata dan manajemen siklus hidup yang kuat.
Berikut cara mengurangi risiko dan menjaga kesehatan data lake Anda:
Data lake dapat tetap menjadi aset dan bukan liabilitas dengan merancang arsitektur yang bersih sejak awal dan menetapkan struktur tata kelola yang solid.
Kerangka kerja manajemen kesehatan data lake. Gambar oleh Penulis.
Teknologi Data Lake Populer
Dengan meningkatnya pentingnya data lake dalam arsitektur data modern, beragam teknologi telah muncul untuk mendukungnya. Alat-alat ini mencakup platform cloud-native, ekosistem open-source, dan integrasi dengan solusi analitik. Di bagian ini, saya akan membahas alat-alat paling populer.
Solusi cloud-native
Penyedia cloud menawarkan layanan terkelola penuh untuk membangun dan memelihara data lake. Platform ini sering menjadi titik awal bagi tim yang mencari skala, daya tahan, dan integrasi erat dengan layanan cloud lainnya.
Solusi cloud-native populer meliputi:
Layanan ini dioptimalkan untuk elastisitas, efisiensi biaya, dan keamanan, menjadikannya ideal untuk data lake skala enterprise.
Alat open-source
Teknologi open-source menambah fleksibilitas dan ekstensibilitas, terutama bagi tim yang ingin menghindari ketergantungan vendor atau beroperasi di lingkungan hybrid/multi-cloud.
Solusi populer meliputi:
Alat-alat ini sering terintegrasi ke dalam platform data yang lebih luas dan disukai oleh tim engineering yang membangun solusi kustom atau modular.
Jika Anda ingin mengeksplorasi perbedaan antara Apache Iceberg dan Delta Lake lebih detail, saya merekomendasikan membaca Apache Iceberg vs. Delta Lake: Features, Differences & Use Cases.
Integrasi dengan platform analitik
Data lake menjadi bernilai saat diintegrasikan dengan alat analitik dan visualisasi yang membantu mengekstrak insight dan mendorong keputusan bisnis. Oleh karena itu, sebelum memilih solusi akhir, sebaiknya selalu periksa sejak awal dengan platform analitik mana solusi data lake harus diintegrasikan.
Platform analitik populer meliputi:
Jika Anda ingin mempelajari lebih lanjut tentang Databricks, saya merekomendasikan kursus Introduction to Databricks.
Saat memilih teknologi, penting untuk menyelaraskannya dengan keahlian tim Anda, strategi data Anda, dan tingkat fleksibilitas atau abstraksi yang Anda butuhkan.
Kesimpulan
Data lake memberdayakan organisasi untuk membangun aplikasi machine learning yang andal dan dasbor real-time dengan menyediakan fondasi data mentah dan semi-terstruktur yang fleksibel serta skalabel.
Dalam artikel ini, kita mengeksplorasi apa itu data lake, komponen utamanya, dan kapan menggunakannya. Kita membahas manfaat seperti fleksibilitas dan skalabilitas, tantangan seperti tata kelola data dan risiko "data swamp," serta cara menghindarinya. Terakhir, kita membahas teknologi populer untuk membangun data lake, termasuk platform cloud dan alat open-source.
Dari pengalaman saya bekerja di MLOps, infrastruktur AI, dan sistem data cloud-native, saya melihat bagaimana data lake yang berarsitektur baik dapat mentransformasi cara tim berkolaborasi dan berinovasi. Namun saya juga melihat betapa cepatnya data lake yang ditata kelola buruk dapat menjadi liabilitas, dan menavigasinya menjadi sulit.
Jika organisasi Anda menangani data yang kompleks, beragam, atau berskala besar dan ingin memungkinkan eksperimen lebih cepat, analitik yang lebih kaya, atau pengembangan AI, data lake mungkin tepat yang Anda butuhkan.
Kursus Understanding Modern Data Architecture adalah tempat awal yang bagus jika Anda ingin belajar lebih lanjut.