Kurs
Analyzing Social Media Data in Python
4 Std.
24.4K
Wenn du mehr über Netzwerkanalyse lernen willst, mach den DataCamp-Kurs Network Analysis in Python (Part 1).
Netzwerke sind überall: Straßennetze, ein Netzwerk aus Freundinnen, Freunden und Followern in Social Media, oder Kolleginnen und Kollegen im Büro. Sie prägen unseren Alltag – vom Verbreiten nützlicher Informationen bis hin zum Einfluss auf nationale Wahlen. Diese Netzwerke analysieren zu können und darauf basierte Entscheidungen zu treffen, ist eine wichtige Kompetenz für jede datengetriebene Rolle.
In diesem Tutorial lernst du Social Network Analysis (SNA) mit Python und NetworkX, einer Python-Bibliothek zur Untersuchung der Struktur, Dynamik und Funktionen komplexer Netzwerke. Wir setzen grundlegende Python-Kenntnisse voraus, Vorkenntnisse in SNA brauchst du nicht.
Starten wir mit der Frage, was wir unter sozialen Netzwerken verstehen. Unten siehst du ein Netzwerk aus Bollywood-Schauspielern als Knoten. Sie sind mit durchgezogenen Linien verbunden, wenn sie mindestens in einem Film zusammengearbeitet haben.
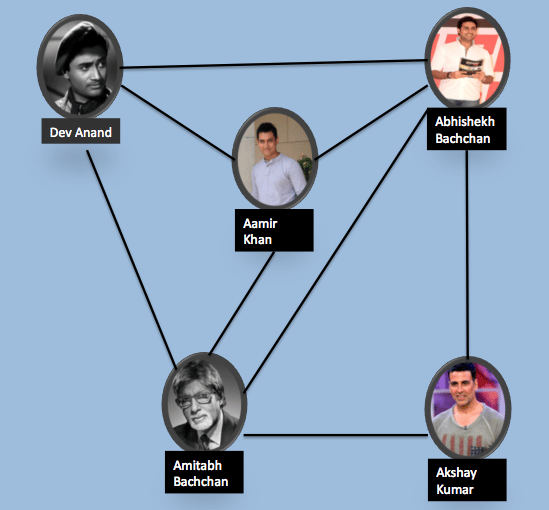
Wir sehen also: Sowohl Amitabh Bachchan als auch Abhishek Bachchan haben mit allen im Netzwerk gespielten Schauspielern zusammengearbeitet, während Akshay Kumar nur mit den beiden Bachchans gearbeitet hat. Ziemlich interessant!
Auch das ist ein soziales Netzwerk. Jedes Netzwerk mit Verbindungen zwischen Individuen, bei dem diese Verbindungen deren Beziehungen abbilden, ist ein soziales Netzwerk. Die Analyse solcher Netzwerke kann uns wertvolle Einblicke geben – etwa wer wirklich Einfluss hat oder wer am stärksten vernetzt ist.
Jedes Netzwerk besteht aus:
Es gibt viele Netzwerktypen. Wir nutzen NetworkX, um diese unterschiedlichen Netzwerke zu erstellen und zu analysieren. Zunächst musst du NetworkX installieren. Du kannst entweder:
pip install networkx
oder – wenn du mit Anaconda arbeitest –
conda install -c anaconda networkx
Damit installierst du die aktuelle Version von NetworkX. Der Code in diesem Tutorial wurde mit Python=3.5 und NetworkX=2.0 erstellt.
Das oben erstellte Schauspielernetzwerk ist symmetrisch, denn die Beziehung „gemeinsam in einem Film arbeiten“ ist symmetrisch. Wenn A mit B verbunden ist, ist B auch mit A verbunden. Erstellen wir dieses Netzwerk in NetworkX.
Wir verwenden die Methode Graph(), um ein neues Netzwerk zu erzeugen, und add_edge(), um eine Kante zwischen zwei Knoten hinzuzufügen.
import networkx as nx
G_symmetric = nx.Graph()
G_symmetric.add_edge('Amitabh Bachchan','Abhishek Bachchan')
G_symmetric.add_edge('Amitabh Bachchan','Aamir Khan')
G_symmetric.add_edge('Amitabh Bachchan','Akshay Kumar')
G_symmetric.add_edge('Amitabh Bachchan','Dev Anand')
G_symmetric.add_edge('Abhishek Bachchan','Aamir Khan')
G_symmetric.add_edge('Abhishek Bachchan','Akshay Kumar')
G_symmetric.add_edge('Abhishek Bachchan','Dev Anand')
G_symmetric.add_edge('Dev Anand','Aamir Khan')
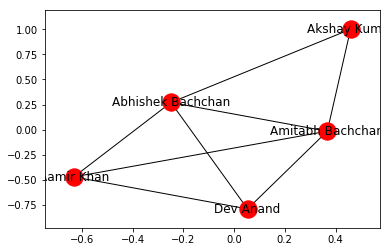
Nun visualisieren wir das soeben konstruierte Netzwerk mit nx.draw_networkx(G_symmetric).
Mehr als 10 Millionen Menschen lernen Python, R, SQL und andere technische Fertigkeiten in unseren praxisorientierten Kursen, die von Branchenexperten entwickelt wurden.
Was ist, wenn die Beziehung zwischen Knoten „Kind von“ ist? Dann ist sie nicht mehr symmetrisch. Wenn A das Kind von B ist, ist B nicht das Kind von A. Ein Netzwerk, in dem die Beziehung asymmetrisch ist (A ist mit B verbunden, aber B nicht zwingend mit A), nennt man ein asymmetrisches Netzwerk. In NetworkX bauen wir ein solches Netzwerk mit der Methode DiGraph (kurz für Directional Graph). Erstellen wir ein asymmetrisches Graphobjekt.
G_asymmetric = nx.DiGraph()
G_asymmetric.add_edge('A','B')
G_asymmetric.add_edge('A','D')
G_asymmetric.add_edge('C','A')
G_asymmetric.add_edge('D','E')
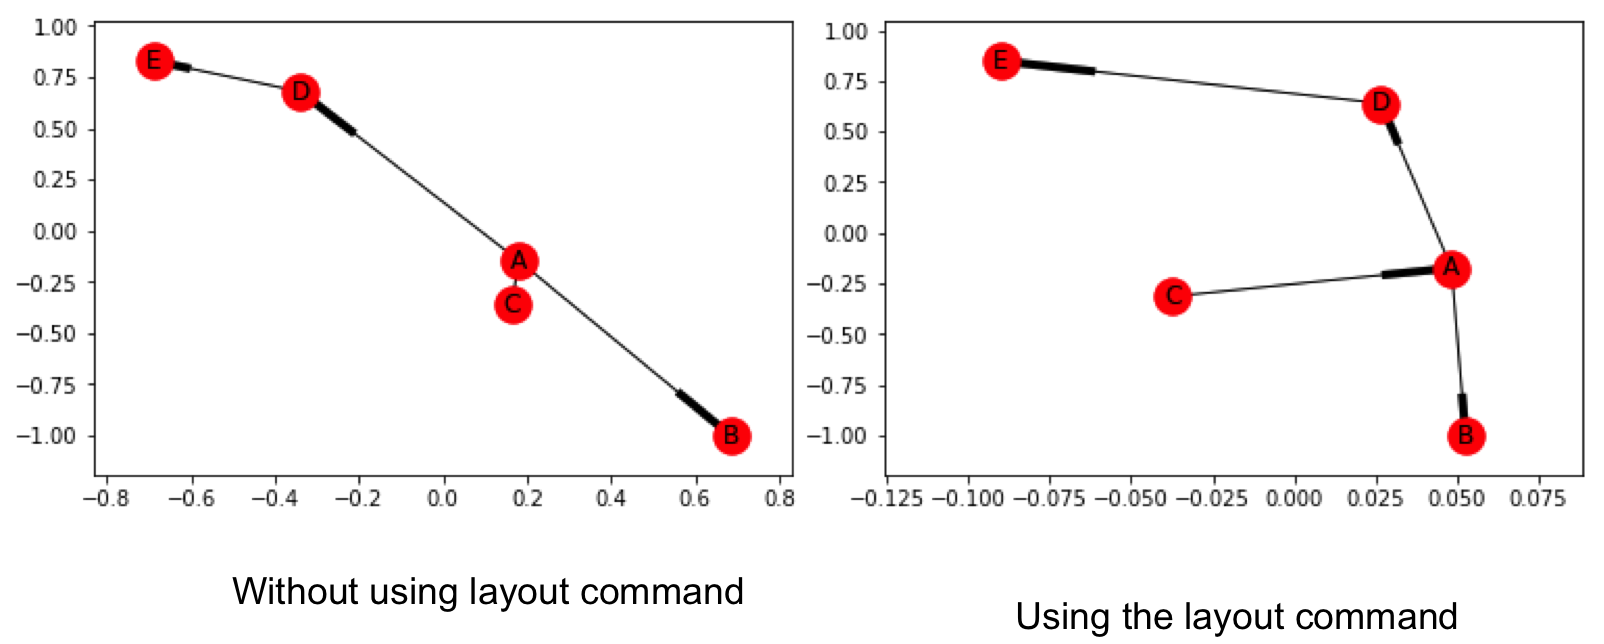
Jetzt visualisieren wir es. Wir können wie zuvor die Funktion draw_networkx() verwenden. Es kann jedoch passieren, dass die Knoten sich nicht sauber trennen und im gezeichneten Netzwerk nicht gut zu erkennen sind. Um das zu verbessern, erzwingen wir ein Layout, das die Knoten so positioniert, dass sie klar sichtbar sind. Das erreichen wir mit spring_layout() und anschließend draw_networkx().
nx.spring_layout(G_asymmetric)
nx.draw_networkx(G_asymmetric)
Unten siehst du das Netzwerk mit und ohne Layout-Befehl. Die Variante mit Layout ist deutlich übersichtlicher.
Bislang hatten unsere Netzwerke keine Gewichte. Oft sind Netzwerke jedoch gewichtet. Wenn wir im ersten Netzwerk die Anzahl gemeinsamer Filme als Gewicht betrachten, erhalten wir ein gewichtetes Netzwerk. Erstellen wir das Schauspielernetzwerk erneut, diesmal mit einem Gewicht pro Kante, das die Anzahl gemeinsamer Filme angibt.
G_weighted = nx.Graph()
G_weighted.add_edge('Amitabh Bachchan','Abhishek Bachchan', weight=25)
G_weighted.add_edge('Amitabh Bachchan','Aaamir Khan', weight=8)
G_weighted.add_edge('Amitabh Bachchan','Akshay Kumar', weight=11)
G_weighted.add_edge('Amitabh Bachchan','Dev Anand', weight=1)
G_weighted.add_edge('Abhishek Bachchan','Aaamir Khan', weight=4)
G_weighted.add_edge('Abhishek Bachchan','Akshay Kumar',weight=7)
G_weighted.add_edge('Abhishek Bachchan','Dev Anand', weight=1)
G_weighted.add_edge('Dev Anand','Aaamir Khan',weight=1)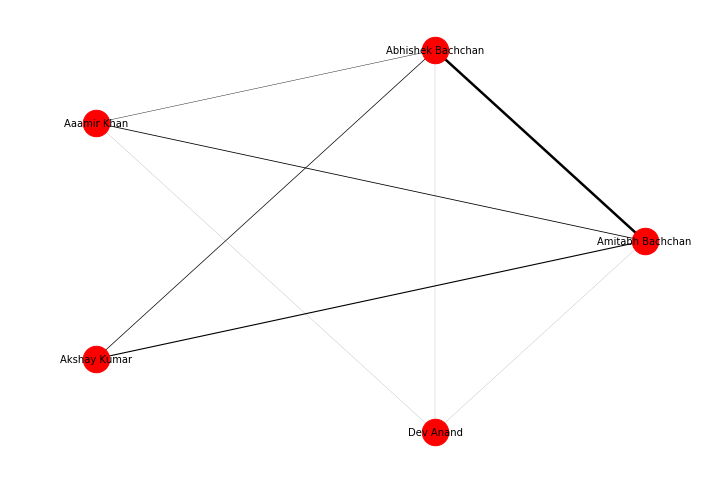
Die obige Abbildung zeigt das gewichtete Schauspielernetzwerk in einem circular-Layout. Die Kantenbreite gibt das Gewicht zwischen zwei Knoten an.
Wir können Kanten mit unterschiedlichen Attributen versehen. Beispielsweise definieren wir eine Nachbarschaftsbeziehung zwischen den Knoten „A“ und „B“ über das Attribut relation. Sind innerhalb eines Netzwerks zwei Knoten über zwei verschiedene Kanten (Beziehungen) verbunden, handelt es sich um einen Multigraphen. Einen solchen Multigraphen erstellen wir mit der Klasse MultiGraph.
G = nx.MultiGraph()
G.add_edge('A','B',relation ='neighbor')
G.add_edge('A','B',relation='friend)
G.add_edge('B','C', relation='neighbor')
G.add_edge('D','C',relation='friend')
Dieser Code erzeugt einen Graphen mit zwei Kanten zwischen A und B. Wir können die Verbindungen mit G.edges() prüfen. Die Ausgabe zeigt:
MultiEdgeDataView([('A', 'B', {'relation': 'neighbor'}), ('A', 'B', {'relation': 'friend'}), ('B', 'C', {'relation': 'neighbor'}), ('B', 'D', {'relation': 'neighbor'}), ('C', 'D', {'relation': 'friend'})])
Jetzt, da das Netzwerk steht, können wir mehr über einzelne Knoten herausfinden. Schauen wir uns ein paar Maße an.
Der Grad eines Knotens gibt an, wie viele Verbindungen er hat. In NetworkX nutzen wir dafür die Funktion degree, um den Grad eines Knotens zu bestimmen.
nx.degree(G_symmetric, 'Dev Anand`)
Das Ergebnis ist 3, da Dev Anand im Netzwerk nur mit drei Schauspielern zusammengearbeitet hat.
In sozialen Netzwerken bilden Personen mit gemeinsamen Verbindungen oft Gruppen. Mit anderen Worten: Es gibt die Tendenz zur Clusterbildung. Wir können den lokalen Clustering-Koeffizienten eines Knotens bestimmen – den Anteil der Freundespaare (also Verbindungen) eines Knotens, die ebenfalls untereinander verbunden sind. Dafür verwenden wir nx.clustering(Graph, Node).
Im symmetrischen Schauspielernetzwerk hat Dev Anand einen lokalen Clustering-Koeffizienten von 1 und Abhishek Bachchan von 0,67.
Der durchschnittliche Clustering-Koeffizient (Summe aller lokalen Clustering-Koeffizienten geteilt durch die Anzahl der Knoten) für das symmetrische Schauspielernetzwerk beträgt 0,867. Ermitteln kannst du ihn mit:
nx.average_clustering(G_symmetric)
Wir können auch den kürzesten Pfad zwischen zwei Knoten und dessen Länge mit nx.shortest_path(Graph, Node1, Node2) bzw. nx.shortest_path_length(Graph, Node1, Node2) bestimmen.
Wenn wir ausführen:
nx.shortest_path(G_symmetric, 'Dev Anand', 'Akshay Kumar')
erhalten wir:
['Dev Anand', 'Amitabh Bachchan', 'Akshay Kumar']
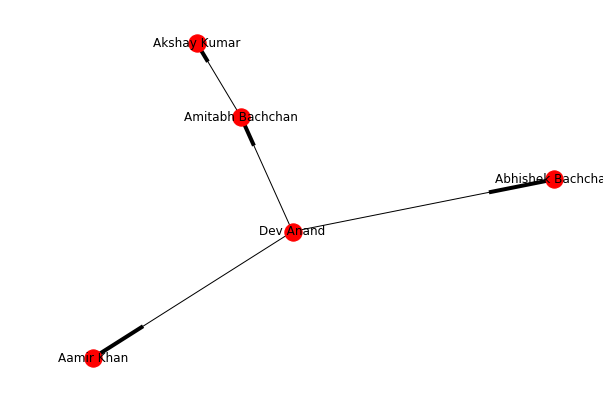
Die Distanz eines Knotens zu allen anderen Knoten im Netzwerk können wir mithilfe der Breitensuche (Breadth-First Search) bestimmen, ausgehend von diesem Knoten. In NetworkX nutzen wir dafür bfs_tree. Wenn du also T = nx.bfs_tree(G_symmetric, 'Dev Anand') ausprobierst und diesen Baum zeichnest, erhältst du eine Struktur, die zeigt, wie du von Dev Anand aus andere Knoten erreichst.
Die Exzentrizität eines Knotens A ist die größte Distanz zwischen A und allen anderen Knoten. Sie kann mit nx.eccentricity() berechnet werden. Im symmetrischen Schauspielernetzwerk hat Dev Anand eine Exzentrizität von 2, Abhishek Bachchan eine von 1 (er ist mit allen verbunden).
Oben haben wir Distanzmaße kennengelernt, die helfen zu verstehen, wie sich Informationen im Netzwerk ausbreiten. Jetzt schauen wir, wie wir die wichtigsten Knoten (Personen) im Netzwerk finden. Diese Kennzahlen heißen Zentralitätsmaße.
Erinnerst du dich an die beliebteste Schülerin aus deiner Schule oder den Star im Baseballteam? Solche Menschen konnten deine Schulzeit himmlisch oder zur Hölle machen. Was gab ihnen diese Macht? Zentralitätsmaße helfen uns, Beliebtheit, Ansehen und Einfluss im Netzwerk zu identifizieren.
Die beliebtesten oder am meisten gemochten Personen haben meist die meisten Freunde. Die Degree Centrality misst, wie viele Verbindungen ein bestimmter Knoten im Netzwerk hat. Dahinter steht die Annahme, dass wichtige Knoten viele Verbindungen besitzen. Mit degree_centrality() in NetworkX berechnen wir die Degree Centrality für alle Knoten eines Netzwerks.
Nicht nur die Anzahl der Verbindungen zählt, sondern auch, mit welchen Personen man vernetzt ist. In Delhi zum Beispiel hört die Verkehrspolizei nach einem Regelverstoß oft zuerst: „Weißt du, mit wem ich verwandt bin?“
Die Eigenvector Centrality misst genau das. Ein Knoten ist wichtig, wenn er mit anderen wichtigen Knoten verbunden ist. Mit eigenvector_centrality() in NetworkX berechnen wir die Eigenvector Centrality für alle Knoten.
Der Google-Pagerank-Algorithmus ist eine Variante der Eigenvector-Centrality.
Die Betweenness Centrality misst Kontrolle im Netzwerk. Sie gibt an, wie häufig ein Punkt auf geodätischen Pfaden (kürzesten Wegen) zwischen Punktpaaren liegt. Sie quantifiziert, wie oft ein bestimmter Knoten auf dem kürzesten Pfad zwischen zwei anderen Knoten erscheint. Knoten mit hoher Betweenness Centrality spielen eine zentrale Rolle im Kommunikations- bzw. Informationsfluss. Sie können strategische Kontrolle und Einfluss ausüben – etwa indem sie Informationen zurückhalten oder verfärben.
In NetworkX berechnen wir sie mit betweenness_centrality(). Dabei können wir u. a. festlegen, ob Werte normalisiert werden, Gewichte berücksichtigt werden und ob Endpunkte in die Zählung der kürzesten Wege einfließen.
Starten wir mit Facebook-Daten. Für unsere Analyse nutzen wir das „Facebook combined ego networks“-Dataset; es enthält das aggregierte Netzwerk der Freundeslisten von zehn Personen. Die benötigte Datei facebook_combined.txt kannst du von der Website der Stanford University herunterladen.
Du kannst auch eigene Facebook-/Twitter-Daten über die jeweiligen APIs abrufen. Freu dich auf das nächste Tutorial: Darin zeigen wir, wie du die Facebook- und Twitter-APIs nutzt und die hier gelernten Methoden darauf anwendest.
Wir lesen die Datei ein und bauen den Graphen auf:
G_fb = nx.read_edgelist("facebook_combined.txt", create_using = nx.Graph(), nodetype=int)
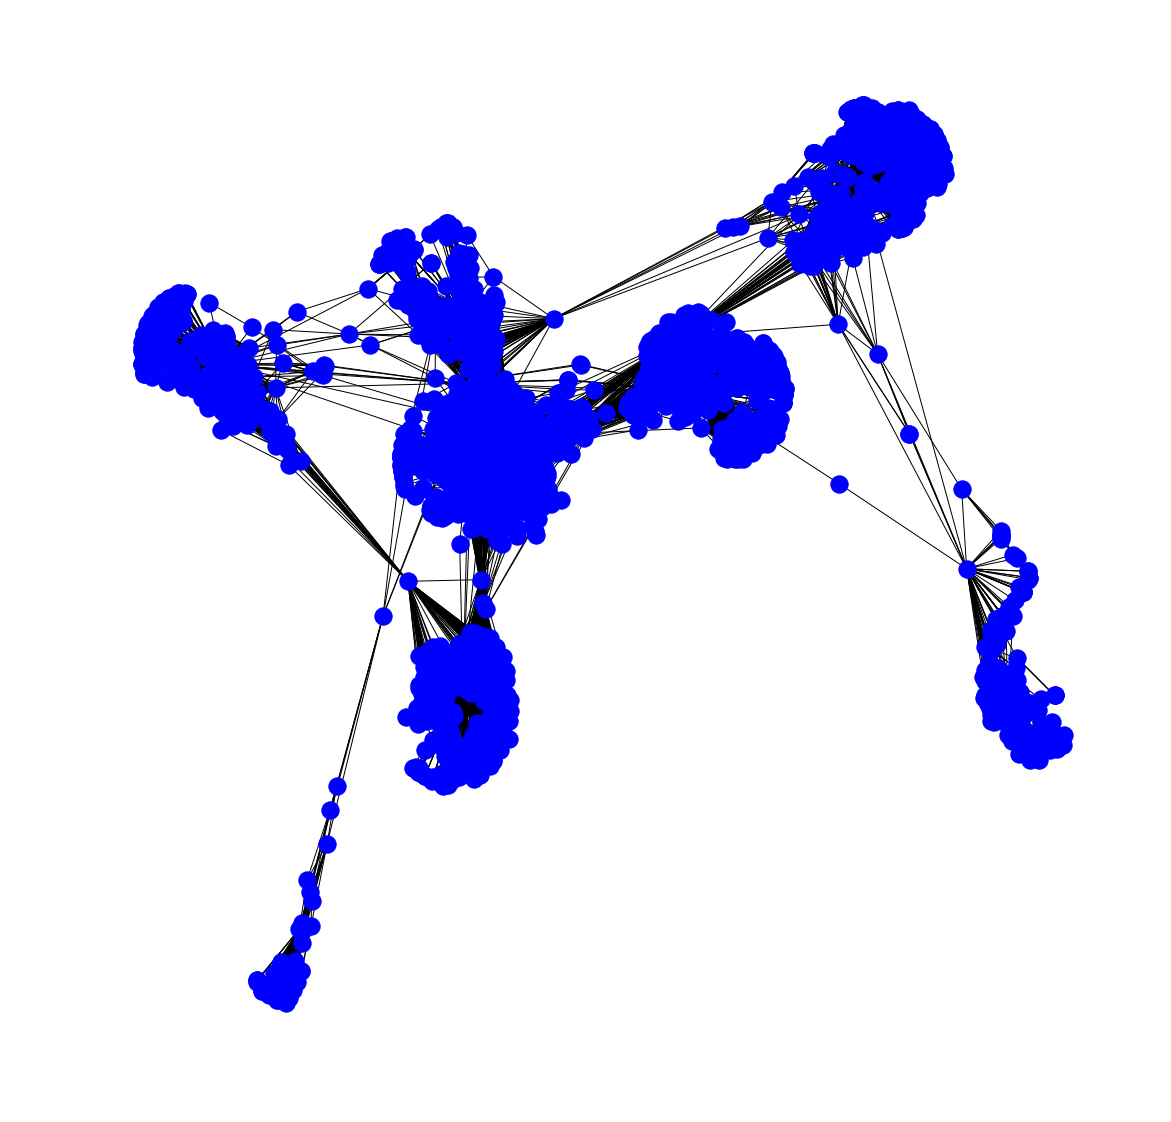
Das Netzwerk umfasst 4.039 Knoten, verbunden durch 88.234 Kanten. Das ist groß! Mit der Funktion info() bekommst du diese Informationen.
[In]: print(nx.info(G_fb))


[Out]: Name:
       Type: Graph
       Number of nodes: 4039
       Number of edges: 88234
       Average degree:  43.6910
Unten siehst du das Netzwerk:
Wir können das Netzwerk auch so visualisieren, dass die Knotenfarbe mit dem Grad variiert und die Knotengröße mit der Betweenness Centrality. Der Code dafür:
pos = nx.spring_layout(G_fb)
betCent = nx.betweenness_centrality(G_fb, normalized=True, endpoints=True)
node_color = [20000.0 * G_fb.degree(v) for v in G_fb]
node_size =  [v * 10000 for v in betCent.values()]
plt.figure(figsize=(20,20))
nx.draw_networkx(G_fb, pos=pos, with_labels=False,
                 node_color=node_color,
                 node_size=node_size )
plt.axis('off')
Die resultierende Grafik sieht so aus:
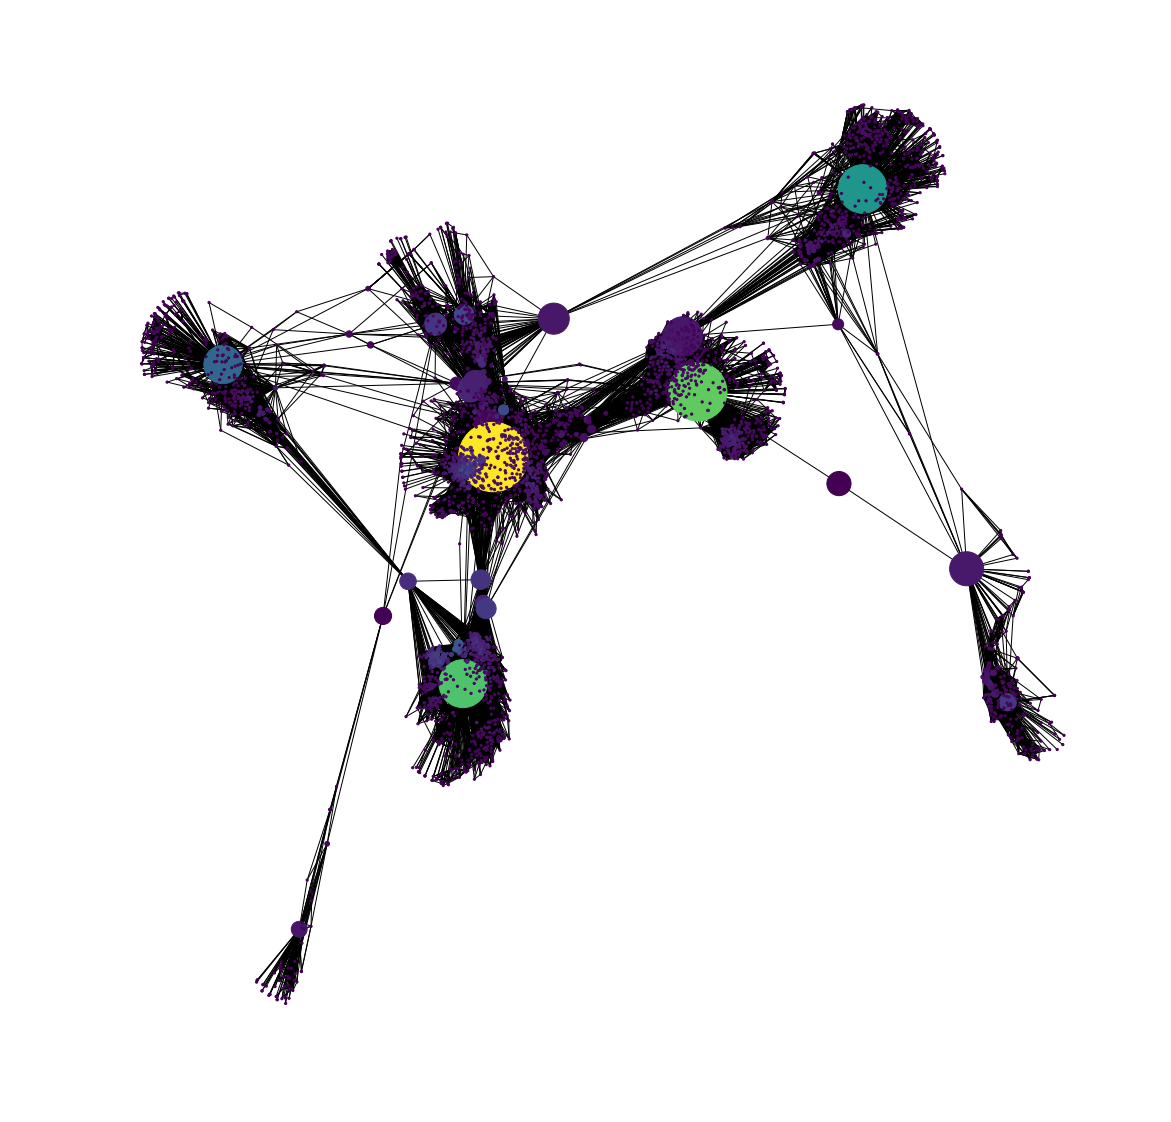
Die Labels der Knoten mit der höchsten Betweenness Centrality ermittelst du so:
sorted(betCent, key=betCent.get, reverse=True)[:5]
Die Tabelle unten listet die fünf Knotenlabels mit den höchsten Zentralitätsmaßen auf.
| Degree Centrality | Eigenvector Centrality | Betweenness Centrality |
|---|---|---|
| 107 | 1912 | 107 |
| 1684 | 2266 | 1684 |
| 1912 | 2206 | 3437 |
| 3437 | 2233 | 1912 |
| 0 | 2464 | 1085 |
Wir sehen, dass sich einige Knoten bei Degree Centrality (Gradmaß) und Betweenness Centrality (Kontrolle des Informationsflusses) überschneiden. Das ist naheliegend: Knoten mit vielen Verbindungen liegen oft auch auf kürzesten Pfaden zwischen anderen Knoten. Der Knoten 1912 ist besonders wichtig, da er in allen drei betrachteten Zentralitätsmaßen heraussticht.
Wenn du mehr über Social Network Analysis in Python lernen willst, mach den DataCamp-Kurs Analyzing Social Media Data in Python.
Mehr über Python und Datenanalyse lernen
Kurs
Kurs
Tutorial
DataCamp Team
5 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Adel Nehme
6 Min.