
Curso
Distribuciones de probabilidad multivariantes en R
4 h
8.9K
A veces necesitas predecir más de una cosa a la vez, como estimar ventas y rotación de clientes con los mismos datos.
En este artículo, te enseño a abordar varias tareas a la vez con la regresión lineal multivariante. Verás qué es, cómo funciona, cuándo utilizarla y cómo aplicarla en la práctica. Al final, estarás listo para llevarla a problemas del mundo real.
Si eres nuevo en regresión, quizá te interese repasar antes nuestra Introducción a la regresión en R o Introducción a la regresión con statsmodels en Python.
La regresión lineal multivariante es una técnica estadística que modela la relación entre múltiples variables independientes y múltiples variables dependientes. A veces se confunde con la regresión lineal múltiple porque suenan parecido, y yo mismo las he confundido. Pero la regresión lineal múltiple utiliza varios predictores para estimar un único resultado, mientras que la multivariante está pensada para situaciones en las que necesitas predecir más de un resultado al mismo tiempo.
Ya te he dado una vista general de qué es la regresión multivariante y cuándo usarla. Ahora vamos a ver cómo se estructura el modelo y en qué supuestos se apoya.
La regresión multivariante utiliza una formulación matricial para modelar varios resultados a la vez:
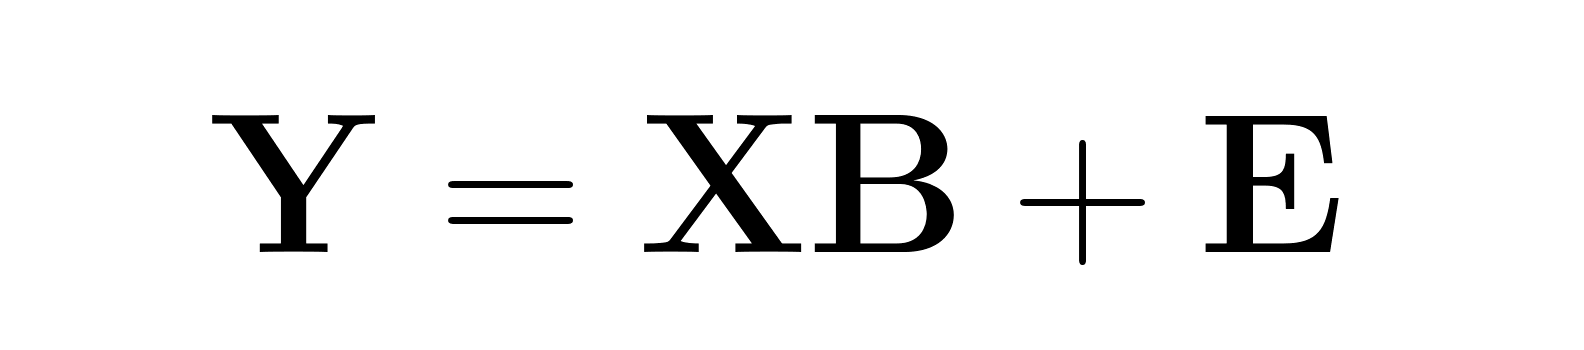
Donde:
Este enfoque reconoce que los errores de distintas variables respuesta pueden estar correlacionados, lo que permite estimaciones de parámetros más eficientes que en modelos univariantes por separado.
Antes de usar el modelo, es importante entender los supuestos que deben cumplirse y qué hacer si no se cumplen.
Si estos supuestos no se cumplen, tendrás que adaptarte. Por ejemplo, transforma variables para abordar problemas de no linealidad o normalidad, usa mínimos cuadrados ponderados para tratar la heteroscedasticidad o aplica ridge regression para problemas de colinealidad.
Si trabajas con variables categóricas, primero tendrás que convertirlas en variables ficticias (dummies).
Para una variable categórica con k categorías, crea k-1 dummies. Así evitas la redundancia conocida como la trampa de las variables ficticias. La categoría que se deja fuera es el nivel de referencia. Los coeficientes reflejarán la diferencia respecto a esa base, así que conviene elegir una que facilite la interpretación.
Con la estructura y los supuestos del modelo claros, veamos cómo se estiman los coeficientes y cómo se comparan los métodos en eficiencia y precisión.
OLS es el punto de partida por defecto y se extiende de forma natural al entorno multivariante. Proporciona estimaciones insesgadas de los coeficientes siempre que se cumplan los supuestos. Aunque las estimaciones individuales coinciden con las de ejecutar regresiones por separado, la ventaja aquí es que los residuos se comparten y puedes contrastar hipótesis conjuntas entre resultados.
Cuando los resultados están correlacionados, el OLS multivariante captura esas relaciones y a menudo (aunque no siempre) mejora la calidad global de la predicción.
Quizá te preguntes por qué se usa tanto OLS. El teorema de Gauss-Markov lo explica: bajo ciertos supuestos, OLS es el mejor estimador lineal insesgado (BLUE). Es decir, ofrece la menor varianza posible entre todos los estimadores lineales insesgados cuando se cumplen las condiciones habituales como ausencia de multicolinealidad, relaciones lineales y varianza constante.
¿Y si esas condiciones no se cumplen, en particular la de varianza constante? En ese caso, considero WLS. Asigna más peso a observaciones con menor varianza del error y menos a las más ruidosas.
WLS ajusta el proceso de OLS añadiendo una matriz de pesos. Puedes estimar los pesos usando los residuos de un modelo OLS o basarte en conocimiento teórico sobre la estructura del error de tus datos.
Para datos de alta dimensión o con multicolinealidad, los métodos de regularización son útiles. Admiten algo de sesgo a cambio de reducir la varianza, lo que a menudo mejora la predicción.
Ridge regression añade una penalización L2 (λ||B||²) que encoge todos los coeficientes hacia cero. Es útil cuando piensas que todos los predictores aportan algo. LASSO aplica una penalización L1 que puede anular por completo algunos coeficientes, lo que ayuda en la selección de variables. Elastic net combina ambas, útil cuando los predictores están correlacionados y quieres seguir seleccionando.
Una vez cubierta la estimación, toca evaluar el rendimiento del modelo y cómo extraer conclusiones útiles.
El R-cuadrado multivariante te da una idea de cuánta variación total explicas entre todos los resultados. A diferencia del univariante, este suele usar el determinante de la matriz de covarianzas residuales y puede no quedar siempre entre 0 y 1.
El R-cuadrado ajustado es especialmente importante en entornos multivariantes, ya que el número de parámetros crece rápido con múltiples resultados. Ayuda a evitar el sobreajuste penalizando la complejidad.
Las herramientas visuales como las elipses de confianza también son útiles. Estas elipses muestran la incertidumbre de las predicciones y cómo se relacionan las variables resultado entre sí. Elipses circulares sugieren independencia; las alargadas apuntan a correlaciones fuertes.
Cuando quieres saber si tu modelo hace algo más que ajustar ruido, las pruebas de hipótesis son clave.
La lambda de Wilks contrasta si ciertos predictores tienen efectos significativos en el conjunto de resultados. Compara las matrices de covarianza del error del modelo completo y de un modelo reducido para determinar si eliminar algunos predictores aumentaría de forma significativa la varianza no explicada.
El T² de Hotelling funciona como un t-test multivariante. Evalúa si un predictor influye en al menos un resultado, teniendo en cuenta las correlaciones entre resultados.
Las pruebas conjuntas ayudan a controlar el riesgo de falsos positivos cuando contrastas múltiples hipótesis a la vez. Esto es útil en la regresión multivariante, donde las comparaciones múltiples se descontrolan con facilidad.
Para decidir entre modelos, criterios como AIC y BIC son muy útiles. Ambos ajustan por complejidad, algo clave cuando modelas múltiples resultados. AIC se centra más en la capacidad predictiva, mientras que BIC tiende a favorecer modelos más simples.
También puedes usar pruebas de razón de verosimilitudes para comparar modelos anidados. Verifican si añadir predictores mejora de forma significativa el ajuste.
La regresión multivariante estándar funciona bien para muchos problemas, pero a veces te encontrarás con situaciones que requieren enfoques especializados. Quizá tengas cientos de predictores, o tus variables se influyen mutuamente de formas que violan los supuestos estándar. Aquí tienes cómo abordar (algunas de) estas situaciones más complejas.
Cuando trabajas con muchos predictores, la selección de variables es esencial tanto para el rendimiento como para la interpretabilidad. LASSO (de "Least Absolute Shrinkage and Selection Operator") destaca porque puede anular automáticamente predictores irrelevantes mientras ajusta el modelo.
A diferencia de ridge regression, que encoge todos los coeficientes hacia cero pero los mantiene, LASSO usa una penalización L1 que genera soluciones dispersas. Es muy útil cuando sospechas que solo un subconjunto de predictores realmente importa.
A veces tus predictores influyen en tus resultados y, a la vez, están influidos por ellos. Piensa en cómo la educación afecta a los ingresos, pero los ingresos también afectan al acceso a la educación. Esto genera endogeneidad, que vuelve poco fiables las estimaciones estándar de regresión.
Las variables instrumentales lo resuelven con un proceso en dos etapas. Primero, buscas un "instrumento", es decir, una variable que afecte a tu predictor problemático pero no afecte directamente al resultado. Luego usas ese instrumento para predecir la parte "limpia" de tu predictor, y esas predicciones las utilizas en la regresión final. Así rompes (o reduces) la relación circular y obtienes estimaciones fiables o más fiables.
La mayoría de paquetes estadísticos manejan regresión multivariante, aunque con distintos puntos fuertes. En Python, sklearn.linear_model. admite de forma nativa múltiples resultados para una verdadera regresión multivariante. En mi opinión, statsmodels ofrece salidas estadísticas más detalladas, incluidas pruebas de hipótesis. Si eres de quienes prefieren R, puedes usar la función incorporada lm() para modelos multivariantes básicos, o el paquete car para diagnósticos más sofisticados.
Partial Least Squares (PLS) resulta muy útil cuando tienes más predictores que observaciones o cuando la multicolinealidad crea problemas. En lugar de usar todos los predictores directamente, PLS crea variables latentes que capturan la información más relevante para predecir tus resultados. Funciona especialmente bien en campos como la quimiometría y la bioinformática, donde puedes tener cientos o miles de predictores y relativamente pocas observaciones.
PLS encuentra direcciones en el espacio de predictores que explican tanto la varianza de los predictores como la covarianza de los resultados. Es especialmente útil cuando la precisión predictiva importa más que la interpretación. La regresión lineal multivariante estándar puede volverse inestable con muchos predictores correlacionados, pero PLS se mantiene estable incluso en situaciones exigentes.
Los intervalos de confianza simples no funcionan bien para predicciones multivariantes porque ignoran las correlaciones entre resultados. Las elipses de confianza muestran la incertidumbre conjunta para pares de resultados, revelando cómo se correlacionan los errores de predicción entre distintas variables respuesta. Estas elipses te cuentan la estructura de relaciones en tus predicciones. Elipses circulares implican predicciones independientes; las alargadas indican fuertes correlaciones.
La orientación de las elipses alargadas muestra qué combinaciones lineales de resultados tienen más y menos incertidumbre. Puedes representarlas para predicciones individuales o para estimaciones de parámetros, y resultan muy útiles al presentar resultados porque dan una representación visual intuitiva de la confianza en distintos aspectos de tus predicciones.
Pasar de la teoría a la práctica implica lidiar con datos desordenados y asegurarte de que el modelo funciona. Así puedes abordar la parte práctica de la regresión multivariante.
Antes de ajustar cualquier modelo multivariante, tendrás que poner los datos a punto. Escalar y centrar es especialmente importante cuando los predictores están en unidades diferentes. Imagina comparar ingresos (en miles) con edad (en años) sin estandarizar. La mayoría de algoritmos funcionan mejor cuando las características están en escalas similares.
Los valores perdidos son otro reto. Puedes eliminar filas con datos faltantes, pero desperdicias información e introduces sesgos. Mejores enfoques incluyen la imputación por la media para variables numéricas o métodos más sofisticados como la imputación múltiple, que crea varios conjuntos de datos plausibles y combina los resultados.
La validación cruzada te ayuda a entender qué tan bien generaliza tu modelo más allá de los datos de entrenamiento. En regresión multivariante, la k-fold divide los datos en k grupos, entrena en k-1 y prueba en el restante. Repites k veces y promedias para tener una estimación robusta del rendimiento.
El bootstrapping ofrece otro enfoque de validación, muy útil para entender la incertidumbre de los parámetros. Crea nuevos conjuntos de datos muestreando con reemplazo del original, ajusta modelos a cada muestra bootstrap y examina la distribución de las estimaciones. Esto te indica la estabilidad de los coeficientes y ayuda a construir intervalos de confianza.
Veamos un ejemplo con un conjunto de datos de ensayos de materiales. Las ingenierías suelen necesitar predecir varias propiedades del hormigón —como resistencia a compresión y trabajabilidad— a partir de los componentes de la mezcla: contenido de cemento, relación agua, tipo de árido, etc. Tiene todo el sentido usar regresión multivariante, ya que estos resultados están relacionados pero son distintos.
El análisis comienza explorando las correlaciones entre componentes y resultados, comprobando la multicolinealidad entre predictores y examinando si las relaciones parecen lineales. Tras el preprocesamiento (escalar las proporciones de la mezcla y gestionar medidas faltantes), ajustarías el modelo multivariante y lo validarías con validación cruzada para asegurarte de que las predicciones se mantienen en nuevas mezclas.
Este es un flujo básico que muestra los pasos clave en Python. Primero, preparamos los datos y hacemos el preprocesamiento:
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
from sklearn.metrics import mean_squared_error

# Load and prepare data (assuming concrete dataset)
# X: mixture components (cement, water, aggregate, etc.)
# y: multiple outcomes (strength, workability, durability)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Este paso estandariza todos los predictores a media cero y varianza unitaria, lo que ayuda a la estabilidad numérica y a la interpretación.
A continuación, ajustamos el modelo multivariante y examinamos los resultados:
# Fit multivariate regression
mlr_model = LinearRegression()
mlr_model.fit(X_scaled, y)

# Get coefficients for each outcome
for i, outcome in enumerate(['strength', 'workability', 'durability']):
   coeffs = mlr_model.coef_[:, i]
   print(f"{outcome} coefficients: {coeffs}”)
El modelo LinearRegression ajusta una única regresión multivariante que tiene en cuenta las correlaciones entre todos los resultados. Los coeficientes te indican cómo afecta cada componente de la mezcla a cada propiedad del hormigón.
Por último, validamos el modelo para comprobar su fiabilidad:
# Cross-validation for each outcome
cv_scores = cross_val_score(mlr_model, X_scaled, y,
                           cv=5, scoring='neg_mean_squared_error')
print(f"Average CV score: {-cv_scores.mean():.3f}")

# Make predictions on new data
y_pred = mlr_model.predict(X_scaled)
mse_per_outcome = [mean_squared_error(y[:, i], y_pred[:, i])
                   for i in range(y.shape[1])]
print(f"MSE per outcome: {mse_per_outcome}")
La validación cruzada te da una estimación honesta de cómo rinde el modelo con datos no vistos. Los MSE por resultado te ayudan a ver qué propiedades del hormigón son más fáciles o más difíciles de predecir con precisión.
La regresión lineal multivariante funciona bien en muchos problemas, pero tiene límites claros. La mayor limitación está en el nombre: asume relaciones lineales entre predictores y resultados. Cuando las relaciones son curvilíneas, con muchas interacciones u otras no linealidades, el modelo dará estimaciones sesgadas. La alta dimensionalidad es otro problema: con muchos predictores respecto a las observaciones, el modelo se vuelve inestable y propenso al sobreajuste.
Varias alternativas pueden manejar mejor estas limitaciones. Los modelos lineales generalizados (GLM) amplían el marco a resultados no normales y permiten distintos enlaces. ANCOVA funciona bien cuando tienes predictores continuos y categóricos con interacciones. Para el sobreajuste, los métodos de regularización como ridge y LASSO ayudan, o puedes probar métodos de conjunto como los random forests, que manejan la no linealidad y la alta dimensión de forma más natural.
La regresión lineal multivariante te ofrece una forma sólida de modelar múltiples resultados relacionados a la vez, capturando relaciones que los modelos univariantes por separado pasan por alto. Sus puntos fuertes están en la interpretabilidad, la capacidad de realizar pruebas estadísticas y la eficiencia al manejar resultados correlacionados.
Que te quedes con la MLR estándar o te muevas a enfoques como la regresión regularizada, el partial least squares o los métodos de conjunto depende de las características de tus datos, el tamaño de muestra y de si te importa más predecir o interpretar en tu caso concreto.
Si quieres seguir reforzando tus habilidades, nuestro curso Intermediate Regression with statsmodels in Python cubre múltiples variables explicativas y efectos de interacción, mientras que Generalized Linear Models in R amplía tu caja de herramientas para manejar distribuciones no normales como la binomial y la Poisson para datos de conteo.
Aprende con DataCamp
Curso
Curso
Curso
Tutorial
Zoumana Keita
12 min
Tutorial
Kurtis Pykes
8 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Natassha Selvaraj
11 min
Tutorial
Avinash Navlani
10 min
Tutorial
DataCamp Team
2 min




