
Cours
Lois de probabilité multivariées en R
4 h
8.9K
Il arrive que vous deviez prédire plusieurs choses en même temps, comme anticiper à la fois les ventes et l'attrition client à partir des mêmes données.
Dans cet article, je vais vous montrer comment ménager la chèvre et le chou. Nous allons parler de régression linéaire multivariée : ce que c'est, comment ça marche, quand l'utiliser et comment la mettre en pratique. À la fin, vous serez prêt(e) à l'appliquer à des problèmes concrets.
Si vous débutez en régression, vous pouvez consulter d'abord nos cours Introduction to Regression in R ou Introduction to Regression with statsmodels in Python.
La régression linéaire multivariée est une technique statistique qui modélise la relation entre plusieurs variables indépendantes et plusieurs variables dépendantes. Elle est parfois confondue avec la régression linéaire multiple car les noms se ressemblent — et il m'est déjà arrivé de les confondre. Mais la régression linéaire multiple utilise plusieurs prédicteurs pour estimer une seule issue, tandis que la multivariée est conçue pour les situations où vous devez prédire plusieurs issues simultanément.
Je viens de définir ce qu'est la régression multivariée et quand l'utiliser. Voyons maintenant comment le modèle est structuré et sur quelles hypothèses il repose.
La régression multivariée s'appuie sur une formulation matricielle pour modéliser plusieurs issues en même temps :
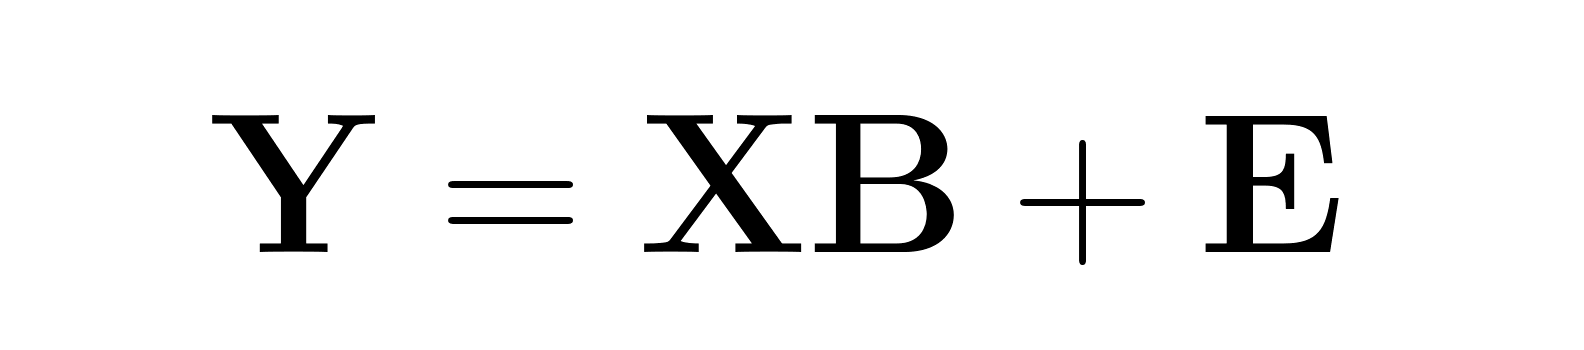
Où :
Cette approche reconnaît que les termes d'erreur des différentes variables réponse peuvent être corrélés, ce qui permet une estimation des paramètres plus efficiente que des modèles univariés séparés.
Avant d'utiliser le modèle, il est essentiel de comprendre les hypothèses qui doivent tenir — et quoi faire si ce n'est pas le cas.
Si ces hypothèses ne tiennent pas, adaptez-vous. Par exemple, transformez des variables pour corriger la non‑linéarité ou des problèmes de normalité, passez aux moindres carrés pondérés pour gérer l'hétéroscédasticité, ou utilisez la régression ridge en cas de collinéarité.
Avec des variables catégorielles, il faut d'abord les convertir en variables indicatrices (dummies).
Pour une variable à k modalités, créez k−1 indicatrices. Cela évite la redondance (le fameux « piège des variables indicatrices »). La modalité omise devient la référence. Vos coefficients reflètent alors l'écart par rapport à cette base : choisissez un référent qui facilite l'interprétation.
Une fois la structure et les hypothèses posées, voyons comment estimer les coefficients et comparer les méthodes en termes d'efficience et de précision.
OLS est le point de départ par défaut et s'étend naturellement au cadre multivarié. Il fournit des estimations non biaisées des coefficients dès lors que les hypothèses sont respectées. Les estimations individuelles sont identiques à celles de régressions séparées, mais ici les résidus sont partagés, ce qui permet de tester des hypothèses conjointes sur l'ensemble des issues.
Lorsque les issues sont corrélées, l'OLS multivarié capture ces liens et améliore souvent (mais pas toujours) la qualité globale des prédictions.
Vous vous demandez peut-être pourquoi l'OLS est si répandu. Le théorème de Gauss‑Markov l'explique : sous certaines hypothèses, l'OLS est le meilleur estimateur linéaire sans biais (BLUE). Autrement dit, il minimise la variance parmi tous les estimateurs linéaires non biaisés, sous les conditions usuelles : pas de multicolinéarité, relations linéaires et variance constante.
Mais si ces conditions ne tiennent pas, en particulier la variance constante ? Dans ce cas, j'envisage WLS. Cette approche accorde plus de poids aux observations à faible variance d'erreur et moins aux plus bruitées.
WLS adapte la procédure OLS en ajoutant une matrice de poids. Vous pouvez estimer les poids à partir des résidus d'un modèle OLS ou selon des connaissances théoriques de la structure d'erreur de vos données.
Dans des scénarios de forte dimension ou de multicolinéarité, les méthodes de rétrécissement (shrinkage) sont utiles. Elles tolèrent un peu de biais pour réduire la variance, ce qui améliore souvent la prédiction.
La régression ridge ajoute une pénalité L2 (λ||B||²) en rapprochant tous les coefficients de zéro : utile quand chaque prédicteur peut apporter quelque chose. LASSO applique une pénalité L1 qui peut annuler certains coefficients — pratique pour la sélection de variables. Elastic Net combine les deux, efficace avec des prédicteurs corrélés tout en sélectionnant.
Après l'estimation, évaluons la performance du modèle et la manière d'en tirer des conclusions utiles.
Le R² multivarié renseigne sur la part de variation globale expliquée par le modèle sur l'ensemble des issues. Contrairement à sa version univariée, il s'appuie souvent sur le déterminant de la matrice de covariance résiduelle et peut ne pas toujours rester entre 0 et 1.
Le R² ajusté est particulièrement important en multivarié, car le nombre de paramètres augmente vite avec plusieurs issues. Il pénalise la complexité pour éviter le surapprentissage.
Des outils visuels comme les ellipses de confiance peuvent aussi aider. Elles illustrent l'incertitude des prédictions et les liens entre variables réponse. Des ellipses circulaires suggèrent l'indépendance ; des ellipses étirées indiquent de fortes corrélations.
Pour vérifier si votre modèle fait mieux que suivre le bruit, les tests d'hypothèse sont essentiels.
Le lambda de Wilks teste si certains prédicteurs ont des effets significatifs sur l'ensemble des issues. Il compare les matrices de covariance des erreurs du modèle complet et d'un modèle réduit pour déterminer si retirer des prédicteurs augmente significativement la variance inexpliquée.
Le T² de Hotelling joue le rôle d'un test t multivarié : il évalue si un prédicteur donné influence au moins une issue, en tenant compte des corrélations entre issues.
Les tests conjoints aident à maîtriser le risque de faux positifs lorsqu'on teste plusieurs hypothèses à la fois, fréquent en régression multivariée.
Pour trancher entre des modèles, des critères comme l'AIC et le BIC sont utiles. Tous deux pénalisent la complexité, crucial lorsque vous modélisez plusieurs issues. L'AIC favorise davantage la puissance prédictive, tandis que le BIC préfère souvent les modèles plus simples.
Les tests du rapport de vraisemblance permettent aussi de comparer des modèles emboîtés et de vérifier si l'ajout de prédicteurs améliore significativement l'ajustement.
La régression multivariée standard convient à de nombreux problèmes, mais certaines situations exigent des approches spécifiques. Peut-être avez-vous des centaines de prédicteurs, ou des variables qui s'influencent mutuellement en violant les hypothèses classiques. Voici comment gérer (une partie de) ces scénarios plus complexes.
Avec de nombreux prédicteurs, la sélection de variables devient essentielle, tant pour la performance que pour l'interprétabilité. LASSO (Least Absolute Shrinkage and Selection Operator) se distingue car il peut automatiquement annuler les prédicteurs non pertinents tout en ajustant le modèle.
Contrairement à la régression ridge, qui rapproche tous les coefficients de zéro mais les conserve, LASSO applique une pénalité L1 qui produit des solutions creuses (parcimonieuses). Idéal si vous pensez qu'un sous-ensemble seulement de vos prédicteurs compte vraiment.
Il arrive que vos prédicteurs influencent vos issues tout en étant eux-mêmes influencés par elles. Pensez au lien entre éducation et revenu : l'éducation influe sur le revenu, mais le revenu conditionne aussi l'accès à l'éducation. Cela crée de l'endogénéité, qui rend les estimations classiques peu fiables.
Les variables instrumentales résolvent ce problème en deux étapes. D'abord, trouvez un « instrument », c'est-à-dire une variable qui affecte le prédicteur posant problème sans agir directement sur l'issue. Ensuite, utilisez cet instrument pour prédire la partie « propre » du prédicteur, puis ces prédictions dans la régression finale. Cela brise (ou atténue) la boucle et fournit des estimations plus fiables.
La plupart des environnements statistiques gèrent la régression multivariée, avec des atouts variés. En Python, sklearn.linear_model. gère nativement des issues multiples pour une véritable régression multivariée. À mon sens, statsmodels fournit un détail statistique plus riche, y compris des tests d'hypothèse. Si vous préférez le langage R, utilisez simplement la fonction intégrée lm() pour des modèles multivariés de base, ou le package car pour des diagnostics plus avancés.
La méthode des moindres carrés partiels (PLS) est utile lorsque vous avez plus de prédicteurs que d'observations, ou lorsque la multicolinéarité pose problème. Plutôt que d'utiliser directement tous les prédicteurs, PLS crée des variables latentes capturant l'information la plus pertinente pour prédire vos issues. Cette approche fonctionne particulièrement bien en chimétrie et en bio-informatique, où l'on peut avoir des centaines voire des milliers de prédicteurs pour relativement peu d'observations.
PLS trouve des directions dans l'espace des prédicteurs qui expliquent à la fois la variance des prédicteurs et la covariance des issues. C'est précieux lorsque la précision prédictive prime sur l'interprétation. La régression linéaire multivariée classique peut devenir instable en présence de nombreux prédicteurs corrélés, alors que PLS reste robuste dans ces contextes.
Les intervalles de confiance simples conviennent mal aux prédictions multivariées car ils ignorent les corrélations entre issues. Les ellipses de confiance montrent l'incertitude conjointe pour des paires d'issues et révèlent comment les erreurs de prédiction sont corrélées entre variables réponse. Des ellipses circulaires indiquent des prédictions indépendantes ; des ellipses étirées signalent de fortes corrélations.
L'orientation des ellipses étirées indique quelles combinaisons linéaires d'issues présentent le plus et le moins d'incertitude. Vous pouvez les tracer pour des prédictions individuelles ou pour des estimations de paramètres ; elles sont très parlantes lors de la présentation des résultats.
Passer de la théorie à la pratique implique de gérer des données imparfaites et de s'assurer que le modèle tient la route. Voici comment aborder le côté opérationnel de la régression multivariée.
Avant d'ajuster un modèle multivarié, mettez vos données en ordre. La mise à l'échelle et le centrage sont cruciaux lorsque les prédicteurs n'ont pas les mêmes unités. Imaginez comparer un revenu (en milliers) à un âge (en années) sans standardisation. La plupart des algorithmes fonctionnent mieux lorsque les caractéristiques sont sur des échelles comparables.
Les valeurs manquantes posent un autre défi. Supprimer les lignes incomplètes gaspille de l'information et peut introduire du biais. Préférez une imputation par la moyenne pour les variables numériques ou des méthodes plus avancées comme l'imputation multiple, qui crée plusieurs jeux de données plausibles et agrège les résultats.
La validation croisée aide à mesurer dans quelle mesure votre modèle généralise au-delà des données d'entraînement. En régression multivariée, la k-fold consiste à diviser les données en k groupes, à entraîner sur k−1 et à tester sur le groupe restant. Répétez k fois et moyennez pour une estimation robuste de la performance.
Le bootstrap offre une autre approche particulièrement utile pour apprécier l'incertitude des paramètres. Il crée de nouveaux jeux de données par tirages avec remise à partir des données initiales, ajuste des modèles sur chaque échantillon bootstrap et examine la distribution des estimations. Vous mesurez ainsi la stabilité des coefficients et construisez des intervalles de confiance.
Prenons un exemple concret avec un jeu de données d'essais de matériaux. Les ingénieurs doivent souvent prédire plusieurs propriétés du béton — comme la résistance à la compression et l'ouvrabilité — à partir des composants du mélange (teneur en ciment, rapport eau, type de granulats). La régression multivariée s'y prête parfaitement, ces issues étant liées mais distinctes.
On commence par explorer les corrélations entre composants et issues, détecter la multicolinéarité entre prédicteurs et vérifier la linéarité des relations. Après prétraitement (mise à l'échelle des ratios et gestion des mesures manquantes), on ajuste le modèle multivarié et on le valide par validation croisée pour s'assurer que les prédictions se généralisent à de nouveaux mélanges.
Voici un flux de travail basique illustrant les étapes clés en Python. D'abord, préparons les données et le prétraitement :
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
from sklearn.metrics import mean_squared_error

# Load and prepare data (assuming concrete dataset)
# X: mixture components (cement, water, aggregate, etc.)
# y: multiple outcomes (strength, workability, durability)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Cette étape standardise tous les prédicteurs (moyenne nulle, variance unité), ce qui améliore la stabilité numérique et l'interprétation.
Ensuite, ajustons le modèle multivarié et examinons les résultats :
# Fit multivariate regression
mlr_model = LinearRegression()
mlr_model.fit(X_scaled, y)

# Get coefficients for each outcome
for i, outcome in enumerate(['strength', 'workability', 'durability']):
   coeffs = mlr_model.coef_[:, i]
   print(f"{outcome} coefficients: {coeffs}”)
Le modèle LinearRegression ajuste une régression multivariée unique qui tient compte des corrélations entre toutes les issues simultanément. Les coefficients indiquent comment chaque composant du mélange influe sur chaque propriété du béton.
Enfin, validons le modèle pour vérifier sa fiabilité :
# Cross-validation for each outcome
cv_scores = cross_val_score(mlr_model, X_scaled, y,
                           cv=5, scoring='neg_mean_squared_error')
print(f"Average CV score: {-cv_scores.mean():.3f}")

# Make predictions on new data
y_pred = mlr_model.predict(X_scaled)
mse_per_outcome = [mean_squared_error(y[:, i], y_pred[:, i])
                   for i in range(y.shape[1])]
print(f"MSE per outcome: {mse_per_outcome}")
La validation croisée fournit une estimation honnête des performances sur des données non vues. Les MSE par issue vous aident à voir quelles propriétés du béton sont plus ou moins prédictibles avec précision.
La régression linéaire multivariée est efficace dans bien des cas, mais ses limites sont claires : comme son nom l'indique, elle suppose des relations linéaires entre prédicteurs et issues. Si les relations sont courbes, riches en interactions ou non linéaires, les résultats seront biaisés. Une forte dimensionnalité pose aussi souci : avec beaucoup de prédicteurs pour peu d'observations, le modèle devient instable et sujet au surapprentissage.
Plusieurs alternatives gèrent mieux ces limites. Les modèles linéaires généralisés (GLM) étendent le cadre aux issues non normales et autorisent différentes fonctions de lien. L'ANCOVA convient lorsque vous avez à la fois des prédicteurs continus et catégoriels avec interactions. Pour les risques de surapprentissage, les méthodes de régularisation comme ridge et LASSO aident, ou bien des méthodes d'ensemble comme les random forests, plus naturelles pour gérer la non-linéarité et les hautes dimensions.
La régression linéaire multivariée offre un moyen solide de modéliser simultanément plusieurs issues liées, en captant des relations qu'un ensemble de modèles univariés manquerait. Ses principaux atouts : l'interprétabilité, des capacités de tests statistiques et une gestion efficiente des issues corrélées.
Choisir entre la MLR standard, la régularisation, les moindres carrés partiels ou des méthodes d'ensemble dépend de vos données, de la taille d'échantillon, et de l'importance relative de la prédiction ou de l'interprétation pour votre problème.
Pour aller plus loin, notre cours Intermediate Regression with statsmodels in Python couvre les variables explicatives multiples et les effets d'interaction, tandis que Generalized Linear Models in R élargit votre boîte à outils pour traiter des distributions non normales comme la loi binomiale et la loi de Poisson pour les données de comptage.
Learn with DataCamp
Cours
Cours
Cours