
Curso
Distribuições de Probabilidade Multivariadas em R
4 h
8.9K
Às vezes, você precisa prever mais de uma coisa ao mesmo tempo, como projetar vendas e churn de clientes usando os mesmos dados.
Neste artigo, vou te mostrar como dar conta desse multitarefa. Vamos falar de regressão linear multivariada. Você vai entender o que é, como funciona, quando usar e como aplicar na prática. No fim, você estará pronto para levar isso a problemas do mundo real.
Se você é novo em regressão, pode ser útil revisar antes nossos cursos Introduction to Regression in R ou Introduction to Regression with statsmodels in Python.
A regressão linear multivariada é uma técnica estatística que modela a relação entre múltiplas variáveis independentes e múltiplas variáveis dependentes. Ela às vezes é confundida com regressão linear múltipla porque o nome é parecido, e eu mesmo já confundi as duas. Mas a regressão linear múltipla usa vários preditores para estimar um único desfecho, enquanto a multivariada é feita para quando você precisa prever mais de um resultado ao mesmo tempo.
Acabei de dar uma visão geral do que é regressão multivariada e quando usar. Agora, vamos ver como o modelo é estruturado e em quais pressupostos ele se apoia.
A regressão multivariada usa uma formulação matricial para modelar vários desfechos ao mesmo tempo:
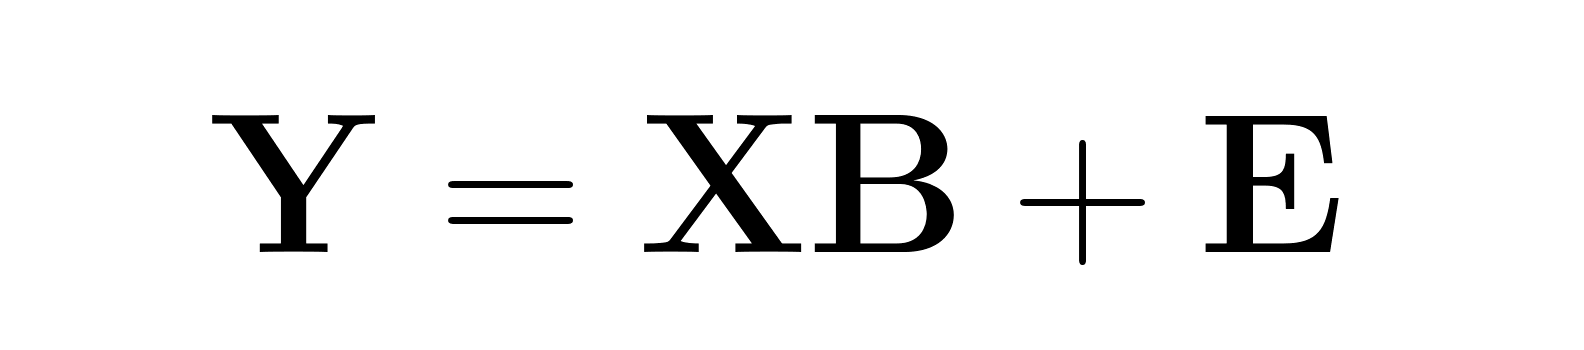
Onde:
Essa abordagem reconhece que os erros de diferentes variáveis resposta podem ser correlacionados, levando a uma estimação de parâmetros mais eficiente do que modelos univariados separados.
Antes de usar o modelo, é importante entender os pressupostos que precisam ser atendidos — e o que fazer se não forem.
Se esses pressupostos não se mantiverem, você vai precisar se adaptar. Por exemplo, tente transformar variáveis para lidar com não linearidade ou problemas de normalidade, use mínimos quadrados ponderados para tratar a heteroscedasticidade, ou aplique ridge regression para problemas de colinearidade.
Se você estiver trabalhando com variáveis categóricas, primeiro precisa convertê-las em variáveis dummies.
Para uma variável categórica com k categorias, crie k-1 dummies. Isso evita redundância, o chamado “dummy variable trap”. A categoria deixada de fora vira o nível de referência. Seus coeficientes passam a refletir a diferença em relação a essa base. Então vale a pena escolher uma referência que facilite a interpretação.
Com a estrutura do modelo e os pressupostos em mente, vamos ver como os coeficientes são estimados e como os métodos se comparam em eficiência e acurácia.
OLS é o ponto de partida padrão e se estende naturalmente ao contexto multivariado. Ele fornece estimativas não viesadas dos coeficientes desde que os pressupostos sejam atendidos. Embora as estimativas individuais sejam as mesmas de rodar regressões separadas, a vantagem aqui é que os resíduos são compartilhados, permitindo testar hipóteses conjuntas entre desfechos.
Quando os desfechos são correlacionados, o OLS multivariado captura essas relações e muitas vezes (mas não sempre) melhora a qualidade geral da previsão.
Você pode estar se perguntando por que o OLS é tão usado. O teorema de Gauss-Markov explica: sob certos pressupostos, o OLS é o Melhor Estimador Linear Não Viesado (BLUE). Isso significa que ele fornece a menor variância possível entre todos os estimadores lineares não viesados, assumindo condições usuais como ausência de multicolinearidade, relações lineares e variância constante.
Mas e se essas condições não segurarem, especialmente a de variância constante? Nesses casos, considere WLS. Ele dá mais peso às observações com menor variância do erro e menos às mais ruidosas.
O WLS ajusta o processo do OLS adicionando uma matriz de pesos. Você pode estimar pesos usando resíduos de um modelo OLS ou com base em conhecimento teórico sobre a estrutura do erro nos seus dados.
Agora, pense em cenários com dados de alta dimensão ou multicolinearidade. Métodos de shrinkage são úteis aqui. Eles aceitam um pouco de viés em troca de redução de variância, o que muitas vezes ajuda na previsão.
Ridge regression adiciona uma penalidade L2 (λ||B||²), encolhendo todos os coeficientes em direção a zero. É útil quando todo preditor pode contribuir. Já o LASSO aplica uma penalidade L1 que pode zerar alguns coeficientes — ótimo para seleção de variáveis. O elastic net combina as duas, ajudando quando os preditores são correlacionados e ainda fazendo seleção.
Depois de cobrir a estimação, vamos avaliar o desempenho do modelo e como tirar conclusões relevantes a partir dele.
O R-quadrado multivariado dá uma noção de quanta variação total seu modelo explica em todos os desfechos. Diferente da versão univariada, ele costuma usar o determinante da matriz de covariância residual e pode não ficar sempre entre 0 e 1.
R-quadrado ajustado é especialmente importante em contextos multivariados, já que a quantidade de parâmetros cresce rápido com múltiplos desfechos. Ele ajuda a evitar overfitting ao penalizar complexidade.
Ferramentas visuais como elipses de confiança também podem ajudar. Essas elipses mostram a incerteza nas previsões e como as variáveis de desfecho se relacionam entre si. Elipses circulares sugerem independência; elipses alongadas indicam correlações fortes.
Quando você quer saber se seu modelo faz mais do que ajustar ruído, testes de hipótese são essenciais.
O Lambda de Wilks testa se determinados preditores têm efeitos significativos no conjunto de desfechos. Ele compara as matrizes de covariância do erro do modelo completo e de um modelo reduzido para determinar se remover certos preditores aumentaria significativamente a variância não explicada.
O T² de Hotelling funciona como um teste t multivariado. Ele avalia se um preditor específico influencia ao menos um desfecho, considerando as correlações entre desfechos.
Testes conjuntos ajudam a controlar o risco de falsos positivos quando várias hipóteses são testadas ao mesmo tempo. Isso é útil em regressão multivariada, onde comparações múltiplas rapidamente saem do controle.
Para decidir entre modelos, critérios como AIC e BIC são muito úteis. Ambos ajustam pela complexidade, o que é especialmente importante ao modelar múltiplos desfechos. O AIC foca mais em poder preditivo, enquanto o BIC tende a preferir modelos mais simples.
Você também pode usar testes de razão de verossimilhança para comparar modelos aninhados. Eles verificam se adicionar preditores melhora significativamente o ajuste.
A regressão multivariada padrão funciona bem em muitos problemas, mas às vezes você vai se deparar com situações que exigem abordagens especializadas. Pode ser que você tenha centenas de preditores, ou que suas variáveis influenciem umas às outras de modos que violam os pressupostos padrão. Veja como lidar (com parte) desses cenários mais espinhosos.
Quando você trabalha com muitos preditores, a seleção de variáveis é essencial tanto para performance quanto para interpretabilidade. O LASSO (sigla de ‘Least Absolute Shrinkage and Selection Operator’) se destaca porque pode zerar automaticamente preditores irrelevantes enquanto ajusta o modelo.
Diferente do ridge, que encolhe todos os coeficientes em direção a zero mas os mantém, o LASSO usa uma penalidade L1 que cria soluções esparsas. Isso é ótimo quando você suspeita que só um subconjunto dos preditores realmente importa.
Às vezes, seus preditores influenciam os desfechos e ao mesmo tempo são influenciados por eles. Pense em como educação afeta renda, mas renda também afeta acesso à educação. Isso cria a chamada endogeneidade, que torna as estimativas de regressão padrão pouco confiáveis.
Variáveis instrumentais resolvem isso com um processo em duas etapas. Primeiro, você encontra um "instrumento", isto é, uma variável que afeta o preditor problemático mas não afeta diretamente o desfecho. Depois usa esse instrumento para prever a parte “limpa” do preditor e usa essas previsões na regressão final. Isso deve quebrar, ou ao menos reduzir, a relação circular e gerar estimativas confiáveis (ou mais confiáveis).
A maioria dos pacotes estatísticos lida com regressão multivariada, cada um com seus pontos fortes. Em Python, sklearn.linear_model. oferece suporte nativo a múltiplos desfechos para regressão multivariada de verdade. Na minha visão, o statsmodels traz saídas estatísticas mais detalhadas, incluindo testes de hipótese. Se você é do time que prefere R, dá para seguir com a função lm() para modelos multivariados básicos, ou usar o pacote car para diagnósticos mais sofisticados.
O Partial Least Squares (PLS) é útil quando você tem mais preditores do que observações, ou quando a multicolinearidade está causando problemas. Em vez de usar todos os preditores diretamente, o PLS cria variáveis latentes que capturam as informações mais relevantes para prever seus desfechos. Essa abordagem funciona especialmente bem em áreas como quimiometria e bioinformática, onde você pode ter centenas ou milhares de preditores, mas relativamente poucas observações.
O PLS encontra direções no espaço dos preditores que explicam tanto a variância dos preditores quanto a covariância dos desfechos (covariância). Ele é especialmente útil quando a acurácia preditiva importa mais do que a interpretação. A regressão linear multivariada padrão pode ficar instável com muitos preditores correlacionados, mas o PLS se mantém estável mesmo em situações desafiadoras.
Intervalos de confiança simples não funcionam bem para previsões multivariadas porque ignoram as correlações entre desfechos. Elipses de confiança mostram a incerteza conjunta para pares de desfechos, revelando como os erros de previsão se correlacionam entre diferentes variáveis resposta. Essas elipses informam sobre a estrutura de relacionamento nas suas previsões. Elipses circulares significam que seus desfechos são previstos de forma independente; elipses alongadas indicam correlações fortes.
A orientação de elipses alongadas mostra quais combinações lineares de desfechos têm mais e menos incerteza. Você pode plotá-las para previsões individuais ou para estimativas de parâmetros, e elas são úteis para apresentar resultados porque oferecem uma visualização intuitiva do quão confiante você pode estar em diferentes aspectos das suas previsões.
Sair da teoria para a prática significa lidar com dados bagunçados e garantir que seu modelo realmente funcione. Veja como encarar o lado prático da regressão multivariada.
Antes de ajustar qualquer modelo multivariado, você precisa preparar seus dados. Escalonamento e centralização são especialmente importantes quando os preditores têm unidades diferentes. Imagine comparar renda (em milhares) com idade (em anos) sem padronizar. A maioria dos algoritmos funciona melhor quando os atributos estão em escalas semelhantes.
Valores ausentes são outro desafio. Você pode descartar linhas com dados faltantes, mas isso desperdiça informação e pode introduzir viés. Abordagens melhores incluem imputação pela média para variáveis numéricas ou métodos mais sofisticados como imputação múltipla, que cria vários conjuntos de dados plausíveis e combina os resultados.
Cross-validation ajuda a entender o quão bem seu modelo generaliza além dos dados de treino. Para regressão multivariada, a validação cruzada k-fold divide seus dados em k grupos, treina em k-1 grupos e testa no grupo restante. Repita k vezes e faça a média dos resultados para ter uma estimativa robusta de performance.
Bootstrapping oferece outra forma de validação, particularmente útil para entender a incerteza dos parâmetros. Ele cria novos conjuntos de dados por amostragem com reposição a partir dos seus dados originais, ajusta modelos em cada amostra bootstrap e examina a distribuição das estimativas dos parâmetros. Isso mostra quão estáveis são seus coeficientes e ajuda a construir intervalos de confiança.
Vamos a um exemplo concreto usando um conjunto de testes de materiais. Engenheiros muitas vezes precisam prever várias propriedades do concreto — como resistência à compressão e trabalhabilidade — com base em componentes da mistura como teor de cimento, relação água e tipo de agregado. Isso é perfeito para regressão multivariada, já que os desfechos são relacionados, mas distintos.
A análise começa explorando correlações entre componentes da mistura e desfechos, checando multicolinearidade entre preditores e examinando se as relações parecem lineares. Após o pré-processamento (escalonando as proporções da mistura e tratando medições ausentes), você ajustaria o modelo multivariado e o validaria com validação cruzada para garantir que as previsões se sustentam em novas misturas de concreto.
Aqui vai um fluxo básico que demonstra as etapas principais em Python. Primeiro, vamos configurar os dados e fazer o pré-processamento:
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
from sklearn.metrics import mean_squared_error

# Load and prepare data (assuming concrete dataset)
# X: mixture components (cement, water, aggregate, etc.)
# y: multiple outcomes (strength, workability, durability)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Esse passo padroniza todos os preditores para média zero e variância unitária, o que ajuda na estabilidade numérica e na interpretação.
Em seguida, vamos ajustar o modelo multivariado e examinar os resultados:
# Fit multivariate regression
mlr_model = LinearRegression()
mlr_model.fit(X_scaled, y)

# Get coefficients for each outcome
for i, outcome in enumerate(['strength', 'workability', 'durability']):
   coeffs = mlr_model.coef_[:, i]
   print(f"{outcome} coefficients: {coeffs}”)
O modelo LinearRegression ajusta uma única regressão multivariada que considera as correlações entre todos os desfechos simultaneamente. Os coeficientes mostram como cada componente da mistura afeta cada propriedade do concreto.
Por fim, vamos validar o modelo para checar sua confiabilidade:
# Cross-validation for each outcome
cv_scores = cross_val_score(mlr_model, X_scaled, y,
                           cv=5, scoring='neg_mean_squared_error')
print(f"Average CV score: {-cv_scores.mean():.3f}")

# Make predictions on new data
y_pred = mlr_model.predict(X_scaled)
mse_per_outcome = [mean_squared_error(y[:, i], y_pred[:, i])
                   for i in range(y.shape[1])]
print(f"MSE per outcome: {mse_per_outcome}")
A validação cruzada dá uma estimativa honesta de quão bem o modelo performa em dados não vistos. Os MSE por desfecho ajudam a entender quais propriedades do concreto são mais fáceis ou mais difíceis de prever com precisão.
A regressão linear multivariada funciona bem em muitos problemas, mas tem limites claros. A maior limitação está no nome — ela assume relações lineares entre preditores e desfechos. Quando as relações são curvas, cheias de interações ou não lineares, a MLR gera vieses. Alta dimensionalidade cria outro problema: com muitos preditores em relação às observações, o modelo fica instável e propenso a overfitting.
Várias alternativas podem lidar melhor com essas limitações. Modelos lineares generalizados (GLMs) estendem o framework para desfechos não normais e permitem funções de ligação diferentes. ANCOVA funciona bem quando você tem preditores contínuos e categóricos com efeitos de interação. Para overfitting, métodos de regularização como ridge e LASSO ajudam, ou você pode tentar métodos de ensemble como random forests, que lidam com não linearidade e alta dimensão de forma mais natural.
A regressão linear multivariada oferece uma forma sólida de modelar múltiplos desfechos relacionados simultaneamente, capturando relações que modelos univariados separados deixariam passar. Seus principais pontos fortes estão na interpretabilidade, na capacidade de testes estatísticos e na eficiência para lidar com desfechos correlacionados.
Escolher entre a MLR padrão e outras abordagens como regressão regularizada, partial least squares e métodos de ensemble depende das características dos seus dados, do tamanho da amostra e de se predição ou interpretação pesa mais no seu problema.
Se quiser desenvolver ainda mais suas habilidades, nosso curso Intermediate Regression with statsmodels in Python cobre múltiplas variáveis explicativas e efeitos de interação, enquanto Generalized Linear Models in R amplia sua caixa de ferramentas para lidar com distribuições não normais como a binomial e a Poisson para dados de contagem.
Aprenda com a DataCamp
Curso
Curso
Curso
Tutorial
Zoumana Keita
12 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Avinash Navlani
10 min
Tutorial
DataCamp Team
10 min
Tutorial
Vidhi Chugh
14 min
Tutorial
DataCamp Team
2 min





