Kurs
Multivariate Wahrscheinlichkeitsverteilungen in R
4 Std.
8.9K
Manchmal musst du mehrere Dinge gleichzeitig vorhersagen, zum Beispiel Absatz und Kundenabwanderung auf Basis derselben Daten.
In diesem Artikel zeige ich dir, wie du genau das meisterst: mit multivariater linearer Regression. Du erfährst, was sie ist, wie sie funktioniert, wann sie sinnvoll ist und wie du sie praktisch anwendest. Am Ende bist du bereit, sie auf reale Herausforderungen anzuwenden.
Wenn du neu beim Thema Regression bist, lohnt sich vorab ein Blick in unsere Introduction to Regression in R oder in die Introduction to Regression with statsmodels in Python.
Die multivariate lineare Regression ist ein statistisches Verfahren, das den Zusammenhang zwischen mehreren unabhängigen Variablen und mehreren abhängigen Variablen modelliert. Sie wird manchmal mit der multiplen linearen Regression verwechselt, weil sie ähnlich klingt — das ist mir auch schon passiert. Bei der multiplen linearen Regression schätzt du jedoch mit mehreren Prädiktoren ein einziges Ergebnis, während die multivariate lineare Regression für Situationen gedacht ist, in denen du mehrere Zielgrößen gleichzeitig vorhersagen willst.
Ich habe dir gerade skizziert, was multivariate Regression ist und wann du sie einsetzen solltest. Jetzt schauen wir uns an, wie das Modell aufgebaut ist und auf welchen Annahmen es basiert.
Die multivariate Regression nutzt eine matrixbasierte Darstellung, um mehrere Zielgrößen gleichzeitig zu modellieren:
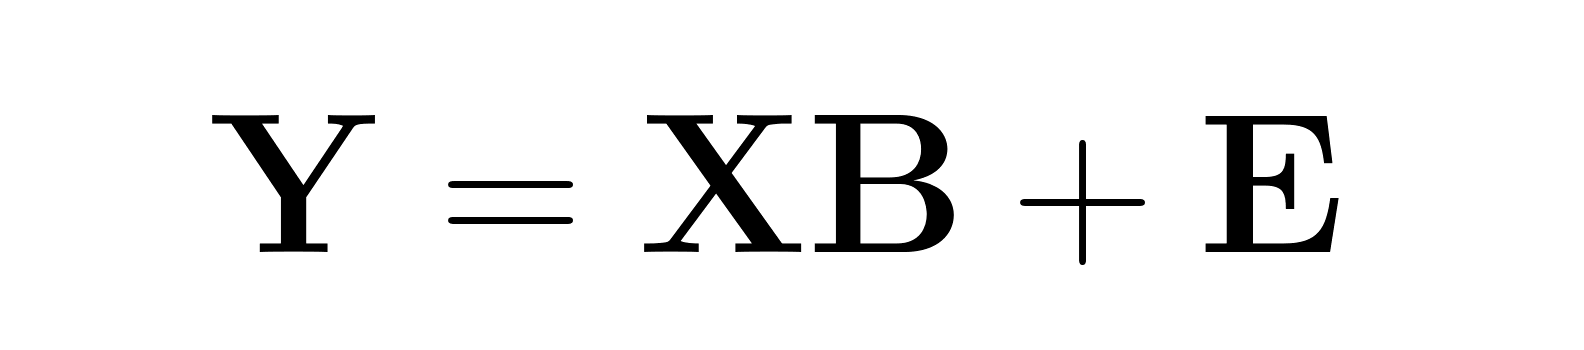
Dabei gilt:
Dieser Ansatz berücksichtigt, dass Fehlerterme verschiedener Zielvariablen korreliert sein können, und ermöglicht dadurch effizientere Parameterschätzungen als getrennte univariate Modelle.
Bevor du das Modell verwendest, ist es wichtig, die notwendigen Annahmen zu verstehen — und was zu tun ist, wenn sie verletzt werden.
Wenn diese Annahmen nicht halten, musst du anpassen. Transformiere Variablen bei Nichtlinearität oder Normalitätsproblemen, nutze Weighted Least Squares gegen Heteroskedastizität oder setze Ridge-Regression bei Kollinearitätsproblemen ein.
Bei kategorialen Variablen musst du zunächst Dummy-Variablen erzeugen.
Für eine kategoriale Variable mit k Ausprägungen erstellst du k-1 Dummies. So vermeidest du Redundanz (Stichwort Dummy-Variable-Trap). Die ausgelassene Kategorie wird zur Referenz. Deine Koeffizienten geben dann die Abweichung relativ zu dieser Basis an — wähle also eine Referenz, die die Interpretation erleichtert.
Mit Struktur und Annahmen im Rücken schauen wir nun, wie Koeffizienten geschätzt werden und wie sich die Methoden hinsichtlich Effizienz und Genauigkeit unterscheiden.
OLS ist der Standardstartpunkt und lässt sich natürlich auf multivariate Settings erweitern. Es liefert unverzerrte Schätzungen der Koeffizienten, solange die Annahmen erfüllt sind. Auch wenn die Einzelschätzungen denen getrennter Regressionen entsprechen, liegt der Vorteil hier darin, dass Residuen gemeinsam betrachtet werden und du gemeinsame Hypothesen über mehrere Zielgrößen testen kannst.
Wenn Zielgrößen korreliert sind, bildet die multivariate OLS diese Beziehungen ab und verbessert oft (aber nicht immer) die Gesamtgüte der Vorhersagen.
Warum ist OLS so verbreitet? Das Gauss-Markov-Theorem liefert die Antwort: Unter bestimmten Annahmen ist OLS der Best Linear Unbiased Estimator (BLUE). Das heißt, es liefert unter den üblichen Bedingungen — keine Multikollinearität, lineare Zusammenhänge, konstante Varianz — die geringste Varianz aller unverzerrten linearen Schätzer.
Was, wenn diese Bedingungen nicht gelten, insbesondere die konstante Varianz? Dann kommt WLS ins Spiel. Beobachtungen mit geringerer Fehlervarianz erhalten mehr Gewicht, rauschigere weniger.
WLS modifiziert OLS mittels einer Gewichtungsmatrix. Die Gewichte kannst du beispielsweise aus Residuen eines OLS-Modells schätzen oder aus theoretischem Wissen über die Fehlerstruktur deiner Daten ableiten.
Bei hochdimensionalen Daten oder Multikollinearität helfen Shrinkage-Methoden. Sie erlauben etwas Bias zugunsten geringerer Varianz und verbessern damit häufig die Vorhersage.
Ridge-Regression fügt eine L2-Strafe (λ||B||²) hinzu und schrumpft alle Koeffizienten Richtung Null — nützlich, wenn jeder Prädiktor etwas beitragen könnte. LASSO wendet eine L1-Strafe an, die manche Koeffizienten vollständig auf Null setzt — praktisch zur Variablenselektion. Elastic Net kombiniert beides, was bei korrelierten Prädiktoren hilft und dennoch Selektion ermöglicht.
Nachdem wir die Schätzung betrachtet haben, geht es nun darum, wie gut dein Modell performt und wie du belastbare Schlüsse daraus ziehst.
Das multivariate R-Quadrat zeigt dir, wie viel der Gesamtvarianz dein Modell über alle Zielgrößen hinweg erklärt. Anders als in der univariaten Variante wird hier oft die Determinante der Residualkovarianzmatrix verwendet; der Wert muss daher nicht zwingend zwischen 0 und 1 liegen.
Adjustiertes R-Quadrat ist im multivariaten Kontext besonders wichtig, da die Anzahl der Parameter mit mehreren Zielgrößen schnell wächst. Es bestraft Komplexität und beugt Overfitting vor.
Visuelle Tools wie Konfidenzellipsen können ebenfalls helfen. Diese Ellipsen zeigen die Unsicherheit in den Vorhersagen und wie die Zielvariablen zusammenhängen. Kreisförmige Ellipsen deuten auf Unabhängigkeit hin; langgezogene auf starke Korrelationen.
Wenn du wissen willst, ob dein Modell mehr leistet, als nur Rauschen zu fitten, sind Hypothesentests entscheidend.
Wilks’ Lambda prüft, ob bestimmte Prädiktoren über die Menge der Zielgrößen hinweg signifikante Effekte haben. Es vergleicht die Fehlerkovarianzmatrizen des Vollmodells und eines reduzierten Modells, um festzustellen, ob das Entfernen bestimmter Prädiktoren die unerklärte Varianz signifikant erhöht.
Hotellings T² funktioniert wie ein multivariater t-Test. Er bewertet, ob ein bestimmter Prädiktor mindestens eine Zielgröße beeinflusst und berücksichtigt dabei Korrelationen zwischen den Outcomes.
Gemeinsame Tests helfen, das Risiko von Fehlalarmen zu reduzieren, wenn du mehrere Hypothesen gleichzeitig prüfst. Das ist in der multivariaten Regression besonders hilfreich, wo Mehrfachvergleiche schnell ausufern können.
Zur Auswahl zwischen Modellen eignen sich Kriterien wie AIC und BIC . Beide berücksichtigen Komplexität — im Multivariaten besonders wichtig. AIC fokussiert stärker auf Vorhersagegüte, BIC bevorzugt tendenziell einfachere Modelle.
Für verschachtelte Modelle kannst du auch Likelihood-Ratio-Tests einsetzen. Sie prüfen, ob zusätzliche Prädiktoren den Fit signifikant verbessern.
Die Standardvariante der multivariaten Regression funktioniert für viele Fragestellungen gut, doch manchmal brauchst du spezialisierte Ansätze. Vielleicht hast du Hunderte Prädiktoren oder Variablen beeinflussen sich gegenseitig und verletzen Standardannahmen. So gehst du mit (einigen) dieser kniffligen Situationen um.
Mit vielen Prädiktoren wird Feature Selection essenziell — für Performance und Interpretierbarkeit. LASSO (Least Absolute Shrinkage and Selection Operator) sticht hier heraus, weil es irrelevante Prädiktoren beim Fitten automatisch auf Null setzen kann.
Im Gegensatz zur Ridge-Regression, die alle Koeffizienten Richtung Null schrumpft, aber beibehält, erzeugt LASSO durch die L1-Strafe dünnbesetzte (sparsame) Lösungen. Das ist ideal, wenn du vermutest, dass nur ein Teil deiner Prädiktoren wirklich zählt.
Manchmal beeinflussen deine Prädiktoren die Zielgrößen und werden zugleich von ihnen beeinflusst. Etwa wenn Bildung das Einkommen beeinflusst, Einkommen aber auch den Zugang zu Bildung. Das führt zu Endogenität und macht Standardregressionsschätzungen unzuverlässig.
Instrumentvariablen lösen das über zwei Stufen. Zuerst findest du ein "Instrument", also eine Variable, die den problematischen Prädiktor beeinflusst, aber nicht direkt die Zielgröße. Dann nutzt du dieses Instrument, um den „sauberen“ Teil des Prädiktors zu prognostizieren, und verwendest diese Vorhersage in der finalen Regression. So durchbrichst du den Kreis und erhältst verlässlichere Schätzungen.
Die meisten Statistikpakete unterstützen multivariate Regression, wenn auch mit unterschiedlichen Stärken. In Python unterstützt sklearn.linear_model. mehrere Zielgrößen nativ und damit echte multivariate Regression. Aus meiner Sicht liefert statsmodels ausführlichere statistische Outputs inklusive Hypothesentests. Wenn du zu den Programmiererinnen und Programmierern gehörst, die R bevorzugen, genügt für einfache multivariate Modelle die eingebaute lm()-Funktion; für fortgeschrittene Diagnostik hilft das car-Package.
Partial Least Squares (PLS) ist hilfreich, wenn du mehr Prädiktoren als Beobachtungen hast oder Multikollinearität Probleme bereitet. Anstatt alle Prädiktoren direkt zu nutzen, bildet PLS latente Variablen, die die relevanteste Information für die Vorhersage deiner Zielgrößen erfassen. Besonders bewährt in Bereichen wie Chemometrie und Bioinformatik, wo Hunderte oder Tausende Prädiktoren wenigen Beobachtungen gegenüberstehen.
PLS findet Richtungen im Prädiktorraum, die sowohl Prädiktorvarianz als auch Zielgrößen-Kovarianz erklären. Das ist besonders nützlich, wenn Vorhersagegenauigkeit wichtiger ist als Interpretation. Standard-MLR kann bei vielen korrelierten Prädiktoren instabil werden, während PLS auch in schwierigen Settings robust bleibt.
Einfache Konfidenzintervalle greifen für multivariate Vorhersagen zu kurz, weil sie Korrelationen zwischen Zielgrößen ignorieren. Konfidenzellipsen zeigen die gemeinsame Unsicherheit für Paare von Outcomes und machen sichtbar, wie Vorhersagefehler über Zielgrößen hinweg korrelieren. Kreisförmige Ellipsen bedeuten unabhängige Vorhersagen, langgezogene weisen auf starke Korrelationen hin.
Die Ausrichtung langgestreckter Ellipsen zeigt, für welche linearen Kombinationen von Zielgrößen die Unsicherheit am größten bzw. kleinsten ist. Du kannst sie für Einzelvorhersagen oder für Parameterschätzungen plotten. Sie sind auch in Präsentationen wertvoll, weil sie die Sicherheit deiner Vorhersagen intuitiv visualisieren.
Vom Konzept zur Praxis heißt: mit unordentlichen Daten umgehen und sicherstellen, dass dein Modell wirklich funktioniert. So managst du den praktischen Teil der multivariaten Regression.
Bevor du ein multivariates Modell fitest, musst du deine Daten in Form bringen. Skalierung und Zentrierung sind besonders wichtig, wenn Prädiktoren unterschiedliche Einheiten haben. Stell dir vor, du vergleichst Einkommen (in Tausend) mit Alter (in Jahren) ohne Standardisierung. Die meisten Algorithmen arbeiten besser, wenn Features auf ähnlichen Skalen liegen.
Fehlende Werte sind eine weitere Herausforderung. Zeilen zu verwerfen verschenkt Information und kann Bias einführen. Besser sind Mittelwertimputation für numerische Variablen oder anspruchsvollere Verfahren wie Multiple Imputation, bei der mehrere plausible Datensätze erzeugt und Ergebnisse kombiniert werden.
Cross-Validation hilft dir zu verstehen, wie gut dein Modell über die Trainingsdaten hinaus generalisiert. Bei multivariater Regression teilst du die Daten in k Folds, trainierst auf k-1 Folds und testest auf dem verbleibenden Fold. Das wiederholst du k-mal und mittlest die Ergebnisse, um eine robuste Leistungsabschätzung zu erhalten.
Bootstrapping ist eine weitere Validierungsmethode und besonders nützlich, um Parameterunsicherheit zu verstehen. Es erstellt neue Datensätze durch Ziehen mit Zurücklegen aus den Originaldaten, fitet auf jedem Bootstrap-Sample Modelle und betrachtet die Verteilung der Schätzungen. So siehst du, wie stabil deine Koeffizienten sind und kannst Konfidenzintervalle ableiten.
Schauen wir uns ein konkretes Beispiel mit einem Materialtest-Datensatz an. Ingenieurteams müssen oft mehrere Eigenschaften von Beton — etwa Druckfestigkeit und Verarbeitbarkeit — anhand der Mischungskomponenten wie Zementgehalt, Wasseranteil und Zuschlagsart vorhersagen. Das ist ein idealer Einsatz für multivariate Regression, da die Outcomes verwandt, aber unterschiedlich sind.
Die Analyse startet mit der Untersuchung der Korrelationen zwischen Mischungskomponenten und Zielgrößen, prüft Multikollinearität unter den Prädiktoren und ob die Beziehungen annähernd linear sind. Nach dem Preprocessing (Skalierung der Mischungsverhältnisse, Umgang mit fehlenden Messungen) fitest du das multivariate Modell und validierst es per Cross-Validation, um sicherzustellen, dass die Vorhersagen für neue Mischungen tragen.
Hier ist ein Basis-Workflow, der die wesentlichen Schritte in Python zeigt. Zuerst richten wir die Daten ein und kümmern uns ums Preprocessing:
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
from sklearn.metrics import mean_squared_error

# Load and prepare data (assuming concrete dataset)
# X: mixture components (cement, water, aggregate, etc.)
# y: multiple outcomes (strength, workability, durability)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Dieser Schritt standardisiert alle Prädiktoren auf Mittelwert Null und Varianz Eins — das verbessert numerische Stabilität und Interpretation.
Als Nächstes fiten wir das multivariate Modell und schauen uns die Ergebnisse an:
# Fit multivariate regression
mlr_model = LinearRegression()
mlr_model.fit(X_scaled, y)

# Get coefficients for each outcome
for i, outcome in enumerate(['strength', 'workability', 'durability']):
   coeffs = mlr_model.coef_[:, i]
   print(f"{outcome} coefficients: {coeffs}”)
Das LinearRegression-Modell fitet eine einzige multivariate Regression, die Korrelationen zwischen allen Zielgrößen gleichzeitig berücksichtigt. Die Koeffizienten zeigen, wie jede Mischungskomponente jede Betoneigenschaft beeinflusst.
Zum Schluss validieren wir das Modell auf seine Zuverlässigkeit:
# Cross-validation for each outcome
cv_scores = cross_val_score(mlr_model, X_scaled, y,
                           cv=5, scoring='neg_mean_squared_error')
print(f"Average CV score: {-cv_scores.mean():.3f}")

# Make predictions on new data
y_pred = mlr_model.predict(X_scaled)
mse_per_outcome = [mean_squared_error(y[:, i], y_pred[:, i])
                   for i in range(y.shape[1])]
print(f"MSE per outcome: {mse_per_outcome}")
Cross-Validation liefert eine ehrliche Einschätzung, wie gut das Modell bei unbekannten Daten performt. Die MSE-Werte je Zielgröße zeigen dir, welche Betoneigenschaften leichter bzw. schwerer präzise vorherzusagen sind.
Multivariate lineare Regression funktioniert in vielen Fällen gut, hat aber klare Grenzen. Die größte ist schon im Namen enthalten — sie setzt lineare Beziehungen zwischen Prädiktoren und Outcomes voraus. Bei gekrümmten, interaktionsstarken oder sonst nichtlinearen Zusammenhängen liefert MLR verzerrte Ergebnisse. Hohe Dimensionalität ist ein weiteres Problem: Mit vielen Prädiktoren relativ zu den Beobachtungen wird das Modell instabil und anfällig für Overfitting.
Mehrere Alternativen kommen damit besser zurecht. Generalisierte lineare Modelle (GLMs) erweitern den Rahmen auf nicht-normalverteilte Zielgrößen und erlauben unterschiedliche Linkfunktionen. ANCOVA ist sinnvoll, wenn kontinuierliche und kategoriale Prädiktoren mit Interaktionseffekten zusammenkommen. Gegen Overfitting helfen Regularisierungsmethoden wie Ridge und LASSO oder Ensemble-Methoden wie Random Forests, die Nichtlinearität und hohe Dimensionalität natürlicher handhaben.
Die multivariate lineare Regression bietet dir einen soliden Weg, mehrere zusammenhängende Zielgrößen gleichzeitig zu modellieren und Beziehungen einzufangen, die separate univariate Modelle übersehen würden. Ihre Stärken liegen in der Interpretierbarkeit, in statistischen Testmöglichkeiten und in der effizienten Handhabung korrelierter Outcomes.
Ob du bei klassischer MLR bleibst oder zu anderen Ansätzen wie regularisierter Regression, Partial Least Squares oder Ensemble-Methoden wechselst, hängt von deinen Daten, der Stichprobengröße und dem Ziel ab — ob Vorhersageleistung oder Interpretation wichtiger ist.
Wenn du deine Kompetenzen weiter ausbauen willst, deckt unser Kurs Intermediate Regression with statsmodels in Python mehrere erklärende Variablen und Interaktionseffekte ab, während Generalized Linear Models in R dein Toolkit für nicht-normale Verteilungen wie die Binomialverteilung und die Poisson-Verteilung bei Zähldaten erweitert.
Mit DataCamp lernen
Kurs
Kurs
Kurs
Tutorial
Mark Pedigo
10 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Aditya Sharma
7 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
DataCamp Team
3 Min.