Las redes neuronales convolucionales (CNN) son una piedra angular de la visión por ordenador moderna, ya que permiten aplicaciones como el reconocimiento de imágenes, la detección facial y los coches autoconducidos. Estas redes están diseñadas para extraer automáticamente patrones y características de las imágenes, lo que las hace más potentes que las técnicas tradicionales de aprendizaje automático para tareas visuales.
En este tutorial, implementaremos una CNN utilizando PyTorch, un marco de aprendizaje profundo que es a la vez fácil de usar y muy eficiente para aplicaciones de investigación y producción.
Requisitos previos: Aprendizaje profundo y PyTorch
Antes de entrar en los detalles de las CNN, debes estar familiarizado con el campo del aprendizaje profundo y con las bibliotecas de Python que utilizaremos durante la configuración de nuestro entorno.
El aprendizaje profundo es un subconjunto del aprendizaje automático, en el que la estructura fundamental del modelo es una red de entradas, capas ocultas y salidas. Una red de este tipo puede tener una o muchas capas ocultas. La intuición original del aprendizaje profundo era crear modelos inspirados en cómo aprende el cerebro humano: a través de células interconectadas llamadas neuronas. Por eso seguimos llamando redes "neuronales" a los modelos de aprendizaje profundo. Estas estructuras de modelos en capas requieren muchos más datos para aprender que otros modelos de aprendizaje supervisado para derivar patrones de los datos no estructurados. Normalmente hablamos de al menos cientos de miles de puntos de datos.
Aunque existen varios marcos y paquetes para implementar algoritmos de aprendizaje profundo, nos centraremos en PyTorch, uno de los marcos más populares y mejor mantenidos. Además de ser utilizado por ingenieros de aprendizaje profundo en la industria, PyTorch es una herramienta favorita entre los investigadores. Muchos artículos sobre aprendizaje profundo se publican utilizando PyTorch. Está diseñado para ser intuitivo y fácil de usar, y comparte muchos puntos en común con la biblioteca NumPy de Python.
Si necesitas una introducción a estos conceptos, considera la posibilidad de inscribirte en el curso Aprendizaje profundo con PyTorch hoy mismo.
¿Qué es una Red Neuronal Convolucional (CNN)?
Las redes neuronales convolucionales, comúnmente llamadas CNN o ConvNet, son un tipo específico de red neuronal profunda muy adecuada para tareas de visión por ordenador. La invención de las CNN se remonta a la década de 1980. Sin embargo, no se generalizaron hasta la década de 2010, tras los avances informáticos que supuso la implementación de las unidades de procesamiento gráfico (GPU). De hecho, la rápida popularización de las CNN ayudó a que el campo de las redes neuronales recuperara protagonismo, dando lugar a la llamada "tercera ola de redes neuronales" que aún vivimos hoy.
Las CNN se inspiran específicamente en la corteza visual biológica. El córtex tiene pequeñas regiones de células sensibles a zonas concretas del campo visual. Esta idea fue ampliada por un cautivador experimento de Hubel y Wiesel en 1962.
Las CNN intentan reproducir esta característica creando redes neuronales complejas formadas por diferentes capas específicas para cada tarea. Las CNN se denominan "feed-forward" porque la información fluye a través del modelo. No hay conexiones de retroalimentación en las que las salidas del modelo se retroalimenten a sí mismas, en comparación con otros modelos que utilizan técnicas como la retropropagación.
En concreto, una CNN suele constar de las siguientes capas:
Capa convolucional
Este es el primer bloque de construcción de una CNN. Como su nombre indica, la principal tarea matemática que se realiza se llama convolución, que es la aplicación de una función de ventana deslizante a una matriz de píxeles que representa una imagen. La función deslizante aplicada a la matriz se denomina núcleo o filtro. En la capa de convolución, se aplican varios filtros de igual tamaño, y cada filtro se utiliza para reconocer un patrón específico de la imagen, como la curvatura de los dígitos, los bordes, la forma completa de los dígitos, etc.
Función de activación
Normalmente, se aplica una función de activación ReLU después de cada operación de convolución. Esta función ayuda a la red a aprender relaciones no lineales entre las características de la imagen, haciendo que la red sea más robusta para identificar distintos patrones. También ayuda a mitigar los problemas de gradiente evanescente.
Capa de agrupamiento
El objetivo de la capa de agrupación es extraer los rasgos más significativos de la matriz convoluta. Esto se hace aplicando algunas operaciones de agregación, que reducen la dimensión del mapa de características (matriz convoluta), reduciendo así la memoria utilizada durante el entrenamiento de la red. La agrupación también es relevante para mitigar el sobreajuste.
Capas totalmente conectadas
Estas capas están en la última capa de la red neuronal convolucional, y sus entradas corresponden a la matriz unidimensional aplanada generada por la última capa de agrupamiento. Se les aplican funciones de activación ReLU para la no linealidad.
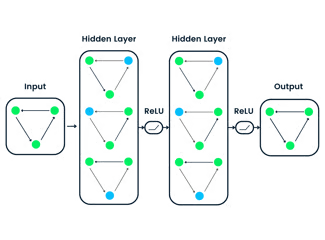
Arquitectura de redes neuronales convolucionales. Fuente: DataCamp
¿Por qué utilizar CNNs para la clasificación de imágenes?
Las redes neuronales convolucionales han sido una de las innovaciones más influyentes en el campo de la visión por ordenador. Han funcionado mucho mejor que los modelos tradicionales de aprendizaje automático, como las SVM y los árboles de decisión, y han producido resultados de vanguardia.
Además, las capas convolucionales confieren a las CNN sus características de invariabilidad de traslación, lo que les permite identificar y extraer patrones y características de los datos independientemente de las variaciones de posición, orientación, escala o traslación.
Las CNN han demostrado su eficacia en muchos estudios de casos y aplicaciones de la vida real, como:
Clasificación de imágenes, detección de objetos, segmentación, reconocimiento facial;
Coches autoconducidos que aprovechan los sistemas de visión basados en CNN;
Clasificación de la estructura cristalina mediante una red neuronal convolucional;
Sistemas de cámaras de seguridad.
Más allá de las tareas de clasificación de imágenes, las CNN son versátiles y pueden aplicarse a otros muchos dominios, como el procesamiento del lenguaje natural, el análisis de series temporales y el reconocimiento del habla.
Implementar una CNN con PyTorch
Ahora que ya conoces la teoría de las CNN, estamos listos para ensuciarnos las manos. En esta sección, construiremos y entrenaremos una CNN sencilla con PyTorch. Nuestro objetivo es construir un modelo para clasificar dígitos en imágenes. Para entrenar y probar nuestro modelo, utilizaremos el famoso conjunto de datos MNIST, una colección de 70.000 imágenes en escala de grises de 28x28 con dígitos escritos a mano.
1. Importar las bibliotecas necesarias
A continuación encontrarás las bibliotecas que utilizaremos para este tutorial. En esencia, aprovecharemos PyTorch para construir nuestra CNN, y el módulo de visión por ordenador de PyTorch torchvision, para descargar y cargar el conjunto de datos MNIST. Por último, también utilizaremos torchmetrics para evaluar el rendimiento de nuestro modelo.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import torch
from torch import optim
from torch import nn
from torch.utils.data import DataLoader
from tqdm import tqdm
# !pip install torchvisionimport torchvision
import torch.nn.functional as F
import torchvision.datasets as datasets
import torchvision.transforms as transforms
# !pip install torchmetricsimport torchmetricsCon la tecnología de
2. Carga y preprocesamiento del conjunto de datos
PyTorch también viene con un rico ecosistema de herramientas y extensiones, incluyendo torchvision, un módulo para visión por ordenador. Torchvision incluye varios conjuntos de datos de imágenes que pueden utilizarse para entrenar y probar redes neuronales. En nuestro tutorial, utilizaremos el conjunto de datos MNIST.
En primer lugar, descargaremos y convertiremos el conjunto de datos MNIST en un tensor, la estructura de datos central de PyTorch, similar a las matrices de NumPy pero con capacidades de aceleración de la GPU.
Luego, también utilizaremos DataLoader para gestionar el procesamiento por lotes y mezclar los conjuntos de datos de entrenamiento y de prueba. Se puede crear un PyTorch DataLoader a partir de un Conjunto de Datos para cargar datos, dividirlos en lotes y realizar transformaciones en los datos si se desea. A continuación, obtiene una muestra de datos lista para el entrenamiento. En el código siguiente, cargamos los datos y los guardamos en DataLoaders con un tamaño de lote de 60 imágenes:
Opcionalmente, el conjunto de datos de entrenamiento podría dividirse a su vez en dos particiones de entrenamiento y validación. La validación es una técnica utilizada en el aprendizaje profundo para evaluar el rendimiento del modelo durante el entrenamiento. Ayuda a detectar posibles sobreajustes e infraajustes de nuestros modelos, y es especialmente útil para optimizar los hiperparámetros. Sin embargo, en aras de la simplicidad, no utilizaremos la validación en este tutorial. Si quieres saber más sobre la validación, puedes consultar una explicación completa en nuestro Curso de Introducción al Aprendizaje Profundo con PyTorch.
Ahora que tenemos nuestros datos, veamos qué aspecto tiene un lote aleatorio de dígitos:
defimshow(img):
npimg = img.numpy()
plt.imshow(np.transpose(npimg,(1,2,0)))
plt.show()# get some random training images
dataiter =iter(dataloader_train)
images, labels =next(dataiter)
labels
# show images
imshow(torchvision.utils.make_grid(images))Con la tecnología de
3. Definir la arquitectura de la CNN
Para resolver el problema de clasificación, aprovecharemos la clase nn.Module, el bloque de construcción de PyTorch para crear intuitivamente sofisticadas arquitecturas de redes neuronales.
En el código siguiente, creamos una clase llamada CNN, que hereda las propiedades de la clase nn.Module. La clase CNN será el modelo de una CNN con dos capas convolucionales, seguidas de una capa totalmente conectada.
En PyTorch, utilizamos nn.Conv2d para definir una capa convolucional. Le pasamos el número de mapas de características de entrada y de salida. También ajustamos algunos parámetros para que funcione la capa convolucional, como el tamaño del núcleo o filtro y el relleno.
A continuación, añadimos una capa de agrupación máxima con nn.MaxPool2d. En ella, deslizamos una ventana no solapada sobre la salida de la capa convolucional anterior. En cada posición, seleccionamos el valor máximo de la ventana para pasarlo hacia delante. Esta operación reduce las dimensiones espaciales de los mapas de características, reduciendo el número de parámetros y la complejidad computacional de la red. Por último, añadimos una capa lineal totalmente conectada.
La función forward() define cómo se conectan las distintas capas, añadiendo varias funciones de activación ReLU después de cada capa convolucional.
classCNN(nn.Module):def__init__(self, in_channels, num_classes):"""
Building blocks of convolutional neural network.
Parameters:
* in_channels: Number of channels in the input image (for grayscale images, 1)
* num_classes: Number of classes to predict. In our problem, 10 (i.e digits from 0 to 9).
"""super(CNN, self).__init__()# 1st convolutional layer
self.conv1 = nn.Conv2d(in_channels=in_channels, out_channels=8, kernel_size=3, padding=1)# Max pooling layer
self.pool = nn.MaxPool2d(kernel_size=2, stride=2)# 2nd convolutional layer
self.conv2 = nn.Conv2d(in_channels=8, out_channels=16, kernel_size=3, padding=1)# Fully connected layer
self.fc1 = nn.Linear(16*7*7, num_classes)defforward(self, x):"""
Define the forward pass of the neural network.
Parameters:
x: Input tensor.
Returns:
torch.Tensor
The output tensor after passing through the network.
"""
x = F.relu(self.conv1(x))# Apply first convolution and ReLU activation
x = self.pool(x)# Apply max pooling
x = F.relu(self.conv2(x))# Apply second convolution and ReLU activation
x = self.pool(x)# Apply max pooling
x = x.reshape(x.shape[0],-1)# Flatten the tensor
x = self.fc1(x)# Apply fully connected layerreturn x
x = x.reshape(x.shape[0],-1)# Flatten the tensor
x = self.fc1(x)# Apply fully connected layerreturn xCon la tecnología de
Una vez definida la clase CNN, podemos crear nuestro modelo y trasladarlo al dispositivo donde será entrenado y ejecutado.
Las redes neuronales, incluidas las CNN, muestran un mejor rendimiento cuando se ejecutan en GPU, pero puede que ese sea el caso de tu ordenador. Por lo tanto, ejecutaremos el modelo en una GPU sólo cuando esté disponible; de lo contrario, utilizaremos una CPU normal.
device ="cuda"if torch.cuda.is_available()else"cpu"
model = CNN(in_channels=1, num_classes=10).to(device)print(model)>>> CNN((conv1): Conv2d(1,8, kernel_size=(3,3), stride=(1,1), padding=(1,1))(pool): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)(conv2): Conv2d(8,16, kernel_size=(3,3), stride=(1,1), padding=(1,1))(fc1): Linear(in_features=784, out_features=10, bias=True))Con la tecnología de
4. Entrenamiento del modelo CNN
Ahora que tenemos nuestro modelo, es hora de entrenarlo. Para ello, primero tendremos que determinar cómo mediremos el rendimiento del modelo. Como se trata de un problema de clasificación multiclase, utilizaremos la función de pérdida de entropía cruzada, disponible en PyTorch como nn.CrossEntropyLoss. También utilizaremos el optimizador Adam, uno de los algoritmos de optimización más populares.
# Define the loss function
criterion = nn.CrossEntropyLoss()# Define the optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001)Con la tecnología de
Iteraremos sobre diez épocas y lotes de entrenamiento para entrenar el modelo y realizaremos la secuencia habitual de pasos para cada lote, como se muestra a continuación.
num_epochs=10for epoch inrange(num_epochs):# Iterate over training batchesprint(f"Epoch [{epoch +1}/{num_epochs}]")for batch_index,(data, targets)inenumerate(tqdm(dataloader_train)):
data = data.to(device)
targets = targets.to(device)
scores = model(data)
loss = criterion(scores, targets)
optimizer.zero_grad()
loss.backward()
optimizer.step()Con la tecnología de
Una vez entrenado el modelo, podemos evaluar su rendimiento en el conjunto de datos de prueba. Utilizaremos la precisión, una métrica popular para los problemas de clasificación. La precisión mide la proporción de casos clasificados correctamente del número total de objetos del conjunto de datos. Se calcula dividiendo el número de predicciones correctas por el número total de predicciones realizadas por el modelo.
En primer lugar, configuramos la métrica de precisión de torchmetrics. A continuación, utilizamos el método .eval del modelo para ponerlo en modo evaluación, porque algunas capas de los modelos PyTorch se comportan de forma diferente en las etapas de entrenamiento y de prueba. También añadimos un contexto Python con torch.no_grad, indicando que no vamos a realizar el cálculo del gradiente.
A continuación, iteramos sobre ejemplos de prueba sin cálculo de gradiente. Para cada lote de pruebas, obtenemos los resultados del modelo, tomamos la clase más probable y la pasamos a la función de precisión junto con las etiquetas. Por último, calculamos las métricas e imprimimos los resultados. Obtuvimos una puntuación de precisión de 0,98, lo que significa que nuestro modelo clasificó correctamente el 98% de los dígitos. No está mal.
# Set up of multiclass accuracy metric
acc = Accuracy(task="multiclass",num_classes=10)# Iterate over the dataset batches
model.eval()with torch.no_grad():for images, labels in dataloader_test:# Get predicted probabilities for test data batch
outputs = model(images)
_, preds = torch.max(outputs,1)
acc(preds, labels)
precision(preds, labels)
recall(preds, labels)#Compute total test accuracy
test_accuracy = acc.compute()print(f"Test accuracy: {test_accuracy}")>>> Test accuracy:0.9857000112533569Con la tecnología de
También puedes utilizar otras métricas de clasificación populares, como el recuerdo y la precisión. Te contamos todo sobre estas métricas con ejemplos prácticos en nuestro Curso Intermedio de Aprendizaje Profundo con PyTorch.
Mejorar el rendimiento del modelo
Aunque nuestro modelo CNN consigue un gran rendimiento, hay varias estrategias que podemos utilizar para mejorar aún más su precisión, robustez y generalización a nuevos datos.
En esta sección, exploraremos técnicas clave como el aumento de datos, el ajuste de hiperparámetros y el aprendizaje por transferencia para optimizar el rendimiento de nuestro modelo.
Técnicas de aumento de datos
El aumento de datos es una técnica utilizada para mejorar la precisión de nuestro modelo creando aleatoriamente nuevos datos de entrenamiento. Por ejemplo, durante la carga, se pueden aplicar transformaciones a las imágenes de entrenamiento, como el cambio de tamaño, el volteo horizontal o vertical, la rotación aleatoria, etc. De ese modo, se pueden crear imágenes aumentadas y asignarles la misma etiqueta que a la imagen original, aumentando así el tamaño del conjunto de entrenamiento.
Añadir transformaciones aleatorias a las imágenes originales nos permite generar más datos y, al mismo tiempo, aumentar el tamaño y la diversidad del conjunto de entrenamiento. Hace que el modelo sea más robusto a las variaciones y distorsiones habituales en las imágenes del mundo real, y reduce el sobreajuste, ya que el modelo aprende a ignorar las transformaciones aleatorias.
Sin embargo, es importante tener cuidado con el aumento de datos, ya que a veces puede perjudicar el proceso de entrenamiento. Por ejemplo, en nuestro problema, si aplicamos el volteo vertical al número "6", se parecerá al número "9". Pasarlo al modelo etiquetado como "6" confundirá al modelo y dificultará el entrenamiento. Estos ejemplos demuestran que, a veces, los aumentos específicos pueden influir en la etiqueta.
Ajuste de hiperparámetros
Otra estrategia para mejorar el rendimiento de nuestro modelo consiste en modificar los valores de los hiperparámetros que intervienen en las distintas capas del modelo. Este ajuste de hiperparámetros requiere un profundo conocimiento de las matemáticas que hay detrás de las redes neuronales y del significado de los distintos hiperparámetros.
Por ejemplo, podrías ajustar tus capas CNN cambiando el tamaño de los filtros o aumentando el relleno. También puedes establecer un valor diferente para los pesos iniciales de las neuronas.
Como no conoceremos de antemano los valores óptimos de los hiperparámetros, será necesario cierto grado de ensayo y error. Esto se hace normalmente mediante una técnica conocida como búsqueda en cuadrícula, que te permite evaluar sistemáticamente un modelo a través de una cuadrícula de valores de parámetros.
Sin embargo, ten cuidado al utilizar esta técnica, ya que suele ser costosa desde el punto de vista informático, sobre todo cuando se trata de redes neuronales complejas y grandes conjuntos de datos de entrenamiento.
Igualmente, podrías aumentar la complejidad de tu modelo añadiendo más capas convolucionales y lineales. Sin embargo, ten cuidado al añadir nuevas capas, pues el número de neuronas puede aumentar drásticamente, lo que provocará tiempos de entrenamiento más largos y posibles sobreajustes.
Entrenar modelos de aprendizaje profundo desde cero es un proceso largo y tedioso, y normalmente requiere muchos datos de entrenamiento. En su lugar, a menudo podemos utilizar modelos preentrenados, es decir, modelos que ya han sido entrenados en alguna tarea.
A veces, podemos reutilizar directamente un modelo preentrenado si ya puede resolver la tarea que nos interesa. En otras ocasiones, puede que tengamos que ajustar el modelo preentrenado para que se adapte a la nueva tarea. Esto se conoce como aprendizaje por transferencia.
Utilizar modelos preentrenados en PyTorch es bastante fácil. Torchvision proporciona una colección de modelos preentrenados para diversas tareas relacionadas con las imágenes. Estos modelos están preentrenados en conjuntos de datos de imágenes a gran escala y son fáciles de conseguir. Consulta nuestro Curso de Aprendizaje Profundo para Imágenes con PyTorch para aprender todo lo que necesitas saber sobre ellos.
Despliegue del modelo CNN
Una vez entrenado tu modelo de clasificación de alta precisión en PyTorch, ya puedes guardar el modelo y sus pesos preentrenados para utilizarlos en el futuro y compartirlo con tu equipo, asegurándote de que puedan cargarlo sin problemas.
Para guardar un modelo, podemos utilizar torch.save. Una extensión de archivo común para los modelos de antorcha es pt o pth. Para guardar los pesos del modelo, pasamos model.state_dict a torch.save proporcionando el nombre del archivo de salida, por ejemplo, MulticlassCNN.pth.
Para cargar un modelo guardado, inicializamos un nuevo modelo con la misma arquitectura. A continuación, utilizamos el método de carga de estado dict junto con torch.load para cargar los parámetros en el nuevo modelo.
# Save the model
torch.save(model.state_dict(),'MulticlassCNN.pth')# Create a new model
loaded_model = CNN(in_channels=1, num_classes=10)# Load the saved model
loaded_model.load_state_dict(torch.load('MulticlassCNN.pth'))print(loaded_model)
CNN((conv1): Conv2d(1,8, kernel_size=(3,3), stride=(1,1), padding=(1,1))(pool): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)(conv2): Conv2d(8,16, kernel_size=(3,3), stride=(1,1), padding=(1,1))(fc1): Linear(in_features=784, out_features=10, bias=True))Con la tecnología de
Conclusión
Hemos cubierto una visión completa de las CNN, proporcionando detalles sobre cada capa de la arquitectura CNN. Además, proporcionamos una guía sobre cómo implementar una CNN en PyTorch, que cubre los pasos principales, desde la carga de datos y el diseño del modelo hasta el entrenamiento y la evaluación del modelo. Por último, también analizamos varias estrategias para mejorar el rendimiento de nuestro modelo. Aplicamos todos estos conjuntos de habilidades a un escenario del mundo real relacionado con una tarea de clasificación multiclase.
Hay mucho que aprender sobre el aprendizaje profundo, posiblemente uno de los campos más apasionantes y exigentes de la IA. Afortunadamente, DataCamp está aquí para ayudarte. Consulta nuestros materiales y cursos dedicados y conviértete en un experto en redes neuronales:
Soy analista de datos autónomo y colaboro con empresas y organizaciones de todo el mundo en proyectos de ciencia de datos. También soy instructor de ciencia de datos con más de 2 años de experiencia. Escribo regularmente artículos relacionados con la ciencia de datos en inglés y español, algunos de los cuales se han publicado en sitios web consolidados como DataCamp, Towards Data Science y Analytics Vidhya Como científico de datos con formación en ciencias políticas y derecho, mi objetivo es trabajar en la interacción de las políticas públicas, el derecho y la tecnología, aprovechando el poder de las ideas para promover soluciones y narrativas innovadoras que puedan ayudarnos a abordar retos urgentes, como la crisis climática. Me considero autodidacta, aprendiz constante y firme partidaria de la multidisciplinariedad. Nunca es demasiado tarde para aprender cosas nuevas.
Una guía completa para entender las CNN, su impacto en el análisis de imágenes y algunas estrategias clave para combatir el sobreajuste en aplicaciones robustas de CNN frente al aprendizaje profundo.
Aprenda todo sobre las redes neuronales gráficas, incluyendo qué son las GNN, los diferentes tipos de redes neuronales gráficas y para qué se utilizan. Además, aprenda a crear una red neuronal gráfica con Pytorch.
Conoce las arquitecturas fundamentales del aprendizaje profundo, como las CNN, las RNN, las LSTM y las GRU, para modelar imágenes y datos secuenciales.






Las redes neuronales convolucionales (CNN) son una piedra angular de la visión por ordenador moderna, ya que permiten aplicaciones como el reconocimiento de imágenes, la detección facial y los coches autoconducidos. Estas redes están diseñadas para extraer automáticamente patrones y características de las imágenes, lo que las hace más potentes que las técnicas tradicionales de aprendizaje automático para tareas visuales.
En este tutorial, implementaremos una CNN utilizando PyTorch, un marco de aprendizaje profundo que es a la vez fácil de usar y muy eficiente para aplicaciones de investigación y producción.
Requisitos previos: Aprendizaje profundo y PyTorch
Antes de entrar en los detalles de las CNN, debes estar familiarizado con el campo del aprendizaje profundo y con las bibliotecas de Python que utilizaremos durante la configuración de nuestro entorno.
El aprendizaje profundo es un subconjunto del aprendizaje automático, en el que la estructura fundamental del modelo es una red de entradas, capas ocultas y salidas. Una red de este tipo puede tener una o muchas capas ocultas. La intuición original del aprendizaje profundo era crear modelos inspirados en cómo aprende el cerebro humano: a través de células interconectadas llamadas neuronas. Por eso seguimos llamando redes "neuronales" a los modelos de aprendizaje profundo. Estas estructuras de modelos en capas requieren muchos más datos para aprender que otros modelos de aprendizaje supervisado para derivar patrones de los datos no estructurados. Normalmente hablamos de al menos cientos de miles de puntos de datos.
Aunque existen varios marcos y paquetes para implementar algoritmos de aprendizaje profundo, nos centraremos en PyTorch, uno de los marcos más populares y mejor mantenidos. Además de ser utilizado por ingenieros de aprendizaje profundo en la industria, PyTorch es una herramienta favorita entre los investigadores. Muchos artículos sobre aprendizaje profundo se publican utilizando PyTorch. Está diseñado para ser intuitivo y fácil de usar, y comparte muchos puntos en común con la biblioteca NumPy de Python.
Si necesitas una introducción a estos conceptos, considera la posibilidad de inscribirte en el curso Aprendizaje profundo con PyTorch hoy mismo.
¿Qué es una Red Neuronal Convolucional (CNN)?
Las redes neuronales convolucionales, comúnmente llamadas CNN o ConvNet, son un tipo específico de red neuronal profunda muy adecuada para tareas de visión por ordenador. La invención de las CNN se remonta a la década de 1980. Sin embargo, no se generalizaron hasta la década de 2010, tras los avances informáticos que supuso la implementación de las unidades de procesamiento gráfico (GPU). De hecho, la rápida popularización de las CNN ayudó a que el campo de las redes neuronales recuperara protagonismo, dando lugar a la llamada "tercera ola de redes neuronales" que aún vivimos hoy.
Las CNN se inspiran específicamente en la corteza visual biológica. El córtex tiene pequeñas regiones de células sensibles a zonas concretas del campo visual. Esta idea fue ampliada por un cautivador experimento de Hubel y Wiesel en 1962.
Las CNN intentan reproducir esta característica creando redes neuronales complejas formadas por diferentes capas específicas para cada tarea. Las CNN se denominan "feed-forward" porque la información fluye a través del modelo. No hay conexiones de retroalimentación en las que las salidas del modelo se retroalimenten a sí mismas, en comparación con otros modelos que utilizan técnicas como la retropropagación.
En concreto, una CNN suele constar de las siguientes capas:
Capa convolucional
Este es el primer bloque de construcción de una CNN. Como su nombre indica, la principal tarea matemática que se realiza se llama convolución, que es la aplicación de una función de ventana deslizante a una matriz de píxeles que representa una imagen. La función deslizante aplicada a la matriz se denomina núcleo o filtro. En la capa de convolución, se aplican varios filtros de igual tamaño, y cada filtro se utiliza para reconocer un patrón específico de la imagen, como la curvatura de los dígitos, los bordes, la forma completa de los dígitos, etc.
Función de activación
Normalmente, se aplica una función de activación ReLU después de cada operación de convolución. Esta función ayuda a la red a aprender relaciones no lineales entre las características de la imagen, haciendo que la red sea más robusta para identificar distintos patrones. También ayuda a mitigar los problemas de gradiente evanescente.
Capa de agrupamiento
El objetivo de la capa de agrupación es extraer los rasgos más significativos de la matriz convoluta. Esto se hace aplicando algunas operaciones de agregación, que reducen la dimensión del mapa de características (matriz convoluta), reduciendo así la memoria utilizada durante el entrenamiento de la red. La agrupación también es relevante para mitigar el sobreajuste.
Capas totalmente conectadas
Estas capas están en la última capa de la red neuronal convolucional, y sus entradas corresponden a la matriz unidimensional aplanada generada por la última capa de agrupamiento. Se les aplican funciones de activación ReLU para la no linealidad.
Puedes leer una explicación más detallada de las matemáticas que hay detrás de las CNN en nuestro tutorial, Redes neuronales convolucionales en Python.
¿Por qué utilizar CNNs para la clasificación de imágenes?
Las redes neuronales convolucionales han sido una de las innovaciones más influyentes en el campo de la visión por ordenador. Han funcionado mucho mejor que los modelos tradicionales de aprendizaje automático, como las SVM y los árboles de decisión, y han producido resultados de vanguardia.
Además, las capas convolucionales confieren a las CNN sus características de invariabilidad de traslación, lo que les permite identificar y extraer patrones y características de los datos independientemente de las variaciones de posición, orientación, escala o traslación.
Las CNN han demostrado su eficacia en muchos estudios de casos y aplicaciones de la vida real, como:
Más allá de las tareas de clasificación de imágenes, las CNN son versátiles y pueden aplicarse a otros muchos dominios, como el procesamiento del lenguaje natural, el análisis de series temporales y el reconocimiento del habla.
Implementar una CNN con PyTorch
Ahora que ya conoces la teoría de las CNN, estamos listos para ensuciarnos las manos. En esta sección, construiremos y entrenaremos una CNN sencilla con PyTorch. Nuestro objetivo es construir un modelo para clasificar dígitos en imágenes. Para entrenar y probar nuestro modelo, utilizaremos el famoso conjunto de datos MNIST, una colección de 70.000 imágenes en escala de grises de 28x28 con dígitos escritos a mano.
1. Importar las bibliotecas necesarias
A continuación encontrarás las bibliotecas que utilizaremos para este tutorial. En esencia, aprovecharemos PyTorch para construir nuestra CNN, y el módulo de visión por ordenador de PyTorch
torchvision, para descargar y cargar el conjunto de datos MNIST. Por último, también utilizaremostorchmetricspara evaluar el rendimiento de nuestro modelo.2. Carga y preprocesamiento del conjunto de datos
PyTorch también viene con un rico ecosistema de herramientas y extensiones, incluyendo torchvision, un módulo para visión por ordenador. Torchvision incluye varios conjuntos de datos de imágenes que pueden utilizarse para entrenar y probar redes neuronales. En nuestro tutorial, utilizaremos el conjunto de datos MNIST.
En primer lugar, descargaremos y convertiremos el conjunto de datos MNIST en un tensor, la estructura de datos central de PyTorch, similar a las matrices de NumPy pero con capacidades de aceleración de la GPU.
Luego, también utilizaremos DataLoader para gestionar el procesamiento por lotes y mezclar los conjuntos de datos de entrenamiento y de prueba. Se puede crear un PyTorch DataLoader a partir de un Conjunto de Datos para cargar datos, dividirlos en lotes y realizar transformaciones en los datos si se desea. A continuación, obtiene una muestra de datos lista para el entrenamiento. En el código siguiente, cargamos los datos y los guardamos en DataLoaders con un tamaño de lote de 60 imágenes:
Opcionalmente, el conjunto de datos de entrenamiento podría dividirse a su vez en dos particiones de entrenamiento y validación. La validación es una técnica utilizada en el aprendizaje profundo para evaluar el rendimiento del modelo durante el entrenamiento. Ayuda a detectar posibles sobreajustes e infraajustes de nuestros modelos, y es especialmente útil para optimizar los hiperparámetros. Sin embargo, en aras de la simplicidad, no utilizaremos la validación en este tutorial. Si quieres saber más sobre la validación, puedes consultar una explicación completa en nuestro Curso de Introducción al Aprendizaje Profundo con PyTorch.
Ahora que tenemos nuestros datos, veamos qué aspecto tiene un lote aleatorio de dígitos:
3. Definir la arquitectura de la CNN
Para resolver el problema de clasificación, aprovecharemos la clase
nn.Module, el bloque de construcción de PyTorch para crear intuitivamente sofisticadas arquitecturas de redes neuronales.En el código siguiente, creamos una clase llamada
CNN, que hereda las propiedades de la clasenn.Module. La claseCNNserá el modelo de una CNN con dos capas convolucionales, seguidas de una capa totalmente conectada.En PyTorch, utilizamos
nn.Conv2dpara definir una capa convolucional. Le pasamos el número de mapas de características de entrada y de salida. También ajustamos algunos parámetros para que funcione la capa convolucional, como el tamaño del núcleo o filtro y el relleno.A continuación, añadimos una capa de agrupación máxima con
nn.MaxPool2d. En ella, deslizamos una ventana no solapada sobre la salida de la capa convolucional anterior. En cada posición, seleccionamos el valor máximo de la ventana para pasarlo hacia delante. Esta operación reduce las dimensiones espaciales de los mapas de características, reduciendo el número de parámetros y la complejidad computacional de la red. Por último, añadimos una capa lineal totalmente conectada.La función
forward()define cómo se conectan las distintas capas, añadiendo varias funciones de activación ReLU después de cada capa convolucional.Una vez definida la clase
CNN, podemos crear nuestro modelo y trasladarlo al dispositivo donde será entrenado y ejecutado.Las redes neuronales, incluidas las CNN, muestran un mejor rendimiento cuando se ejecutan en GPU, pero puede que ese sea el caso de tu ordenador. Por lo tanto, ejecutaremos el modelo en una GPU sólo cuando esté disponible; de lo contrario, utilizaremos una CPU normal.
4. Entrenamiento del modelo CNN
Ahora que tenemos nuestro modelo, es hora de entrenarlo. Para ello, primero tendremos que determinar cómo mediremos el rendimiento del modelo. Como se trata de un problema de clasificación multiclase, utilizaremos la función de pérdida de entropía cruzada, disponible en PyTorch como
nn.CrossEntropyLoss. También utilizaremos el optimizador Adam, uno de los algoritmos de optimización más populares.Iteraremos sobre diez épocas y lotes de entrenamiento para entrenar el modelo y realizaremos la secuencia habitual de pasos para cada lote, como se muestra a continuación.
5. Evaluar el modelo
Una vez entrenado el modelo, podemos evaluar su rendimiento en el conjunto de datos de prueba. Utilizaremos la precisión, una métrica popular para los problemas de clasificación. La precisión mide la proporción de casos clasificados correctamente del número total de objetos del conjunto de datos. Se calcula dividiendo el número de predicciones correctas por el número total de predicciones realizadas por el modelo.
En primer lugar, configuramos la métrica de precisión de torchmetrics. A continuación, utilizamos el método .eval del modelo para ponerlo en modo evaluación, porque algunas capas de los modelos PyTorch se comportan de forma diferente en las etapas de entrenamiento y de prueba. También añadimos un contexto Python con
torch.no_grad, indicando que no vamos a realizar el cálculo del gradiente.A continuación, iteramos sobre ejemplos de prueba sin cálculo de gradiente. Para cada lote de pruebas, obtenemos los resultados del modelo, tomamos la clase más probable y la pasamos a la función de precisión junto con las etiquetas. Por último, calculamos las métricas e imprimimos los resultados. Obtuvimos una puntuación de precisión de 0,98, lo que significa que nuestro modelo clasificó correctamente el 98% de los dígitos. No está mal.
También puedes utilizar otras métricas de clasificación populares, como el recuerdo y la precisión. Te contamos todo sobre estas métricas con ejemplos prácticos en nuestro Curso Intermedio de Aprendizaje Profundo con PyTorch.
Mejorar el rendimiento del modelo
Aunque nuestro modelo CNN consigue un gran rendimiento, hay varias estrategias que podemos utilizar para mejorar aún más su precisión, robustez y generalización a nuevos datos.
En esta sección, exploraremos técnicas clave como el aumento de datos, el ajuste de hiperparámetros y el aprendizaje por transferencia para optimizar el rendimiento de nuestro modelo.
Técnicas de aumento de datos
El aumento de datos es una técnica utilizada para mejorar la precisión de nuestro modelo creando aleatoriamente nuevos datos de entrenamiento. Por ejemplo, durante la carga, se pueden aplicar transformaciones a las imágenes de entrenamiento, como el cambio de tamaño, el volteo horizontal o vertical, la rotación aleatoria, etc. De ese modo, se pueden crear imágenes aumentadas y asignarles la misma etiqueta que a la imagen original, aumentando así el tamaño del conjunto de entrenamiento.
Añadir transformaciones aleatorias a las imágenes originales nos permite generar más datos y, al mismo tiempo, aumentar el tamaño y la diversidad del conjunto de entrenamiento. Hace que el modelo sea más robusto a las variaciones y distorsiones habituales en las imágenes del mundo real, y reduce el sobreajuste, ya que el modelo aprende a ignorar las transformaciones aleatorias.
Sin embargo, es importante tener cuidado con el aumento de datos, ya que a veces puede perjudicar el proceso de entrenamiento. Por ejemplo, en nuestro problema, si aplicamos el volteo vertical al número "6", se parecerá al número "9". Pasarlo al modelo etiquetado como "6" confundirá al modelo y dificultará el entrenamiento. Estos ejemplos demuestran que, a veces, los aumentos específicos pueden influir en la etiqueta.
Ajuste de hiperparámetros
Otra estrategia para mejorar el rendimiento de nuestro modelo consiste en modificar los valores de los hiperparámetros que intervienen en las distintas capas del modelo. Este ajuste de hiperparámetros requiere un profundo conocimiento de las matemáticas que hay detrás de las redes neuronales y del significado de los distintos hiperparámetros.
Por ejemplo, podrías ajustar tus capas CNN cambiando el tamaño de los filtros o aumentando el relleno. También puedes establecer un valor diferente para los pesos iniciales de las neuronas.
Como no conoceremos de antemano los valores óptimos de los hiperparámetros, será necesario cierto grado de ensayo y error. Esto se hace normalmente mediante una técnica conocida como búsqueda en cuadrícula, que te permite evaluar sistemáticamente un modelo a través de una cuadrícula de valores de parámetros.
Sin embargo, ten cuidado al utilizar esta técnica, ya que suele ser costosa desde el punto de vista informático, sobre todo cuando se trata de redes neuronales complejas y grandes conjuntos de datos de entrenamiento.
Igualmente, podrías aumentar la complejidad de tu modelo añadiendo más capas convolucionales y lineales. Sin embargo, ten cuidado al añadir nuevas capas, pues el número de neuronas puede aumentar drásticamente, lo que provocará tiempos de entrenamiento más largos y posibles sobreajustes.
Puedes aprender más sobre el ajuste de hiperparámetros en nuestro Curso de Introducción al Aprendizaje Profundo con PyTorch.
Utilizar modelos preentrenados
Entrenar modelos de aprendizaje profundo desde cero es un proceso largo y tedioso, y normalmente requiere muchos datos de entrenamiento. En su lugar, a menudo podemos utilizar modelos preentrenados, es decir, modelos que ya han sido entrenados en alguna tarea.
A veces, podemos reutilizar directamente un modelo preentrenado si ya puede resolver la tarea que nos interesa. En otras ocasiones, puede que tengamos que ajustar el modelo preentrenado para que se adapte a la nueva tarea. Esto se conoce como aprendizaje por transferencia.
Utilizar modelos preentrenados en PyTorch es bastante fácil. Torchvision proporciona una colección de modelos preentrenados para diversas tareas relacionadas con las imágenes. Estos modelos están preentrenados en conjuntos de datos de imágenes a gran escala y son fáciles de conseguir. Consulta nuestro Curso de Aprendizaje Profundo para Imágenes con PyTorch para aprender todo lo que necesitas saber sobre ellos.
Despliegue del modelo CNN
Una vez entrenado tu modelo de clasificación de alta precisión en PyTorch, ya puedes guardar el modelo y sus pesos preentrenados para utilizarlos en el futuro y compartirlo con tu equipo, asegurándote de que puedan cargarlo sin problemas.
Para guardar un modelo, podemos utilizar
torch.save. Una extensión de archivo común para los modelos de antorcha esptopth. Para guardar los pesos del modelo, pasamosmodel.state_dictatorch.saveproporcionando el nombre del archivo de salida, por ejemplo,MulticlassCNN.pth.Para cargar un modelo guardado, inicializamos un nuevo modelo con la misma arquitectura. A continuación, utilizamos el método de carga de estado
dictjunto contorch.loadpara cargar los parámetros en el nuevo modelo.Conclusión
Hemos cubierto una visión completa de las CNN, proporcionando detalles sobre cada capa de la arquitectura CNN. Además, proporcionamos una guía sobre cómo implementar una CNN en PyTorch, que cubre los pasos principales, desde la carga de datos y el diseño del modelo hasta el entrenamiento y la evaluación del modelo. Por último, también analizamos varias estrategias para mejorar el rendimiento de nuestro modelo. Aplicamos todos estos conjuntos de habilidades a un escenario del mundo real relacionado con una tarea de clasificación multiclase.
Hay mucho que aprender sobre el aprendizaje profundo, posiblemente uno de los campos más apasionantes y exigentes de la IA. Afortunadamente, DataCamp está aquí para ayudarte. Consulta nuestros materiales y cursos dedicados y conviértete en un experto en redes neuronales: