
Cours
Analyse des séries temporelles en Python
4 h
70.6K
Le traitement du signal est une discipline fondamentale de la data science qui consiste à extraire, analyser et transformer des signaux et des données de séries temporelles. Le domaine est vaste et peut vite devenir complexe. Ce guide vous présente les notions et concepts clés pour aborder le traitement des signaux, qu’il s’agisse de données de capteurs de pression ou de tendances boursières.
Dans le cadre du traitement du signal, un signal désigne toute information qui varie dans le temps ou dans l’espace. Les signaux prennent de nombreuses formes : formes d’onde audio, relevés de température, données de marché financier, mesures de capteurs, etc.
Les séries temporelles sont un sous-ensemble de signaux où les mesures sont enregistrées à des instants successifs. Les signaux peuvent être analogiques (continus) ou numériques (discrets).
On distingue deux grandes catégories de données de signal : continues et discrètes.
Les signaux continus sont mesurés et enregistrés sur un intervalle continu, par exemple les signaux analogiques comme les ondes sonores ou les mesures de température (thermomètres analogiques).
Les signaux discrets sont relevés à des instants spécifiques et distincts. C’est le format le plus courant en pratique, en raison de la nature discrète des systèmes actuels d’acquisition et de stockage de données.
Les mesures de capteurs numériques et les données de marché échantillonnées à intervalles fixes sont des exemples de signaux discrétisés dans le temps.
Souvent, les signaux bruts sont difficiles à interpréter.
Imaginez par exemple visualiser l’onde sonore d’un podcast. Le traitement du signal permet d’extraire de ces données brutes des informations précieuses, invisibles au premier coup d’œil. Ces informations servent ensuite à prendre des décisions éclairées, identifier des opportunités ou résoudre des problèmes complexes dans de nombreux domaines.
Le traitement du signal est également utile lors du prétraitement des données.
Les données réelles sont souvent bruitées ; les techniques de traitement du signal aident les data scientists à supprimer perturbations, valeurs aberrantes et artefacts, pour obtenir des jeux de données plus propres et fiables. Ces données propres sont essentielles pour des modèles et des prévisions précis, ainsi que pour d’autres analyses avancées. Par ailleurs, le traitement du signal est au cœur de nombreux algorithmes et modèles de pointe en data science, comme les prévisions de séries temporelles, la détection d’anomalies, ou encore la reconnaissance d’images et de la parole.
Figure 1 : Image artistique représentant l’audiogramme (fréquences sonores) d’un podcasteur. Ce type d’audiogramme est un exemple de signal. Crédit : DALL-E.
Une série temporelle est un type de signal ordonné dans le temps, où chaque point est associé à un horodatage. Cette structure temporelle permet d’analyser tendances, saisonnalités et cycles. De nombreuses ressources existent pour l’analyse de séries temporelles en Python et en R.
La prévision de séries temporelles est un sous-domaine du traitement du signal qui vise à prédire les valeurs futures à partir des données historiques. Elle est cruciale dans de nombreux secteurs pour prendre de meilleures décisions, optimiser les ressources et anticiper les tendances de marché. Elle consiste à analyser les motifs et tendances d’une série pour estimer ses valeurs aux pas de temps à venir.
Pour une vue détaillée de la prévision de séries temporelles, consultez le tutoriel Time Series Forecasting.
Les signaux se comprennent souvent mieux en images. Plusieurs types de graphiques sont couramment utilisés selon la nature des données.
Les graphiques en lignes sont un moyen simple et puissant de visualiser un signal : l’axe des ordonnées représente la valeur du signal, et l’axe des abscisses un indicateur séquentiel (temps, mètres, numéro d’échantillon, etc.). Ils offrent une lecture immédiate des tendances et fluctuations.
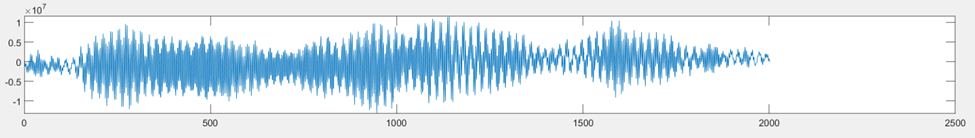
La forme d’onde audio est un moyen courant de visualiser le son. Vous avez peut-être vu ces tracés lors de l’écoute de musique ou de podcasts, de nombreuses applications les affichant en temps réel.
Autres visualisations classiques : le spectrogramme ou l’audiogramme. Les données boursières sont souvent représentées par une série de boîtes, appelées chandeliers (candlesticks), pour afficher les tendances dans le temps.
Figure 3 : Exemple de forme d’onde audio représentant un son. Crédit image : DALL-E.
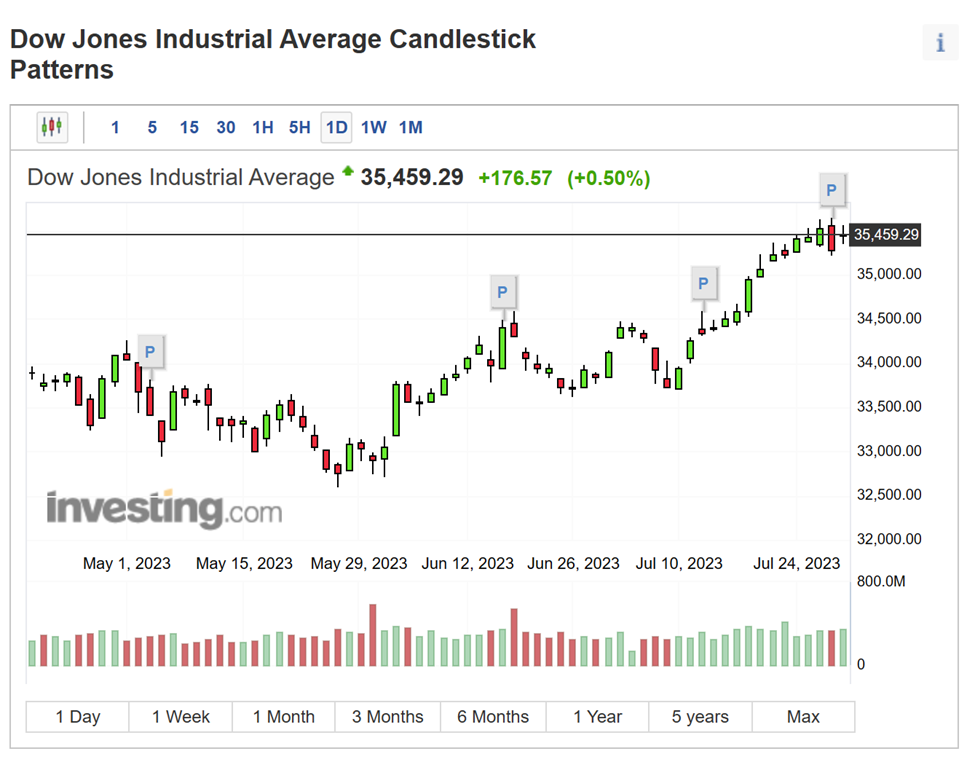
Figure 4 : Exemple de graphique en chandeliers pour l’analyse des marchés. Source de l’image
Pour le traitement du signal et l’analyse de séries temporelles, deux outils de programmation sont couramment utilisés : MATLAB et Python.
MATLAB, développé par MathWorks, est un outil puissant et polyvalent, largement adopté en ingénierie, mathématiques et recherche scientifique. Sa documentation riche, ses fonctions natives dédiées au traitement du signal, son interface conviviale et ses capacités de visualisation en font un excellent choix. Son principal inconvénient reste son coût.
Si vous souhaitez utiliser MATLAB pour le traitement du signal, consultez la Signal Processing Toolbox et l’Audio Toolbox, toutes deux très bien documentées et riches en exemples interactifs.
Python est une alternative gratuite, plébiscitée par de nombreux data scientists pour ces tâches. Si vous envisagez de passer de Matlab à Python, découvrez ce cours Python for MATLAB users de DataCamp !
Des bibliothèques comme NumPy, Pandas et SciPy offrent un solide support pour l’analyse de séries temporelles. La documentation est abondante pour Python, mais sa nature open source peut parfois compliquer la recherche d’exemples adaptés à votre cas précis.
Pour des tâches de traitement du signal, je vous recommande ce dépôt GitHub.
Le prétraitement des données est une étape cruciale qui conditionne la qualité et la pertinence de l’analyse. Selon vos données et vos objectifs, cela peut consister à gérer des échantillonnages irréguliers ou des valeurs manquantes via le rééchantillonnage et l’interpolation, ou à lisser vos données au moyen de filtres.
En travaillant sur des signaux, vous pouvez rencontrer des intervalles d’échantillonnage irréguliers ou des points manquants, ce qui complique l’analyse et la modélisation.
Le rééchantillonnage permet d’uniformiser les intervalles. Il peut s’agir d’augmenter la fréquence (upsampling) ou de la réduire (downsampling) pour obtenir une série temporelle régulière.
L’interpolation intervient lorsque des points manquent ou doivent être estimés. Les techniques courantes incluent l’interpolation linéaire, par splines ou basée sur le temps.
Ces méthodes comblent les lacunes en estimant des valeurs à partir des points voisins, afin d’obtenir un signal continu et plus lisse.
Au fond, rééchantillonnage et interpolation reposent sur une même idée pour des résultats différents : interpréter un motif dans les données et « deviner » à quoi ressembleraient les valeurs le long de ce motif, avec des approches distinctes.
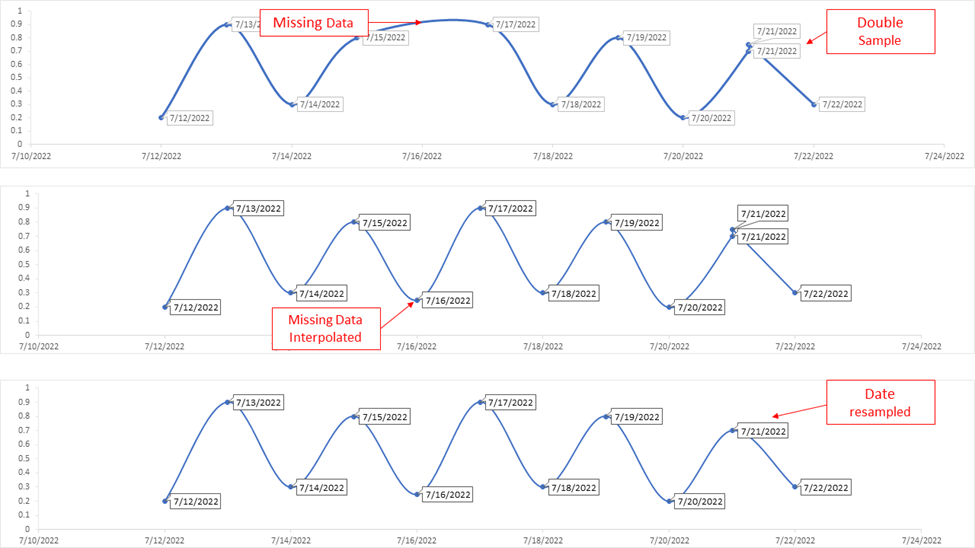
Figure 5 : Exemple très simplifié montrant comment l’interpolation et le rééchantillonnage peuvent nettoyer des données désordonnées.
Le bruit et les valeurs aberrantes sont fréquents dans les signaux et peuvent entraver l’obtention d’insights.
Les valeurs aberrantes s’écartent fortement du motif global, tandis que le bruit correspond à des fluctuations aléatoires qui masquent les structures sous-jacentes.
On peut gérer les valeurs aberrantes via des techniques comme la troncature ou la winsorisation, qui consistent à plafonner les valeurs extrêmes à un seuil donné.
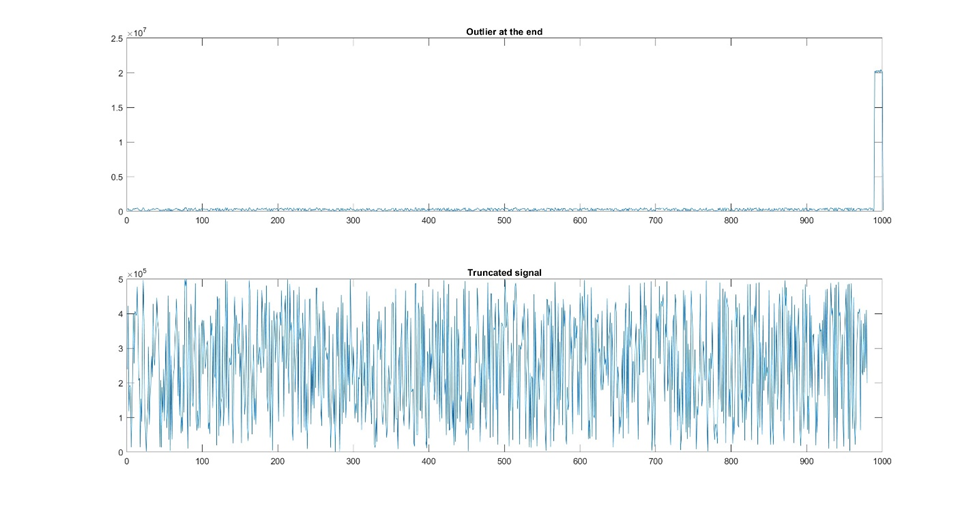
Figure 6 : Parfois, le bruit ou des valeurs aberrantes se concentrent au début ou à la fin du signal ; vous pouvez y remédier en tronquant le jeu de données.
Autre option : traiter séparément ces valeurs lors de l’analyse, selon leur importance et leur impact global.
Au final, votre stratégie face au bruit et aux valeurs aberrantes dépendra de votre jeu de données.
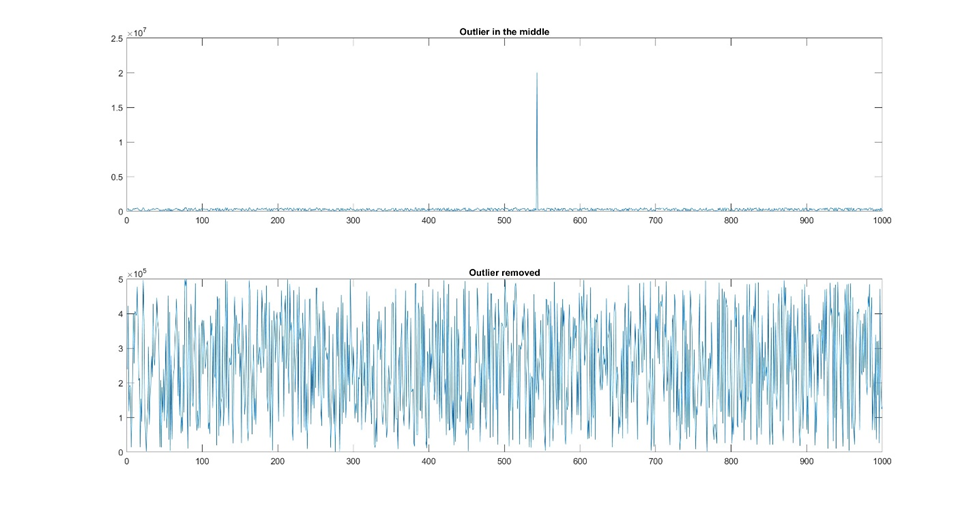
Figure 7 : S’il n’y a que quelques valeurs aberrantes, vous pouvez les supprimer manuellement. Autre approche : éliminer toute valeur en dehors d’une plage d’amplitude donnée.
Une manière de traiter le bruit consiste à lisser le signal pour atténuer les fluctuations aléatoires.
Cette technique met en évidence les tendances de fond tout en supprimant le bruit à court terme. Le lissage relève souvent d’un dosage subtil : assez pour réduire le bruit de fond, pas au point d’effacer le signal. Étant donné l’importance du filtrage, nous y reviendrons plus loin.
Les moyennes mobiles et fenêtres glissantes sont des techniques simples et efficaces pour lisser les séries temporelles et réduire l’impact du bruit. Les fenêtres glissantes consistent à calculer une statistique (p. ex. : moyenne ou écart-type) sur une fenêtre coulissante de points. Cette approche met en évidence des motifs locaux et des variations.
La moyenne mobile est l’application la plus courante des fenêtres glissantes, où l’on calcule la moyenne. Elle atténue les fluctuations à court terme et facilite l’identification des tendances de fond. Les moyennes mobiles sont particulièrement utilisées en finance pour étudier les tendances de prix.
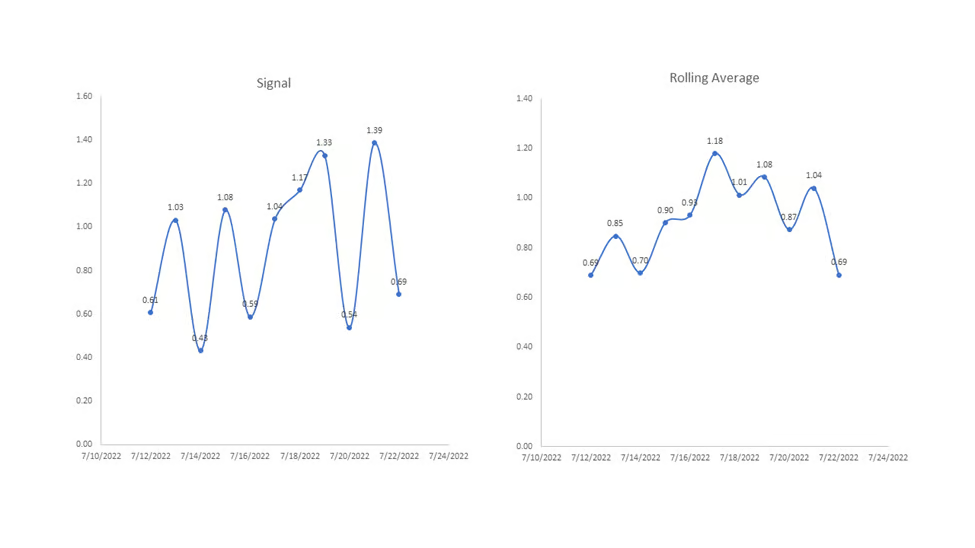
Figure 8 : Exemple d’utilisation d’une moyenne glissante pour lisser un signal. Ici, la fenêtre est de 3 : chaque point du graphe de droite est la moyenne de trois points correspondants du graphe de gauche.
Les filtres passe-bas, passe-haut et passe-bande sont des techniques fréquentielles qui laissent passer ou bloquent certaines composantes de fréquence d’un signal.
Un filtre passe-bas laisse passer les basses fréquences et atténue les hautes, utile pour supprimer le bruit et conserver les tendances lentes.
À l’inverse, un filtre passe-haut laisse passer les hautes fréquences et filtre les basses. Il sert souvent à mettre en relief des événements brefs ou des variations soudaines.
Un filtre passe-bande laisse passer une plage de fréquences donnée et bloque les autres. Il est utile lorsque des bandes spécifiques concentrent l’information pertinente. En audio, par exemple, un passe-bande peut extraire des fréquences correspondant à la parole humaine.
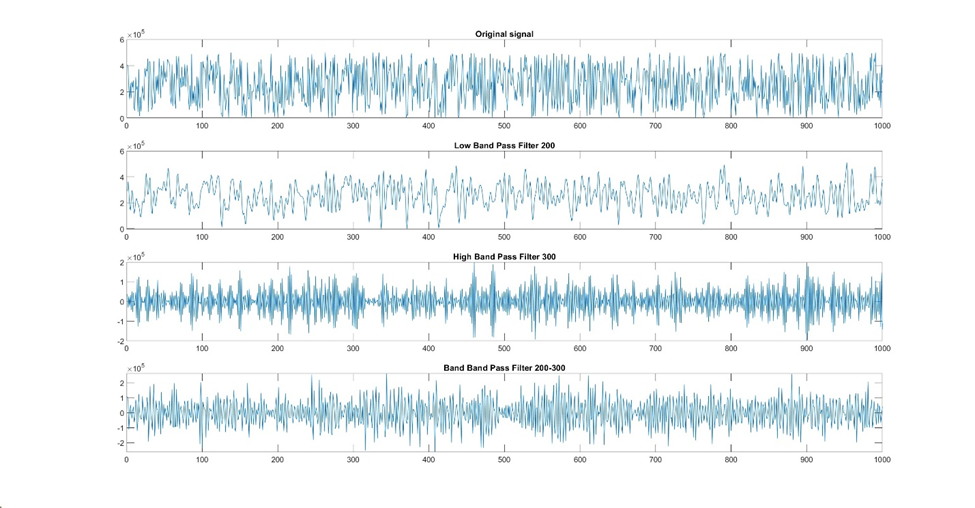
Figure 9 : Démonstration de l’effet de différents filtres sur un signal.
Choisir le bon filtre ou la bonne technique de lissage pour votre jeu de données peut prendre du temps.
Une bonne stratégie est de commencer par un passe-bande haut ou bas (selon ce que vous cherchez à isoler), puis d’itérer.
Voici plusieurs techniques plus avancées à essayer si les méthodes simples n’isolent pas suffisamment le motif recherché :
On peut appréhender un signal dans le domaine temporel ou fréquentiel. Commençons par le temps.
L’analyse temporelle consiste à examiner le comportement d’un signal au fil du temps. Nous allons explorer trois aspects importants : l’auto-corrélation et la corrélation croisée, les caractéristiques temporelles (moyenne, variance, asymétrie, kurtosis, etc.) et l’analyse de tendance avec méthodes de dé-trend.
Le calcul de différentes caractéristiques statistiques dans le temps fournit des informations précieuses sur le comportement d’une série.
La moyenne donne la tendance centrale des données, un aperçu du niveau global.
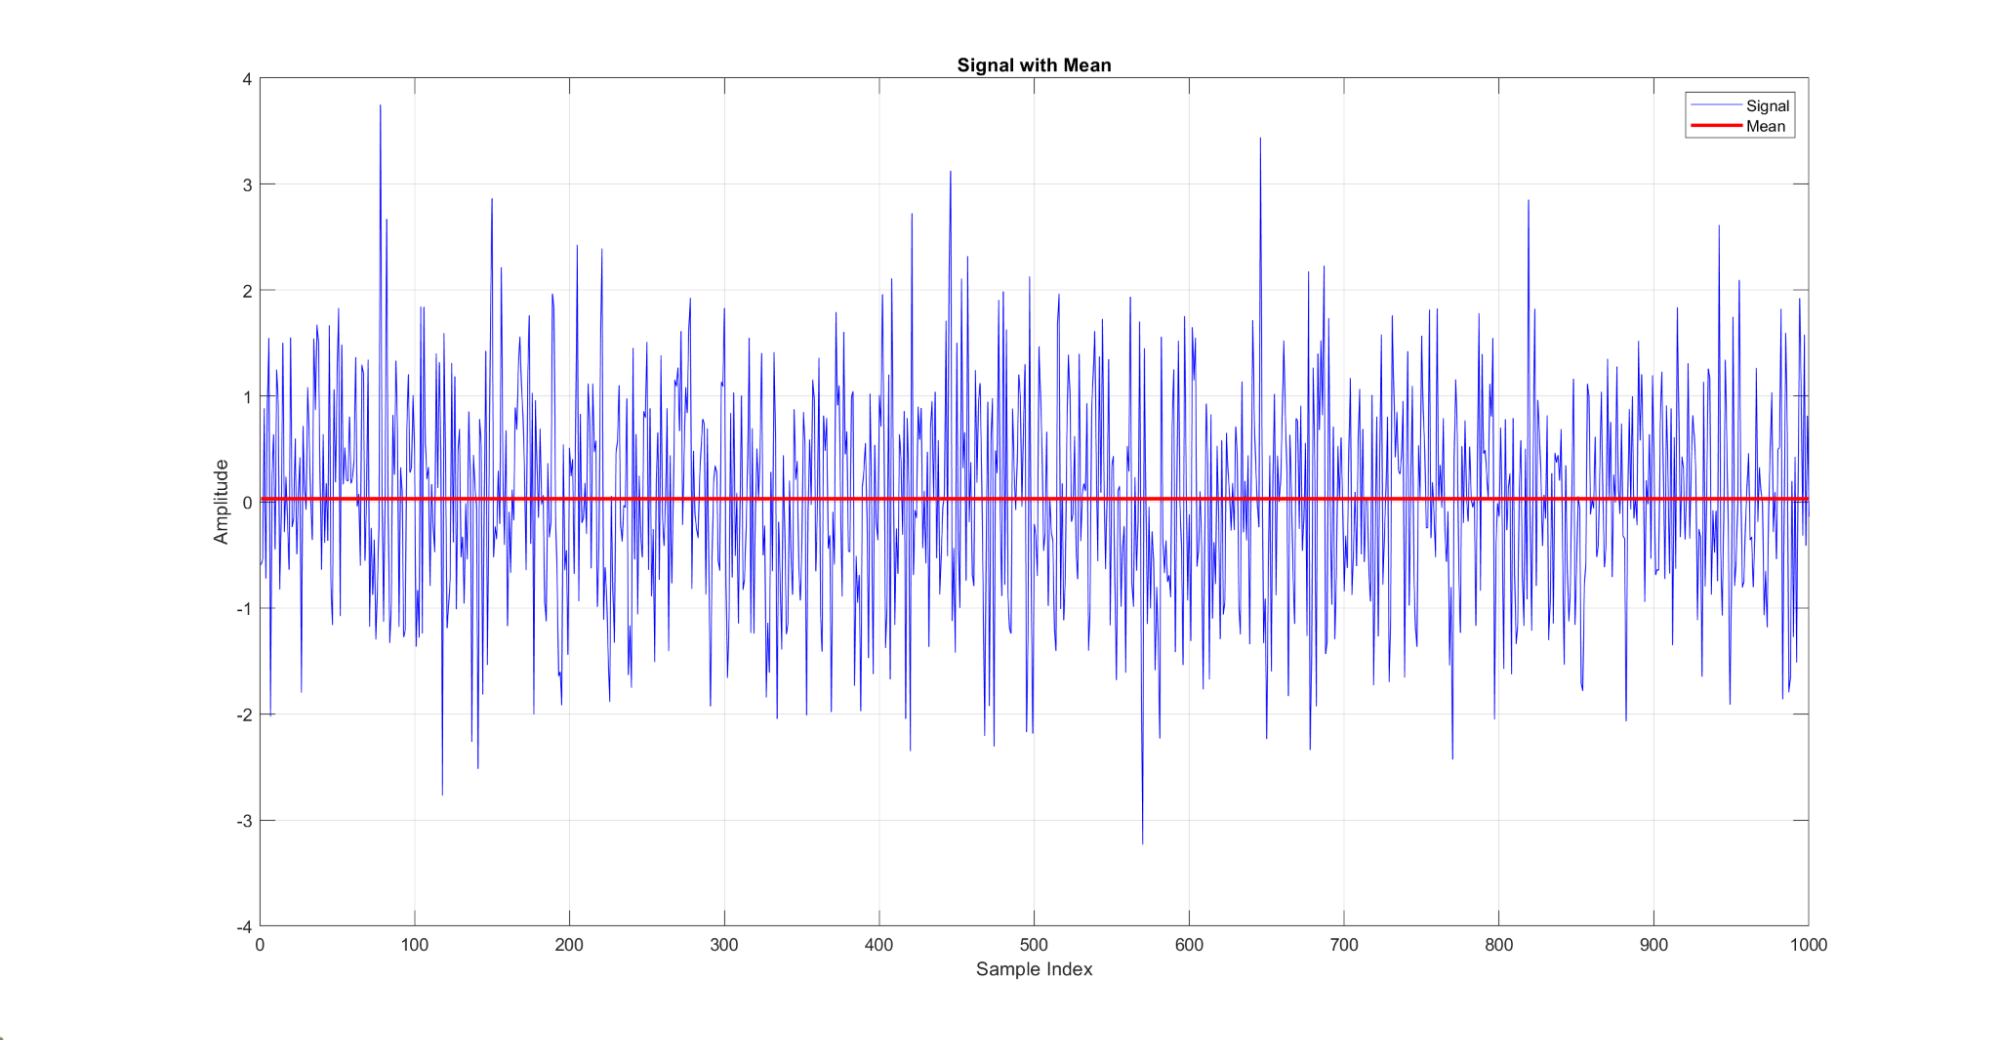
Figure 10 : Illustration de la moyenne d’un signal. La ligne rouge indique la moyenne de la distribution bleue.
La variance mesure la dispersion des points autour de la moyenne.
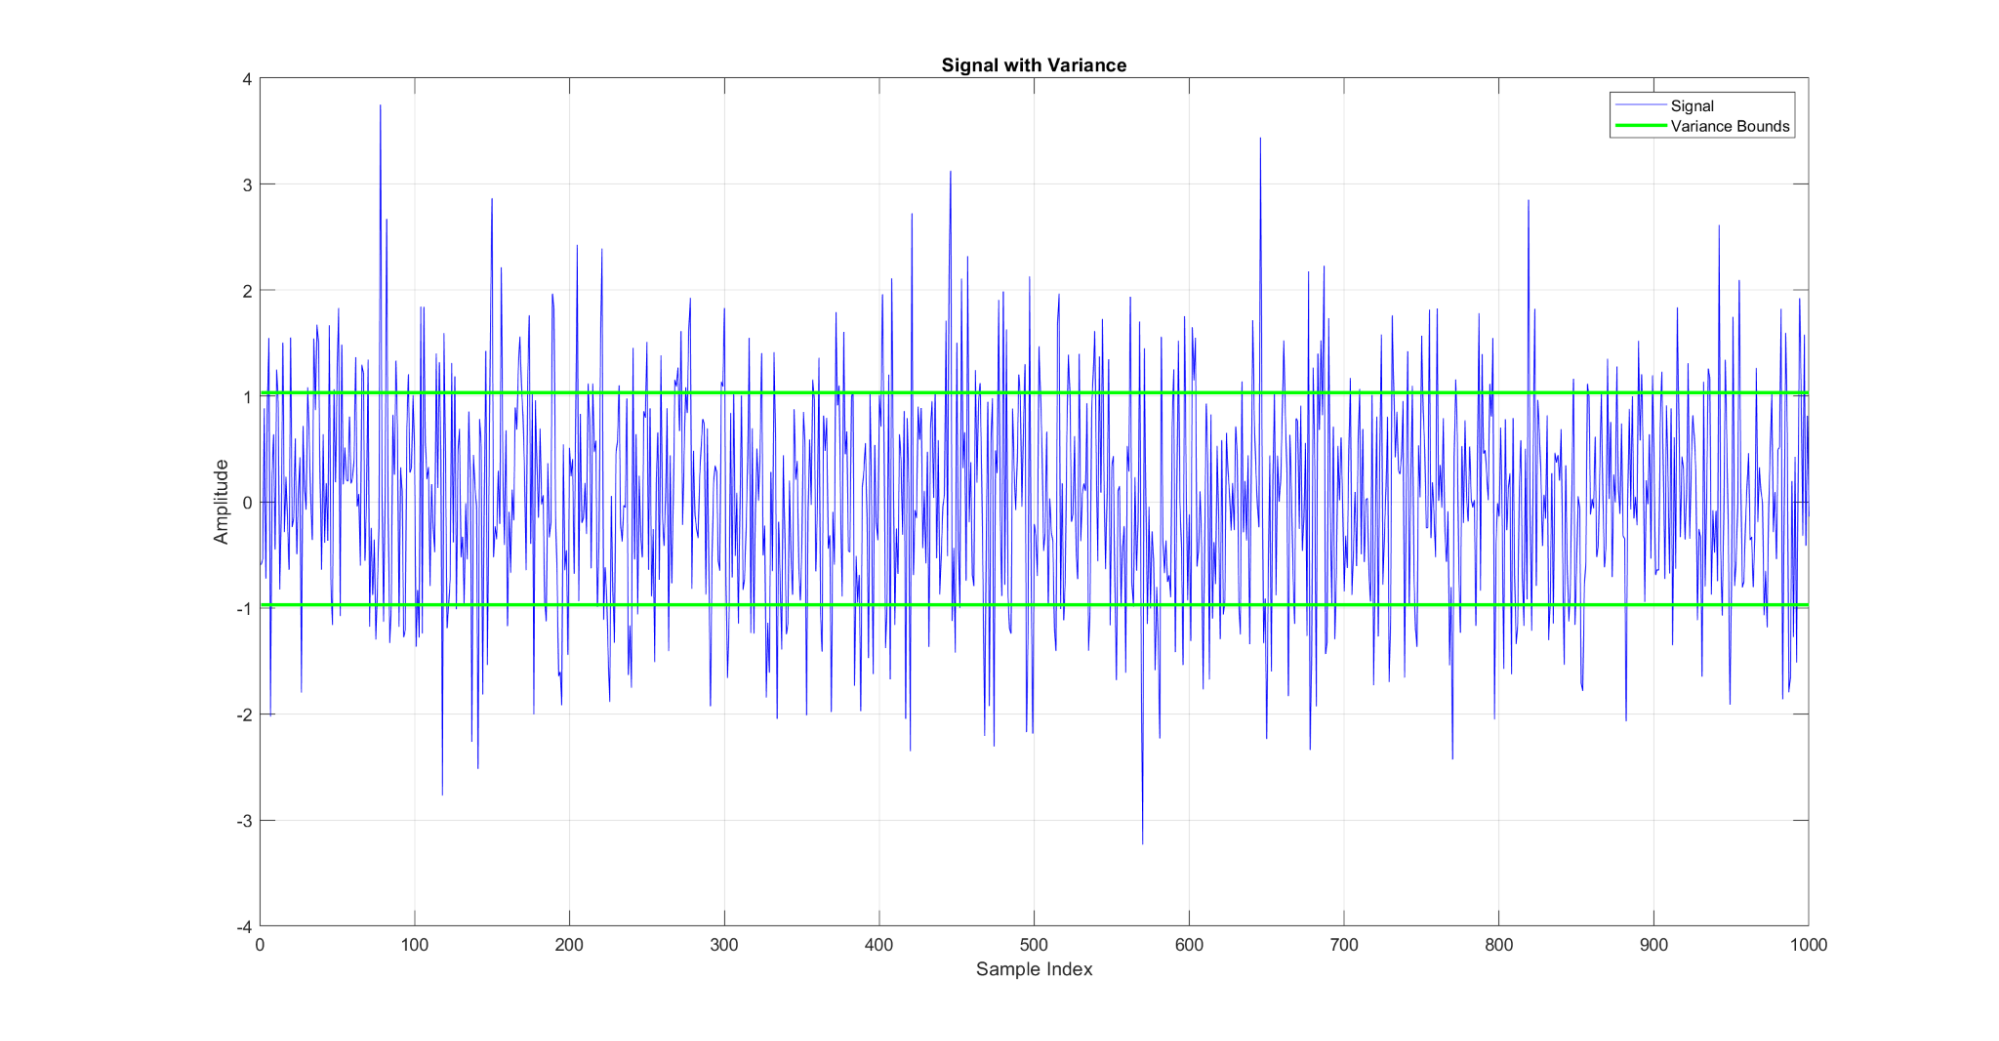
Figure 11 : Illustration de la variance pour un signal. Les lignes vertes représentent la variance autour de la moyenne.
L’asymétrie (skewness) quantifie la dissymétrie de la distribution, indiquant si les données s’étalent plutôt d’un côté.
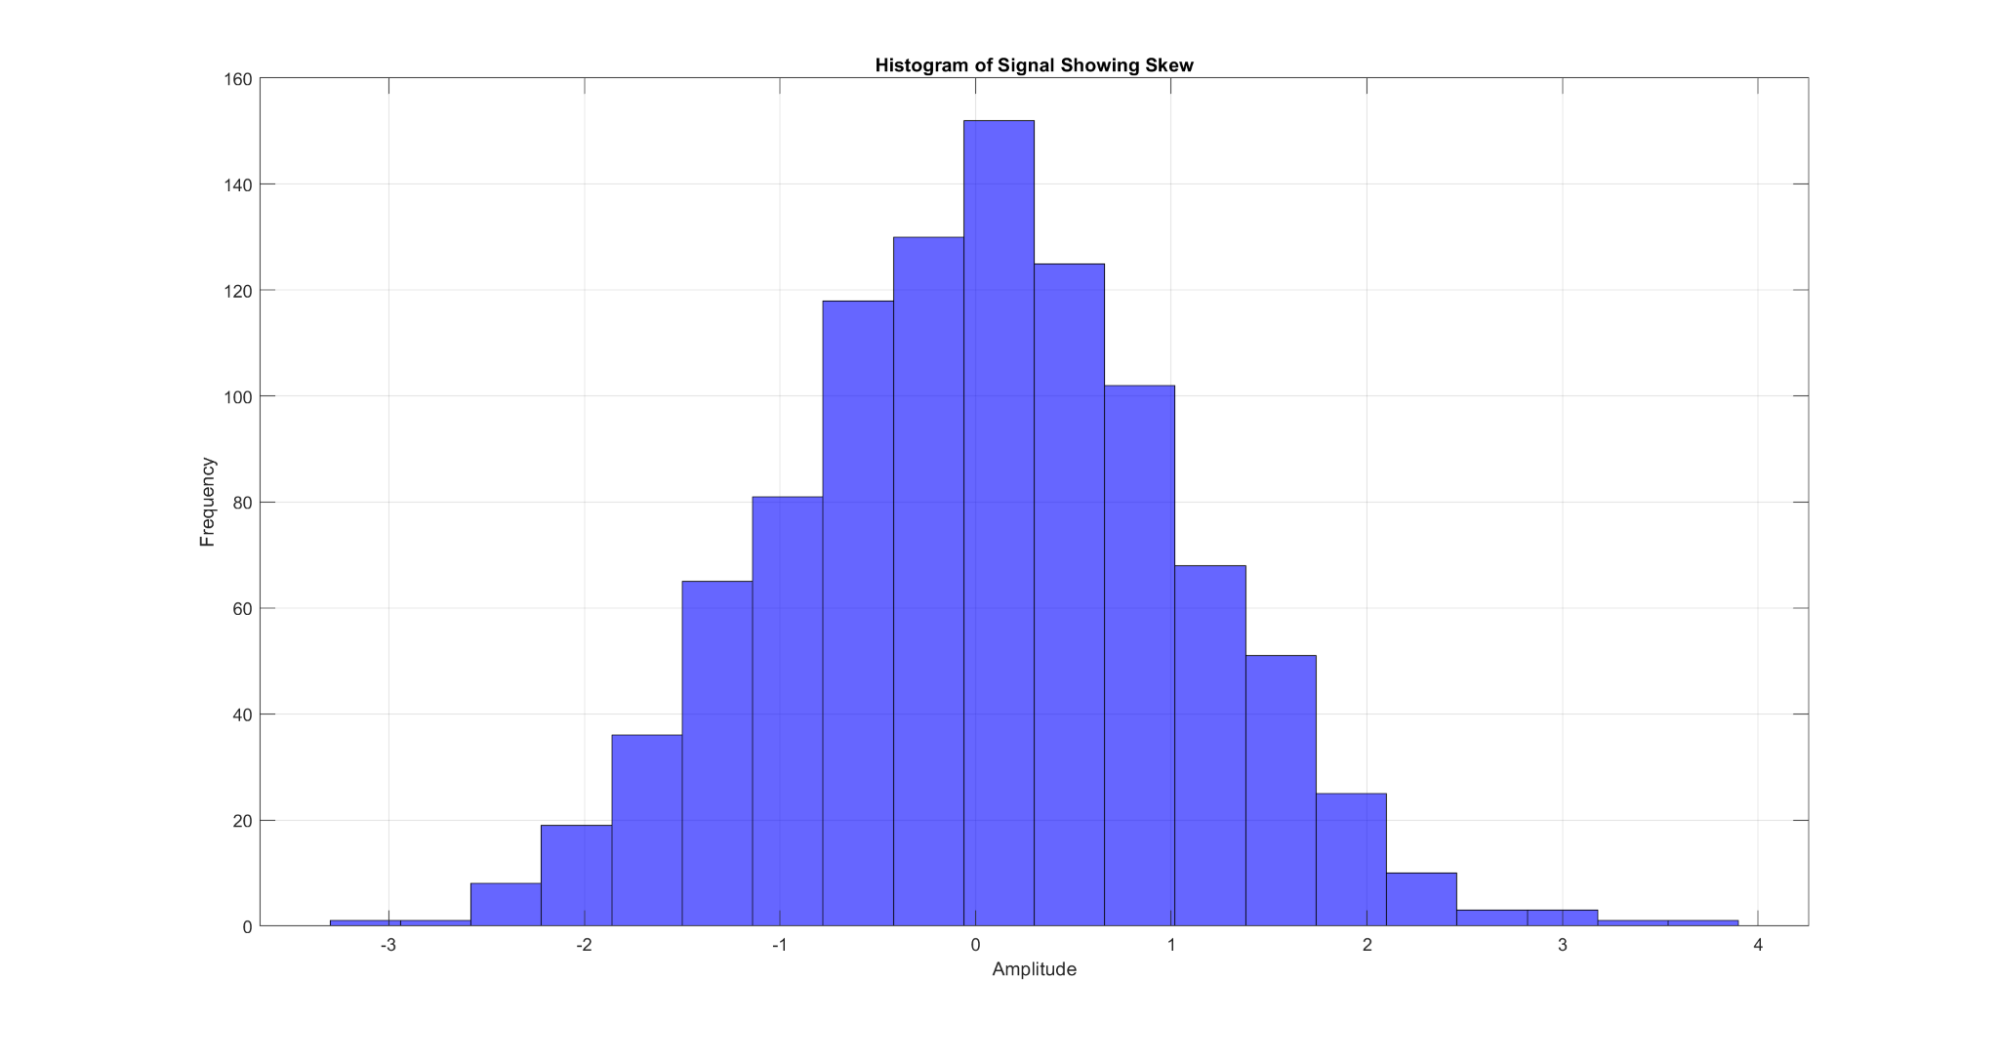
Figure 12 : Illustration de l’asymétrie. Lorsque le signal est représenté en histogramme des amplitudes, l’asymétrie se voit dans la dissymétrie des queues.
La kurtosis mesure l’épaisseur des queues de la distribution et caractérise la présence de valeurs extrêmes.
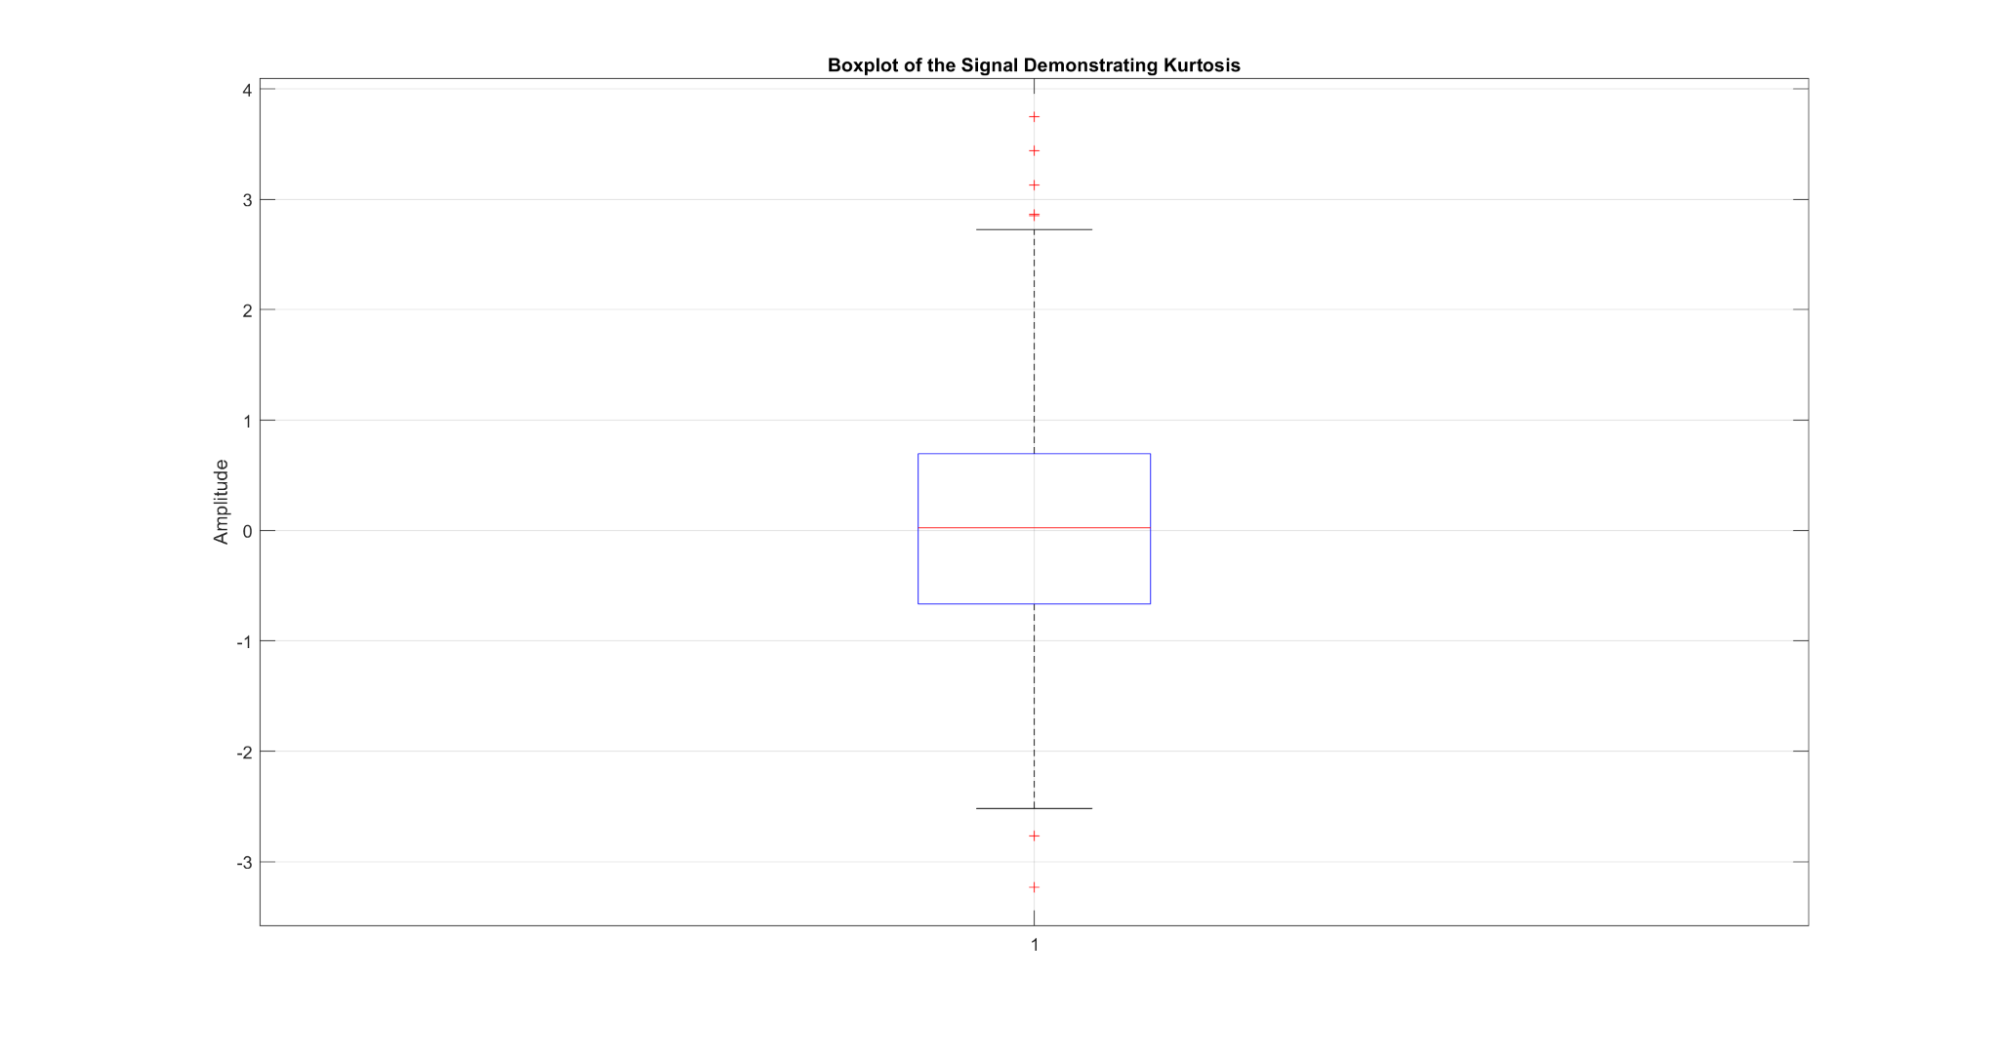
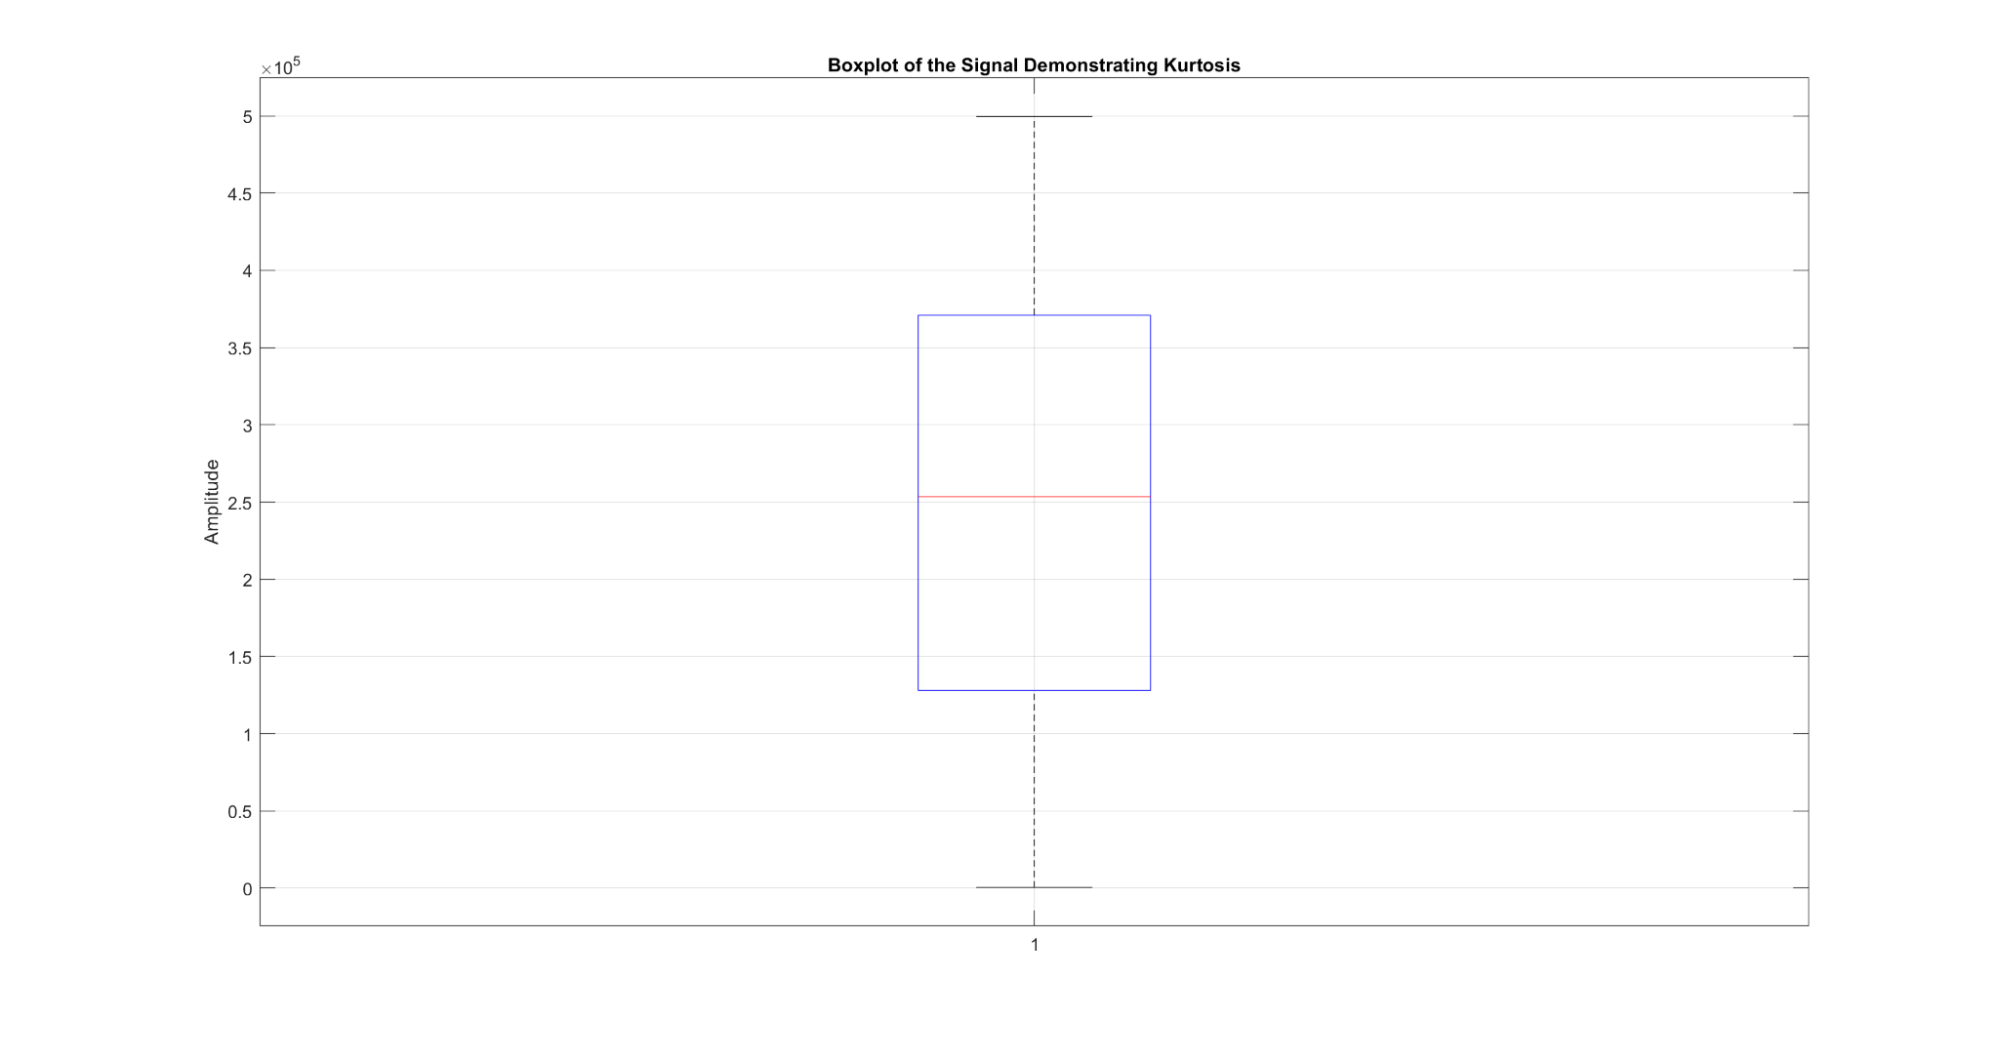
Figure 13 : Illustration de la kurtosis. En boîte à moustaches, elle se visualise par la hauteur de la boîte.
Si vous avez déjà travaillé sur des distributions, ces statistiques vous sont familières : elles s’appliquent aux signaux comme aux distributions.
L’auto-corrélation mesure la similarité entre une série et une version décalée d’elle-même. Elle permet d’identifier des motifs répétitifs ou un comportement cyclique.
Une forte auto-corrélation à un certain décalage indique un motif récurrent avec cette périodicité. Par exemple, sur des données d’infections virales, l’auto-corrélation peut révéler une saisonnalité des vagues.
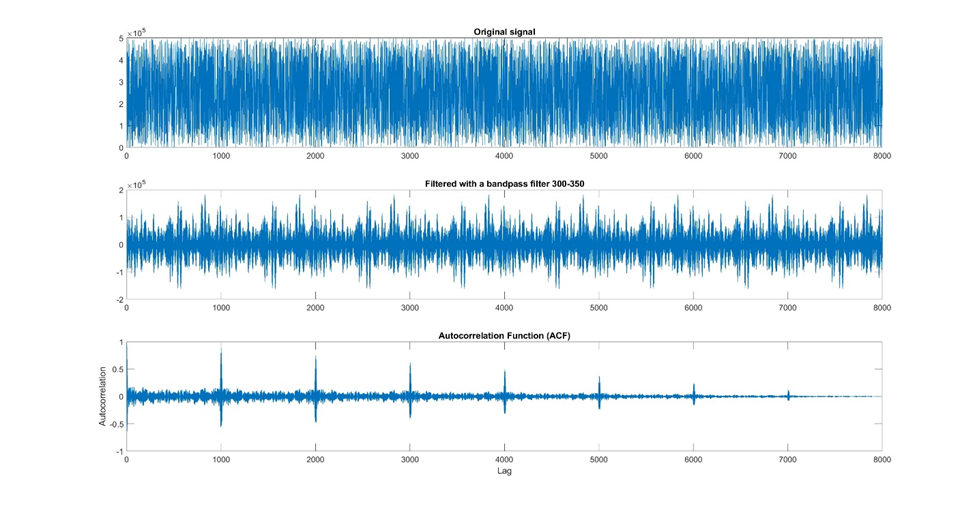
Figure 14 : Exemple d’utilisation de l’auto-corrélation pour identifier une périodicité. Ici, un signal très bruité a été filtré par passe-bande puis soumis à une auto-corrélation pour évaluer sa corrélation avec lui-même à différents décalages. Le graphe montre une répétition avec une période d’environ 1000.
La corrélation croisée étudie la relation entre deux signaux différents. Elle sert à repérer corrélations et décalages entre variables. Par exemple, on peut analyser la relation entre la température et la consommation d’énergie dans le temps.
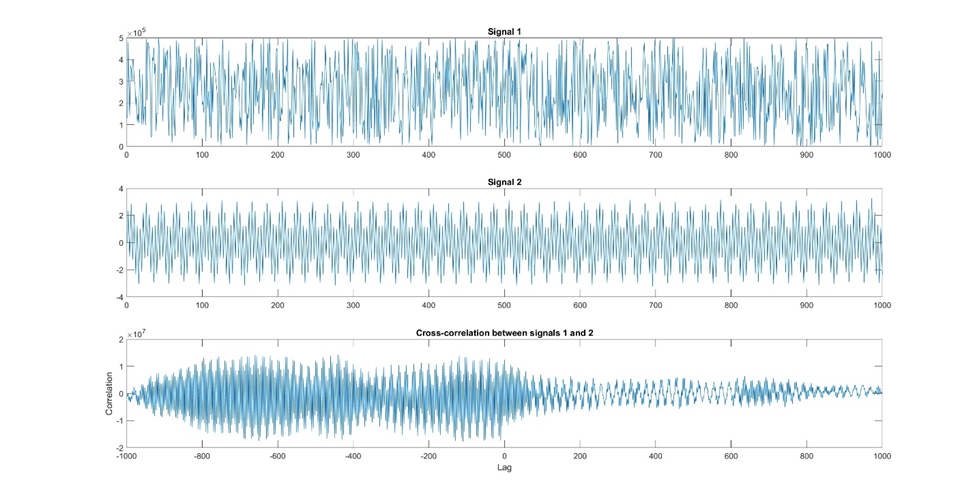
Figure 15 : Exemple de corrélation croisée. Nous avons deux signaux, l’un faiblement périodique et l’autre plus nettement. La corrélation croisée révèle une corrélation plus forte pour des décalages négatifs et quasi nulle pour des décalages positifs.
L’analyse de tendance permet de comprendre le comportement de fond d’un signal sur le long terme. Une tendance décrit la direction générale des données sur une période étendue : ascendante, descendante ou stable.
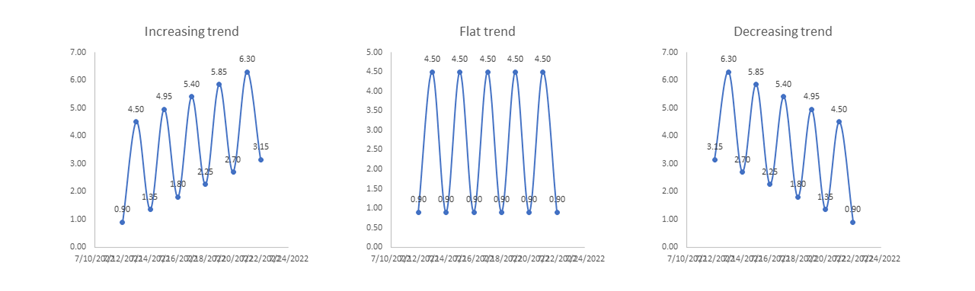
Figure 12 : Exemple de trois types de tendances : croissante, stable et décroissante.
Les méthodes de dé-trend consistent à séparer la tendance du reste du signal, afin de se concentrer sur la saisonnalité et les fluctuations irrégulières.
Une méthode courante est la moyenne mobile, où l’on soustrait au signal lissée la série d’origine. D’autres approches consistent à ajuster un polynôme ou à utiliser des techniques comme le filtre de Hodrick–Prescott.
À première vue, le dé-trend ressemble au lissage, mais les objectifs diffèrent : le lissage réduit le bruit pour clarifier les tendances longues, tandis que le dé-trend supprime ces tendances pour rendre plus visibles les périodicités et saisonnalités. Selon vos buts, vous pouvez combiner les deux.
Visualiser le signal d’origine aux côtés du signal dé-trendé aide à mieux comprendre le comportement des données. Les tracés en lignes ou en tiges s’y prêtent bien.
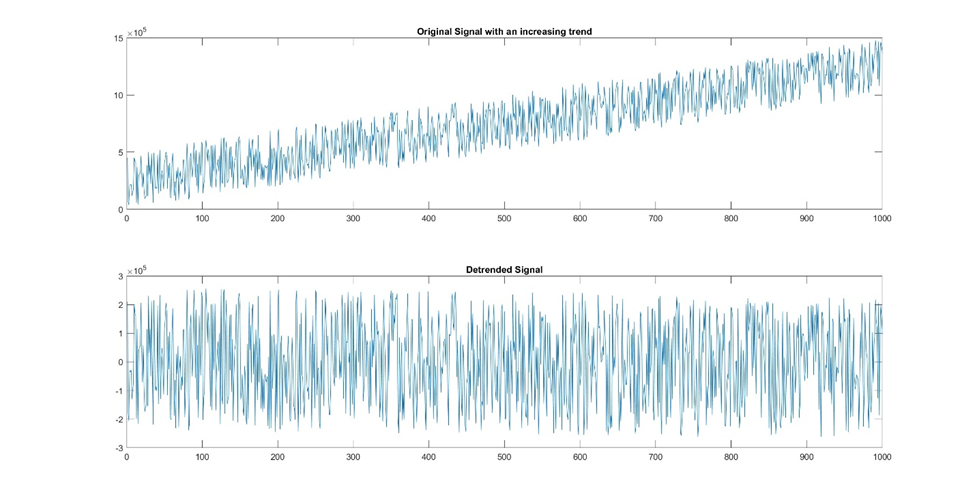
Figure 16 : Exemple illustrant la puissance du dé-trend. Le signal original présentait une tendance haussière. Après dé-trend, le motif ne suit plus cette trajectoire. Une fois la tendance retirée, un filtre de lissage peut aider à mieux voir le motif sous-jacent.
L’analyse fréquentielle est une approche puissante pour comprendre les composantes en fréquence des données.
La transformée de Fourier convertit un signal temporel en sa représentation fréquentielle. Elle décompose le signal d’origine en une somme de fonctions sinusoïdales de différentes fréquences. Le spectre de fréquences obtenu met en évidence les composantes présentes dans la série.
La visualisation se fait souvent via la densité spectrale de puissance (PSD), qui affiche la puissance (ou le carré de l’amplitude) de chaque fréquence. Les pics de la PSD indiquent les fréquences dominantes et révèlent des motifs ou des comportements périodiques.
La densité spectrale de puissance est un outil fondamental du domaine fréquentiel, montrant la répartition de la puissance selon la fréquence. Elle renseigne sur l’intensité des différentes composantes fréquentielles du signal.
Des pics élevés signalent des composantes fortes, alors que des pics faibles traduisent des fréquences moins marquées.
On visualise souvent la PSD en échelle logarithmique pour mieux distinguer les fréquences faibles. Ces graphes aident à identifier des fréquences significatives correspondant à des phénomènes précis dans les données.
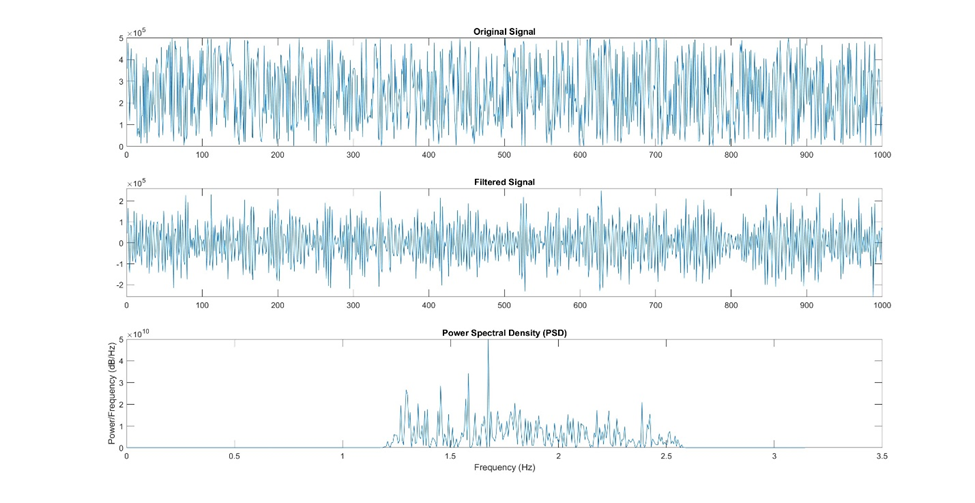
Figure 17 : Exemple d’utilisation d’une PSD pour examiner la force des composantes fréquentielles d’un signal. Le signal a été filtré par passe-bande, puis la PSD a été générée avec une fonction native de Matlab.
Le spectrogramme est une visualisation qui montre comment le contenu fréquentiel d’un signal évolue dans le temps. Il fournit une représentation temps–fréquence en découpant le signal en segments et en calculant la transformée de Fourier pour chacun.
À l’aide d’une carte de couleurs représentant la puissance ou l’amplitude de chaque composante, le spectrogramme offre une vue tridimensionnelle des données. Les zones chaudes indiquent des composantes fortes à certains instants, tandis que les zones froides signalent des fréquences faibles ou absentes.
L’analyse temps–fréquence permet de détecter des événements transitoires ou des changements de caractéristiques fréquentielles difficiles à repérer uniquement dans le temps ou la fréquence. C’est particulièrement utile en reconnaissance vocale et audio, où les phonèmes présentent des fréquences variables au fil du temps.
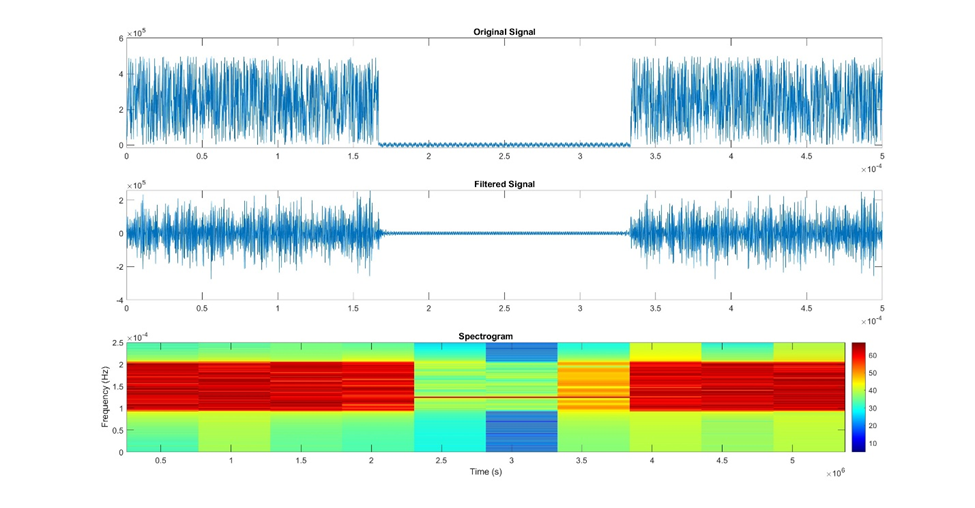
Figure 18 : Exemple de visualisation d’un signal sous forme de spectrogramme. Le signal initial a été filtré par passe-bande puis tracé en spectrogramme via une fonction Matlab par défaut.
Les applications du traitement du signal sont nombreuses et couvrent de multiples secteurs. Voici quelques usages majeurs en data science :
Le traitement du signal joue un rôle déterminant en finance, en permettant une analyse fine des séries financières.
En appliquant filtres, analyse de tendance et caractéristiques temporelles, les data scientists détectent motifs, tendances et anomalies dans les données boursières.
Des modèles de prévision servent à anticiper les tendances de marché, les cours et les risques. Ces estimations sont précieuses pour les investisseurs, traders et institutions afin de décider et piloter efficacement les portefeuilles.
Pour approfondir l’analytique financière, explorez le catalogue de cours DataCamp sur la finance ou ce cours Introduction to Financial Concepts in Python.
L’Internet des objets (IoT) génère d’énormes volumes de séries temporelles issues de capteurs et dispositifs variés.
Le traitement du signal aide à en extraire des informations exploitables. En analysant ces données, les data scientists surveillent l’état des équipements, détectent les anomalies et optimisent les performances.
Dans l’industrie 4.0, par exemple, ces techniques permettent d’anticiper des pannes et d’éviter les arrêts, améliorant la productivité et réduisant les coûts de maintenance.
DataCamp propose un excellent cours sur l’analyse des données IoT. À découvrir !
Le traitement du signal est utilisé en santé et en biomédical, où la surveillance continue des signaux physiologiques est essentielle au suivi des patients.
Sur des électrocardiogrammes (ECG) ou électroencéphalogrammes (EEG), ces techniques aident à détecter des anomalies, évaluer l’état des patients et contribuer au diagnostic et à la prise en charge.
Les analyses temporelles et fréquentielles mettent au jour des motifs cachés dans les signaux médicaux, faisant progresser la détection des maladies et la compréhension de la physiologie humaine.
Au-delà du soin, ces méthodes sont très utilisées en recherche biomédicale, par exemple pour analyser des données génomiques et d’autres signaux biologiques, avec des retombées sur les mécanismes de maladie, la découverte de médicaments et la médecine personnalisée.
Découvrez ce cours DataCamp sur l’analyse d’images biomédicales en Python qui mobilise certaines de ces techniques.
En traitement de la parole et de l’audio, les techniques de traitement du signal servent à analyser et interpréter le langage parlé et les signaux sonores.
Les systèmes de reconnaissance automatique de la parole (ASR), assistants vocaux et la détection d’émotions s’appuient sur des algorithmes qui extraient des caractéristiques pertinentes et reconnaissent des motifs de parole.
La réduction de bruit, l’amélioration audio et la synthèse vocale mobilisent elles aussi intensivement ces méthodes.
Si le sujet vous intéresse, DataCamp propose un cours sur le Spoken Language Processing in Python.
Le traitement du signal s’applique aussi à l’analyse d’images et de vidéos : reconnaissance d’images, détection d’objets, vidéosurveillance, etc.
Des techniques comme la transformée de Fourier servent à la compression et à l’extraction de caractéristiques. Les analyses temps–fréquence, comme les spectrogrammes, sont clés pour synchroniser audio et vidéo, permettant la lecture labiale ou la reconnaissance de gestes.
Pour en savoir plus sur le traitement d’images, je vous recommande ce cours sur DataCamp.
Le traitement du signal est au cœur de l’analyse des données de capteurs, utilisée en surveillance environnementale, prévision météo ou automatisation industrielle. Il aide à déceler motifs et tendances, et à mettre en place maintenance prédictive, détection d’anomalies et optimisation des systèmes.
Le traitement du signal intervient dans de nombreuses études scientifiques, des signaux de pression aux secousses sismiques, en passant par les tensions électriques. Ces techniques ont même permis d’identifier les sons produits par les ailes des colibris !
Le traitement du signal est puissant, mais pour obtenir des résultats fiables et pertinents, il faut respecter quelques bonnes pratiques. Voici l’essentiel pour réussir vos analyses.
Avant de plonger dans les techniques, un prétraitement et un nettoyage rigoureux s’imposent ! Gérez les valeurs manquantes, traitez les valeurs aberrantes et normalisez les données pour garantir cohérence et fiabilité. Les techniques de réduction du bruit, comme le filtrage, sont utiles pour écarter les perturbations qui biaisent l’analyse.
Les visualisations sont un levier très puissant en traitement du signal. Elles clarifient les motifs et permettent d’évaluer l’efficacité des techniques appliquées.
Nous vous recommandons vivement de visualiser vos données à chaque étape du prétraitement et de l’analyse.
Tracés temporels, spectres de fréquences et spectrogrammes font partie des incontournables.
Choisir les bonnes techniques de traitement du signal pour le bon problème
Le traitement du signal regroupe un large éventail de techniques, adaptées à des données et objectifs différents. Comprendre la nature des données et le but de l’analyse est essentiel pour faire les bons choix. Pour des séries temporelles, la transformée de Fourier et l’auto-corrélation aident à analyser fréquences et motifs. Pour des images, privilégiez des méthodes dédiées comme la détection de contours et l’extraction de caractéristiques.
Le traitement du signal est un pilier de la data science, qui permet d’extraire des insights exploitables à partir de données complexes dans de nombreux secteurs. De la finance à la santé, de la parole à l’image, l’analyse des signaux transforme des données brutes en décisions actionnables.
Les récents progrès en apprentissage automatique et en puissance de calcul ont accéléré l’émergence de techniques innovantes. Découvrez comment utiliser le machine learning avec vos données de signal dans un article dédié.
Traiter des signaux pour la première fois peut impressionner. Nous espérons que ce tutoriel vous a donné les clés pour isoler une empreinte vocale, détecter un séisme ou anticiper une hausse de cours.
Si cet article vous a intéressé, DataCamp propose plusieurs code-alongs à explorer. Voici un atelier sur l’analyse temporelle en Python, et une étude de cas sur l’analyse d’une série du fleuve Thames en Python. Il existe aussi des tutoriels séries temporelles en Python et sur tableurs.
Commencez à apprendre les sujets abordés dans ce tutoriel !
Cours
Cours
Cours