Cours
Software Development with Claude Code
4 h
9K
Un agent renvoie à chaque tour le même prompt système, les définitions d’outils et le contexte du dépôt. Le tarif qui pèse sur votre facture est donc la lecture de cache, pas le tarif d’entrée.
Fable 5.1 coûte 10 $ par million de tokens en entrée et 50 $ par million de tokens en sortie, inchangé par rapport à Fable 5. Les lectures de cache coûtent 0,25 $ par million, contre 1 $ auparavant, et les écritures de cache sur cinq minutes restent à 12,50 $ par million. Notre guide Claude Fable 5.1 présente la grille complète et les estimations d’économies d’Anthropic.
Lire un préfixe mis en cache coûte peu. L’écrire, non : c’est 50 fois le tarif de lecture, donc la boucle n’est rentable que si un préfixe est relu plusieurs fois. Plus loin, la ventilation des coûts montre ce que cela donne sur une exécution réelle et quelle catégorie a réellement dominé.
Le plafond de tokens vient du modèle, pas de votre budget. Fable 5.1 offre une fenêtre de contexte d’un million de tokens avec jusqu’à 128 K tokens de sortie par réponse, et max_tokens est une limite stricte couvrant à la fois la réflexion et le texte de réponse. À effort élevé, il faut de la marge pour les deux, c’est pourquoi la boucle d’agent ci‑dessous fixe 16 000 et non une valeur plus "ronde".
Quelques détails d’accès comptent avant d’écrire du code. Deux d’entre eux bloquent net vos requêtes :
Fable 5.1 exige une rétention des données de 30 jours et n’est pas disponible en rétention zéro, sauf autorisation d’Anthropic. Une requête depuis un espace de travail incompatible renvoie une 400 invalid_request_error sans autre indice.
Le modèle n’est pas pris en charge sur Priority Tier. Fable 5 l’est, ce qui piége parfois lors d’une migration.
La sortie texte de Fable 5.1 porte le filigrane texte d’Anthropic. Aucun token en plus et aucun changement côté requête.
Notre flux de travail se déroule en deux étapes :
Le projet d’exemple est une petite API JSON Flask pour enregistrer et rechercher des favoris, avec une factory d’app, trois blueprints, un module de configuration, des modèles et une suite pytest. J’utilise la limitation de débit (rate limiting) comme tâche fil rouge, car l’agent doit inspecter l’initialisation de l’app, les routes, la config et les tests avant de repérer les fichiers et tests requis. Le code complet et le projet d’exemple sont disponibles dans le dépôt GitHub.
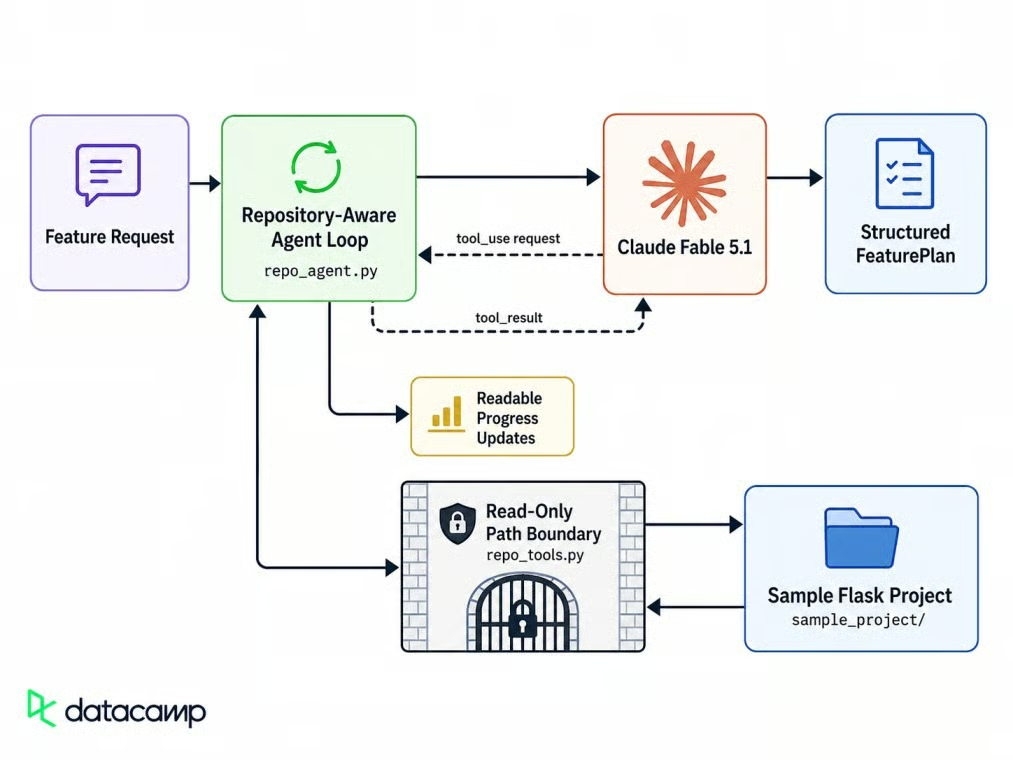
Les requêtes accèdent aux fichiers via une seule frontière. Image de l’auteur.
L’agent ne peut utiliser que trois outils : list_project_files, read_project_file et get_project_metadata. Claude n’accède jamais directement au système de fichiers. Il demande un chemin, et votre code décide si ce chemin est autorisé.
Commencez avec un environnement Python séparé et conservez la clé API sur le serveur.
Il vous faut Python 3.10 ou plus récent et une clé API Anthropic avec accès à claude-fable-5-1.
Pour créer une clé API, connectez‑vous à la Claude Console, ouvrez la page des clés API, cliquez sur Create key, puis copiez la clé. Donnez‑lui idéalement un nom qui rappelle son usage, choisissez une date d’expiration et stockez‑la en lieu sûr.
Créez un environnement virtuel et installez les paquets :
python -m venv .venv
source .venv/bin/activate          # macOS ou Linux
.venv\Scripts\Activate.ps1         # Windows PowerShell
pip install anthropic==1.3.0 pydantic fastapi uvicorn python-dotenv
Conservez le SDK figé, car les fonctions bêta évoluent fréquemment. Les mises à jour de progression nécessitent au moins 1.1.0, et les exemples utilisent 1.3.0.
Placez la clé dans un .env et ajoutez .env à .gitignore avant votre premier commit. Elle doit rester sur un serveur que vous contrôlez, jamais dans un navigateur ni dans un dépôt accessible. L’exposer peut permettre une utilisation non autorisée de l’API et générer des frais en entrée, sortie et opérations de cache.
ANTHROPIC_API_KEY=sk-ant-your-key-hereAvec cela en place, le client trouve la clé tout seul.
Envoyez la plus petite requête API possible avant de construire quoi que ce soit dessus.
Initialisez le client, envoyez un message utilisateur et affichez les métadonnées de la réponse :
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()

client = Anthropic()
MODEL = "claude-fable-5-1"

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}],
)

text = next((b.text for b in response.content if b.type == "text"), None)
print(text if text is not None else f"No text returned ({response.stop_reason})")
print(f"Model: {response.model}")
print(f"Stop reason: {response.stop_reason}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")
print(f"Request ID: {response._request_id}")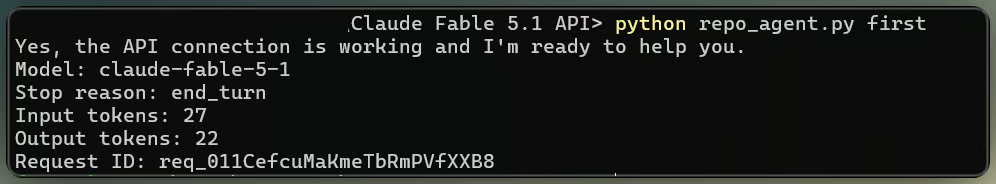
Le premier appel renvoie du texte et des métadonnées. Image de l’auteur.
L’appel next(...) sélectionne le premier bloc texte. La réflexion adaptative est toujours active et ne peut pas être désactivée, donc une réponse peut débuter par un bloc de réflexion ; envoyer thinking: {"type": "disabled"} renvoie une 400 au lieu de le couper. Si un bloc de réflexion arrive en premier, response.content[0].text lève une exception.
La solution consiste à filtrer par type de bloc au lieu de supposer une position fixe. Journalisez aussi response._request_id, car le support Anthropic l’utilise pour tracer une requête.
Voici la requête utilisée dans les exemples de planification et d’effort. Elle impose à l’agent d’inspecter plusieurs fichiers :
feature_request = (
    "Add rate limiting to the public API endpoints so one client cannot exhaust "
    "the search endpoint or brute force the token endpoint."
)
Gardez ce texte inchangé pendant la comparaison des niveaux d’effort et des comptes de tokens. Les résultats décriront ainsi les réglages API plutôt qu’un prompt différent.
Réglez l’effort via output_config. Il accepte low, medium, high, xhigh et max. La valeur par défaut API est high.
response = client.messages.create(
    model=MODEL,
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": feature_request}],
)
L’effort peut influer sur l’usage de tokens, le comportement des outils et la latence. J’ai exécuté la même demande de fonctionnalité trois fois à chacun de quatre niveaux d’effort ; le tableau présente les moyennes :
|
Effort |
Secondes |
Tokens de réflexion |
Tokens de sortie totaux |
Coût |
|---|---|---|---|---|
|
|
7,7 |
111 |
173 |
$0.0093 |
|
|
8,1 |
129 |
186 |
$0.0099 |
|
|
7,9 |
136 |
199 |
$0.0106 |
|
|
20,0 |
151 |
1 764 |
$0.0888 |
Les tokens de réflexion sont inclus dans les tokens de sortie totaux, ne les additionnez donc pas. Dans ces exécutions, low, medium et high sont restés proches en latence et en coût.
xhigh a pris deux fois et demie plus de temps, a produit près de neuf fois plus de tokens en sortie et a coûté huit fois plus.
À retenir : démarrez à high, descendez à medium pour les étapes routinières, et montez plus haut seulement si vos tests montrent un gain mesurable. À low effort, le modèle peut répondre de mémoire au lieu d’appeler un outil de recherche. Si un tour a besoin d’informations fraîches, dites‑le ou relevez le niveau.
Le prompt système définit le comportement de l’agent :
SYSTEM_PROMPT = """You are a senior engineer who turns feature requests into implementation plans for an existing codebase.

Stay inside the requested feature. Do not propose unrelated refactors, dependency upgrades, or style changes.

If a file or dependency you need does not exist, say so plainly instead of inventing it.

Write in plain sentences and do not use em dashes.

Finish with concrete guidance: what changes, where, in what order, what could break, and which tests to add."""
Les recommandations de prompt d’Anthropic soulignent que le modèle peut étendre la tâche ou s’arrêter trop tôt. Le prompt lui demande de rester dans le périmètre et de finir avec des consignes concrètes. Un schéma gérera plus tard le format de sortie.
Définissez le plan avec Pydantic pour que votre application puisse le valider et le transmettre à d’autres composants :
from pydantic import BaseModel, Field

class FeaturePlan(BaseModel):
    summary: str = Field(description="One or two sentences on what will be built.")
    implementation_steps: list[str]
    files_to_modify: list[str]
    risks: list[str]
    tests: list[str]

response = client.messages.parse(
    model=MODEL,
    max_tokens=8192,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}],
    output_format=FeaturePlan,
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details and response.stop_details.category
        else "unspecified"
    )
    print(f"Declined: {category}")
elif response.parsed_output is None:
    print(f"No plan. Stop reason: {response.stop_reason}")
else:
    print(response.parsed_output.summary)
messages.parse() convertit le modèle Pydantic en schéma JSON, l’envoie, valide la réponse et renvoie un objet typé dans parsed_output. Les sorties structurées sont généralement disponibles, sans en‑tête bêta. Vérifiez d’abord stop_reason car un refus, traité plus loin, contourne le schéma et ne laisse rien à analyser.
Ce résultat générique de l’introduction avait un mérite : il n’a nommé aucun fichier qu’il ne pouvait pas voir. Un schéma valide la structure, pas l’ancrage factuel.
Avant d’ajouter des outils, tenez compte des restrictions sur l’imposition d’outils, de la compatibilité des blocs de réflexion et de l’historique append‑only.
Fable 5.1 refuse l’imposition de choix d’outil. La section boucle d’outils ci‑dessous montre l’erreur et la configuration auto utilisée à la place.
Les blocs de réflexion ne sont compatibles que dans un sens. Fable 5.1 lit les blocs issus des modèles Claude précédents, mais aucun modèle antérieur ne peut lire les siens.
Quand un routeur ou un fallback déplace la conversation vers un modèle plus ancien, l’API supprime les blocs incompatibles avant que le modèle cible ne les reçoive. Le reste de l’historique est conservé, mais le modèle plus ancien doit planifier sans ces blocs.
Modifier des tours antérieurs invalide les blocs de réflexion qui suivent. Cela peut casser le découpage d’historique et la synthèse côté client.
Le guide de migration couvre l’ensemble des changements.
Donnez maintenant du contexte dépôt au modèle via des outils en lecture seule.
La couche outil comporte deux volets : les fonctions Python qui appliquent les règles d’accès et les schémas que Claude peut appeler.
Lecture seule ne signifie pas sûr par défaut. Un modèle peut demander ../../.env aussi facilement que config.py, donc la protection doit vivre dans votre code, pas votre prompt :
def _resolve(self, relative_path: str) -> Path:
    relative = Path(relative_path)
    if relative.is_absolute() or relative.drive:
        raise ToolError(f"path is outside the project root: {relative_path}")

    cursor = self.root
    for part in relative.parts:
        cursor /= part
        if cursor.is_symlink():
            raise ToolError(f"symlinks are not followed: {relative_path}")

    candidate = (self.root / relative).resolve()

    # After resolving "..", the path still has to sit under the allowed root.
    if candidate != self.root and self.root not in candidate.parents:
        raise ToolError(f"path is outside the project root: {relative_path}")
    if candidate.name in DENY_NAMES:
        raise ToolError(f"reading {candidate.name} is not allowed")

    return candidate
Rejetez les chemins absolus et les composants symlink, puis résolvez le chemin et confirmez qu’il reste sous la racine du projet. Demander ../.env renvoie « path is outside the project root. ». L’erreur d’outil renvoyée permet à l’agent de continuer avec les fichiers autorisés.
La classe de lecture contrôle ce que Python peut ouvrir. Claude a aussi besoin de schémas JSON décrivant les trois actions qu’il peut demander :
EMPTY_SCHEMA = {
    "type": "object",
    "properties": {},
    "additionalProperties": False,
}

TOOLS = [
    {
        "name": "list_project_files",
        "description": "List readable text files in the project.",
        "input_schema": EMPTY_SCHEMA,
        "strict": True,
    },
    {
        "name": "read_project_file",
        "description": "Read one text file relative to the project root.",
        "input_schema": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
            "additionalProperties": False,
        },
        "strict": True,
    },
    {
        "name": "get_project_metadata",
        "description": "Read project metadata and dependency manifests.",
        "input_schema": EMPTY_SCHEMA,
        "strict": True,
    },
]
strict vérifie les arguments quand le modèle choisit un outil. Cela ne force pas l’appel d’un outil, ce qui est important pour Fable 5.1.
Commencez par la boucle de base : envoyez les outils, inspectez stop_reason, exécutez ce qui est demandé, ajoutez les résultats et répétez.
MAX_AGENT_TURNS = 8
reader = ProjectReader("sample_project")
messages = [{"role": "user", "content": feature_request}]

for turn in range(1, MAX_AGENT_TURNS + 1):
    response = client.messages.create(
        model=MODEL,
        max_tokens=16000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        messages=messages,
    )

    if response.stop_reason == "refusal":
        return declined(response.stop_details.category)
    if response.stop_reason == "max_tokens":
        return cutoff()
    if response.stop_reason != "tool_use":
        messages.append({"role": "assistant", "content": response.content})
        break

    messages.append({"role": "assistant", "content": response.content})
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        output, is_error = reader.run(block.name, block.input)
        results.append({
            "type": "tool_result",
            "tool_use_id": block.id,
            "content": output,
            "is_error": is_error,
        })

    messages.append({"role": "user", "content": results})
else:
    return turn_limit()
MAX_AGENT_TURNS borne les requêtes du modèle, pas la dépense, donc appliquez une limite de coût distincte si besoin. La boucle gère refusal, max_tokens et tool_use directement ; les autres raisons d’arrêt mettent fin à l’inspection. Le champ is_error indique qu’un chemin a été refusé, pour que le modèle choisisse une autre action.
Avec Fable 5, vous pouviez forcer le premier appel avec tool_choice: {"type": "any"}. Fable 5.1 renvoie cette erreur avant exécution :
tool_choice: type "tool" and "any" are not supported for this model.Forcer des appels contournerait la réflexion toujours active. Laissez tool_choice sur auto, utilisez les schémas stricts ci‑dessus et nommez les outils dans le prompt quand une étape en nécessite un.
Fable 5.1 émet parfois un seul appel d’outil par tour, alors que Fable 5 en regroupait plusieurs. Cela ajoute des allers‑retours. Ajoutez cette ligne au prompt : « Demandez les fichiers indépendants au cours du même tour plutôt qu’un par tour. » Une exécution a regroupé neuf lectures de fichiers indépendantes, bien que le nombre varie.
Le streaming texte émet le contenu au fil de sa génération ; les mises à jour de progression couvrent les pauses entre appels d’outils.
Le projet complet utilise context_system() pour combiner SYSTEM_PROMPT et un résumé du projet avant de démarrer le flux :
with client.messages.stream(
    model=MODEL,
    max_tokens=8192,
    system=context_system(),
    messages=[{"role": "user", "content": feature_request}],
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)
    final = stream.get_final_message()

print(f"\nOutput tokens: {final.usage.output_tokens}")
get_final_message() vous donne le message assemblé avec l’usage et la raison d’arrêt une fois le flux terminé. Les chunks streamés ne contiennent pas forcément un JSON complet, donc attendez le message final avant de parser.
Le streaming texte ne couvre pas les délais pendant les appels d’outils. Fable 5.1 peut écrire de courtes mises à jour de progression avant les appels d’outils. Avec la valeur par défaut thinking.display à "omitted", les blocs de réflexion spécifiques à la progression sont vides, même si le modèle peut produire un amorçage texte normal.
Avec display: "updates" et l’en‑tête bêta thinking-display-updates-2026-08-18 , la documentation de l’API définit une mise à jour lisible comme un bloc thinking non vide, la réflexion demeurant cachée. Dans les exécutions réelles de ce projet, le champ thinking est resté vide et le statut lisible est arrivé sous forme de bloc text immédiatement avant tool_use. L’assistant vérifie donc les deux types de blocs, et la boucle ne l’appelle que sur les tours qui se terminent par tool_use :
PROGRESS_BETA = "thinking-display-updates-2026-08-18"

response = client.beta.messages.create(
    model=MODEL,
    max_tokens=16000,
    betas=[PROGRESS_BETA],
    thinking={"type": "adaptive", "display": "updates"},
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    messages=messages,
)

def status_lines(response) -> list[str]:
    lines = []
    for block in response.content:
        if block.type == "thinking":
            text = (block.thinking or "").strip()
        elif block.type == "text":
            text = (block.text or "").strip()
        else:
            continue
        if text:
            lines.append(text)
    return lines
Les messages de progression décrivent les fichiers que le modèle prévoit de lire : « Je vais lire le câblage de l’app, la config, les extensions, les routes publiques et auth, ainsi que les tests existants, car c’est là que s’accrocherait la limitation de débit. » Affichez ces messages et ignorez les blocs vides.
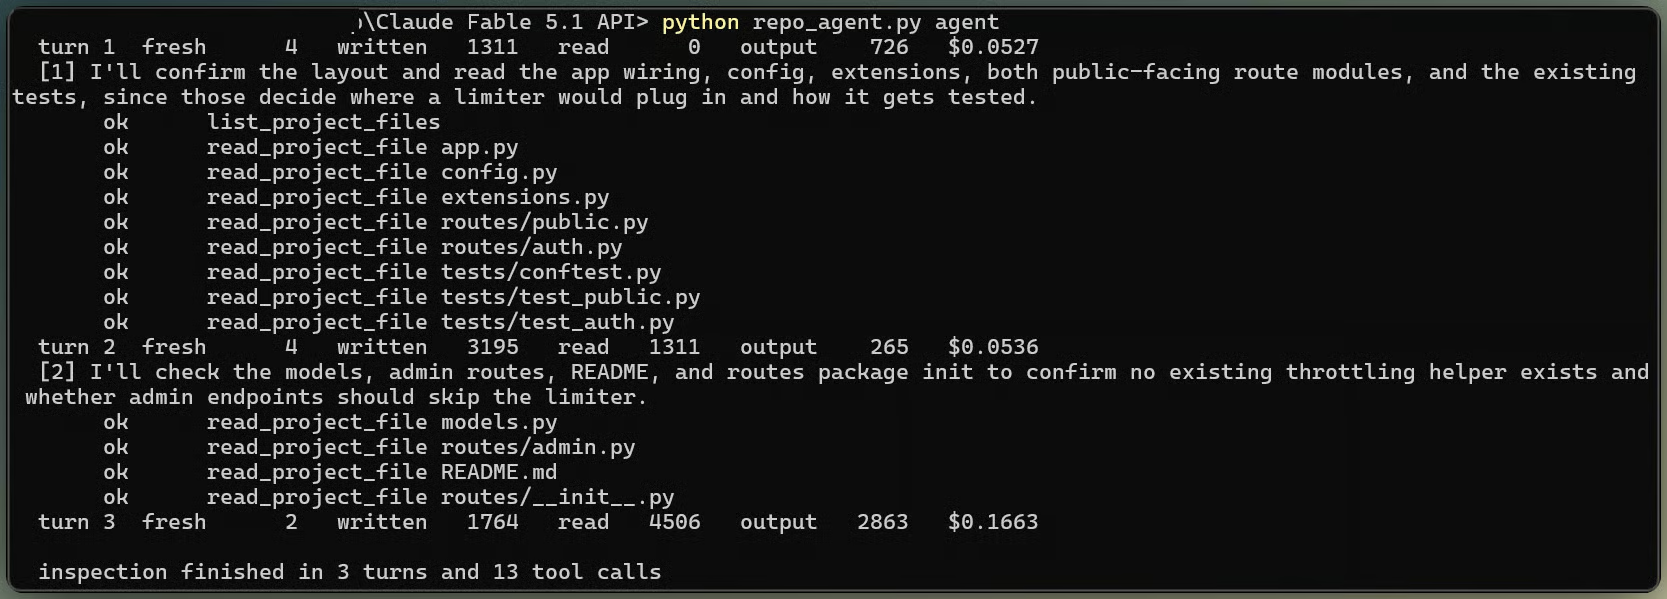
L’agent lit des fichiers tout en signalant sa progression. Image de l’auteur.
Fable 5.1 en écrit moins que Fable 5, surtout à effort élevé. Si votre interface exige des mises à jour régulières, demandez une phrase d’introduction, des messages de progression et un récapitulatif de clôture.
La prochaine fonction est très pratique. On le sait, l’agent de dépôt n’a pas besoin du même niveau de raisonnement à chaque tour.
Dans une boucle d’agent, baissez l’effort pour les tours de récupération routiniers et remontez‑le pour le tour final de planification.
Avec l’en‑tête bêta mid-conversation-output-config-2026-07-01 vous pouvez ajouter un message système qui ne change que le niveau d’effort :
EFFORT_BETA = "mid-conversation-output-config-2026-07-01"

messages.append({"role": "system", "content": [], "output_config": {"effort": "low"}})
messages.append({"role": "user", "content": "Summarize the repository evidence in five words."})

response = client.beta.messages.create(
    model=MODEL,
    max_tokens=4096,
    betas=[EFFORT_BETA],
    output_config={"effort": "high"},
    messages=messages,
)
Le nouveau niveau s’applique à partir du prochain tour utilisateur, pas en plein milieu du tour actuel, et il n’invalide pas le cache de prompt. Modifier output_config.effort au niveau de la requête invalide le cache.
L’agent garde le réglage global à high, ajoute une directive medium par message avant les récupérations routinières, puis une directive high avant le plan final. Un test jumeau a utilisé 18 tokens de sortie à effort inférieur contre 76 auparavant. Considérez‑le comme un exemple, pas une économie garantie.
Utilisez une instruction à portée d’un tour pour bloquer les lectures de fichiers supplémentaires pendant la planification finale.
Réglez clear_at: "next_user_message" sur un message système avec l’en‑tête bêta mid-conversation-system-clear-at-2026-08-21 . L’API traite son texte comme une instruction système pour le tour courant, puis cesse de l’afficher après le prochain message utilisateur. Il reste dans messages, donc l’historique antérieur ne change pas, le cache continue à correspondre et le message effacé ne coûte aucun token d’entrée.
SCOPED_SYSTEM_BETA = "mid-conversation-system-clear-at-2026-08-21"

messages.append({"role": "system", "content": [], "output_config": {"effort": "high"}})
messages.append({"role": "user", "content": "Write the implementation plan now."})
messages.append({
    "role": "system",
    "content": (
        "For this turn only: do not request more files. Base the plan on what "
        "you have already read, and name only paths you actually opened."
    ),
    "clear_at": "next_user_message",
})

response = client.beta.messages.create(
    model=MODEL,
    max_tokens=16000,
    betas=[EFFORT_BETA, SCOPED_SYSTEM_BETA],
    tool_choice={"type": "none"},
    output_config={"format": {"type": "json_schema", "schema": plan_schema()}},
    system=agent_system(),
    tools=TOOLS,
    messages=messages,
)
tool_choice={"type": "none"} empêche la requête finale d’appeler un autre outil. L’instruction à portée limitée contraint le plan aux fichiers déjà inspectés par l’agent. N’ajoutez pas un rappel à supprimer à la requête suivante : cette édition invaliderait les blocs de réflexion ultérieurs.
Une erreur The block is bound to a different conversation signifie que l’historique avant un bloc de réflexion a changé. Chaque bloc de réflexion Fable 5.1 est lié exactement au prompt système, aux définitions d’outils et aux messages qui le précèdent.
Le résultat dépend de la date de création de votre compte.
Les comptes créés le 31 août 2026 ou après reçoivent une 400 indiquant que le bloc est lié à une autre conversation.
Pour les comptes plus anciens, l’API enregistre l’écart mais n’agit dessus que si la requête définit thinking.block_binding.prefix_mismatch_behavior.
Vous pouvez le détecter avec l’en‑tête bêta thinking-binding-controls-2026-08-01, thinking.block_binding.prefix_mismatch_behavior réglé sur "drop_block", et le tableau input_transformations. Un historique édité apparaît avec reason: "prefix_binding_mismatch". Exécutez ce contrôle une fois sur votre intégration.
Les opérations suivantes déclenchent l’écart :
Éditer, réordonner ou supprimer un tour antérieur tout en conservant les suivants
Injecter du texte par requête dans un tour antérieur et le retirer à la requête suivante
Modifier le contenu ou l’ordre du prompt system global ou du tableau tools en cours de conversation
Servir des octets différents depuis l’URL d’une image ou d’un document lors d’une requête ultérieure
Chacune a un substitut qui préserve les liaisons :
Ajoutez des instructions avec des messages système en cours de conversation plutôt que d’éditer system.
Changez les outils avec des modifications d’outils en cours de conversation plutôt que de changer le tableau global.
Réduisez l’historique avec l’édition ou compaction de contexte côté serveur qui ne comptent pas comme des éditions.
Renvoyez les blocs de réflexion inchangés.
Déplacer les marqueurs cache_control et changer l’effort au niveau de la requête sont tous deux sûrs et n’invalident pas les liaisons des blocs de réflexion. En revanche, modifier l’effort global redémarre la mise en cache des prompts : préférez l’effort par message quand le préfixe mis en cache doit rester.
L’exécution suivante sépare les coûts d’entrée fraîche, d’écritures de cache, de lectures de cache et de sortie.
La mise en cache réduit le coût du contexte répété entre les tours. L’historique qui grandit déplace le point de rupture, donc la mise en cache automatique s’adapte mieux ici.
Un champ global cache_control déplace le point de rupture vers le dernier bloc cachable à chaque requête :
response = client.beta.messages.create(
    model=MODEL,
    cache_control={"type": "ephemeral"},
    system=system,
    tools=TOOLS,
    messages=messages,
    # Other request fields...
)
Un préfixe cachable inférieur à 512 tokens n’est pas mis en cache sur Fable 5.1, même marqué avec cache_control. L’API le traite normalement et renvoie zéro pour les deux compteurs de cache. Écrire un préfixe de 583 tokens a coûté 0,0073 $ ; le lire au tour suivant a coûté 0,00015 $. Le deuxième tour devait tout de même écrire sa nouvelle partie dans le cache, donc un hit de cache n’élimine pas tous les coûts d’entrée.
response.usage rapporte séparément l’entrée fraîche, la création de cache, les lectures de cache et la sortie. Tarifiez ces quatre compteurs individuellement ; additionner seulement l’entrée et la sortie masque le coût d’écriture de cache et surestime le prix des hits de cache.
Voici la ventilation des coûts d’une exécution complète qui a lu 12 fichiers sur trois tours et produit un plan :
|
Poste |
Tokens |
Coût estimé |
Part |
|---|---|---|---|
|
Sortie |
5 713 |
$0.2857 |
59,4 % |
|
Écritures de cache |
15 426 |
$0.1928 |
40,1 % |
|
Entrée fraîche |
50 |
$0.0005 |
0,1 % |
|
Lectures de cache |
6 549 |
$0.0016 |
0,3 % |
|
Total |
27 738 |
$0.4806 |
100 % |
Les lectures de cache représentaient moins d’un demi‑pourcent de cette estimation. Au tarif ancien de Fable 5, l’exécution aurait coûté environ 0,4855 $ au lieu de 0,4806 $. Les économies grandissent quand chaque tour réutilise bien plus de contexte.
Dans cette exécution, la sortie a généré près de 60 % du coût estimé, et les écritures de cache environ 40 %. Au tarif cinq minutes utilisé ici, un token d’écriture de cache coûte 50 fois un token de lecture de cache. À une heure, un token d’écriture coûte 80 fois celui d’une lecture.
Un refus et une requête échouée nécessitent des comportements applicatifs différents.
Un refus avant la sortie arrive en HTTP 200 avec stop_reason: "refusal", contenu vide et stop_details. Sa catégorie peut être nulle. Un refus plus tard dans un flux peut suivre une sortie partielle, que l’application doit ignorer. Un try/except autour de l’appel ne captera aucun des deux cas.
response = client.messages.create(model=MODEL, max_tokens=8192, messages=messages)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details and response.stop_details.category
        else "unspecified"
    )
    return f"This request was declined ({category})."
Traitez‑le comme un état applicatif. Si une requête autorisée est floue, réécrivez‑la plus précisément. N’implémentez pas de logique de retry visant à contourner le classifieur.
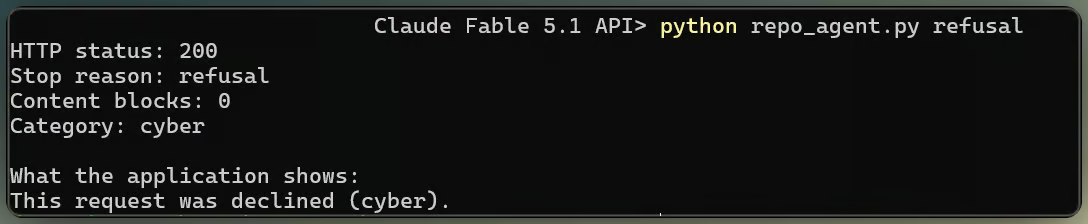
Un refus arrive en HTTP 200. Image de l’auteur.
Le fallback côté serveur peut réessayer une requête refusée sur un autre modèle, via fallbacks: "default" avec l’en‑tête bêta server-side-fallback-2026-07-01 . Les cibles autorisées pour Fable 5.1 sont Opus 4.8 et Opus 5.
Le fallback par défaut ne s’exécute que lorsque la catégorie de refus a une cible recommandée. Un refus testé reasoning_extraction n’a pas déclenché de fallback ; inspectez usage.iterations plutôt que de supposer que chaque refus sera retenté. Comme mentionné plus haut, passer à un modèle plus ancien supprime aussi les blocs de réflexion Fable 5.1.
L’agent local peut maintenant proposer le même workflow via une API HTTP.
Si vous n’avez besoin que d’un script local, ignorez cette section. Pour un service web, utilisez FastAPI avec AsyncAnthropic. Créez un client unique pour le processus dans un gestionnaire de cycle de vie. Importez le schéma et les prompts du module d’agent existant.
@asynccontextmanager
async def lifespan(_: FastAPI):
    global client
    client = AsyncAnthropic()
    try:
        yield
    finally:
        await client.close()


@app.post("/plan", response_model=PlanResponse)
async def create_plan(body: PlanRequest):
    reader = resolve_project(body.project)
    messages, totals, turns, tool_calls = await inspect(reader, body.feature_request)
    plan, final_usage = await write_plan(messages)
    totals.add(final_usage)
    return PlanResponse(plan=plan, turns=turns, tool_calls=tool_calls, usage=as_usage(totals))
Notez que l’appelant envoie un nom de projet, pas un chemin. resolve_project() le fait correspondre à un petit ensemble de racines autorisées, empêchant une lecture arbitraire sur le serveur. Ce service mappe les refus en 422 par choix applicatif. L’API Claude les renvoie, elle, en HTTP 200.
Lancez‑le avec uvicorn app:app --reload. La documentation interactive est disponible sur http://localhost:8000/docs.
Apprenez l’IA avec DataCamp !
Cours
Cours
Cursus
blog
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Stephen Gruppetta
12 min
Tutoriel
Satyabrata Pal
15 min
Tutoriel
Sejal Jaiswal
9 min