Cours
Introduction à la visualisation de données avec Matplotlib
4 h
234.9K
Dans ce guide pas à pas, nous verrons ce qu’est un diagramme de Gantt, pourquoi et quand ces visualisations sont utiles, comment créer un diagramme de Gantt en Python avec matplotlib, et comment le personnaliser. Au passage, nous construirons quelques exemples de diagrammes de Gantt avec matplotlib.
Un diagramme de Gantt est un type d’histogramme (barres) utilisé pour représenter un planning de projet complet et son pilotage. Il affiche généralement les éléments suivants : le nom des tâches, leurs dates de début et de fin, les équipes en charge, l’avancement de la tâche en pourcentage ou en fraction, la performance par équipe, ainsi que les jalons clés du projet.
Les noms des tâches sont disposés sur l’axe des ordonnées (y), le plus souvent triés par date de début, dans l’ordre chronologique de haut en bas. L’axe des abscisses (x) représente quant à lui le temps, la largeur de chaque barre correspondant à la durée d’exécution de la tâche.
Puisqu’un diagramme de Gantt n’est, au fond, qu’une variante d’un histogramme horizontal, on peut le créer avec de nombreuses bibliothèques de visualisation Python, notamment matplotlib, Plotly, Bokeh et Altair. Dans ce tutoriel, nous nous concentrerons sur matplotlib, la plus utilisée.
Si vous souhaitez explorer d’autres façons de créer un diagramme de Gantt et d’autres types de graphiques en Python, découvrez le cours Introduction to Data Visualization with Plotly in Python. Pour réviser ou développer vos compétences matplotlib, ces cours vous seront utiles : Introduction to Data Visualization with Matplotlib et Python for MATLAB Users.
Commençons par construire un diagramme de Gantt basique avec matplotlib à l’aide de la méthode barh() de matplotlib.pyplot.
Nous devons d’abord importer les bibliothèques nécessaires :
import pandas as pd
import numpy as np
import matplotlib
import matplotlib.pyplot as plt
import datetime as dt
Ensuite, créons des données factices pour travailler :
df = pd.DataFrame({'task': ['A', 'B', 'C', 'D', 'E', 'F', 'G', 'H', 'I', 'J', 'K', 'L'],
                  'team': ['R&D', 'Accounting', 'Sales', 'Sales', 'IT', 'R&D', 'IT', 'Sales', 'Accounting', 'Accounting', 'Sales', 'IT'],
                  'start': pd.to_datetime(['20 Oct 2022', '24 Oct 2022', '26 Oct 2022', '31 Oct 2022', '3 Nov 2022', '7 Nov 2022', '10 Nov 2022', '14 Nov 2022', '18 Nov 2022', '23 Nov 2022', '28 Nov 2022', '30 Nov 2022']),
                  'end': pd.to_datetime(['31 Oct 2022', '28 Oct 2022', '31 Oct 2022', '8 Nov 2022', '9 Nov 2022', '18 Nov 2022', '17 Nov 2022', '22 Nov 2022', '23 Nov 2022', '1 Dec 2022', '5 Dec 2022', '5 Dec 2022']),
                  'completion_frac': [1, 1, 1, 1, 1, 0.95, 0.7, 0.35, 0.1, 0, 0, 0]})
print(df)
Sortie :
  task        team      start        end  completion_frac
0     A         R&D 2022-10-20 2022-10-31             1.00
1     B  Accounting 2022-10-24 2022-10-28             1.00
2     C       Sales 2022-10-26 2022-10-31             1.00
3     D       Sales 2022-10-31 2022-11-08             1.00
4     E          IT 2022-11-03 2022-11-09             1.00
5     F         R&D 2022-11-07 2022-11-18             0.95
6     G          IT 2022-11-10 2022-11-17             0.70
7     H       Sales 2022-11-14 2022-11-22             0.35
8     I  Accounting 2022-11-18 2022-11-23             0.10
9     J  Accounting 2022-11-23 2022-12-01             0.00
10    K       Sales 2022-11-28 2022-12-05             0.00
11    L          IT 2022-11-30 2022-12-05             0.00
Pour faciliter la construction d’un diagramme de Gantt avec ces données, calculons quatre colonnes supplémentaires représentant les informations suivantes :
df['days_to_start'] = (df['start'] - df['start'].min()).dt.daysdf['days_to_end'] = (df['end'] - df['start'].min()).dt.daysdf['task_duration'] = df['days_to_end'] - df['days_to_start'] + 1 # inclure aussi la date de findf['completion_days'] = df['completion_frac'] * df['task_duration']Vérifions le résultat :
print(df)Sortie :
  task        team      start        end  completion_frac  days_to_start  \
0     A         R&D 2022-10-20 2022-10-31             1.00              0
1     B  Accounting 2022-10-24 2022-10-28             1.00              4
2     C       Sales 2022-10-26 2022-10-31             1.00              6
3     D       Sales 2022-10-31 2022-11-08             1.00             11
4     E          IT 2022-11-03 2022-11-09             1.00             14
5     F         R&D 2022-11-07 2022-11-18             0.95             18
6     G          IT 2022-11-10 2022-11-17             0.70             21
7     H       Sales 2022-11-14 2022-11-22             0.35             25
8     I  Accounting 2022-11-18 2022-11-23             0.10             29
9     J  Accounting 2022-11-23 2022-12-01             0.00             34
10    K       Sales 2022-11-28 2022-12-05             0.00             39
11    L          IT 2022-11-30 2022-12-05             0.00             41

    days_to_end  task_duration  completion_days
0            11             12            12.00
1             8              5             5.00
2            11              6             6.00
3            19              9             9.00
4            20              7             7.00
5            29             12            11.40
6            28              8             5.60
7            33              9             3.15
8            34              6             0.60
9            42              9             0.00
10           46              8             0.00
11           46              6             0.00
Nous sommes maintenant prêts à générer un diagramme de Gantt basique avec matplotlib :
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'])
plt.show()
Sortie :
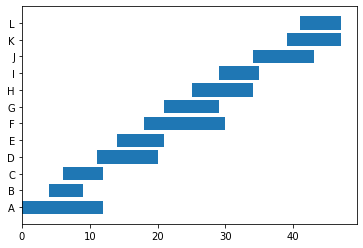
Ce graphique nécessite plusieurs ajustements pour en tirer un maximum d’informations :
Nous allons implémenter ces améliorations dans un instant. Avant cela, voyons comment gérer la création d’un diagramme de Gantt basique.
broken_barh()Lorsque certaines tâches comportent plusieurs sous-tâches réparties dans le temps, il est préférable d’utiliser une autre méthode matplotlib : broken_barh().
Pour disposer de données factices et tester cette approche, procédons ainsi :
completion_frac).start et end en start_1 et end_1 (par commodité).# 1
df2 = df[df['team']=='Sales'][['task', 'team', 'start', 'end']]
# 2
df2.rename(columns={'start': 'start_1', 'end': 'end_1'}, inplace=True)
df2.reset_index(drop=True, inplace=True)
# 3
df2['start_2'] = pd.to_datetime([None, '10 Nov 2022', '25 Nov 2022', None])
df2['end_2'] = pd.to_datetime([None, '14 Nov 2022', '28 Nov 2022', None])
df2['start_3'] = pd.to_datetime([None, None, '1 Dec 2022', None])
df2['end_3'] = pd.to_datetime([None, None, '5 Dec 2022', None])
# 4
for i in [1, 2, 3]:
suffix = '_' + str(i)
df2['days_to_start' + suffix] = (df2['start' + suffix] - df2['start_1'].min()).dt.days
df2['days_to_end' + suffix] = (df2['end' + suffix] - df2['start_1'].min()).dt.days
df2['task_duration' + suffix] = df2['days_to_end' + suffix] - df2['days_to_start' + suffix] + 1
print(df2)Sortie :
task   team    start_1      end_1    start_2      end_2    start_3  \
0    C  Sales 2022-10-26 2022-10-31        NaT        NaT        NaT
1    D  Sales 2022-10-31 2022-11-08 2022-11-10 2022-11-14        NaT
2    H  Sales 2022-11-14 2022-11-22 2022-11-25 2022-11-28 2022-12-01
3    K  Sales 2022-11-28 2022-12-05        NaT        NaT        NaT

      end_3  days_to_start_1  days_to_end_1  task_duration_1  \
0        NaT                0              5                6
1        NaT                5             13                9
2 2022-12-05               19             27                9
3        NaT               33             40                8

  days_to_start_2  days_to_end_2  task_duration_2  days_to_start_3  \
0              NaN            NaN              NaN              NaN
1             15.0           19.0              5.0              NaN
2             30.0           33.0              4.0             36.0
3              NaN            NaN              NaN              NaN

  days_to_end_3  task_duration_3
0            NaN              NaN
1            NaN              NaN
2           40.0              5.0
3            NaN              NaN
Notez que la tâche D comporte désormais deux sous-tâches, la tâche H en a trois, et les tâches C et K ont chacune une sous-tâche. Les tâches D et H sont donc celles pour lesquelles nous allons utiliser la méthode broken_barh(). Sa syntaxe étant un peu moins intuitive que celle de barh(), passons en revue ses paramètres principaux. Les paramètres obligatoires de broken_barh() sont :
xranges : une séquence de tuples au format (xmin, xwidth) indiquant le début et l’étendue de chaque barre. Chaque barre représente une sous-tâche : ce paramètre encode donc la date de début et la durée de chaque sous-tâche.yrange : un tuple au format (ymin, yheight) indiquant la position en y et la hauteur de chaque barre.Traçons maintenant notre diagramme de Gantt « morcelé ». L’algorithme est le suivant :
barh() comme précédemment.broken_barh().broken_barh().# 1
fig, ax = plt.subplots()
# 2
for index, row in df2.iterrows():
if row['start_2'] is None:
ax.barh(y=df2['task'], width=df2['task_duration_1'], left=df2['days_to_start_1'])
elif row['start_2'] is not None and row['start_3'] is None:
ax.broken_barh(xranges=[(row['days_to_start_1'], row['task_duration_1']), (row['days_to_start_2'], row['task_duration_2'])], yrange=(index + 1, 0.5))
else:
ax.broken_barh(xranges=[(row['days_to_start_1'], row['task_duration_1']), (row['days_to_start_2'], row['task_duration_2']), (row['days_to_start_3'], row['task_duration_3'])], yrange=(index + 1, 0.5))
# 3
ax.set_yticks([1.25, 2.25, 3.25, 4.25])
ax.set_yticklabels(df2['task'])
plt.show()Sortie :
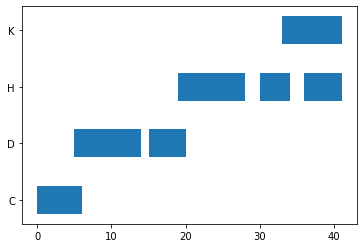
Dans le code ci-dessus, on peut aussi utiliser broken_barh() pour tracer les barres des tâches à une seule sous-tâche. Il suffit de remplacer cette ligne :
ax.barh(y=df2['task'], width=df2['task_duration_1'], left=df2['days_to_start_1'])par celle-ci :
ax.broken_barh(xranges=[(row['days_to_start_1'], row['task_duration_1'])], yrange=(index + 1, 0.5))Cette approche rend aussi le code plus homogène et plus lisible.
Revenons à notre dataframe initial :
print(df)Sortie :
  task        team      start        end  completion_frac  days_to_start  \
0     A         R&D 2022-10-20 2022-10-31             1.00              0
1     B  Accounting 2022-10-24 2022-10-28             1.00              4
2     C       Sales 2022-10-26 2022-10-31             1.00              6
3     D       Sales 2022-10-31 2022-11-08             1.00             11
4     E          IT 2022-11-03 2022-11-09             1.00             14
5     F         R&D 2022-11-07 2022-11-18             0.95             18
6     G          IT 2022-11-10 2022-11-17             0.70             21
7     H       Sales 2022-11-14 2022-11-22             0.35             25
8     I  Accounting 2022-11-18 2022-11-23             0.10             29
9     J  Accounting 2022-11-23 2022-12-01             0.00             34
10    K       Sales 2022-11-28 2022-12-05             0.00             39
11    L          IT 2022-11-30 2022-12-05             0.00             41

    days_to_end  task_duration  completion_days
0            11             12            12.00
1             8              5             5.00
2            11              6             6.00
3            19              9             9.00
4            20              7             7.00
5            29             12            11.40
6            28              8             5.60
7            33              9             3.15
8            34              6             0.60
9            42              9             0.00
10           46              8             0.00
11           46              6             0.00
et à notre premier diagramme de Gantt :
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'])
plt.show()
Sortie :
Nous souhaitons maintenant personnaliser ce graphique pour le rendre plus parlant.
Pour aller plus loin dans la personnalisation avec matplotlib, consultez : Matplotlib Tutorial: Python Plotting et Matplotlib Cheat Sheet: Plotting in Python.
Ils incluent :
Un titre explicite est indispensable pour tout graphique, y compris un diagramme de Gantt. Supposons que notre projet s’appelle Project X :
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'])
plt.title('Project Management Schedule of Project X', fontsize=15)
plt.show()
Sortie :
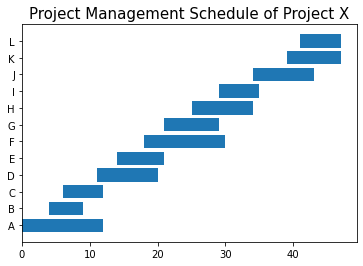
À cette étape, nous allons reprendre le code précédent et réaliser les actions suivantes :
ax.# 1
fig, ax = plt.subplots()
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'] + 1)
plt.title('Project Management Schedule of Project X', fontsize=15)
# 2
plt.gca().invert_yaxis()
# 3
xticks = np.arange(5, df['days_to_end'].max() + 2, 7)
# 4
xticklabels = pd.date_range(start=df['start'].min() + dt.timedelta(days=4), end=df['end'].max()).strftime("%d/%m")
# 5
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
# 6
ax.xaxis.grid(True, alpha=0.5)
plt.show()Sortie :
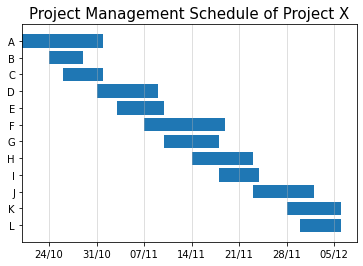
Si vous souhaitez pratiquer davantage pour lire et écrire du code Python aisément, notre cours Intermediate Python est une bonne base de référence.
Colorons maintenant chaque barre (chaque tâche) selon l’équipe à laquelle elle est affectée. Pour cela, nous allons :
# 1
team_colors = {'R&D': 'c', 'Accounting': 'm', 'Sales': 'y', 'IT': 'b'}

# 2
fig, ax = plt.subplots()

# 3
for index, row in df.iterrows():
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']])

# 4
plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)
plt.show()
Sortie :
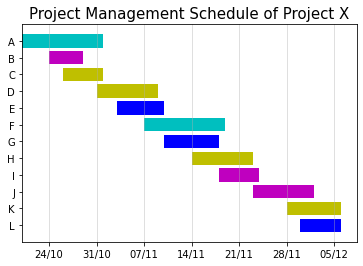
Il manque une légende indiquant quelle couleur correspond à quelle équipe. Pour y remédier, créons des « patches » — des objets 2D matplotlib remplis d’une couleur prédéfinie. Nous utiliserons la classe matplotlib.patches.Patch pour générer une liste de patches, un par équipe, avec la couleur appropriée :
patches = []
for team in team_colors:
    patches.append(matplotlib.patches.Patch(color=team_colors[team]))
Nous pouvons maintenant ajouter la légende au graphique :
fig, ax = plt.subplots()
for index, row in df.iterrows():
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']])
plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)

# Adding a legend
ax.legend(handles=patches, labels=team_colors.keys(), fontsize=11)

plt.show()
Sortie :
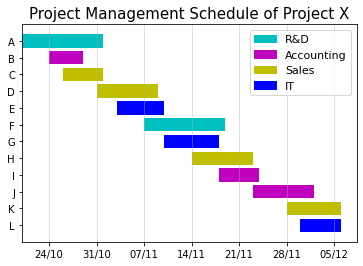
Le diagramme de Gantt ci-dessus est nettement plus informatif.
Vous trouverez d’autres techniques pour améliorer l’esthétique et la lisibilité des graphiques dans le cours Improving Your Data Visualizations in Python.
Jusqu’ici, nous n’avons pas utilisé la colonne completion_days calculée au début. Utilisons-la maintenant pour rendre le diagramme plus instructif en affichant le niveau d’avancement de chaque tâche.
Techniquement, nous allons superposer une seconde barre sur chacune des barres existantes. La barre inférieure représentera la durée totale de la tâche (jours alloués), tandis que la barre supérieure correspondra au statut d’avancement (jours réalisés/alloués).
Pour chaque tâche, les deux barres auront la même couleur (celle de l’équipe), mais la barre inférieure sera plus claire afin de distinguer visuellement les deux.
Autrement dit, si une équipe surperforme sur une tâche, la combinaison des deux barres indiquera qu’elle a déjà travaillé plus de jours que prévu sur cette tâche (signe d’une probable finalisation avant la date limite).
À l’inverse, si une équipe sous-performe, la combinaison des barres montrera qu’elle a travaillé moins de jours que prévu (la tâche risque d’être finalisée après l’échéance).
fig, ax = plt.subplots()

for index, row in df.iterrows():

    # Adding a lower bar - for the overall task duration
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']], alpha=0.4)

    # Adding an upper bar - for the status of completion
    plt.barh(y=row['task'], width=row['completion_days'], left=row['days_to_start'] + 1, color=team_colors[row['team']])

plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)
ax.legend(handles=patches, labels=team_colors.keys(), fontsize=11)
plt.show()
Sortie :
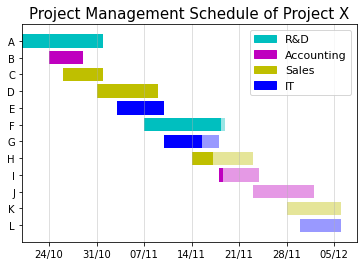
On voit que les équipes n’avancent pas toutes au même rythme, ce qui est courant dans les projets réels. Pour en tirer davantage d’enseignements, supposons que la date du jour est le 17 novembre 2022 et marquons-la sur le graphique :
fig, ax = plt.subplots()
for index, row in df.iterrows():
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']], alpha=0.4)
    plt.barh(y=row['task'], width=row['completion_days'], left=row['days_to_start'] + 1, color=team_colors[row['team']])

plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)
ax.legend(handles=patches, labels=team_colors.keys(), fontsize=11)

# Marking the current date on the chart
ax.axvline(x=29, color='r', linestyle='dashed')
ax.text(x=29.5, y=11.5, s='17/11', color='r')

plt.show()
Sortie :
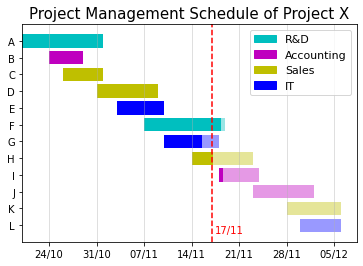
On peut tirer les observations suivantes sur l’état actuel de Project X :
Ces constats aident les leads et le chef de projet à ajuster le planning et à allouer les ressources nécessaires au bon moment pour éviter les retards sur les livrables.
On peut enrichir davantage notre diagramme de Gantt matplotlib. Par exemple :
Veillez toutefois à garder le diagramme lisible et à éviter de le surcharger. Comme pour toute visualisation, il s’agit de trouver le bon équilibre entre richesse d’information, lisibilité du graphique et clarté du code qui le génère.
Pour résumer, dans ce tutoriel, nous avons exploré :
Nous avons également parcouru différents exemples et les étapes pour les construire.
Pour une approche plus complète de la création de graphiques percutants et informatifs en Python, découvrez notre parcours de compétences Data Visualization with Python.
Cours de visualisation de données
Cours
Cours
Cours