Kurs
Einführung in die Datenvisualisierung mit Matplotlib
4 Std.
234.8K
In dieser Schritt-für-Schritt-Anleitung schauen wir uns an, was ein Gantt‑Diagramm ist, warum und wann sich solche Visualisierungen lohnen, wie du in Python mit matplotlib ein Gantt‑Diagramm erstellst und wie du es weiter anpasst. Unterwegs bauen wir mehrere Gantt‑Diagramm‑Beispiele in matplotlib.
Ein Gantt‑Diagramm ist eine spezielle Form eines Balkendiagramms, mit dem sich ein vollständiger Plan für Projektplanung und ‑steuerung abbilden lässt. Üblicherweise zeigt es Aufgabenbezeichnungen, Start- und Enddaten, die zugeordneten Teams, den Fertigstellungsgrad in Prozent oder als Bruchteil, die Performance je Team sowie wichtige Meilensteine.
Die Aufgabennamen stehen entlang der y‑Achse und sind meist nach Startdatum chronologisch von oben nach unten sortiert. Die x‑Achse zeigt Zeiträume; die Breite jedes Balkens entspricht der Dauer der jeweiligen Aufgabe.
Da ein Gantt‑Diagramm im Kern ein horizontales Balkendiagramm ist, können wir es in vielen Python‑Bibliotheken für Datenvisualisierung erstellen, etwa in matplotlib, Plotly, Bokeh und Altair. In diesem Tutorial konzentrieren wir uns auf die Erstellung mit der populärsten Bibliothek – matplotlib.
Wenn du alternative Wege zur Erstellung eines Gantt‑Diagramms und anderer Diagrammtypen in Python kennenlernen möchtest, schau dir den Kurs Introduction to Data Visualization with Plotly in Python an. Möchtest du deine matplotlib‑Kompetenzen auffrischen oder ausbauen, helfen dir diese Kurse: Introduction to Data Visualization with Matplotlib und Python for MATLAB Users.
Starten wir mit einem einfachen Gantt‑Diagramm in matplotlib über die Methode barh() von matplotlib.pyplot.
Zuerst laden wir die benötigten Bibliotheken:
import pandas as pd
import numpy as np
import matplotlib
import matplotlib.pyplot as plt
import datetime as dt
Als Nächstes erstellen wir Beispieldaten:
df = pd.DataFrame({'task': ['A', 'B', 'C', 'D', 'E', 'F', 'G', 'H', 'I', 'J', 'K', 'L'],
                  'team': ['R&D', 'Accounting', 'Sales', 'Sales', 'IT', 'R&D', 'IT', 'Sales', 'Accounting', 'Accounting', 'Sales', 'IT'],
                  'start': pd.to_datetime(['20 Oct 2022', '24 Oct 2022', '26 Oct 2022', '31 Oct 2022', '3 Nov 2022', '7 Nov 2022', '10 Nov 2022', '14 Nov 2022', '18 Nov 2022', '23 Nov 2022', '28 Nov 2022', '30 Nov 2022']),
                  'end': pd.to_datetime(['31 Oct 2022', '28 Oct 2022', '31 Oct 2022', '8 Nov 2022', '9 Nov 2022', '18 Nov 2022', '17 Nov 2022', '22 Nov 2022', '23 Nov 2022', '1 Dec 2022', '5 Dec 2022', '5 Dec 2022']),
                  'completion_frac': [1, 1, 1, 1, 1, 0.95, 0.7, 0.35, 0.1, 0, 0, 0]})
print(df)
Ausgabe:
  task        team      start        end  completion_frac
0     A         R&D 2022-10-20 2022-10-31             1.00
1     B  Accounting 2022-10-24 2022-10-28             1.00
2     C       Sales 2022-10-26 2022-10-31             1.00
3     D       Sales 2022-10-31 2022-11-08             1.00
4     E          IT 2022-11-03 2022-11-09             1.00
5     F         R&D 2022-11-07 2022-11-18             0.95
6     G          IT 2022-11-10 2022-11-17             0.70
7     H       Sales 2022-11-14 2022-11-22             0.35
8     I  Accounting 2022-11-18 2022-11-23             0.10
9     J  Accounting 2022-11-23 2022-12-01             0.00
10    K       Sales 2022-11-28 2022-12-05             0.00
11    L          IT 2022-11-30 2022-12-05             0.00
Um das Gantt‑Diagramm einfacher zu erstellen, berechnen wir vier zusätzliche Spalten, die Folgendes abbilden:
df['days_to_start'] = (df['start'] - df['start'].min()).dt.daysdf['days_to_end'] = (df['end'] - df['start'].min()).dt.daysdf['task_duration'] = df['days_to_end'] - df['days_to_start'] + 1 # auch das Enddatum einschließendf['completion_days'] = df['completion_frac'] * df['task_duration']Prüfen wir das Ergebnis:
print(df)Ausgabe:
  task        team      start        end  completion_frac  days_to_start  \
0     A         R&D 2022-10-20 2022-10-31             1.00              0
1     B  Accounting 2022-10-24 2022-10-28             1.00              4
2     C       Sales 2022-10-26 2022-10-31             1.00              6
3     D       Sales 2022-10-31 2022-11-08             1.00             11
4     E          IT 2022-11-03 2022-11-09             1.00             14
5     F         R&D 2022-11-07 2022-11-18             0.95             18
6     G          IT 2022-11-10 2022-11-17             0.70             21
7     H       Sales 2022-11-14 2022-11-22             0.35             25
8     I  Accounting 2022-11-18 2022-11-23             0.10             29
9     J  Accounting 2022-11-23 2022-12-01             0.00             34
10    K       Sales 2022-11-28 2022-12-05             0.00             39
11    L          IT 2022-11-30 2022-12-05             0.00             41

    days_to_end  task_duration  completion_days
0            11             12            12.00
1             8              5             5.00
2            11              6             6.00
3            19              9             9.00
4            20              7             7.00
5            29             12            11.40
6            28              8             5.60
7            33              9             3.15
8            34              6             0.60
9            42              9             0.00
10           46              8             0.00
11           46              6             0.00
Jetzt können wir ein grundlegendes Gantt‑Diagramm in matplotlib erzeugen:
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'])
plt.show()
Ausgabe:
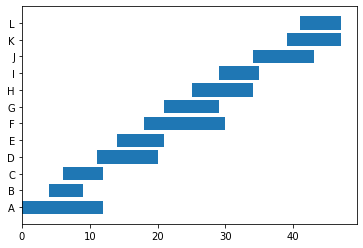
Diese Grafik braucht noch einige Anpassungen, damit wir maximalen Informationsgehalt herausholen:
Diese Verfeinerungen setzen wir gleich um. Zuvor schauen wir uns jedoch eine Alternative für das grundlegende Diagramm an.
broken_barh()Wenn einige Aufgaben zwei oder mehr Teilaufgaben über die Zeit verteilt enthalten, sollten wir die Methode broken_barh() nutzen.
Um Beispielsdaten für diesen Ansatz zu haben, machen wir Folgendes:
completion_frac ignorieren wir zunächst).start und end der Einfachheit halber in start_1 und end_1 um.# 1
df2 = df[df['team']=='Sales'][['task', 'team', 'start', 'end']]
# 2
df2.rename(columns={'start': 'start_1', 'end': 'end_1'}, inplace=True)
df2.reset_index(drop=True, inplace=True)
# 3
df2['start_2'] = pd.to_datetime([None, '10 Nov 2022', '25 Nov 2022', None])
df2['end_2'] = pd.to_datetime([None, '14 Nov 2022', '28 Nov 2022', None])
df2['start_3'] = pd.to_datetime([None, None, '1 Dec 2022', None])
df2['end_3'] = pd.to_datetime([None, None, '5 Dec 2022', None])
# 4
for i in [1, 2, 3]:
suffix = '_' + str(i)
df2['days_to_start' + suffix] = (df2['start' + suffix] - df2['start_1'].min()).dt.days
df2['days_to_end' + suffix] = (df2['end' + suffix] - df2['start_1'].min()).dt.days
df2['task_duration' + suffix] = df2['days_to_end' + suffix] - df2['days_to_start' + suffix] + 1
print(df2)Ausgabe:
task   team    start_1      end_1    start_2      end_2    start_3  \
0    C  Sales 2022-10-26 2022-10-31        NaT        NaT        NaT
1    D  Sales 2022-10-31 2022-11-08 2022-11-10 2022-11-14        NaT
2    H  Sales 2022-11-14 2022-11-22 2022-11-25 2022-11-28 2022-12-01
3    K  Sales 2022-11-28 2022-12-05        NaT        NaT        NaT

      end_3  days_to_start_1  days_to_end_1  task_duration_1  \
0        NaT                0              5                6
1        NaT                5             13                9
2 2022-12-05               19             27                9
3        NaT               33             40                8

  days_to_start_2  days_to_end_2  task_duration_2  days_to_start_3  \
0              NaN            NaN              NaN              NaN
1             15.0           19.0              5.0              NaN
2             30.0           33.0              4.0             36.0
3              NaN            NaN              NaN              NaN

  days_to_end_3  task_duration_3
0            NaN              NaN
1            NaN              NaN
2           40.0              5.0
3            NaN              NaN
Jetzt hat Aufgabe D zwei Teilaufgaben, Aufgabe H drei, und die Aufgaben C und K jeweils eine. Für D und H verwenden wir daher die Methode broken_barh(). Da ihre Syntax etwas weniger intuitiv ist als bei barh(), schauen wir uns die wichtigsten Parameter und ihre Form an. Pflichtparameter von broken_barh() sind:
xranges – eine Sequenz von Tupeln im Format (xmin, xwidth) für Start und Ausdehnung jedes Balkens. Jeder Balken steht hier für eine Teilaufgabe. Dieser Parameter zeigt also Startdatum und Dauer jeder Teilaufgabe.yrange – ein Tupel im Format (ymin, yheight) für y‑Position und Höhe jedes Balkens.Jetzt plotten wir unser „gebrochenes“ Gantt‑Diagramm. Der Ablauf:
barh() plotten, wie zuvor.broken_barh() plotten.broken_barh() plotten.# 1
fig, ax = plt.subplots()
# 2
for index, row in df2.iterrows():
if row['start_2'] is None:
ax.barh(y=df2['task'], width=df2['task_duration_1'], left=df2['days_to_start_1'])
elif row['start_2'] is not None and row['start_3'] is None:
ax.broken_barh(xranges=[(row['days_to_start_1'], row['task_duration_1']), (row['days_to_start_2'], row['task_duration_2'])], yrange=(index + 1, 0.5))
else:
ax.broken_barh(xranges=[(row['days_to_start_1'], row['task_duration_1']), (row['days_to_start_2'], row['task_duration_2']), (row['days_to_start_3'], row['task_duration_3'])], yrange=(index + 1, 0.5))
# 3
ax.set_yticks([1.25, 2.25, 3.25, 4.25])
ax.set_yticklabels(df2['task'])
plt.show()Ausgabe:
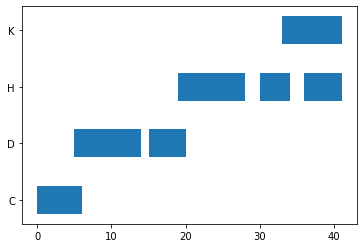
Im obigen Code könnten wir broken_barh() auch für Aufgaben mit nur einer Teilaufgabe verwenden. Dazu ersetzen wir diese Zeile:
ax.barh(y=df2['task'], width=df2['task_duration_1'], left=df2['days_to_start_1'])durch diese:
ax.broken_barh(xranges=[(row['days_to_start_1'], row['task_duration_1'])], yrange=(index + 1, 0.5))So wird der Code einheitlicher und besser lesbar.
Zurück zu unserem ersten DataFrame:
print(df)Ausgabe:
  task        team      start        end  completion_frac  days_to_start  \
0     A         R&D 2022-10-20 2022-10-31             1.00              0
1     B  Accounting 2022-10-24 2022-10-28             1.00              4
2     C       Sales 2022-10-26 2022-10-31             1.00              6
3     D       Sales 2022-10-31 2022-11-08             1.00             11
4     E          IT 2022-11-03 2022-11-09             1.00             14
5     F         R&D 2022-11-07 2022-11-18             0.95             18
6     G          IT 2022-11-10 2022-11-17             0.70             21
7     H       Sales 2022-11-14 2022-11-22             0.35             25
8     I  Accounting 2022-11-18 2022-11-23             0.10             29
9     J  Accounting 2022-11-23 2022-12-01             0.00             34
10    K       Sales 2022-11-28 2022-12-05             0.00             39
11    L          IT 2022-11-30 2022-12-05             0.00             41

    days_to_end  task_duration  completion_days
0            11             12            12.00
1             8              5             5.00
2            11              6             6.00
3            19              9             9.00
4            20              7             7.00
5            29             12            11.40
6            28              8             5.60
7            33              9             3.15
8            34              6             0.60
9            42              9             0.00
10           46              8             0.00
11           46              6             0.00
und unserem ersten Gantt‑Diagramm:
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'])
plt.show()
Ausgabe:
Jetzt wollen wir das Diagramm gezielt anpassen, um mehr Erkenntnisse herauszuholen.
Wenn du tiefer in das Anpassen von Plots mit matplotlib einsteigen willst, empfehlen wir: Matplotlib Tutorial: Python Plotting und das Matplotlib Cheat Sheet: Plotting in Python.
Dazu zählen:
Ein aussagekräftiger Titel ist Pflicht – auch beim Gantt‑Diagramm. Nehmen wir an, unser Projekt heißt Project X:
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'])
plt.title('Project Management Schedule of Project X', fontsize=15)
plt.show()
Ausgabe:
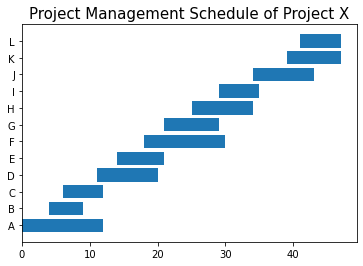
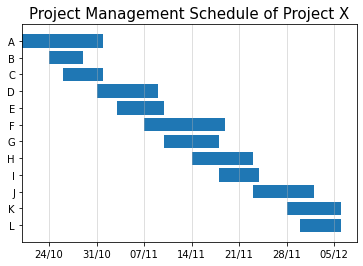
Aufbauend auf dem vorherigen Code führen wir Folgendes aus:
ax‑Objekt zu arbeiten.# 1
fig, ax = plt.subplots()
plt.barh(y=df['task'], width=df['task_duration'], left=df['days_to_start'] + 1)
plt.title('Project Management Schedule of Project X', fontsize=15)
# 2
plt.gca().invert_yaxis()
# 3
xticks = np.arange(5, df['days_to_end'].max() + 2, 7)
# 4
xticklabels = pd.date_range(start=df['start'].min() + dt.timedelta(days=4), end=df['end'].max()).strftime("%d/%m")
# 5
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
# 6
ax.xaxis.grid(True, alpha=0.5)
plt.show()Ausgabe:
Wenn du mehr Übung in Python brauchst, um Code leichter zu lesen und zu schreiben, ist unser Kurs Intermediate Python ein guter Startpunkt.
Jetzt färben wir jeden Balken (jede Aufgabe) entsprechend dem zuständigen Team ein. Dazu gehen wir so vor:
# 1
team_colors = {'R&D': 'c', 'Accounting': 'm', 'Sales': 'y', 'IT': 'b'}

# 2
fig, ax = plt.subplots()

# 3
for index, row in df.iterrows():
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']])

# 4
plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)
plt.show()
Ausgabe:
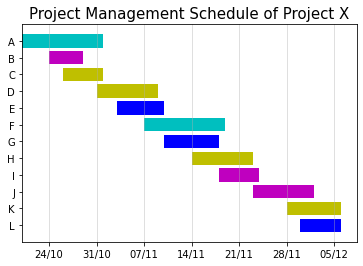
In der obigen Version fehlt noch eine Legende, die zeigt, welche Farbe zu welchem Team gehört. Dafür erstellen wir Patches – 2D‑Objekte in matplotlib mit vordefinierter Füllfarbe. Wir nutzen die Klasse matplotlib.patches.Patch und erzeugen eine Liste von Patches, je Team eines, passend eingefärbt:
patches = []
for team in team_colors:
    patches.append(matplotlib.patches.Patch(color=team_colors[team]))
Jetzt fügen wir die Legende dem Chart hinzu:
fig, ax = plt.subplots()
for index, row in df.iterrows():
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']])
plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)

# Legende hinzufügen
ax.legend(handles=patches, labels=team_colors.keys(), fontsize=11)

plt.show()
Ausgabe:
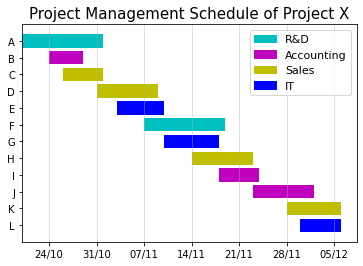
So ist das Gantt‑Diagramm deutlich aussagekräftiger.
Weitere Techniken, um Ästhetik und Lesbarkeit von Plots zu verbessern, findest du im Kurs Improving Your Data Visualizations in Python.
Bisher haben wir die zu Beginn berechnete Spalte completion_days noch nicht genutzt. Jetzt verwenden wir sie, um den Status jeder Aufgabe sichtbar zu machen.
Technisch fügen wir zu jedem bestehenden Balken einen zweiten darüber liegenden hinzu. Der untere Balken zeigt die gesamte, zugewiesene Dauer der Aufgabe in Tagen, der obere den aktuellen Fertigstellungsstand in Tagen.
Beide Balken haben pro Aufgabe dieselbe Teamfarbe, aber der untere ist heller als der obere, damit der Unterschied klar erkennbar ist.
Anders gesagt: Wenn ein Team bei einer Aufgabe über Plan liegt, wirken beide Balken zusammen so, als hätte das Team bereits mehr Tage daran gearbeitet als vorgesehen (die Aufgabe wird voraussichtlich vor der Deadline fertig).
Umgekehrt zeigt eine Unterperformance, dass weniger Tage als geplant aufgelaufen sind (die Aufgabe wird voraussichtlich nach der Deadline fertig).
fig, ax = plt.subplots()

for index, row in df.iterrows():

    # Unterer Balken – Gesamtdauer der Aufgabe
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']], alpha=0.4)

    # Oberer Balken – Fertigstellungsstatus
    plt.barh(y=row['task'], width=row['completion_days'], left=row['days_to_start'] + 1, color=team_colors[row['team']])

plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)
ax.legend(handles=patches, labels=team_colors.keys(), fontsize=11)
plt.show()
Ausgabe:
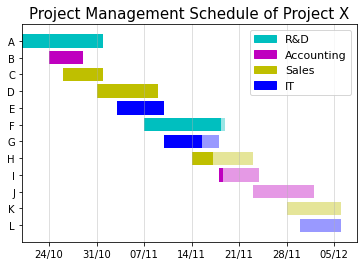
Wir sehen: Die Teams kommen unterschiedlich schnell voran – typisch für reale Projekte. Um noch mehr Kontext zu bekommen, nehmen wir an, heute ist der 17. November 2022, und markieren dieses Datum im Diagramm:
fig, ax = plt.subplots()
for index, row in df.iterrows():
    plt.barh(y=row['task'], width=row['task_duration'], left=row['days_to_start'] + 1, color=team_colors[row['team']], alpha=0.4)
    plt.barh(y=row['task'], width=row['completion_days'], left=row['days_to_start'] + 1, color=team_colors[row['team']])

plt.title('Project Management Schedule of Project X', fontsize=15)
plt.gca().invert_yaxis()
ax.set_xticks(xticks)
ax.set_xticklabels(xticklabels[::7])
ax.xaxis.grid(True, alpha=0.5)
ax.legend(handles=patches, labels=team_colors.keys(), fontsize=11)

# Aktuelles Datum im Diagramm markieren
ax.axvline(x=29, color='r', linestyle='dashed')
ax.text(x=29.5, y=11.5, s='17/11', color='r')

plt.show()
Ausgabe:
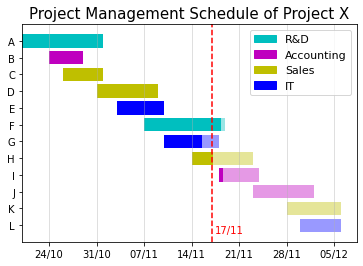
Daraus lassen sich folgende Beobachtungen zum Status von Project X ableiten:
Solche Erkenntnisse helfen Teamleads und Projektleitung, den Zeitplan anzupassen und Ressourcen rechtzeitig umzuverteilen, um Verzögerungen bei Deliverables zu vermeiden.
Wir können unser Gantt‑Diagramm in matplotlib weiter anreichern, zum Beispiel:
Wichtig ist jedoch, das Diagramm übersichtlich zu halten. Wie bei jeder Visualisierung gilt es, ein gutes Gleichgewicht zwischen Informationsdichte, Lesbarkeit des Plots und Verständlichkeit des Codes zu finden.
Zusammengefasst haben wir in diesem Tutorial behandelt:
Außerdem haben wir uns verschiedene Gantt‑Beispiele und den Schritt‑für‑Schritt‑Prozess zu ihrer Erstellung angesehen.
Für einen integrierten Lernpfad rund um überzeugende und informative Diagramme in Python, wirf einen Blick auf unseren Data Visualization with Python Skill Track.
Kurse zur Datenvisualisierung
Kurs
Kurs
Kurs