
Cours
Modèles Transformer avec PyTorch
2 h
9.1K
Le mécanisme d’attention, et plus précisément la self‑attention, a été introduit pour la première fois dans le célèbre article “Attention is All You Need“ de Vaswani et al. en 2017.
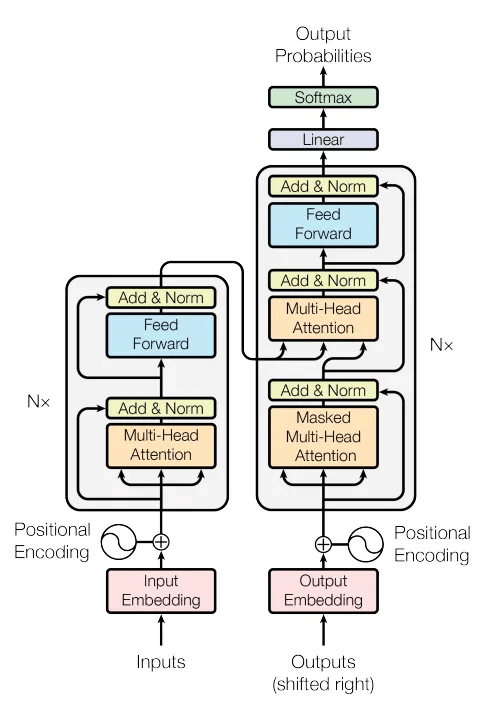
Ce mécanisme est au cœur du modèle Transformers, qui alimente à son tour certains des modèles les plus puissants que nous ayons, comme les LLM et les VLM.
Oui, c’est donc crucial !
Mais voilà le point important : beaucoup de gens (et j’en faisais partie !) pensent que l’attention a été inventée en 2017.
Ce n’est pas le cas.
Le mécanisme d’attention d’origine a été proposé pour la première fois en 2015, lorsque Bahdanau et al. l’ont introduit dans le contexte de la traduction automatique. Leur idée : permettre au décodeur de se concentrer, à chaque étape de décodage, sur différentes parties de la phrase d’entrée, au lieu de s’appuyer sur un seul vecteur de contexte fixe.
Ce léger changement a eu un énorme impact — et a semé les graines de ce qui deviendra la self‑attention puis, à terme, l’attention multi‑têtes.
Vous vous posez peut‑être maintenant la question :
« Concrètement, qu’entend‑on par attention ? »
Introduisons ce concept avec deux phrases simples :
Ces exemples montrent l’objectif de l’attention : focaliser l’information, en aidant le modèle à décider quels autres mots sont pertinents pour celui qu’il traite, souvent selon le sens sémantique ou les relations grammaticales.
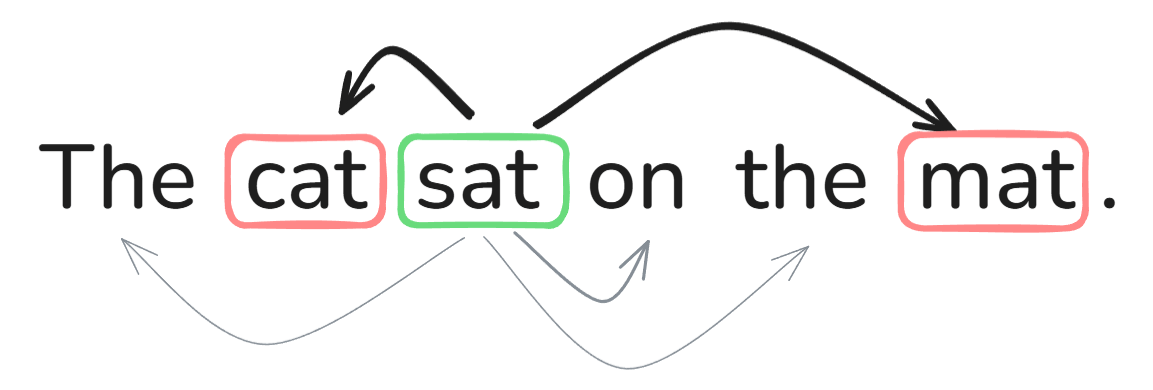
Point important : tous les tokens sont pris en compte pour calculer les pondérations et scores d’attention (nous y revenons plus loin), pas seulement certains, comme le montre le schéma ci‑dessus. Cela implique aussi que certains mots attirent plus l’attention que d’autres, ce que la largeur des flèches illustre.
C’est ce qui rend les transformers si performants pour comprendre la langue : ils utilisent l’attention pour relier dynamiquement chaque mot à tous les autres.
Nous avons défini ce qu’est l’attention, mais pas encore comment elle est calculée en interne.
C’est ici qu’interviennent les requêtes (Queries), clés (Keys) et valeurs (Values) (souvent abrégées en Q, K et V). Pour la suite, restons sur notre exemple : « the cat sat on the mat ».
D’abord, à l’entrée du Transformer, la phrase est tokenisée par un tokenizer, par exemple le Byte‑pair encoding.
On peut voir la tokenisation comme une segmentation du texte en unités plus petites. Dans notre phrase, les mots étant courts, supposons pour l’exemple qu’une unité correspond à un mot. Visuellement, après tokenisation, la phrase ressemble à ceci :
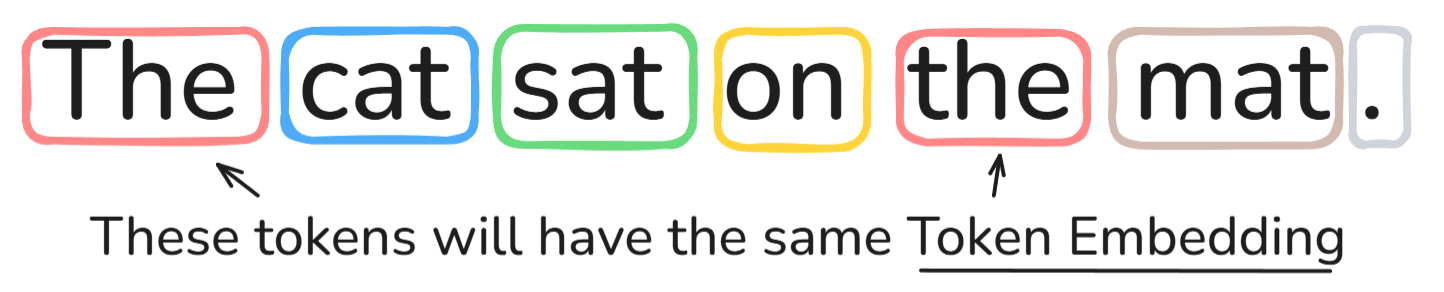
Notez que même la ponctuation (le point final) devient un token. Pour simplifier, supposons que le point soit un token à part entière.
Après tokenisation, on convertit chaque token en son identifiant (Token ID) via le vocabulaire du tokenizer. Ce vocabulaire s’apparente à une table listant tous les tokens connus du modèle et leur identifiant associé.
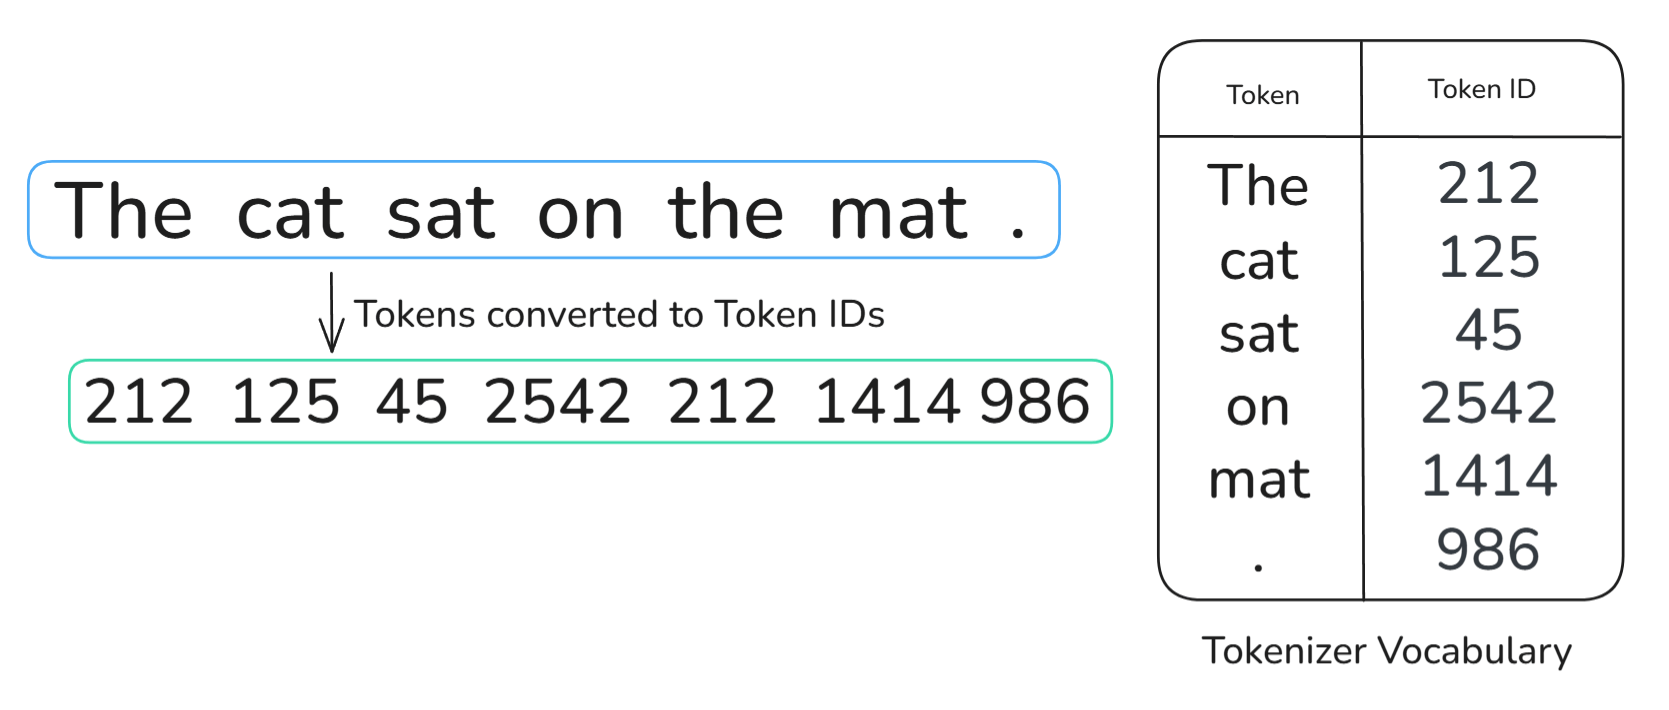
Ensuite, chaque Token ID est mappé à son vecteur d’embedding via une matrice d’embedding. Important : tous ces embeddings ont la même dimension ; prenons 512 dans notre exemple.
Dernière étape : ajouter un embedding positionnel pour fournir la position de chaque token. Deux approches courantes :
Le détail de ces mécanismes dépasse le cadre de ce tutoriel. Retenez surtout que nos vecteurs d’entrée suivent la formule :
Vecteur d’entrée = Token Embedding + Positional Embedding
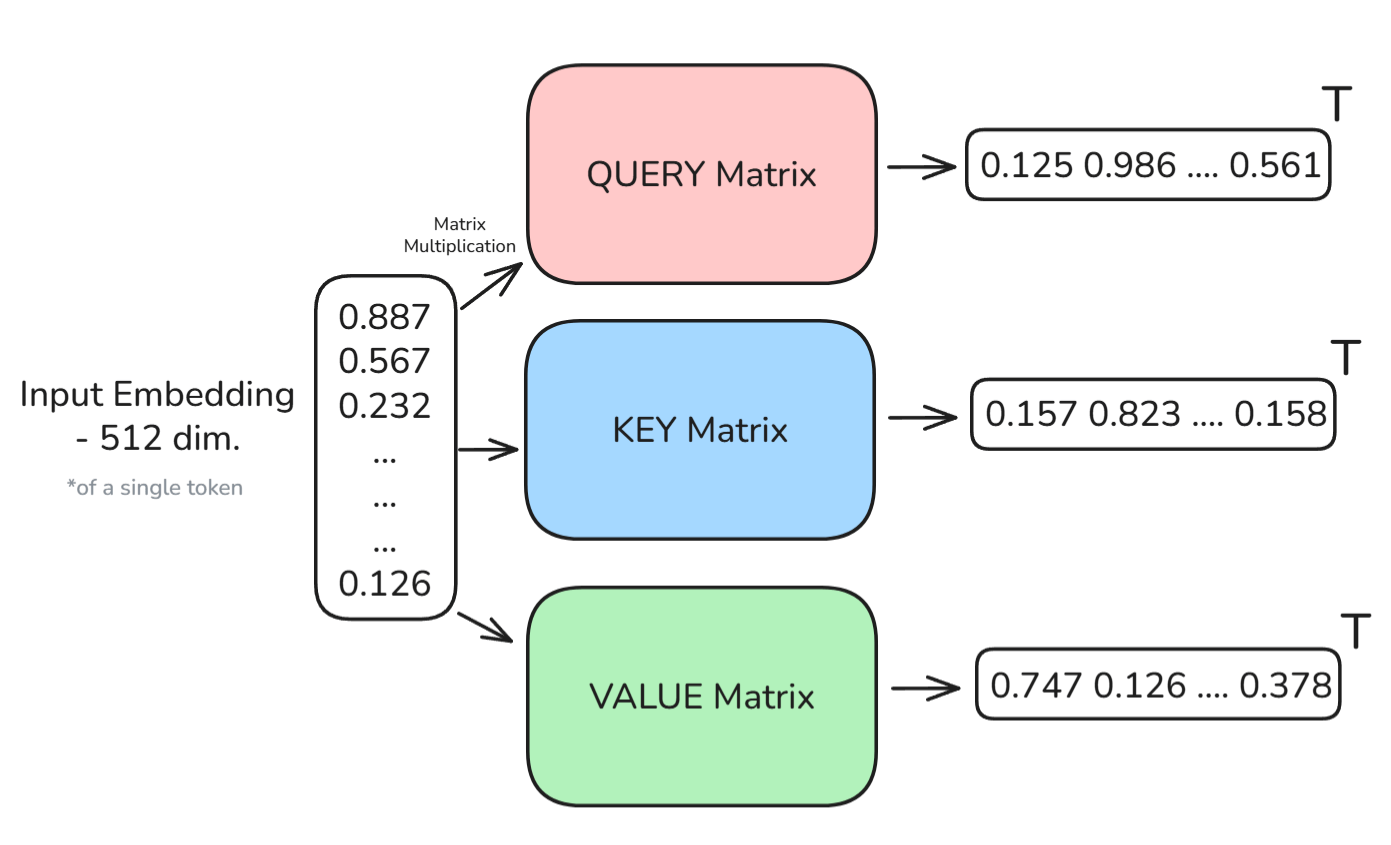
Nous pouvons maintenant introduire les vecteurs Q, K, V. Pour chaque mot de l’entrée, on crée trois vecteurs :
Ce sont des transformations apprises, représentées par leurs matrices respectives. Formellement :
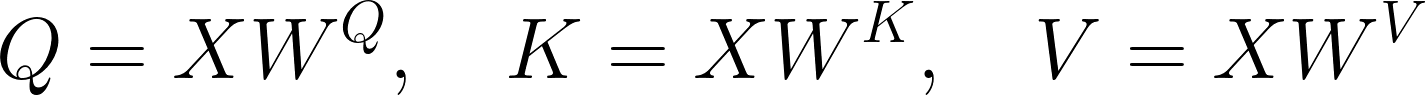
Ainsi, chaque token est représenté par trois nouveaux vecteurs. Le schéma ci‑dessous illustre ce processus :
Dans l’article « Attention is all you need », une formule décrit comment utiliser ces vecteurs pour calculer les pondérations d’attention. Parcourons‑la pas à pas, en supposant que l’on calcule l’attention pour « sat » :
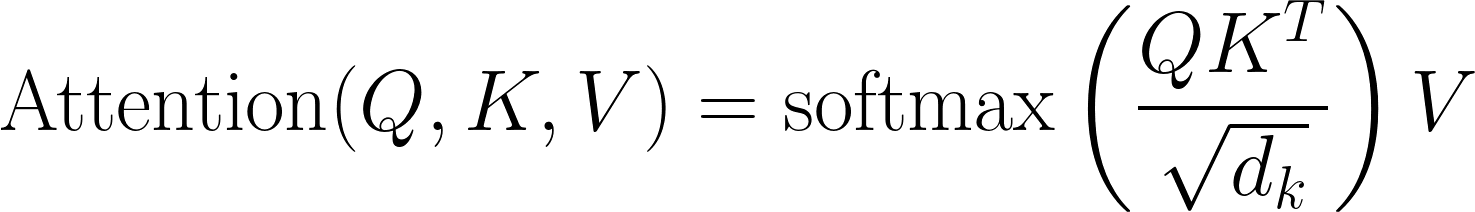
On commence par comparer le vecteur Query de « sat » aux vecteurs Key de tous les autres mots — y compris lui‑même. On obtient un ensemble de scores de similarité (scalaires) indiquant la pertinence de chaque mot pour « sat ». On les appelle formellement des scores d’attention.
Ces scores sont ensuite normalisés par sqrt(d_k) pour éviter des valeurs trop grandes et stabiliser les gradients lors de l’apprentissage par rétropropagation. Les scores mis à l’échelle passent ensuite par une softmax, qui les transforme en pondérations d’attention.
La softmax fournit des probabilités indiquant au modèle l’importance de chaque mot ; les pondérations d’attention d’un token donné somment donc à 1.
Enfin, on effectue une somme pondérée des vecteurs value en utilisant ces pondérations d’attention.
On obtient ainsi un nouveau vecteur qui représente « sat » en contexte, enrichi par l’ensemble des tokens, surtout par cat, mat et tout autre token pertinent.
Ce processus s’applique à chaque token de la phrase. Chaque token porte attention à tous les autres, y compris à lui‑même. C’est pour cela qu’on parle de self‑attention.
Notez aussi que nous avons illustré le calcul pour un seul token, mais en pratique, on le fait pour beaucoup — voire tous — simultanément, car la multiplication de matrices est très efficace.
C’est possible car l’architecture est entièrement parallélisable. Contrairement aux réseaux neuronaux récurrents (RNN) qui traitent séquentiellement, ce mécanisme permet aux Transformers de traiter tous les tokens en même temps, ce qui les rend rapides et puissants.
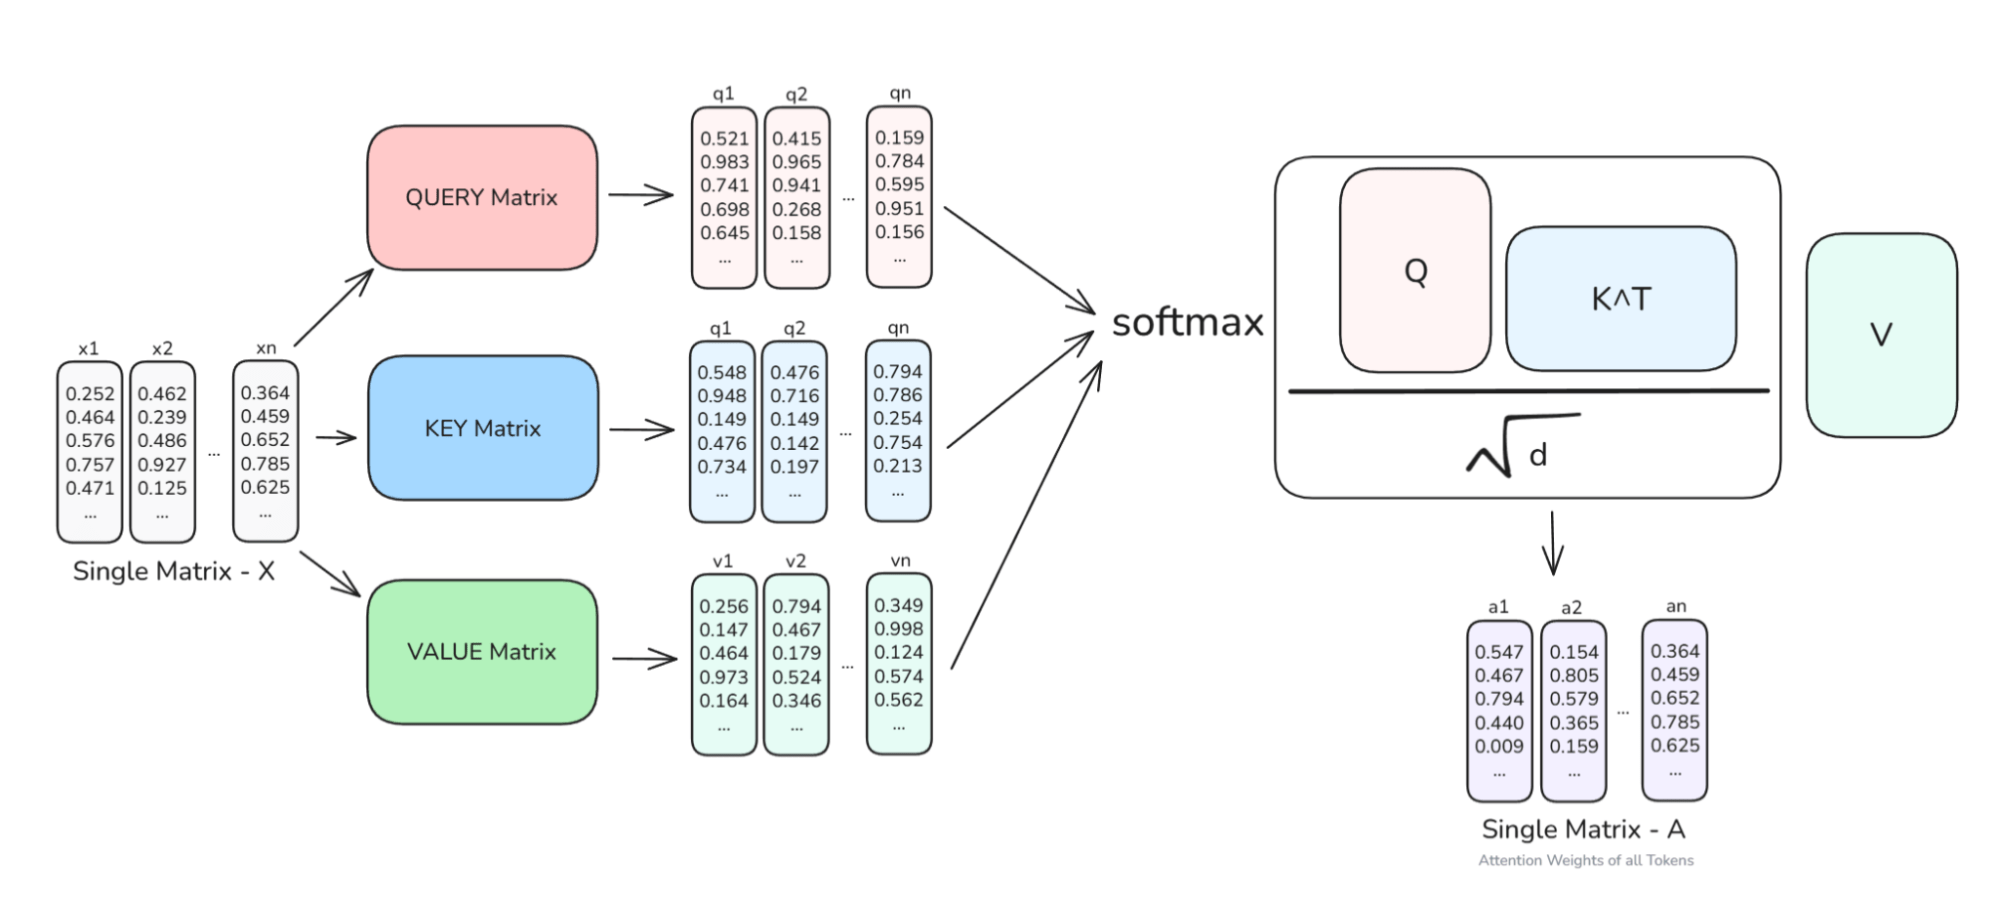
Pour visualiser, voyez le schéma ci‑dessus : la matrice d’entrée X est transformée en matrices Query, Key et Value correspondantes, puis la formule d’attention par produit scalaire pondéré est appliquée pour obtenir les embeddings enrichis de tous les tokens de l’entrée : A.
Passons au code en PyTorch. Bonne nouvelle : c’est assez simple :
import torchimport torch.nn.functional as Fdef scaled_dot_product_attention(Q, K, V): d_k = Q.size(-1) # the dimension of the key vectors scores = torch.matmul(Q, K.transpose(-2, -1)) / torch.sqrt(torch.tensor(d_k, dtype=torch.float32)) attn_weights = F.softmax(scores, dim=-1) output = torch.matmul(attn_weights, V) return output, attn_weightsAvec une simple fonction, nous reproduisons le mécanisme décrit ci‑dessus. Points clés :
Q, K et V sont des tenseurs de forme [batch_size, seq_len, dim]Un détail important n’a pas encore été mentionné : il n’existe pas qu’un seul type d’attention dans un Transformer, mais trois :
Chacune joue un rôle légèrement différent. Passons‑les en revue.
C’est ce que nous avons vu jusqu’ici : dans l’encodeur, chaque token porte attention à tous les autres de la même séquence d’entrée (p. ex. « the cat sat on the mat. »).
Ici, aucune contrainte : l’entrée entière est connue à l’avance, ce qui permet au modèle de construire des représentations contextuelles profondes pour chaque token, en tenant compte de ce qui précède et suit.
Rappel : cela se passe côté encodeur.
Ici, c’est un peu plus délicat. Dans le décodeur, on ne veut pas que chaque token voie le futur, sinon ce serait tricher pendant la génération de texte.
Prenons un autre exemple : « The dog barked very loudly. » Lorsque le modèle génère « barked » (en supposant, pour simplifier, un token par mot), il ne doit pas savoir que le token suivant est « very », sinon il n’apprendrait pas à générer les prochains tokens.
Pour résoudre cela, on applique un masque causal (aussi appelé masque triangulaire) qui garantit que chaque token ne peut prêter attention qu’à lui‑même et aux tokens précédents, jamais à ceux qui suivent.
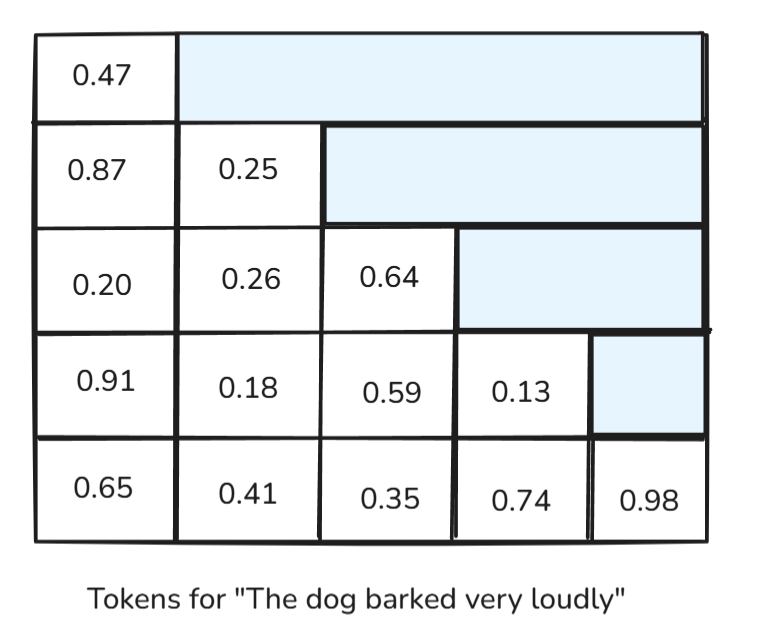
Le schéma montre que les scores vers le futur sont annulés par le masquage, ce qui permet au modèle d’apprendre à générer des tokens nouveaux, justes et cohérents.
Une fois que le décodeur commence à générer, il a toujours besoin d’informations sur l’entrée d’origine (celle à laquelle il répond). C’est le rôle de la cross‑attention.
Ici, le décodeur prête attention à la sortie de l’encodeur. Ainsi, tandis que la self‑attention du décodeur est masquée, la cross‑attention ne l’est pas, et le décodeur peut regarder tous les tokens encodés à la fois.
Lors de mon apprentissage, l’exemple de traduction m’a beaucoup aidé. Si vous traduisez « Bonjour tout le monde » en anglais, le décodeur doit pouvoir considérer tous les mots français au moment de choisir chaque mot anglais, n’est‑ce pas ?
C’est exactement ce que fait la cross‑attention. Nous n’entrerons toutefois pas plus en détail ici, cela dépasse le périmètre de cet article.
Nous comprenons maintenant la self‑attention. Mais vous pourriez demander :
Si nous avons déjà l’attention, pourquoi avons‑nous besoin de plusieurs têtes ?
Pour cela, j’aime l’analogie de la lampe torche, qui m’a aidé à construire mon intuition au départ.
Considérez une seule tête d’attention comme une lampe torche qui éclaire les parties importantes d’une phrase. Mais une phrase recèle de multiples relations à saisir : sujet‑verbe, pronom‑objet, adjectif‑nom, dépendances longues, etc.
Ne vaudrait‑il pas mieux capturer plusieurs de ces relations plutôt qu’une seule à la fois ?
La solution consiste donc à donner au modèle plusieurs lampes torches, chacune se concentrant sur une partie différente de la phrase. C’est l’attention multi‑têtes.
Plutôt que de calculer un seul triplet Q, K, V et une unique attention, on scinde les embeddings en sous‑espaces et on exécute plusieurs têtes d’attention indépendantes en parallèle.
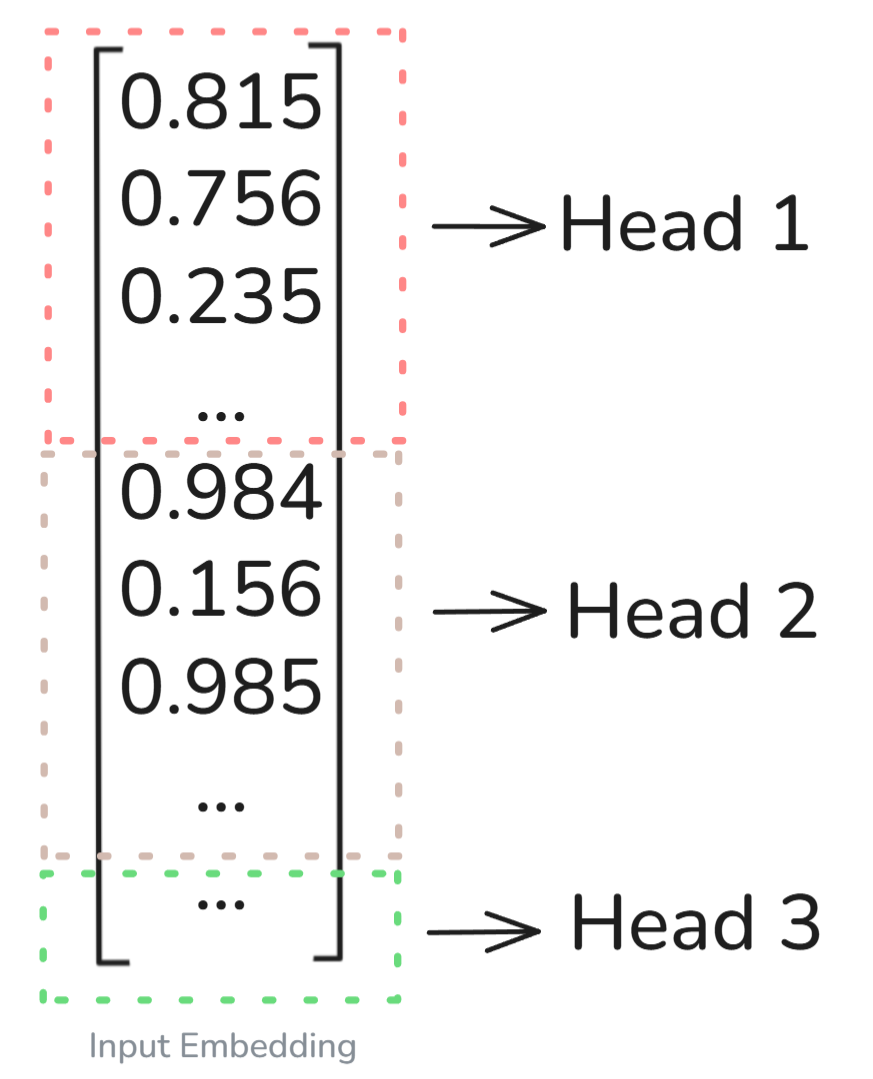
Comme on le voit ci‑dessus, l’embedding d’entrée (pour un token ici, pour simplifier) est réparti équitablement entre n têtes différentes.
Dans notre exemple, supposons une dimension de 512 et 8 têtes : chaque tête traite en parallèle (512/8=64) dimensions, afin de capturer différentes relations.
Pour étoffer votre intuition sur les types de relations que ces têtes peuvent (j’insiste sur peuvent, car on ne comprend pas encore parfaitement ce que chaque tête capture) modéliser, prenons un exemple simple :
Considérons la phrase :
« The quick brown fox jumps over the lazy dog. »
Point essentiel : toutes ces têtes s’exécutent simultanément, puis leurs sorties sont concaténées et reprojetées à la dimension initiale de l’embedding (ici 512).
Pour bien ancrer la compréhension de l’attention multi‑têtes, utilisons la bibliothèque HuggingFace pour voir son fonctionnement en pratique.
!pip install transformers bertviz torchCommencez par exécuter la cellule ci‑dessus pour installer les packages nécessaires.
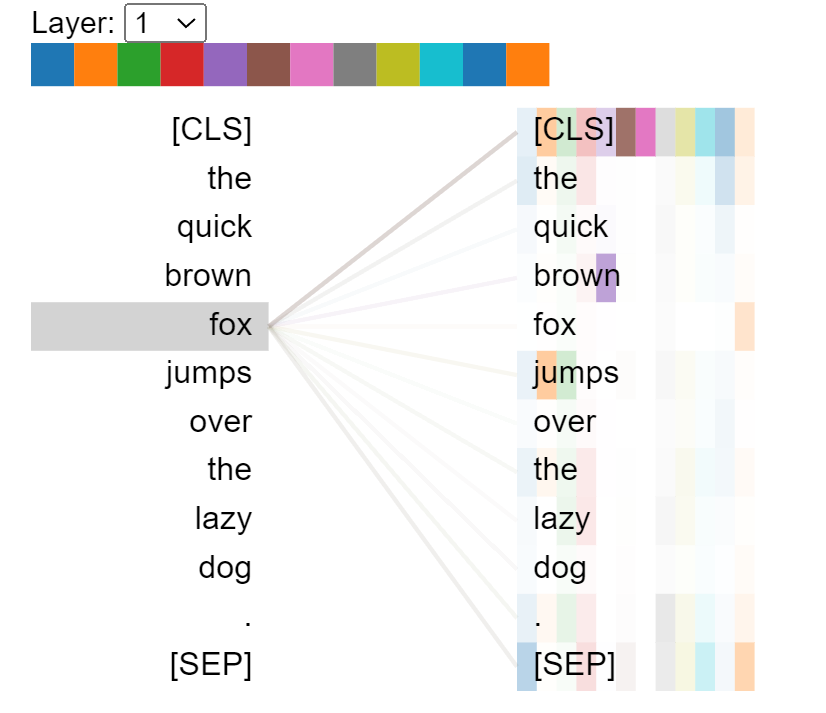
from transformers import BertTokenizer, BertModelfrom bertviz import head_viewimport torchmodel_name = 'bert-base-uncased' # We will be using the Bert modelmodel = BertModel.from_pretrained(model_name, output_attentions=True)tokenizer = BertTokenizer.from_pretrained(model_name)model.eval() # As we are not training, we have set the model to evaluation mode so no updates are made# This is our input sentencesentence = "The quick brown fox jumps over the lazy dog."# Using the tokenizer to convert the sentence into tokensinputs = tokenizer(sentence, return_tensors='pt')input_ids = inputs['input_ids']# Forward pass with attentionswith torch.no_grad(): outputs = model(**inputs) attentions = outputs.attentions # Tuple of (num_layers, batch, num_heads, seq_len, seq_len)# Here we decode the tokens tokens = tokenizer.convert_ids_to_tokens(input_ids[0])head_view(attentions, tokens) # VisualizationLa sortie ressemble à ce qui suit. Remarquez les 12 couleurs différentes : ce modèle comporte 12 têtes. L’épaisseur des lignes correspond à l’intensité des scores d’attention entre tokens.
Dans cette section, écrivons le pseudocode de l’attention multi‑têtes. Supposons que l’entrée X ait la forme [batch, seq_len, d_model].
Nous pouvons alors procéder ainsi :
Q = X @ W_Q # Calculating the Query valuesK = X @ W_K # Calculating the Key valuesV = X @ W_V# Calculating the Value valuesQ_i, K_i, V_i = split_into_heads(Q, K, V, num_heads) # Now we split the Q,K,V into multiple different heads (by evenly splitting the dimensions)# Here we compute scaled dot-product attention for each headscores = (Q_i @ K_i.T) / sqrt(head_dimscores += maskA_i = softmax(scores)A_i = dropout(A_i)Z_i = A_i @ V_iZ = concat_heads(Z_i) # We have to concatenate all of the Heads# This is our final linear projection matrixoutput = Z @ W_Ooutput = dropout(output)Tout cela devrait désormais vous être familier, à l’exception peut‑être de la matrice de projection linéaire finale.
Voyons‑la rapidement.
Après le calcul de chaque tête, leurs sorties sont concaténées en un seul vecteur. Mais ce vecteur combiné doit être remis à la dimension du modèle : c’est le rôle de la matrice de projection finale. Elle remappe simplement la concaténation à la taille de l’embedding d’entrée, pour l’envoyer à la couche suivante du Transformer.
Quelques optimisations et bonnes pratiques :
Côté hyperparamètres, lors du codage de la couche d’attention, surveillez principalement :
num_heads : nombre de têtes calculées en parallèle, qui doit diviser d_model sans reste.head_dim : la dimension de chaque tête.dropout_rate : pour prévenir le surapprentissage.Nous avons couvert beaucoup de terrain. Nous sommes partis d’une idée simple : l’attention repose sur la focalisation. Nous avons vu comment les Transformers exploitent cette focalisation en évaluant, via Queries, Keys et Values, le lien de chaque mot avec tous les autres.
Nous avons compris comment la self‑attention (et brièvement d’autres variantes comme l’attention causale et la cross‑attention) confère à chaque token une représentation riche et contextuelle. Puis nous avons franchi une étape avec l’attention multi‑têtes : plutôt que de s’appuyer sur une seule « lampe torche », on en fournit plusieurs au modèle, chacune capturant des motifs différents dans la phrase, simultanément.
C’est ce qui fait la force des Transformers : ils ne se contentent pas de lire, ils comprennent la structure, le sens et les relations à l’échelle de séquences entières.
Nous n’avons couvert ici qu’un aspect des Transformers. Pour aller plus loin, découvrez ce cours complet : Transformer Models with PyTorch Course.
Si vous souhaitez passer rapidement aux applications, je vous recommande aussi le projet Developing Multi-Input Models For OCR ou le cours Working with HuggingFace. Si vous préférez les articles, consultez ce guide complet pour construire un Transformer avec PyTorch et mon autre guide sur les Vision Transformers.
Les meilleurs cours DataCamp
Cours
Cursus
Cursus