Curso
Modelos Transformer con PyTorch
2 h
9.2K
El mecanismo de atención, o más específicamente, la autoatención, se presentó por primera vez en el famoso artículo “Attention is All You Need“ de Vaswani et al. en 2017.
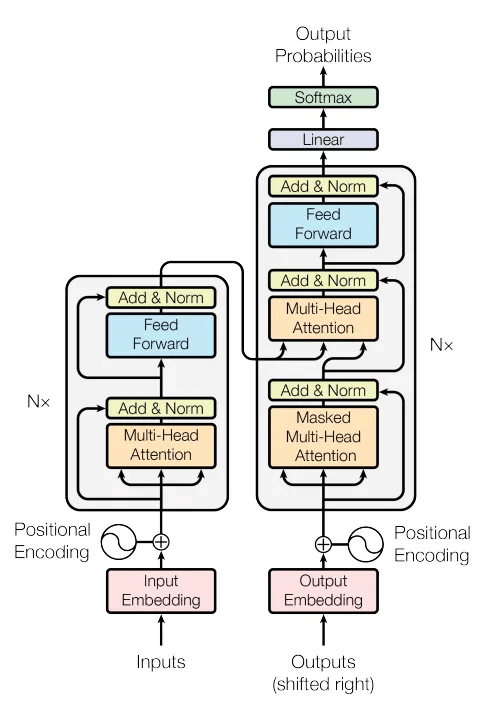
Este mecanismo es el que impulsa el modelo Transformer, que a su vez da vida a algunos de los modelos más potentes que tenemos hoy, como los LLM y los VLM.
Así que sí, es bastante importante.
Pero hay algo: mucha gente (¡y yo antes era una de ellas!) cree que la atención se inventó en 2017.
No fue así.
El mecanismo de atención original se introdujo por primera vez en 2015, cuando Bahdanau et al. lo presentaron en el contexto de la traducción automática. Su idea era permitir que el decodificador se centrara en distintas partes de la frase de entrada en cada paso de decodificación, en lugar de depender de un único vector de contexto fijo.
Ese pequeño cambio marcó una gran diferencia y plantó la semilla de lo que acabaría siendo la autoatención y, con el tiempo, la atención multi-cabeza.
Pero quizá te estés preguntando algo a estas alturas:
“¿Qué significa realmente atención?”
Voy a introducir este concepto con dos frases muy simples:
Con estos ejemplos empezamos a ver qué busca la atención. Se trata de enfocar: ayudar al modelo a decidir qué otras palabras son relevantes para la que está procesando, a menudo según su significado semántico o sus relaciones gramaticales.
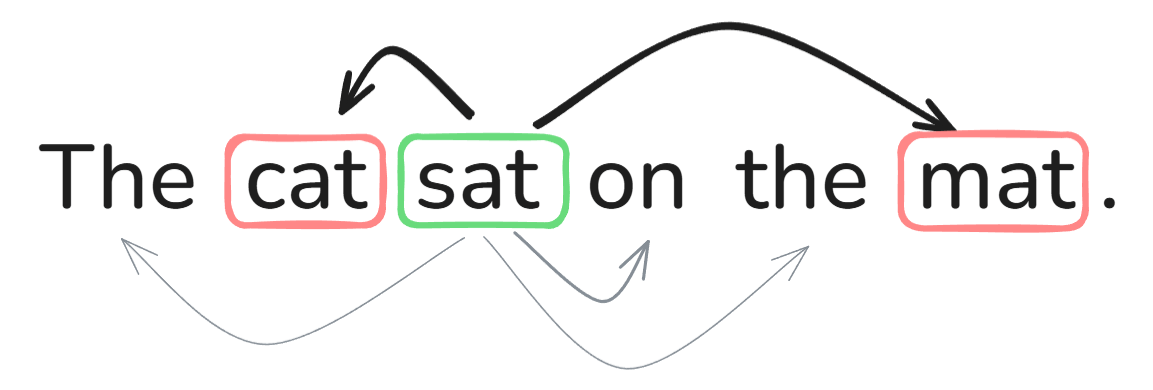
Algo importante a destacar es que se utilizan todos los tokens para calcular las ponderaciones y puntuaciones de atención (hablaremos más sobre esto luego), no solo algunos tokens concretos, como se ve en el diagrama. Esto también implica que habrá atención más fuerte entre algunas palabras que entre otras, algo que se representa con el grosor de las flechas.
Esto es lo que hace que los transformers sean tan buenos entendiendo el lenguaje: usan la atención para relacionar dinámicamente cada palabra con todas las demás.
Ya hemos visto qué es la atención, pero aún no sabemos cómo es el procesamiento interno.
Aquí entran en juego las queries, las keys y los values (abreviados como Q, K y V). Para el resto del artículo, seguiremos con nuestro ejemplo: “the cat sat on the mat”.
Primero, cuando una frase entra en el Transformer, se tokeniza inmediatamente con un tokenizer; uno muy conocido es el byte-pair encoding.
Podemos pensar la tokenización como dividir un texto en unidades más pequeñas. Como todas las palabras de nuestra frase son cortas, para este ejemplo podemos asumir que cada unidad equivale a una palabra. Visualmente, la frase tras pasar por el tokenizer debería verse así:
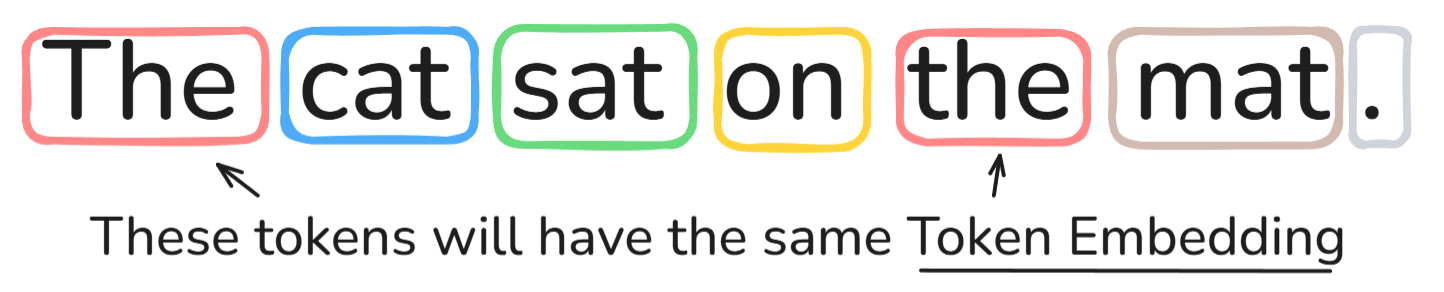
Fíjate en que incluso la puntuación (el punto final) se ha convertido en un token. De nuevo, por simplicidad, asumimos que el punto es su propio token independiente.
Tras la tokenización, usamos el vocabulario del tokenizer para convertir cada token en su Token ID correspondiente. Puedes pensar en el vocabulario como una base de datos/tabla que contiene todos los tokens que el modelo reconoce y su Token ID asociado.
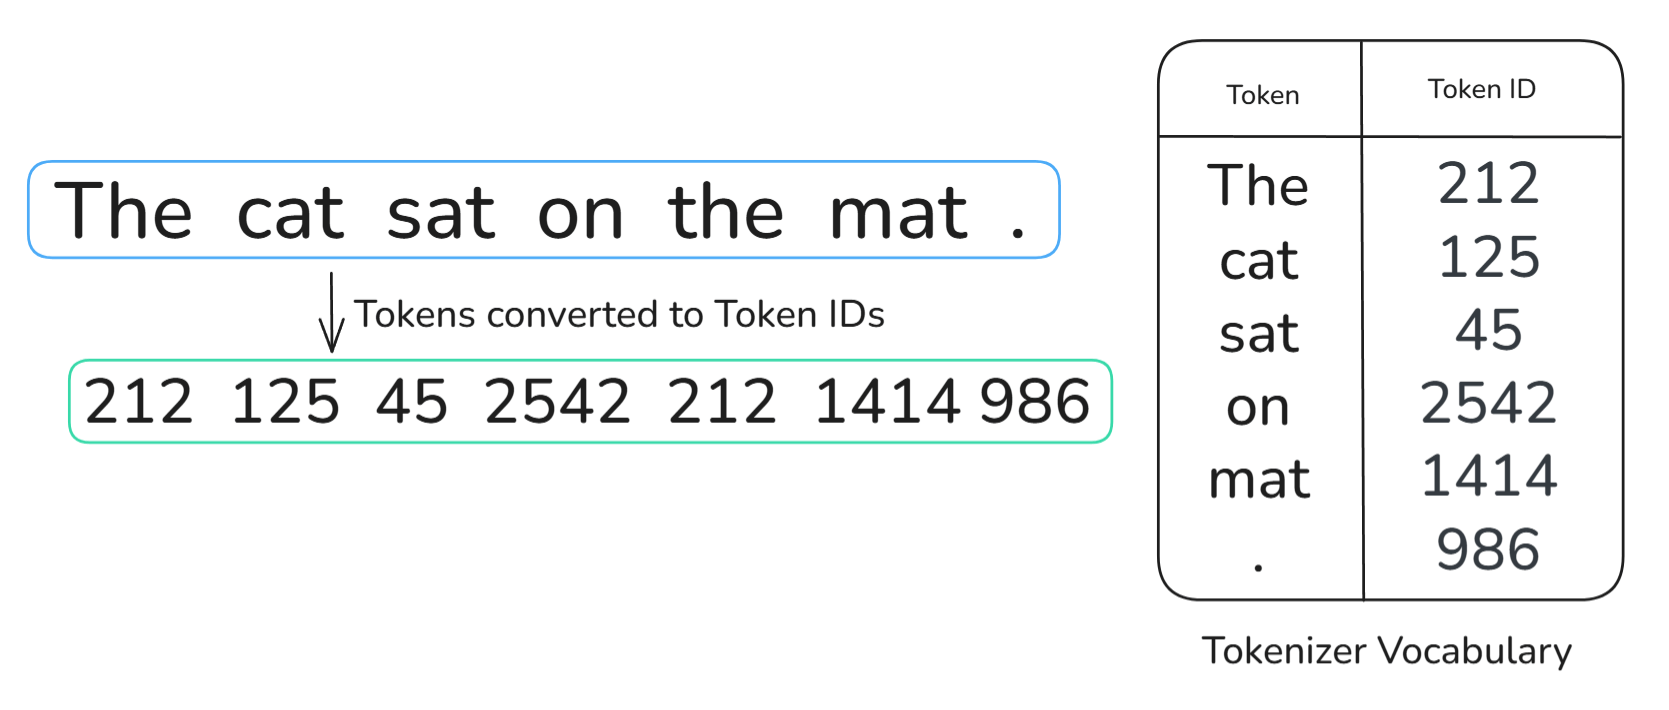
Después, cada uno de estos IDs únicos se mapea a su embedding usando una matriz de embeddings. Es importante tener en cuenta que todos estos embeddings tendrán vectores de la misma dimensión; en nuestro ejemplo, asumimos 512.
El último paso es añadir un embedding posicional para que el modelo tenga información de la posición de cada token. Los dos métodos más comunes son:
La mecánica subyacente de estos embeddings posicionales queda fuera del alcance de este tutorial. Por ahora basta con saber que obtenemos nuestros vectores de entrada con esta fórmula:
Vector de entrada = token embedding + positional embedding
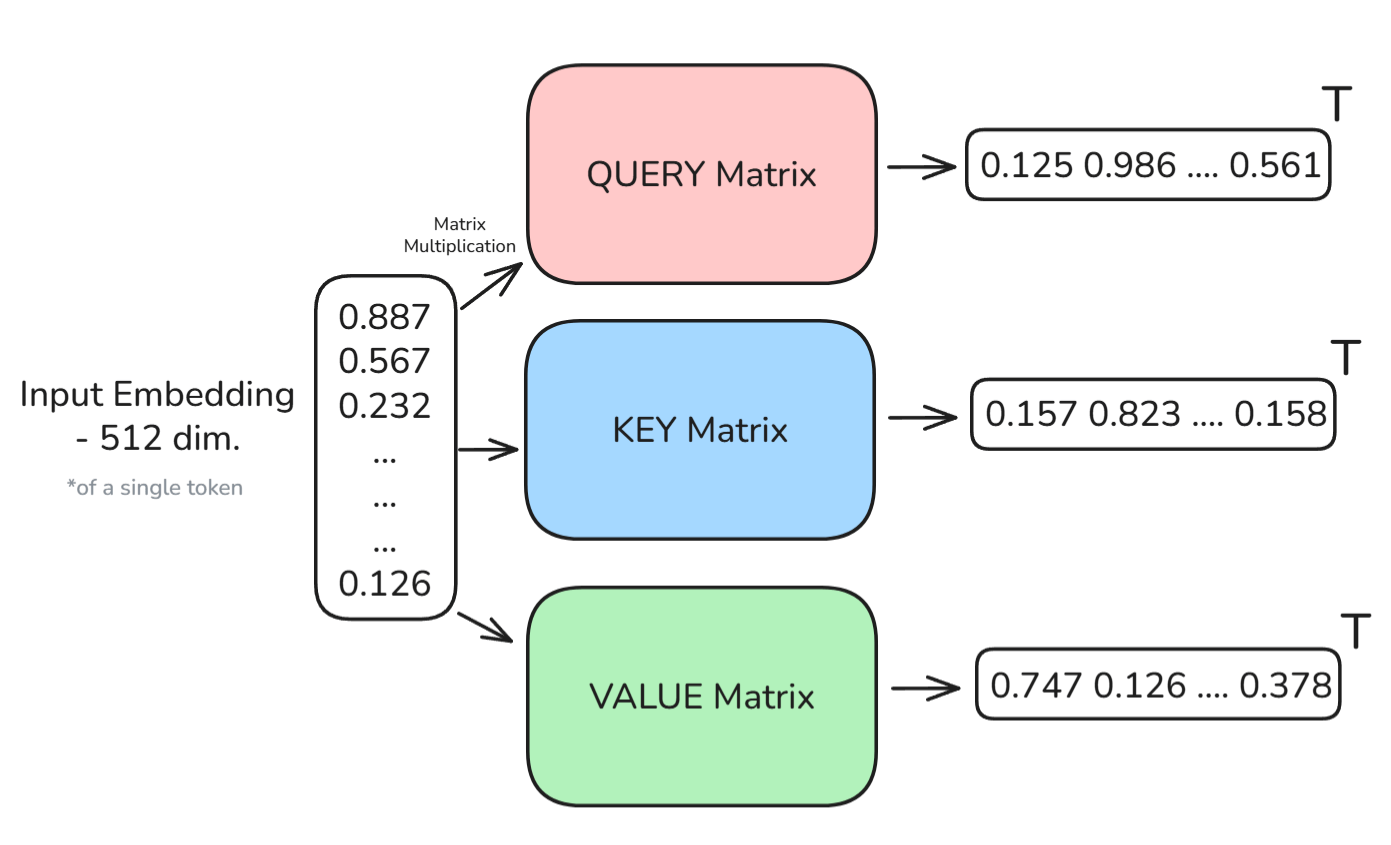
Ahora sí, estamos listos para presentar los vectores Q, K y V. Para empezar, ten en cuenta que para cada palabra de la entrada creamos tres vectores:
Son transformaciones aprendibles y también sus respectivas matrices. Matemáticamente, estas transformaciones se escriben así:
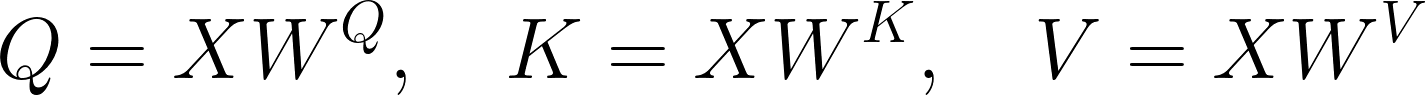
Con esto, cada token se puede representar por tres vectores nuevos. He creado el siguiente diagrama para ayudarte a visualizar el proceso:
En el artículo “Attention is All You Need” se dio una fórmula matemática que muestra cómo se usan los nuevos vectores para calcular las ponderaciones de atención. Veámoslo paso a paso, asumiendo que calculamos las ponderaciones cuando estamos en “sat”:
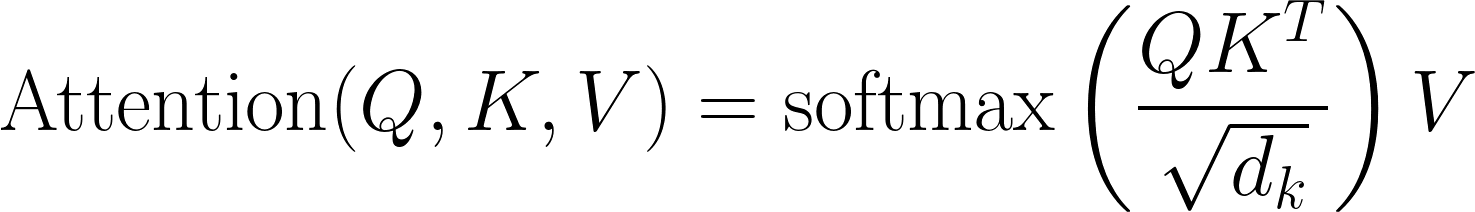
Para empezar, usamos el vector Query de “sat” para compararlo con los vectores Key de todas las demás palabras, incluida ella misma. El resultado es un conjunto de puntuaciones de similitud (son escalares) que nos dicen cuán relevante es cada palabra para “sat”. Formalmente se conocen como attention scores.
Estas puntuaciones se escalan con sqrt(d_k) para evitar que crezcan demasiado y ayudar a estabilizar los gradientes al entrenar con backpropagation. Después, las puntuaciones escaladas pasan por una softmax, convirtiéndolas en ponderaciones de atención.
La softmax nos da una probabilidad que indica al modelo cuánto peso dar a cada palabra; por tanto, las ponderaciones de atención para un token concreto suman 1.
Por último, calculamos una suma ponderada de los vectores value usando estas ponderaciones.
Esto nos da un nuevo vector que representa “sat” en contexto, enriquecido con la información de todos los tokens, pero sobre todo de cat, mat y cualquier otro token relevante.
Este proceso ocurre para cada token de la frase. Cada token atiende a todos los demás, e incluso a sí mismo. Por eso lo llamamos autoatención.
Ten también en cuenta que hemos calculado el nuevo vector enriquecido para un único token, pero en la práctica esto se hace para muchos, si no todos, a la vez, ya que la multiplicación de matrices es extremadamente eficiente.
Podemos hacerlo porque la arquitectura es totalmente paralelizable. A diferencia de las redes neuronales recurrentes (RNN), que procesan secuencialmente, este mecanismo permite a los Transformers procesar todos los tokens a la vez, haciéndolos rápidos y potentes.
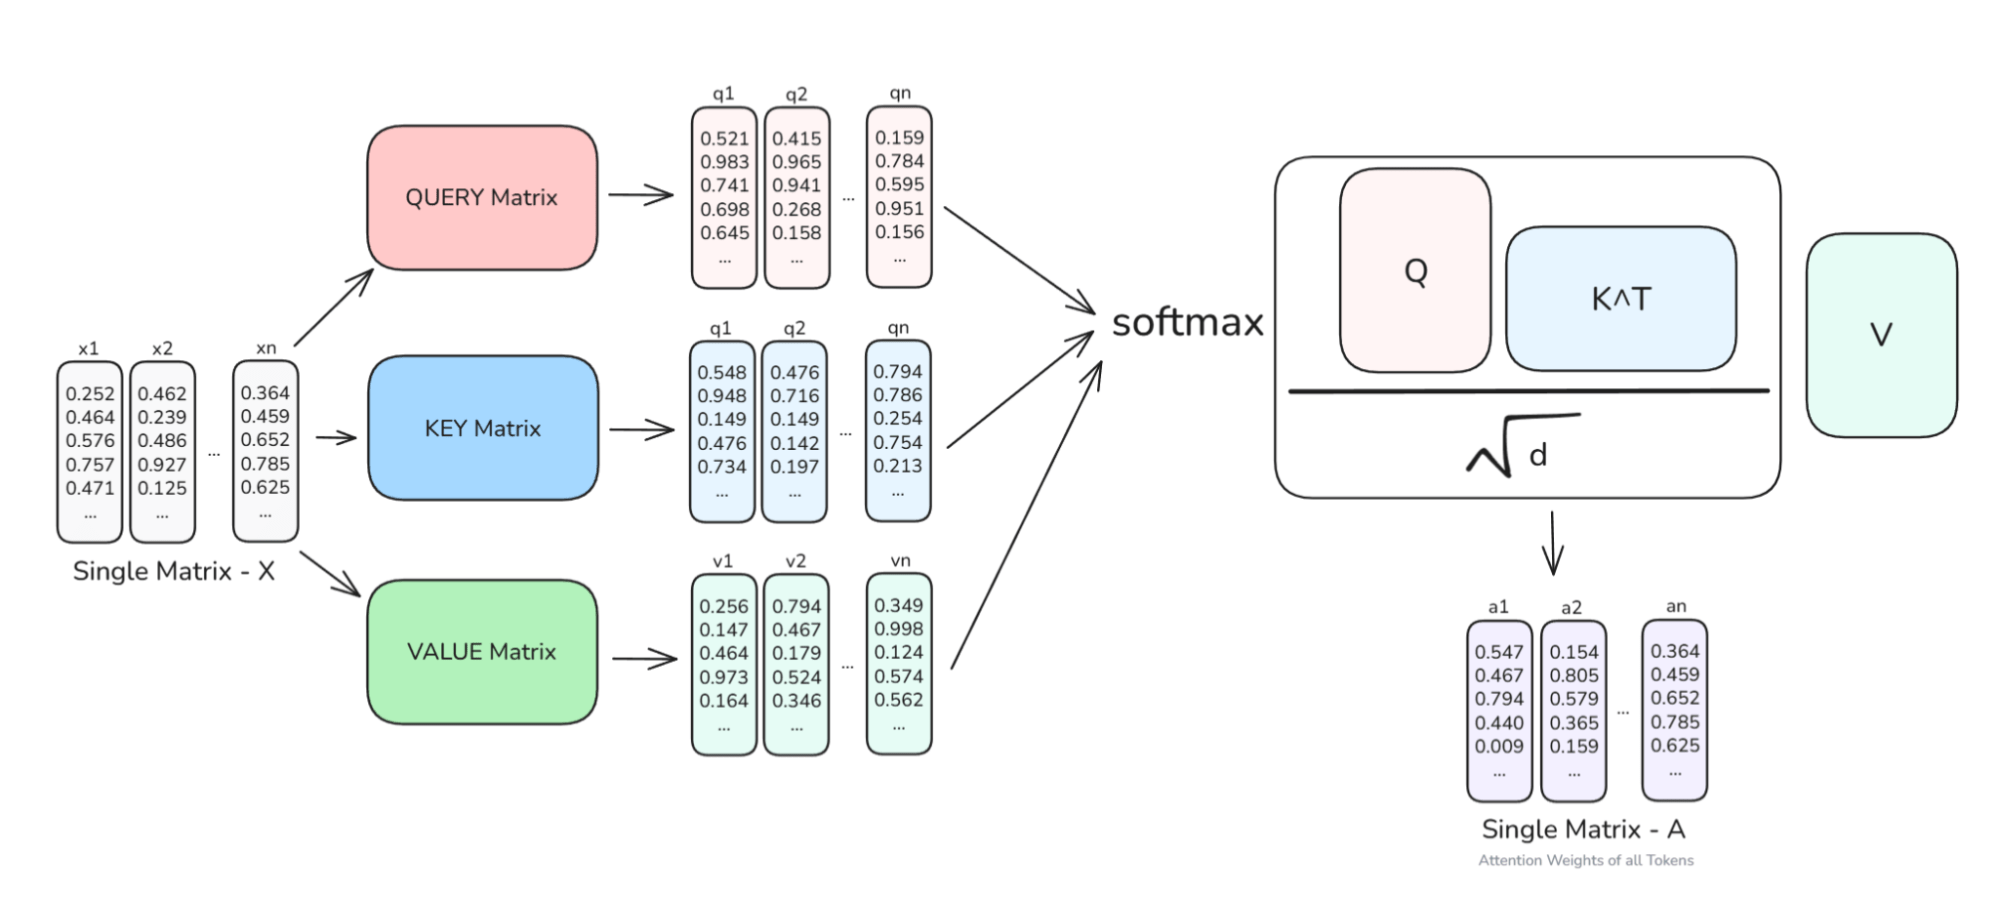
Para visualizarlo, mira el diagrama anterior. Verás que la matriz de entrada X se transforma en las matrices Query, Key y Value respectivas, y luego se aplica la fórmula de atención por producto punto escalado para obtener los embeddings enriquecidos de todos los tokens de nuestra entrada: A.
Ahora vamos a programar lo que acabamos de comentar en PyTorch. Sorprendentemente, es bastante sencillo:
import torchimport torch.nn.functional as Fdef scaled_dot_product_attention(Q, K, V): d_k = Q.size(-1) # the dimension of the key vectors scores = torch.matmul(Q, K.transpose(-2, -1)) / torch.sqrt(torch.tensor(d_k, dtype=torch.float32)) attn_weights = F.softmax(scores, dim=-1) output = torch.matmul(attn_weights, V) return output, attn_weightsCon una función sencilla, podemos replicar lo anterior. Aquí van los puntos clave:
Q, K y V son tensores con forma [batch_size, seq_len, dim]Hay, sin embargo, un detalle importante que aún no he mencionado. No existe un único tipo de atención en el Transformer: en realidad hay tres:
Cada una cumple un papel ligeramente distinto, así que las repasamos rápidamente.
Esto es lo que hemos explorado hasta ahora: en el encoder, cada token atiende a todos los demás tokens de la misma secuencia de entrada, como en el ejemplo “the cat sat on the mat”.
Lo importante aquí es que no hay restricciones, ya que toda la entrada se conoce de antemano, lo que permite al modelo construir representaciones contextuales profundas de cada token, entendiendo lo que viene antes y después.
Ten en cuenta también que esto sucede en el encoder.
Aquí se complica un poco. Como ahora estamos en el decoder, no queremos que cada token vea el futuro, porque eso sería hacer trampa durante la generación de texto.
Tomemos otro ejemplo: “The dog barked very loudly.” Cuando el modelo está generando “barked” (asumiendo, por simplicidad, que cada palabra es un token), no debería saber que el siguiente token es “very”; de lo contrario, no aprendería a generar nuevos tokens.
Para resolverlo aplicamos una máscara causal (a veces llamada máscara triangular) que se asegura de que cada token solo pueda atenderse a sí mismo y a los tokens anteriores, nunca a los que vienen después.
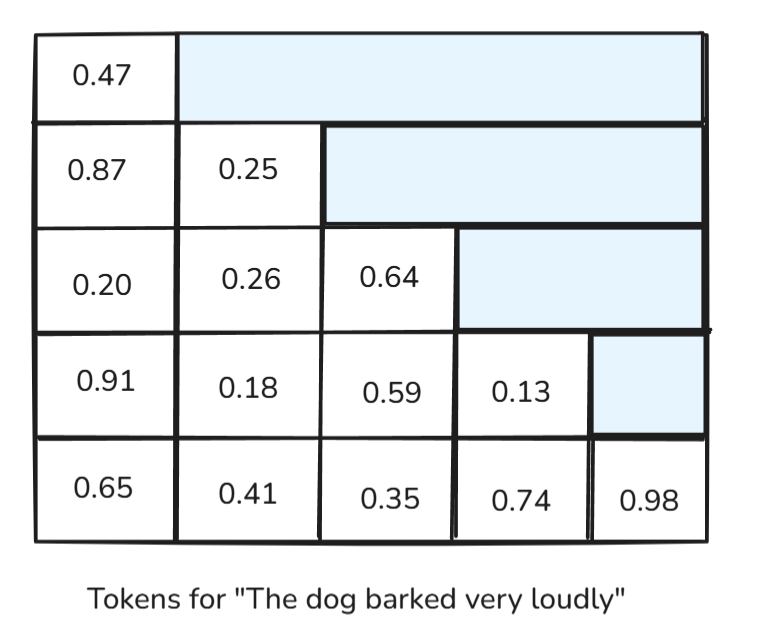
En el diagrama anterior vemos que las puntuaciones de atención hacia el futuro se eliminan enmascarándolas, lo que permite al modelo aprender a generar tokens nuevos, precisos y coherentes.
Una vez que el decoder empieza a generar, sigue necesitando la información de la entrada original (que es aquello a lo que responde). Aquí es donde aparece la cross attention.
Aquí, el decoder atiende a la salida del encoder. Así que mientras la autoatención del decoder está enmascarada, la cross attention no lo está, y el decoder puede mirar a todos los tokens del encoder a la vez.
Cuando aprendía este concepto, me gustó mucho el ejemplo de traducción. Imagina que estás traduciendo “Bonjour tout le monde” al inglés: el decoder debería poder mirar todas las palabras en francés mientras decide cada palabra en inglés, ¿verdad?
Eso es exactamente lo que hace la cross attention. No entraremos en más detalle aquí, porque no es necesario para el alcance de este artículo.
Ya entendemos cómo funciona la autoatención. Pero quizá te hagas esta pregunta:
Si ya tenemos atención, ¿por qué necesitamos varias cabezas?
Para esto me gusta la analogía de las linternas, que me ayudó mucho al principio.
Piensa en una sola cabeza de atención como una linterna que intenta iluminar las partes importantes de una frase. Pero una frase puede tener múltiples relaciones que entender: sujeto-verbo, objeto-pronombre, adjetivo-sustantivo, dependencias a largo plazo, etc.
¿No sería mejor capturar más de estas relaciones en lugar de solo una cada vez?
La solución es darle al modelo varias linternas, cada una enfocando partes distintas de la frase. Eso es la atención multi-cabeza.
En lugar de calcular un único conjunto de Q, K y V y ejecutar una sola atención, dividimos los embeddings en partes más pequeñas y ejecutamos varias cabezas independientes en paralelo.
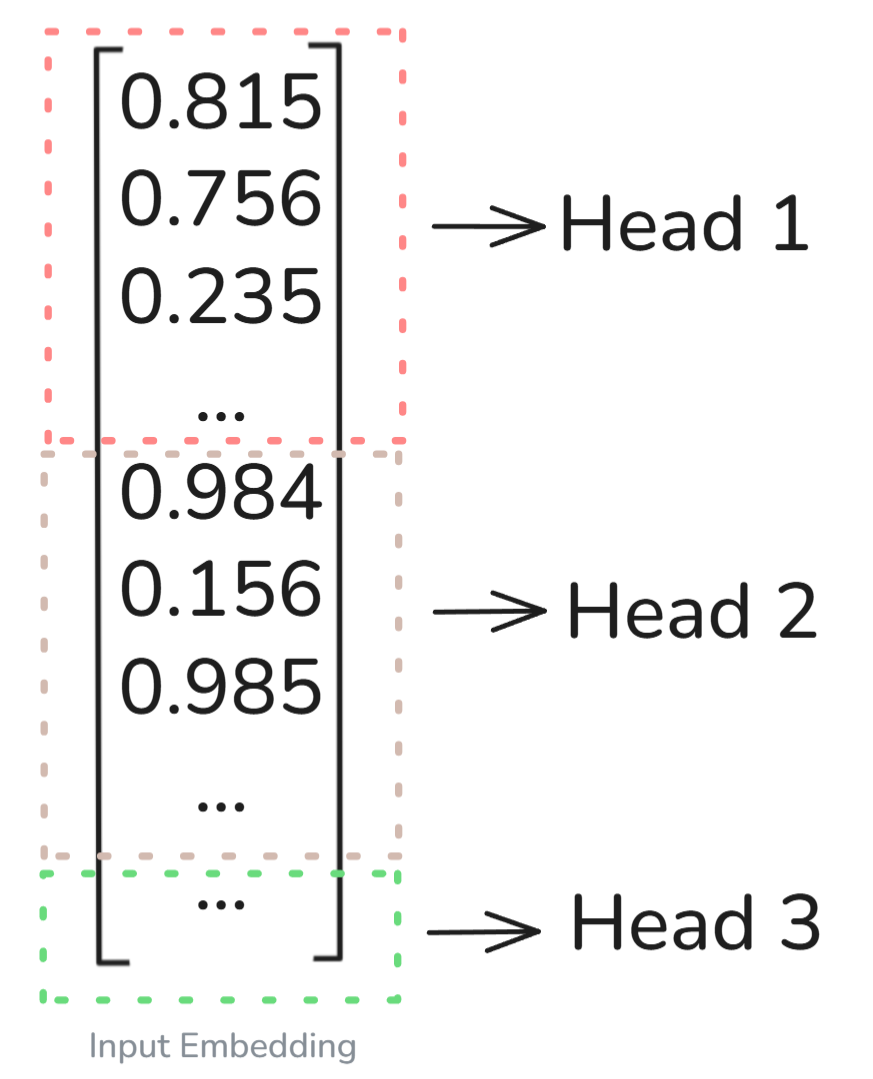
Como se ve en el diagrama, el embedding de entrada (para un único token en este caso, para simplificar) se divide de forma uniforme entre las n cabezas diferentes.
En nuestro ejemplo, supongamos que la dimensión era 512 y el número de cabezas 8; por tanto, cada cabeza procesará (512/8 = 64) dimensiones en paralelo, tratando de capturar relaciones distintas.
Para reforzar tu intuición sobre qué tipos de relaciones pueden (digo pueden porque aún no entendemos del todo qué mira cada cabeza) procesar estas cabezas, veamos un ejemplo sencillo:
Considera esta frase:
“The quick brown fox jumps over the lazy dog.”
Lo clave es que todas estas cabezas se ejecutan a la vez y sus salidas se concatenan y se proyectan de nuevo al tamaño original del embedding (en nuestro caso, 512).
Para afianzar completamente nuestra comprensión de la atención multi-cabeza, usemos la librería HuggingFace para ver cómo funciona este mecanismo.
!pip install transformers bertviz torchPrimero, ejecuta la celda anterior para descargar todos los paquetes necesarios.
from transformers import BertTokenizer, BertModelfrom bertviz import head_viewimport torchmodel_name = 'bert-base-uncased' # We will be using the Bert modelmodel = BertModel.from_pretrained(model_name, output_attentions=True)tokenizer = BertTokenizer.from_pretrained(model_name)model.eval() # As we are not training, we have set the model to evaluation mode so no updates are made# This is our input sentencesentence = "The quick brown fox jumps over the lazy dog."# Using the tokenizer to convert the sentence into tokensinputs = tokenizer(sentence, return_tensors='pt')input_ids = inputs['input_ids']# Forward pass with attentionswith torch.no_grad(): outputs = model(**inputs) attentions = outputs.attentions # Tuple of (num_layers, batch, num_heads, seq_len, seq_len)# Here we decode the tokens tokens = tokenizer.convert_ids_to_tokens(input_ids[0])head_view(attentions, tokens) # VisualizationLa salida que obtenemos se ve a continuación. Observa que hay 12 colores distintos, lo que significa que este modelo tiene 12 cabezas. El grosor de las líneas también se correlaciona con la magnitud de las puntuaciones de atención entre tokens.
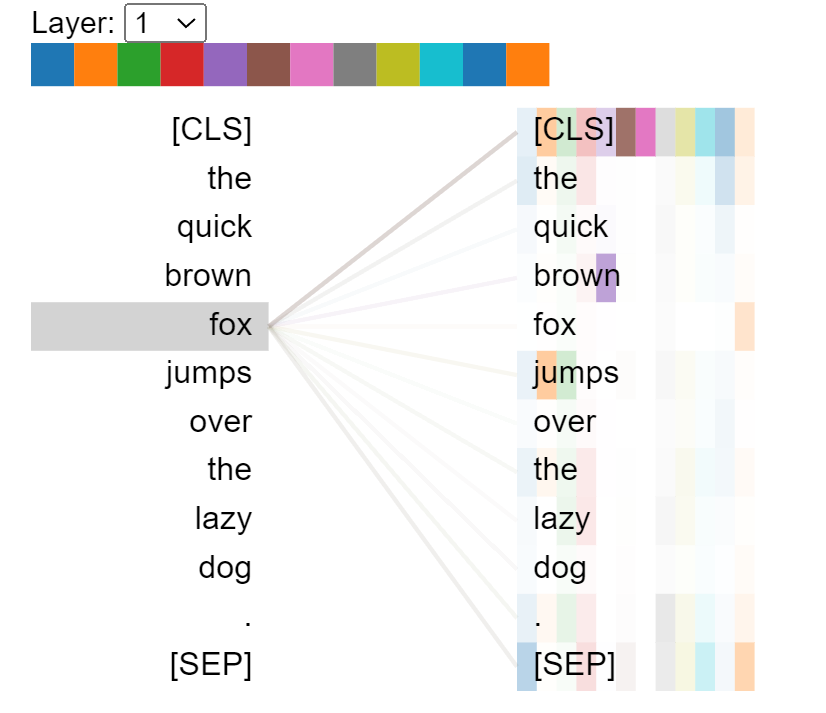
En esta sección, vamos a escribir el pseudocódigo del mecanismo de atención multi-cabeza. Supongamos primero que nuestra entrada X tiene forma [batch, seq_len, d_model].
Entonces podemos proceder con el pseudocódigo:
Q = X @ W_Q # Calculating the Query valuesK = X @ W_K # Calculating the Key valuesV = X @ W_V# Calculating the Value valuesQ_i, K_i, V_i = split_into_heads(Q, K, V, num_heads) # Now we split the Q,K,V into multiple different heads (by evenly splitting the dimensions)# Here we compute scaled dot-product attention for each headscores = (Q_i @ K_i.T) / sqrt(head_dim)scores += maskA_i = softmax(scores)A_i = dropout(A_i)Z_i = A_i @ V_iZ = concat_heads(Z_i) # We have to concatenate all of the Heads# This is our final linear projection matrixoutput = Z @ W_Ooutput = dropout(output)Todo esto ya debería sonarte, salvo quizá la matriz de proyección lineal final.
Repasémoslo rápidamente.
Después de que cada cabeza de atención termine su trabajo, sus salidas se concatenan de nuevo en un único vector. Pero esta salida combinada aún debe reajustarse a la dimensión original del modelo, y ahí entra la matriz de proyección lineal final. Simplemente mapea la salida concatenada al mismo tamaño que el embedding de entrada, para poder pasarla a la siguiente capa del Transformer.
Comentemos también algunas optimizaciones y buenas prácticas:
En cuanto a buenas prácticas, cuando implementemos la capa de atención, hay 3 hiperparámetros principales que debemos considerar:
num_heads: cuántas cabezas de atención ejecutar en paralelo; asegúrate de que divide de forma exacta d_model.head_dim: dimensión de cada cabeza.dropout_rate: para evitar sobreajuste.Hemos cubierto mucho en este artículo. Empezamos con una idea sencilla: la atención va de enfocar. Luego vimos cómo los Transformers usan ese enfoque calculando cómo se relaciona cada palabra con todas las demás mediante queries, keys y values.
Vimos cómo la autoatención (y de pasada otros tipos como la causal y la cross attention) da a cada token una representación rica y sensible al contexto. Y luego fuimos un paso más allá con la atención multi-cabeza, donde en lugar de confiar en una sola “linterna”, le damos al modelo varias, cada una capturando patrones diferentes a la vez.
Esto es lo que da a los Transformers su verdadera fuerza. No solo leen; comprenden la estructura, el significado y las relaciones subyacentes a lo largo de secuencias completas.
En este artículo hemos cubierto un aspecto de los Transformers, pero aún queda mucho por aprender, así que échale un vistazo a este curso completo y detallado: Transformer Models with PyTorch Course.
Si quieres pasar a la parte aplicada, también te recomiendo el proyecto Developing Multi-Input Models For OCR o el curso Working with HuggingFace. Si prefieres artículos, echa un vistazo a esta guía completa para construir un Transformer con PyTorch y a mi otra guía sobre Vision Transformers.
Los mejores cursos de DataCamp
Curso
Programa
Programa
blog
Natassha Selvaraj
15 min
blog
Abid Ali Awan
9 min
blog
Bhavishya Pandit
8 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Josep Ferrer
11 min
Tutorial
Arunn Thevapalan
12 min