Curso
Modelos Transformer com PyTorch
2 h
9K
O mecanismo de attention, mais especificamente a self-attention, foi apresentado pela primeira vez no famoso artigo “Attention is All You Need“, de Vaswani et al., em 2017.
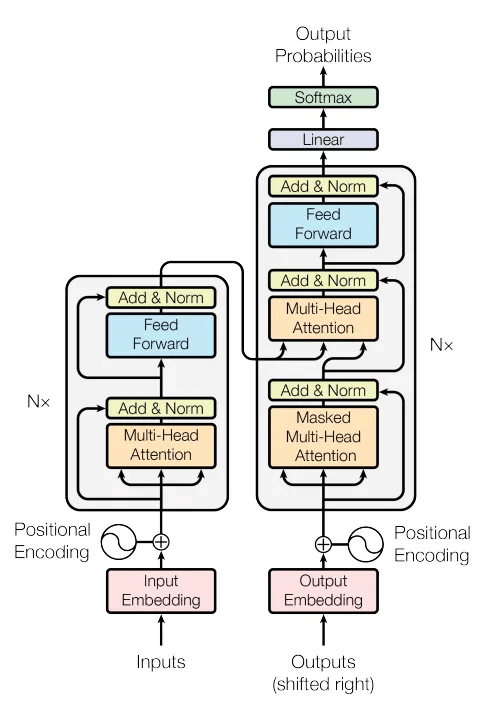
Esse mecanismo é o que impulsiona o modelo Transformer, que por sua vez alimenta alguns dos modelos mais poderosos que temos hoje, como LLMs e VLMs.
Então sim, isso é bem importante!
Mas aqui vai uma coisa: muita gente (e eu já fui uma delas!) acredita que a attention foi inventada em 2017.
Não foi.
O mecanismo original de attention foi apresentado em 2015, quando Bahdanau et al. o introduziram no contexto de tradução automática. A ideia foi permitir que o decodificador focasse em diferentes partes da frase de entrada a cada passo de decodificação, em vez de depender de um único vetor de contexto fixo.
Essa pequena mudança fez uma enorme diferença — e plantou a semente do que se tornaria a self-attention e, posteriormente, a multi-head attention.
Mas você pode estar com uma pergunta neste ponto:
“O que attention significa na prática?”
Vou apresentar esse conceito com duas frases simples:
A partir desses exemplos, dá para perceber o que a attention tenta fazer. É tudo sobre foco: ajudar o modelo a decidir quais outras palavras são relevantes para a palavra que ele está processando, muitas vezes com base no significado semântico ou em relações gramaticais.
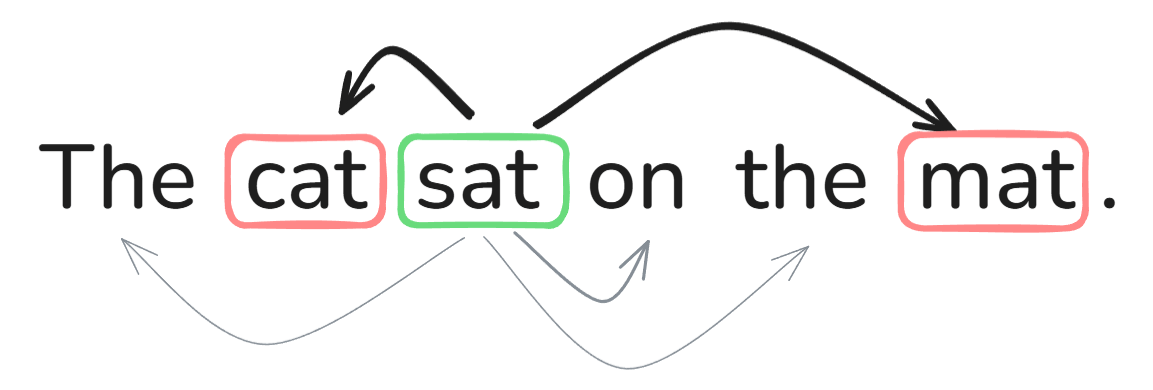
É importante notar que todos os tokens são usados no cálculo dos pesos e escores de attention (falaremos mais disso adiante), não apenas alguns específicos, como mostra o diagrama acima. Isso também significa que haverá atenções mais fortes entre algumas palavras do que entre outras, indicado pela espessura das setas.
É isso que torna os transformers tão bons em entender linguagem: eles usam attention para relacionar dinamicamente cada palavra com todas as outras.
Agora já entendemos o que é attention, mas ainda não sabemos como é o processamento interno.
É aqui que entram as Queries, as Keys e os Values (comumente abreviados como Q, K e V). No restante do artigo, vamos manter o exemplo da frase “the cat sat on the mat”.
Primeiro, quando uma frase entra no Transformer, ela é imediatamente tokenizada por um tokenizer; um tokenizer bastante conhecido é o Byte-Pair Encoding.
Podemos pensar na tokenização como dividir o texto em unidades menores. Como todas as palavras da nossa frase são bem curtas, neste exemplo podemos assumir que cada unidade equivale a uma palavra. Visualmente, a frase após passar pelo tokenizer fica assim:
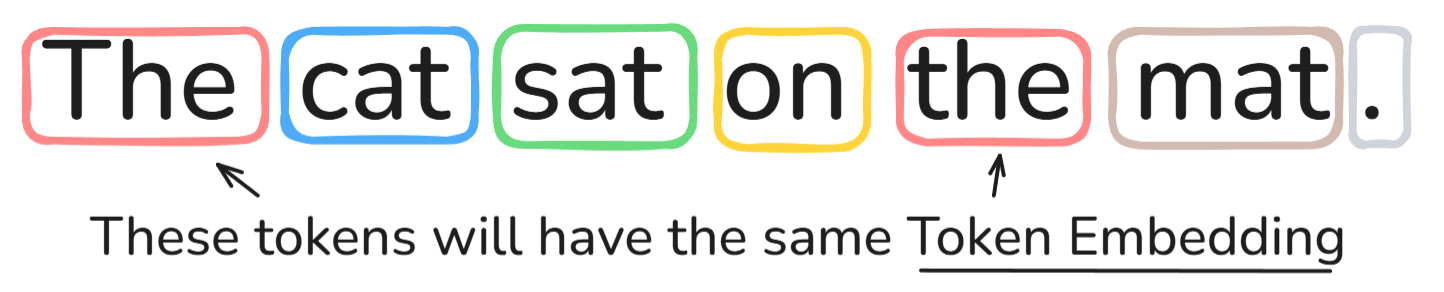
Note que até a pontuação (ponto final) foi convertida em um token. Novamente, para simplificar, estamos assumindo que o ponto final é um token separado.
Após a tokenização, usamos o vocabulário do tokenizer para converter cada token no seu respectivo Token ID. Você pode imaginar o vocabulário como uma tabela que contém todos os tokens que o modelo reconhece e seus respectivos IDs.
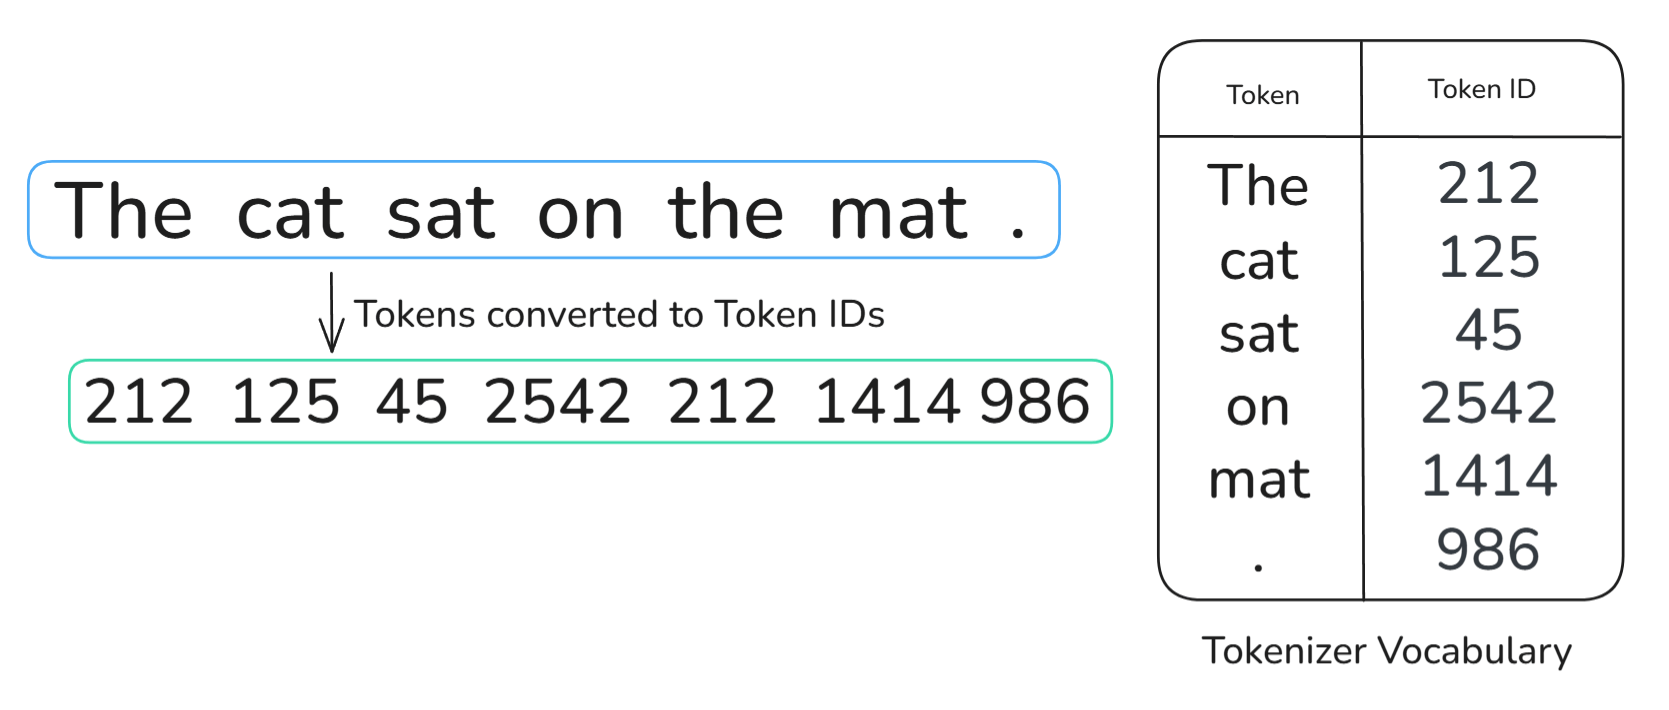
Em seguida, cada um desses Token IDs únicos é mapeado para seu embedding usando uma matriz de embeddings. É importante notar que todos esses embeddings terão vetores da mesma dimensão; no nosso exemplo, estamos assumindo 512.
A última etapa é adicionar o positional embedding para que o modelo saiba a posição de cada token. Os dois métodos mais comuns são:
A mecânica detalhada desses positional embeddings foge ao escopo deste tutorial. O que precisamos saber agora é que obtemos nossos vetores de entrada pela fórmula:
Vetor de entrada = Token Embedding + Positional Embedding
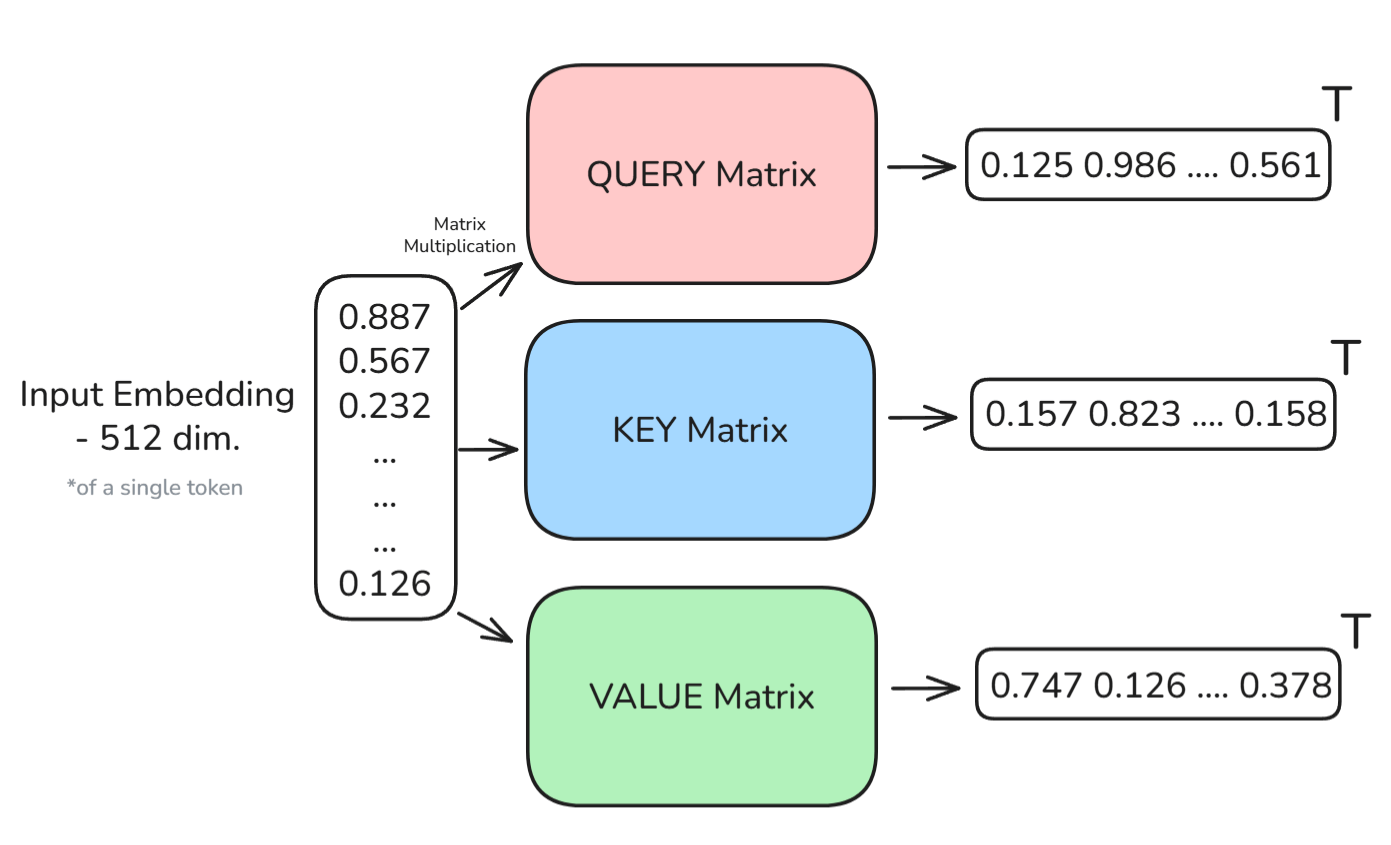
Agora sim, prontos para introduzir os vetores Q, K e V. Para cada palavra na entrada, criamos três vetores:
Essas transformações são aprendidas e correspondem às suas respectivas matrizes. Matematicamente, escrevemos assim:
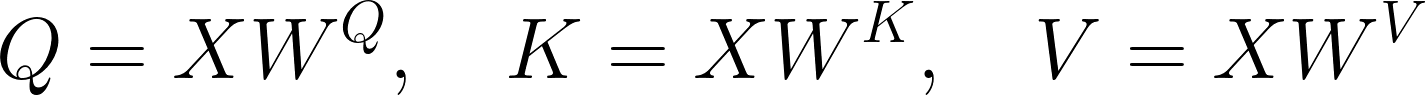
A partir disso, cada token passa a ser representado por três novos vetores. Criei o diagrama abaixo para ajudar a visualizar o processo:
No artigo “Attention is All You Need”, foi apresentada uma fórmula mostrando como os novos vetores são usados para calcular os pesos de attention. Vamos passar por ela passo a passo, assumindo que estamos calculando os pesos quando estamos em “sat”:
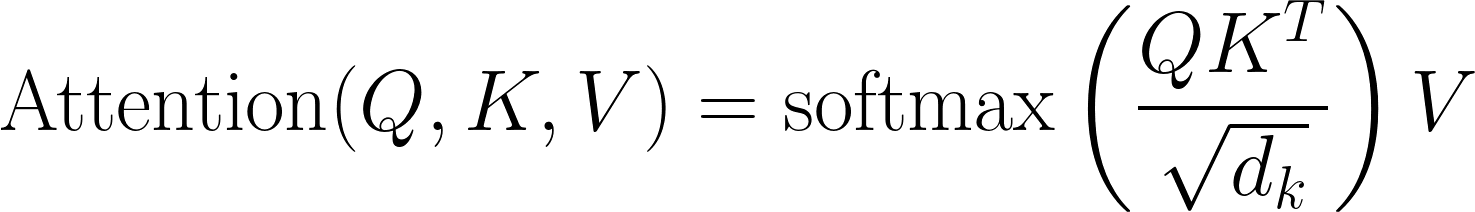
Para começar, usamos o vetor Query de “sat” para comparar com os vetores Key de todas as outras palavras — incluindo ele mesmo. O resultado é um conjunto de escores de similaridade (escalares) que indicam quão relevante cada palavra é para “sat”. Formalmente, chamamos isso de Attention Scores.
Esses escores são então escalados por sqrt(d_k) para evitar valores muito grandes e ajudar a estabilizar os gradientes durante o treinamento por backpropagation. Esses escores escalonados passam por um softmax, virando pesos de attention.
O softmax nos dá uma probabilidade que informa ao modelo quanto peso atribuir a cada palavra; portanto, os pesos de attention de um token específico somam 1.
Por fim, fazemos uma soma ponderada dos vetores value usando esses pesos de attention.
Isso nos dá um novo vetor que representa “sat” em contexto, enriquecido pela informação de todos os tokens, mas principalmente de cat, mat e quaisquer outros tokens relevantes.
Esse processo ocorre para cada token da frase. Cada token presta atenção a todos os outros tokens — e a si mesmo. É por isso que chamamos de self-attention.
Observe também que calculamos o novo vetor enriquecido para um único token, mas, na prática, fazemos isso para muitos — senão todos — de uma vez, já que a multiplicação de matrizes é extremamente eficiente.
Conseguimos fazer isso porque a arquitetura é totalmente paralelizável. Diferente das redes neurais recorrentes (RNNs), que processam sequencialmente, esse mecanismo permite que os Transformers processem todos os tokens ao mesmo tempo, tornando-os rápidos e poderosos.
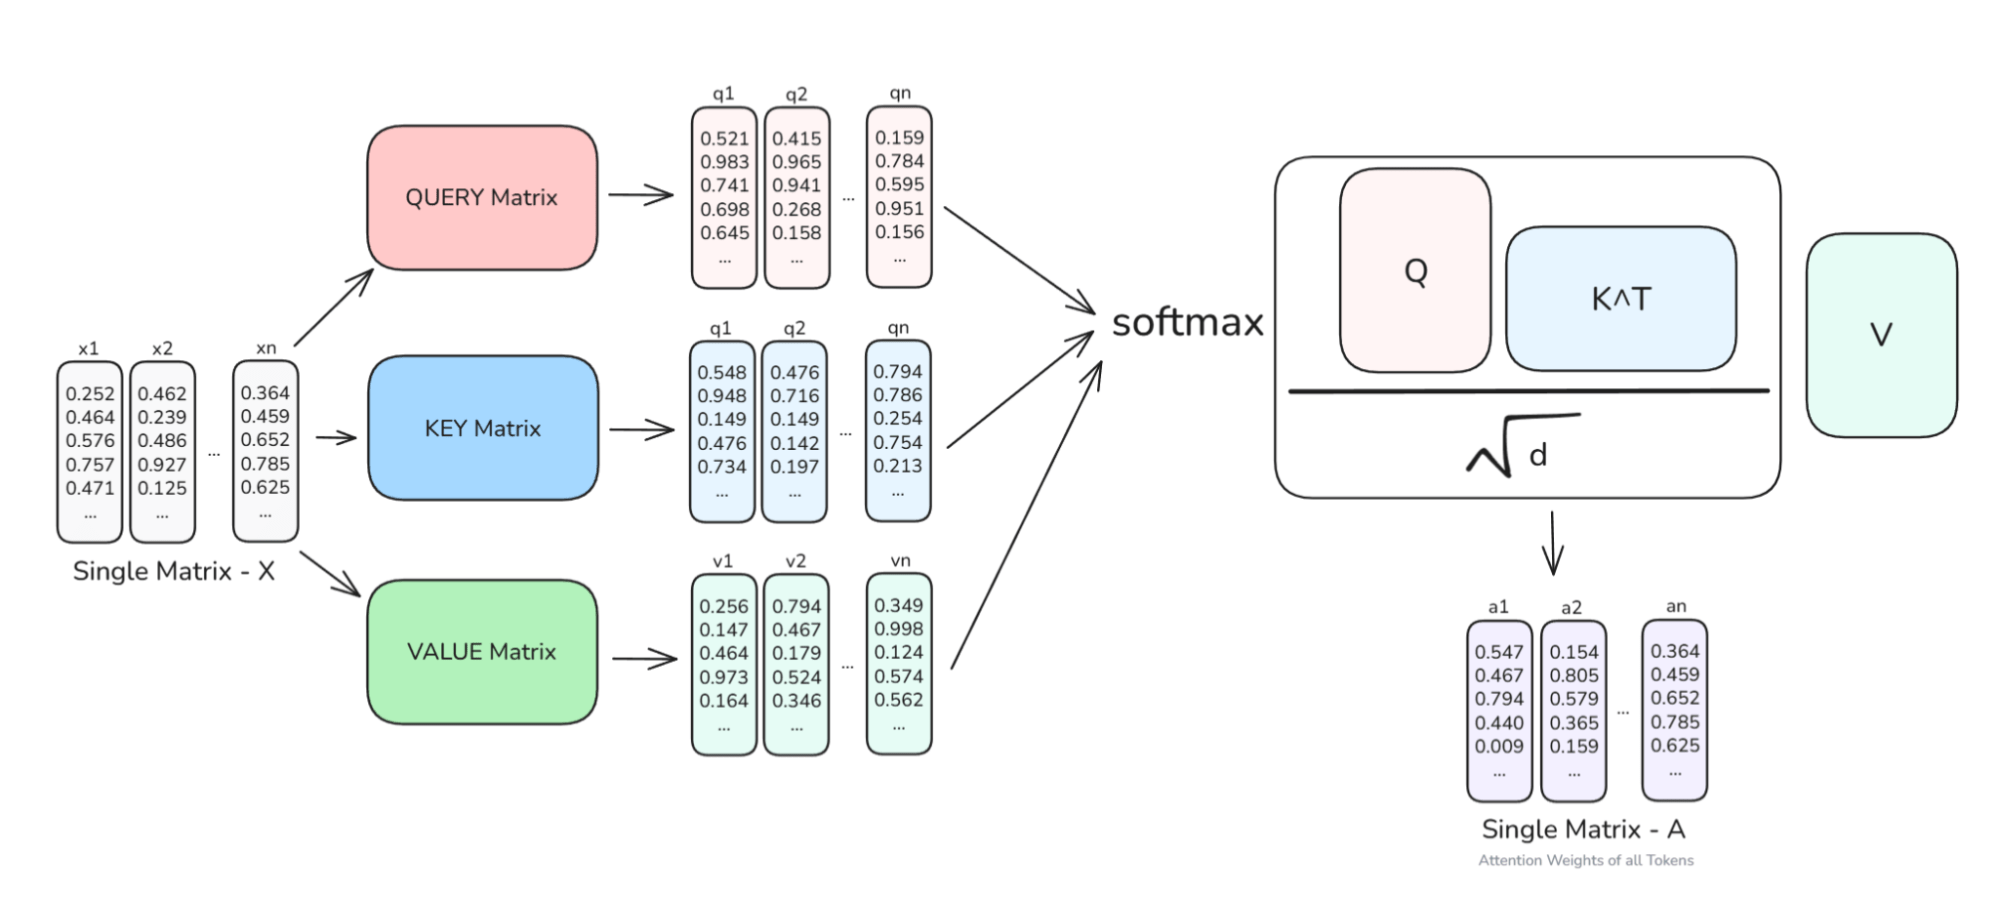
Para ajudar a visualizar, observe o diagrama acima. Você vê que a matriz de entrada X é transformada nas respectivas matrizes de Query, Key e Value e, em seguida, aplicamos a fórmula de scaled dot-product attention para obter os vetores de embedding enriquecidos de todos os tokens da entrada — A.
Agora vamos codificar o que acabamos de discutir em PyTorch. Surpreendentemente, é bem simples:
import torchimport torch.nn.functional as Fdef scaled_dot_product_attention(Q, K, V): d_k = Q.size(-1) # the dimension of the key vectors scores = torch.matmul(Q, K.transpose(-2, -1)) / torch.sqrt(torch.tensor(d_k, dtype=torch.float32)) attn_weights = F.softmax(scores, dim=-1) output = torch.matmul(attn_weights, V) return output, attn_weightsCom uma função simples, conseguimos reproduzir tudo o que vimos acima! Pontos mais importantes:
Q, K e V são tensores com forma [batch_size, seq_len, dim]Existe, porém, um detalhe importante que ainda não mencionei. Não há apenas um tipo de attention no Transformer — na verdade, há três:
Cada uma cumpre um papel ligeiramente diferente, então vamos passar rapidamente por elas.
É o que exploramos até aqui: no encoder, cada token presta atenção a todos os outros tokens da mesma sequência de entrada — como no exemplo “the cat sat on the mat”.
O ponto importante aqui é que não há restrição, já que toda a entrada é conhecida antecipadamente. Isso permite ao modelo construir representações contextuais profundas de cada token, entendendo o que vem antes e depois.
Lembre também que isso acontece no encoder.
Aqui a coisa complica um pouco. Como agora estamos no decoder, não queremos que cada token veja o futuro, pois isso seria “colar” durante a geração de texto.
Vamos a outro exemplo: “The dog barked very loudly.” Quando o modelo está gerando “barked” (assumindo cada palavra como um token, para simplificar), ele não deveria saber que o próximo token é “very”, caso contrário não estaria aprendendo a gerar novos tokens.
Para resolver isso, aplicamos uma máscara causal (às vezes chamada de máscara triangular), garantindo que cada token só possa prestar atenção a si mesmo e aos tokens anteriores — nunca aos seguintes.
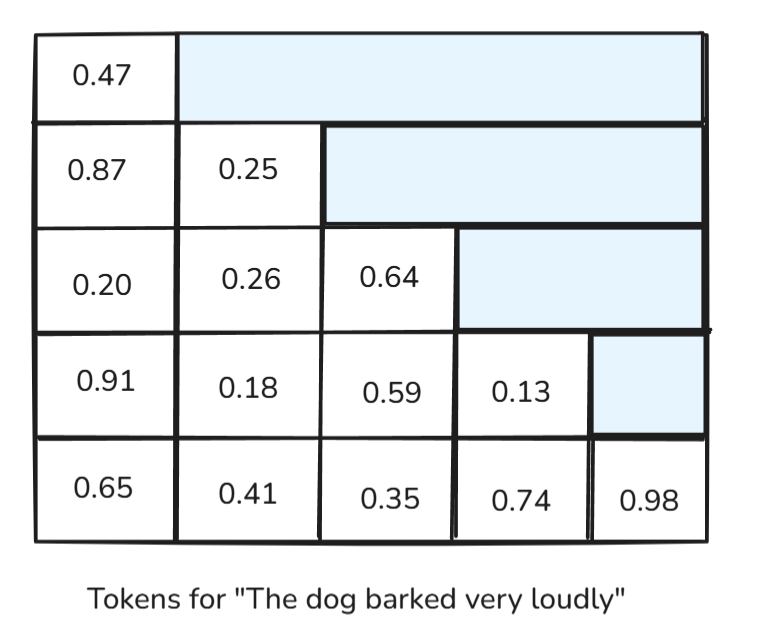
No diagrama acima, vemos que os escores de attention para o futuro são removidos pela máscara, permitindo que o modelo aprenda a gerar tokens novos, precisos e coerentes.
Quando o decoder começa a gerar, ele ainda precisa da informação da entrada original (para a qual está respondendo). É aqui que entra a cross-attention.
Aqui, o decoder presta atenção à saída do encoder. Enquanto a self-attention do decoder é mascarada, a cross-attention não é — e, por isso, o decoder pode olhar para todos os tokens do encoder de uma vez.
Quando eu estava aprendendo esse conceito, gostei muito do exemplo de tradução. Imagine traduzir “Bonjour tout le monde” para inglês: o decoder deve conseguir olhar para todas as palavras em francês enquanto decide cada palavra em inglês, certo?
É exatamente isso que a cross-attention faz. No entanto, não vamos nos aprofundar nela aqui, pois não é necessário para o escopo deste artigo.
Agora entendemos como a self-attention funciona. Mas surge a pergunta:
Se já temos attention, por que precisamos de múltiplas cabeças?
Para isso, gosto da analogia da lanterna, que ajudou muito a minha intuição quando comecei a aprender.
Pense em uma única cabeça de attention como uma lanterna tentando iluminar as partes importantes de uma frase. Mas uma frase tem múltiplos tipos de relações a entender: sujeito–verbo, objeto–pronome, adjetivo–substantivo, dependências de longo alcance etc.
Não seria melhor capturar várias dessas relações em vez de apenas uma por vez?
A solução é dar ao modelo várias lanternas, cada uma focando em partes diferentes da frase. Isso é a multi-head attention.
Em vez de calcular um único conjunto de Q, K, V e rodar uma única atenção, dividimos os embeddings em partes menores e executamos várias cabeças independentes de attention em paralelo.
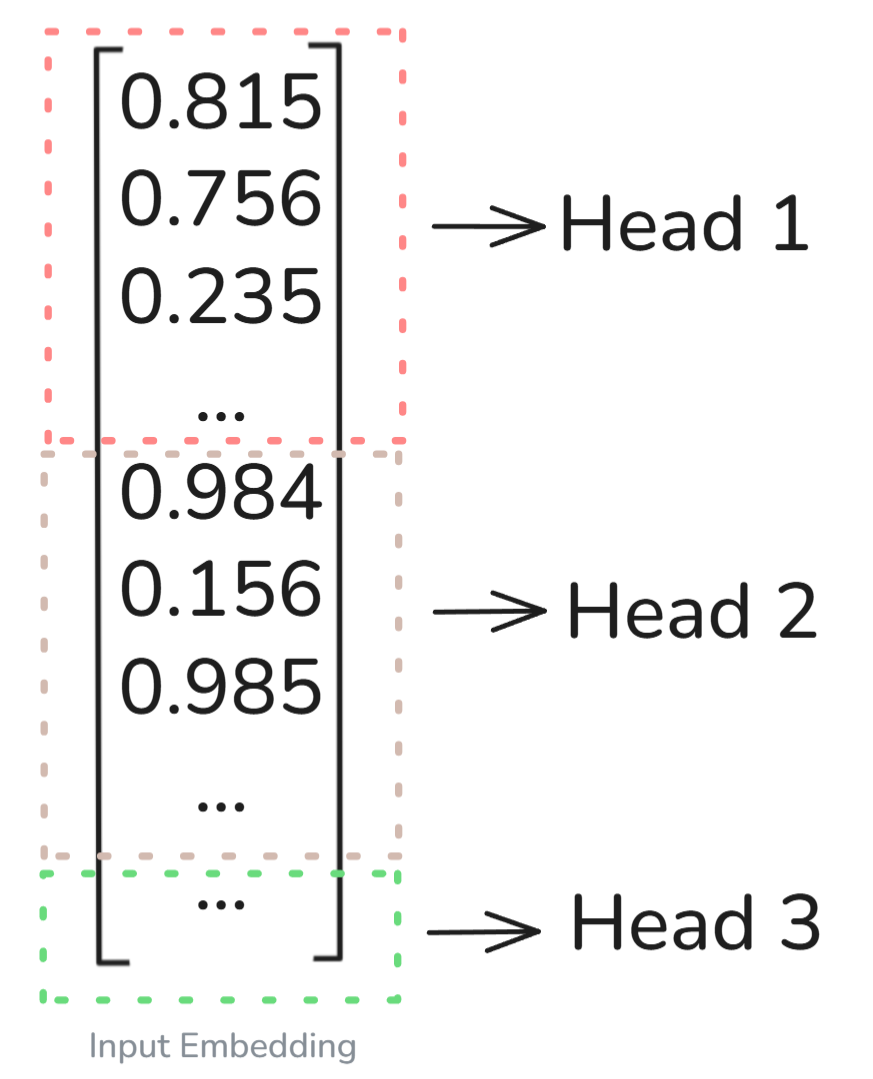
Como mostra o diagrama acima, o embedding de entrada (para um único token, para simplificar) foi dividido igualmente entre as n cabeças diferentes.
No nosso exemplo, vamos assumir dimensão 512 e 8 cabeças; portanto, cada cabeça processa (512/8 = 64) dimensões em paralelo, tentando capturar relações diferentes.
Para reforçar sua intuição sobre que tipos de relações essas cabeças podem (eu digo “podem” porque ainda não entendemos totalmente o que cada cabeça foca) processar, vamos a um exemplo simples:
Considere a frase:
“The quick brown fox jumps over the lazy dog.”
O ponto principal é que todas essas cabeças rodam simultaneamente, e suas saídas são concatenadas e projetadas de volta para o tamanho original do embedding (no nosso caso, 512).
Para consolidar de vez nosso entendimento de Multi-Head Attention, vamos usar a biblioteca HuggingFace para ver como o mecanismo funciona na prática.
!pip install transformers bertviz torchPrimeiro, execute a célula acima para baixar todos os pacotes necessários.
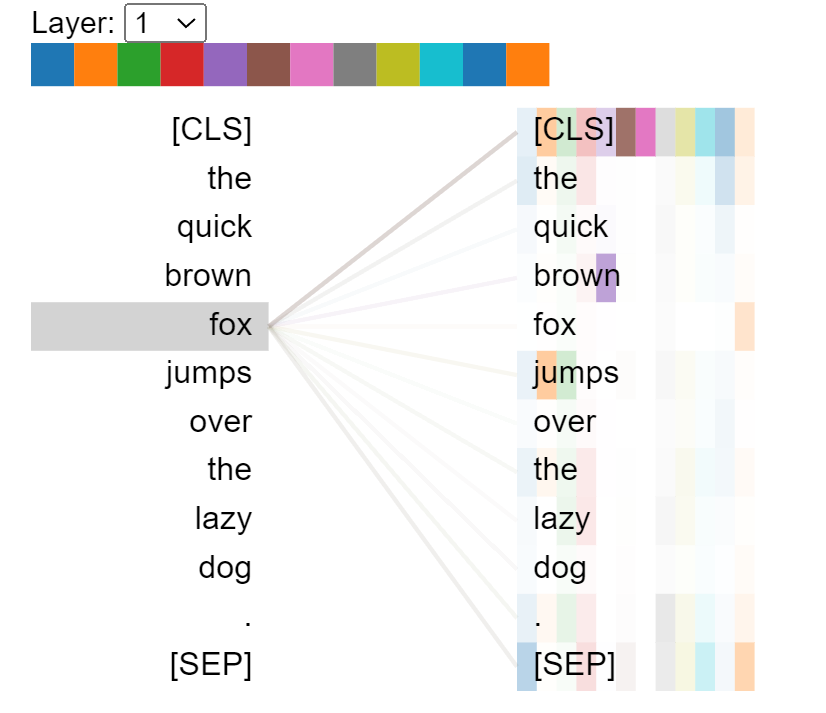
from transformers import BertTokenizer, BertModelfrom bertviz import head_viewimport torchmodel_name = 'bert-base-uncased' # We will be using the Bert modelmodel = BertModel.from_pretrained(model_name, output_attentions=True)tokenizer = BertTokenizer.from_pretrained(model_name)model.eval() # As we are not training, we have set the model to evaluation mode so no updates are made# This is our input sentencesentence = "The quick brown fox jumps over the lazy dog."# Using the tokenizer to convert the sentence into tokensinputs = tokenizer(sentence, return_tensors='pt')input_ids = inputs['input_ids']# Forward pass with attentionswith torch.no_grad(): outputs = model(**inputs) attentions = outputs.attentions # Tuple of (num_layers, batch, num_heads, seq_len, seq_len)# Here we decode the tokens tokens = tokenizer.convert_ids_to_tokens(input_ids[0])head_view(attentions, tokens) # VisualizationA saída pode ser vista abaixo. Repare que há 12 cores diferentes, indicando 12 cabeças nesse modelo. A espessura das linhas também se correlaciona com a magnitude dos escores de attention entre os tokens.
Nesta seção, vamos escrever o pseudocódigo do mecanismo de Multi-Head Attention. Vamos assumir que nossa entrada X tem forma [batch, seq_len, d_model].
Então, seguimos com o pseudocódigo:
Q = X @ W_Q # Calculating the Query valuesK = X @ W_K # Calculating the Key valuesV = X @ W_V# Calculating the Value valuesQ_i, K_i, V_i = split_into_heads(Q, K, V, num_heads) # Now we split the Q,K,V into multiple different heads (by evenly splitting the dimensions)# Here we compute scaled dot-product attention for each headscores = (Q_i @ K_i.T) / sqrt(head_dim)scores += maskA_i = softmax(scores)A_i = dropout(A_i)Z_i = A_i @ V_iZ = concat_heads(Z_i) # We have to concatenate all of the Heads# This is our final linear projection matrixoutput = Z @ W_Ooutput = dropout(output)Tudo isso já deve soar familiar, exceto talvez a matriz linear de projeção final.
Vamos recapitular rapidamente.
Depois que todas as cabeças de attention terminam seu trabalho, suas saídas são concatenadas em um único vetor. Mas esse resultado combinado ainda precisa ser remodelado para a dimensão original do modelo — e é aí que entra a matriz de projeção linear final. Ela simplesmente mapeia a saída concatenada de volta para o mesmo tamanho do embedding de entrada, para que possa ser passada à próxima camada do Transformer.
Algumas otimizações e boas práticas:
Quanto às boas práticas, ao implementar a camada de attention, há 3 hiperparâmetros principais a observar:
num_heads: quantas cabeças de attention rodar em paralelo — certifique-se de que divide igualmente d_model.head_dim: dimensão de cada cabeça.dropout_rate: para evitar overfitting.Vimos bastante coisa neste artigo. Começamos com uma ideia simples: attention é sobre foco. Depois, exploramos como os Transformers usam esse foco ao calcular como cada palavra se relaciona com todas as outras, usando Queries, Keys e Values.
Vimos como a self-attention (e, brevemente, outras variantes como a causal e a cross-attention) dá a cada token uma representação rica e sensível ao contexto. E fomos além com a multi-head attention, onde, em vez de depender de uma única “lanterna”, damos ao modelo várias, cada uma capturando padrões diferentes da frase ao mesmo tempo.
É isso que dá aos Transformers seu verdadeiro poder. Eles não apenas leem; eles entendem a estrutura, o significado e as relações ao longo de sequências inteiras.
Aqui, cobrimos um aspecto dos Transformers, mas ainda há muito para aprender. Confira este curso completo e detalhado: Transformer Models with PyTorch Course.
Se você quer ir direto para as aplicações, recomendo o projeto Developing Multi-Input Models For OCR ou o curso Working with HuggingFace. Se preferir artigos, confira este guia completo e intuitivo para construir um Transformer com PyTorch e meu outro guia sobre Vision Transformers.
Principais cursos da DataCamp
Curso
Programa
Programa
blog
Stanislav Karzhev
12 min
blog
Natassha Selvaraj
15 min
Tutorial
Josep Ferrer
11 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Zoumana Keita
8 min
Tutorial
Sejal Jaiswal
15 min