
Cours
Modèles Transformer avec PyTorch
2 h
9K
Nous savons tous que les Transformers sont devenus incontournables en traitement du langage naturel et qu'ils s'imposent maintenant en vision par ordinateur. Les Vision Transformers (ViT) proposent une approche inédite de la compréhension d'image, en appliquant les mêmes principes que les modèles pour le texte ; Large Language Models.
Les ViT ont été introduits pour la première fois en 2020 par Google Research dans l'article « An Image is Worth 16×16 Words », démontrant que des transformers entraînés sur de grands jeux d'images peuvent égaler voire dépasser les CNN. Depuis, des variantes pratiques comme DeiT et Swin ont élargi leur usage à de nombreuses tâches de vision.
Dans ce tutoriel, je vous guide à travers les concepts clés, les composants de l'architecture et les applications pratiques des vision transformers (la variante « vanilla » d'origine). À la fin, vous comprendrez non seulement le fonctionnement des ViT, mais aussi comment les implémenter dans vos projets de vision par ordinateur. Je vous recommande également de consulter mon autre guide sur l'attention multi-têtes.
Commençons par une introduction en douceur aux vision transformers.
Ces modèles considèrent une image comme une séquence de données, comme un modèle de langage traite les mots d'une phrase. L'image est ensuite divisée en patches de taille fixe, chacun étant aplati et incorporé dans un vecteur.
Ces vecteurs sont ensuite passés dans un encodeur transformer standard, qui modélise globalement les relations entre patches via le mécanisme d'attention.
C'est fondamentalement différent des réseaux de neurones convolutionnels (CNN), qui se concentrent sur des caractéristiques locales et s'appuient sur une extraction hiérarchique des features.
Puisque nous parlons de CNN, voyons quelles sont les différences avec les ViT :
|
Caractéristique |
Convolutional Neural Networks (CNN) |
Vision Transformers (ViT) |
|
Architecture |
Couches convolution + pooling |
Encodeur Transformer avec auto-attention |
|
Champ récepteur |
Local, s'étend avec la profondeur |
Global dès le départ |
|
Information de position |
Implicite via la structure |
Explicite via des encodages positionnels |
|
Besoins en données |
Plutôt efficaces avec de petits jeux de données |
Nécessitent des jeux de données à grande échelle |
|
Biais inductif |
Fort |
Minimal mais plus flexible |
|
Potentiel de parallélisation |
Modéré |
Très élevé |
|
Montée en charge du modèle |
Moins adaptés aux très grands modèles |
Hautement scalables |
|
Interprétabilité |
Via les couches de pooling, mais reste difficile |
Peut être améliorée avec la visualisation de l'attention, mais reste difficile |
Évidemment, nous n'avons pas encore couvert les vision transformers en détail, mais il est utile d'aborder quelques points qui peuvent ne pas être évidents d'emblée.
Par exemple, les termes biais inductif et champ récepteur sont importants mais vous ne les avez peut-être jamais rencontrés.
Le biais inductif correspond aux hypothèses qu'un modèle formule pour faciliter son apprentissage à partir des données. Cela peut sembler abstrait, mais l'analogie suivante devrait éclairer le concept.
Imaginez que nous réalisons ensemble un puzzle. Nous supposons que les pièces s'emboîtent en fonction de leur forme et de leur couleur. Cette hypothèse nous aide à reconstituer plus vite. C'est ainsi qu'un CNN fonctionne.
Il fait des hypothèses judicieuses, par exemple que des parties proches dans une image sont liées, comme des pièces voisines appartenant à la même zone de l'image. Il suppose aussi que si l'on déplace une forme, elle reste la même. Ces hypothèses utiles sont des biais inductifs forts.
Maintenant, imaginez qu'on nous donne un tas de pièces sans savoir à quoi ressemble l'image finale. Nous ne savons pas s'il faut se fier à la forme, à la couleur ou à tout autre indice. Nous essayons donc différentes approches et apprenons progressivement ce qui fonctionne.
C'est ce que fait un modèle Transformer. Il ne fait pas d'hypothèses fortes. Il apprend des motifs en observant beaucoup de données. On parle de biais inductif minimal. Cela offre plus de liberté au modèle, mais exige davantage de données et de temps d'apprentissage.
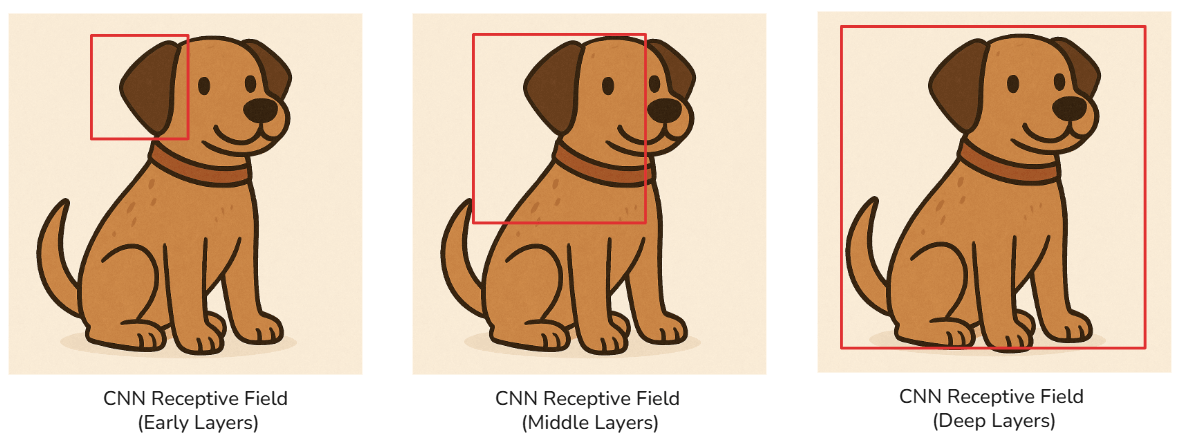
L'image ci-dessus montre comment évolue le champ récepteur d'un CNN. Rappelez-vous : un CNN comporte plusieurs couches convolutionnelles, et plus on va en profondeur, plus chaque neurone est influencé par une région étendue de l'entrée.
Cet agrandissement du champ récepteur permet aux couches profondes de détecter des caractéristiques plus complexes et globales, comme illustré (de l'oreille au visage, puis au chien entier).
C'est très différent du champ récepteur d'un Vision Transformer :
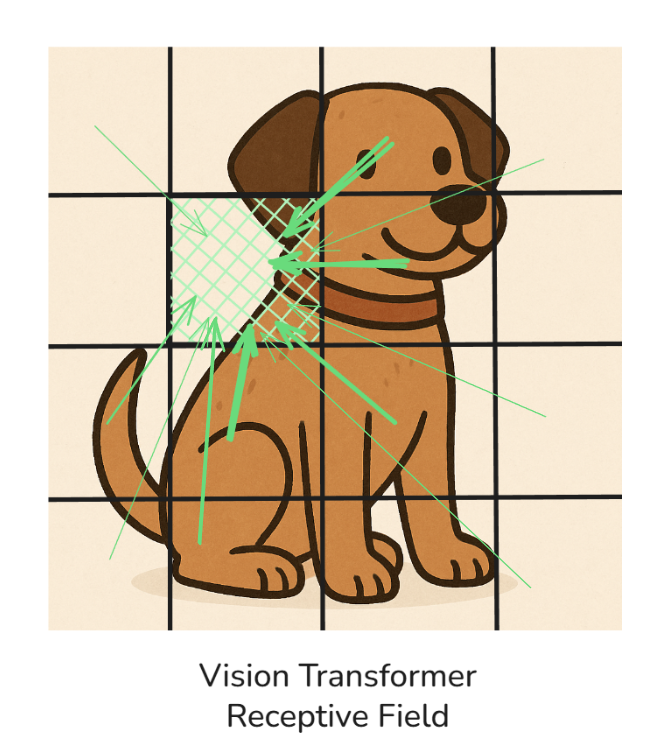
Dans l'illustration ci-dessus, on voit que le champ récepteur d'un ViT (vanilla) est global : tous les patches s'attendent mutuellement avec des intensités différentes (représentées par l'épaisseur des flèches).
Par simplicité, j'ai montré que le patch (en vert) est pris en compte par les autres patches, mais en réalité, tous les patches s'attendent entre eux (ce serait illisible à dessiner !).
Savoir quand utiliser un CNN ou un vision transformer est essentiel pour faire des choix architecturaux efficaces dans nos workflows de vision par ordinateur.
Les deux familles ont leurs forces (et leurs faiblesses !) et performent différemment selon la taille des données, les ressources de calcul et la complexité des motifs visuels à modéliser.
Voici les points auxquels je me réfère pour trancher :
Privilégiez les CNN lorsque :
Optez pour les Vision Transformers lorsque :
En résumé, si vous évoluez dans un environnement contraint en ressources ou que vous avez besoin de résultats rapides et fiables avec peu de données, les CNN sont le choix le plus sûr et le plus efficace.
En revanche, si votre projet exige un raisonnement global approfondi sur l'espace visuel et que vous avez la puissance de calcul nécessaire, les vision transformers sont préférables.
Plongeons maintenant dans l'architecture du Vision Transformer. Comme elle comporte plusieurs étapes (cinq pour être précis), explorons-les une à une.
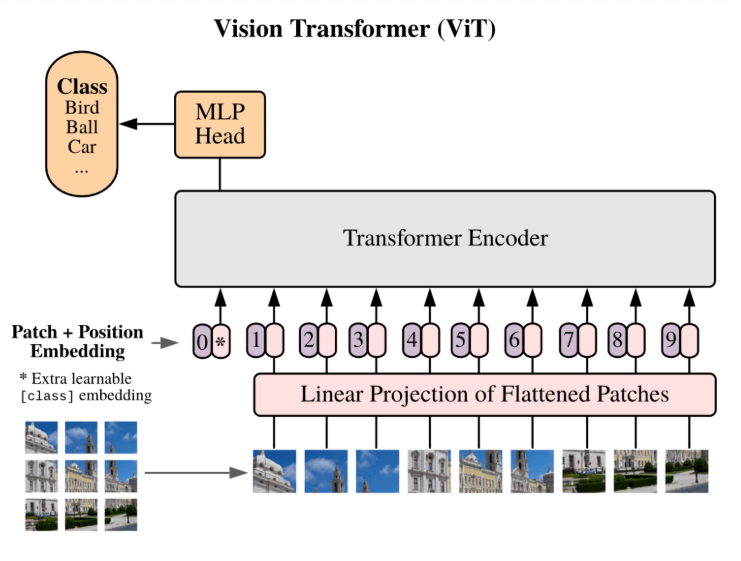
C'est la première transformation : convertir une image dans un format compréhensible par le transformer.
Supposons une image 224×224. Plutôt que de l'utiliser telle quelle, on la découpe en patches de taille fixe. Si chaque patch fait 16×16 (comme dans l'article initial), on obtient 14×14 = 196 patches (224/16 = 14).
On peut voir cela comme le découpage d'une photo en carrés parfaitement égaux. Chaque patch contient une information localisée et joue le rôle d'un « mot » dans une phrase.
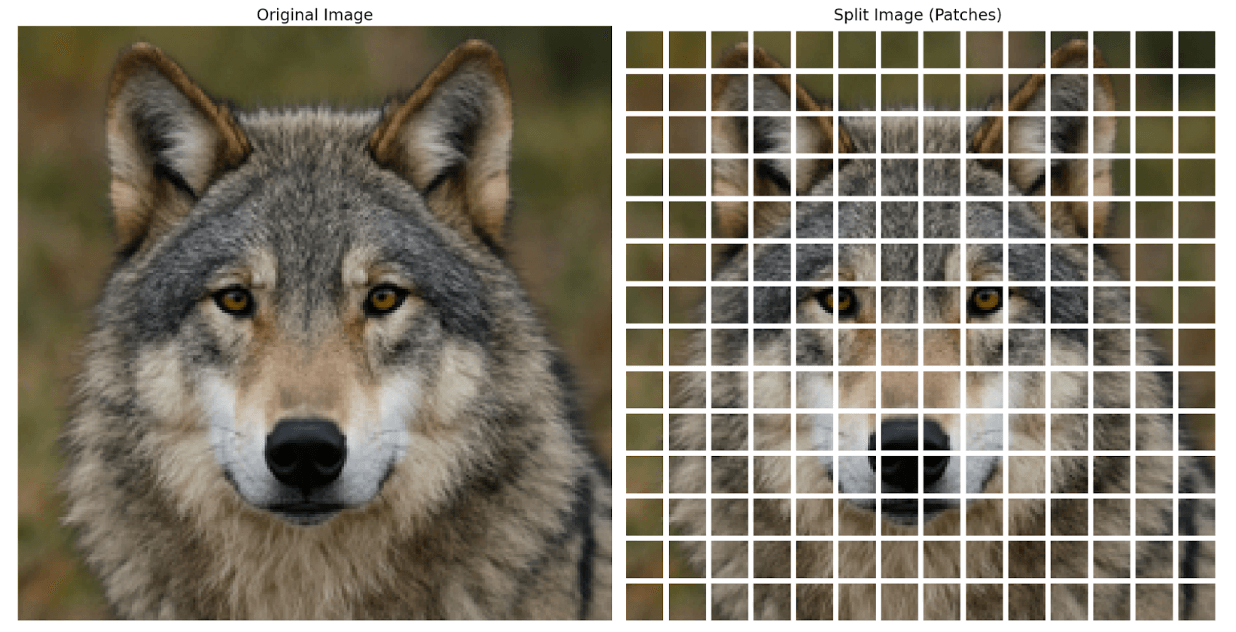
Dans l'illustration ci-dessus, l'image d'un loup est découpée en carrés égaux : 196 au total.
Vous avez peut-être une question :
« L'image est en RVB ; que deviennent les 3 canaux de couleur ? »
Point important : chaque patch est un bloc de données qui a ici la forme 16×16×3. 16×16 sont la hauteur et la largeur, et 3 les canaux de couleur : chaque patch est donc un tenseur 3D.
Chaque patch constitue ainsi une représentation compacte des informations spatiales et de couleur d'une zone locale de l'image.
Ce découpage en patches transforme la structure spatiale 2D de l'image en une séquence 1D de données multidimensionnelles, adaptée à un modèle transformer.
Ensuite, nous devons transformer chaque patch en une représentation numérique exploitable par le transformer.
Chaque patch 16×16 RVB est aplatî en un seul vecteur. Dans notre exemple, 16×16×3 = 768 valeurs. On déroule en quelque sorte tous les pixels et valeurs de couleur en une suite numérique.
Ces vecteurs bruts, bien que riches, ne sont pas encore dans un espace propice à l'apprentissage. On fait donc passer chacun par une couche de projection linéaire apprenable. Pensez-y comme à une couche dense qui projette l'entrée 768D dans un nouvel espace d'embedding de dimension D (souvent 768, mais pas toujours).
Pourquoi ?
Cette projection aligne tous les tokens de patch dans un format homogène et apprenable attendu par l'encodeur transformer. Jusqu'ici, nous avions une séquence de vecteurs de longueur fixe, chaque vecteur représentant un patch de l'image.
Ce processus transforme des patches riches en information spatiale et colorimétrique en une séquence unifiée de « tokens » (analogue aux embeddings de mots en TAL), permettant au transformer de traiter l'image comme une série structurée d'entités apprenables.
Il reste une étape avant d'envoyer ces tokens dans notre encodeur. Vous l'aurez deviné si vous connaissez déjà les LLM !
Les transformers sont intrinsèquement insensibles à la position.
Ils considèrent une séquence comme un ensemble non ordonné : aucune mécanique interne ne leur donne le sens de l'ordre ou de la position des tokens. Or, en analyse d'image, la structure spatiale et la mise en page sont cruciales !
Détaillons ce point.
Dans le contexte des images, chaque patch représente une région spécifique de l'image d'origine. Si l'on fournit à l'encodeur une séquence d'embeddings de patches sans indiquer d'où ils proviennent, il ignore si un patch vient du coin supérieur gauche ou de la partie inférieure droite.
Ce manque de repères spatiaux limiterait la compréhension des motifs, des formes et des structures.
Pour y remédier, on ajoute un encodage positionnel à chaque embedding de patch. C'est un vecteur jouant le rôle d'étiquette spatiale : il encode la position d'origine du patch dans l'image. Ces vecteurs sont ajoutés aux embeddings avant l'entrée dans le transformer.
Deux approches courantes existent :
Si cela vous paraît abstrait, imaginez l'encodage positionnel comme des coordonnées GPS pour les patches.
Ils indiquent au transformer la position d'origine du token. Ainsi, l'auto-attention modélise à la fois le contenu de chaque patch et sa position relative ou absolue dans l'image.
Cette étape est cruciale : sans elle, le Vision Transformer serait incapable de reconstruire la structure d'une image, quelle que soit la puissance de l'attention.
Nous arrivons au cœur de l'apprentissage profond : découverte de motifs, modélisation du contexte et fusion de features.
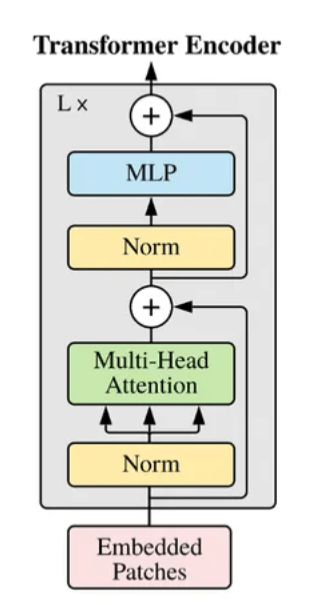
Plusieurs de ces blocs encodeurs sont empilés pour former l'encodeur complet d'un Vision Transformer. Détaillons le contenu d'un bloc :
Globalement, ces blocs sont empilés en couches (par ex., 12 pour ViT-Base), chacune apprenant des représentations d'image plus profondes.
On y est presque ! Passons à la dernière étape du ViT (vanilla).
Après les couches encodeuses, il faut résumer l'information et produire une prédiction.
On introduit donc un token [CLS] spécial au début de la séquence de patches. C'est un embedding apprenable qui interagit avec tous les autres tokens durant l'encodage.
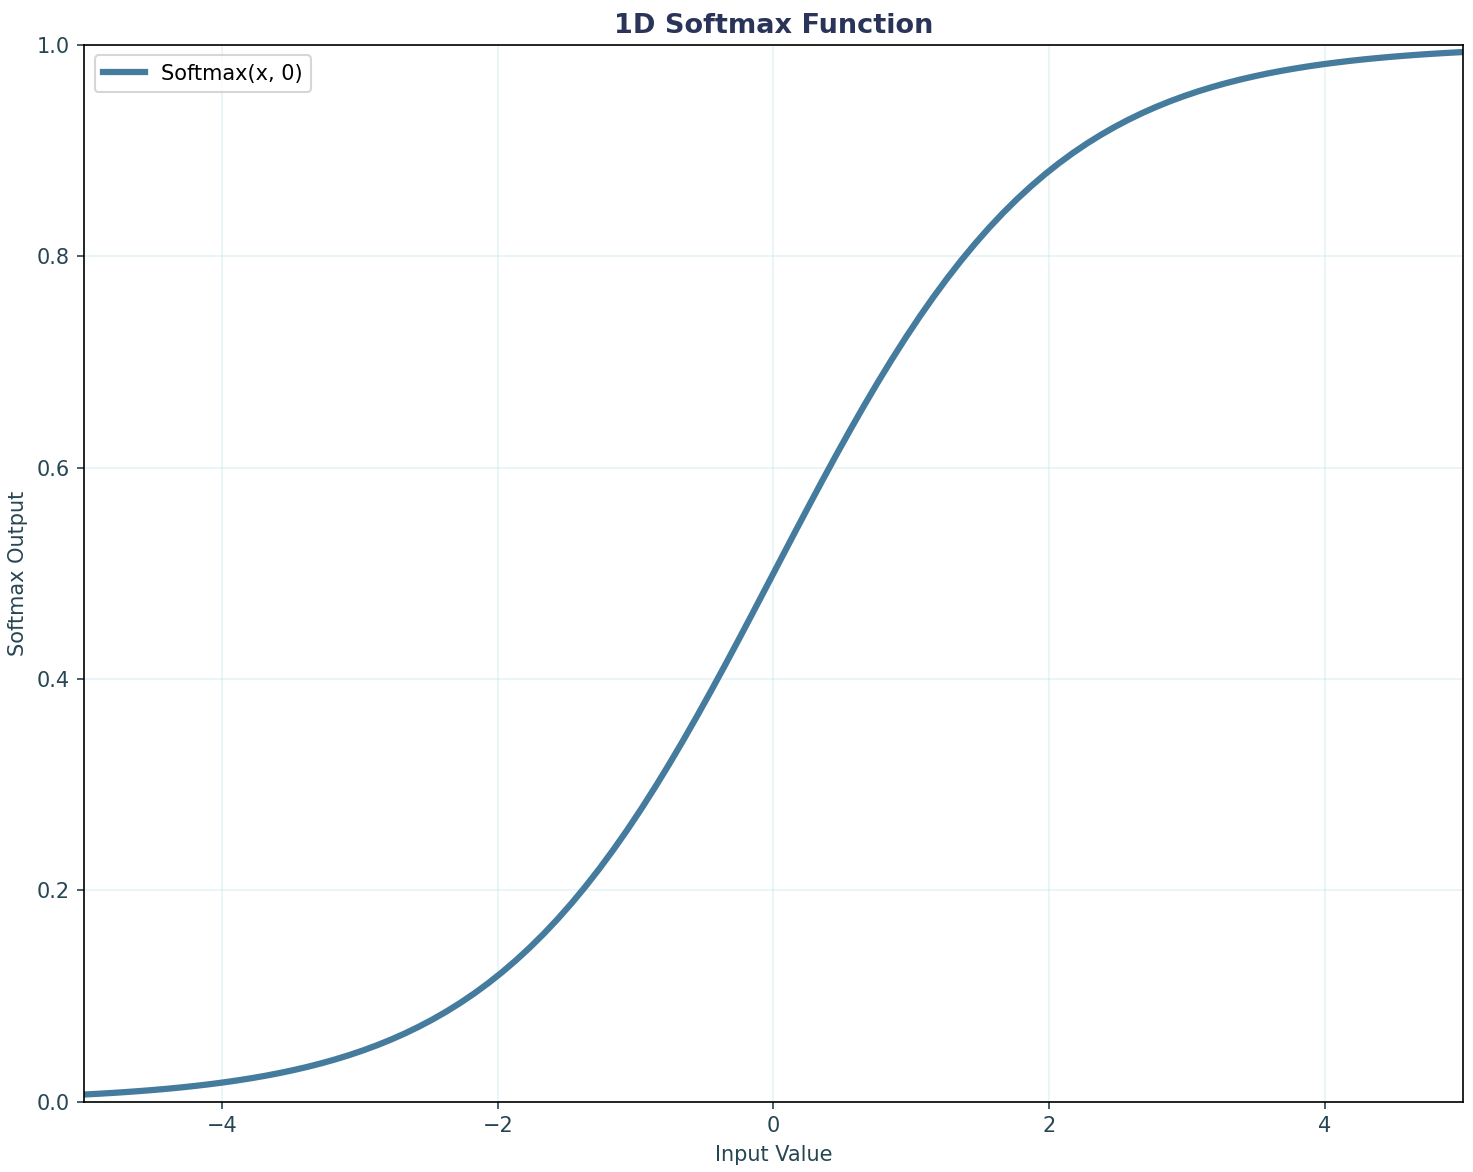
Au fil des couches, il agrège une information globale. En sortie, on extrait ce token et on le passe à une tête perceptron multicouche (MLP) (généralement quelques couches denses suivies d'un softmax pour la classification).
Cette dernière étape fournit l'étiquette prédite, par exemple « cette image est un chien », sur la base des informations récoltées par le token [CLS]. Point clé : seul le token [CLS] est envoyé à cette tête MLP finale et sert à la classification ; pas les autres tokens !
Passons en revue quelques architectures de Vision Transformer marquantes.
La plupart du temps, nous n'entraînons pas un ViT depuis zéro ! Voyons comment utiliser des modèles ViT préentraiînés issus des bibliothèques de deep learning les plus répandues.
L'une des façons les plus simples et fiables d'utiliser des vision transformers passe par la bibliothèque Transformers de Hugging Face. Elle fournit des ViT préentraiînés, prêts à l'emploi en quelques lignes de code.
Voici du code pour télécharger et utiliser le modèle ViT Base original :
# Imports neededfrom transformers import ViTImageProcessor, ViTForImageClassificationfrom PIL import Imageimport torchimport requests# Here I am loading and preprocessing an image - but you can use any image of your choiceimage = Image.open(requests.get(https://huggingface.co/datasets/huggingface/cats-image?image-viewer=ED6CB286C90CF5F1FAF278077DF091477DF05416', stream=True).raw)# Here, we load and process the ViT modelprocessor = ViTImageProcessor.from_pretrained('google/vit-base-patch16-224')model = ViTForImageClassification.from_pretrained('google/vit-base-patch16-224')# Preprocessing the image so it gets it into the necessary formatinputs = processor(images=image, return_tensors='pt')# Forward pass - with no backpropagationwith torch.no_grad(): outputs = model(**inputs)# Here we get the predicted labels (since we are performing classification)logits = outputs.logits predicted_class = logits.argmax(-1) # Selects the index of the class with the highest logit score (highest predicted probability)print(f"Predicted class index: {predicted_class.item()}")Parlons un peu plus en détail de ce code. D'abord, vous vous demandez peut-être pourquoi télécharger deux composants séparés. Ils sont distincts mais complémentaires :
ViTImageProcessor – Responsable du prétraitement de l'image avant son passage dans le modèle. Gère le redimensionnement, la normalisation et la conversion dans le format attendu par le ViT. Voyez-le comme l'équivalent vision d'un tokenizer en TAL !ViTForImageClassification – C'est le modèle qui réalise l'inférence. Il attend des entrées dans un format tensoriel spécifique et produit des prédictions (logits, probabilités, etc.).Autre interrogation possible : output.logits et, plus précisément, ce que sont les logits.
En apprentissage automatique – notamment en classification – les logits sont les sorties brutes de la dernière couche du modèle, avant toute activation (softmax, etc.). Elles représentent des scores non normalisés pour chaque classe.
Vous pouvez les voir comme les niveaux de confiance internes du modèle. Ces valeurs peuvent être positives ou négatives et ne somment pas à 1.
Pour convertir des logits en probabilités, on applique la fonction softmax, qui les transforme en distribution de probabilité.
Ainsi, quand nous utilisons argmax(logits, -1), nous sélectionnons simplement l'index (classe) au score brut le plus élevé, en général équivalent à la plus haute probabilité après softmax.
Autre bibliothèque référence pour les vision transformers : timm (par Ross Wightman). Elle offre de nombreuses variantes de ViT préentraiînées, idéales pour l'expérimentation rapide ou le fine-tuning. Voici comment charger et utiliser un ViT en inférence :
# Relevant importsimport timmimport torchfrom torchvision import transformsfrom PIL import Imageimport requests# Loading an imageurl = 'https://huggingface.co/datasets/huggingface/cats-image?image-viewer=ED6CB286C90CF5F1FAF278077DF091477DF05416'image = Image.open(requests.get(url, stream=True).raw)# Here we have defined the transformation we are going to do on the imagetransform = transforms.Compose([ transforms.Resize((224, 224)), transforms.ToTensor(), transforms.Normalize(mean=[0.5, 0.5, 0.5], std=[0.5, 0.5, 0.5])])image_tensor = transform(image).unsqueeze(0) # Adding batch dimension# Loading the ViT modelmodel = timm.create_model('vit_base_patch16_224', pretrained=True)model.eval() # Setting it to evaluation mode# Inference componentwith torch.no_grad(): outputs = model(image_tensor) predicted_class = outputs.argmax(dim=1) # Obtaining the class with the highest probabilityprint(f"Predicted class index: {predicted_class.item()}")Vous voyez sans doute la similarité entre timm et la bibliothèque transformers. Toutes deux fournissent des ViT préentraiînés, gèrent le prétraitement (dans timm nous utilisons le code PyTorch standard) et, in fine, renvoient la classe au logit maximal.
Globalement, les vision transformers ont transformé la vision par ordinateur en convertissant les images en « phrases » de patches et en utilisant l'auto-attention pour capter le contexte global dès la première couche. Dans ce tutoriel, nous avons vu :
Pour aller plus loin, je vous recommande cet article sur le fonctionnement des Transformers pour en maîtriser la théorie. Pour consolider, explorez ensuite la construction d'un transformer from scratch.
Si vous souhaitez apprendre la théorie et la pratique en même temps, notre cours Transformer Models with PyTorch est fait pour vous.
Les meilleurs cours DataCamp
Cours
Cursus
Cursus